Última chance! Formação ilimitada com 50% de desconto
A promoção termina em
Todo LLM tem o mesmo problema: ele esquece tudo assim que a conversa termina — às vezes até durante conversas longas. Você passa vinte minutos explicando seu projeto, seus limites e preferências, e ele acerta em cheio. Fecha a aba, abre uma nova sessão, e ele te cumprimenta como se nunca tivesse te visto. Todo aquele contexto, sumiu.
Se você quer criar um agente de IA — algo que realmente lembra do contexto e conhece seu domínio — você precisa dar memória a ele. Do tipo prático, que guarda o que você disse e consegue consultar os fatos que você ensinou.
Este é um POC que eu construí exatamente para isso. Três tipos de memória, um banco de dados e pouco código. O código-fonte completo está no GitHub.
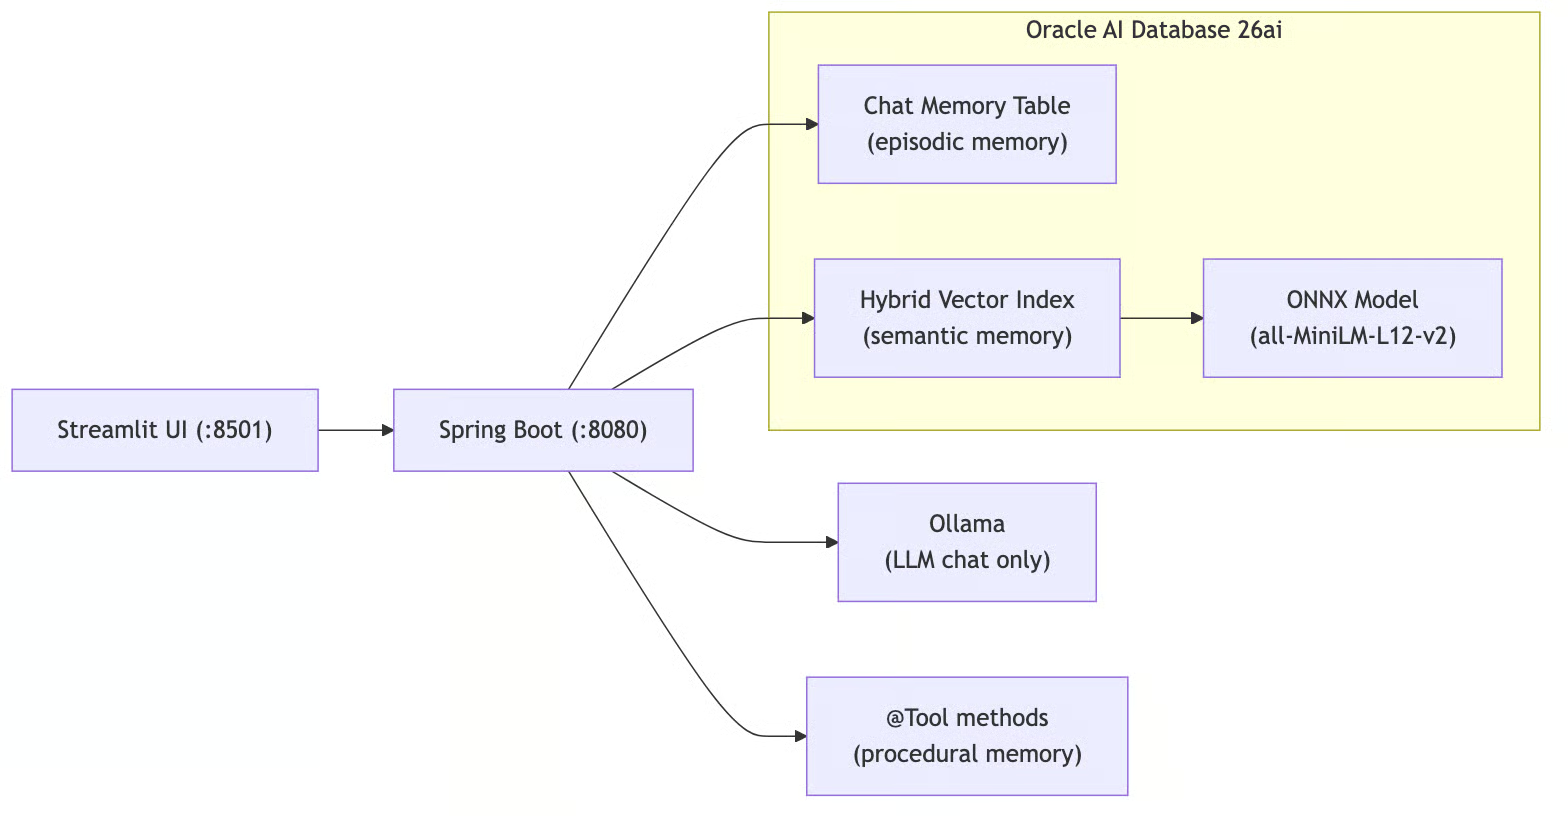
Figura 1. Arquitetura ponta a ponta de memória de agente com Spring AI e Oracle AI Database 26ai
A stack:
Costuma-se falar de memória episódica, semântica, procedimental e de trabalho para agentes.
A memória de trabalho é só a janela de contexto do LLM; o "rascunho" ativo do pedido atual. Ela não é persistida, então não há nada a construir. Eu implementei as outras três:
Memória episódica é o histórico da conversa. O agente lembra o que você disse antes. "Meu nome é Victor" na mensagem 1 significa que ele ainda sabe seu nome na mensagem 50. Isso é armazenado como linhas em uma tabela relacional.
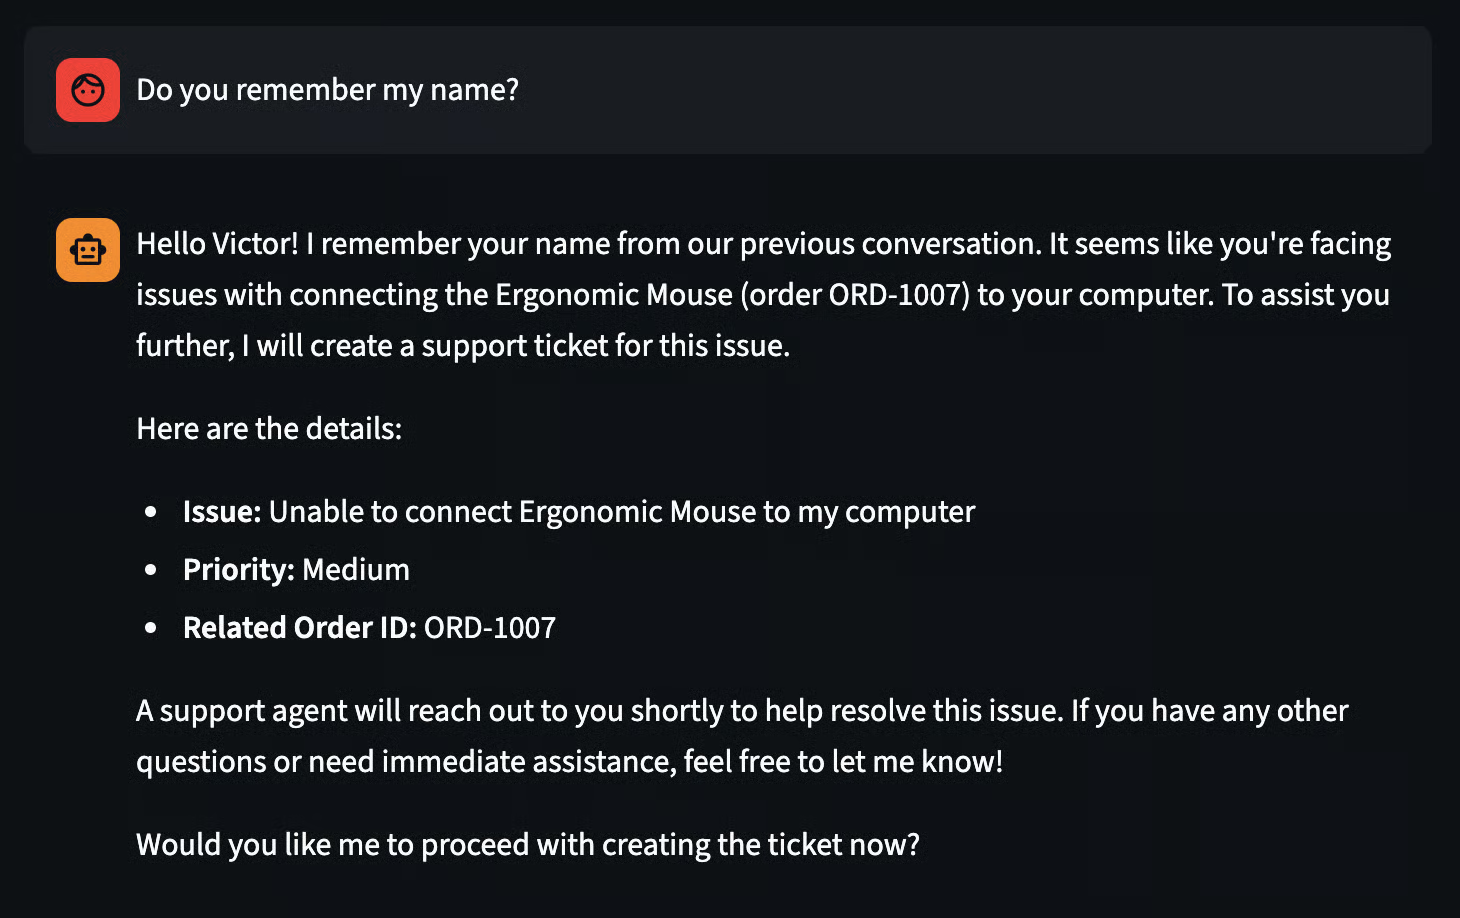
Figura 2. Memória episódica é o histórico do chat
Memória semântica é o conhecimento do domínio. Você alimenta o agente com fatos (documentação de produto, políticas da empresa etc.) e ele busca os mais relevantes para responder.
Isso é RAG (Retrieval-Augmented Generation): o texto é convertido em vetores densos (embeddings) que mapeiam significado em um espaço geométrico, aproximando textos semanticamente similares.
Mas a busca puramente vetorial tem pontos cegos; ela captura bem o sentido, mas sofre com termos exatos como IDs de pedidos ou códigos de produto.
Por isso, este POC usa os Hybrid Vector Indexes da Oracle, que executam a busca por similaridade vetorial e a busca por palavras-chave (lexical) em paralelo, e depois fundem as duas listas de resultados com Reciprocal Rank Fusion (RRF).
Na consulta, a busca híbrida encontra documentos que correspondem por significado ou por termos exatos e injeta os principais resultados no prompt do LLM. As embeddings são calculadas dentro do banco por um modelo ONNX (all-MiniLM-L12-v2, 384 dimensões) carregado diretamente no Oracle, sem chamadas a APIs externas de embedding. Mais sobre isso abaixo.
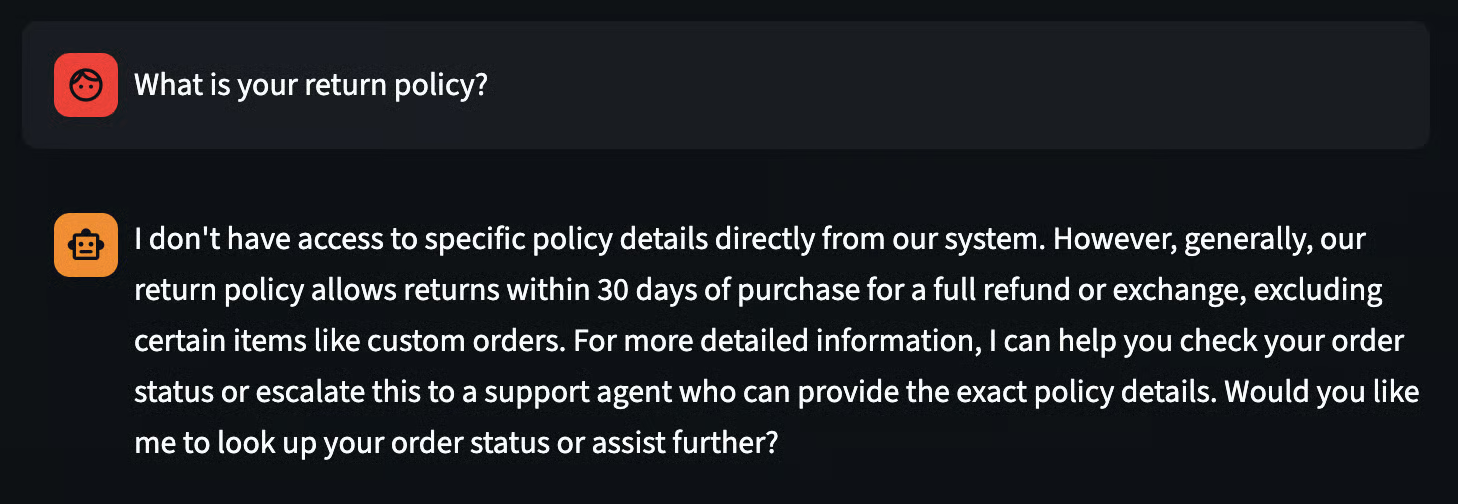
Figura 3. Memória semântica como conhecimento de domínio
Memória procedimental é o "como", os fluxos passo a passo que o agente sabe executar. Consultar um pedido, iniciar uma devolução, escalar para o suporte. No Spring AI, isso são métodos anotados com @Tool, que o LLM pode chamar quando decide que a tarefa exige ação, não só uma resposta.
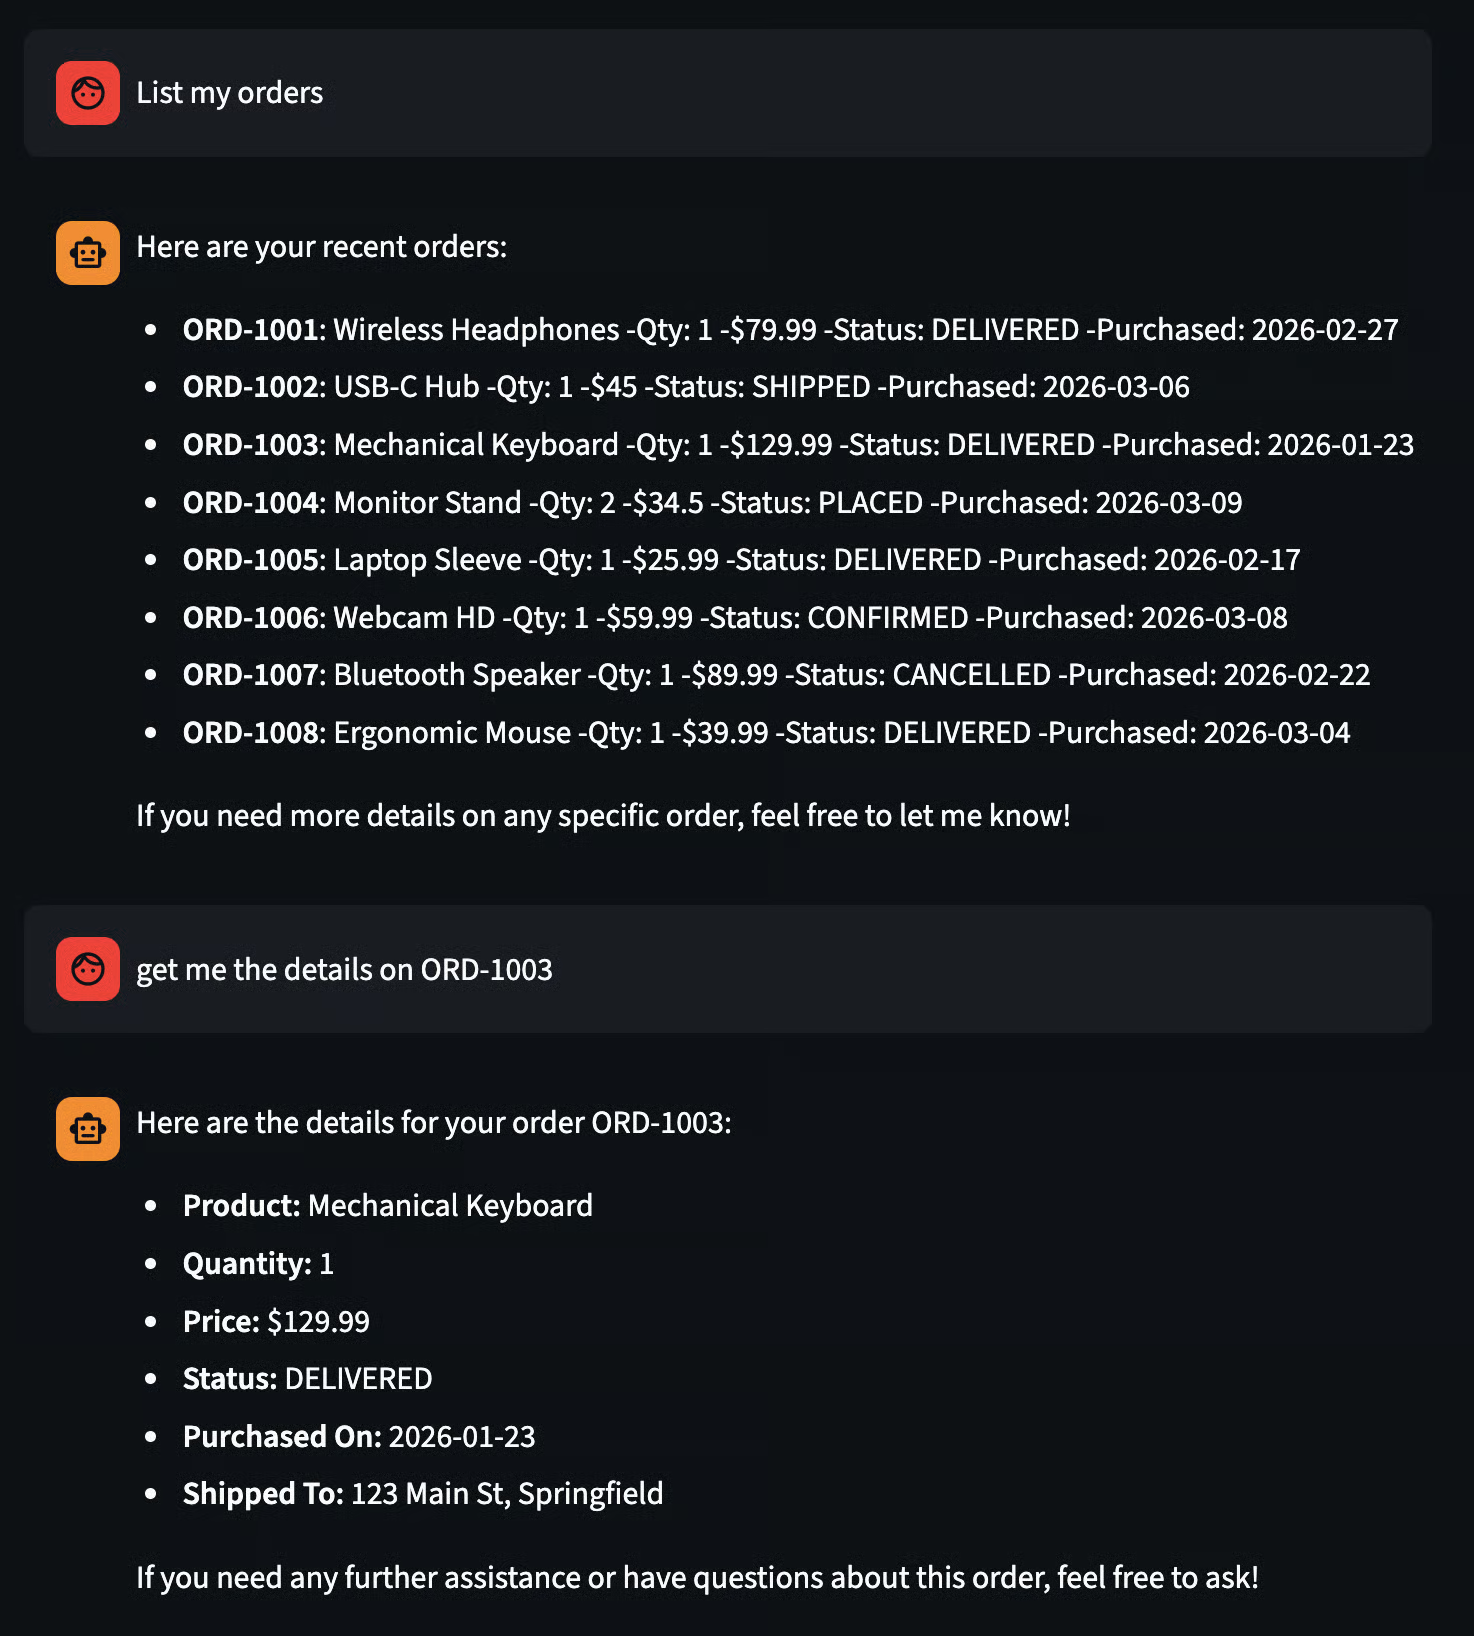
Figura 4. Memória procedimental em ação: o agente usa tool calls para consultar dados de pedidos em tempo real e retornar resultados específicos da tarefa.
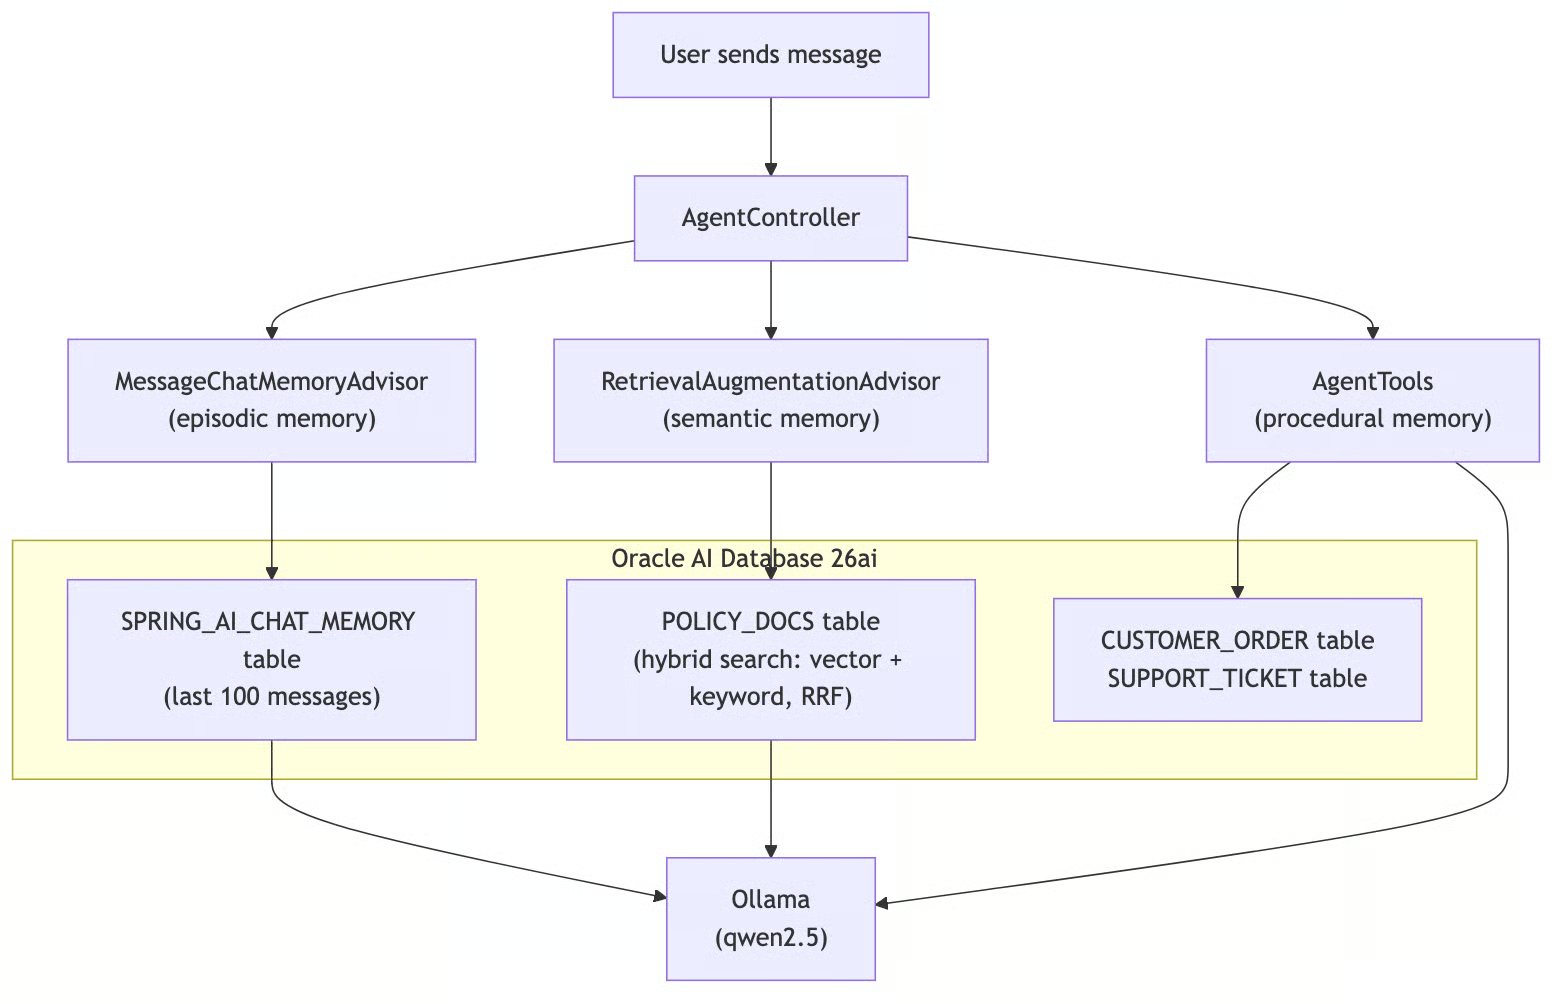
Figura 5. Fluxo de requisição no AgentController, onde memórias episódica, semântica e procedimental são combinadas a partir de tabelas do Oracle AI Database antes de gerar a resposta com o Ollama.
As duas tabelas vivem no mesmo Oracle Database. Sem Pinecone. Sem Redis. Sem segundo banco. Um pool de conexões, um conjunto de credenciais, uma coisa para monitorar.
A memória procedimental é implementada como métodos anotados com @Tool em um componente Spring que consulta tabelas reais no banco. Aqui vão dois métodos representativos, simplificados para clareza; a classe completa tem seis ferramentas (veja AgentTools.java):
@Tool(description = "Look up the status of a customer order by its order ID. " +
        "Returns the current status including shipping information.")
public String lookupOrderStatus(
        @ToolParam(description = "The order ID to look up, e.g. ORD-1001") String orderId) {
    // Fetches order from DB via JPA, returns formatted status string
}

@Tool(description = "Initiate a product return for a given order. " +
        "Validates the order exists, checks that it is in DELIVERED status, " +
        "and verifies the return is within the 30-day return window.")
public String initiateReturn(
        @ToolParam(description = "The order ID to return") String orderId,
        @ToolParam(description = "The reason for the return") String reason) {
    // Validates order exists, checks DELIVERED status and 30-day window, updates status via JPA
}
A descrição do @Tool informa ao LLM quando usar cada método, e @ToolParam descreve os argumentos. Quando o usuário diz "Quero devolver o pedido ORD-1001", o LLM lê as descrições das ferramentas, decide que initiateReturn é o procedimento certo, extrai os argumentos da conversa, chama o método e incorpora o resultado na resposta.
As outras quatro ferramentas são getCurrentDateTime (busca data/hora atual no banco), listOrders, escalateToSupport e listSupportTickets. Todas seguem o mesmo padrão: consultas via JPA ou JDBC. O LLM decide quando agir; os métodos Java definem como.
O controller integra tudo: dois advisors, seis ferramentas, um ChatClient. Aqui está o núcleo, simplificado para clareza (a versão completa adiciona validação de entrada, tratamento de erros e endpoints de gerenciamento de conversa. Veja AgentController.java):
@RestController
@RequestMapping("/api/v1/agent")
public class AgentController {

    public AgentController(ChatClient.Builder builder,
                           JdbcChatMemoryRepository chatMemoryRepository,
                           JdbcTemplate jdbcTemplate,
                           AgentTools agentTools) {
        // Builds a ChatClient with:
        //   - MessageChatMemoryAdvisor (episodic: last 100 messages per conversation)
        //   - RetrievalAugmentationAdvisor + OracleHybridDocumentRetriever (semantic: hybrid search)
        //   - AgentTools via .defaultTools() (procedural: 6 @Tool methods)
        //   - System prompt defining the agent persona and tool usage rules
    }

    @PostMapping("/chat")
    public ResponseEntity<String> chat(
            @RequestBody String message,
            @RequestHeader("X-Conversation-Id") String conversationId) {
        // Sends message to ChatClient with conversation ID, returns LLM response
    }

    @PostMapping("/knowledge")
    public ResponseEntity<String> addKnowledge(@RequestBody String content) {
        // Inserts text into POLICY_DOCS table via JDBC (hybrid index handles embedding)
    }
}
Dois endpoints, dois advisors, seis ferramentas, um ChatClient. Vamos dissecar os três tipos de memória.
O padrão de advisors do Spring AI é onde a mágica acontece. Eles interceptam cada chamada ao LLM, podem ajustar o prompt antes do envio e processar a resposta na volta.
MessageChatMemoryAdvisor cuida da memória episódica. Antes de cada chamada ao LLM, ele carrega as últimas 100 mensagens da conversa atual da tabela SPRING_AI_CHAT_MEMORY e as adiciona ao início do prompt. Depois da resposta, salva a nova troca. A conversa é identificada pelo header X-Conversation-Id: ID diferente, memória diferente.
RetrievalAugmentationAdvisor cuida da memória semântica. Antes de cada chamada ao LLM, um OracleHybridDocumentRetriever customizado chama DBMS_HYBRID_VECTOR.SEARCH, que executa a busca por similaridade vetorial e a busca por palavras-chave do Oracle Text em paralelo e funde os resultados com RRF.
Os 5 documentos mais relevantes são injetados no prompt como contexto por um ContextualQueryAugmenter customizado que trata os documentos como suplementares; o LLM é instruído a usá-los apenas para perguntas de política, não para pedidos de ação ou contexto conversacional. Isso evita que o contexto de RAG sobreponha o histórico do chat ou impeça chamadas de ferramentas.
Por que híbrido em vez de apenas vetorial? Embeddings densas capturam significado: uma consulta sobre "política de devolução" vai casar com documentos sobre reembolso e trocas mesmo sem essas palavras exatas.
Mas são fracas para termos exatos: uma consulta por "ORD-1001" degrada porque o modelo de embedding codifica semântica, não palavras-chave. A busca híbrida cobre os dois: o lado vetorial trata do significado, o lado lexical cobre correspondências exatas, e o RRF combina as duas listas por posição no ranking, sem tentar normalizar escores incompatíveis.
AgentTools cuida da memória procedimental. A chamada .defaultTools(agentTools) registra os seis métodos anotados com @Tool do componente. Em toda requisição, o LLM recebe as descrições das ferramentas junto com a mensagem do usuário. Se a tarefa requer ação, não só conhecimento, o LLM chama a ferramenta apropriada, obtém o resultado e o incorpora à resposta. O Spring AI gerencia o protocolo de tool calling automaticamente.
Os três tipos de memória rodam a cada requisição. O agente lembra o que você disse, consulta conhecimento relevante e sabe executar tarefas ao mesmo tempo.
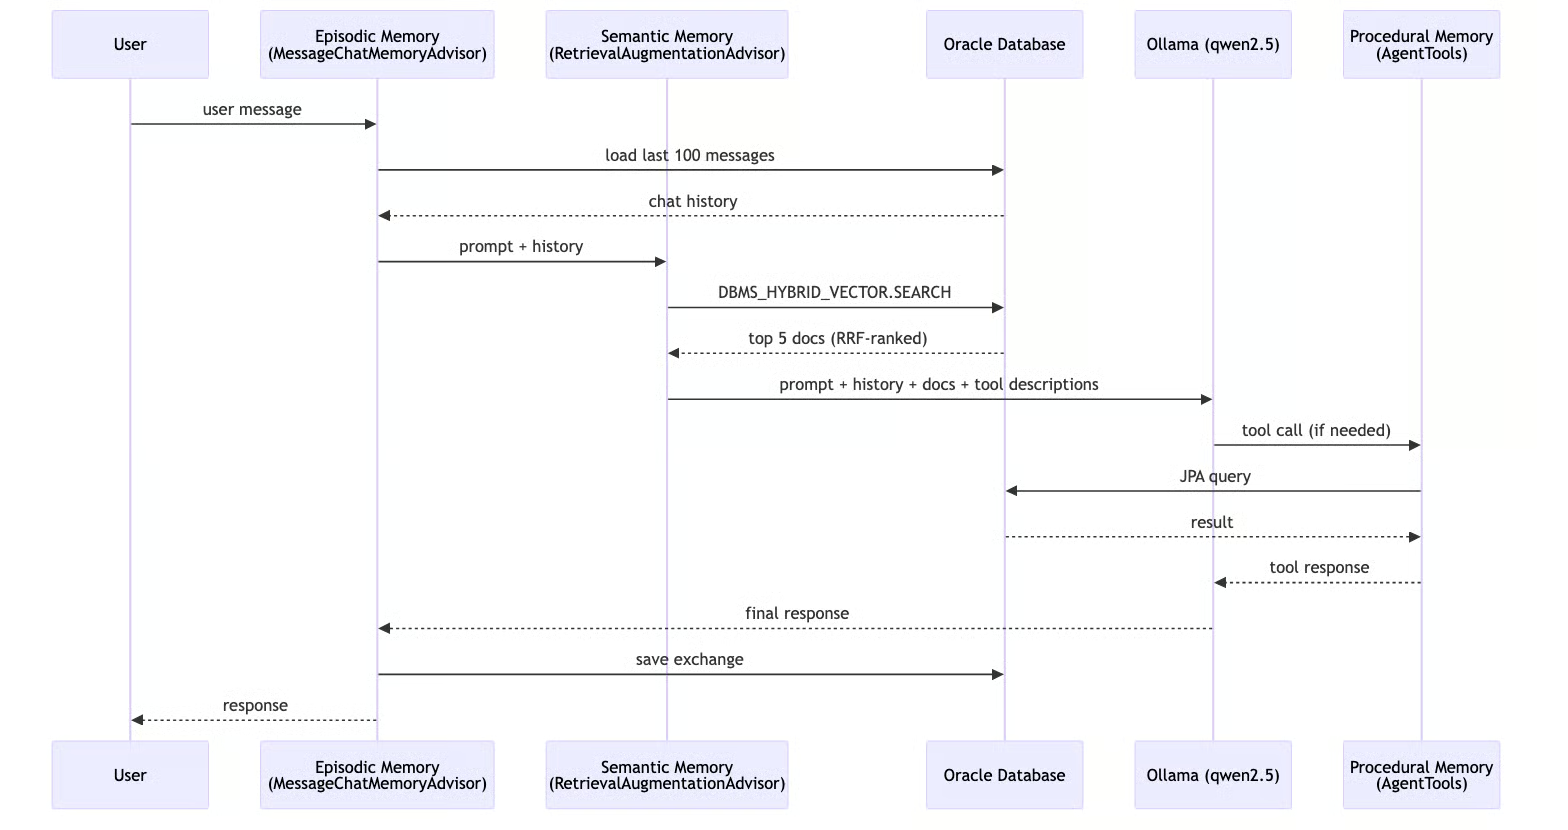
Figura 6. Sequência ponta a ponta em que histórico do chat, contexto RAG híbrido e chamadas de ferramentas opcionais se combinam para produzir e persistir a resposta final.
O endpoint /knowledge é simples: faça um POST com um texto e ele é inserido na tabela POLICY_DOCS via JDBC. O índice vetorial híbrido cuida automaticamente da embedding usando o modelo ONNX no banco, sem precisar de chamada a API externa de embedding. Na próxima pergunta relacionada, a busca híbrida vai encontrá-lo.
Um DataSeeder (Spring CommandLineRunner) popula o banco na inicialização com 8 pedidos de demo e 12 documentos de políticas (devolução, envio, suporte, garantia, pagamento, cancelamento, troca, frete internacional, privacidade, promoções, garantia de produto e compras em volume). As políticas são carregadas de um recurso policies.json e inseridas na tabela POLICY_DOCS via JDBC. Os pedidos usam datas relativas para que a lógica da janela de devolução de 30 dias funcione sempre na demo. O seeder verifica contagens existentes para evitar duplicatas em reinicializações.
A primeira versão deste POC usava o QuestionAnswerAdvisor do Spring AI com OracleVectorStore: busca por similaridade vetorial pura com threshold de cosseno. Funcionava bem para perguntas limpas e bem formuladas sobre políticas. Mas desmoronava em termos exatos e typos. Uma busca por "order ORD-1001" tentava casar semanticamente com documentos de políticas, o que não faz sentido. Um "retrun polcy" com erro de digitação perdia score porque o modelo de embedding não entende que é um typo.
O Oracle 26ai oferece o DBMS_HYBRID_VECTOR.SEARCH, uma única chamada PL/SQL que executa busca por similaridade vetorial e busca por palavras-chave do Oracle Text em paralelo e depois funde os resultados.
O diferencial é o Reciprocal Rank Fusion (RRF): em vez de tentar normalizar escores de similaridade do cosseno (limitados entre 0 e 1) com escores BM25 de palavras-chave (não limitados), ele ranqueia os documentos pela posição em cada lista.
Um documento que é 1º no resultado vetorial e 3º no lexical recebe um ranking combinado que reflete ambos os sinais.
A preparação é um script SQL único que carrega um modelo de embedding ONNX no Oracle AI Database e cria um índice híbrido:
/SQL
-- Load the ONNX model for in-database embeddings
BEGIN
  DBMS_VECTOR.LOAD_ONNX_MODEL(
    directory  => 'DM_DUMP',
    file_name  => 'all_MiniLM_L12_v2.onnx',
    model_name => 'ALL_MINILM_L12_V2'
  );
END;
/

-- Create a hybrid index: vector similarity + Oracle Text keyword search
CREATE HYBRID VECTOR INDEX POLICY_HYBRID_IDX
ON POLICY_DOCS(content)
PARAMETERS('MODEL ALL_MINILM_L12_V2 VECTOR_IDXTYPE HNSW');
Depois que o índice existe, as embeddings são geradas automaticamente quando as linhas são inseridas — sem necessidade de chamadas externas de embedding.
O QuestionAnswerAdvisor do Spring AI só encapsula VectorStore.similaritySearch(), ou seja, apenas busca vetorial. Para usar busca híbrida, eu troquei para o RetrievalAugmentationAdvisor, a alternativa modular: ele aceita um DocumentRetriever customizado e um QueryAugmenter customizado para controlar como os documentos recuperados são injetados no prompt.
O OracleHybridDocumentRetriever custom implementa DocumentRetriever e chama DBMS_HYBRID_VECTOR.SEARCH via JDBC, passando um parâmetro JSON que especifica o índice híbrido, o scorer (RRF) e uma correspondência por palavra-chave:
public List<Document> retrieve(Query query) {
    // Builds a JSON spec with hybrid index name, RRF scorer, vector + text search clauses
    // Calls DBMS_HYBRID_VECTOR.SEARCH via JDBC, parses JSON results into List<Document>
}
Isso contorna totalmente o OracleVectorStore para recuperação. A cláusula text.contains usa correspondência simples por palavra-chave com OR (palavras com mais de 2 caracteres), deixando o stemming nativo do Oracle Text lidar com variações.
O agente precisa de recuperação precisa para tomar boas decisões. Se a memória semântica retornar documentos de política errados ou com baixa confiança, o LLM pode alucinar parâmetros de ferramenta ou deixar de chamar uma ferramenta que deveria usar.
Busca híbrida significa contexto com mais confiança — e, portanto, decisões autônomas melhores; o agente tem menos chance de citar uma política errado ou perder um documento relevante quando tanto significado quanto termos exatos são considerados.
A configuração fica em um único application.yaml. Decisões-chave: o Hibernate cria automaticamente as tabelas JPA (ddl-auto: update), o Spring AI cria automaticamente a tabela de memória de chat (initialize-schema: always), a tabela POLICY_DOCS e o índice vetorial híbrido são criados por um script SQL único (setup-hybrid-search.sql) e o Oracle UCP compartilha um pool de conexões entre os três tipos de memória.
Sem Flyway, sem classes @Configuration customizadas. A auto-configuração do Spring AI detecta o driver JDBC do Oracle e faz o wiring. Veja o application.yaml completo no repositório.
O frontend em Streamlit envia mensagens para o backend e renderiza as respostas. Aqui está o núcleo (o app completo inclui botões de quick start e novo chat. Veja app.py):
def send_message(prompt, url):
    # POSTs plain text to /api/v1/agent/chat with X-Conversation-Id header
    # Renders user message and assistant response in Streamlit chat UI

if prompt := st.chat_input("Type a message..."):
    send_message(prompt, backend_url)
Ele gera um UUID por sessão para o ID da conversa, envia texto puro ao backend e renderiza a resposta. Só isso.
Versão curta: suba um container do Oracle DB, carregue o modelo ONNX e crie o índice híbrido (setup único), instale o Ollama e puxe o modelo de chat (qwen2.5), rode o backend Spring Boot com o perfil local e, opcionalmente, inicie a UI em Streamlit. As embeddings são geradas dentro do banco pelo modelo ONNX, sem precisar de modelo de embedding no Ollama. O passo a passo completo está no README do repositório.
Teste rápido com curl:
curl -X POST http://localhost:8080/api/v1/agent/chat \
  -H "Content-Type: text/plain" \
  -H "X-Conversation-Id: test-1" \
-d "What orders do I have?"Essa arquitetura é um ótimo padrão para construir agentes reais com Spring AI e Oracle Database porque mantém todas as camadas de memória em uma única stack operacional: contexto episódico, recuperação semântica e ações procedimentais. O Spring AI oferece abstrações limpas (Advisors + @Tool) para que o comportamento do agente permaneça legível e testável, enquanto o Oracle cuida de dados transacionais e da recuperação híbrida no mesmo sistema, com embeddings dentro do banco e ranking por RRF para mais precisão tanto em significado quanto em termos exatos.
O resultado é prático: menos partes móveis, menos falhas de integração, menor latência e operações em produção mais simples. Em vez de costurar sistemas separados para histórico de chat, busca vetorial, busca por palavras-chave e tabelas de negócio, você constrói em uma plataforma e ainda assim obtém recuperação de alta qualidade e execução confiável de ferramentas. Para times lançando features de agentes, essa combinação de simplicidade, precisão e controle operacional é difícil de superar.
Para aprender mais sobre agentes de IA e como eles funcionam, recomendo a trilha de habilidades AI Agent Fundamentals da DataCamp.
Top DataCamp Courses
Curso
Curso
Curso
blog
blog
DataCamp Team
4 min
blog
Javier Canales Luna
9 min
Tutorial
Zoumana Keita
12 min
Tutorial
Zoumana Keita
14 min
Tutorial
Oluseye Jeremiah
13 min