Kurs
Einführung in Oracle SQL
4 Std.
18.3K
Jedes LLM hat dasselbe Problem: Es vergisst alles in dem Moment, in dem das Gespräch endet – manchmal sogar schon während langer Unterhaltungen. Du erklärst zwanzig Minuten lang dein Projekt-Setup, deine Rahmenbedingungen und Vorlieben, und es liefert perfekte Antworten. Tab schließen, neue Session öffnen – und es begrüßt dich wie ein Fremder. Der ganze Kontext, weg.
Wenn du einen KI-Agenten bauen willst, der sich an Kontext erinnert und Dinge über deine Domäne weiß, musst du ihm ein Gedächtnis geben. Die praktische Sorte, bei der er sich merkt, was du gesagt hast, und Fakten nachschlagen kann, die du ihm beigebracht hast.
Genau dafür habe ich dieses POC gebaut. Drei Arten von Gedächtnis, eine Datenbank, wenig Code. Der komplette Quellcode ist auf GitHub verfügbar.
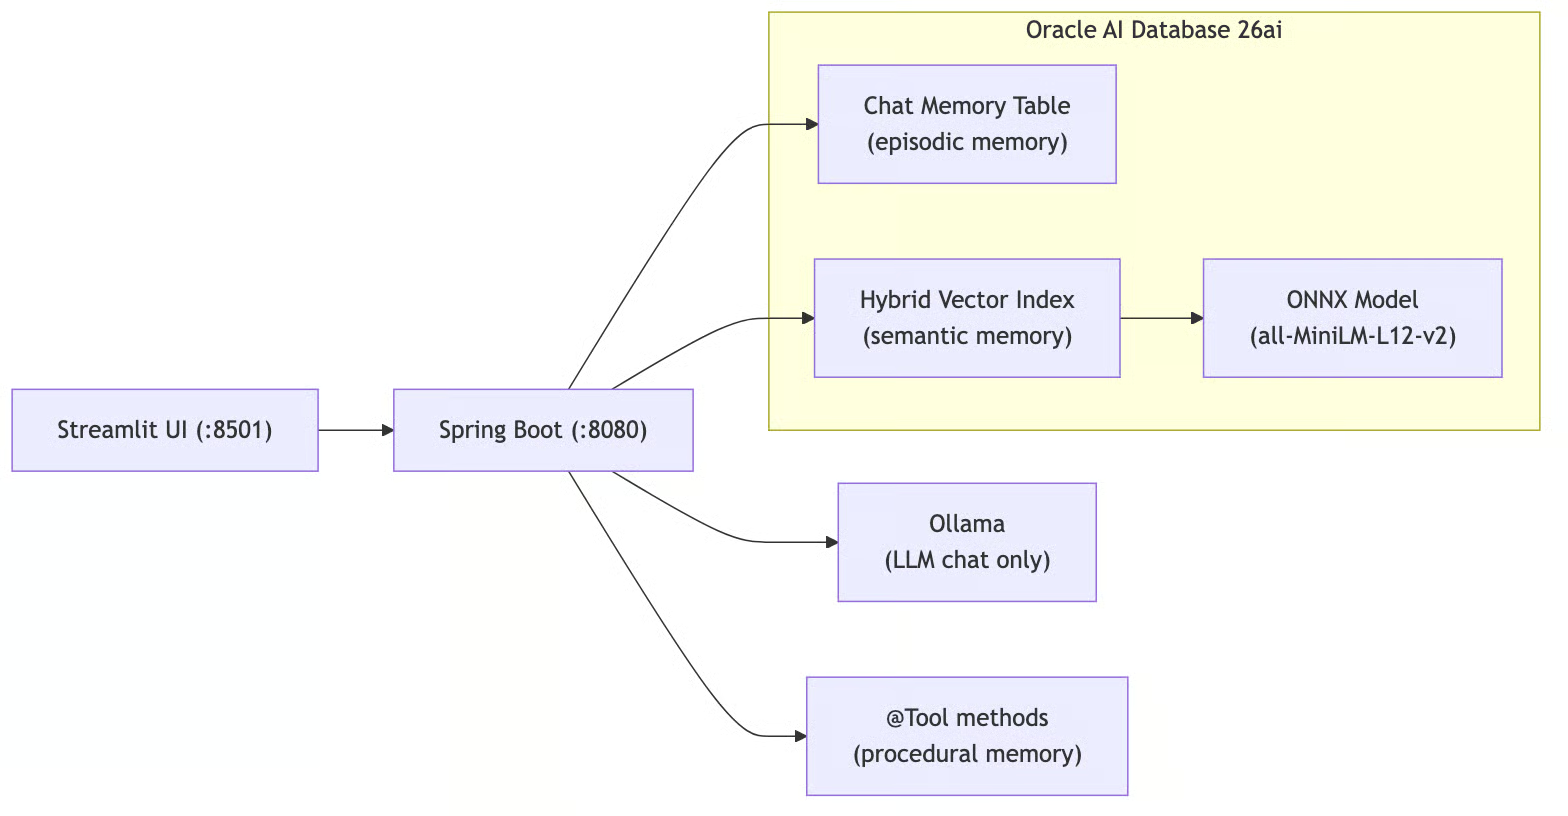
Abbildung 1. End-to-end-Agentenarchitektur mit Gedächtnis auf Basis von Spring AI und Oracle AI Database 26ai
Der Stack:
Für Agenten spricht man von episodischem, semantischem, prozeduralem und Arbeitsgedächtnis.
Das Arbeitsgedächtnis ist einfach das Kontextfenster des LLM – das aktive „Notizblatt“ für die aktuelle Anfrage. Es wird nicht persistiert, also gibt es nichts zu bauen. Ich habe die anderen drei implementiert:
Episodisches Gedächtnis ist der Chatverlauf. Der Agent erinnert sich an das, was du früher im Gespräch gesagt hast. „Ich heiße Victor“ in Nachricht 1 bedeutet, dass er deinen Namen auch in Nachricht 50 noch weiß. Gespeichert wird das als Zeilen in einer relationalen Tabelle.
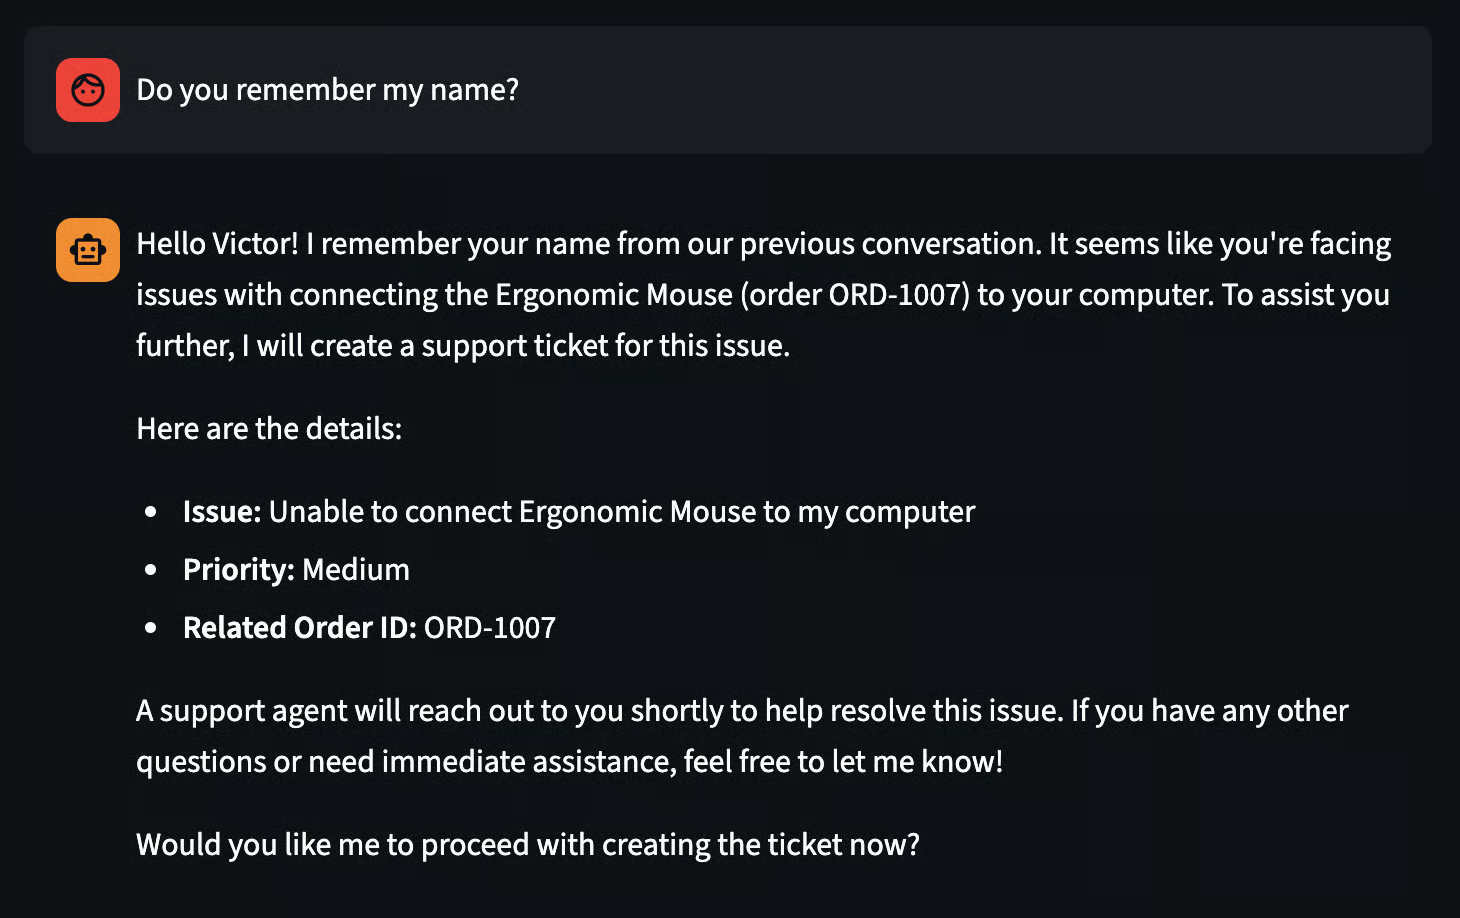
Abbildung 2. Episodisches Gedächtnis ist Chatverlauf
Semantisches Gedächtnis ist Domänenwissen. Du fütterst den Agenten mit Fakten (Produktdokus, Unternehmensrichtlinien, was auch immer), und er holt die passenden beim Beantworten von Fragen.
Das ist RAG (Retrieval-Augmented Generation): Text wird in dichte Vektoren (Embeddings) umgewandelt, die Bedeutung in geometrischen Raum abbilden, sodass semantisch ähnliche Texte nahe beieinander liegen.
Reine Vektorsuche hat jedoch blinde Flecken: Sie erfasst Bedeutung gut, tut sich aber schwer mit exakten Begriffen wie Bestell-IDs oder Produktcodes.
Darum nutzt dieses POC Oracles Hybrid Vector Indexes, die Vektorähnlichkeitssuche und Keyword- (lexikale) Suche parallel ausführen und die beiden Ergebnislisten per Reciprocal Rank Fusion (RRF) zusammenführen.
Zur Abfragezeit findet die hybride Suche Dokumente, die entweder über Bedeutung oder über exakte Begriffe passen, und injiziert die Top-Ergebnisse in den LLM-Prompt. Embeddings werden in der Datenbank von einem ONNX-Modell (all-MiniLM-L12-v2, 384 Dimensionen) berechnet, das direkt in Oracle geladen ist – keine externen Embedding-API-Calls. Mehr dazu weiter unten.
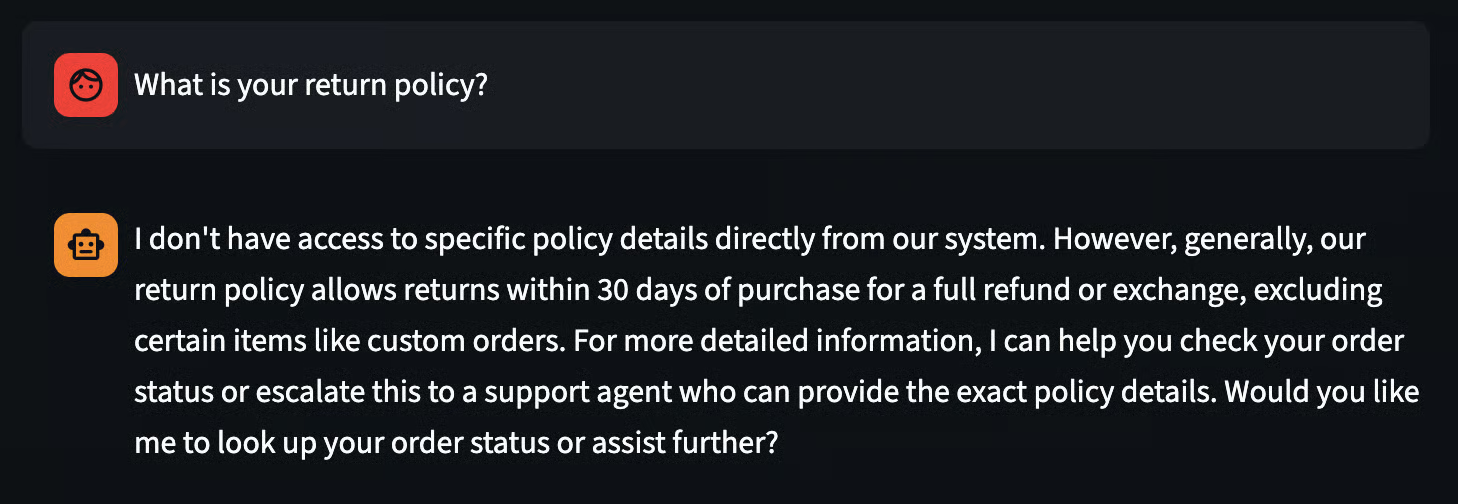
Abbildung 3. Semantisches Gedächtnis als Domänenwissen
Prozedurales Gedächtnis ist das „Wie“ – die Schritt-für-Schritt-Workflows, die der Agent ausführen kann. Eine Bestellung nachschlagen, eine Retoure starten, an den Support eskalieren. In Spring AI sind das mit @Tool annotierte Methoden, die das LLM aufrufen kann, wenn eine Aufgabe Handlung statt nur Antwort erfordert.
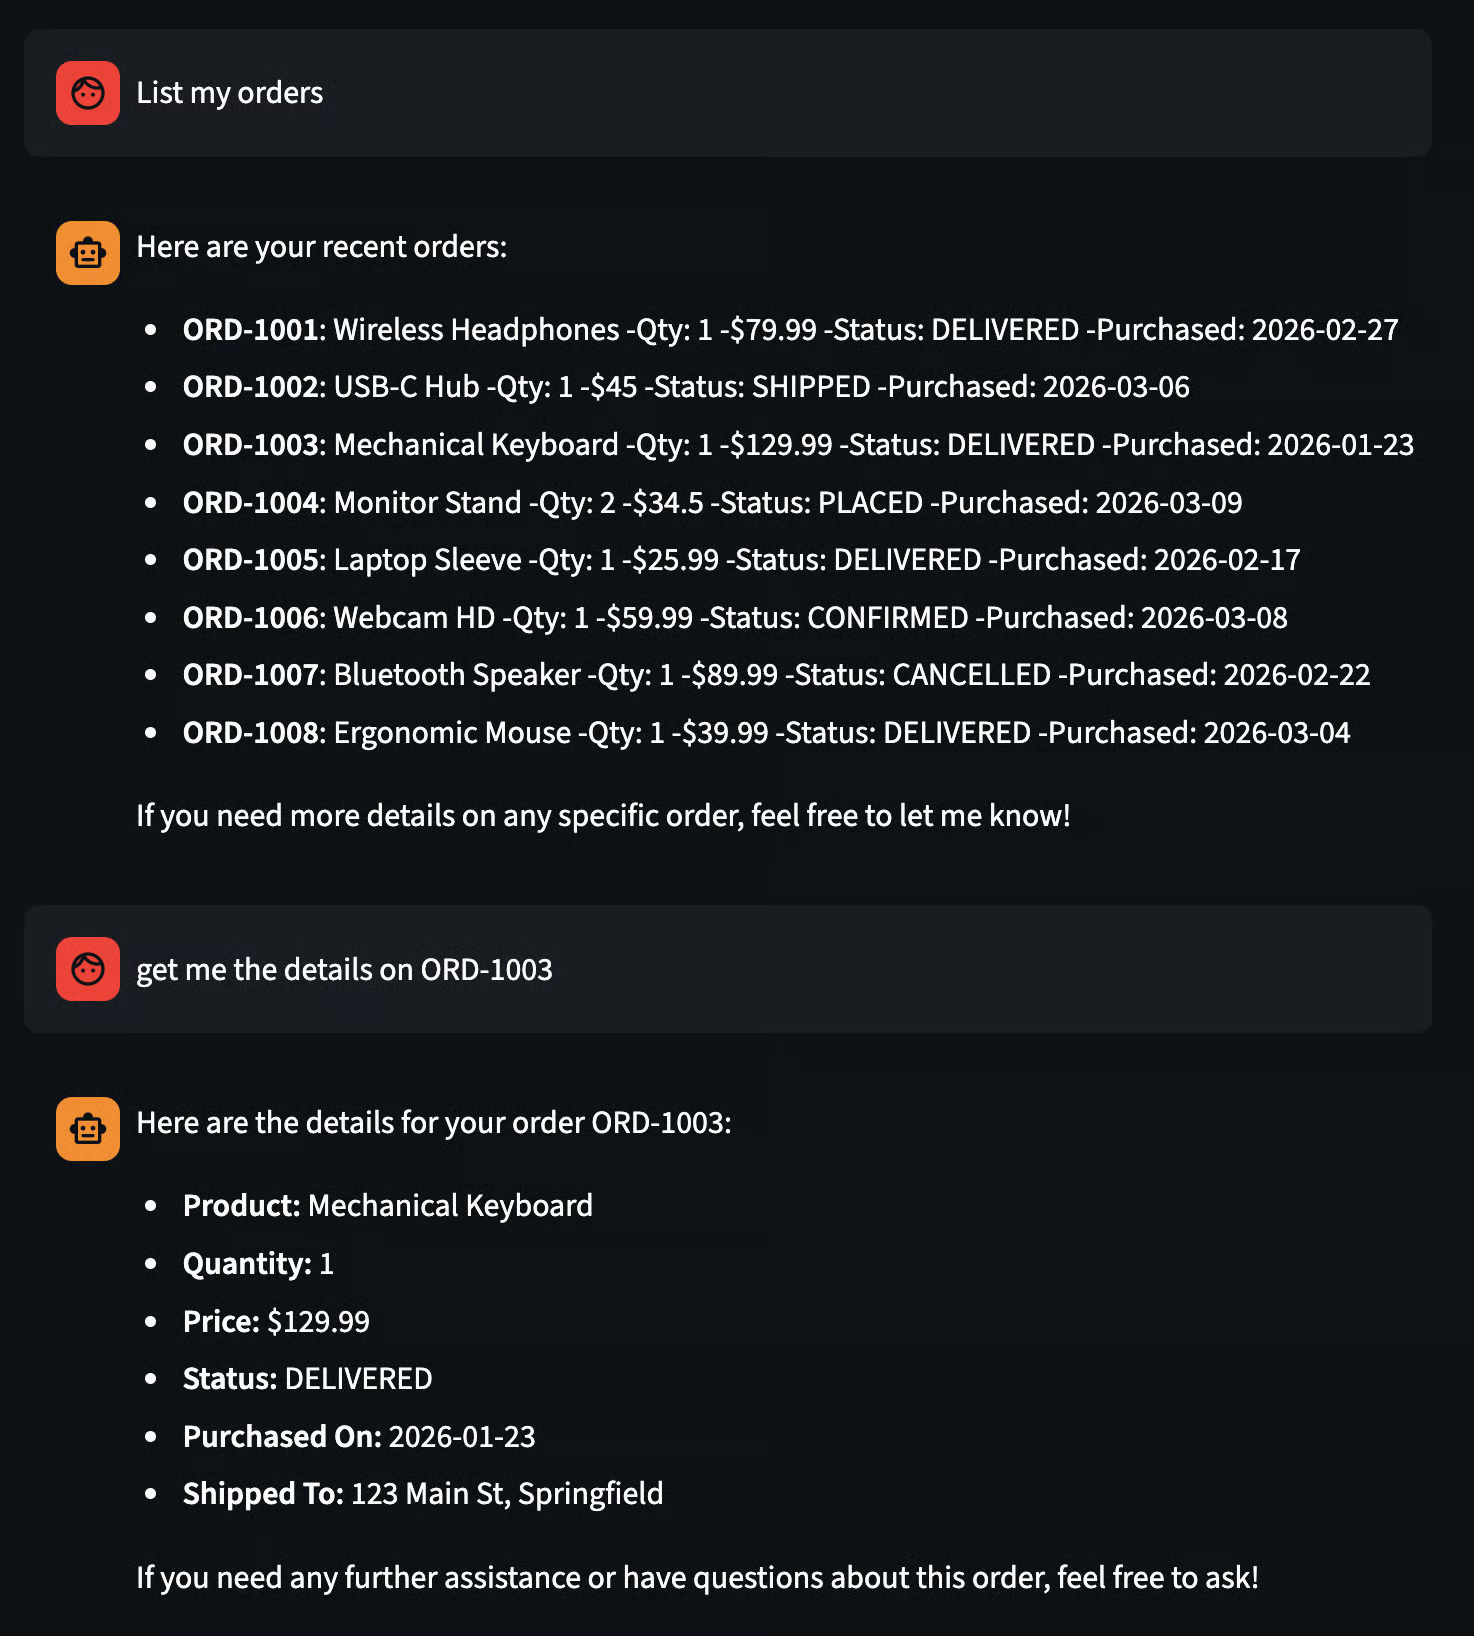
Abbildung 4. Prozedurales Gedächtnis in Aktion: Der Agent nutzt Toolaufrufe, um Live-Bestelldaten abzufragen und aufgabenspezifische Ergebnisse zurückzugeben.
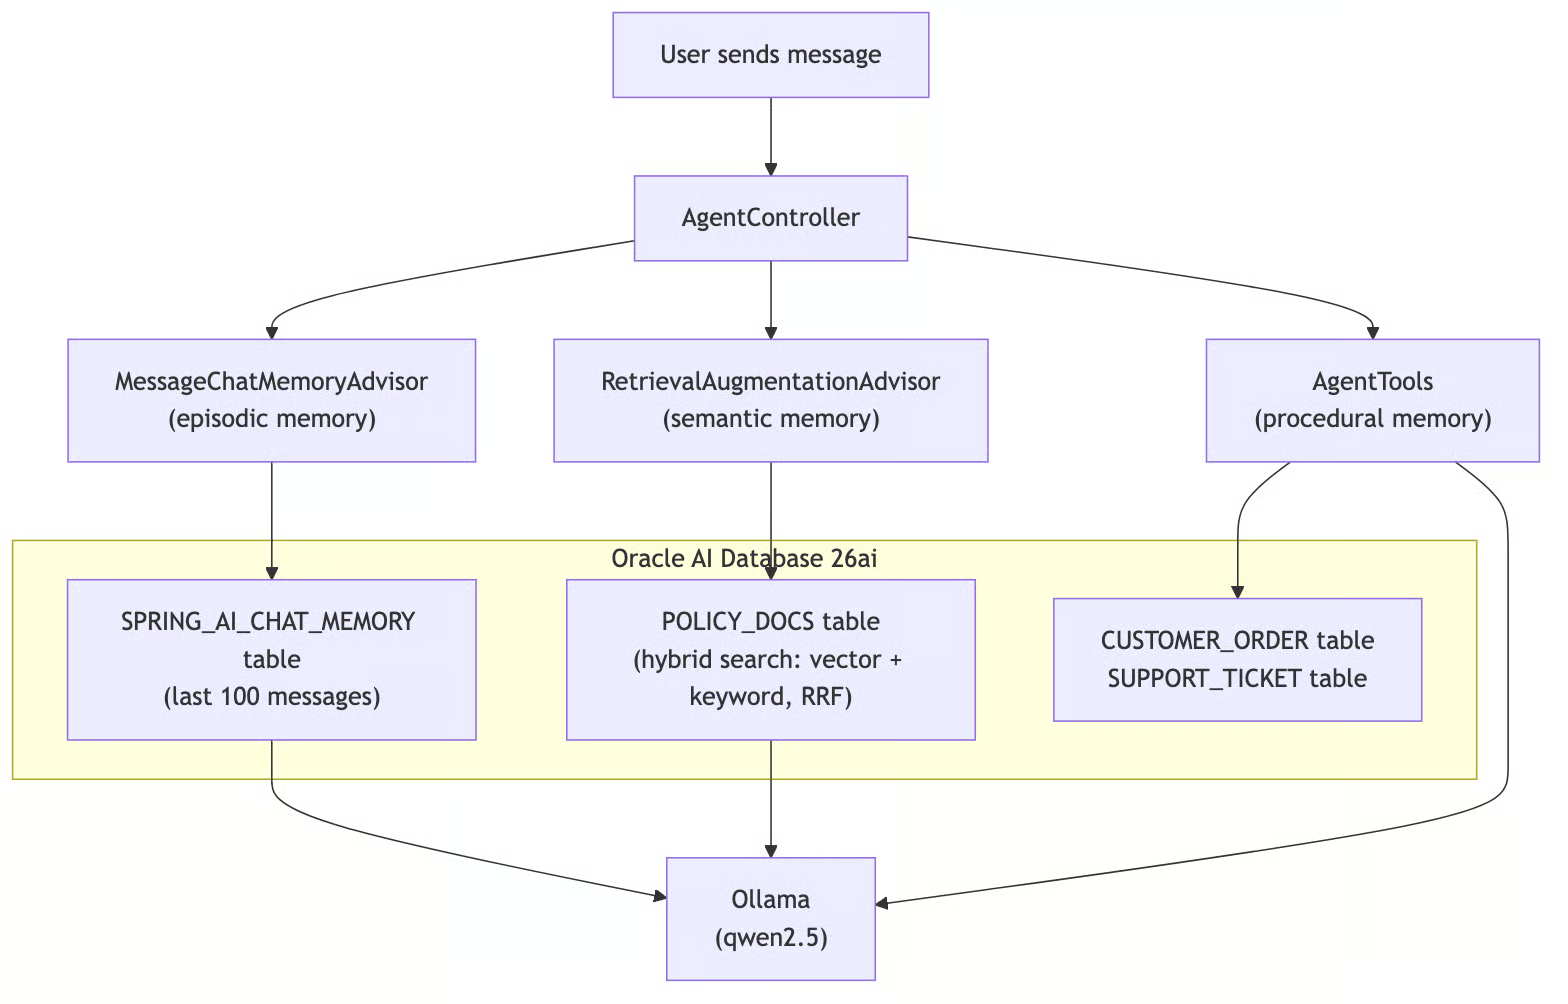
Abbildung 5. Request-Flow durch den AgentController: Episodisches, semantisches und prozedurales Gedächtnis werden aus Oracle AI Database-Tabellen kombiniert, bevor mit Ollama eine Antwort generiert wird.
Beide Tabellen leben in derselben Oracle-Datenbank. Kein Pinecone. Kein Redis. Keine zweite Datenbank. Ein Connection-Pool, ein Satz Zugangsdaten, eine Instanz zum Monitoren.
Prozedurales Gedächtnis wird als mit @Tool annotierte Methoden in einer Spring-Komponente umgesetzt, die echte Datenbanktabellen abfragt. Hier sind zwei repräsentative Methoden, der Übersicht halber vereinfacht; die vollständige Klasse enthält insgesamt sechs Tools (siehe AgentTools.java):
@Tool(description = "Look up the status of a customer order by its order ID. " +
        "Returns the current status including shipping information.")
public String lookupOrderStatus(
        @ToolParam(description = "The order ID to look up, e.g. ORD-1001") String orderId) {
    // Fetches order from DB via JPA, returns formatted status string
}

@Tool(description = "Initiate a product return for a given order. " +
        "Validates the order exists, checks that it is in DELIVERED status, " +
        "and verifies the return is within the 30-day return window.")
public String initiateReturn(
        @ToolParam(description = "The order ID to return") String orderId,
        @ToolParam(description = "The reason for the return") String reason) {
    // Validates order exists, checks DELIVERED status and 30-day window, updates status via JPA
}
Die @Tool-Beschreibung signalisiert dem LLM, wann welches Verfahren zu nutzen ist, und @ToolParam beschreibt die Parameter. Wenn der User sagt: „Ich möchte Bestellung ORD-1001 zurückgeben“, liest das LLM die Tool-Beschreibungen, entscheidet, dass initiateReturn die richtige Prozedur ist, extrahiert die Argumente aus dem Gespräch, ruft die Methode auf und verarbeitet das Ergebnis in der Antwort.
Die anderen vier Tools sind getCurrentDateTime (holt Datum/Uhrzeit aus der Datenbank), listOrders, escalateToSupport und listSupportTickets. Alle folgen demselben Muster: Datenbankabfragen via JPA oder JDBC. Das LLM entscheidet, wann es handelt; die Java-Methoden definieren das Wie.
Der Controller verdrahtet alles: zwei Advisors, sechs Tools, ein ChatClient. Hier ist der Kern, zur Übersicht vereinfacht (die vollständige Version ergänzt Eingabevalidierung, Fehlerbehandlung und Endpunkte für Gesprächsverwaltung. Siehe AgentController.java):
@RestController
@RequestMapping("/api/v1/agent")
public class AgentController {

    public AgentController(ChatClient.Builder builder,
                           JdbcChatMemoryRepository chatMemoryRepository,
                           JdbcTemplate jdbcTemplate,
                           AgentTools agentTools) {
        // Builds a ChatClient with:
        //   - MessageChatMemoryAdvisor (episodic: last 100 messages per conversation)
        //   - RetrievalAugmentationAdvisor + OracleHybridDocumentRetriever (semantic: hybrid search)
        //   - AgentTools via .defaultTools() (procedural: 6 @Tool methods)
        //   - System prompt defining the agent persona and tool usage rules
    }

    @PostMapping("/chat")
    public ResponseEntity<String> chat(
            @RequestBody String message,
            @RequestHeader("X-Conversation-Id") String conversationId) {
        // Sends message to ChatClient with conversation ID, returns LLM response
    }

    @PostMapping("/knowledge")
    public ResponseEntity<String> addKnowledge(@RequestBody String content) {
        // Inserts text into POLICY_DOCS table via JDBC (hybrid index handles embedding)
    }
}
Zwei Endpunkte, zwei Advisors, sechs Tools, ein ChatClient. Schauen wir uns die drei Gedächtnistypen an.
Das Advisor-Pattern von Spring AI ist der Dreh- und Angelpunkt. Advisors fangen jeden LLM-Call ab, können den Prompt vor dem Senden verändern und die Antwort nach der Rückkehr verarbeiten.
MessageChatMemoryAdvisor übernimmt das episodische Gedächtnis. Vor jedem LLM-Call lädt er die letzten 100 Nachrichten der aktuellen Unterhaltung aus der Tabelle SPRING_AI_CHAT_MEMORY und stellt sie dem Prompt voran. Nach der Antwort speichert er den neuen Austausch. Die Unterhaltung wird über den Header X-Conversation-Id identifiziert: andere ID, anderes Gedächtnis.
RetrievalAugmentationAdvisor kümmert sich um das semantische Gedächtnis. Vor jedem LLM-Call ruft ein benutzerdefinierter OracleHybridDocumentRetriever DBMS_HYBRID_VECTOR.SEARCH auf, das Vektorähnlichkeitssuche und Oracle Text-Keyword-Suche parallel ausführt und die Ergebnisse per Reciprocal Rank Fusion (RRF) fusioniert.
Die Top 5 Treffer werden über einen Custom-ContextualQueryAugmenter als Kontext in den Prompt injiziert. Die Dokumente gelten als ergänzend; das LLM soll sie nur für Policy-Fragen nutzen, nicht für Handlungsanfragen oder Gesprächskontext. So überschreibt der RAG-Kontext weder den Chatverlauf noch unterdrückt er Toolaufrufe.
Warum Hybrid statt reiner Vektorsuche? Dichte Embeddings erfassen Bedeutung: Eine Anfrage zur „Rückgaberichtlinie“ matcht Dokumente zu Rückerstattungen und Umtausch, auch wenn diese Worte nicht exakt vorkommen.
Bei exakten Begriffen sind sie jedoch schwach: Eine Suche nach „ORD-1001“ leidet, weil das Embedding-Modell Semantik statt Keywords kodiert. Hybridsuche deckt beides ab: Die Vektorseite übernimmt Bedeutung, die Keyword-Seite exakte Treffer, und RRF führt beide Ranglisten positionsbasiert zusammen, statt inkompatible Scores zu normalisieren.
AgentTools steuert das prozedurale Gedächtnis. Der Aufruf .defaultTools(agentTools) registriert alle sechs mit @Tool annotierten Methoden der Komponente. Bei jeder Anfrage erhält das LLM die Tool-Beschreibungen zusammen mit der User-Nachricht. Wenn Handeln statt Wissensabruf gefragt ist, ruft das LLM das passende Tool auf, erhält das Ergebnis und verwebt es in die Antwort. Spring AI übernimmt das Tool-Calling-Protokoll automatisch.
Alle drei Gedächtnistypen laufen bei jeder Anfrage. Der Agent merkt sich, was du gesagt hast, schlägt relevantes Wissen nach und weiß, wie er Aufgaben ausführt.
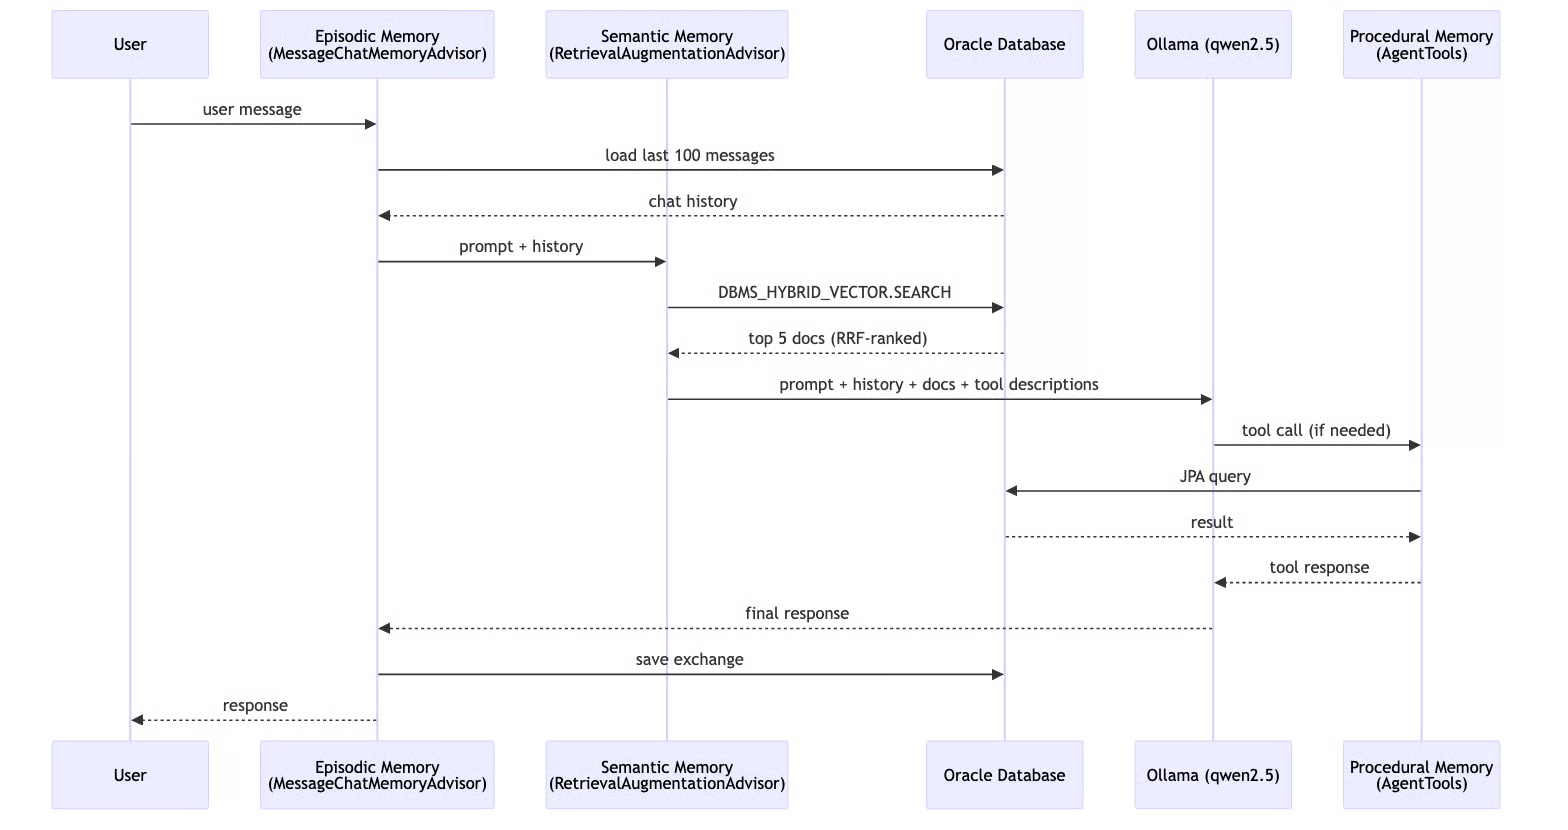
Abbildung 6. End-to-end-Sequenz, bei der Chatverlauf, hybrider RAG-Kontext und optionale Toolaufrufe kombiniert werden, um die finale Antwort zu erzeugen und zu persistieren.
Der Endpunkt /knowledge ist simpel: Per POST etwas Text senden, und er wird via JDBC in die Tabelle POLICY_DOCS eingefügt. Der hybride Vektorindex übernimmt das Embedding automatisch über das in-database ONNX model, ohne einen externen Embedding-API-Call. Beim nächsten passenden Thema findet die Hybridsuche das Dokument.
Ein DataSeeder (Spring-CommandLineRunner) befüllt die Datenbank beim Start mit 8 Demo-Bestellungen und 12 Richtlinien-Dokumenten (Rückgabe, Versand, Support, Garantie, Zahlung, Stornierung, Umtausch, internationaler Versand, Datenschutz, Aktionen, Produktgarantie und Großbestellungen). Die Richtlinien werden aus einer policies.json-Ressourcendatei geladen und via JDBC in POLICY_DOCS eingefügt. Bestellungen nutzen relative Daten, damit die 30-Tage-Retourenlogik in Demos immer greift. Der Seeder prüft vorhandene Counts, um Duplikate bei Neustarts zu vermeiden.
Die erste Version dieses POC nutzte den QuestionAnswerAdvisor von Spring AI mit OracleVectorStore: reine Vektorähnlichkeitssuche mit Cosinus-Schwelle. Das funktionierte bei sauber formulierten Fragen zu Richtlinien gut. Bei exakten Begriffen und Tippfehlern fiel es jedoch auseinander. Eine Anfrage „order ORD-1001“ versuchte semantisch gegen Richtliniendokumente zu matchen – das ergibt keinen Sinn. Ein vertipptes „retrun polcy“ verlor Ähnlichkeitsscore, weil das Embedding-Modell den Tippfehler nicht erkennt.
Oracle 26ai bietet DBMS_HYBRID_VECTOR.SEARCH, einen einzigen PL/SQL-Aufruf, der Vektorähnlichkeitssuche und Oracle-Text-Keyword-Suche parallel ausführt und die Ergebnisse fusioniert.
Der Schlüssel ist Reciprocal Rank Fusion (RRF): Statt Cosinus-Scores (0–1) gegen BM25-Keyword-Scores (unbegrenzt) zu normalisieren, werden Dokumente nach ihrer Position in jeder Ergebnisliste gerankt.
Ein Dokument, das bei Vektorergebnissen auf Platz 1 und bei Keywords auf Platz 3 liegt, erhält einen kombinierten Rang, der beide Signale widerspiegelt.
Das Setup ist ein einmaliges SQL-Skript, das ein ONNX-Embedding-Modell in die Oracle AI Database lädt und einen hybriden Index erstellt:
/SQL
-- Load the ONNX model for in-database embeddings
BEGIN
  DBMS_VECTOR.LOAD_ONNX_MODEL(
    directory  => 'DM_DUMP',
    file_name  => 'all_MiniLM_L12_v2.onnx',
    model_name => 'ALL_MINILM_L12_V2'
  );
END;
/

-- Create a hybrid index: vector similarity + Oracle Text keyword search
CREATE HYBRID VECTOR INDEX POLICY_HYBRID_IDX
ON POLICY_DOCS(content)
PARAMETERS('MODEL ALL_MINILM_L12_V2 VECTOR_IDXTYPE HNSW');
Sobald der Index existiert, werden Embeddings bei Inserts automatisch berechnet – keine externen Embedding-APIs nötig.
Spring AIs QuestionAnswerAdvisor kapselt nur VectorStore.similaritySearch(), also reine Vektorsuche. Für Hybridsuche bin ich auf den RetrievalAugmentationAdvisor umgestiegen – die modulare Alternative: Er akzeptiert einen Custom-DocumentRetriever und einen Custom-QueryAugmenter, um zu steuern, wie gefundene Dokumente in den Prompt gelangen.
Der benutzerdefinierte OracleHybridDocumentRetriever implementiert DocumentRetriever und ruft DBMS_HYBRID_VECTOR.SEARCH via JDBC auf. Dabei wird ein JSON-Parameter übergeben, der den hybriden Index, den Scorer (RRF) und ein Keyword-Match definiert:
public List<Document> retrieve(Query query) {
    // Builds a JSON spec with hybrid index name, RRF scorer, vector + text search clauses
    // Calls DBMS_HYBRID_VECTOR.SEARCH via JDBC, parses JSON results into List<Document>
}
Damit wird OracleVectorStore für Retrieval vollständig umgangen. Die Klausel text.contains nutzt einfaches Keyword-OR-Matching (Wörter länger als 2 Zeichen), wobei das integrierte Stemming von Oracle Text Varianten abdeckt.
Der Agent braucht präzises Retrieval, um gute Entscheidungen zu treffen. Liefert das semantische Gedächtnis falsche oder unsichere Richtlinien-Dokumente, kann das LLM Tool-Parameter halluzinieren oder einen nötigen Toolaufruf auslassen.
Hybridsuche bedeutet höherwertigen Kontext – und damit bessere autonome Entscheidungen. Der Agent zitiert Richtlinien seltener falsch und übersieht weniger relevante Dokumente, weil sowohl Bedeutung als auch exakte Begriffe gematcht werden.
Die Konfiguration steckt in einer einzigen application.yaml. Zentrale Entscheidungen: Hibernate erstellt die JPA-Tabellen automatisch (ddl-auto: update), Spring AI erstellt die Chat-Memory-Tabelle automatisch (initialize-schema: always), die Tabelle POLICY_DOCS und der hybride Vektorindex werden einmalig per SQL-Skript (setup-hybrid-search.sql) erstellt, und Oracle UCP teilt sich einen Connection-Pool über alle drei Gedächtnistypen.
Kein Flyway, keine eigenen @Configuration-Klassen. Die Auto-Konfiguration von Spring AI erkennt den Oracle-JDBC-Treiber und verdrahtet alles. Die vollständige application.yaml findest du im Repo.
Das Streamlit-Frontend sendet Nachrichten ans Backend und rendert die Antworten. Hier der Kern (die vollständige App enthält Quickstart-Buttons und eine Funktion für neue Unterhaltungen. Siehe app.py):
def send_message(prompt, url):
    # POSTs plain text to /api/v1/agent/chat with X-Conversation-Id header
    # Renders user message and assistant response in Streamlit chat UI

if prompt := st.chat_input("Type a message..."):
    send_message(prompt, backend_url)
Pro Session wird eine UUID als Conversation ID erzeugt, Plaintext ans Backend gesendet und die Antwort gerendert. Das war’s.
Kurzfassung: Einen Oracle-DB-Container starten, das ONNX-Modell laden und den hybriden Index anlegen (Einmal-Setup), Ollama installieren und das Chatmodell ziehen (qwen2.5), das Spring-Boot-Backend mit dem Profil local starten und optional das Streamlit-UI. Embeddings werden in der Datenbank durch das ONNX-Modell erzeugt – kein Embedding-Modell in Ollama nötig. Die vollständige Anleitung steht im Repo-README.
Schnelltest mit curl:
curl -X POST http://localhost:8080/api/v1/agent/chat \
  -H "Content-Type: text/plain" \
  -H "X-Conversation-Id: test-1" \
-d "What orders do I have?"Dieses Setup ist eine starke Standardwahl, um mit Spring AI und Oracle Database echte Agenten zu bauen, weil es alle Gedächtnisebenen in einem operativen Stack bündelt: episodischer Kontext, semantisches Retrieval und prozedurale Aktionen. Spring AI liefert saubere Abstraktionen (Advisors + @Tool), sodass das Agentenverhalten lesbar und testbar bleibt, während Oracle Transaktionsdaten und hybride Retrievals im selben System handhabt – mit Embeddings in der Datenbank und RRF-Ranking für bessere Präzision bei Bedeutung und exakten Begriffen.
Das Ergebnis ist praxisnah: weniger bewegliche Teile, weniger Integrationsfehler, niedrigere Latenz und einfacherer Betrieb. Statt getrennte Systeme für Chatverlauf, Vektorsuche, Keyword-Suche und Geschäftstabellen zu verknüpfen, baust du auf einer Plattform – und bekommst trotzdem hochwertiges Retrieval plus verlässliche Toolausführung. Für Teams, die Agenten-Features ausliefern, ist diese Kombination aus Einfachheit, Genauigkeit und operativer Kontrolle kaum zu schlagen.
Wenn du mehr über KI-Agenten und ihre Funktionsweise erfahren willst, schau dir den AI Agent Fundamentals Skill Track von DataCamp an.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs