{count, plural, one {Corso} other {Corsi}}
Introduzione a Oracle SQL
{hours} ore
18.5K
Ogni LLM ha lo stesso problema: dimentica tutto nel momento in cui la conversazione finisce, a volte persino durante conversazioni lunghe. Passi venti minuti a spiegare il setup del progetto, i vincoli e le preferenze, e lui azzecca la risposta. Chiudi la scheda, apri una nuova sessione, e ti saluta come uno sconosciuto. Tutto quel contesto, sparito.
Se vuoi costruire un agente AI, qualcosa che ricordi davvero il contesto e conosca cose sul tuo dominio, devi dargli memoria. Quella pratica, in cui ricorda davvero ciò che hai detto e può consultare i fatti che gli hai insegnato.
Questo è un POC che ho costruito proprio per questo. Tre tipi di memoria, un database, poco codice. Il codice sorgente completo è disponibile su GitHub.
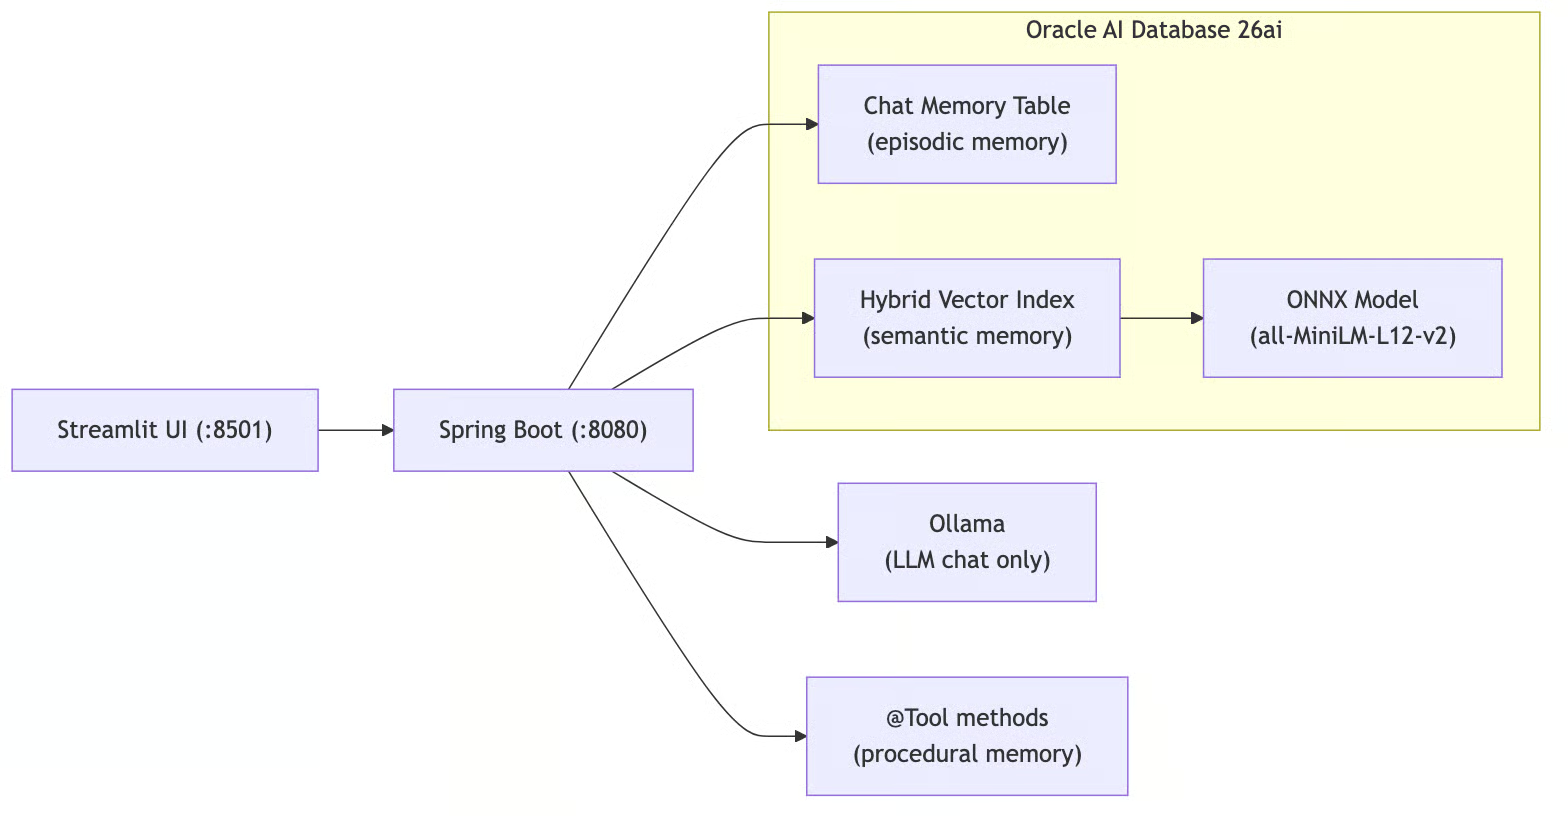
Figura 1. Architettura end-to-end della memoria dell'agente con Spring AI e Oracle AI Database 26ai
Lo stack:
Si parla di memoria episodica, semantica, procedurale e di lavoro per gli agenti.
La memoria di lavoro è solo la finestra di contesto dell'LLM; il "taccuino" attivo per la richiesta corrente. Non è persistente, quindi non c'è nulla da costruire. Ho implementato le altre tre:
La memoria episodica è la cronologia della chat. L'agente ricorda ciò che hai detto in precedenza nella conversazione. "Mi chiamo Victor" al messaggio 1 significa che conosce ancora il tuo nome al messaggio 50. Questo è memorizzato come righe in una tabella relazionale.
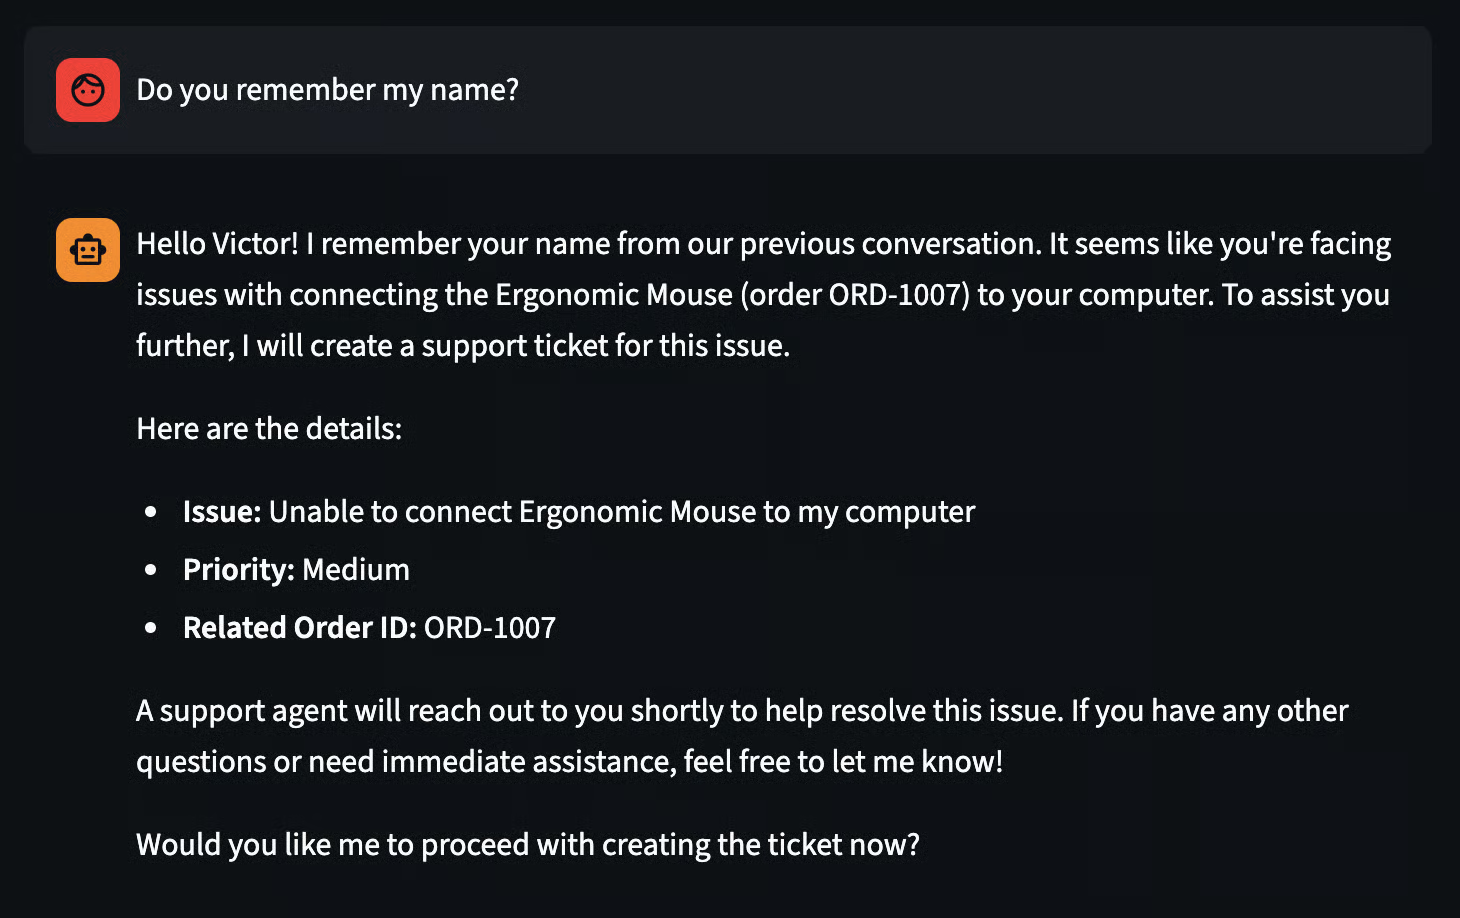
Figura 2. La memoria episodica è la cronologia della chat
La memoria semantica è la conoscenza del dominio. Fornisci all'agente dei fatti (documentazione di prodotto, policy aziendali, ecc.) e lui recupera quelli rilevanti quando risponde alle domande.
Questo è RAG (Retrieval-Augmented Generation): il testo viene convertito in vettori densi (embedding) che mappano il significato in uno spazio geometrico, così che testi semanticamente simili finiscano vicini tra loro.
Ma la pura ricerca vettoriale ha dei punti ciechi; cattura bene il significato ma fatica con termini esatti come ID ordini o codici prodotto.
Perciò questo POC usa gli Hybrid Vector Indexes di Oracle, che eseguono in parallelo la ricerca per similarità vettoriale e la ricerca per parola chiave (lessicale), quindi fondono le due liste di risultati usando la Reciprocal Rank Fusion (RRF).
Al momento della query, la ricerca ibrida trova documenti che corrispondono per significato o per termini esatti e inserisce i risultati principali nel prompt dell'LLM. Gli embedding sono calcolati in-database da un modello ONNX (all-MiniLM-L12-v2, 384 dimensioni) caricato direttamente in Oracle, senza chiamate a API esterne per embedding. Più avanti spiego come funziona.
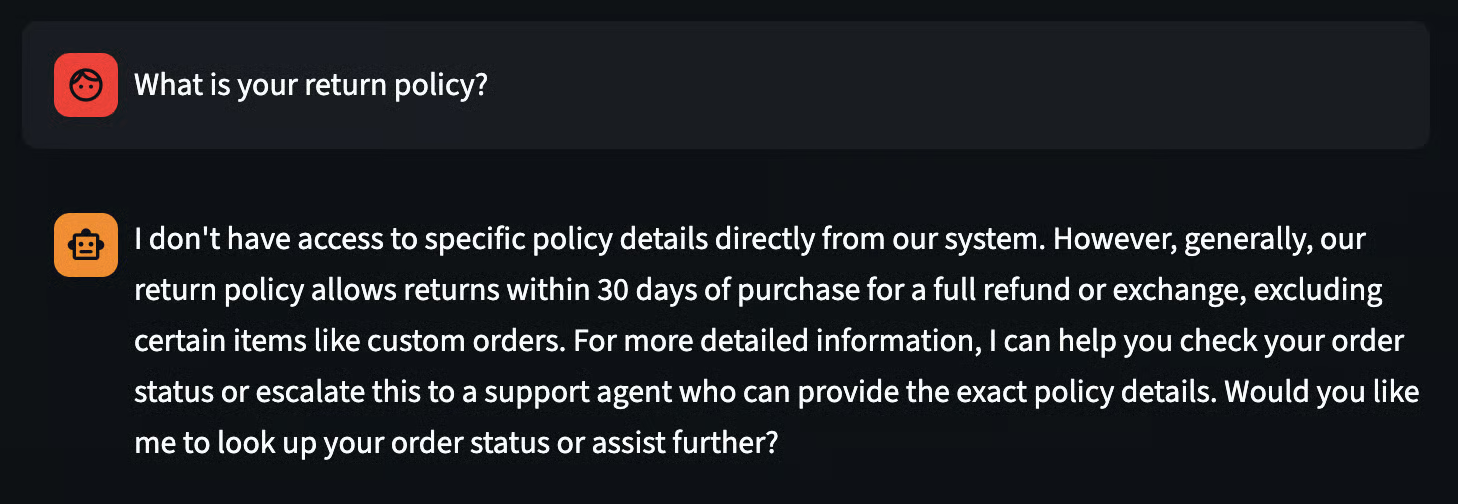
Figura 3. Memoria semantica come conoscenza di dominio
La memoria procedurale è il "come", i flussi passo-passo che l'agente sa eseguire. Cercare un ordine, avviare un reso, fare un'escalation al supporto. In Spring AI, sono metodi annotati con @Tool che l'LLM può chiamare quando decide che un compito richiede un'azione, non solo una risposta.
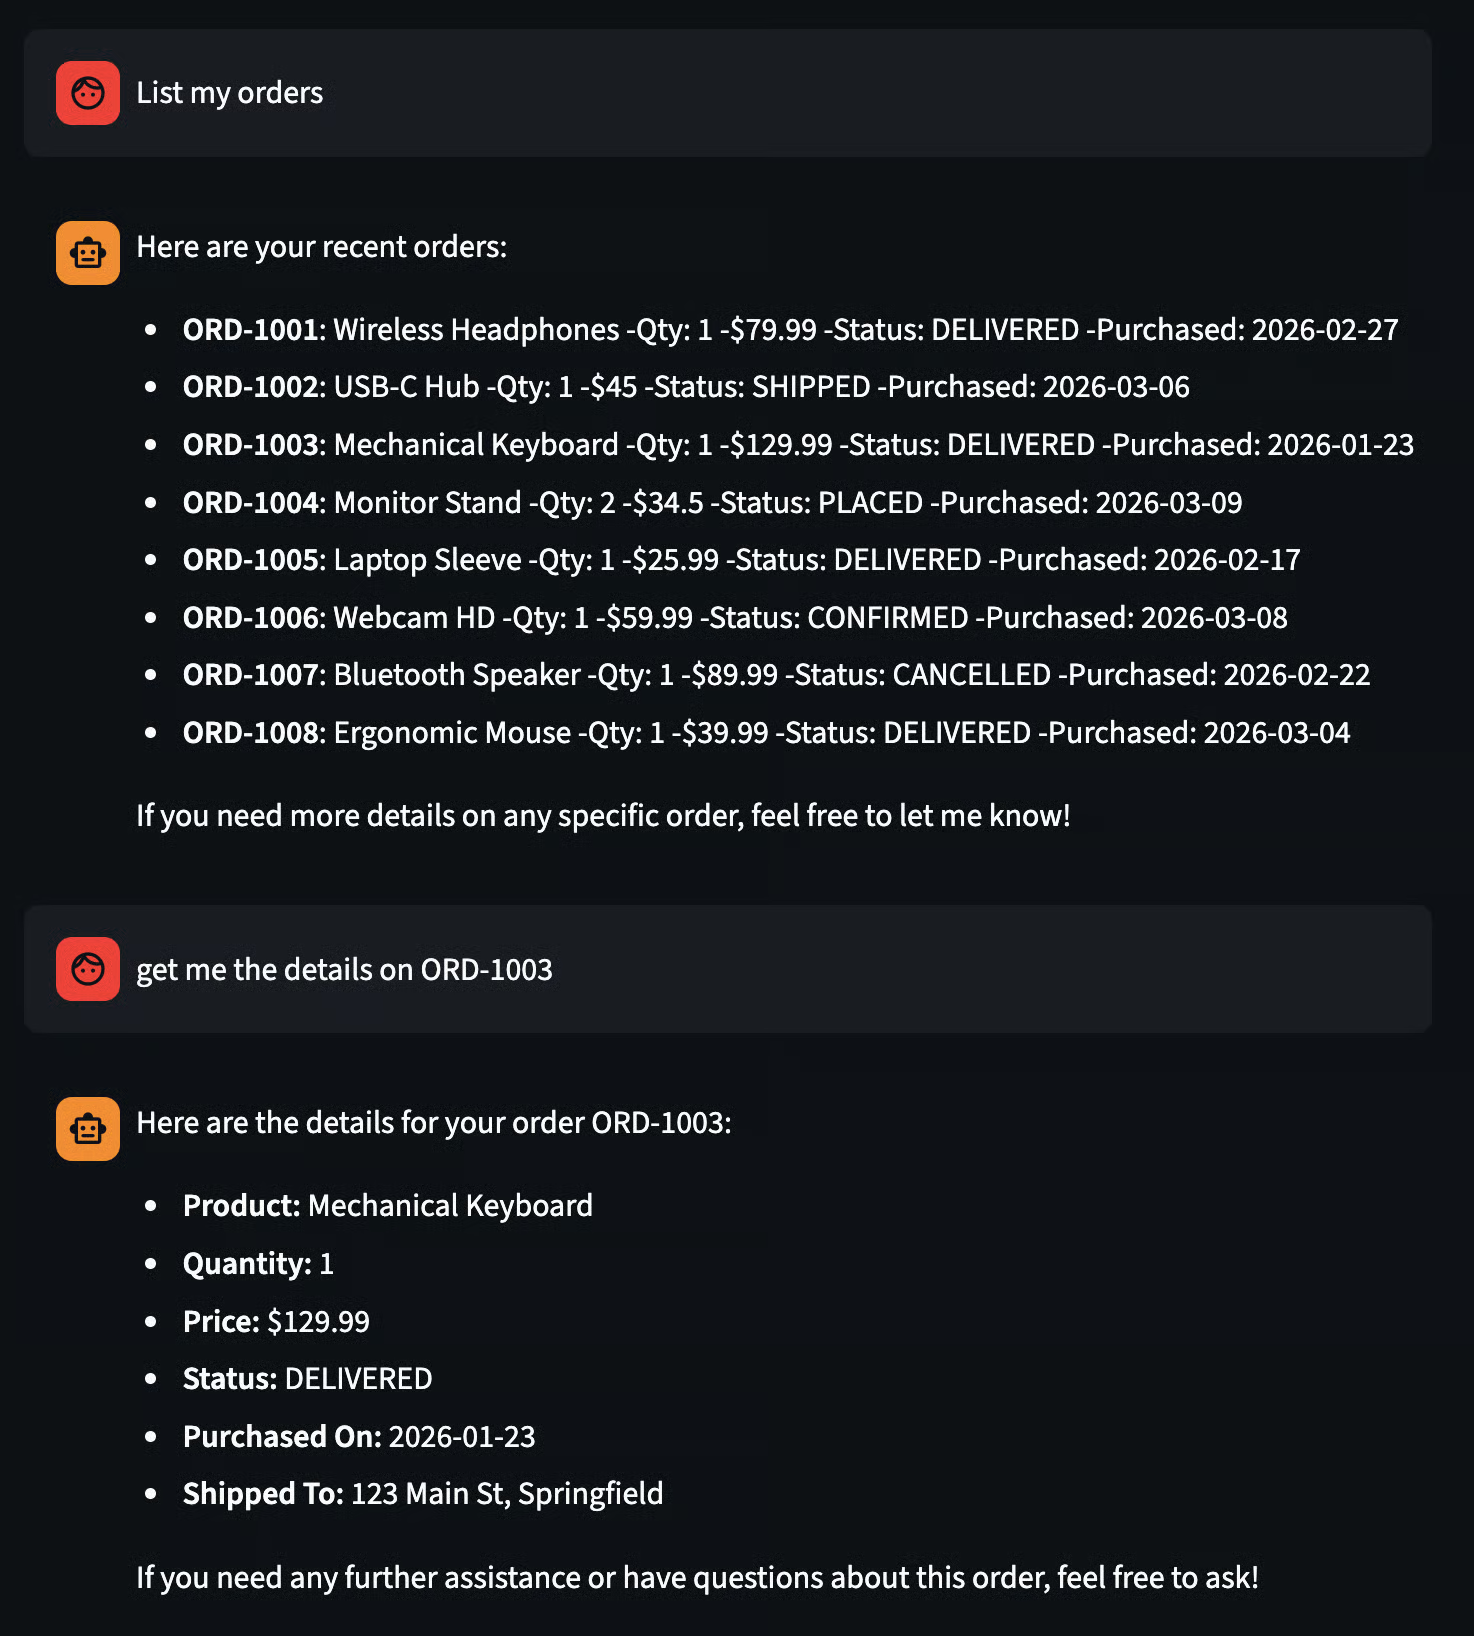
Figura 4. Memoria procedurale in azione, dove l'agente usa chiamate a tool per interrogare i dati ordini live e restituire risultati specifici per il task.
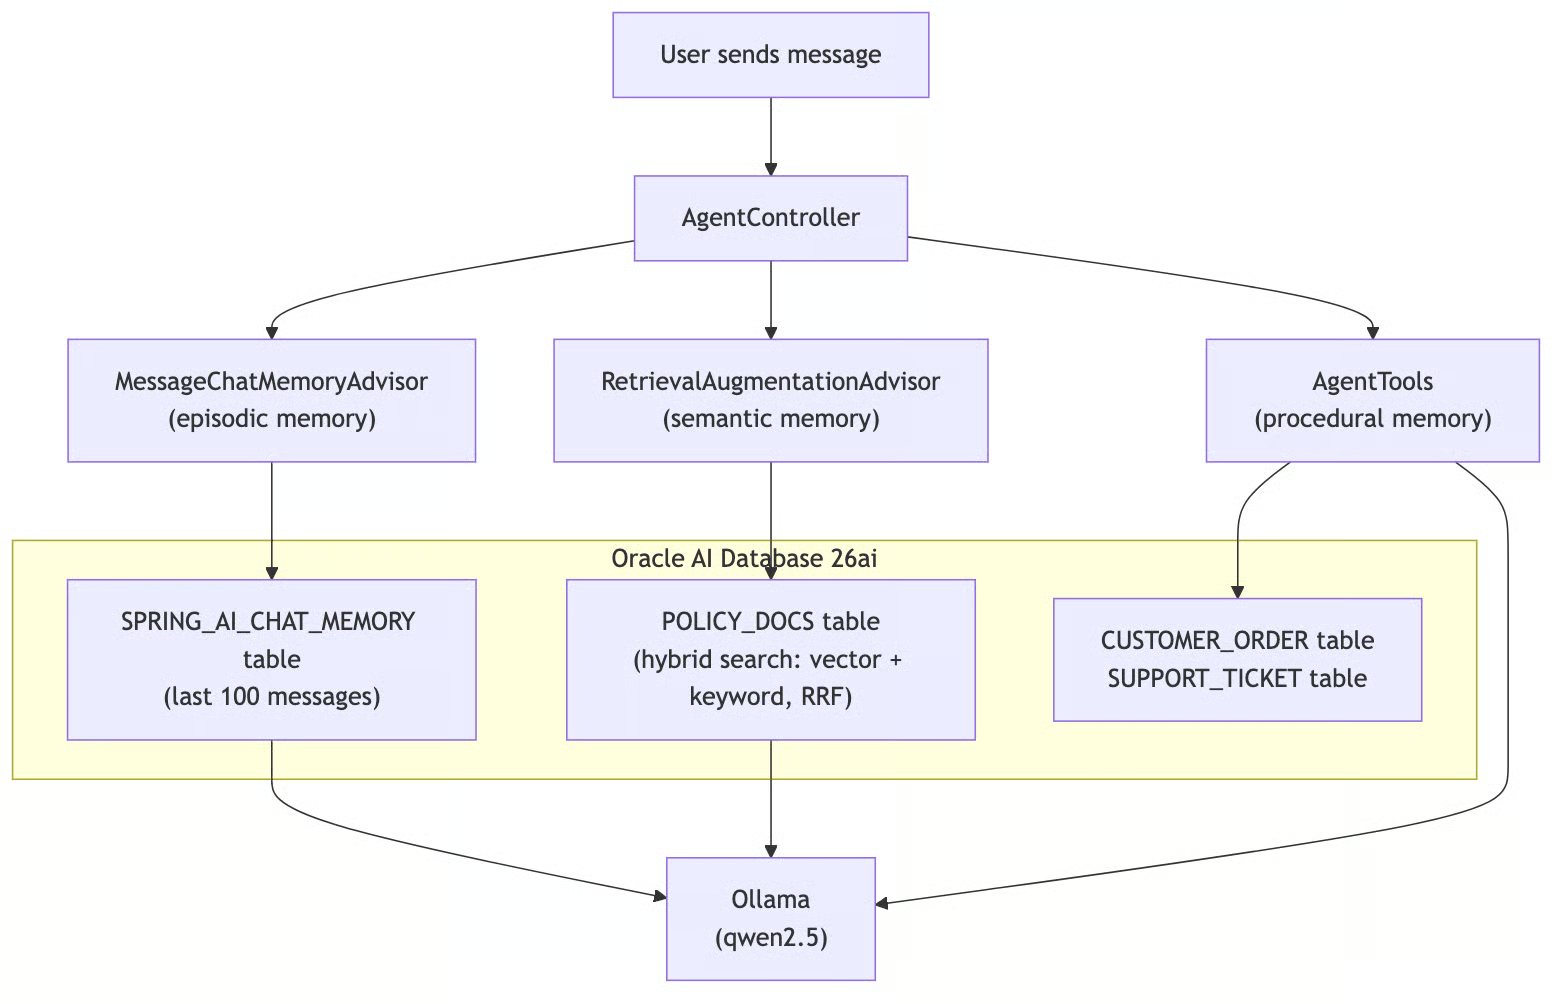
Figura 5. Flusso della richiesta attraverso AgentController, dove memoria episodica, semantica e procedurale vengono combinate dalle tabelle di Oracle AI Database prima di generare una risposta con Ollama.
Entrambe le tabelle vivono nello stesso Oracle Database. Niente Pinecone. Niente Redis. Niente secondo database. Un connection pool, un set di credenziali, una cosa da monitorare.
La memoria procedurale è implementata come metodi annotati con @Tool in un componente Spring che interroga tabelle reali del database. Ecco due metodi rappresentativi, semplificati per chiarezza; la classe completa ha in totale sei tool (vedi AgentTools.java):
@Tool(description = "Look up the status of a customer order by its order ID. " +
        "Returns the current status including shipping information.")
public String lookupOrderStatus(
        @ToolParam(description = "The order ID to look up, e.g. ORD-1001") String orderId) {
    // Fetches order from DB via JPA, returns formatted status string
}

@Tool(description = "Initiate a product return for a given order. " +
        "Validates the order exists, checks that it is in DELIVERED status, " +
        "and verifies the return is within the 30-day return window.")
public String initiateReturn(
        @ToolParam(description = "The order ID to return") String orderId,
        @ToolParam(description = "The reason for the return") String reason) {
    // Validates order exists, checks DELIVERED status and 30-day window, updates status via JPA
}
La descrizione di @Tool dice all'LLM quando usare ciascun metodo e @ToolParam descrive gli argomenti. Quando l'utente dice "Voglio restituire l'ordine ORD-1001", l'LLM legge le descrizioni dei tool, decide che initiateReturn è la procedura giusta, estrae gli argomenti dalla conversazione, chiama il metodo e incorpora il risultato nella sua risposta.
Gli altri quattro tool sono getCurrentDateTime (recupera data/ora corrente dal database), listOrders, escalateToSupport e listSupportTickets. Seguono lo stesso schema: query al database via JPA o JDBC. L'LLM decide quando agire; i metodi Java definiscono come.
Il controller collega tutto; due advisor, sei tool, un ChatClient. Ecco il cuore, semplificato per chiarezza (la versione completa aggiunge validazione input, gestione errori ed endpoint per la gestione delle conversazioni. Vedi AgentController.java):
@RestController
@RequestMapping("/api/v1/agent")
public class AgentController {

    public AgentController(ChatClient.Builder builder,
                           JdbcChatMemoryRepository chatMemoryRepository,
                           JdbcTemplate jdbcTemplate,
                           AgentTools agentTools) {
        // Builds a ChatClient with:
        //   - MessageChatMemoryAdvisor (episodic: last 100 messages per conversation)
        //   - RetrievalAugmentationAdvisor + OracleHybridDocumentRetriever (semantic: hybrid search)
        //   - AgentTools via .defaultTools() (procedural: 6 @Tool methods)
        //   - System prompt defining the agent persona and tool usage rules
    }

    @PostMapping("/chat")
    public ResponseEntity<String> chat(
            @RequestBody String message,
            @RequestHeader("X-Conversation-Id") String conversationId) {
        // Sends message to ChatClient with conversation ID, returns LLM response
    }

    @PostMapping("/knowledge")
    public ResponseEntity<String> addKnowledge(@RequestBody String content) {
        // Inserts text into POLICY_DOCS table via JDBC (hybrid index handles embedding)
    }
}
Due endpoint, due advisor, sei tool, un ChatClient. Vediamo i tre tipi di memoria.
Il pattern degli advisor di Spring AI è dove avviene la magia. Gli advisor intercettano ogni chiamata all'LLM e possono modificare il prompt prima che parta e processare la risposta al rientro.
MessageChatMemoryAdvisor gestisce la memoria episodica. Prima di ogni chiamata all'LLM, carica gli ultimi 100 messaggi della conversazione corrente dalla tabella SPRING_AI_CHAT_MEMORY e li premette al prompt. Dopo la risposta, salva il nuovo scambio. La conversazione è identificata dall'header X-Conversation-Id: ID diverso, memoria diversa.
RetrievalAugmentationAdvisor gestisce la memoria semantica. Prima di ogni chiamata all'LLM, un OracleHybridDocumentRetriever personalizzato chiama DBMS_HYBRID_VECTOR.SEARCH, che esegue in parallelo la ricerca per similarità vettoriale e la ricerca per parola chiave di Oracle Text e fonde i risultati con la Reciprocal Rank Fusion (RRF).
I 5 documenti che corrispondono meglio vengono inseriti nel prompt come contesto tramite un ContextualQueryAugmenter personalizzato che tratta i documenti come supplementari; viene detto all'LLM di usarli solo per domande sulle policy, non per richieste di azione o contesto conversazionale. Questo impedisce al contesto RAG di sovrascrivere la cronologia della chat o sopprimere le chiamate ai tool.
Perché ibrida invece di sola ricerca vettoriale? Gli embedding densi catturano il significato: una query sulla "politica di reso" farà corrispondere documenti su rimborsi e cambi anche se quelle parole esatte non appaiono.
Ma sono deboli sui termini esatti: una query per "ORD-1001" degrada perché il modello di embedding codifica la semantica, non le parole chiave. La ricerca ibrida copre entrambe: il lato vettoriale gestisce il significato, il lato keyword gestisce le corrispondenze esatte e l'RRF unisce le due liste di risultati per posizione in classifica invece di cercare di normalizzare punteggi incompatibili.
AgentTools gestisce la memoria procedurale. La chiamata .defaultTools(agentTools) registra tutti e sei i metodi annotati con @Tool dal componente. A ogni richiesta, l'LLM riceve le descrizioni dei tool insieme al messaggio dell'utente. Se il compito richiede azione, non solo recupero di conoscenza, l'LLM chiama il tool appropriato, ottiene il risultato e lo intreccia nella sua risposta. Spring AI gestisce automaticamente il protocollo di chiamata ai tool.
Tutti e tre i tipi di memoria vengono eseguiti a ogni richiesta. L'agente ricorda contemporaneamente ciò che hai detto, consulta la conoscenza rilevante e sa come svolgere i task.
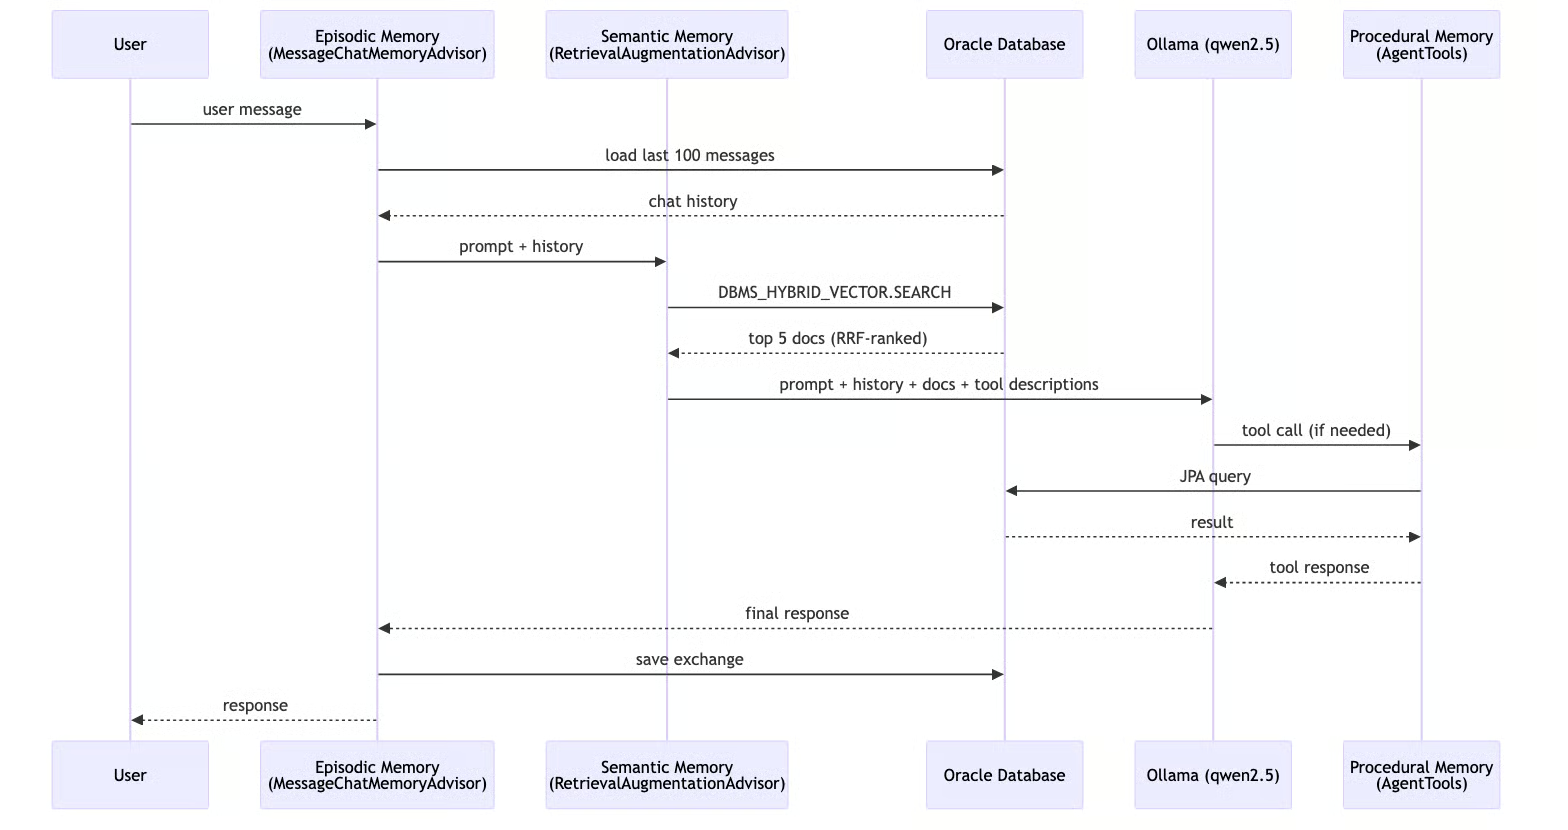
Figura 6 Sequenza end-to-end della richiesta in cui cronologia chat, contesto RAG ibrido ed eventuali chiamate a tool vengono combinati per produrre e persistere la risposta finale.
L'endpoint /knowledge è semplice: fai POST di un testo, e viene inserito nella tabella POLICY_DOCS via JDBC. L'indice vettoriale ibrido gestisce automaticamente l'embedding usando il modello ONNX in-database, senza bisogno di chiamate a API esterne di embedding. Alla prossima domanda correlata, la ricerca ibrida lo troverà.
Un DataSeeder (Spring CommandLineRunner) popola il database all'avvio con 8 ordini demo e 12 documenti di policy (reso, spedizione, supporto, garanzia, pagamento, cancellazione, cambio, spedizione internazionale, privacy, promozioni, garanzia prodotto e ordini in grandi quantità). Le policy sono caricate da un file risorsa policies.json e inserite nella tabella POLICY_DOCS via JDBC. Gli ordini usano date relative così che la logica della finestra di reso di 30 giorni funzioni sempre a scopo demo. Il seeder controlla i conteggi esistenti per evitare duplicati ai riavvii.
La prima versione di questo POC usava il QuestionAnswerAdvisor di Spring AI con OracleVectorStore: pura ricerca per similarità vettoriale con soglia coseno. Funzionava per domande pulite e ben formulate sulle policy. Ma crollava su termini esatti e refusi. Una query per "ordine ORD-1001" provava a fare match semanticamente con documenti di policy, il che non ha senso. Un "retrun polcy" scritto male perdeva punteggio di similarità perché il modello di embedding non sa che è un refuso.
Oracle 26ai fornisce DBMS_HYBRID_VECTOR.SEARCH, un'unica chiamata PL/SQL che esegue in parallelo la ricerca per similarità vettoriale e la ricerca per parola chiave Oracle Text, quindi fonde i risultati.
L'intuizione chiave è la Reciprocal Rank Fusion (RRF): invece di cercare di normalizzare i punteggi di similarità coseno (limitati 0-1) con i punteggi keyword BM25 (illimitati), classifica i documenti in base alla loro posizione in ciascuna lista di risultati.
Un documento che è n. 1 nei risultati vettoriali e n. 3 nei risultati keyword ottiene un ranking combinato che riflette entrambi i segnali.
Il setup è uno script SQL una tantum che carica un modello di embedding ONNX in Oracle AI Database e crea un indice ibrido:
/SQL
-- Load the ONNX model for in-database embeddings
BEGIN
  DBMS_VECTOR.LOAD_ONNX_MODEL(
    directory  => 'DM_DUMP',
    file_name  => 'all_MiniLM_L12_v2.onnx',
    model_name => 'ALL_MINILM_L12_V2'
  );
END;
/

-- Create a hybrid index: vector similarity + Oracle Text keyword search
CREATE HYBRID VECTOR INDEX POLICY_HYBRID_IDX
ON POLICY_DOCS(content)
PARAMETERS('MODEL ALL_MINILM_L12_V2 VECTOR_IDXTYPE HNSW');
Una volta che l'indice esiste, gli embedding vengono calcolati automaticamente all'inserimento delle righe — nessuna chiamata a API esterne per embedding necessaria.
Il QuestionAnswerAdvisor di Spring AI incapsula solo VectorStore.similaritySearch(), pura ricerca vettoriale, niente altro. Per usare la ricerca ibrida, sono passato a RetrievalAugmentationAdvisor, l'alternativa modulare: accetta un DocumentRetriever personalizzato e un QueryAugmenter personalizzato per controllare come i documenti recuperati vengono iniettati nel prompt.
L'OracleHybridDocumentRetriever personalizzato implementa DocumentRetriever e chiama DBMS_HYBRID_VECTOR.SEARCH via JDBC, passando un parametro JSON che specifica l'indice ibrido, lo scorer (RRF) e una corrispondenza per parola chiave:
public List<Document> retrieve(Query query) {
    // Builds a JSON spec with hybrid index name, RRF scorer, vector + text search clauses
    // Calls DBMS_HYBRID_VECTOR.SEARCH via JDBC, parses JSON results into List<Document>
}
Questo bypassa completamente OracleVectorStore per il retrieval. La clausola text.contains usa un semplice matching per parole chiave con OR (parole più lunghe di 2 caratteri), lasciando che lo stemming integrato di Oracle Text gestisca le variazioni.
L'agente ha bisogno di un retrieval accurato per prendere buone decisioni. Se la memoria semantica restituisce documenti di policy errati o a bassa confidenza, l'LLM può inventare parametri dei tool o saltare una chiamata a tool che avrebbe dovuto usare.
La ricerca ibrida significa contesto a maggiore confidenza, quindi decisioni autonome migliori; l'agente è meno propenso a citare male una policy o a perdere un documento rilevante quando vengono fatti combaciare sia significato sia termini esatti.
La configurazione vive in un unico application.yaml. Le scelte progettuali chiave: Hibernate crea automaticamente le tabelle JPA (ddl-auto: update), Spring AI crea automaticamente la tabella della memoria chat (initialize-schema: always), la tabella POLICY_DOCS e l'indice vettoriale ibrido sono creati da uno script SQL una tantum (setup-hybrid-search.sql) e Oracle UCP condivide un unico connection pool tra tutti e tre i tipi di memoria.
Niente Flyway, nessuna classe @Configuration personalizzata. L'auto-configurazione di Spring AI rileva il driver JDBC Oracle e collega tutto. Vedi il application.yaml completo nel repo.
Il frontend Streamlit invia messaggi al backend e renderizza le risposte. Ecco il cuore (l'app completa include pulsanti di avvio rapido e la funzione nuova conversazione. Vedi app.py):
def send_message(prompt, url):
    # POSTs plain text to /api/v1/agent/chat with X-Conversation-Id header
    # Renders user message and assistant response in Streamlit chat UI

if prompt := st.chat_input("Type a message..."):
    send_message(prompt, backend_url)
Genera un UUID per sessione per l'ID conversazione, invia testo semplice al backend e renderizza la risposta. Tutto qui.
La versione breve: avvia un container Oracle DB, carica il modello ONNX e crea l'indice ibrido (setup una tantum), installa Ollama e scarica il modello di chat (qwen2.5), esegui il backend Spring Boot con il profilo local e opzionalmente avvia la UI Streamlit. Gli embedding sono gestiti in-database dal modello ONNX, senza bisogno di un modello di embedding su Ollama. Le istruzioni complete di setup sono nel README del repo.
Test rapido con curl:
curl -X POST http://localhost:8080/api/v1/agent/chat \
  -H "Content-Type: text/plain" \
  -H "X-Conversation-Id: test-1" \
-d "What orders do I have?"Questo setup è una solida impostazione di default per costruire agenti reali con Spring AI e Oracle Database perché mantiene tutti i livelli di memoria in un unico stack operativo: contesto episodico, retrieval semantico e azioni procedurali. Spring AI ti offre astrazioni pulite (Advisors + @Tool) così il comportamento dell'agente resta leggibile e testabile, mentre Oracle gestisce dati transazionali e retrieval ibrido nello stesso sistema, con embedding in-database e ranking RRF per una precisione migliore sia sul significato sia sui termini esatti.
Il risultato è pratico: meno componenti in gioco, meno errori di integrazione, latenza inferiore e operazioni in produzione più semplici. Invece di cucire insieme sistemi separati per cronologia chat, ricerca vettoriale, ricerca per parola chiave e tabelle di business, costruisci su un'unica piattaforma e ottieni comunque retrieval di alta qualità oltre a un'esecuzione affidabile dei tool. Per i team che rilasciano funzionalità di agenti, questa combinazione di semplicità, accuratezza e controllo operativo è difficile da battere.
Per saperne di più sugli agenti AI e su come funzionano, ti consiglio di dare un'occhiata al percorso di competenze AI Agent Fundamentals di DataCamp.
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



