Cours
Introduction à Oracle SQL
4 h
18.4K
Tous les LLM ont le même problème : ils oublient tout dès que la conversation se termine, parfois même en plein échange prolongé. Passez vingt minutes à expliquer votre environnement, vos contraintes et vos préférences : il fournit une excellente réponse. Fermez l’onglet, ouvrez une nouvelle session : il vous salue comme un inconnu. Tout ce contexte s’est évaporé.
Si vous voulez construire un agent IA qui retient le contexte et connaît votre domaine, il faut lui donner de la mémoire. La mémoire concrète, celle qui se souvient de ce que vous avez dit et qui peut retrouver les informations que vous lui avez enseignées.
Voici un POC que j’ai conçu pour faire exactement cela. Trois types de mémoire, une seule base de données, peu de code. Le code source complet est disponible sur GitHub.
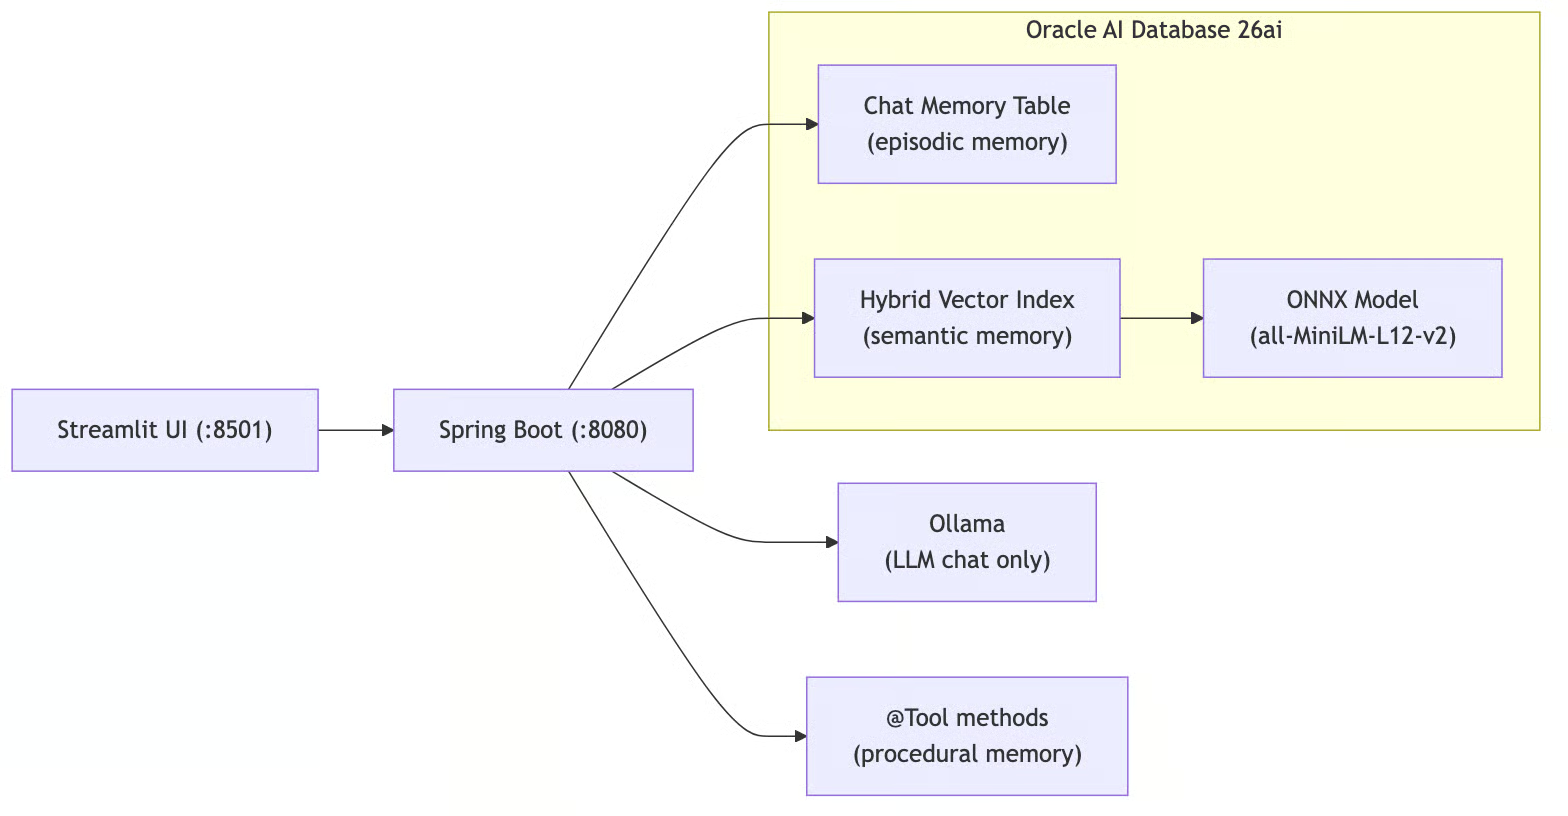
Figure 1. Architecture de bout en bout de la mémoire d’agent avec Spring AI et Oracle AI Database 26ai
La pile :
On parle de mémoire épisodique, sémantique, procédurale et de travail pour les agents.
La mémoire de travail est simplement la fenêtre de contexte du LLM : le « bloc-notes » actif de la requête en cours. Elle n’est pas persistée, donc rien à construire côté persistance. J’ai implémenté les trois autres :
La mémoire épisodique, c’est l’historique de conversation. L’agent se souvient de ce que vous avez dit plus tôt. « Je m’appelle Victor » au message 1 signifie qu’il connaît encore votre nom au message 50. C’est stocké sous forme de lignes dans une table relationnelle.
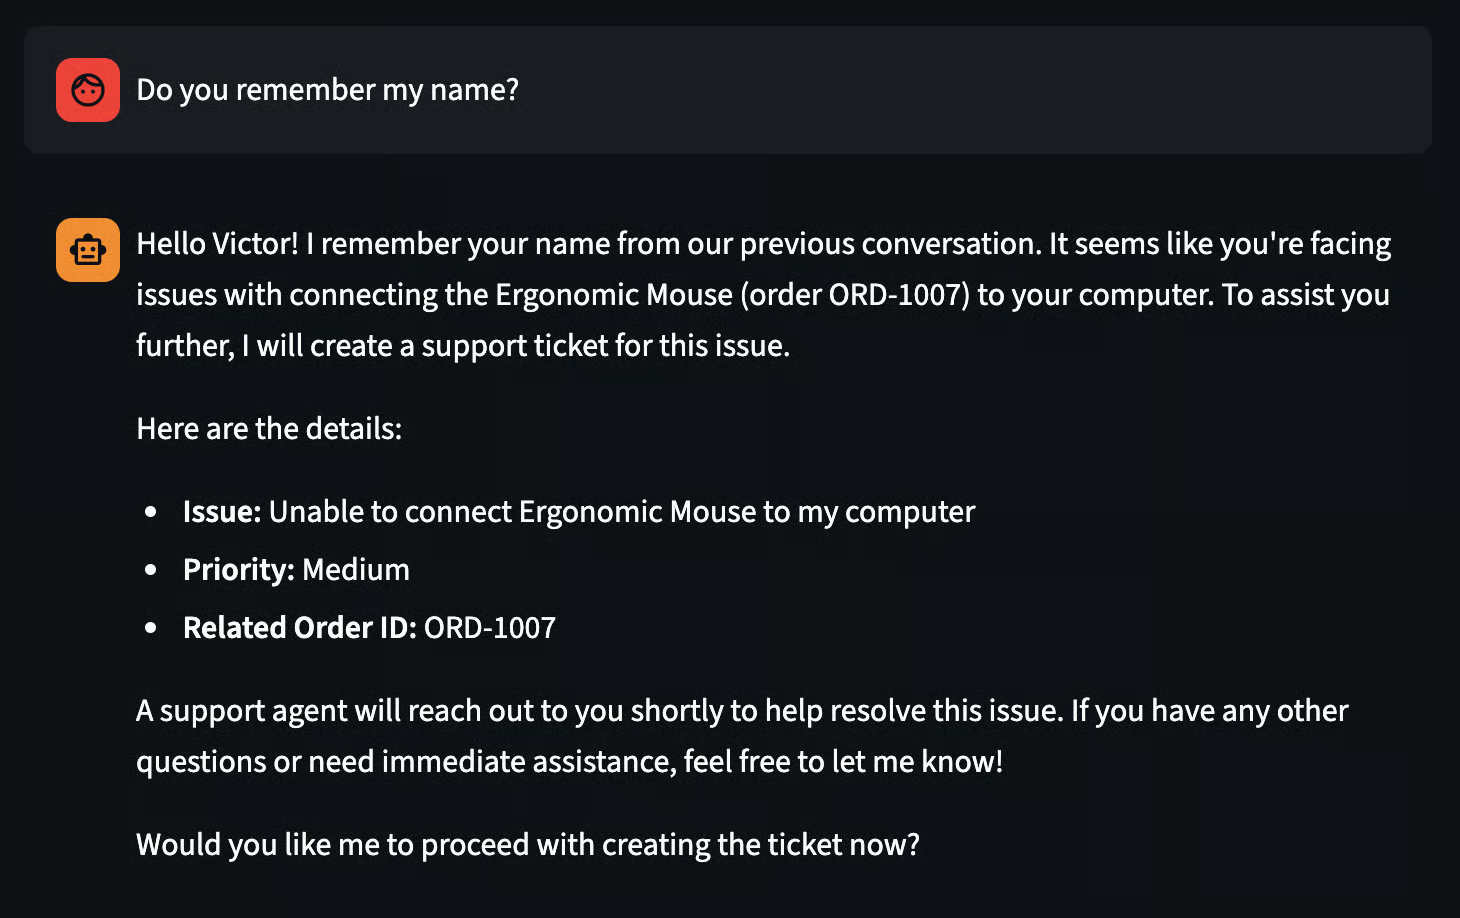
Figure 2. La mémoire épisodique correspond à l’historique de chat
La mémoire sémantique, c’est la connaissance du domaine. Vous fournissez à l’agent des faits (docs produit, politiques internes, etc.) et il retrouve les passages pertinents pour répondre aux questions.
C’est le RAG (Retrieval-Augmented Generation) : le texte est converti en vecteurs denses (embeddings) qui projettent le sens dans un espace géométrique, de sorte que des textes sémantiquement proches soient voisins.
Mais la recherche purement vectorielle a des angles morts : elle capture bien le sens, mais peine sur les termes exacts comme des IDs de commande ou des références produit.
Ce POC utilise donc les Hybrid Vector Indexes d’Oracle : la recherche par similarité vectorielle et la recherche lexicale (mots-clés) s’exécutent en parallèle, puis leurs résultats sont fusionnés via la Reciprocal Rank Fusion (RRF).
Au moment de la requête, la recherche hybride retrouve des documents soit par le sens, soit par correspondance exacte, puis injecte les meilleurs résultats dans l’invite du LLM. Les embeddings sont calculés en base par un modèle ONNX (all-MiniLM-L12-v2, 384 dimensions) chargé directement dans Oracle, sans appel à une API d’embeddings externe. Détails ci-dessous.
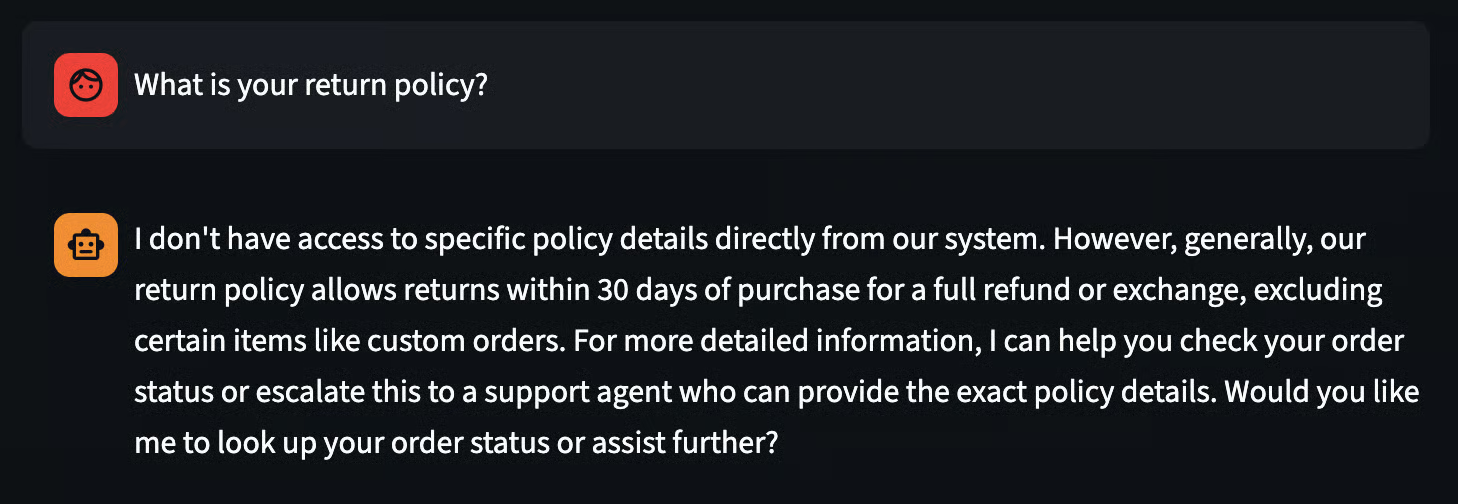
Figure 3. La mémoire sémantique comme connaissance du domaine
La mémoire procédurale correspond au « comment » : les enchaînements pas à pas que l’agent sait exécuter. Rechercher une commande, lancer un retour, escalader vers le support. Dans Spring AI, ce sont des méthodes annotées @Tool que le LLM peut appeler lorsqu’il décide qu’une action est nécessaire, au-delà d’une simple réponse.
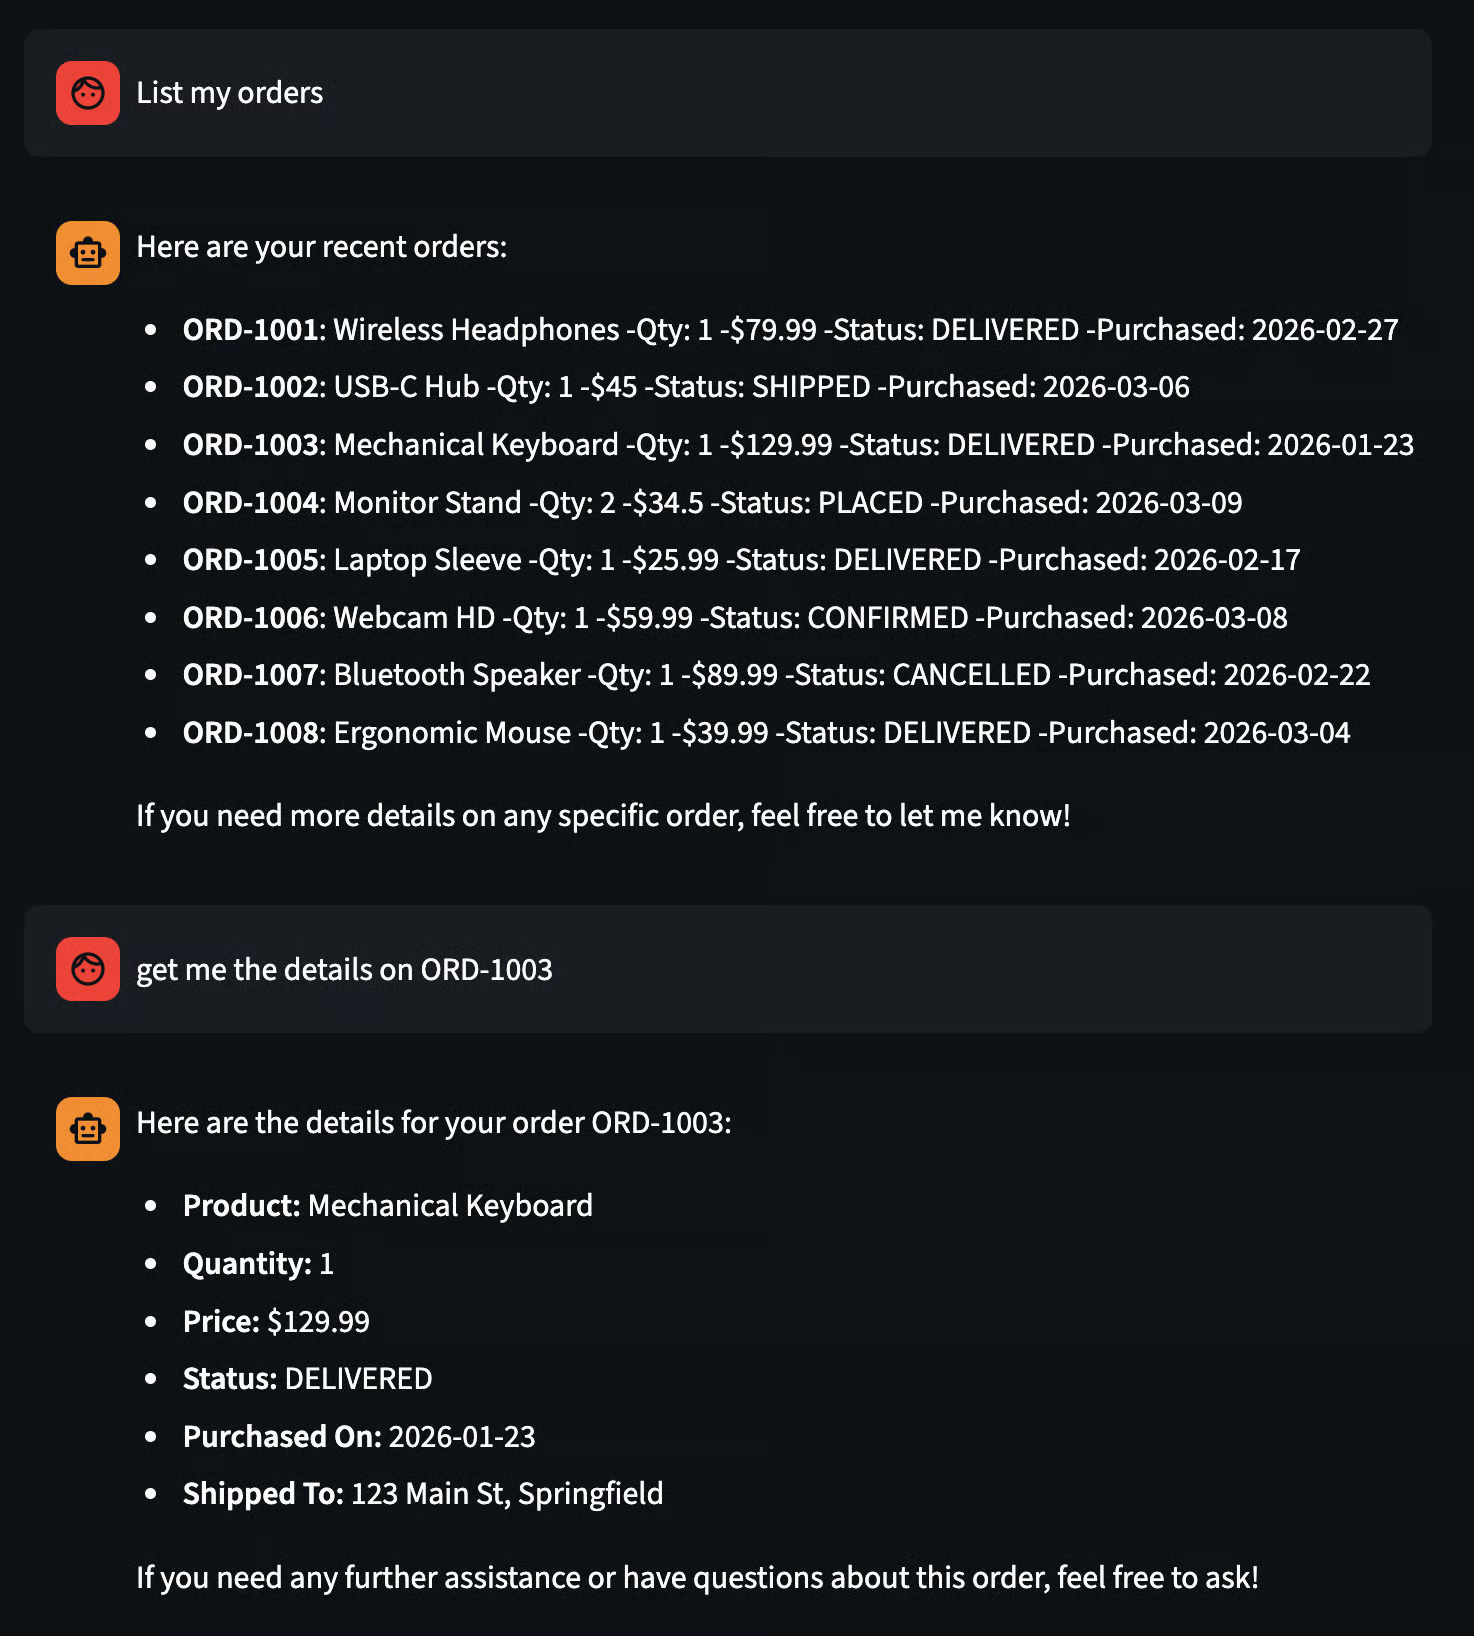
Figure 4. Mémoire procédurale en action : l’agent utilise des appels d’outils pour interroger des données de commande en temps réel et renvoyer des résultats adaptés à la tâche.
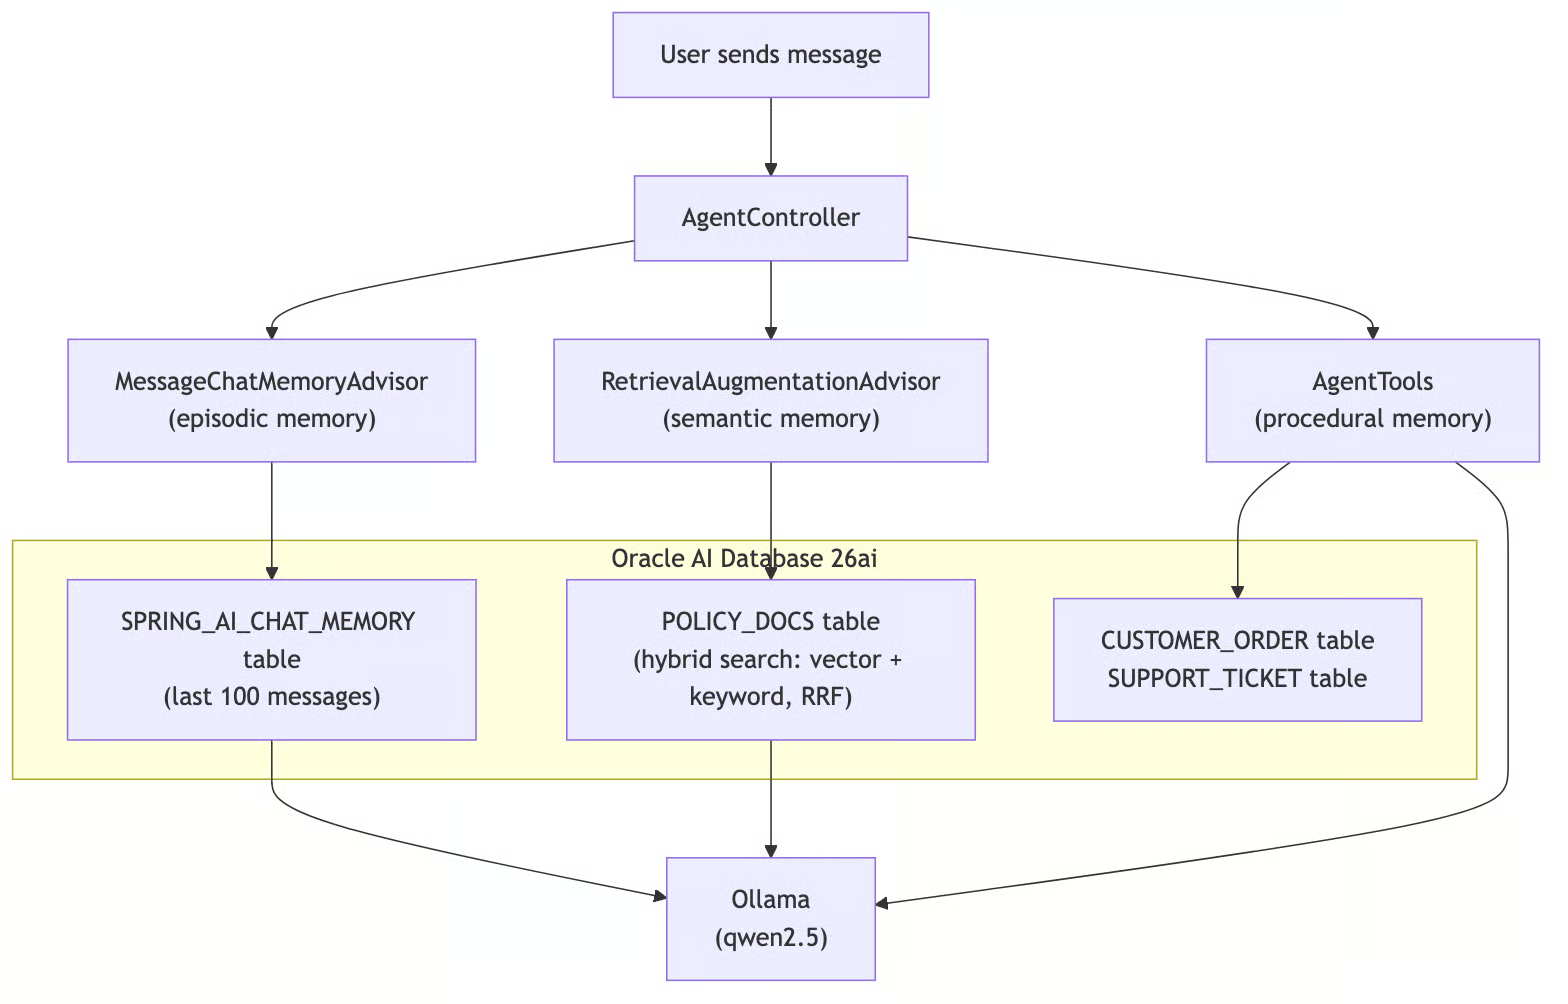
Figure 5. Flux de requête via AgentController, où les mémoires épisodique, sémantique et procédurale sont combinées depuis les tables Oracle AI Database avant de générer une réponse avec Ollama.
Les deux tables cohabitent dans la même base Oracle. Pas de Pinecone. Pas de Redis. Pas de deuxième base. Un seul pool de connexions, un seul jeu d’identifiants, un seul point à surveiller.
La mémoire procédurale est implémentée sous forme de méthodes annotées @Tool dans un composant Spring qui interroge de vraies tables. Voici deux méthodes représentatives, simplifiées pour la lisibilité ; la classe complète contient six outils au total (voir AgentTools.java) :
@Tool(description = "Look up the status of a customer order by its order ID. " +
        "Returns the current status including shipping information.")
public String lookupOrderStatus(
        @ToolParam(description = "The order ID to look up, e.g. ORD-1001") String orderId) {
    // Fetches order from DB via JPA, returns formatted status string
}

@Tool(description = "Initiate a product return for a given order. " +
        "Validates the order exists, checks that it is in DELIVERED status, " +
        "and verifies the return is within the 30-day return window.")
public String initiateReturn(
        @ToolParam(description = "The order ID to return") String orderId,
        @ToolParam(description = "The reason for the return") String reason) {
    // Validates order exists, checks DELIVERED status and 30-day window, updates status via JPA
}
La description @Tool indique au LLM quand utiliser chaque méthode, et @ToolParam décrit les paramètres. Quand l’utilisateur dit « Je veux retourner la commande ORD-1001 », le LLM lit les descriptions d’outils, décide que initiateReturn est la bonne procédure, extrait les arguments de la conversation, appelle la méthode et intègre le résultat dans sa réponse.
Les quatre autres outils sont getCurrentDateTime (récupère la date/heure courante depuis la base), listOrders, escalateToSupport et listSupportTickets. Même schéma : requêtes base via JPA ou JDBC. Le LLM décide quand agir ; les méthodes Java définissent comment.
Le contrôleur orchestre l’ensemble : deux advisors, six outils, un ChatClient. Voici le cœur, simplifié pour la clarté (la version complète ajoute validation d’entrée, gestion d’erreurs et endpoints de gestion de conversation. Voir AgentController.java) :
@RestController
@RequestMapping("/api/v1/agent")
public class AgentController {

    public AgentController(ChatClient.Builder builder,
                           JdbcChatMemoryRepository chatMemoryRepository,
                           JdbcTemplate jdbcTemplate,
                           AgentTools agentTools) {
        // Builds a ChatClient with:
        //   - MessageChatMemoryAdvisor (episodic: last 100 messages per conversation)
        //   - RetrievalAugmentationAdvisor + OracleHybridDocumentRetriever (semantic: hybrid search)
        //   - AgentTools via .defaultTools() (procedural: 6 @Tool methods)
        //   - System prompt defining the agent persona and tool usage rules
    }

    @PostMapping("/chat")
    public ResponseEntity<String> chat(
            @RequestBody String message,
            @RequestHeader("X-Conversation-Id") String conversationId) {
        // Sends message to ChatClient with conversation ID, returns LLM response
    }

    @PostMapping("/knowledge")
    public ResponseEntity<String> addKnowledge(@RequestBody String content) {
        // Inserts text into POLICY_DOCS table via JDBC (hybrid index handles embedding)
    }
}
Deux endpoints, deux advisors, six outils, un ChatClient. Détaillons les trois types de mémoire.
Le pattern d’advisors de Spring AI est le point névralgique. Les advisors interceptent chaque appel au LLM, peuvent modifier l’invite avant envoi et traiter la réponse au retour.
MessageChatMemoryAdvisor gère la mémoire épisodique. Avant chaque appel, il charge les 100 derniers messages de la conversation courante depuis la table SPRING_AI_CHAT_MEMORY et les préfixe à l’invite. Après la réponse, il enregistre l’échange. La conversation est identifiée par l’en-tête X-Conversation-Id : ID différent, mémoire différente.
RetrievalAugmentationAdvisor gère la mémoire sémantique. Avant chaque appel LLM, un OracleHybridDocumentRetriever personnalisé appelle DBMS_HYBRID_VECTOR.SEARCH : recherche vectorielle et Oracle Text en parallèle, puis fusion par RRF.
Les 5 meilleurs documents sont injectés dans l’invite comme contexte via un ContextualQueryAugmenter personnalisé qui les traite comme supplémentaires : le LLM ne doit les utiliser que pour les questions de politique, pas pour les demandes d’action ni le contexte conversationnel. Cela évite que le RAG écrase l’historique ou empêche les appels d’outils.
Pourquoi l’hybride plutôt que le tout vectoriel ? Les embeddings denses capturent le sens : une requête « return policy » fera correspondre des documents sur les remboursements et échanges même sans ces mots exacts.
Mais ils sont faibles sur les termes exacts : une requête « ORD-1001 » se dégrade car le modèle code le sens, pas les mots-clés. La recherche hybride couvre les deux : la partie vecteur gère le sens, la partie mots-clés gère les correspondances exactes, et la RRF fusionne les deux listes par position plutôt que de normaliser des scores incompatibles.
AgentTools gère la mémoire procédurale. L’appel .defaultTools(agentTools) enregistre les six méthodes annotées @Tool du composant. À chaque requête, le LLM reçoit les descriptions d’outils avec le message utilisateur. Si la tâche exige une action, le LLM appelle l’outil adéquat, récupère le résultat et l’intègre à sa réponse. Spring AI gère automatiquement le protocole d’appel d’outils.
Les trois types de mémoire s’exécutent à chaque requête. L’agent se souvient de ce que vous avez dit, consulte les connaissances pertinentes et sait réaliser des tâches.
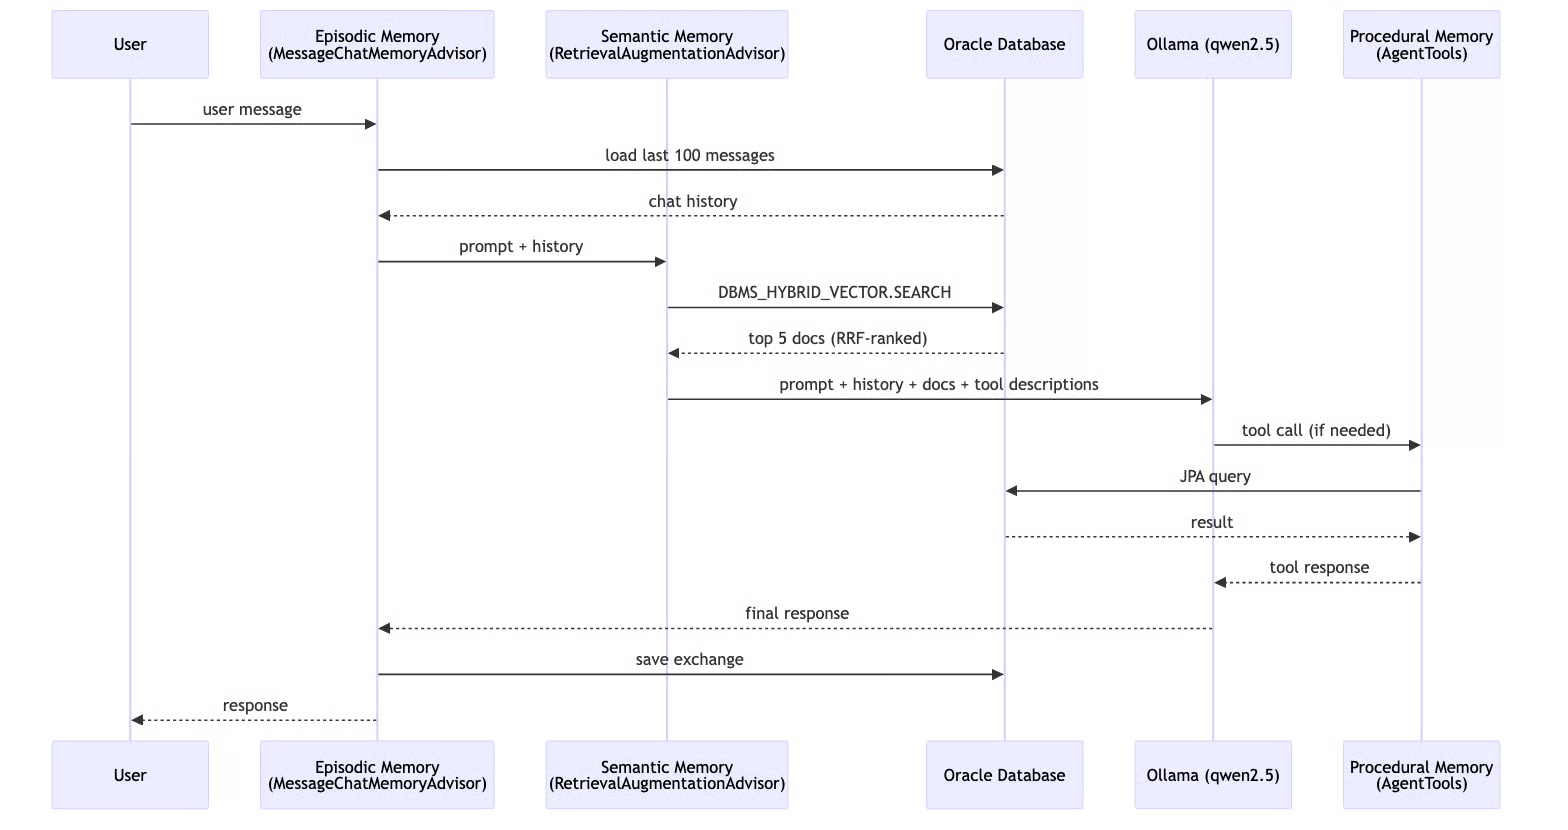
Figure 6 Séquence de bout en bout où l’historique, le contexte RAG hybride et les appels d’outils éventuels sont combinés pour produire et persister la réponse finale.
L’endpoint /knowledge est simple : envoyez du texte en POST, il est inséré dans la table POLICY_DOCS via JDBC. L’index vectoriel hybride gère automatiquement la génération d’embeddings à l’aide du modèle ONNX en base, sans appel à une API externe. La prochaine fois qu’une question reliée survient, la recherche hybride le retrouvera.
Un DataSeeder (Spring CommandLineRunner) peuple la base au démarrage avec 8 commandes de démo et 12 documents de politique (retour, livraison, support, garantie, paiement, annulation, échange, livraison internationale, confidentialité, promotions, garantie produit, commandes en gros). Les politiques sont chargées depuis une ressource policies.json et insérées dans POLICY_DOCS via JDBC. Les commandes utilisent des dates relatives pour que la fenêtre de retour de 30 jours fonctionne toujours en démo. Le seeder vérifie les comptes existants pour éviter les doublons au redémarrage.
La première version de ce POC utilisait le QuestionAnswerAdvisor de Spring AI avec OracleVectorStore : recherche par similarité vectorielle pure avec seuil cosinus. Efficace pour des questions propres et bien formulées sur les politiques. Mais ça se dégradait sur les termes exacts et les fautes de frappe. Une requête « order ORD-1001 » tentait une correspondance sémantique avec des documents de politiques, ce qui n’a pas de sens. Un « retrun polcy » mal orthographié perdait du score car le modèle d’embedding ne sait pas que c’est une faute.
Oracle 26ai fournit DBMS_HYBRID_VECTOR.SEARCH : un appel PL/SQL unique qui lance en parallèle la similarité vectorielle et la recherche Oracle Text, puis fusionne les résultats.
L’idée clé, c’est la Reciprocal Rank Fusion (RRF) : au lieu d’essayer de normaliser des scores cosinus (bornés 0–1) avec des scores BM25 (non bornés), on classe les documents par position dans chaque liste de résultats.
Un document classé n°1 côté vecteur et n°3 côté mots-clés obtient un rang combiné qui reflète les deux signaux.
La mise en place tient dans un script SQL à exécution unique qui charge un modèle d’embeddings ONNX dans Oracle AI Database et crée un index hybride :
/SQL
-- Load the ONNX model for in-database embeddings
BEGIN
  DBMS_VECTOR.LOAD_ONNX_MODEL(
    directory  => 'DM_DUMP',
    file_name  => 'all_MiniLM_L12_v2.onnx',
    model_name => 'ALL_MINILM_L12_V2'
  );
END;
/

-- Create a hybrid index: vector similarity + Oracle Text keyword search
CREATE HYBRID VECTOR INDEX POLICY_HYBRID_IDX
ON POLICY_DOCS(content)
PARAMETERS('MODEL ALL_MINILM_L12_V2 VECTOR_IDXTYPE HNSW');
Une fois l’index en place, les embeddings sont calculés automatiquement à l’insertion des lignes — pas besoin d’API d’embeddings externe.
Le QuestionAnswerAdvisor de Spring AI n’encapsule que VectorStore.similaritySearch() : de la recherche vectorielle pure, rien d’autre. Pour utiliser la recherche hybride, je suis passé à RetrievalAugmentationAdvisor : l’alternative modulaire qui accepte un DocumentRetriever et un QueryAugmenter personnalisés pour contrôler l’injection des documents dans l’invite.
Le OracleHybridDocumentRetriever personnalisé implémente DocumentRetriever et appelle DBMS_HYBRID_VECTOR.SEARCH via JDBC, en passant un paramètre JSON qui spécifie l’index hybride, le scoreur (RRF) et la correspondance par mots-clés :
public List<Document> retrieve(Query query) {
    // Builds a JSON spec with hybrid index name, RRF scorer, vector + text search clauses
    // Calls DBMS_HYBRID_VECTOR.SEARCH via JDBC, parses JSON results into List<Document>
}
Cela contourne totalement OracleVectorStore pour la partie retrieval. La clause text.contains utilise un simple OR de mots-clés (mots de plus de 2 caractères), en laissant le stemming intégré d’Oracle Text gérer les variantes.
L’agent a besoin d’une recherche fiable pour bien décider. Si la mémoire sémantique renvoie des documents erronés ou à faible confiance, le LLM peut halluciner des paramètres d’outils ou passer à côté d’un appel d’outil nécessaire.
La recherche hybride offre un contexte plus fiable, donc de meilleures décisions autonomes : l’agent est moins susceptible de mal citer une politique ou de manquer un document pertinent lorsque le sens et les termes exacts sont couverts.
La configuration tient dans un unique application.yaml. Points clés : Hibernate crée automatiquement les tables JPA (ddl-auto: update), Spring AI crée la table de mémoire de chat (initialize-schema: always), la table POLICY_DOCS et l’index hybride sont créés par un script SQL à exécution unique (setup-hybrid-search.sql), et Oracle UCP partage un seul pool de connexions pour les trois types de mémoire.
Pas de Flyway, pas de classes @Configuration personnalisées. L’auto-configuration de Spring AI détecte le driver JDBC Oracle et connecte le tout. Voir le application.yaml complet dans le dépôt.
Le frontend Streamlit envoie les messages au backend et affiche les réponses. Voici l’essentiel (l’appli complète inclut des boutons de démarrage rapide et la création d’une nouvelle conversation. Voir app.py) :
def send_message(prompt, url):
    # POSTs plain text to /api/v1/agent/chat with X-Conversation-Id header
    # Renders user message and assistant response in Streamlit chat UI

if prompt := st.chat_input("Type a message..."):
    send_message(prompt, backend_url)
Un UUID est généré par session comme ID de conversation, on envoie du texte brut au backend, et on affiche la réponse. C’est tout.
En bref : lancez un conteneur Oracle DB, chargez le modèle ONNX et créez l’index hybride (setup à faire une fois), installez Ollama et téléchargez le modèle de chat (qwen2.5), exécutez le backend Spring Boot avec le profil local, et lancez éventuellement l’UI Streamlit. Les embeddings sont gérés en base par le modèle ONNX, sans modèle d’embeddings Ollama. Le guide complet est dans le README du dépôt.
Test rapide avec curl :
curl -X POST http://localhost:8080/api/v1/agent/chat \
  -H "Content-Type: text/plain" \
  -H "X-Conversation-Id: test-1" \
-d "What orders do I have?"Cette architecture constitue une excellente base pour construire de vrais agents avec Spring AI et Oracle Database car elle conserve toutes les couches mémoire dans une même pile opérationnelle : contexte épisodique, recherche sémantique et actions procédurales. Spring AI offre des abstractions nettes (Advisors + @Tool) pour garder un comportement d’agent lisible et testable, tandis qu’Oracle gère données transactionnelles et recherche hybride dans le même système, avec embeddings en base et classement RRF pour une meilleure précision sur le sens comme sur les termes exacts.
Le résultat est très concret : moins de briques, moins de pannes d’intégration, une latence réduite et une exploitation plus simple. Plutôt que d’assembler des systèmes séparés pour l’historique, la recherche vectorielle, la recherche par mots-clés et les tables métier, vous construisez sur une seule plateforme tout en bénéficiant d’une recherche de qualité et d’une exécution d’outils fiable. Pour des équipes qui délivrent des fonctionnalités d’agent, ce mix simplicité, précision et maîtrise opérationnelle est difficile à battre.
Pour en savoir plus sur les agents IA et leur fonctionnement, nous vous recommandons le parcours de compétences AI Agent Fundamentals de DataCamp.
Meilleurs cours DataCamp
Cours
Cours
Cours
blog
blog
Kurtis Pykes
9 min
blog
Lynn Heidmann
blog
Kurtis Pykes
15 min
blog
Zoumana Keita
15 min
Tutoriel