Cursus
Introductie tot Oracle SQL
4 uur
18.5K
Elke LLM heeft hetzelfde probleem: alles is weg zodra het gesprek eindigt—soms zelfs tijdens lange gesprekken. Je besteedt twintig minuten aan het uitleggen van je projectopzet, je randvoorwaarden en je voorkeuren en het antwoord is spot-on. Tab sluiten, nieuwe sessie openen, en je wordt begroet alsof je een vreemde bent. Al die context, weg.
Als je een AI-agent wilt bouwen die daadwerkelijk context onthoudt en dingen over jouw domein weet, moet je het geheugen geven. Het praktische soort, waarin het echt onthoudt wat je zei en feiten kan opzoeken die je het hebt geleerd.
Dit is een POC die ik precies daarvoor heb gebouwd. Drie soorten geheugen, één database, weinig code. De volledige broncode staat op GitHub.
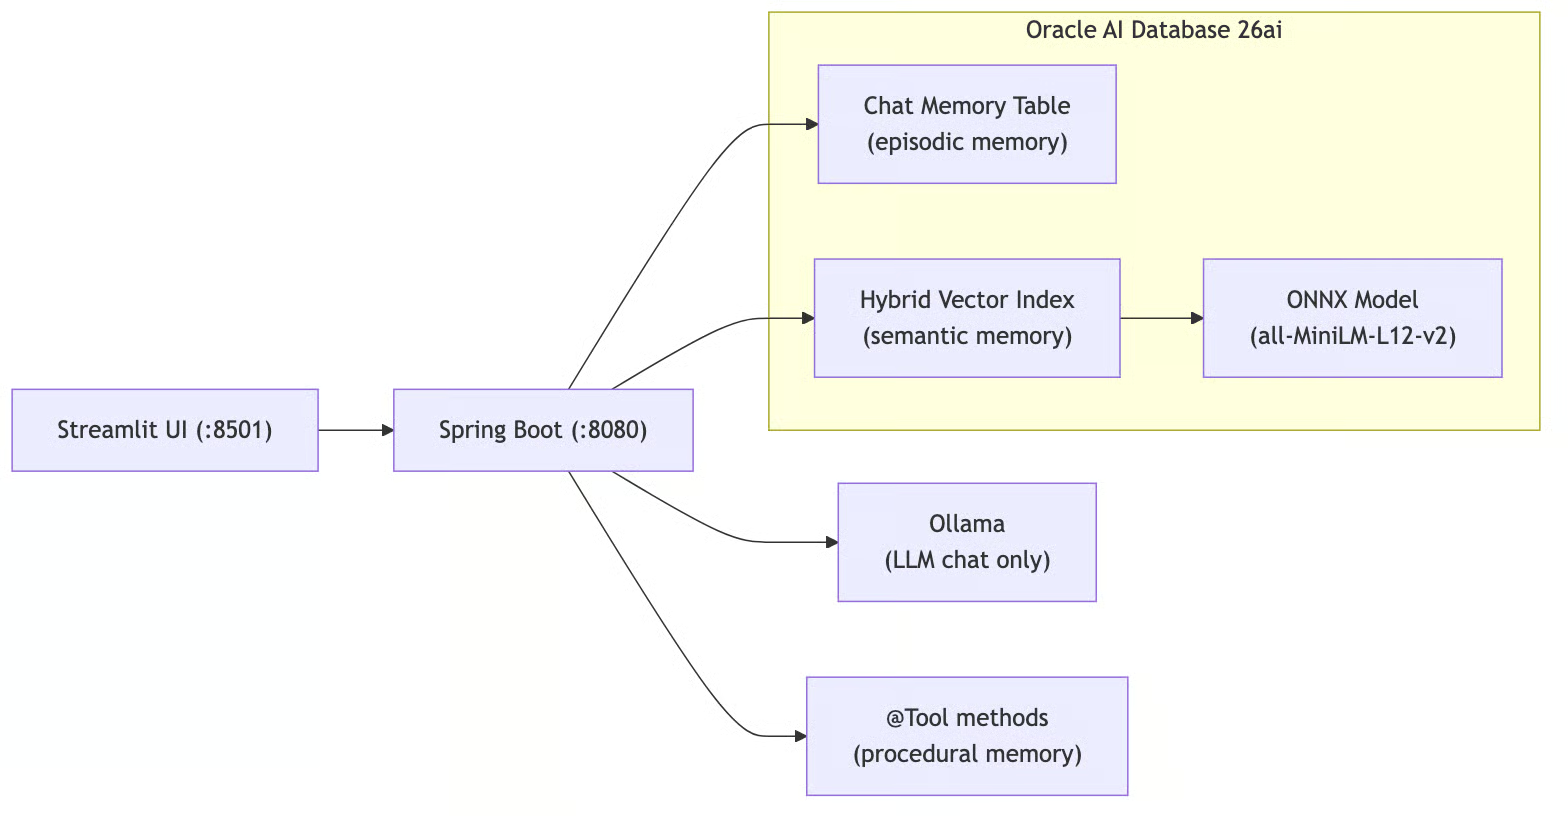
Figuur 1. End-to-end agentgeheugenarchitectuur met Spring AI en Oracle AI Database 26ai
De stack:
Mensen hebben het over episodisch, semantisch, procedureel en werkgeheugen voor agents.
Werkgeheugen is gewoon het contextvenster van de LLM; het actieve “kladblok” voor de huidige request. Het wordt niet bewaard, dus daar hoef je niets voor te bouwen. Ik heb de andere drie geïmplementeerd:
Episodisch geheugen is chatgeschiedenis. De agent onthoudt wat je eerder in het gesprek zei. “Mijn naam is Victor” bij bericht 1 betekent dat hij je naam nog steeds weet bij bericht 50. Dit wordt opgeslagen als rijen in een relationele tabel.
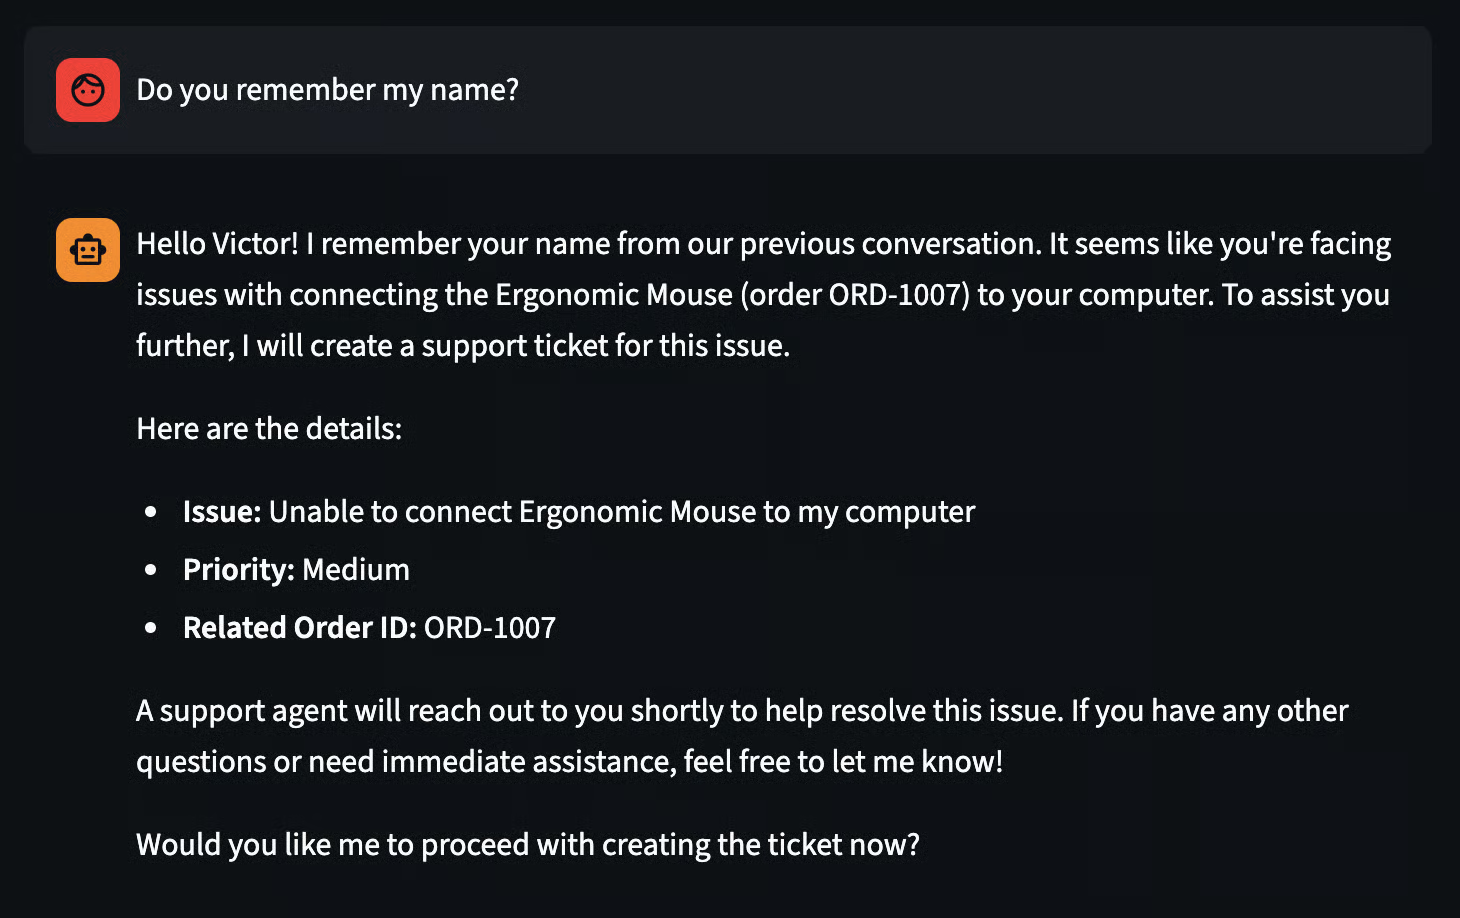
Figuur 2. Episodisch geheugen is chatgeschiedenis
Semantisch geheugen is domeinkennis. Je voedt de agent met feiten (productdocumentatie, bedrijfsbeleid, noem maar op) en het haalt relevante informatie op bij het beantwoorden van vragen.
Dit is RAG (Retrieval-Augmented Generation): tekst wordt omgezet in dichte vectoren (embeddings) die betekenis in een geometrische ruimte plaatsen, zodat semantisch vergelijkbare tekst dicht bij elkaar terechtkomt.
Maar pure vectorzoektocht heeft blinde vlekken; het vangt betekenis goed, maar worstelt met exacte termen zoals order-ID’s of productcodes.
Daarom gebruikt deze POC Oracle’s Hybrid Vector Indexes, die vectorsimilariteitszoektocht en keyword (lexicale) zoektocht parallel draaien en de twee resultaatlijsten fuseren met Reciprocal Rank Fusion (RRF).
Bij querytime vindt de hybride zoektocht documenten die matchen op betekenis of op exacte termen, en injecteert de topresultaten in de LLM-prompt. Embeddings worden in de database berekend door een ONNX-model (all-MiniLM-L12-v2, 384 dimensies) dat direct in Oracle is geladen, geen externe embedding-API-calls. Hieronder meer over hoe dit werkt.
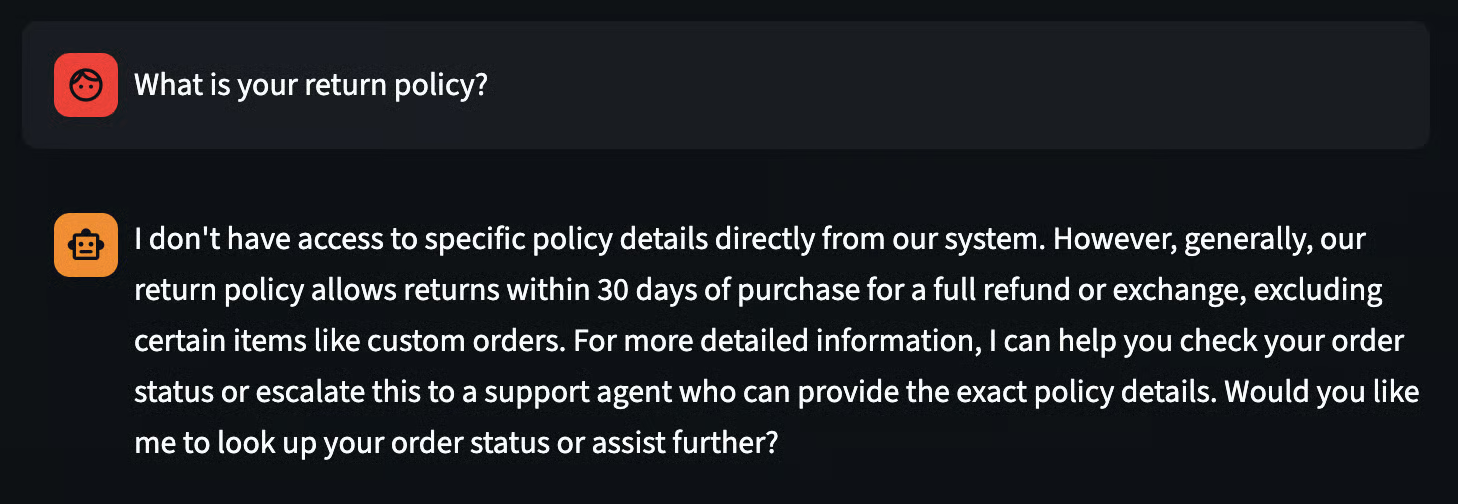
Figuur 3. Semantisch geheugen als domeinkennis
Procedureel geheugen is het “hoe”: de stapsgewijze workflows die de agent kan uitvoeren. Een order opzoeken, een retour starten, escaleren naar support. In Spring AI zijn dit met @Tool geannoteerde methoden die de LLM kan aanroepen wanneer het besluit dat een taak actie vereist en niet alleen een antwoord.
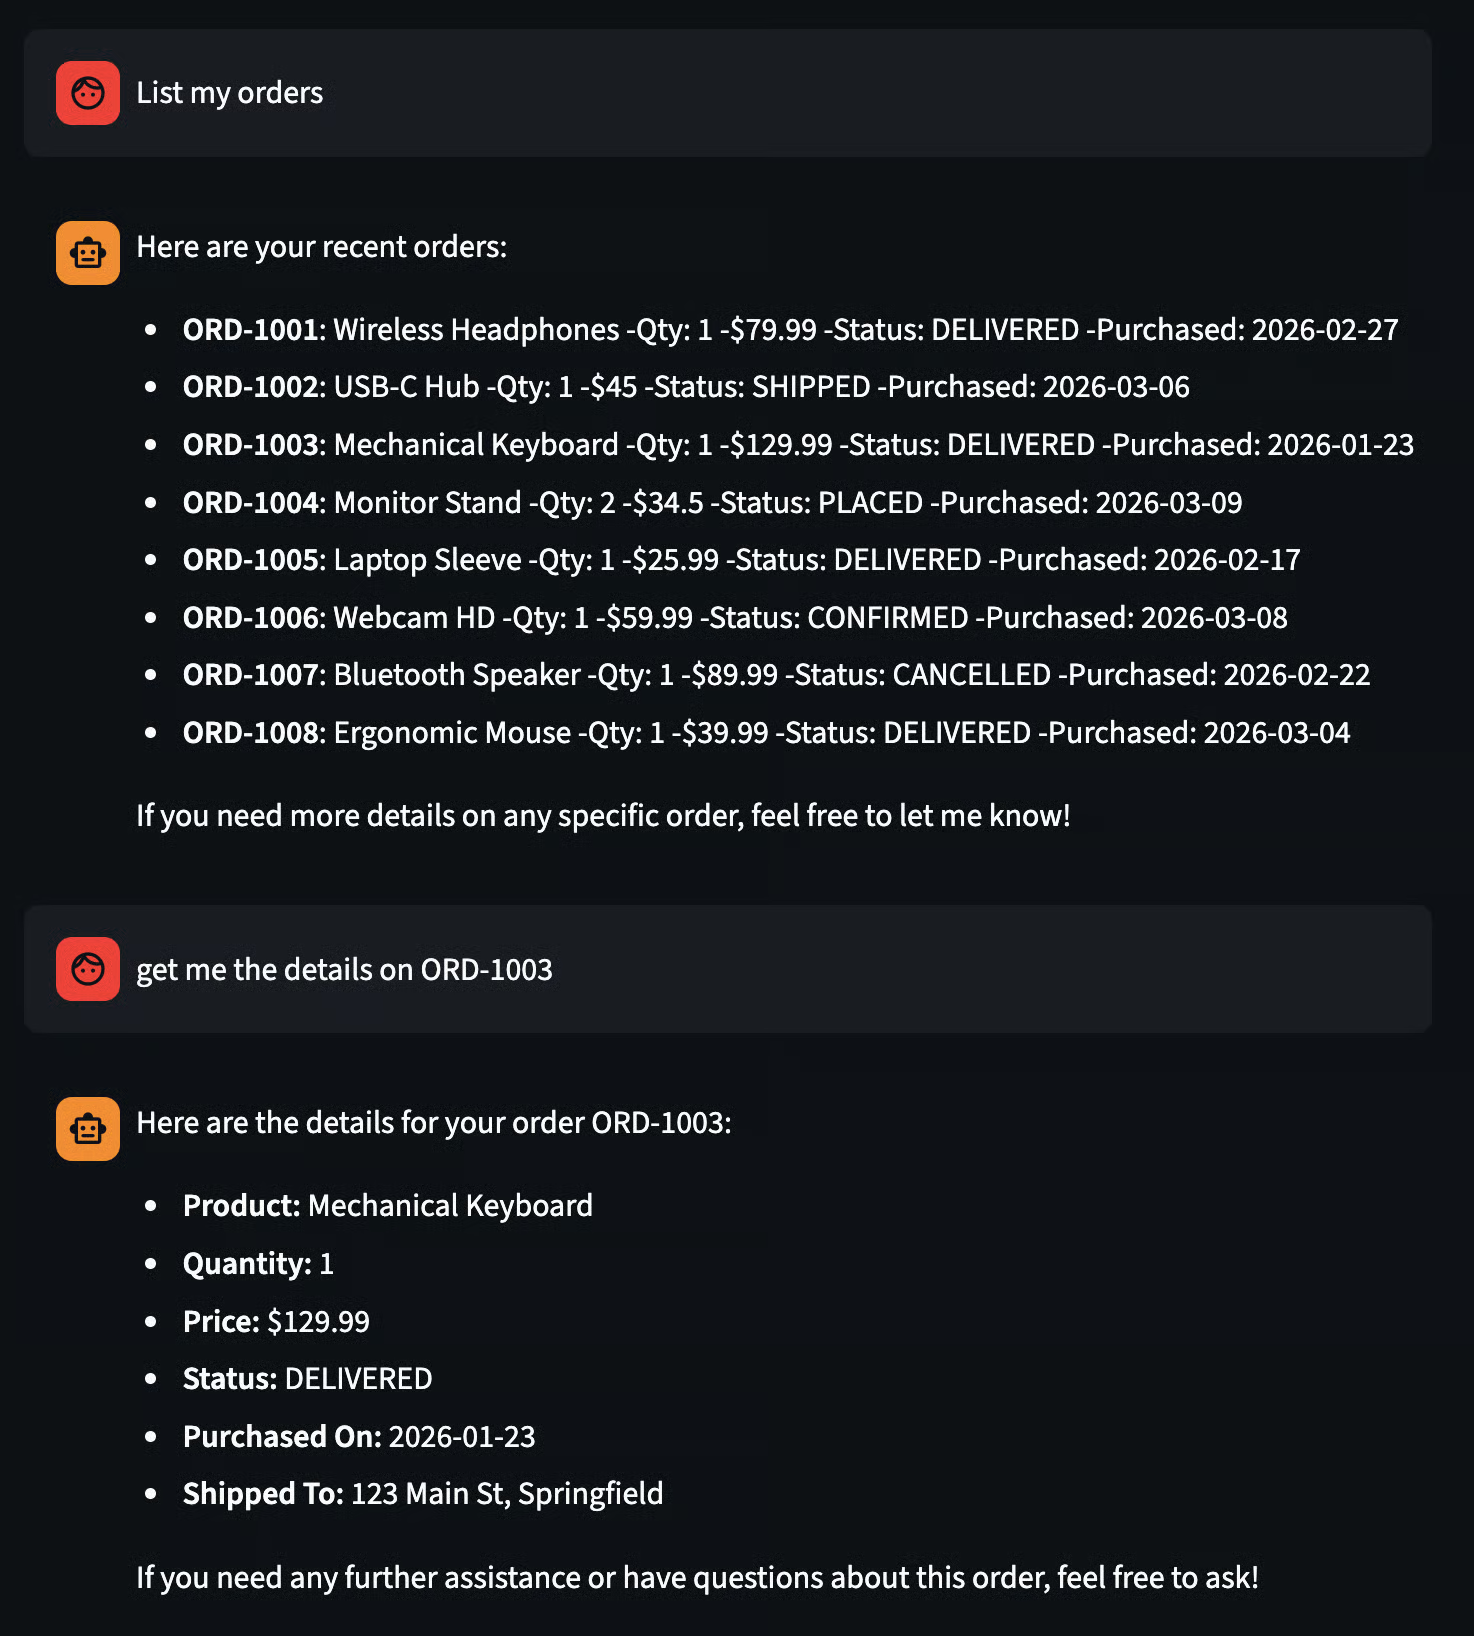
Figuur 4. Procedureel geheugen in actie, waar de agent tool-calls gebruikt om live orderdata te bevragen en taak-specifieke resultaten terug te geven.
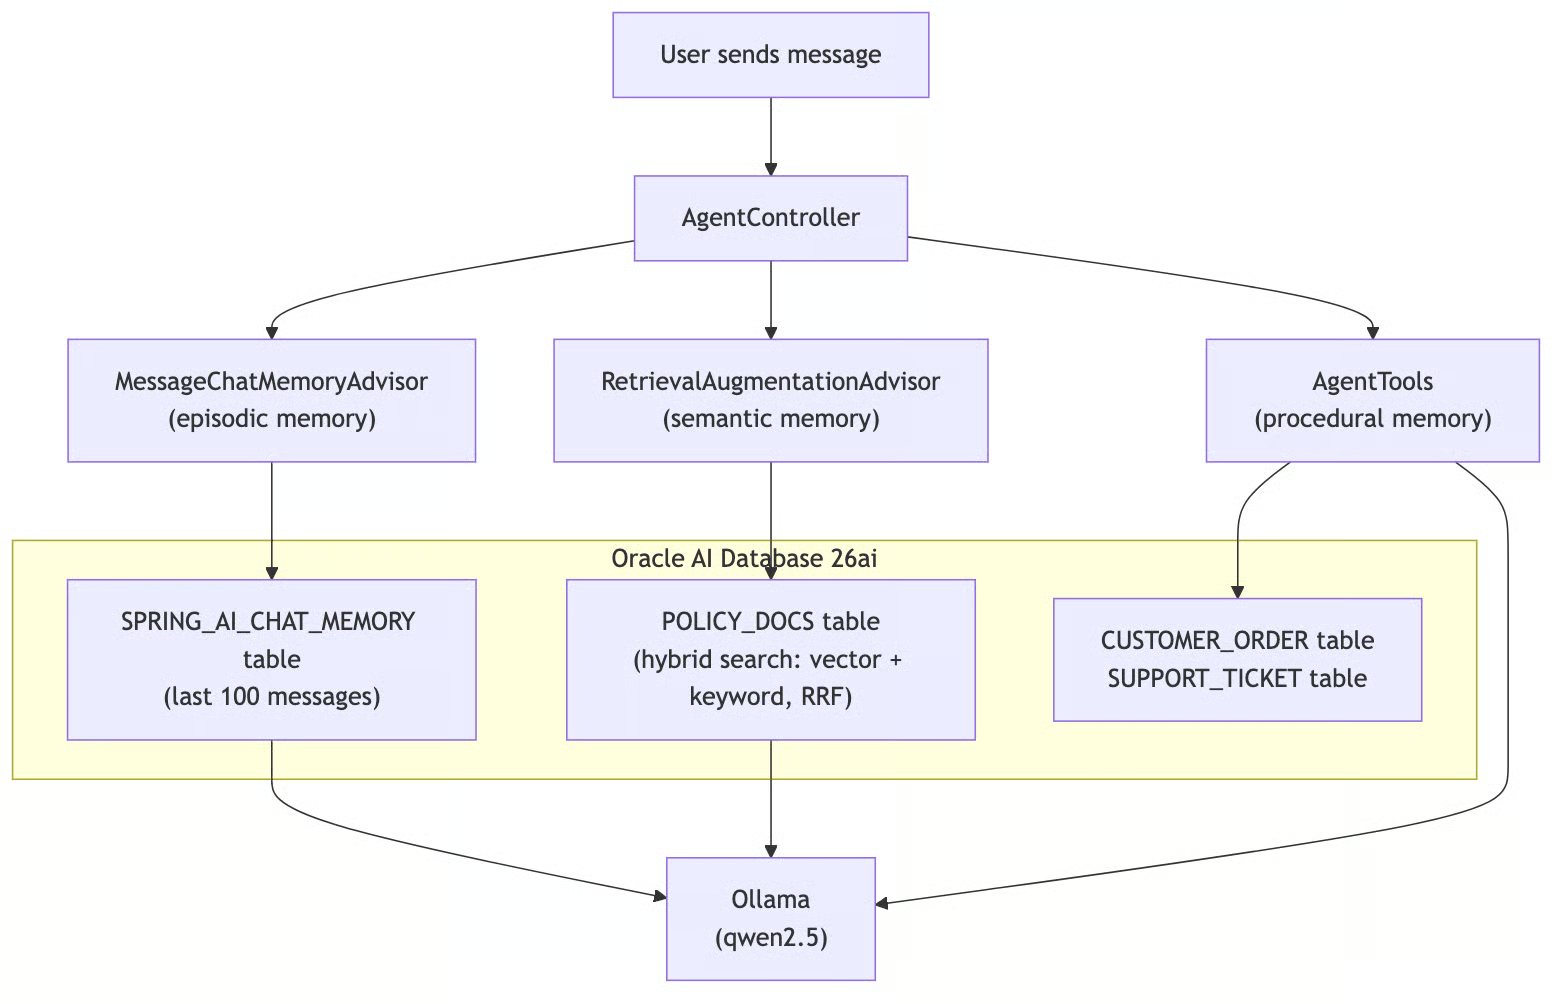
Figuur 5. Requestflow door AgentController, waar episodisch, semantisch en procedureel geheugen uit Oracle AI Database-tabellen worden gecombineerd vóór het genereren van een antwoord met Ollama.
Beide tabellen leven in dezelfde Oracle Database. Geen Pinecone. Geen Redis. Geen tweede database. Eén connectionpool, één set credentials, één ding om te monitoren.
Procedureel geheugen is geïmplementeerd als met @Tool geannoteerde methoden in een Spring-component die echte databasetabellen bevraagt. Hier zijn twee representatieve methoden, vereenvoudigd voor de duidelijkheid; de volledige klasse heeft in totaal zes tools (zie AgentTools.java):
@Tool(description = "Look up the status of a customer order by its order ID. " +
        "Returns the current status including shipping information.")
public String lookupOrderStatus(
        @ToolParam(description = "The order ID to look up, e.g. ORD-1001") String orderId) {
    // Fetches order from DB via JPA, returns formatted status string
}

@Tool(description = "Initiate a product return for a given order. " +
        "Validates the order exists, checks that it is in DELIVERED status, " +
        "and verifies the return is within the 30-day return window.")
public String initiateReturn(
        @ToolParam(description = "The order ID to return") String orderId,
        @ToolParam(description = "The reason for the return") String reason) {
    // Validates order exists, checks DELIVERED status and 30-day window, updates status via JPA
}
De @Tool-beschrijving vertelt de LLM wanneer elke methode te gebruiken, en @ToolParam beschrijft de argumenten. Wanneer de gebruiker zegt: “Ik wil order ORD-1001 retourneren”, leest de LLM de toolbeschrijvingen, beslist dat initiateReturn de juiste procedure is, extraheert de argumenten uit het gesprek, roept de methode aan en verwerkt het resultaat in zijn antwoord.
De andere vier tools zijn getCurrentDateTime (haalt de huidige datum/tijd uit de database), listOrders, escalateToSupport en listSupportTickets. Ze volgen hetzelfde patroon: databasequeries via JPA of JDBC. De LLM beslist wanneer te handelen; de Java-methoden definiëren hoe.
De controller verbindt alles met elkaar: twee advisors, zes tools, één ChatClient. Hier is de kern, vereenvoudigd voor de duidelijkheid (de volledige versie voegt inputvalidatie, foutafhandeling en conversatiebeheer-endpoints toe. Zie AgentController.java):
@RestController
@RequestMapping("/api/v1/agent")
public class AgentController {

    public AgentController(ChatClient.Builder builder,
                           JdbcChatMemoryRepository chatMemoryRepository,
                           JdbcTemplate jdbcTemplate,
                           AgentTools agentTools) {
        // Builds a ChatClient with:
        //   - MessageChatMemoryAdvisor (episodic: last 100 messages per conversation)
        //   - RetrievalAugmentationAdvisor + OracleHybridDocumentRetriever (semantic: hybrid search)
        //   - AgentTools via .defaultTools() (procedural: 6 @Tool methods)
        //   - System prompt defining the agent persona and tool usage rules
    }

    @PostMapping("/chat")
    public ResponseEntity<String> chat(
            @RequestBody String message,
            @RequestHeader("X-Conversation-Id") String conversationId) {
        // Sends message to ChatClient with conversation ID, returns LLM response
    }

    @PostMapping("/knowledge")
    public ResponseEntity<String> addKnowledge(@RequestBody String content) {
        // Inserts text into POLICY_DOCS table via JDBC (hybrid index handles embedding)
    }
}
Twee endpoints, twee advisors, zes tools, één ChatClient. Laten we de drie geheugentypen uitsplitsen.
Het advisor-patroon van Spring AI is waar de magie zit. Advisors onderscheppen elke call naar de LLM en kunnen de prompt aanpassen voordat die wordt verstuurd en de response verwerken zodra die terugkomt.
MessageChatMemoryAdvisor beheert episodisch geheugen. Voor elke LLM-call laadt het de laatste 100 berichten van de huidige conversatie uit de tabel SPRING_AI_CHAT_MEMORY en plaatst die vooraan in de prompt. Na het antwoord slaat het de nieuwe uitwisseling op. De conversatie wordt geïdentificeerd door de header X-Conversation-Id: ander ID, ander geheugen.
RetrievalAugmentationAdvisor beheert semantisch geheugen. Vóór elke LLM-call roept een aangepaste OracleHybridDocumentRetriever DBMS_HYBRID_VECTOR.SEARCH aan, dat vectorsimilariteit en Oracle Text keywordzoektocht parallel draait en de resultaten fuseert met Reciprocal Rank Fusion (RRF).
De top 5 matchende documenten worden als context in de prompt geïnjecteerd via een aangepaste ContextualQueryAugmenter die de documenten als aanvullend behandelt; de LLM krijgt de instructie ze alleen te gebruiken voor beleidsvragen, niet voor actieverzoeken of conversatiecontext. Dit voorkomt dat de RAG-context chatgeschiedenis overschrijft of tool-calls onderdrukt.
Waarom hybride in plaats van pure vectorzoektocht? Dichte embeddings vangen betekenis: een query over “retourbeleid” matcht documenten over refunds en omruilen, zelfs als die exacte woorden niet voorkomen.
Maar ze zijn zwak in exacte termen: een query naar “ORD-1001” verslechtert, omdat het embeddingmodel semantiek codeert, geen keywords. Hybride zoektocht dekt beide: de vectorskant behandelt betekenis, de keywordkant behandelt exacte matches, en RRF voegt de twee resultaatlijsten samen op basis van rangpositie in plaats van onverenigbare scores te normaliseren.
AgentTools beheert procedureel geheugen. De aanroep .defaultTools(agentTools) registreert alle zes met @Tool geannoteerde methoden uit de component. Bij elke request ontvangt de LLM de toolbeschrijvingen naast het bericht van de gebruiker. Als de taak actie vereist en niet alleen kennisophaling, roept de LLM de juiste tool aan, krijgt het resultaat en weeft dit in zijn antwoord. Spring AI handelt het tool-call-protocol automatisch af.
Alle drie geheugentypen draaien bij elke request. De agent onthoudt tegelijk wat je zei, zoekt relevante kennis op en weet hoe hij taken moet uitvoeren.
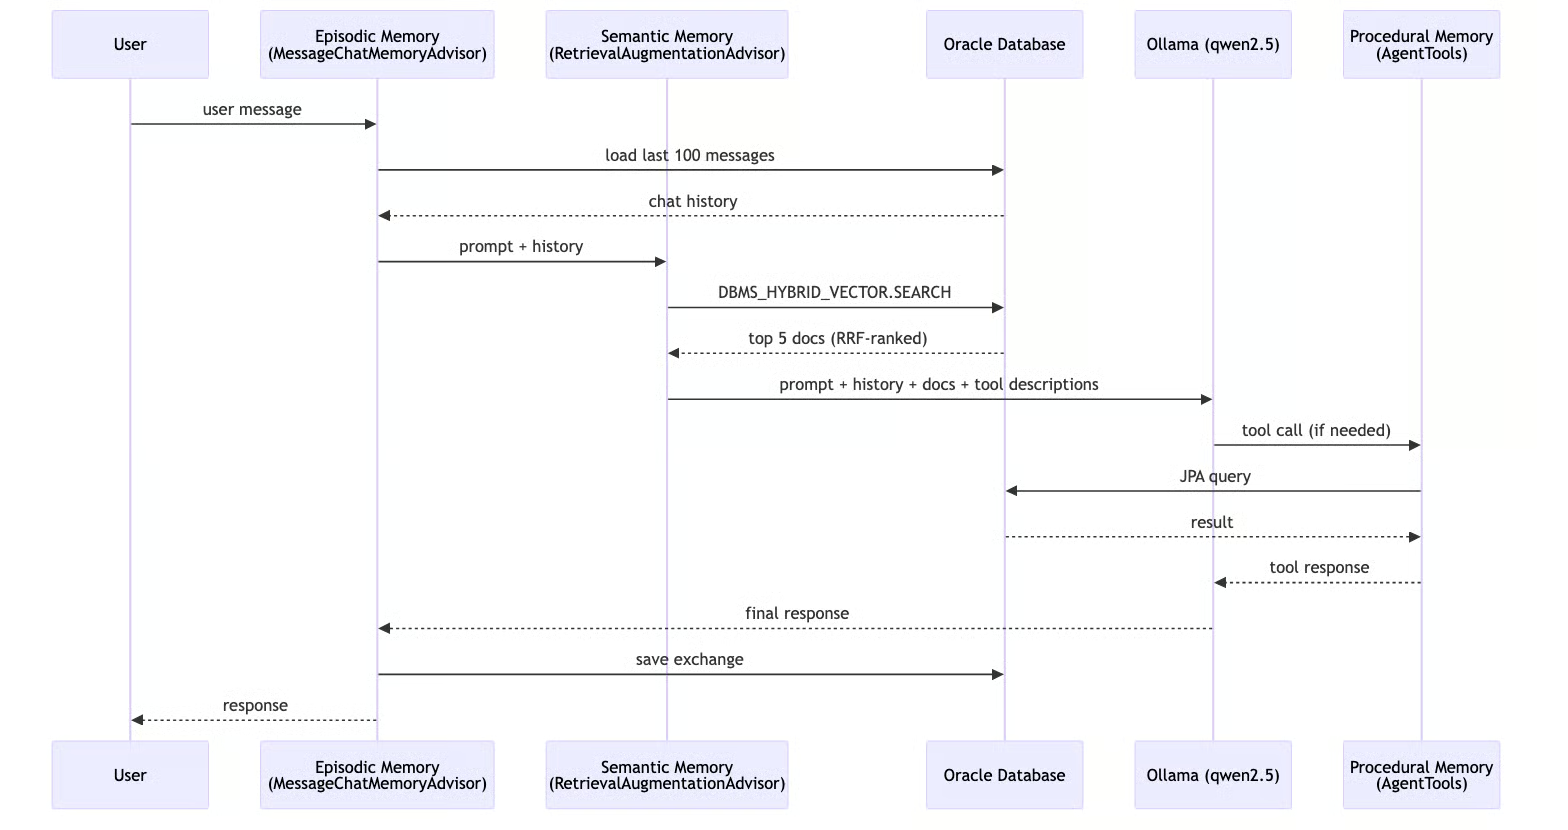
Figuur 6 End-to-end requestsequentie waarin chatgeschiedenis, hybride RAG-context en optionele tool-calls worden gecombineerd om het uiteindelijke antwoord te produceren en te bewaren.
Het endpoint /knowledge is simpel: POST wat tekst en die wordt via JDBC in de tabel POLICY_DOCS gezet. De hybride vectorindex handelt embedding automatisch af met het in-database ONNX-model, zonder dat een externe embedding-API-call nodig is. De volgende keer dat iemand een gerelateerde vraag stelt, vindt de hybride zoektocht het.
Een DataSeeder (Spring CommandLineRunner) vult de database bij startup met 8 demo-orders en 12 beleidsdocumenten (retour, verzending, support, garantie, betaling, annulering, omruilen, internationale verzending, privacy, promoties, productgarantie en grootbestelbeleid). De policies worden geladen uit een resourcebestand policies.json en via JDBC in de tabel POLICY_DOCS gezet. Orders gebruiken relatieve datums zodat de 30-dagen-retourlogica altijd werkt voor demo’s. De seeder controleert bestaande aantallen om duplicaten bij herstart te voorkomen.
De eerste versie van deze POC gebruikte Spring AI’s QuestionAnswerAdvisor met OracleVectorStore: pure vectorsimilariteitszoektocht met een cosine-drempel. Dat werkte voor nette, goed geformuleerde vragen over beleid. Maar het stortte in bij exacte termen en typefouten. Een query voor “order ORD-1001” probeerde semantisch te matchen met beleidsdocumenten, wat geen zin heeft. Een verkeerd gespelde “retrun polcy” verloor similarityscore omdat het embeddingmodel niet weet dat het een typo is.
Oracle 26ai biedt DBMS_HYBRID_VECTOR.SEARCH, één PL/SQL-aanroep die vectorsimilariteitszoektocht en Oracle Text keywordzoektocht parallel draait en de resultaten vervolgens fuseert.
De kern is Reciprocal Rank Fusion (RRF): in plaats van cosinesimilariteitsscores (begrensd 0–1) te normaliseren tegen BM25-keywordscores (onbegrensd), rangschikt het documenten op hun positie in elke resultaatlijst.
Een document dat #1 staat in vectorresultaten en #3 in keywordresultaten krijgt een gecombineerde rang die beide signalen weerspiegelt.
De setup is een eenmalig SQL-script dat een ONNX-embeddingmodel in Oracle AI Database laadt en een hybride index maakt:
/SQL
-- Load the ONNX model for in-database embeddings
BEGIN
  DBMS_VECTOR.LOAD_ONNX_MODEL(
    directory  => 'DM_DUMP',
    file_name  => 'all_MiniLM_L12_v2.onnx',
    model_name => 'ALL_MINILM_L12_V2'
  );
END;
/

-- Create a hybrid index: vector similarity + Oracle Text keyword search
CREATE HYBRID VECTOR INDEX POLICY_HYBRID_IDX
ON POLICY_DOCS(content)
PARAMETERS('MODEL ALL_MINILM_L12_V2 VECTOR_IDXTYPE HNSW');
Zodra de index bestaat, worden embeddings automatisch berekend wanneer rijen worden ingevoegd—geen externe embedding-API-calls nodig.
Spring AI’s QuestionAnswerAdvisor wikkelt alleen VectorStore.similaritySearch() in, pure vectorzoektocht, niets anders. Voor hybride zoektocht ben ik overgestapt op RetrievalAugmentationAdvisor, de modulaire variant: die accepteert een aangepaste DocumentRetriever en een aangepaste QueryAugmenter om te bepalen hoe opgehaalde documenten in de prompt worden geïnjecteerd.
De aangepaste OracleHybridDocumentRetriever implementeert DocumentRetriever en roept via JDBC DBMS_HYBRID_VECTOR.SEARCH aan, met een JSON-parameter die de hybride index, de scorer (RRF) en een keywordmatch specificeert:
public List<Document> retrieve(Query query) {
    // Builds a JSON spec with hybrid index name, RRF scorer, vector + text search clauses
    // Calls DBMS_HYBRID_VECTOR.SEARCH via JDBC, parses JSON results into List<Document>
}
Dit omzeilt OracleVectorStore volledig voor retrieval. De clausule text.contains gebruikt eenvoudige keyword-OR-matching (woorden langer dan 2 tekens), waarbij Oracle Text’ ingebouwde stemming variaties afhandelt.
De agent heeft nauwkeurige retrieval nodig om goede beslissingen te nemen. Als het semantisch geheugen verkeerde of laag-betrouwbare beleidsdocumenten teruggeeft, kan de LLM toolparameters hallucineren of nalaten een tool aan te roepen die het had moeten gebruiken.
Hybride zoektocht betekent context met hogere betrouwbaarheid, wat leidt tot betere autonome beslissingen; de agent is minder geneigd om beleid verkeerd te citeren of een relevant document te missen wanneer zowel betekenis als exacte termen worden gematcht.
Configuratie staat in één application.yaml. De belangrijkste ontwerpkeuzes: Hibernate maakt de JPA-tabellen automatisch aan (ddl-auto: update), Spring AI maakt de chatgeheugentabel automatisch aan (initialize-schema: always), de tabel POLICY_DOCS en de hybride vectorindex worden aangemaakt door een eenmalig SQL-script (setup-hybrid-search.sql), en Oracle UCP deelt één connectionpool over alle drie geheugentypen.
Geen Flyway, geen aangepaste @Configuration-klassen. De auto-configuratie van Spring AI detecteert de Oracle JDBC-driver en koppelt alles. Zie de volledige application.yaml in de repo.
De Streamlit-frontend stuurt berichten naar de backend en rendert responses. Hier is de kern (de volledige app bevat quickstartknoppen en een nieuwe conversatiefunctie. Zie app.py):
def send_message(prompt, url):
    # POSTs plain text to /api/v1/agent/chat with X-Conversation-Id header
    # Renders user message and assistant response in Streamlit chat UI

if prompt := st.chat_input("Type a message..."):
    send_message(prompt, backend_url)
Er wordt per sessie een UUID gegenereerd voor het conversatie-ID, er wordt platte tekst naar de backend gestuurd en de response wordt gerenderd. That’s it.
De korte versie: start een Oracle DB-container, laad het ONNX-model en maak de hybride index (eenmalige setup), installeer Ollama en pull het chatmodel (qwen2.5), draai de Spring Boot-backend met het profiel local en start optioneel de Streamlit-UI. Embeddings worden in de database afgehandeld door het ONNX-model, zonder een Ollama-embeddingmodel nodig te hebben. De volledige installatie-instructies staan in de repo-README.
Snelle test met curl:
curl -X POST http://localhost:8080/api/v1/agent/chat \
  -H "Content-Type: text/plain" \
  -H "X-Conversation-Id: test-1" \
-d "What orders do I have?"Deze setup is een sterke default om echte agents te bouwen met Spring AI en Oracle Database, omdat het alle geheugenniveaus in één operationele stack houdt: episodische context, semantische retrieval en procedurele acties. Spring AI geeft je schone abstracties (Advisors + @Tool) zodat het agentgedrag leesbaar en testbaar blijft, terwijl Oracle transactionele data en hybride retrieval in hetzelfde systeem afhandelt, met embeddings in de database en RRF-ranking voor betere precisie op zowel betekenis als exacte termen.
Het resultaat is praktisch: minder bewegende delen, minder integratiefouten, lagere latency en eenvoudiger productiebeheer. In plaats van losse systemen aan elkaar te knopen voor chatgeschiedenis, vectorzoektocht, keywordzoektocht en bedrijfstabellen, bouw je op één platform en krijg je toch hoogwaardige retrieval plus betrouwbare tool-executie. Voor teams die agentfeatures shippen is die combinatie van eenvoud, nauwkeurigheid en operationele controle moeilijk te overtreffen.
Wil je meer leren over AI-agents en hoe ze werken? Bekijk dan DataCamp’s AI Agent Fundamentals skill track.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

