Kursus
Memahami Machine Learning
2 jam
310.9K
Dalam tutorial ini, Anda akan mempelajari cara menggunakan pustaka yang sangat unik di Python: tpot. Alasan pustaka ini unik adalah karena ia mengotomatisasi seluruh pipeline Machine Learning dan memberikan model machine learning dengan kinerja terbaik untuk Anda. Secara lebih spesifik, Anda akan mempelajari:
Mari mulai!
Ada banyak komponen yang harus Anda pertimbangkan sebelum menyelesaikan masalah machine learning, beberapa di antaranya meliputi persiapan data, pemilihan fitur, rekayasa fitur, pemilihan dan validasi model, penyetelan hyperparameter, dan lain-lain. Secara teori, Anda dapat menemukan dan menerapkan banyak teknik untuk masing-masing komponen ini, namun semuanya bisa berkinerja berbeda untuk dataset yang berbeda. Tantangannya adalah menemukan kombinasi teknik dengan kinerja terbaik sehingga Anda dapat meminimalkan galat dalam prediksi. Inilah alasan utama mengapa saat ini orang-orang bekerja mengembangkan algoritma dan platform Auto-ML agar siapa pun, tanpa keahlian machine learning, dapat membangun model tanpa menghabiskan banyak waktu atau usaha. Salah satu platform tersebut tersedia sebagai pustaka Python: TPOT. Anda dapat menganggap TPOT sebagai Asisten Data Science Anda. TPOT adalah alat Automated Machine Learning di Python yang mengoptimalkan pipeline machine learning menggunakan genetic programming. Ia akan mengotomatisasi bagian paling membosankan dari machine learning dengan secara cerdas menjelajahi ribuan kemungkinan pipeline untuk menemukan yang terbaik bagi data Anda.
from IPython.core.display import Image
Image(filename="/home/manishpathak/DataCamp/tpot/tpot-ml-pipeline.png",width=800,height=800)
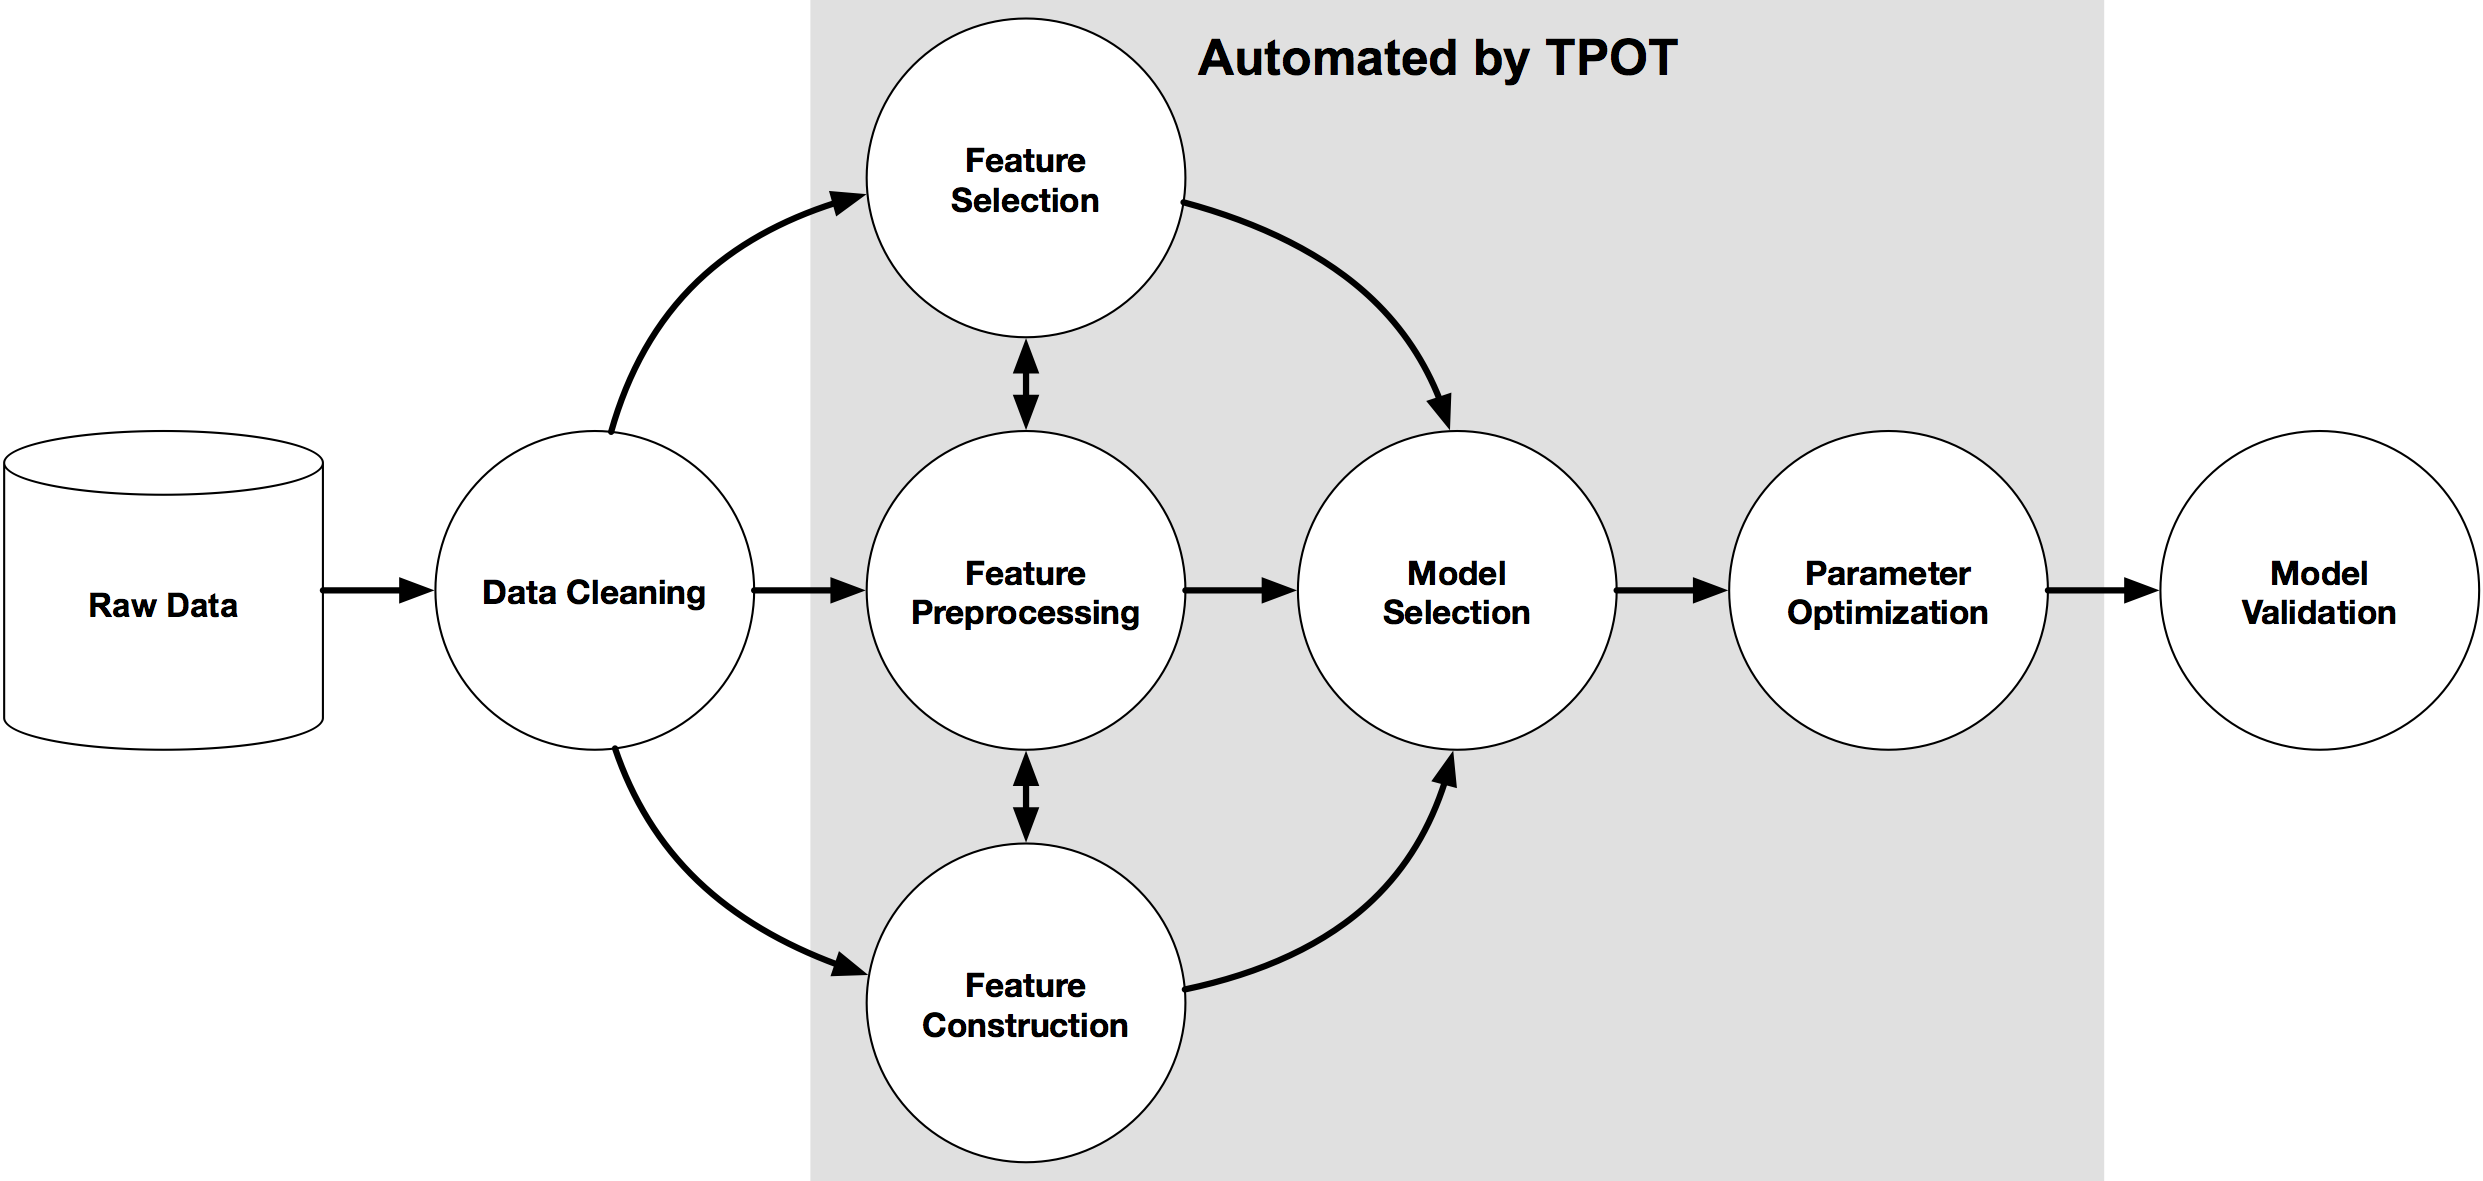
Setelah TPOT selesai mencari, ia memberikan kode Python untuk pipeline terbaik yang ditemukan sehingga Anda bisa menyempurnakannya lebih lanjut.
Untuk memasang tpot pada sistem Anda, jalankan perintah sudo pip install tpot di terminal baris perintah atau lihat tautan ini. tpot dibangun di atas beberapa pustaka Python yang sudah ada, termasuk numpy, scipy, scikit-learn, DEAP, update_checker, tqdm, stopit, pandas. Sebagian besar paket Python yang diperlukan dapat dipasang melalui distribusi Anaconda Python, atau bisa juga dipasang secara terpisah. Opsional, Anda juga dapat memasang XGBoost jika Anda ingin tpot menggunakan model eXtreme Gradient Boosting.
Dengan data, daya komputasi, dan model machine learning yang tepat, Anda dapat menemukan solusi untuk masalah apa pun, namun mengetahui model mana yang harus digunakan bisa menjadi tantangan karena begitu banyak pilihan seperti Decision Trees, SVM, KNN, dan lain-lain. Di sinilah genetic programming dapat sangat berguna dan membantu. Algoritma genetika terinspirasi oleh proses Darwinian Seleksi Alam, dan digunakan untuk menghasilkan solusi bagi masalah optimasi dan pencarian dalam ilmu komputer.
Secara garis besar, Algoritma Genetika memiliki tiga sifat:
Genetic Programming sendiri adalah topik besar dalam ilmu komputer, namun jika Anda ingin mendalami algoritma genetika, lihat seri video ini.
Lalu bagaimana semua ini cocok dengan data science?
Ternyata, memilih model machine learning yang tepat dan semua hyperparameter terbaik untuk model tersebut sendiri merupakan masalah optimasi yang dapat digunakan genetic programming. Pustaka Python tpot yang dibangun di atas scikit-learn menggunakan genetic programming untuk mengoptimalkan pipeline machine learning Anda. Misalnya, dalam machine learning, setelah menyiapkan data Anda perlu tahu fitur apa yang akan dimasukkan ke model dan bagaimana Anda harus membangun fitur-fitur tersebut. Setelah memiliki fitur-fitur itu, Anda memasukkannya ke model untuk dilatih, kemudian menyetel hyperparameter untuk mendapatkan hasil optimal. Alih-alih melakukan semuanya sendiri melalui coba-coba, TPOT mengotomatisasi langkah-langkah ini untuk Anda dengan genetic programming dan menghasilkan kode optimal saat selesai.
Untuk memahami lebih jauh, Anda akan berlatih menggunakan pustaka tpot pada sebuah dataset sumber terbuka. Dataset yang akan digunakan adalah MAGIC Gamma Telescope DataSet. Data dihasilkan untuk mensimulasikan perekaman partikel gamma berenergi tinggi di teleskop gamma Cherenkov atmosfer berbasis darat menggunakan teknik pencitraan. Untuk detail lengkap mengenai deskripsi dataset, lihat tautan ini. Dataset memiliki atribut/fitur berikut:
Tujuannya adalah mengklasifikasikan sebuah observasi sebagai gamma, yang merupakan sinyal yang diinginkan, atau hadron, yang merupakan derau latar belakang, berdasarkan atribut yang disediakan.
Anda akan mulai dengan mengimpor pustaka pandas dan numpy untuk membaca data dan melakukan komputasi masing-masing.
import pandas as pd
import numpy as np
Gunakan fungsi pandas read_csv() untuk membaca dataset sebagai DataFrame. Juga, tentukan parameter header = None karena dataset belum memiliki nama kolom.
telescope_data=pd.read_csv('https://archive.ics.uci.edu/ml/machine-learning-databases/magic/magic04.data',header=None)
Periksa isi DataFrame menggunakan metode head().
telescope_data.head()

Untuk memberikan nama pada kolom-kolom DataFrame, Anda dapat menggunakan atribut columns pada DataFrame pandas dan memberinya daftar yang berisi nama kolom.
telescope_data.columns = ['fLength', 'fWidth','fSize','fConc','fConcl','fAsym','fM3Long','fM3Trans','fAlpha','fDist','class']
telescope_data.head()

Sekarang Anda juga memiliki nama kolom dalam DataFrame.
Untuk mendapatkan informasi yang diperlukan tentang DataFrame seperti jumlah nilai di setiap kolom, tipe data, count, mean, dan sebagainya, Anda dapat menggunakan metode pandas info() dan describe().
telescope_data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 19020 entries, 0 to 19019
Data columns (total 11 columns):
fLength     19020 non-null float64
fWidth      19020 non-null float64
fSize       19020 non-null float64
fConc       19020 non-null float64
fConcl      19020 non-null float64
fAsym       19020 non-null float64
fM3Long     19020 non-null float64
fM3Trans    19020 non-null float64
fAlpha      19020 non-null float64
fDist       19020 non-null float64
class       19020 non-null object
dtypes: float64(10), object(1)
memory usage: 1.6+ MB
telescope_data.describe()

Ternyata semua fitur dalam DataFrame bersifat kontinu. Namun, variabel/fitur target class bersifat kategorikal. Anda dapat memeriksa jumlah masing-masing kelas pada variabel target menggunakan metode value_counts().
telescope_data['class'].value_counts()
g    12332
h     6688
Name: class, dtype: int64
Biasanya, ada baiknya mengacak data secara acak sebelum memulai untuk menghindari segala jenis pengurutan dalam data. Anda dapat menyusun ulang data dalam DataFrame menggunakan random dan fungsi permutation() dari numpy. Untuk mengatur ulang nomor indeks setelah pengacakan gunakan metode reset_index() dengan parameter drop = True.
telescope_shuffle=telescope_data.iloc[np.random.permutation(len(telescope_data))]
tele=telescope_shuffle.reset_index(drop=True)
tele.head()

Sebelum menggunakan tpot, penting untuk melakukan pelabelan variabel kategorikal dalam DataFrame Anda. Untuk mempelajari lebih lanjut tentang pelabelan variabel kategorikal, lihat tutorial ini. Di sini hanya variabel target class yang merupakan fitur kategorikal, sehingga perlakuan dilakukan pada kolom tersebut. Anda akan mengganti kelas g (sinyal) dengan nilai numerik 0 dan kelas h (latar belakang) dengan nilai numerik 1. Ini dapat dilakukan melalui fungsi map() dengan argumen berupa kamus yang memuat pemetaan masing-masing kelas dari variabel target.
tele['class']=tele['class'].map({'g':0,'h':1})

tele.head()

Sekarang Anda menyimpan label kelas, yang perlu diprediksi, dalam variabel terpisah tele_class.
tele_class = tele['class'].values
Anda juga sebaiknya melakukan penanganan nilai hilang sebelum menggunakan tpot. Untuk memeriksa jumlah nilai hilang per kolom, Anda dapat menjalankan berikut ini:
pd.isnull(tele).any()
fLength     False
fWidth      False
fSize       False
fConc       False
fConcl      False
fAsym       False
fM3Long     False
fM3Trans    False
fAlpha      False
fDist       False
class       False
dtype: bool
Dataset ini tidak memiliki nilai hilang. Catatan pada dataset dengan nilai hilang Anda bisa menghapus baris/kolom menggunakan metode dropna() atau mengganti nilai hilang dengan nilai dummy menggunakan metode fillna(). Misalnya, potongan kode berikut akan mengganti nilai NA dengan nilai dummy -999.
tele = tele.fillna(-999)
Sekarang Anda akan membagi DataFrame menjadi set pelatihan dan set pengujian seperti yang biasa dilakukan saat melakukan pemodelan machine learning. Anda dapat melakukannya melalui cross_validation train_test_split dari sklearn. Parameternya adalah tele.index sebagai indeks DataFrame, train_size = 0.75 untuk menyimpan 75% data dalam set pelatihan, test_size = 0.25 untuk menyimpan 25% sisanya dalam set pengujian dan stratify = tele_class nilai label kelas dalam dataset. Catatan set validasi hanya untuk memberi gambaran tentang galat set uji. Di sini disamakan dengan set uji.
from sklearn.cross_validation import train_test_split
training_indices, validation_indices = training_indices, testing_indices = train_test_split(tele.index,
                                                                                            stratify = tele_class,
                                                                                            train_size=0.75, test_size=0.25)
Anda dapat memeriksa ukuran set pelatihan dan set validasi menggunakan atribut size.
training_indices.size, validation_indices.size
(14265, 4755)
Sekarang saatnya menggunakan pustaka tpot untuk menyarankan pipeline terbaik bagi masalah klasifikasi biner ini. Untuk melakukannya, Anda harus mengimpor kelas TPOTClassifier dari pustaka tpot. Jika ini adalah masalah regresi, Anda akan mengimpor kelas TPOTRegressor.
TPOTClassifier memiliki beragam parameter, dan Anda dapat membaca semuanya di sini. Namun, yang paling penting untuk diketahui adalah:
accuracy, average_precision, roc_auc, recall, dan lain-lain. Bawaannya adalah accuracy.Juga perhatikan mutation_rate + crossover_rate tidak boleh melebihi 1.0.
Di sini Anda akan menggunakan tpot dengan generations = 5 dan parameter lain pada nilai bawaan. Parameter verbosity = 2 menyatakan seberapa banyak informasi yang dikomunikasikan TPOT saat berjalan.
Kemudian Anda akan memanggil metode fit() dengan set pelatihan (tanpa kolom target) dan kolom target sebagai argumen.
Catatan menjalankan kode pada sel di bawah ini akan memakan waktu beberapa jam hingga selesai. Dengan pengaturan TPOT saat ini (5 generasi dengan ukuran populasi 100), TPOT akan mengevaluasi 500 konfigurasi pipeline sebelum selesai. Untuk memberi konteks, pikirkan pencarian grid dengan 500 kombinasi hyperparameter untuk sebuah algoritma machine learning dan berapa lama waktu yang diperlukan. Itu berarti 500 konfigurasi model yang dievaluasi dengan 5-fold cross-validation, yang berarti kira-kira 2500 model dilatih dan dievaluasi pada data pelatihan dalam satu grid search. Itu adalah prosedur yang memakan waktu! Nanti, Anda akan mengetahui beberapa argumen lain yang dapat Anda berikan kepada TPOTClassifier untuk mengendalikan waktu eksekusi agar TPOT selesai.
from tpot import TPOTClassifier
from tpot import TPOTRegressor

tpot = TPOTClassifier(generations=5,verbosity=2)

tpot.fit(tele.drop('class',axis=1).loc[training_indices].values,
         tele.loc[training_indices,'class'].values)
Optimization Progress:  33%|███▎      | 200/600 [41:43<1:51:41, 16.75s/pipeline]

Generation 1 - Current best internal CV score: 0.880266061124

Optimization Progress:  50%|█████     | 300/600 [1:14:37<46:57,  9.39s/pipeline]

Generation 2 - Current best internal CV score: 0.880266061124

Optimization Progress:  67%|██████▋   | 400/600 [1:59:17<2:21:21, 42.41s/pipeline]

Generation 3 - Current best internal CV score: 0.880266061124

Optimization Progress:  84%|████████▎ | 501/600 [3:01:12<1:02:16, 37.74s/pipeline]

Generation 4 - Current best internal CV score: 0.881597992166

Generation 5 - Current best internal CV score: 0.881597992166

Best pipeline: GradientBoostingClassifier(RobustScaler(PolynomialFeatures(input_matrix, degree=2, include_bias=False, interaction_only=False)), learning_rate=0.1, max_depth=6, max_features=0.6000000000000001, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=5, max_eval_time_mins=5,
        max_time_mins=None, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=100, periodic_checkpoint_folder=None,
        population_size=100, random_state=None, scoring=None,
        subsample=1.0, verbosity=2, warm_start=False)
Pada hasil di atas, 5 generasi dihitung, masing-masing memberikan efisiensi pelatihan dari model yang dipasangkan pada set pelatihan. Terlihat bahwa pipeline terbaik adalah yang memiliki skor akurasi CV sebesar 88,16%. Model yang menghasilkan hasil ini adalah pipeline yang terdiri dari teknik prapemrosesan seperti PloynomialFeatures lalu RobustScaler yang menambahkan fitur sintetis ke data masukan dan menormalkannya, yang kemudian digunakan oleh pengklasifikasi Gradient Boosting untuk membentuk prediksi akhir. Anda juga dapat melihat bahwa tpot memberikan berbagai nilai hyper-parameter seperti learning_rate,max_depth, dan sebagainya, bersamaan dengan pengklasifikasi.
Berikutnya, galat uji dihitung untuk tujuan validasi.
tpot.score(tele.drop('class',axis=1).loc[validation_indices].values,
           tele.loc[validation_indices, 'class'].values)
0.885173501577287
Seperti terlihat, akurasi uji adalah 88,51%.
Terakhir, Anda dapat meminta TPOT mengekspor kode Python yang sesuai untuk pipeline teroptimasi ke file teks dengan fungsi export:
tpot.export('tpot_MAGIC_Gamma_Telescope_pipeline.py')
True
## This is the pipeline that tpot generated: tpot_MAGIC_Gamma_Telescope_pipeline.py
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, RobustScaler

# NOTE: Make sure that the class is labeled 'target' in the data file
tpot_data = pd.read_csv('PATH/TO/DATA/FILE', sep='COLUMN_SEPARATOR', dtype=np.float64)
features = tpot_data.drop('target', axis=1).values
training_features, testing_features, training_target, testing_target = \
            train_test_split(features, tpot_data['target'].values, random_state=42)

# Score on the training set was:0.881597992166
exported_pipeline = make_pipeline(
    PolynomialFeatures(degree=2, include_bias=False, interaction_only=False),
    RobustScaler(),
    GradientBoostingClassifier(learning_rate=0.1, max_depth=6, max_features=0.6, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)
)

exported_pipeline.fit(training_features, training_target)
results = exported_pipeline.predict(testing_features)
Keren, bukan? Tanpa Anda harus mengutak-atik banyak parameter dan opsi untuk mendapatkan model terbaik, TPOT tidak hanya memberikan informasi tentang model terbaik tetapi juga kode yang dapat dijalankan untuk itu!
Seperti disebutkan sebelumnya, menjalankan TPOT terakhir memakan waktu beberapa jam untuk selesai. Nah, ada parameter tertentu yang dapat Anda tentukan untuk mengendalikan waktu eksekusi TPOT namun dengan trade-off. Karena Anda akan membatasi waktu eksekusi TPOT, TPOT tidak akan dapat menjelajahi semua kemungkinan pipeline dan karena itu model terbaik yang disarankan TPOT pada akhir batas waktu yang dibatasi mungkin bukan model terbaik yang mungkin untuk dataset tersebut. Namun, jika diberi waktu yang cukup, hasilnya akan cukup mendekati model terbaik yang mungkin. Beberapa parameter tersebut adalah:
None, pengaturan ini akan menimpa parameter generations dan memungkinkan TPOT berjalan hingga menit max_time_mins berlalu.n_jobs=-1 akan menggunakan sebanyak mungkin inti yang tersedia pada komputer. Waspadai bahwa menggunakan beberapa proses pada mesin yang sama dapat menyebabkan masalah memori untuk dataset besar. Bawaan adalah 1.Untuk latihan, Anda akan kembali menjalankan TPOT dengan argumen tambahan max_time_mins = 2 dan max_eval_time_mins = 0.04 tetapi kali ini dengan population_size = 15 yang dikurangi.
tpot = TPOTClassifier(verbosity=2, max_time_mins=2, max_eval_time_mins=0.04, population_size=15)
tpot.fit(tele.drop('class',axis=1).loc[training_indices].values, tele.loc[training_indices,'class'].values)
Optimization Progress: 42pipeline [00:42,  1.17s/pipeline]

Generation 1 - Current best internal CV score: 0.86119902629

Optimization Progress: 64pipeline [01:03,  1.04s/pipeline]

Generation 2 - Current best internal CV score: 0.86119902629

Optimization Progress: 83pipeline [01:21,  1.14s/pipeline]

Generation 3 - Current best internal CV score: 0.861689811492

Optimization Progress: 104pipeline [01:45,  1.03pipeline/s]

Generation 4 - Current best internal CV score: 0.861759642796

2.03228221667 minutes have elapsed. TPOT will close down.
TPOT closed prematurely. Will use the current best pipeline.

Best pipeline: XGBClassifier(RobustScaler(SelectPercentile(input_matrix, percentile=85)), learning_rate=0.1, max_depth=2, min_child_weight=4, n_estimators=100, nthread=1, subsample=0.1)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=1000000, max_eval_time_mins=0.04,
        max_time_mins=2, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=15, periodic_checkpoint_folder=None,
        population_size=15, random_state=None, scoring=None, subsample=1.0,
        verbosity=2, warm_start=False)
Seperti yang Anda perhatikan, pengklasifikasi dengan kinerja terbaik dalam kerangka waktu yang ditentukan sekarang adalah XGBoost dengan SelectPercentile() dan RobustScaler() sebagai langkah prapemrosesan.
Menjalankan TPOT tidak sesederhana memfitting satu model pada dataset. Ia mempertimbangkan banyak algoritme machine learning (random forests, model linear, SVM, dan lain-lain) dalam sebuah pipeline dengan banyak langkah prapemrosesan (imputasi nilai hilang, penskalaan, PCA, seleksi fitur, dan sebagainya), hyper-parameter untuk semua model dan langkah prapemrosesan, serta berbagai cara untuk meng-ensemble atau menumpuk algoritme dalam pipeline. Itulah mengapa biasanya memerlukan waktu lama untuk dieksekusi dan tidak layak untuk dataset besar.
Jika Anda bekerja dengan dataset yang cukup kompleks atau menjalankan TPOT dalam waktu singkat, beberapa kali menjalankan TPOT dapat menghasilkan rekomendasi pipeline yang berbeda. Ketika dua kali menjalankan TPOT merekomendasikan pipeline berbeda, ini berarti eksekusi TPOT tidak konvergen karena kurangnya waktu atau bahwa beberapa pipeline berkinerja kurang-lebih sama pada dataset Anda.
Hore! Anda telah sampai di akhir tutorial ini. Anda memulai dengan sedikit pengenalan tentang gagasan di balik platform Automated Machine Learning. Lalu Anda mengeksplorasi sedikit tentang Genetic Programming dan bagaimana TPOT menggunakannya untuk mengotomatisasi proses penyusunan pipeline machine learning. Anda juga berlatih menggunakan pustaka TPOT di Python pada sebuah dataset sembari memperoleh pengetahuan tentang fungsi-fungsi yang disediakannya. Jika Anda berencana menggunakan TPOT di masa mendatang, saya sangat menyarankan Anda melihat dokumentasinya yang sangat baik. Selamat mengeksplorasi!
Jika Anda ingin mempelajari lebih lanjut tentang Machine Learning di Python, ikuti kursus DataCamp Machine Learning with Tree-Based Models in Python. Juga, lihat tutorial DataCamp Introduction to Machine Learning in Python.
Halaman web berikut digunakan sebagai sumber dalam penulisan tutorial ini.
Pelajari lebih lanjut tentang Python dan Machine Learning
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt



