Curso
Entendendo Machine Learning
2 h
308K
Neste tutorial, você vai aprender a usar uma biblioteca bem diferente em Python: tpot. O que torna essa biblioteca única é que ela automatiza todo o pipeline de Machine Learning e entrega o modelo com melhor desempenho para o seu problema. Mais especificamente, você vai aprender:
Vamos nessa!
Antes de resolver um problema de machine learning, existem muitos componentes a considerar, como preparação de dados, seleção de features, engenharia de features, escolha e validação do modelo, ajuste de hiperparâmetros, etc. Em teoria, você pode aplicar uma infinidade de técnicas para cada etapa, mas elas podem performar de forma diferente dependendo do dataset. O desafio é encontrar a combinação que melhor funciona para reduzir o erro nas suas previsões. Por isso, hoje em dia existem esforços para criar algoritmos e plataformas de AutoML, permitindo que qualquer pessoa, mesmo sem grande expertise, construa modelos sem gastar muito tempo ou esforço. Uma dessas plataformas está disponível como uma biblioteca Python: TPOT. Pense na TPOT como sua assistente de Data Science. A TPOT é uma ferramenta de AutoML em Python que otimiza pipelines de machine learning usando programação genética. Ela automatiza a parte mais trabalhosa do processo, explorando de forma inteligente milhares de pipelines possíveis para encontrar o melhor para os seus dados.
from IPython.core.display import Image
Image(filename="/home/manishpathak/DataCamp/tpot/tpot-ml-pipeline.png",width=800,height=800)
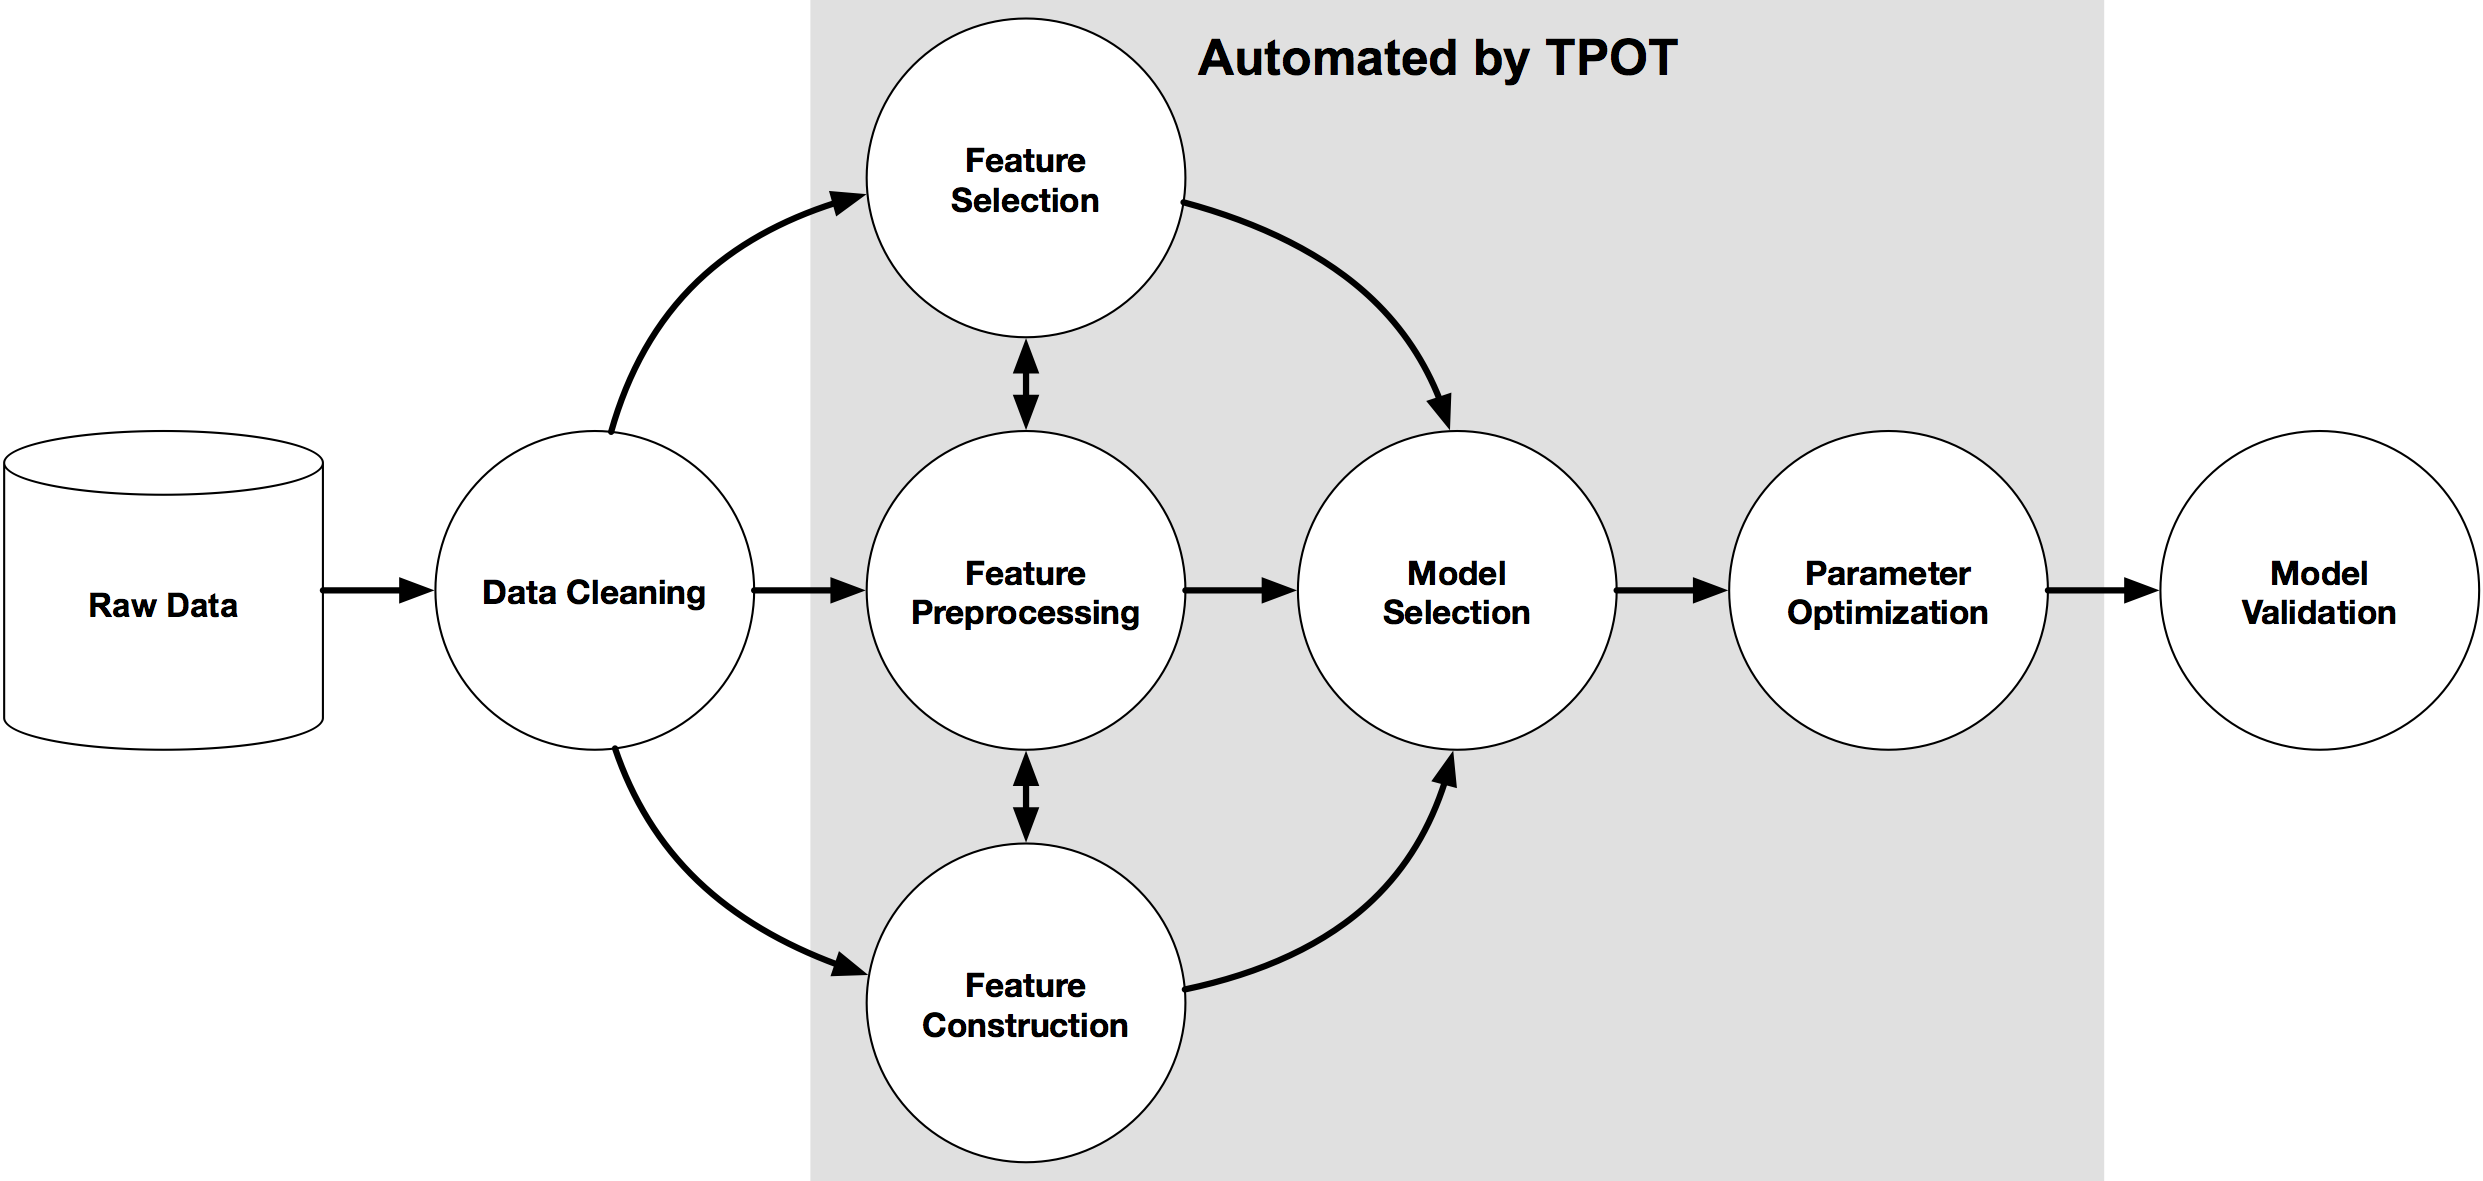
Quando a TPOT termina a busca, ela fornece o código Python do melhor pipeline encontrado para que você possa aprimorar a partir dali.
Para instalar a tpot no seu sistema, execute o comando sudo pip install tpot no terminal ou confira este link. A tpot é construída sobre várias bibliotecas Python, incluindo numpy, scipy, scikit-learn, DEAP, update_checker, tqdm, stopit, pandas. A maior parte desses pacotes pode ser instalada via a distribuição Anaconda, ou separadamente. Opcionalmente, você também pode instalar o XGBoost se quiser que a tpot use modelos de eXtreme Gradient Boosting.
Com os dados certos, poder computacional e um bom modelo de machine learning, você pode encontrar soluções para muitos problemas — mas escolher o modelo ideal pode ser desafiador, já que há várias opções como árvores de decisão, SVM, KNN, etc. É aí que a programação genética pode ajudar bastante. Algoritmos genéticos se inspiram no processo darwinista de seleção natural e são usados para gerar soluções para problemas de otimização e busca em ciência da computação.
De forma geral, algoritmos genéticos têm três propriedades:
Programação genética é um tema amplo, mas se você quiser se aprofundar, confira esta série de vídeos.
Mas como isso se encaixa em data science?
A escolha do melhor modelo de machine learning e dos hiperparâmetros ideais é, por si só, um problema de otimização — perfeito para programação genética. A biblioteca Python tpot, construída sobre o scikit-learn, usa programação genética para otimizar o seu pipeline. Por exemplo, depois de preparar seus dados, você precisa decidir quais features entrarão no modelo e como construí-las. Em seguida, treina o modelo e ajusta os hiperparâmetros para obter o melhor resultado. Em vez de fazer tudo isso manualmente por tentativa e erro, a TPOT automatiza essas etapas com programação genética e, ao final, entrega o código ótimo para você.
Para entender na prática, você vai usar a biblioteca tpot em um dataset open source: o MAGIC Gamma Telescope. Os dados simulam o registro de partículas gama de alta energia em um telescópio Cherenkov atmosférico terrestre usando a técnica de imagem. Para mais detalhes, consulte este link. O dataset possui os seguintes atributos/features:
O objetivo é classificar cada observação como gamma (sinal desejado) ou hadron (ruído de fundo), com base nos atributos fornecidos.
Comece importando as bibliotecas pandas e numpy para leitura e manipulação dos dados.
import pandas as pd
import numpy as np
Use a função read_csv() do pandas para ler o dataset como um DataFrame. Defina também o parâmetro header = None, já que o arquivo não tem nomes de coluna.
telescope_data=pd.read_csv('https://archive.ics.uci.edu/ml/machine-learning-databases/magic/magic04.data',header=None)
Verifique o conteúdo do DataFrame com o método head().
telescope_data.head()

Para nomear as colunas do DataFrame, use o atributo columns e atribua uma lista com os nomes desejados.
telescope_data.columns = ['fLength', 'fWidth','fSize','fConc','fConcl','fAsym','fM3Long','fM3Trans','fAlpha','fDist','class']
telescope_data.head()

Agora o DataFrame também tem nomes de coluna.
Para obter informações como quantidade de valores por coluna, tipo de dado, contagem, média etc., use os métodos info() e describe() do pandas.
telescope_data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 19020 entries, 0 to 19019
Data columns (total 11 columns):
fLength     19020 non-null float64
fWidth      19020 non-null float64
fSize       19020 non-null float64
fConc       19020 non-null float64
fConcl      19020 non-null float64
fAsym       19020 non-null float64
fM3Long     19020 non-null float64
fM3Trans    19020 non-null float64
fAlpha      19020 non-null float64
fDist       19020 non-null float64
class       19020 non-null object
dtypes: float64(10), object(1)
memory usage: 1.6+ MB
telescope_data.describe()

Perceba que todas as features do DataFrame são contínuas. Já a variável alvo class é categórica. Você pode verificar a contagem de cada classe usando value_counts().
telescope_data['class'].value_counts()
g    12332
h     6688
Name: class, dtype: int64
É uma boa prática embaralhar aleatoriamente os dados para evitar qualquer ordenação indesejada. Reorganize o DataFrame usando numpy.random e a função permutation(). Para resetar os índices após o embaralhamento, use reset_index() com drop = True.
telescope_shuffle=telescope_data.iloc[np.random.permutation(len(telescope_data))]
tele=telescope_shuffle.reset_index(drop=True)
tele.head()

Antes de usar a tpot, é essencial rotular variáveis categóricas no DataFrame. Para saber mais sobre isso, veja este tutorial. Aqui, apenas a variável alvo class é categórica, então o tratamento será nessa coluna. Vamos substituir a classe g (sinal) pelo valor numérico 0 e a classe h (fundo) por 1. Isso pode ser feito com a função map() passando um dicionário com o mapeamento.
tele['class']=tele['class'].map({'g':0,'h':1})

tele.head()

Agora, armazene os rótulos da classe, que você quer prever, em uma variável separada tele_class.
tele_class = tele['class'].values
Você também deve tratar valores ausentes antes de usar a tpot. Para verificar o número de ausências por coluna, execute:
pd.isnull(tele).any()
fLength     False
fWidth      False
fSize       False
fConc       False
fConcl      False
fAsym       False
fM3Long     False
fM3Trans    False
fAlpha      False
fDist       False
class       False
dtype: bool
Este dataset não tem valores ausentes. Observação: em datasets com ausências, você pode remover linhas/colunas com dropna() ou substituir pelos valores desejados com fillna(). Por exemplo, o código abaixo substitui NA por -999.
tele = tele.fillna(-999)
Agora, divida o DataFrame em conjuntos de treino e teste, como em qualquer projeto de machine learning. Você pode usar o train_test_split do sklearn (módulo cross_validation). Os parâmetros são: tele.index como índices, train_size = 0.75 para manter 75% no treino, test_size = 0.25 para os 25% restantes no teste, e stratify = tele_class para estratificar pelos rótulos. Observação: o conjunto de validação aqui serve para estimar o erro no teste e é igual ao conjunto de teste.
from sklearn.cross_validation import train_test_split
training_indices, validation_indices = training_indices, testing_indices = train_test_split(tele.index,
                                                                                            stratify = tele_class,
                                                                                            train_size=0.75, test_size=0.25)
Verifique o tamanho dos conjuntos de treino e validação com o atributo size.
training_indices.size, validation_indices.size
(14265, 4755)
Agora é hora de usar a biblioteca tpot para sugerir o melhor pipeline para este problema de classificação binária. Para isso, importe a classe TPOTClassifier da biblioteca tpot. Se fosse um problema de regressão, você usaria TPOTRegressor.
O TPOTClassifier tem vários parâmetros; você pode ver todos aqui. Os principais são:
accuracy, average_precision, roc_auc, recall, etc. Padrão: accuracy.Também lembre: mutation_rate + crossover_rate não pode ultrapassar 1.0.
Aqui, vamos usar a tpot com generations = 5 e o restante nos valores padrão. O parâmetro verbosity = 2 define o quanto a TPOT relata durante a execução.
Depois, chame o método fit() com o conjunto de treino (sem a coluna alvo) e a coluna alvo como argumentos.
Atenção: executar o código abaixo leva várias horas. Com essas configurações (5 gerações e população de 100), a TPOT avalia 500 configurações de pipeline. Para comparar, pense em um grid search com 500 combinações de hiperparâmetros e validação cruzada 5-fold — são ~2500 modelos ajustados e avaliados. É um processo demorado! Mais adiante, você verá parâmetros para controlar o tempo de execução.
from tpot import TPOTClassifier
from tpot import TPOTRegressor

tpot = TPOTClassifier(generations=5,verbosity=2)

tpot.fit(tele.drop('class',axis=1).loc[training_indices].values,
         tele.loc[training_indices,'class'].values)
Optimization Progress:  33%|███▎      | 200/600 [41:43<1:51:41, 16.75s/pipeline]

Generation 1 - Current best internal CV score: 0.880266061124

Optimization Progress:  50%|█████     | 300/600 [1:14:37<46:57,  9.39s/pipeline]

Generation 2 - Current best internal CV score: 0.880266061124

Optimization Progress:  67%|██████▋   | 400/600 [1:59:17<2:21:21, 42.41s/pipeline]

Generation 3 - Current best internal CV score: 0.880266061124

Optimization Progress:  84%|████████▎ | 501/600 [3:01:12<1:02:16, 37.74s/pipeline]

Generation 4 - Current best internal CV score: 0.881597992166

Generation 5 - Current best internal CV score: 0.881597992166

Best pipeline: GradientBoostingClassifier(RobustScaler(PolynomialFeatures(input_matrix, degree=2, include_bias=False, interaction_only=False)), learning_rate=0.1, max_depth=6, max_features=0.6000000000000001, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=5, max_eval_time_mins=5,
        max_time_mins=None, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=100, periodic_checkpoint_folder=None,
        population_size=100, random_state=None, scoring=None,
        subsample=1.0, verbosity=2, warm_start=False)
Acima, foram computadas 5 gerações, cada uma reportando a eficiência (via CV) no treino. O melhor pipeline obteve acurácia de 88,16% em CV. Esse pipeline inclui etapas de pré-processamento como PolynomialFeatures e RobustScaler, que criam features sintéticas e as normalizam, seguidas de um Gradient Boosting para gerar as previsões finais. Note que a tpot também retorna os hiperparâmetros, como learning_rate, max_depth etc., juntamente com o classificador.
Em seguida, calculamos o erro no teste para validação.
tpot.score(tele.drop('class',axis=1).loc[validation_indices].values,
           tele.loc[validation_indices, 'class'].values)
0.885173501577287
Como pode ser visto, a acurácia no teste é 88,51%.
Por fim, você pode pedir para a TPOT exportar o código Python do pipeline otimizado para um arquivo de texto com a função export:
tpot.export('tpot_MAGIC_Gamma_Telescope_pipeline.py')
True
## Este é o pipeline que a tpot gerou: tpot_MAGIC_Gamma_Telescope_pipeline.py
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, RobustScaler

# OBS: certifique-se de que a coluna alvo esteja nomeada como 'target' no arquivo de dados
tpot_data = pd.read_csv('PATH/TO/DATA/FILE', sep='COLUMN_SEPARATOR', dtype=np.float64)
features = tpot_data.drop('target', axis=1).values
training_features, testing_features, training_target, testing_target = \
            train_test_split(features, tpot_data['target'].values, random_state=42)

# Score no conjunto de treino foi:0.881597992166
exported_pipeline = make_pipeline(
    PolynomialFeatures(degree=2, include_bias=False, interaction_only=False),
    RobustScaler(),
    GradientBoostingClassifier(learning_rate=0.1, max_depth=6, max_features=0.6, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)
)

exported_pipeline.fit(training_features, training_target)
results = exported_pipeline.predict(testing_features)
Demais, né? Sem precisar ajustar manualmente um monte de parâmetros para achar o melhor modelo, a TPOT não só informa qual é o melhor pipeline como também gera um código funcional para você!
Como dito, a última execução da TPOT levou horas. Há parâmetros para controlar esse tempo, mas com trade-offs. Ao limitar a execução, a TPOT não conseguirá explorar todos os pipelines possíveis; assim, o melhor modelo dentro do tempo pode não ser o absolutamente melhor para o dataset. Ainda assim, com tempo suficiente, chega-se perto do ótimo. Alguns parâmetros:
None, substitui generations e roda até o tempo expirar.n_jobs=-1 usa todos os núcleos disponíveis. Cuidado com uso de memória em datasets grandes. Padrão: 1.Para praticar, vamos rodar a TPOT novamente com max_time_mins = 2 e max_eval_time_mins = 0.04, desta vez com population_size = 15.
tpot = TPOTClassifier(verbosity=2, max_time_mins=2, max_eval_time_mins=0.04, population_size=15)
tpot.fit(tele.drop('class',axis=1).loc[training_indices].values, tele.loc[training_indices,'class'].values)
Optimization Progress: 42pipeline [00:42,  1.17s/pipeline]

Generation 1 - Current best internal CV score: 0.86119902629

Optimization Progress: 64pipeline [01:03,  1.04s/pipeline]

Generation 2 - Current best internal CV score: 0.86119902629

Optimization Progress: 83pipeline [01:21,  1.14s/pipeline]

Generation 3 - Current best internal CV score: 0.861689811492

Optimization Progress: 104pipeline [01:45,  1.03pipeline/s]

Generation 4 - Current best internal CV score: 0.861759642796

2.03228221667 minutes have elapsed. TPOT will close down.
TPOT closed prematurely. Will use the current best pipeline.

Best pipeline: XGBClassifier(RobustScaler(SelectPercentile(input_matrix, percentile=85)), learning_rate=0.1, max_depth=2, min_child_weight=4, n_estimators=100, nthread=1, subsample=0.1)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=1000000, max_eval_time_mins=0.04,
        max_time_mins=2, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=15, periodic_checkpoint_folder=None,
        population_size=15, random_state=None, scoring=None, subsample=1.0,
        verbosity=2, warm_start=False)
Como você pode notar, dentro do tempo limitado o melhor classificador foi o XGBoost, com SelectPercentile() e RobustScaler() no pré-processamento.
Rodar a TPOT não é tão simples quanto ajustar um único modelo no dataset. Ela considera múltiplos algoritmos (random forests, modelos lineares, SVMs, etc.) em um pipeline com diversas etapas de pré-processamento (imputação de ausentes, padronização, PCA, seleção de features, etc.), os hiperparâmetros de todos os modelos e etapas, além de diferentes formas de ensemble ou stacking. Por isso, normalmente leva bastante tempo e pode ser inviável em datasets muito grandes.
Se você estiver lidando com um dataset razoavelmente complexo ou rodar a TPOT por pouco tempo, execuções diferentes podem resultar em pipelines distintos. Quando duas execuções recomendam pipelines diferentes, isso indica que a busca não convergiu por falta de tempo ou que vários pipelines têm desempenhos muito parecidos no seu dataset.
Uhul! Você chegou ao fim deste tutorial. Começamos com uma introdução à ideia por trás de plataformas de AutoML. Depois, exploramos programação genética e como a TPOT a utiliza para automatizar a construção de pipelines. Você também praticou o uso da TPOT em Python em um dataset real e conheceu as principais funções que ela oferece. Se pretende usar a TPOT no futuro, recomendo fortemente consultar sua excelente documentação. Boas explorações!
Se você quer aprender mais sobre Machine Learning em Python, faça o curso Machine Learning with Tree-Based Models in Python da DataCamp. Também confira o tutorial Introduction to Machine Learning in Python da DataCamp.
As páginas abaixo foram usadas como referência para este tutorial.
Aprenda mais sobre Python e Machine Learning
Curso
Curso
Curso
Tutorial
Kurtis Pykes
11 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Moez Ali
14 min
Tutorial
Avinash Navlani
10 min





