
Last chance! 50% off DataCamp Premium
Sale ends in
In questo tutorial imparerai a usare una libreria davvero unica in Python: tpot. Il motivo per cui questa libreria è unica è che automatizza l’intera pipeline di Machine Learning e ti fornisce il modello di machine learning con le prestazioni migliori. In particolare, imparerai:
Iniziamo!
Prima di risolvere un problema di machine learning devi considerare molti componenti, tra cui preparazione dei dati, selezione e ingegnerizzazione delle feature, selezione e validazione del modello, tuning degli iperparametri, ecc. In teoria, per ognuno di questi componenti puoi trovare e applicare una miriade di tecniche, ma potrebbero comportarsi in modo diverso su dataset diversi. La sfida è trovare la combinazione di tecniche con le prestazioni migliori, così da minimizzare l’errore nelle tue previsioni. È questo il motivo principale per cui oggi si lavora allo sviluppo di algoritmi e piattaforme di Auto-ML, in modo che chiunque, anche senza competenze specifiche di machine learning, possa costruire modelli senza spendere troppo tempo o sforzo. Una di queste piattaforme è disponibile come libreria Python: TPOT. Puoi considerare TPOT come il tuo assistente di Data Science. TPOT è uno strumento di Automated Machine Learning in Python che ottimizza le pipeline di machine learning usando la programmazione genetica. Automatizzerà la parte più noiosa del machine learning esplorando in modo intelligente migliaia di possibili pipeline per trovare la migliore per i tuoi dati.
from IPython.core.display import Image
Image(filename="/home/manishpathak/DataCamp/tpot/tpot-ml-pipeline.png",width=800,height=800)
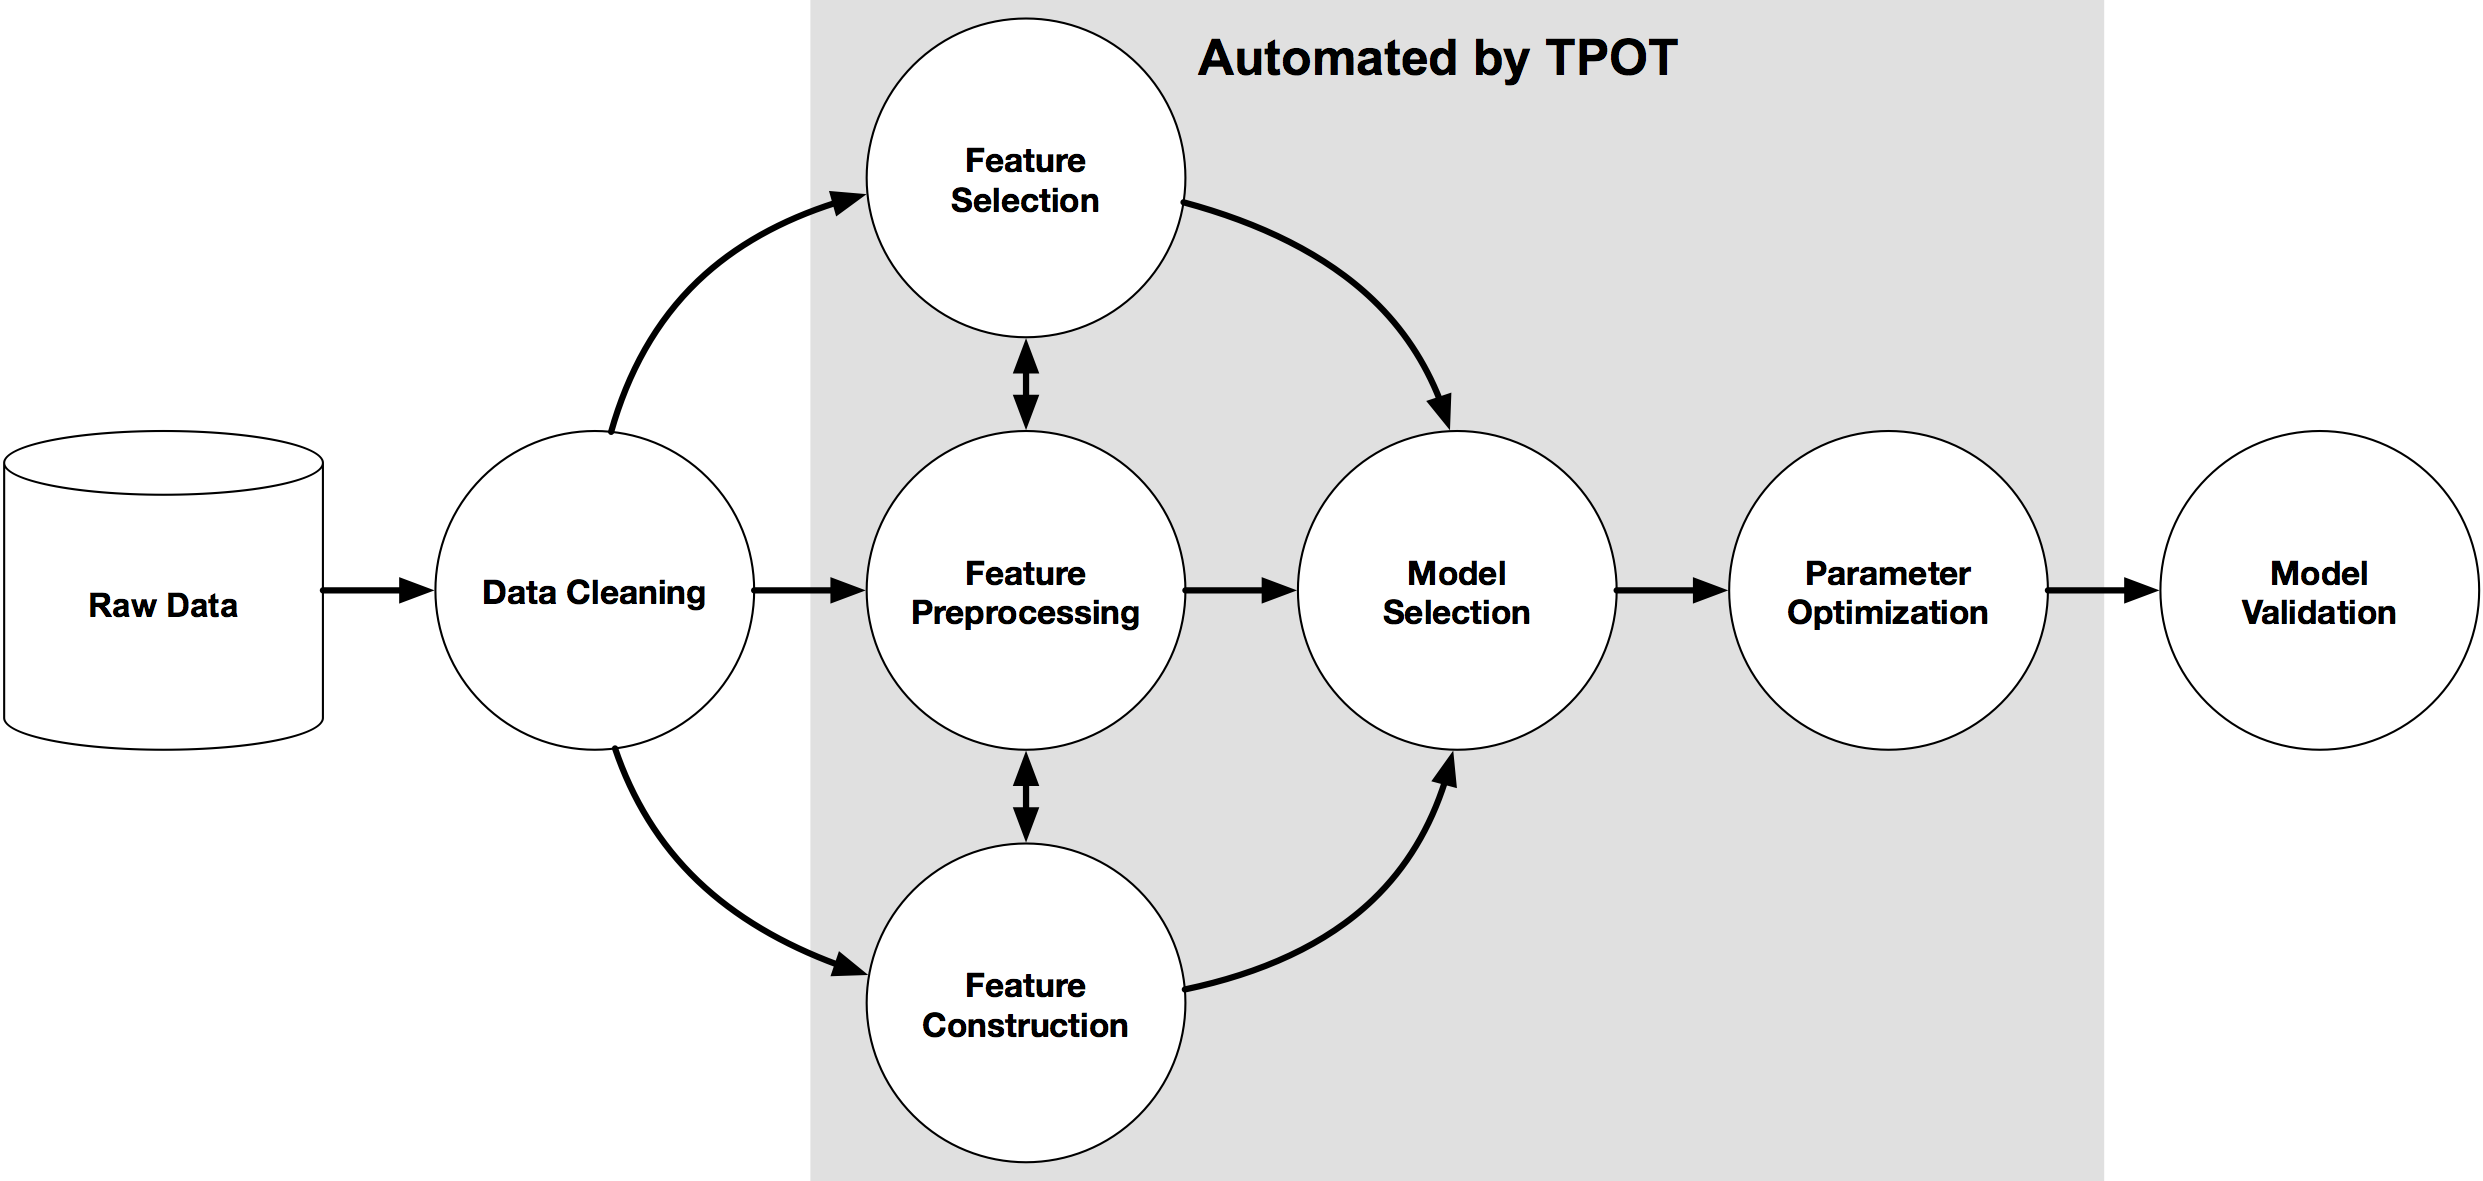
Una volta terminata la ricerca, TPOT ti fornisce il codice Python per la migliore pipeline trovata, così puoi modificarla a partire da lì.
Per installare tpot sul tuo sistema, puoi eseguire il comando sudo pip install tpot nel terminale oppure consultare questo link. tpot è costruito sopra diverse librerie Python esistenti, tra cui numpy, scipy, scikit-learn, DEAP, update_checker, tqdm, stopit, pandas. La maggior parte dei pacchetti necessari può essere installata tramite la distribuzione Anaconda, oppure puoi installarli separatamente. Facoltativamente, puoi anche installare XGBoost se vuoi che tpot utilizzi i modelli di eXtreme Gradient Boosting.
Con i dati giusti, potenza di calcolo e modello di machine learning adeguato puoi trovare una soluzione a qualsiasi problema, ma scegliere quale modello usare può essere difficile, perché ce ne sono tantissimi, come Decision Trees, SVM, KNN, ecc. È qui che la programmazione genetica può essere molto utile. Gli algoritmi genetici sono ispirati al processo darwiniano di selezione naturale e vengono usati per generare soluzioni a problemi di ottimizzazione e ricerca in informatica.
In termini generali, gli Algoritmi Genetici hanno tre proprietà:
La Programmazione Genetica è un grande argomento in informatica, ma se vuoi approfondire gli algoritmi genetici guarda questa serie di video.
Ma come si inserisce tutto questo nella data science?
Ebbene, risulta che scegliere il giusto modello di machine learning e tutti i migliori iperparametri per quel modello è di per sé un problema di ottimizzazione per cui si può usare la programmazione genetica. La libreria Python tpot, costruita su scikit-learn, usa la programmazione genetica per ottimizzare la tua pipeline di machine learning. Per esempio, nel machine learning, dopo aver preparato i dati devi sapere quali feature fornire al modello e come costruirle. Una volta ottenute, le passi al modello per l’addestramento e poi effettui il tuning degli iperparametri per ottenere risultati ottimali. Invece di fare tutto questo da solo per tentativi ed errori, TPOT automatizza questi passaggi con la programmazione genetica e, al termine, ti restituisce il codice ottimale.
Per capire meglio, farai pratica con la libreria tpot su un dataset open source. Il dataset che userai è MAGIC Gamma Telescope DataSet. I dati sono generati per simulare la registrazione di particelle gamma ad alta energia in un telescopio Cherenkov atmosferico a base terrestre usando la tecnica di imaging. Per i dettagli completi sulla descrizione del dataset consulta questo link. Il dataset ha i seguenti attributi/feature:
L’obiettivo è classificare un’osservazione come gamma, cioè il segnale desiderato, o adrone, cioè il rumore di fondo, in base agli attributi forniti.
Inizierai importando le librerie pandas e numpy per leggere i dati e svolgere i calcoli.
import pandas as pd
import numpy as np
Usa la funzione read_csv() di pandas per leggere il dataset come DataFrame. Specifica anche il parametro header = None dato che il dataset non ha ancora i nomi delle colonne.
telescope_data=pd.read_csv('https://archive.ics.uci.edu/ml/machine-learning-databases/magic/magic04.data',header=None)
Controlla il contenuto del DataFrame usando il metodo head().
telescope_data.head()

Per dare un nome alle colonne del DataFrame, puoi usare l’attributo columns sul DataFrame pandas e assegnargli una lista con i nomi delle colonne.
telescope_data.columns = ['fLength', 'fWidth','fSize','fConc','fConcl','fAsym','fM3Long','fM3Trans','fAlpha','fDist','class']
telescope_data.head()

Ora nel tuo DataFrame ci sono anche i nomi delle colonne.
Per ottenere le informazioni necessarie sul DataFrame, come numero di valori in ogni colonna, tipo di dato, count, media, ecc., puoi usare i metodi info() e describe() di pandas.
telescope_data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 19020 entries, 0 to 19019
Data columns (total 11 columns):
fLength     19020 non-null float64
fWidth      19020 non-null float64
fSize       19020 non-null float64
fConc       19020 non-null float64
fConcl      19020 non-null float64
fAsym       19020 non-null float64
fM3Long     19020 non-null float64
fM3Trans    19020 non-null float64
fAlpha      19020 non-null float64
fDist       19020 non-null float64
class       19020 non-null object
dtypes: float64(10), object(1)
memory usage: 1.6+ MB
telescope_data.describe()

Si scopre che tutte le feature nel DataFrame sono continue per natura. La variabile/feature target class è invece categoriale. Puoi controllare le occorrenze di ciascuna classe nella variabile target usando il metodo value_counts().
telescope_data['class'].value_counts()
g    12332
h     6688
Name: class, dtype: int64
In genere è una buona idea mescolare casualmente i dati prima di iniziare, per evitare qualsiasi tipo di ordinamento. Puoi riordinare i dati nel DataFrame usando random e la funzione permutation() di numpy. Per reimpostare gli indici dopo lo shuffle usa il metodo reset_index() con parametro drop = True.
telescope_shuffle=telescope_data.iloc[np.random.permutation(len(telescope_data))]
tele=telescope_shuffle.reset_index(drop=True)
tele.head()

Prima di usare tpot, è essenziale etichettare le variabili categoriche nel tuo DataFrame. Per saperne di più sull’etichettatura delle variabili categoriche guarda questo tutorial. Qui solo la variabile target class è categoriale, quindi il trattamento va fatto su quella colonna. Sostituirai la classe g (segnale) con il valore numerico 0 e la classe h (fondo) con il valore numerico 1. Questo si ottiene con la funzione map() passando un dizionario che contiene la mappatura delle classi della variabile target.
tele['class']=tele['class'].map({'g':0,'h':1})

tele.head()

Ora memorizza le etichette di classe, che devi prevedere, in una variabile separata tele_class.
tele_class = tele['class'].values
Dovresti anche gestire i valori mancanti prima di usare tpot. Per controllare il numero di valori mancanti per colonna, puoi eseguire quanto segue:
pd.isnull(tele).any()
fLength     False
fWidth      False
fSize       False
fConc       False
fConcl      False
fAsym       False
fM3Long     False
fM3Trans    False
fAlpha      False
fDist       False
class       False
dtype: bool
Questo dataset non ha valori mancanti. Nota che nei dataset con valori mancanti puoi o eliminare righe/colonne usando il metodo dropna() oppure sostituire i valori mancanti con un valore fittizio usando fillna(). Per esempio, il seguente blocco di codice sostituirà i valori NA con il valore fittizio -999.
tele = tele.fillna(-999)
Ora dividerai il DataFrame in un set di training e uno di test, come fai in qualsiasi attività di modellazione di machine learning. Puoi farlo tramite cross_validation di sklearn con train_test_split. I parametri sono tele.index come indici del DataFrame, train_size = 0.75 per mantenere il 75% dei dati nel training set, test_size = 0.25 per tenere il restante 25% nel test set e stratify = tele_class per stratificare in base ai valori delle etichette di classe nel dataset. Nota il validation set serve soltanto a darci un’idea dell’errore sul test set. Qui è mantenuto uguale al test set.
from sklearn.cross_validation import train_test_split
training_indices, validation_indices = training_indices, testing_indices = train_test_split(tele.index,
                                                                                            stratify = tele_class,
                                                                                            train_size=0.75, test_size=0.25)
Puoi controllare la dimensione del training set e del validation set usando l’attributo size.
training_indices.size, validation_indices.size
(14265, 4755)
Ora è il momento di usare la libreria tpot per farci suggerire la migliore pipeline per questo problema di classificazione binaria. Per farlo, devi importare la classe TPOTClassifier dalla libreria tpot. Se fosse stato un problema di regressione avresti importato la classe TPOTRegressor.
TPOTClassifier ha una vasta gamma di parametri; puoi leggerli tutti qui. Ma quelli più importanti da conoscere sono:
accuracy, average_precision, roc_auc, recall, ecc. Il valore predefinito è accuracy.Ricorda anche che mutation_rate + crossover_rate non può superare 1.0.
Qui userai tpot con generations = 5 e gli altri parametri ai valori predefiniti. Il parametro verbosity = 2 indica quante informazioni TPOT comunica durante l’esecuzione.
Poi chiamerai il metodo fit() passando come argomenti il training set (senza la colonna target) e la colonna target.
Nota l’esecuzione del codice nella cella sottostante richiederà diverse ore. Con le impostazioni date (5 generazioni con popolazione di 100), TPOT valuterà 500 configurazioni di pipeline prima di terminare. Per contestualizzare, pensa a una grid search di 500 combinazioni di iperparametri per un algoritmo di machine learning e a quanto tempo richiederebbe. Sono 500 configurazioni di modello da valutare con cross-validation a 5 fold, il che significa che in una grid search vengono approssimativamente addestrati e valutati 2500 modelli sui dati di training. È una procedura dispendiosa in tempo! Più avanti conoscerai altri argomenti che puoi passare a TPOTClassifier per controllare il tempo di esecuzione di TPOT.
from tpot import TPOTClassifier
from tpot import TPOTRegressor

tpot = TPOTClassifier(generations=5,verbosity=2)

tpot.fit(tele.drop('class',axis=1).loc[training_indices].values,
         tele.loc[training_indices,'class'].values)
Optimization Progress:  33%|███▎      | 200/600 [41:43<1:51:41, 16.75s/pipeline]

Generation 1 - Current best internal CV score: 0.880266061124

Optimization Progress:  50%|█████     | 300/600 [1:14:37<46:57,  9.39s/pipeline]

Generation 2 - Current best internal CV score: 0.880266061124

Optimization Progress:  67%|██████▋   | 400/600 [1:59:17<2:21:21, 42.41s/pipeline]

Generation 3 - Current best internal CV score: 0.880266061124

Optimization Progress:  84%|████████▎ | 501/600 [3:01:12<1:02:16, 37.74s/pipeline]

Generation 4 - Current best internal CV score: 0.881597992166

Generation 5 - Current best internal CV score: 0.881597992166

Best pipeline: GradientBoostingClassifier(RobustScaler(PolynomialFeatures(input_matrix, degree=2, include_bias=False, interaction_only=False)), learning_rate=0.1, max_depth=6, max_features=0.6000000000000001, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=5, max_eval_time_mins=5,
        max_time_mins=None, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=100, periodic_checkpoint_folder=None,
        population_size=100, random_state=None, scoring=None,
        subsample=1.0, verbosity=2, warm_start=False)
Qui sopra sono state calcolate 5 generazioni, ognuna con l’efficienza in training del modello sul training set. Come si vede, la migliore pipeline è quella con accuratezza in CV pari all’88,16%. Il modello che produce questo risultato è la pipeline composta da tecniche di pre-processing come PolynomialFeatures e poi RobustScaler, che aggiungono feature sintetiche ai dati in input e le normalizzano, e infine da un classificatore Gradient Boosting che produce le predizioni finali. Puoi anche notare che tpot fornisce vari valori di iperparametri come learning_rate, max_depth, ecc., insieme al classificatore.
Successivamente, viene calcolato l’errore sul test per scopi di validazione.
tpot.score(tele.drop('class',axis=1).loc[validation_indices].values,
           tele.loc[validation_indices, 'class'].values)
0.885173501577287
Come si vede, l’accuratezza sul test è 88,51%.
Infine, puoi dire a TPOT di esportare il codice Python corrispondente alla pipeline ottimizzata in un file di testo con la funzione export:
tpot.export('tpot_MAGIC_Gamma_Telescope_pipeline.py')
True
## This is the pipeline that tpot generated: tpot_MAGIC_Gamma_Telescope_pipeline.py
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, RobustScaler

# NOTE: Make sure that the class is labeled 'target' in the data file
tpot_data = pd.read_csv('PATH/TO/DATA/FILE', sep='COLUMN_SEPARATOR', dtype=np.float64)
features = tpot_data.drop('target', axis=1).values
training_features, testing_features, training_target, testing_target = \
            train_test_split(features, tpot_data['target'].values, random_state=42)

# Score on the training set was:0.881597992166
exported_pipeline = make_pipeline(
    PolynomialFeatures(degree=2, include_bias=False, interaction_only=False),
    RobustScaler(),
    GradientBoostingClassifier(learning_rate=0.1, max_depth=6, max_features=0.6, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)
)

exported_pipeline.fit(training_features, training_target)
results = exported_pipeline.predict(testing_features)
Non è fantastico? Senza dover armeggiare con un sacco di parametri e opzioni per ottenere il modello migliore, TPOT non solo ti ha dato informazioni sul modello ottimale, ma anche un codice funzionante!
Come accennato, l’ultima esecuzione di TPOT ha richiesto diverse ore. Ci sono però alcuni parametri che puoi specificare per controllare il tempo di esecuzione di TPOT, ma con un compromesso. Poiché limiterai il tempo di esecuzione, TPOT non potrà esplorare tutte le possibili pipeline e quindi il modello migliore suggerito entro il limite di tempo potrebbe non essere il migliore possibile per quel dataset. Tuttavia, se si dà tempo sufficiente, sarà comunque abbastanza vicino al modello ottimale. Alcuni parametri sono:
None, questa impostazione sovrascrive il parametro generations e consente a TPOT di girare finché non sono trascorsi max_time_mins minuti.n_jobs=-1 userà tutti i core disponibili sulla macchina. Attenzione: usare più processi sulla stessa macchina può causare problemi di memoria con dataset grandi. Predefinito 1.Per esercizio, eseguirai di nuovo TPOT con argomenti aggiuntivi max_time_mins = 2 e max_eval_time_mins = 0.04, ma questa volta con population_size = 15 ridotta.
tpot = TPOTClassifier(verbosity=2, max_time_mins=2, max_eval_time_mins=0.04, population_size=15)
tpot.fit(tele.drop('class',axis=1).loc[training_indices].values, tele.loc[training_indices,'class'].values)
Optimization Progress: 42pipeline [00:42,  1.17s/pipeline]

Generation 1 - Current best internal CV score: 0.86119902629

Optimization Progress: 64pipeline [01:03,  1.04s/pipeline]

Generation 2 - Current best internal CV score: 0.86119902629

Optimization Progress: 83pipeline [01:21,  1.14s/pipeline]

Generation 3 - Current best internal CV score: 0.861689811492

Optimization Progress: 104pipeline [01:45,  1.03pipeline/s]

Generation 4 - Current best internal CV score: 0.861759642796

2.03228221667 minutes have elapsed. TPOT will close down.
TPOT closed prematurely. Will use the current best pipeline.

Best pipeline: XGBClassifier(RobustScaler(SelectPercentile(input_matrix, percentile=85)), learning_rate=0.1, max_depth=2, min_child_weight=4, n_estimators=100, nthread=1, subsample=0.1)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=1000000, max_eval_time_mins=0.04,
        max_time_mins=2, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=15, periodic_checkpoint_folder=None,
        population_size=15, random_state=None, scoring=None, subsample=1.0,
        verbosity=2, warm_start=False)
Come puoi notare, il classificatore con le prestazioni migliori entro il tempo specificato è ora XGBoost con SelectPercentile() e RobustScaler() come passaggi di pre-processing.
Eseguire TPOT non è semplice come addestrare un solo modello sul dataset. Considera molteplici algoritmi di machine learning (random forest, modelli lineari, SVM, ecc.) in una pipeline con numerosi passaggi di pre-processing (imputazione dei valori mancanti, scaling, PCA, selezione delle feature, ecc.), gli iperparametri di tutti i modelli e dei passaggi di pre-processing, oltre a più modi per fare ensemble o stacking degli algoritmi nella pipeline. Ecco perché di solito richiede molto tempo e non è praticabile per dataset molto grandi.
Se lavori con un dataset ragionevolmente complesso o esegui TPOT per poco tempo, esecuzioni diverse di TPOT possono portare a raccomandazioni di pipeline differenti. Quando due esecuzioni raccomandano pipeline diverse, significa che non sono converste per mancanza di tempo o che più pipeline hanno prestazioni più o meno equivalenti sul tuo dataset.
Urrà! Sei arrivato alla fine di questo tutorial. Hai iniziato con una breve introduzione all’idea alla base delle piattaforme di Automated Machine Learning. Poi hai esplorato un po’ la Programmazione Genetica e come TPOT la usa per automatizzare la costruzione delle pipeline di machine learning. Hai anche fatto pratica con la libreria TPOT in Python su un dataset, acquisendo conoscenza delle funzioni che offre. Se pensi di usare TPOT in futuro, ti consiglio vivamente di consultare la sua eccellente documentazione. Buona esplorazione!
Se vuoi imparare di più sul Machine Learning in Python, segui il corso di DataCamp Machine Learning with Tree-Based Models in Python. Dai un’occhiata anche al tutorial di DataCamp Introduction to Machine Learning in Python.
Le seguenti pagine web sono state usate come fonti per la stesura di questo tutorial.
Scopri di più su Python e Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



