Curso
Comprender el machine learning
2 h
308.6K
En este tutorial, aprenderás a usar una librería muy particular en Python: tpot. ¿Por qué es única? Porque automatiza toda la canalización de Machine Learning y te entrega el modelo que mejor rendimiento obtiene. En concreto, verás:
¡Vamos allá!
Antes de resolver un problema de machine learning, hay muchos componentes a tener en cuenta: preparación de datos, selección y creación de características, elección y validación del modelo, ajuste de hiperparámetros, etc. En teoría, puedes aplicar multitud de técnicas en cada paso, pero su rendimiento varía según el conjunto de datos. El reto es encontrar la combinación que mejor funcione para minimizar el error de tus predicciones. Por eso hoy en día se desarrollan algoritmos y plataformas de Auto-ML: para que cualquiera, sin ser experto en machine learning, pueda crear modelos sin invertir demasiado tiempo ni esfuerzo. Una de estas plataformas está disponible como librería de Python: TPOT. Piensa en TPOT como tu asistente de ciencia de datos. TPOT es una herramienta de AutoML en Python que optimiza canalizaciones de machine learning usando programación genética. Automatiza la parte más tediosa explorando de forma inteligente miles de canalizaciones posibles para encontrar la mejor para tus datos.
from IPython.core.display import Image
Image(filename="/home/manishpathak/DataCamp/tpot/tpot-ml-pipeline.png",width=800,height=800)
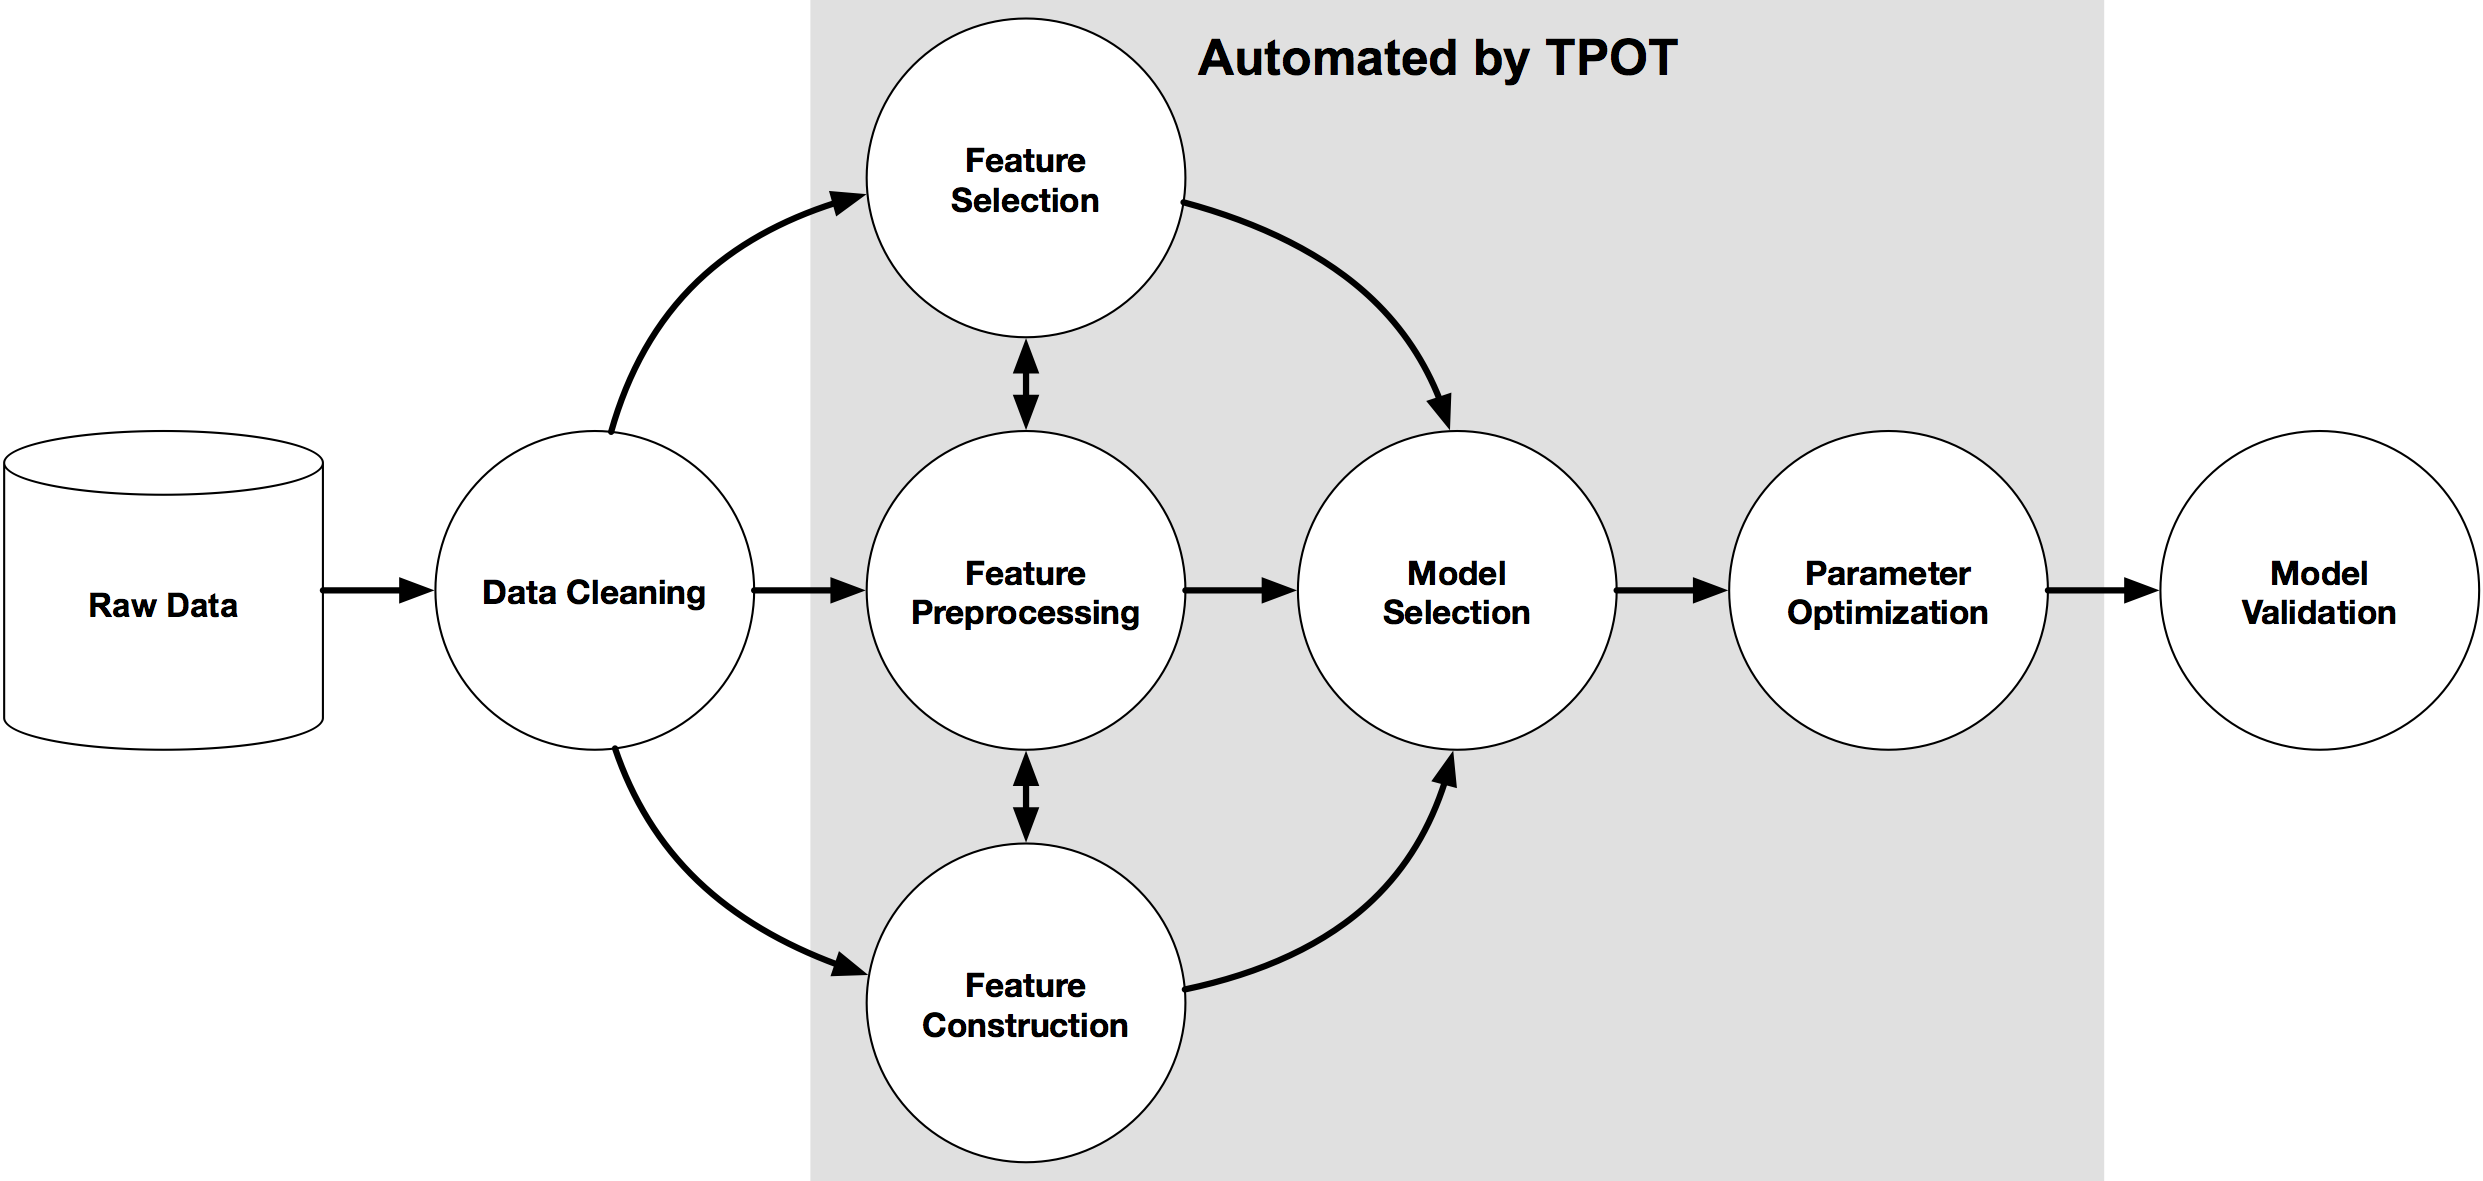
Cuando TPOT termina su búsqueda, te proporciona el código Python de la mejor canalización encontrada para que puedas ajustarla a partir de ahí.
Para instalar tpot en tu sistema, ejecuta el comando sudo pip install tpot en la terminal o consulta este enlace. tpot se apoya en varias librerías existentes de Python, como numpy, scipy, scikit-learn, DEAP, update_checker, tqdm, stopit, pandas. La mayoría de los paquetes necesarios se pueden instalar con la distribución Anaconda de Python, aunque también puedes instalarlos por separado. Opcionalmente, puedes instalar XGBoost si quieres que tpot utilice modelos de eXtreme Gradient Boosting.
Con los datos adecuados, potencia de cómputo y el modelo de machine learning apropiado puedes encontrar soluciones a multitud de problemas, pero elegir el modelo correcto no es trivial: hay muchísimos (árboles de decisión, SVM, KNN, etc.). Ahí es donde la programación genética puede ser muy útil. Los algoritmos genéticos se inspiran en la selección natural darwinista y se usan para generar soluciones a problemas de optimización y búsqueda en informática.
De forma general, los algoritmos genéticos tienen tres propiedades:
La programación genética es un tema amplio, pero si quieres profundizar, echa un vistazo a esta serie de vídeos.
¿Y cómo encaja todo esto en data science?
Resulta que elegir el modelo de machine learning y sus mejores hiperparámetros es en sí un problema de optimización, perfecto para aplicar programación genética. La librería de Python tpot, construida sobre scikit-learn, usa programación genética para optimizar tu canalización de machine learning. Por ejemplo, tras preparar los datos, debes decidir qué variables introducir al modelo y cómo construirlas. Luego entrenas y ajustas hiperparámetros para lograr resultados óptimos. En lugar de hacerlo a base de ensayo y error, TPOT automatiza estos pasos con programación genética y, al finalizar, te devuelve el código óptimo.
Para entenderlo mejor, practicarás con tpot sobre un dataset de código abierto: MAGIC Gamma Telescope DataSet. Los datos simulan el registro de partículas gamma de alta energía en un telescopio Cherenkov atmosférico utilizando la técnica de imagen. Para ver la descripción completa del conjunto de datos, consulta este enlace. El dataset incluye los siguientes atributos/características:
El objetivo es clasificar cada observación como gamma (la señal deseada) o hadrón (ruido de fondo) en función de los atributos.
Empieza importando las librerías pandas y numpy para leer y procesar los datos.
import pandas as pd
import numpy as np
Usa la función read_csv() de pandas para leer el dataset como un DataFrame. Indica también el parámetro header = None porque el fichero no trae nombres de columnas.
telescope_data=pd.read_csv('https://archive.ics.uci.edu/ml/machine-learning-databases/magic/magic04.data',header=None)
Consulta el contenido del DataFrame con el método head().
telescope_data.head()

Para asignar nombres a las columnas, usa el atributo columns del DataFrame y pásale una lista con los nombres.
telescope_data.columns = ['fLength', 'fWidth','fSize','fConc','fConcl','fAsym','fM3Long','fM3Trans','fAlpha','fDist','class']
telescope_data.head()

Ya tienes también los nombres de columna en tu DataFrame.
Para obtener información útil del DataFrame como número de valores por columna, tipos, conteos, medias, etc., usa los métodos info() y describe() de pandas.
telescope_data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 19020 entries, 0 to 19019
Data columns (total 11 columns):
fLength     19020 non-null float64
fWidth      19020 non-null float64
fSize       19020 non-null float64
fConc       19020 non-null float64
fConcl      19020 non-null float64
fAsym       19020 non-null float64
fM3Long     19020 non-null float64
fM3Trans    19020 non-null float64
fAlpha      19020 non-null float64
fDist       19020 non-null float64
class       19020 non-null object
dtypes: float64(10), object(1)
memory usage: 1.6+ MB
telescope_data.describe()

Resulta que todas las características del DataFrame son continuas. La variable objetivo class es categórica. Puedes ver los conteos de cada clase con value_counts().
telescope_data['class'].value_counts()
g    12332
h     6688
Name: class, dtype: int64
Por lo general es buena idea barajar aleatoriamente los datos al inicio para evitar órdenes no deseados. Puedes reordenar el DataFrame con random y permutation() de numpy. Para reiniciar el índice tras barajar, usa reset_index() con drop = True.
telescope_shuffle=telescope_data.iloc[np.random.permutation(len(telescope_data))]
tele=telescope_shuffle.reset_index(drop=True)
tele.head()

Antes de usar tpot, es esencial codificar las variables categóricas de tu DataFrame. Para saber más, echa un vistazo a este tutorial. Aquí solo la variable objetivo class es categórica, así que el tratamiento va sobre esa columna. Sustituirás la clase g (señal) por 0 y la clase h (fondo) por 1. Puedes hacerlo con map() pasando un diccionario con el mapeo.
tele['class']=tele['class'].map({'g':0,'h':1})

tele.head()

Ahora guarda las etiquetas de clase que quieres predecir en una variable aparte, tele_class.
tele_class = tele['class'].values
También deberías tratar los valores ausentes antes de usar tpot. Para comprobar cuántos hay por columna, ejecuta lo siguiente:
pd.isnull(tele).any()
fLength     False
fWidth      False
fSize       False
fConc       False
fConcl      False
fAsym       False
fM3Long     False
fM3Trans    False
fAlpha      False
fDist       False
class       False
dtype: bool
Este dataset no tiene valores ausentes. Nota: en conjuntos con valores ausentes puedes eliminar filas/columnas con dropna() o imputarlos con un valor de relleno usando fillna(). Por ejemplo, este fragmento sustituye los NA por -999.
tele = tele.fillna(-999)
Ahora divide el DataFrame en conjunto de entrenamiento y de prueba, como harías en cualquier modelado. Puedes hacerlo con cross_validation train_test_split de sklearn. Los parámetros son: tele.index como índices del DataFrame, train_size = 0.75 para reservar el 75% para entrenamiento, test_size = 0.25 para el 25% restante y stratify = tele_class para estratificar por la etiqueta. Nota: el conjunto de validación aquí sirve para hacernos una idea del error de test y coincide con el de prueba.
from sklearn.cross_validation import train_test_split
training_indices, validation_indices = training_indices, testing_indices = train_test_split(tele.index,
                                                                                            stratify = tele_class,
                                                                                            train_size=0.75, test_size=0.25)
Puedes comprobar el tamaño de entrenamiento y validación con el atributo size.
training_indices.size, validation_indices.size
(14265, 4755)
Es momento de usar la librería tpot para que nos proponga la mejor canalización para este problema de clasificación binaria. Para ello, importa la clase TPOTClassifier de tpot. Si fuera un problema de regresión, importarías TPOTRegressor.
TPOTClassifier tiene muchos parámetros; puedes leerlos todos aquí. Los más relevantes son:
accuracy, average_precision, roc_auc, recall, etc. Por defecto, accuracy.Además, ten en cuenta que mutation_rate + crossover_rate no puede superar 1.0.
Aquí usarás tpot con generations = 5 y el resto de parámetros por defecto. El parámetro verbosity = 2 controla cuánta información muestra TPOT durante la ejecución.
Después llamarás a fit() con el conjunto de entrenamiento (sin la columna objetivo) y la columna objetivo.
Nota: ejecutar el siguiente bloque puede tardar varias horas. Con estas opciones (5 generaciones y población de 100), TPOT evaluará 500 canalizaciones antes de terminar. Para ponerlo en contexto, imagina una búsqueda en rejilla con 500 combinaciones de hiperparámetros y validación cruzada de 5 pliegues: en torno a 2500 modelos entrenados y evaluados. ¡Lleva tiempo! Más adelante verás argumentos para controlar la duración.
from tpot import TPOTClassifier
from tpot import TPOTRegressor

tpot = TPOTClassifier(generations=5,verbosity=2)

tpot.fit(tele.drop('class',axis=1).loc[training_indices].values,
         tele.loc[training_indices,'class'].values)
Optimization Progress:  33%|███▎      | 200/600 [41:43<1:51:41, 16.75s/pipeline]

Generation 1 - Current best internal CV score: 0.880266061124

Optimization Progress:  50%|█████     | 300/600 [1:14:37<46:57,  9.39s/pipeline]

Generation 2 - Current best internal CV score: 0.880266061124

Optimization Progress:  67%|██████▋   | 400/600 [1:59:17<2:21:21, 42.41s/pipeline]

Generation 3 - Current best internal CV score: 0.880266061124

Optimization Progress:  84%|████████▎ | 501/600 [3:01:12<1:02:16, 37.74s/pipeline]

Generation 4 - Current best internal CV score: 0.881597992166

Generation 5 - Current best internal CV score: 0.881597992166

Best pipeline: GradientBoostingClassifier(RobustScaler(PolynomialFeatures(input_matrix, degree=2, include_bias=False, interaction_only=False)), learning_rate=0.1, max_depth=6, max_features=0.6000000000000001, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=5, max_eval_time_mins=5,
        max_time_mins=None, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=100, periodic_checkpoint_folder=None,
        population_size=100, random_state=None, scoring=None,
        subsample=1.0, verbosity=2, warm_start=False)
Arriba se calcularon 5 generaciones, cada una mostrando el rendimiento en validación cruzada sobre el entrenamiento. La mejor canalización alcanza una exactitud CV del 88,16%. El modelo es una canalización con técnicas de preprocesado como PolynomialFeatures y RobustScaler, que generan características sintéticas y las normalizan; después un clasificador Gradient Boosting produce las predicciones finales. Verás que tpot también devuelve hiperparámetros como learning_rate, max_depth, etc., junto con el clasificador.
A continuación, se calcula el error en test para validación.
tpot.score(tele.drop('class',axis=1).loc[validation_indices].values,
           tele.loc[validation_indices, 'class'].values)
0.885173501577287
Como se ve, la exactitud en test es del 88,51%.
Por último, puedes pedir a TPOT que exporte el código Python de la canalización optimizada a un archivo de texto con la función export:
tpot.export('tpot_MAGIC_Gamma_Telescope_pipeline.py')
True
## This is the pipeline that tpot generated: tpot_MAGIC_Gamma_Telescope_pipeline.py
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, RobustScaler

# NOTE: Make sure that the class is labeled 'target' in the data file
tpot_data = pd.read_csv('PATH/TO/DATA/FILE', sep='COLUMN_SEPARATOR', dtype=np.float64)
features = tpot_data.drop('target', axis=1).values
training_features, testing_features, training_target, testing_target = \
            train_test_split(features, tpot_data['target'].values, random_state=42)

# Score on the training set was:0.881597992166
exported_pipeline = make_pipeline(
    PolynomialFeatures(degree=2, include_bias=False, interaction_only=False),
    RobustScaler(),
    GradientBoostingClassifier(learning_rate=0.1, max_depth=6, max_features=0.6, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)
)

exported_pipeline.fit(training_features, training_target)
results = exported_pipeline.predict(testing_features)
¿No es genial? Sin tener que ajustar a mano multitud de parámetros para dar con el mejor modelo, TPOT no solo te dice cuál es, sino que además te da el código funcional.
Como indicábamos, la última ejecución de TPOT tardó horas. Hay parámetros para controlar el tiempo de ejecución, pero con contrapartidas: si limitas el tiempo, TPOT no podrá explorar todas las canalizaciones y el mejor modelo encontrado dentro del límite puede no ser el óptimo absoluto para ese dataset. Aun así, con tiempo suficiente se acercará bastante. Algunos parámetros son:
None, anula generations y TPOT ejecuta hasta que pasen esos minutos.n_jobs=-1 usa todos los núcleos disponibles. Ojo con los problemas de memoria en datasets grandes. Por defecto, 1.A modo de práctica, ejecuta de nuevo TPOT con max_time_mins = 2 y max_eval_time_mins = 0.04, y esta vez con population_size = 15.
tpot = TPOTClassifier(verbosity=2, max_time_mins=2, max_eval_time_mins=0.04, population_size=15)
tpot.fit(tele.drop('class',axis=1).loc[training_indices].values, tele.loc[training_indices,'class'].values)
Optimization Progress: 42pipeline [00:42,  1.17s/pipeline]

Generation 1 - Current best internal CV score: 0.86119902629

Optimization Progress: 64pipeline [01:03,  1.04s/pipeline]

Generation 2 - Current best internal CV score: 0.86119902629

Optimization Progress: 83pipeline [01:21,  1.14s/pipeline]

Generation 3 - Current best internal CV score: 0.861689811492

Optimization Progress: 104pipeline [01:45,  1.03pipeline/s]

Generation 4 - Current best internal CV score: 0.861759642796

2.03228221667 minutes have elapsed. TPOT will close down.
TPOT closed prematurely. Will use the current best pipeline.

Best pipeline: XGBClassifier(RobustScaler(SelectPercentile(input_matrix, percentile=85)), learning_rate=0.1, max_depth=2, min_child_weight=4, n_estimators=100, nthread=1, subsample=0.1)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=1000000, max_eval_time_mins=0.04,
        max_time_mins=2, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=15, periodic_checkpoint_folder=None,
        population_size=15, random_state=None, scoring=None, subsample=1.0,
        verbosity=2, warm_start=False)
Como puedes ver, el mejor clasificador dentro del tiempo fijado es ahora XGBoost con SelectPercentile() y RobustScaler() como pasos de preprocesado.
Ejecutar TPOT no es tan simple como ajustar un único modelo. Considera múltiples algoritmos (random forests, modelos lineales, SVM, etc.) en una canalización con numerosos pasos de preprocesado (imputación, escalado, PCA, selección de características, etc.), los hiperparámetros de todos ellos y distintas formas de crear ensembles o stacking dentro de la canalización. Por eso suele tardar y no es viable para conjuntos de datos muy grandes.
Si trabajas con un dataset razonablemente complejo o ejecutas TPOT poco tiempo, distintas ejecuciones pueden devolver canalizaciones diferentes. Esto significa que no han convergido por falta de tiempo o que varias canalizaciones rinden de forma muy similar en tus datos.
¡Enhorabuena! Has llegado al final del tutorial. Empezaste con una breve introducción a las plataformas de Machine Learning automatizado. Luego vimos la programación genética y cómo TPOT la usa para automatizar la construcción de canalizaciones. También practicaste con la librería TPOT en Python sobre un dataset y conociste sus funciones. Si planeas usar TPOT en el futuro, te recomiendo su excelente documentación. ¡A seguir explorando!
Si quieres aprender más sobre Machine Learning en Python, haz el curso de DataCamp Machine Learning with Tree-Based Models in Python. También puedes leer el tutorial de DataCamp Introduction to Machine Learning in Python.
Estas páginas web se usaron como fuentes para escribir este tutorial.
Aprende más sobre Python y machine learning
Curso
Curso
Curso
Tutorial
Moez Ali
14 min
Tutorial
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Avinash Navlani
10 min





