Cours
Comprendre le Machine Learning
2 h
308.2K
Dans ce tutoriel, vous allez apprendre à utiliser une bibliothèque assez unique en Python : tpot. Ce qui rend cette bibliothèque unique, c’est qu’elle automatise toute la chaîne de traitement en apprentissage automatique et vous propose le meilleur modèle de machine learning pour vos données. Plus précisément, vous allez voir :
Allons-y !
Avant d’aborder un problème de machine learning, vous devez prendre en compte de nombreux éléments : préparation des données, sélection et ingénierie des variables, choix et validation du modèle, réglage des hyperparamètres, etc. En théorie, on peut appliquer une multitude de techniques pour chacune de ces étapes, mais leur performance varie d’un jeu de données à l’autre. Le défi consiste à trouver la meilleure combinaison afin de minimiser l’erreur de prédiction. C’est la raison pour laquelle des algorithmes et des plateformes d’AutoML voient le jour : permettre à toute personne, même sans expertise pointue en machine learning, de construire des modèles rapidement et efficacement. L’une de ces plateformes est disponible sous forme de bibliothèque Python : TPOT. Considérez TPOT comme votre assistant data science. TPOT est un outil d’AutoML en Python qui optimise des pipelines de machine learning grâce à la programmation génétique. Il automatise la partie la plus fastidieuse du machine learning en explorant intelligemment des milliers de pipelines possibles pour trouver le meilleur pour vos données.
from IPython.core.display import Image
Image(filename="/home/manishpathak/DataCamp/tpot/tpot-ml-pipeline.png",width=800,height=800)
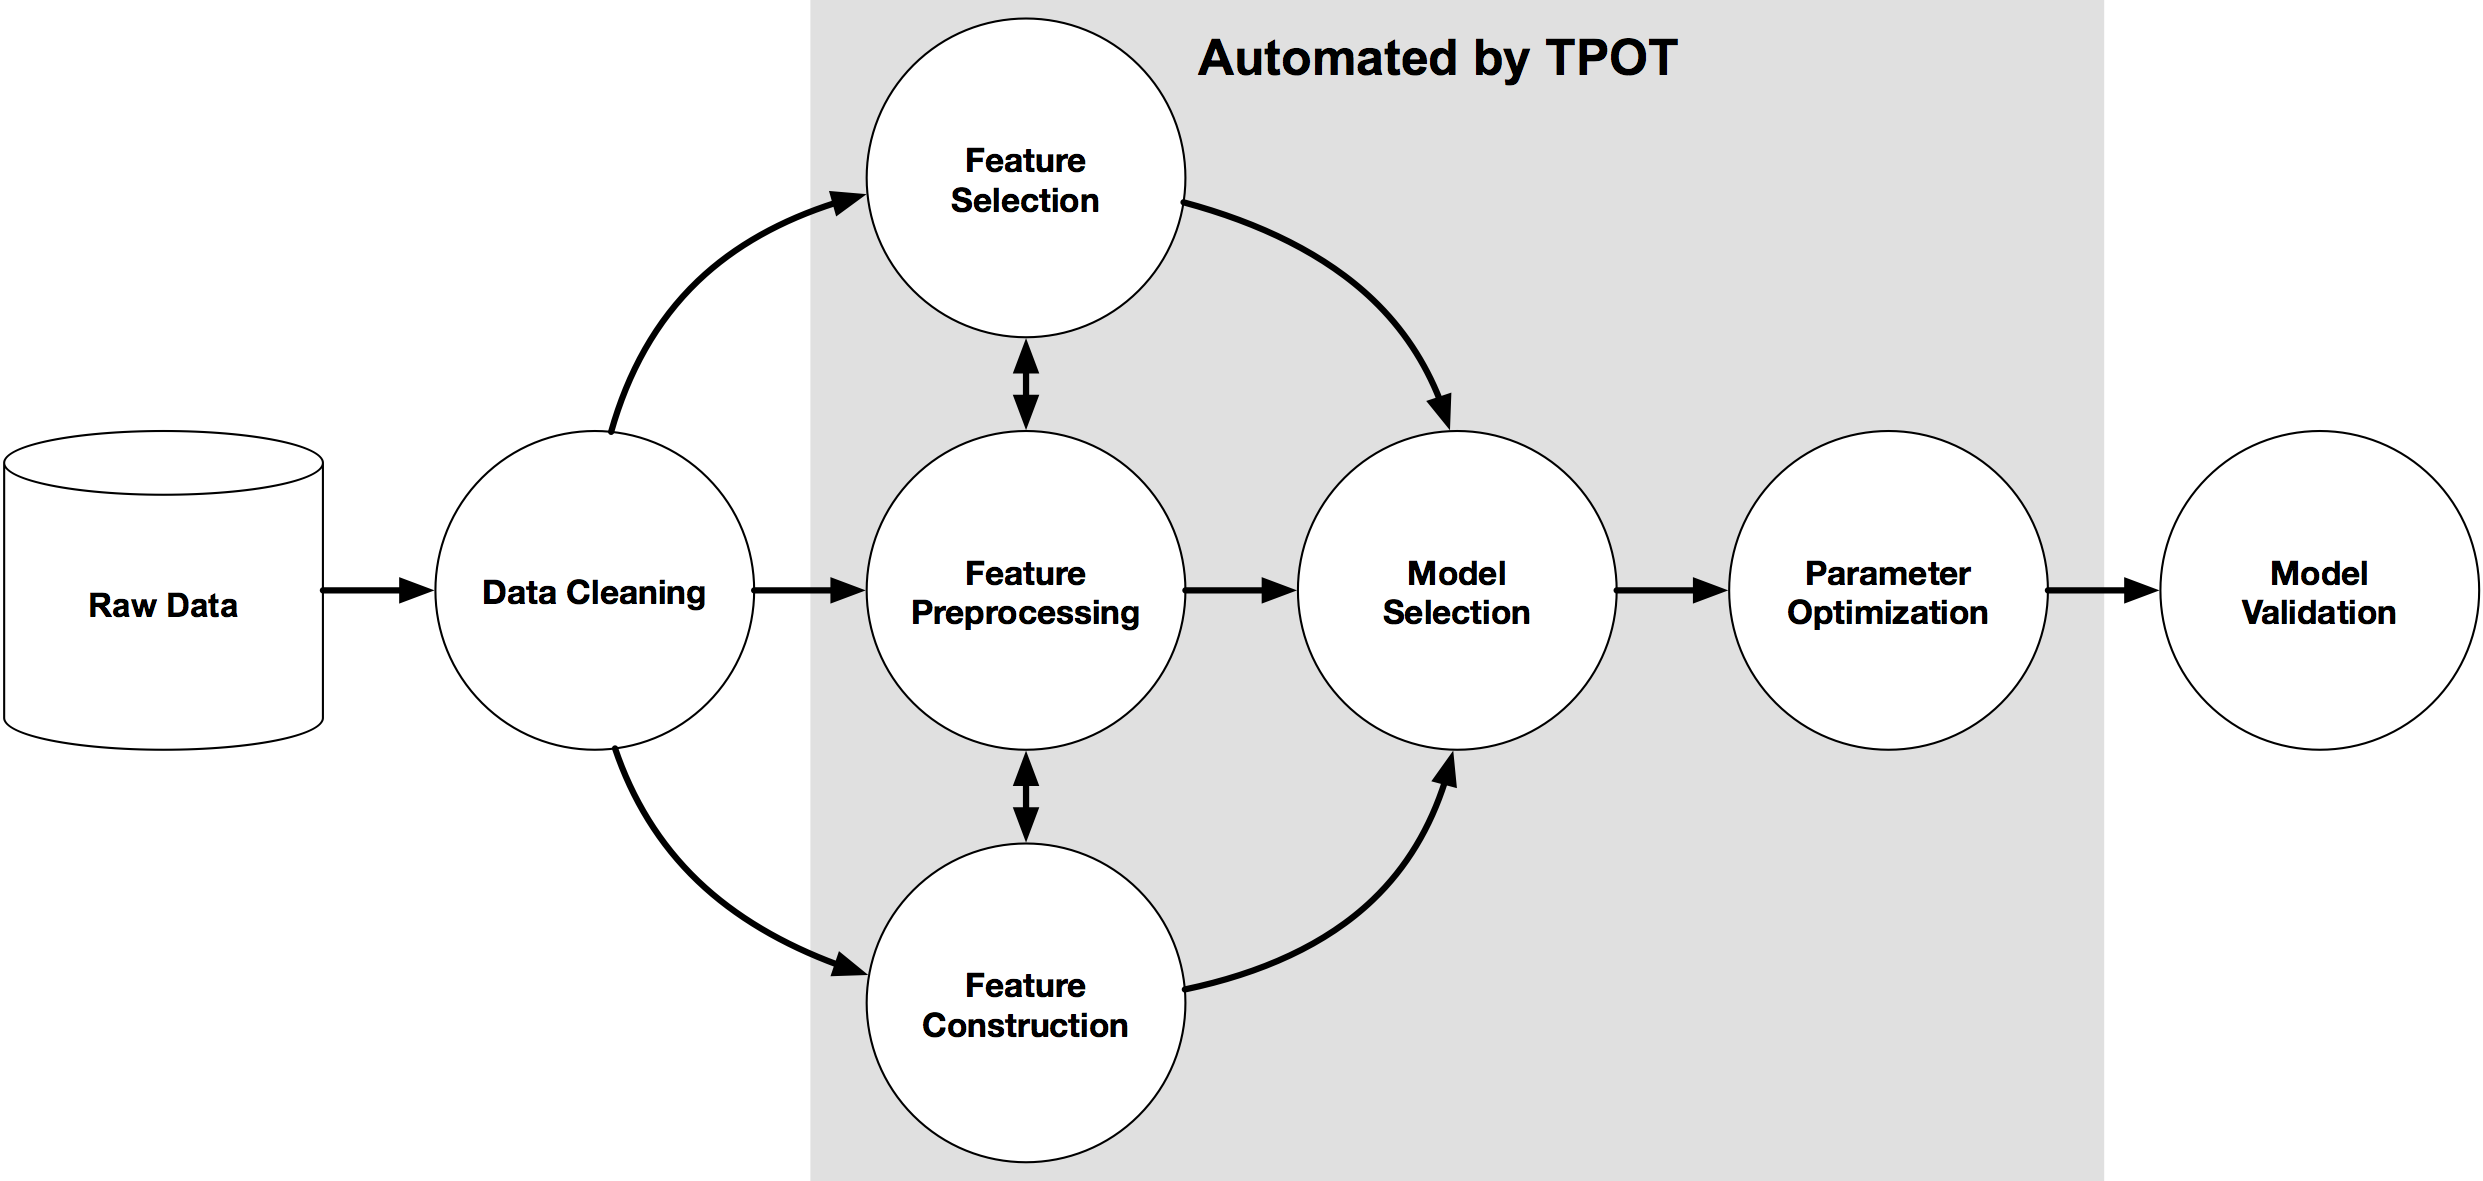
Une fois la recherche terminée, TPOT vous fournit le code Python du meilleur pipeline trouvé afin que vous puissiez ensuite l’affiner si besoin.
Pour installer tpot sur votre système, exécutez la commande sudo pip install tpot dans votre terminal, ou consultez ce lien. tpot s’appuie sur plusieurs bibliothèques Python existantes, dont numpy, scipy, scikit-learn, DEAP, update_checker, tqdm, stopit, pandas. La plupart des packages requis peuvent être installés via la distribution Anaconda, ou séparément. En option, vous pouvez aussi installer XGBoost si vous souhaitez que tpot utilise les modèles eXtreme Gradient Boosting.
Avec de bonnes données, de la puissance de calcul et le bon modèle, vous pouvez résoudre bien des problèmes, mais choisir le modèle adéquat peut s’avérer complexe vu le nombre d’options (arbres de décision, SVM, KNN, etc.). C’est là que la programmation génétique peut grandement aider. Les algorithmes génétiques s’inspirent de la sélection naturelle darwinienne et servent à générer des solutions à des problèmes d’optimisation et de recherche en informatique.
De manière générale, les algorithmes génétiques reposent sur trois principes :
La programmation génétique est un vaste sujet en soi. Si vous souhaitez creuser, consultez cette série de vidéos.
Mais quel lien avec la data science ?
Choisir le bon modèle de machine learning et ses meilleurs hyperparamètres est en soi un problème d’optimisation, pour lequel la programmation génétique est pertinente. La bibliothèque Python tpot, bâtie sur scikit-learn, utilise la programmation génétique pour optimiser votre pipeline. Par exemple, après avoir préparé vos données, vous devez décider quelles variables (features) alimenter dans le modèle et comment les construire. Une fois ces variables prêtes, vous entraînez le modèle puis ajustez ses hyperparamètres pour obtenir des résultats optimaux. Au lieu de faire tout cela manuellement par essais-erreurs, TPOT automatise ces étapes via la programmation génétique et vous fournit le code optimal à la fin.
Pour aller plus loin, vous allez pratiquer avec la bibliothèque tpot sur un jeu de données open source : MAGIC Gamma Telescope. Ces données simulent l’enregistrement de particules gamma haute énergie dans un télescope Cherenkov atmosphérique au sol, via une technique d’imagerie. Pour une description complète, consultez ce lien. Le jeu de données comporte les attributs/caractéristiques suivants :
L’objectif est de classer une observation en gamma (le signal recherché) ou en hadron (le bruit de fond), à partir des attributs fournis.
Commencez par importer les bibliothèques pandas et numpy pour la lecture et le calcul.
import pandas as pd
import numpy as np
Utilisez la fonction read_csv() de pandas pour charger le jeu de données dans un DataFrame. Indiquez également le paramètre header = None puisque le fichier ne contient pas encore de noms de colonnes.
telescope_data=pd.read_csv('https://archive.ics.uci.edu/ml/machine-learning-databases/magic/magic04.data',header=None)
Vérifiez le contenu du DataFrame avec la méthode head().
telescope_data.head()

Pour nommer les colonnes du DataFrame, utilisez l’attribut columns et affectez-lui une liste de noms.
telescope_data.columns = ['fLength', 'fWidth','fSize','fConc','fConcl','fAsym','fM3Long','fM3Trans','fAlpha','fDist','class']
telescope_data.head()

Les colonnes sont maintenant nommées.
Pour obtenir des informations utiles (nombre de valeurs, type, count, moyenne, etc.), utilisez les méthodes info() et describe() de pandas.
telescope_data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 19020 entries, 0 to 19019
Data columns (total 11 columns):
fLength     19020 non-null float64
fWidth      19020 non-null float64
fSize       19020 non-null float64
fConc       19020 non-null float64
fConcl      19020 non-null float64
fAsym       19020 non-null float64
fM3Long     19020 non-null float64
fM3Trans    19020 non-null float64
fAlpha      19020 non-null float64
fDist       19020 non-null float64
class       19020 non-null object
dtypes: float64(10), object(1)
memory usage: 1.6+ MB
telescope_data.describe()

Il s’avère que toutes les variables du DataFrame sont continues. La variable cible class, elle, est catégorielle. Pour vérifier les effectifs par classe, utilisez value_counts().
telescope_data['class'].value_counts()
g    12332
h     6688
Name: class, dtype: int64
Il est généralement recommandé de mélanger aléatoirement les données au départ, pour éviter tout effet d’ordre. Vous pouvez réorganiser les lignes du DataFrame avec numpy.random et la fonction permutation(). Pour réinitialiser l’index après mélange, utilisez reset_index() avec drop = True.
telescope_shuffle=telescope_data.iloc[np.random.permutation(len(telescope_data))]
tele=telescope_shuffle.reset_index(drop=True)
tele.head()

Avant d’utiliser tpot, il est essentiel d’encoder les variables catégorielles de votre DataFrame. Pour en savoir plus, consultez ce tutoriel. Ici, seule la variable cible class est catégorielle, le traitement porte donc sur cette colonne. Vous allez remplacer la classe g (signal) par 0 et la classe h (bruit) par 1. Utilisez map() avec un dictionnaire de correspondance.
tele['class']=tele['class'].map({'g':0,'h':1})

tele.head()

Stockez maintenant les étiquettes de classe (cible à prédire) dans une variable distincte tele_class.
tele_class = tele['class'].values
Traitez également les valeurs manquantes avant d’utiliser tpot. Pour compter les valeurs manquantes par colonne, exécutez :
pd.isnull(tele).any()
fLength     False
fWidth      False
fSize       False
fConc       False
fConcl      False
fAsym       False
fM3Long     False
fM3Trans    False
fAlpha      False
fDist       False
class       False
dtype: bool
Ce jeu de données ne contient pas de valeurs manquantes. Remarque : s’il y en a, vous pouvez soit supprimer des lignes/colonnes avec dropna(), soit les remplacer par une valeur de substitution avec fillna(). Par exemple, le code suivant remplace les NA par -999.
tele = tele.fillna(-999)
Divisez maintenant le DataFrame en un ensemble d’entraînement et un ensemble de test, comme pour tout projet de machine learning. Utilisez train_test_split de sklearn (cross_validation). Les paramètres sont : tele.index pour les indices, train_size = 0.75 pour conserver 75 % des données en apprentissage, test_size = 0.25 pour les 25 % restants en test, et stratify = tele_class pour respecter la répartition des classes. Remarque : l’ensemble de validation sert ici à estimer l’erreur sur le test et est identique au test.
from sklearn.cross_validation import train_test_split
training_indices, validation_indices = training_indices, testing_indices = train_test_split(tele.index,
                                                                                            stratify = tele_class,
                                                                                            train_size=0.75, test_size=0.25)
Vérifiez la taille des ensembles d’entraînement et de validation via l’attribut size.
training_indices.size, validation_indices.size
(14265, 4755)
Il est temps d’utiliser la bibliothèque tpot pour nous proposer le meilleur pipeline pour ce problème de classification binaire. Pour cela, importez la classe TPOTClassifier depuis tpot. Pour un problème de régression, vous auriez importé TPOTRegressor.
TPOTClassifier propose de nombreux paramètres, détaillés ici. Les plus notables :
accuracy, average_precision, roc_auc, recall, etc.). Par défaut : accuracy.Remarque : mutation_rate + crossover_rate ne doivent pas dépasser 1,0.
Ici, vous utiliserez tpot avec generations = 5, les autres paramètres par défaut. Le paramètre verbosity = 2 contrôle la quantité d’informations affichées pendant l’exécution.
Appelez ensuite la méthode fit() avec l’ensemble d’entraînement (sans la colonne cible) et la colonne cible en arguments.
Attention : l’exécution du code ci-dessous peut durer plusieurs heures. Avec ces réglages (5 générations, population de 100), TPOT va évaluer 500 configurations de pipelines. C’est comparable à une grille de 500 combinaisons d’hyperparamètres évaluées en validation croisée 5-fold, soit environ 2 500 modèles entraînés et évalués : c’est long ! Plus loin, vous verrez des paramètres pour contrôler le temps d’exécution.
from tpot import TPOTClassifier
from tpot import TPOTRegressor

tpot = TPOTClassifier(generations=5,verbosity=2)

tpot.fit(tele.drop('class',axis=1).loc[training_indices].values,
         tele.loc[training_indices,'class'].values)
Optimization Progress:  33%|███▎      | 200/600 [41:43<1:51:41, 16.75s/pipeline]

Generation 1 - Current best internal CV score: 0.880266061124

Optimization Progress:  50%|█████     | 300/600 [1:14:37<46:57,  9.39s/pipeline]

Generation 2 - Current best internal CV score: 0.880266061124

Optimization Progress:  67%|██████▋   | 400/600 [1:59:17<2:21:21, 42.41s/pipeline]

Generation 3 - Current best internal CV score: 0.880266061124

Optimization Progress:  84%|████████▎ | 501/600 [3:01:12<1:02:16, 37.74s/pipeline]

Generation 4 - Current best internal CV score: 0.881597992166

Generation 5 - Current best internal CV score: 0.881597992166

Best pipeline: GradientBoostingClassifier(RobustScaler(PolynomialFeatures(input_matrix, degree=2, include_bias=False, interaction_only=False)), learning_rate=0.1, max_depth=6, max_features=0.6000000000000001, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=5, max_eval_time_mins=5,
        max_time_mins=None, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=100, periodic_checkpoint_folder=None,
        population_size=100, random_state=None, scoring=None,
        subsample=1.0, verbosity=2, warm_start=False)
Ci-dessus, 5 générations ont été calculées, chacune indiquant la performance en CV interne sur l’entraînement. La meilleure pipeline atteint une précision CV de 88,16 %. Le modèle associé est un pipeline combinant des étapes de prétraitement comme PolynomialFeatures puis RobustScaler (génération de variables polynomiales et normalisation), exploitées ensuite par un classifieur Gradient Boosting pour produire les prédictions. Vous noterez aussi que tpot renvoie les valeurs d’hyperparamètres (learning_rate, max_depth, etc.) avec le classifieur.
On calcule ensuite l’erreur sur l’ensemble de test à des fins de validation.
tpot.score(tele.drop('class',axis=1).loc[validation_indices].values,
           tele.loc[validation_indices, 'class'].values)
0.885173501577287
On obtient ainsi une précision test de 88,51 %.
Enfin, vous pouvez demander à TPOT d’exporter le code Python du pipeline optimisé dans un fichier texte avec la fonction d’export :
tpot.export('tpot_MAGIC_Gamma_Telescope_pipeline.py')
True
## This is the pipeline that tpot generated: tpot_MAGIC_Gamma_Telescope_pipeline.py
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, RobustScaler

# NOTE: Make sure that the class is labeled 'target' in the data file
tpot_data = pd.read_csv('PATH/TO/DATA/FILE', sep='COLUMN_SEPARATOR', dtype=np.float64)
features = tpot_data.drop('target', axis=1).values
training_features, testing_features, training_target, testing_target = \
            train_test_split(features, tpot_data['target'].values, random_state=42)

# Score on the training set was:0.881597992166
exported_pipeline = make_pipeline(
    PolynomialFeatures(degree=2, include_bias=False, interaction_only=False),
    RobustScaler(),
    GradientBoostingClassifier(learning_rate=0.1, max_depth=6, max_features=0.6, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)
)

exported_pipeline.fit(training_features, training_target)
results = exported_pipeline.predict(testing_features)
Génial, non ? Sans passer des heures à ajuster des paramètres, TPOT vous donne non seulement le meilleur modèle, mais aussi un code prêt à l’emploi !
Comme indiqué plus haut, l’exécution précédente de TPOT a pris plusieurs heures. Vous pouvez toutefois fixer certains paramètres pour contrôler le temps d’exécution, avec un compromis. En limitant le temps, TPOT n’explorera pas toutes les pipelines possibles et la solution proposée à l’issue du délai pourrait ne pas être strictement optimale. Avec suffisamment de temps, elle s’en approchera. Parmi ces paramètres :
None, cette valeur remplace generations et TPOT s’exécute jusqu’à expiration du délai.n_jobs=-1 utilise tous les cœurs disponibles. Attention à la mémoire sur les grands jeux de données. Par défaut : 1.Pour pratiquer, relancez TPOT avec les arguments max_time_mins = 2 et max_eval_time_mins = 0.04, et une population_size = 15 réduite.
tpot = TPOTClassifier(verbosity=2, max_time_mins=2, max_eval_time_mins=0.04, population_size=15)
tpot.fit(tele.drop('class',axis=1).loc[training_indices].values, tele.loc[training_indices,'class'].values)
Optimization Progress: 42pipeline [00:42,  1.17s/pipeline]

Generation 1 - Current best internal CV score: 0.86119902629

Optimization Progress: 64pipeline [01:03,  1.04s/pipeline]

Generation 2 - Current best internal CV score: 0.86119902629

Optimization Progress: 83pipeline [01:21,  1.14s/pipeline]

Generation 3 - Current best internal CV score: 0.861689811492

Optimization Progress: 104pipeline [01:45,  1.03pipeline/s]

Generation 4 - Current best internal CV score: 0.861759642796

2.03228221667 minutes have elapsed. TPOT will close down.
TPOT closed prematurely. Will use the current best pipeline.

Best pipeline: XGBClassifier(RobustScaler(SelectPercentile(input_matrix, percentile=85)), learning_rate=0.1, max_depth=2, min_child_weight=4, n_estimators=100, nthread=1, subsample=0.1)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=1000000, max_eval_time_mins=0.04,
        max_time_mins=2, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=15, periodic_checkpoint_folder=None,
        population_size=15, random_state=None, scoring=None, subsample=1.0,
        verbosity=2, warm_start=False)
On constate que, dans le délai imparti, le meilleur classifieur est ici XGBoost, avec SelectPercentile() et RobustScaler() en étapes de prétraitement.
Exécuter TPOT, ce n’est pas simplement ajuster un seul modèle sur le jeu de données. Il considère plusieurs algorithmes (forêts aléatoires, modèles linéaires, SVM, etc.) au sein d’un pipeline avec de nombreuses étapes de prétraitement (imputation, mise à l’échelle, ACP, sélection de variables, etc.), les hyperparamètres de tous ces éléments, ainsi que différentes manières d’ensemblage ou d’empilement des algorithmes. C’est pourquoi l’exécution est souvent longue et peu adaptée à de très grands volumes de données.
Si vous travaillez sur un jeu de données assez complexe ou si vous laissez TPOT tourner peu de temps, deux exécutions peuvent aboutir à des pipelines différents. Cela signifie que l’optimisation n’a pas convergé faute de temps, ou que plusieurs pipelines obtiennent des performances similaires sur vos données.
Bravo ! Vous êtes arrivé au terme de ce tutoriel. Vous avez commencé par une introduction à l’AutoML, puis exploré la programmation génétique et la façon dont TPOT l’exploite pour automatiser la construction de pipelines. Vous avez également pratiqué TPOT en Python sur un jeu de données et découvert ses principales fonctionnalités. Si vous envisagez d’utiliser TPOT, je vous recommande vivement sa documentation. Bonne exploration !
Si vous souhaitez approfondir le machine learning en Python, suivez le cours DataCamp Machine Learning with Tree-Based Models in Python. Consultez aussi le tutoriel Introduction to Machine Learning in Python de DataCamp.
Les pages suivantes ont servi de sources pour la rédaction de ce tutoriel.
Approfondir Python et le machine learning
Cours
Cours
Cours