Cursus
Inzicht in Machine Learning
2 uur
311.6K
In deze tutorial leer je hoe je een heel unieke bibliotheek in Python gebruikt: tpot. Wat deze bibliotheek uniek maakt, is dat hij de volledige machine learning-pijplijn automatiseert en je het best presterende machinelearningmodel oplevert. Meer specifiek leer je:
Laten we beginnen!
Er zijn veel onderdelen waar je aan moet denken voordat je een machine learning-probleem oplost, zoals datapreparatie, featureselectie, feature-engineering, modelselectie en -validatie, hyperparametertuning, enzovoort. In theorie kun je voor elk van deze onderdelen een heleboel technieken vinden en toepassen, maar ze kunnen allemaal anders presteren op verschillende datasets. De uitdaging is om de best presterende combinatie van technieken te vinden, zodat je de fout in je voorspellingen minimaliseert. Dit is de belangrijkste reden dat er tegenwoordig AutoML-algoritmen en -platformen worden ontwikkeld, zodat iedereen, zonder machine learning-expertise, modellen kan bouwen zonder veel tijd of moeite. Zo’n platform is beschikbaar als een Python-bibliotheek: TPOT. Je kunt TPOT zien als je Data Science-assistent. TPOT is een geautomatiseerde machine learning-tool in Python die machine learning-pijplijnen optimaliseert met genetische programmering. Het automatiseert het meest tijdrovende deel van machine learning door op intelligente wijze duizenden mogelijke pijplijnen te verkennen om de beste voor jouw data te vinden.
from IPython.core.display import Image
Image(filename="/home/manishpathak/DataCamp/tpot/tpot-ml-pipeline.png",width=800,height=800)
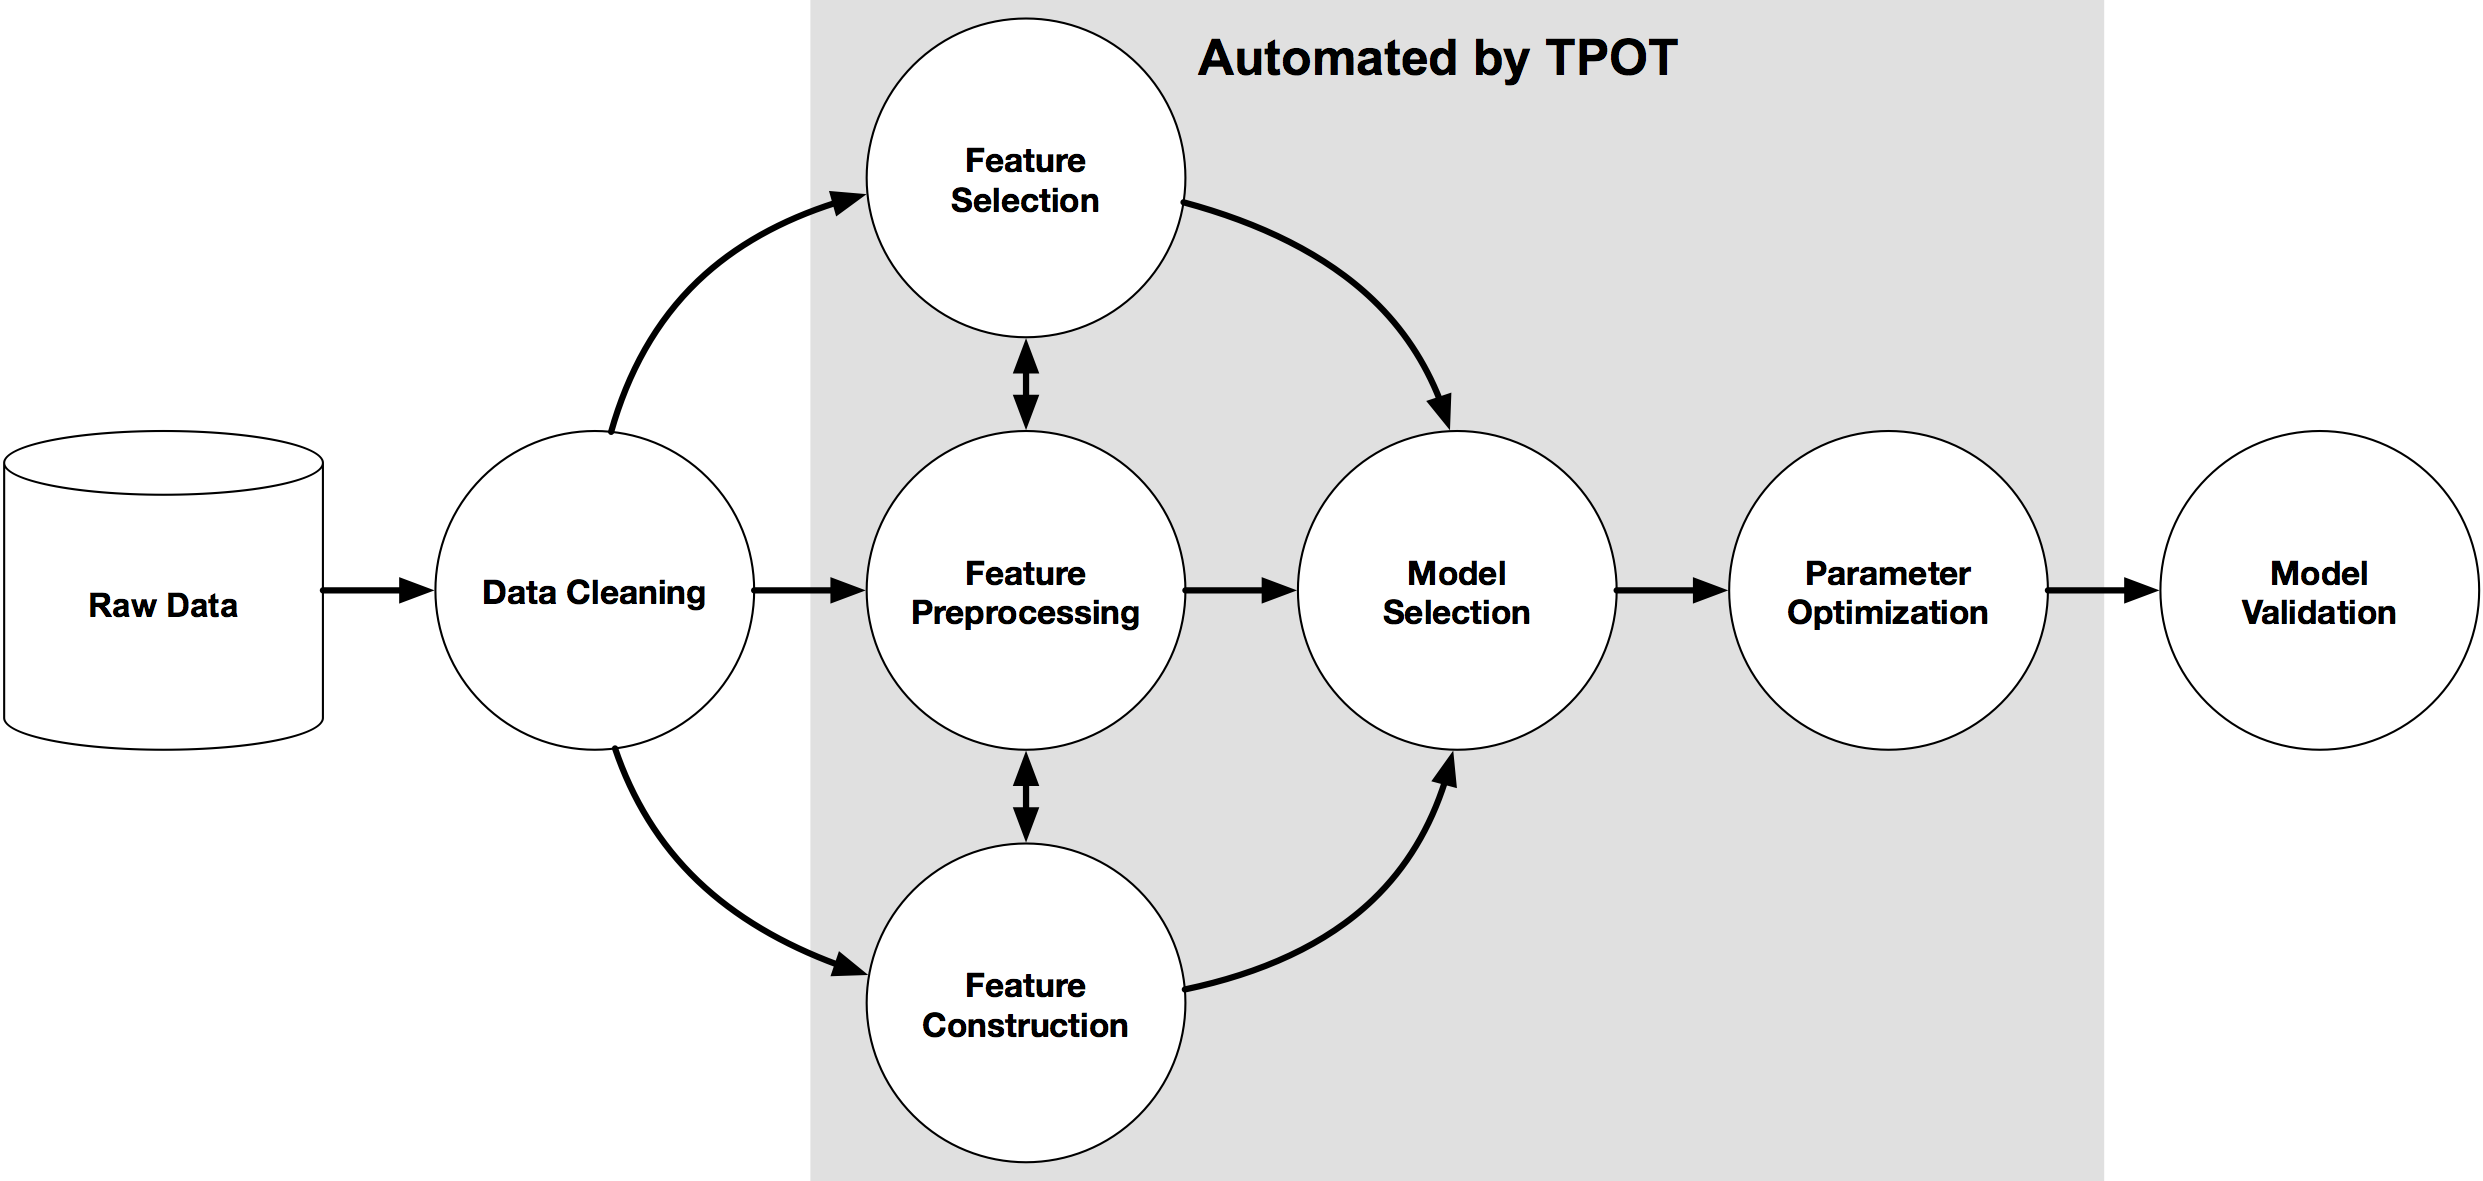
Zodra TPOT klaar is met zoeken, geeft het je de Python-code voor de beste pijplijn die het heeft gevonden, zodat je er daarna mee kunt sleutelen.
Om tpot op je systeem te installeren, kun je de opdracht sudo pip install tpot uitvoeren in de commandoregel of deze link bekijken. tpot is gebouwd bovenop een aantal bestaande Python-bibliotheken, waaronder numpy, scipy, scikit-learn, DEAP, update_checker, tqdm, stopit, pandas. De meeste benodigde Python-pakketten kun je installeren via de Anaconda Python-distributie, of je kunt ze ook apart installeren. Optioneel kun je ook XGBoost installeren als je wilt dat tpot de eXtreme Gradient Boosting-modellen gebruikt.
Met de juiste data, rekenkracht en een machinelearningmodel kun je een oplossing vinden voor elk probleem, maar weten welk model je moet gebruiken kan lastig zijn omdat er zoveel zijn, zoals decision trees, SVM, KNN, enzovoort. Daar komt genetische programmering goed van pas. Genetische algoritmen zijn geïnspireerd op het Darwinistische proces van natuurlijke selectie en worden gebruikt om oplossingen te genereren voor optimalisatie- en zoekproblemen in de informatica.
Grofweg hebben genetische algoritmen drie eigenschappen:
Genetische programmering zelf is een groot onderwerp in de informatica, maar als je dieper wilt duiken in genetische algoritmen, bekijk dan deze video-serie.
Maar hoe past dit allemaal in data science?
Het blijkt dat het kiezen van het juiste machinelearningmodel en de beste hyperparameters voor dat model op zichzelf een optimalisatieprobleem is, waarvoor genetische programmering kan worden gebruikt. De Python-bibliotheek tpot, gebouwd op scikit-learn, gebruikt genetische programmering om je machine learning-pijplijn te optimaliseren. In machine learning moet je bijvoorbeeld, nadat je je data hebt voorbereid, weten welke features je aan je model moet voeren en hoe je die features moet samenstellen. Zodra je die features hebt, voer je ze in je model om te trainen en stel je je hyperparameters af om de optimale resultaten te krijgen. In plaats van dit allemaal zelf te doen via trial-and-error, automatiseert TPOT deze stappen met genetische programmering en geeft het je de optimale code zodra het klaar is.
Om het beter te begrijpen, ga je oefenen met de tpot-bibliotheek op een open-sourcedataset. De dataset die je gebruikt is de MAGIC Gamma Telescope DataSet. De data zijn gegenereerd om de registratie van hoogenergetische gammapartikels in een op de grond gebaseerde atmosferische Cherenkov-gammatelescoop te simuleren met behulp van de imagingtechniek. Voor de volledige details over de datasetbeschrijving, bekijk deze link. De dataset heeft de volgende attributen/features:
Het doel is om een observatie te classificeren als gamma, het gewenste signaal, of hadron, de achtergrondruis, op basis van de gegeven attributen.
Je begint met het importeren van de bibliotheken pandas en numpy om respectievelijk de data in te lezen en berekeningen uit te voeren.
import pandas as pd
import numpy as np
Gebruik de pandas-functie read_csv() om de dataset als een DataFrame in te lezen. Geef ook de parameter header = None op, omdat de dataset nog geen kolomnamen heeft.
telescope_data=pd.read_csv('https://archive.ics.uci.edu/ml/machine-learning-databases/magic/magic04.data',header=None)
Controleer de inhoud van het DataFrame met de methode head().
telescope_data.head()

Om namen aan de kolommen van het DataFrame te geven, kun je het attribuut columns op het pandas DataFrame gebruiken en dit toewijzen aan een lijst met de kolomnamen.
telescope_data.columns = ['fLength', 'fWidth','fSize','fConc','fConcl','fAsym','fM3Long','fM3Trans','fAlpha','fDist','class']
telescope_data.head()

Nu heb je ook de kolomnamen in je DataFrame.
Om de benodigde informatie over het DataFrame te krijgen, zoals het aantal waarden in elke kolom, datatype, count, mean, enzovoort, kun je de pandas-methoden info() en describe() gebruiken.
telescope_data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 19020 entries, 0 to 19019
Data columns (total 11 columns):
fLength     19020 non-null float64
fWidth      19020 non-null float64
fSize       19020 non-null float64
fConc       19020 non-null float64
fConcl      19020 non-null float64
fAsym       19020 non-null float64
fM3Long     19020 non-null float64
fM3Trans    19020 non-null float64
fAlpha      19020 non-null float64
fDist       19020 non-null float64
class       19020 non-null object
dtypes: float64(10), object(1)
memory usage: 1.6+ MB
telescope_data.describe()

Alle features in het DataFrame blijken continu van aard te zijn. De doelvariabele/feature class is echter categorisch. Je kunt de aantallen per klasse in de doelvariabele controleren met de methode value_counts().
telescope_data['class'].value_counts()
g    12332
h     6688
Name: class, dtype: int64
Het is over het algemeen een goed idee om de data willekeurig te schudden voordat je begint, om elke vorm van ordening in de data te vermijden. Je kunt de data in het DataFrame herschikken met behulp van random en de functie permutation() van numpy. Om de indexnummers na het schudden te resetten, gebruik je de methode reset_index() met drop = True als parameter.
telescope_shuffle=telescope_data.iloc[np.random.permutation(len(telescope_data))]
tele=telescope_shuffle.reset_index(drop=True)
tele.head()

Voordat je tpot gebruikt, is het essentieel om de categorische variabelen in je DataFrame te labelen. Wil je meer leren over het labelen van categorische variabelen, bekijk dan deze tutorial. Hier is alleen de doelvariabele class categorisch, dus die kolom moet worden behandeld. Je vervangt de klasse g (signaal) door een numerieke waarde 0 en klasse h (achtergrond) door een numerieke waarde 1. Dit kan met de functie map() met als argument een dictionary die de respectieve mapping van de klassen van de doelvariabele bevat.
tele['class']=tele['class'].map({'g':0,'h':1})

tele.head()

Sla nu de klasselabels, die je moet voorspellen, op in een aparte variabele tele_class.
tele_class = tele['class'].values
Je moet ook ontbrekende waarden behandelen voordat je tpot gebruikt. Om het aantal ontbrekende waarden per kolom te controleren, kun je het volgende uitvoeren:
pd.isnull(tele).any()
fLength     False
fWidth      False
fSize       False
fConc       False
fConcl      False
fAsym       False
fM3Long     False
fM3Trans    False
fAlpha      False
fDist       False
class       False
dtype: bool
Deze dataset heeft geen ontbrekende waarden. Let op: in datasets met ontbrekende waarden kun je ofwel de rijen/kolommen verwijderen met de methode dropna(), of de ontbrekende waarde vervangen door een dummywaarde met de methode fillna(). Bijvoorbeeld: de volgende code vervangt de NA-waarden door een dummywaarde -999.
tele = tele.fillna(-999)
Je splitst het DataFrame nu in een trainingsset en een testset, zoals je doet bij elk type machine learning-modellering. Dit kan via cross_validation train_test_split van sklearn. De parameters zijn tele.index als indexen van het DataFrame, train_size = 0.75 om 75% van de data in de trainingsset te houden, test_size = 0.25 om de overige 25% in de testset te houden en stratify = tele_class de waardes van de klasselabels in de dataset. Let op: de validatieset is alleen om een idee te krijgen van de fout op de testset. Hier is die hetzelfde gehouden als de testset.
from sklearn.cross_validation import train_test_split
training_indices, validation_indices = training_indices, testing_indices = train_test_split(tele.index,
                                                                                            stratify = tele_class,
                                                                                            train_size=0.75, test_size=0.25)
Je kunt de grootte van de trainingsset en validatieset controleren met het attribuut size.
training_indices.size, validation_indices.size
(14265, 4755)
Het is nu tijd om de bibliotheek tpot te gebruiken om ons de beste pijplijn voor dit binaire classificatieprobleem voor te stellen. Importeer daarvoor de klasse TPOTClassifier uit de bibliotheek tpot. Als dit een regressieprobleem was geweest, had je de klasse TPOTRegressor geïmporteerd.
TPOTClassifier heeft een groot aantal parameters, en je kunt er alles over lezen hier. Maar de belangrijkste die je moet kennen zijn:
accuracy, average_precision, roc_auc, recall, enz. Standaard is accuracy.Let ook op: mutation_rate + crossover_rate mag niet hoger zijn dan 1,0.
Hier gebruik je tpot met generations = 5 en de rest van de parameters op de standaardwaarden. De parameter verbosity = 2 geeft aan hoeveel informatie TPOT communiceert terwijl het draait.
Vervolgens roep je de methode fit() aan met de trainingsset (zonder de doelkolom) en de doelkolom als argumenten.
Let op: het uitvoeren van de code in de onderstaande cel duurt enkele uren. Met de gegeven TPOT-instellingen (5 generaties met population size 100) zal TPOT 500 pijplijnconfiguraties evalueren voordat het klaar is. Ter vergelijking: denk aan een grid search van 500 hyperparametercombinaties voor een machinelearningalgoritme en hoe lang die grid search duurt. Dat zijn 500 modelconfiguraties die met 5-voudige crossvalidatie worden geëvalueerd, wat betekent dat grofweg 2500 modellen worden getraind en geëvalueerd op de trainingsdata in één grid search. Dat is een tijdrovende procedure! Later leer je meer argumenten kennen die je aan TPOTClassifier kunt doorgeven om de uitvoeringstijd van TPOT te beperken.
from tpot import TPOTClassifier
from tpot import TPOTRegressor

tpot = TPOTClassifier(generations=5,verbosity=2)

tpot.fit(tele.drop('class',axis=1).loc[training_indices].values,
         tele.loc[training_indices,'class'].values)
Optimization Progress:  33%|███▎      | 200/600 [41:43<1:51:41, 16.75s/pipeline]

Generation 1 - Current best internal CV score: 0.880266061124

Optimization Progress:  50%|█████     | 300/600 [1:14:37<46:57,  9.39s/pipeline]

Generation 2 - Current best internal CV score: 0.880266061124

Optimization Progress:  67%|██████▋   | 400/600 [1:59:17<2:21:21, 42.41s/pipeline]

Generation 3 - Current best internal CV score: 0.880266061124

Optimization Progress:  84%|████████▎ | 501/600 [3:01:12<1:02:16, 37.74s/pipeline]

Generation 4 - Current best internal CV score: 0.881597992166

Generation 5 - Current best internal CV score: 0.881597992166

Best pipeline: GradientBoostingClassifier(RobustScaler(PolynomialFeatures(input_matrix, degree=2, include_bias=False, interaction_only=False)), learning_rate=0.1, max_depth=6, max_features=0.6000000000000001, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=5, max_eval_time_mins=5,
        max_time_mins=None, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=100, periodic_checkpoint_folder=None,
        population_size=100, random_state=None, scoring=None,
        subsample=1.0, verbosity=2, warm_start=False)
Hierboven zijn 5 generaties berekend, die elk de trainingsefficiëntie van het model op de trainingsset tonen. Zoals te zien is, is de beste pijplijn degene met een CV-nauwkeurigheidsscore van 88,16%. Het model dat dit resultaat oplevert is de pijplijn met preprocessingtechnieken zoals PloynomialFeatures en vervolgens RobustScaler die synthetische features toevoegen aan de invoerdata en deze normaliseren, waarna een Gradient Boosting-classifier wordt gebruikt om de uiteindelijke voorspellingen te maken. Je ziet ook dat tpot verschillende hyperparametervaarden geeft zoals learning_rate, max_depth, enzovoort, samen met de classifier.
Vervolgens wordt de testfout berekend voor validatiedoeleinden.
tpot.score(tele.drop('class',axis=1).loc[validation_indices].values,
           tele.loc[validation_indices, 'class'].values)
0.885173501577287
Zoals je ziet is de testnauwkeurigheid 88,51%.
Tot slot kun je TPOT vragen om de bijbehorende Python-code voor de geoptimaliseerde pijplijn naar een tekstbestand te exporteren met de exportfunctie:
tpot.export('tpot_MAGIC_Gamma_Telescope_pipeline.py')
True
## This is the pipeline that tpot generated: tpot_MAGIC_Gamma_Telescope_pipeline.py
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, RobustScaler

# NOTE: Make sure that the class is labeled 'target' in the data file
tpot_data = pd.read_csv('PATH/TO/DATA/FILE', sep='COLUMN_SEPARATOR', dtype=np.float64)
features = tpot_data.drop('target', axis=1).values
training_features, testing_features, training_target, testing_target = \
            train_test_split(features, tpot_data['target'].values, random_state=42)

# Score on the training set was:0.881597992166
exported_pipeline = make_pipeline(
    PolynomialFeatures(degree=2, include_bias=False, interaction_only=False),
    RobustScaler(),
    GradientBoostingClassifier(learning_rate=0.1, max_depth=6, max_features=0.6, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)
)

exported_pipeline.fit(training_features, training_target)
results = exported_pipeline.predict(testing_features)
Is dat niet geweldig? Zonder dat jij veel parameters en opties hoeft te finetunen om het beste model te krijgen, gaf TPOT je niet alleen informatie over het beste model maar ook werkende code daarvoor!
Zoals eerder aangegeven duurde de laatste TPOT-run meerdere uren. Er zijn parameters die je kunt opgeven om de uitvoeringstijd van TPOT te beperken, maar met een trade-off. Omdat je de tijd van de TPOT-uitvoering beperkt, kan TPOT niet alle mogelijke pijplijnen verkennen, en daarom is het beste model dat TPOT aan het einde van de beperkte tijd voorstelt mogelijk niet het best mogelijke model voor die dataset. Als er echter voldoende tijd wordt gegeven, zal het er min of meer dicht bij in de buurt komen. Enkele parameters zijn:
None is, overschrijft deze instelling de parameter generations en mag TPOT blijven draaien totdat max_time_mins is verstreken.n_jobs=-1 gebruikt zoveel cores als beschikbaar op de computer. Let op: meerdere processen op dezelfde machine kunnen geheugenproblemen veroorzaken bij grote datasets. Standaard is 1.Voor de oefening draai je TPOT opnieuw met extra argumenten max_time_mins = 2 en max_eval_time_mins = 0.04, maar dit keer met een verlaagde population_size = 15.
tpot = TPOTClassifier(verbosity=2, max_time_mins=2, max_eval_time_mins=0.04, population_size=15)
tpot.fit(tele.drop('class',axis=1).loc[training_indices].values, tele.loc[training_indices,'class'].values)
Optimization Progress: 42pipeline [00:42,  1.17s/pipeline]

Generation 1 - Current best internal CV score: 0.86119902629

Optimization Progress: 64pipeline [01:03,  1.04s/pipeline]

Generation 2 - Current best internal CV score: 0.86119902629

Optimization Progress: 83pipeline [01:21,  1.14s/pipeline]

Generation 3 - Current best internal CV score: 0.861689811492

Optimization Progress: 104pipeline [01:45,  1.03pipeline/s]

Generation 4 - Current best internal CV score: 0.861759642796

2.03228221667 minutes have elapsed. TPOT will close down.
TPOT closed prematurely. Will use the current best pipeline.

Best pipeline: XGBClassifier(RobustScaler(SelectPercentile(input_matrix, percentile=85)), learning_rate=0.1, max_depth=2, min_child_weight=4, n_estimators=100, nthread=1, subsample=0.1)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=1000000, max_eval_time_mins=0.04,
        max_time_mins=2, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=15, periodic_checkpoint_folder=None,
        population_size=15, random_state=None, scoring=None, subsample=1.0,
        verbosity=2, warm_start=False)
Zoals je ziet is de best presterende classifier binnen het opgegeven tijdsbestek nu XGBoost met SelectPercentile() en RobustScaler() als preprocessingstappen.
TPOT draaien is niet zo simpel als één model op de dataset fitten. Het overweegt meerdere machinelearningalgoritmen (random forests, lineaire modellen, SVM’s, enz.) in een pijplijn met tal van preprocessingstappen (imputatie van ontbrekende waarden, schalen, PCA, featureselectie, enz.), de hyperparameters voor alle modellen en preprocessingstappen, en meerdere manieren om de algoritmen binnen de pijplijn te ensemblen of te stacken. Daarom duurt het meestal lang om uit te voeren en is het niet haalbaar voor grote datasets.
Als je met een redelijk complexe dataset werkt of TPOT een korte tijd laat draaien, kunnen verschillende TPOT-runs tot verschillende pijplijnadviezen leiden. Wanneer twee TPOT-runs verschillende pijplijnen aanbevelen, betekent dit dat de TPOT-runs niet zijn geconvergeerd door tijdgebrek of dat meerdere pijplijnen min of meer hetzelfde presteren op jouw dataset.
Hoera! Je bent aan het einde van deze tutorial gekomen. Je begon met een korte introductie over het idee achter geautomatiseerde machine learning-platformen. Daarna verkende je genetische programmering en hoe TPOT dit gebruikt om het bouwen van machine learning-pijplijnen te automatiseren. Je oefende ook met het gebruik van de TPOT-bibliotheek in Python op een dataset en je leerde over de functies die het biedt. Als je van plan bent TPOT in de toekomst te gebruiken, raad ik je sterk aan om de uitstekende documentatie te bekijken. Veel plezier met ontdekken!
Wil je meer leren over machine learning in Python, volg dan DataCamp’s cursus Machine Learning with Tree-Based Models in Python. Bekijk ook DataCamp’s tutorial Introduction to Machine Learning in Python.
De volgende webpagina’s zijn als bron gebruikt bij het schrijven van deze tutorial.
Leer meer over Python en Machine Learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

