Kurs
Machine Learning verstehen
2 Std.
308.6K
In diesem Tutorial lernst du eine außergewöhnliche Python-Bibliothek kennen: tpot. Das Besondere an dieser Bibliothek ist, dass sie die gesamte Machine-Learning-Pipeline automatisiert und dir das leistungsstärkste Modell liefert. Konkret wirst du lernen:
Los geht’s!
Bevor du ein Machine-Learning-Problem löst, musst du viele Bausteine beachten: Datenaufbereitung, Feature-Auswahl, Feature Engineering, Modellauswahl und -validierung, Hyperparameter-Tuning usw. Theoretisch gibt es für jeden Baustein unzählige Techniken – aber sie liefern je nach Datensatz sehr unterschiedliche Ergebnisse. Die Herausforderung besteht darin, die bestmögliche Kombination zu finden, um den Fehler deiner Vorhersagen zu minimieren. Genau deshalb werden heute Auto-ML-Algorithmen und -Plattformen entwickelt: Damit jede Person – auch ohne ML-Expertise – schnell Modelle bauen kann. Eine dieser Plattformen gibt es als Python-Bibliothek: TPOT. Du kannst TPOT als deinen Data-Science-Assistenten betrachten. TPOT ist ein Automated-Machine-Learning-Tool für Python, das ML-Pipelines mit genetischer Programmierung optimiert. Es automatisiert den mühsamsten Teil von Machine Learning, indem es intelligent Tausende möglicher Pipelines erkundet – und die beste für deine Daten findet.
from IPython.core.display import Image
Image(filename="/home/manishpathak/DataCamp/tpot/tpot-ml-pipeline.png",width=800,height=800)
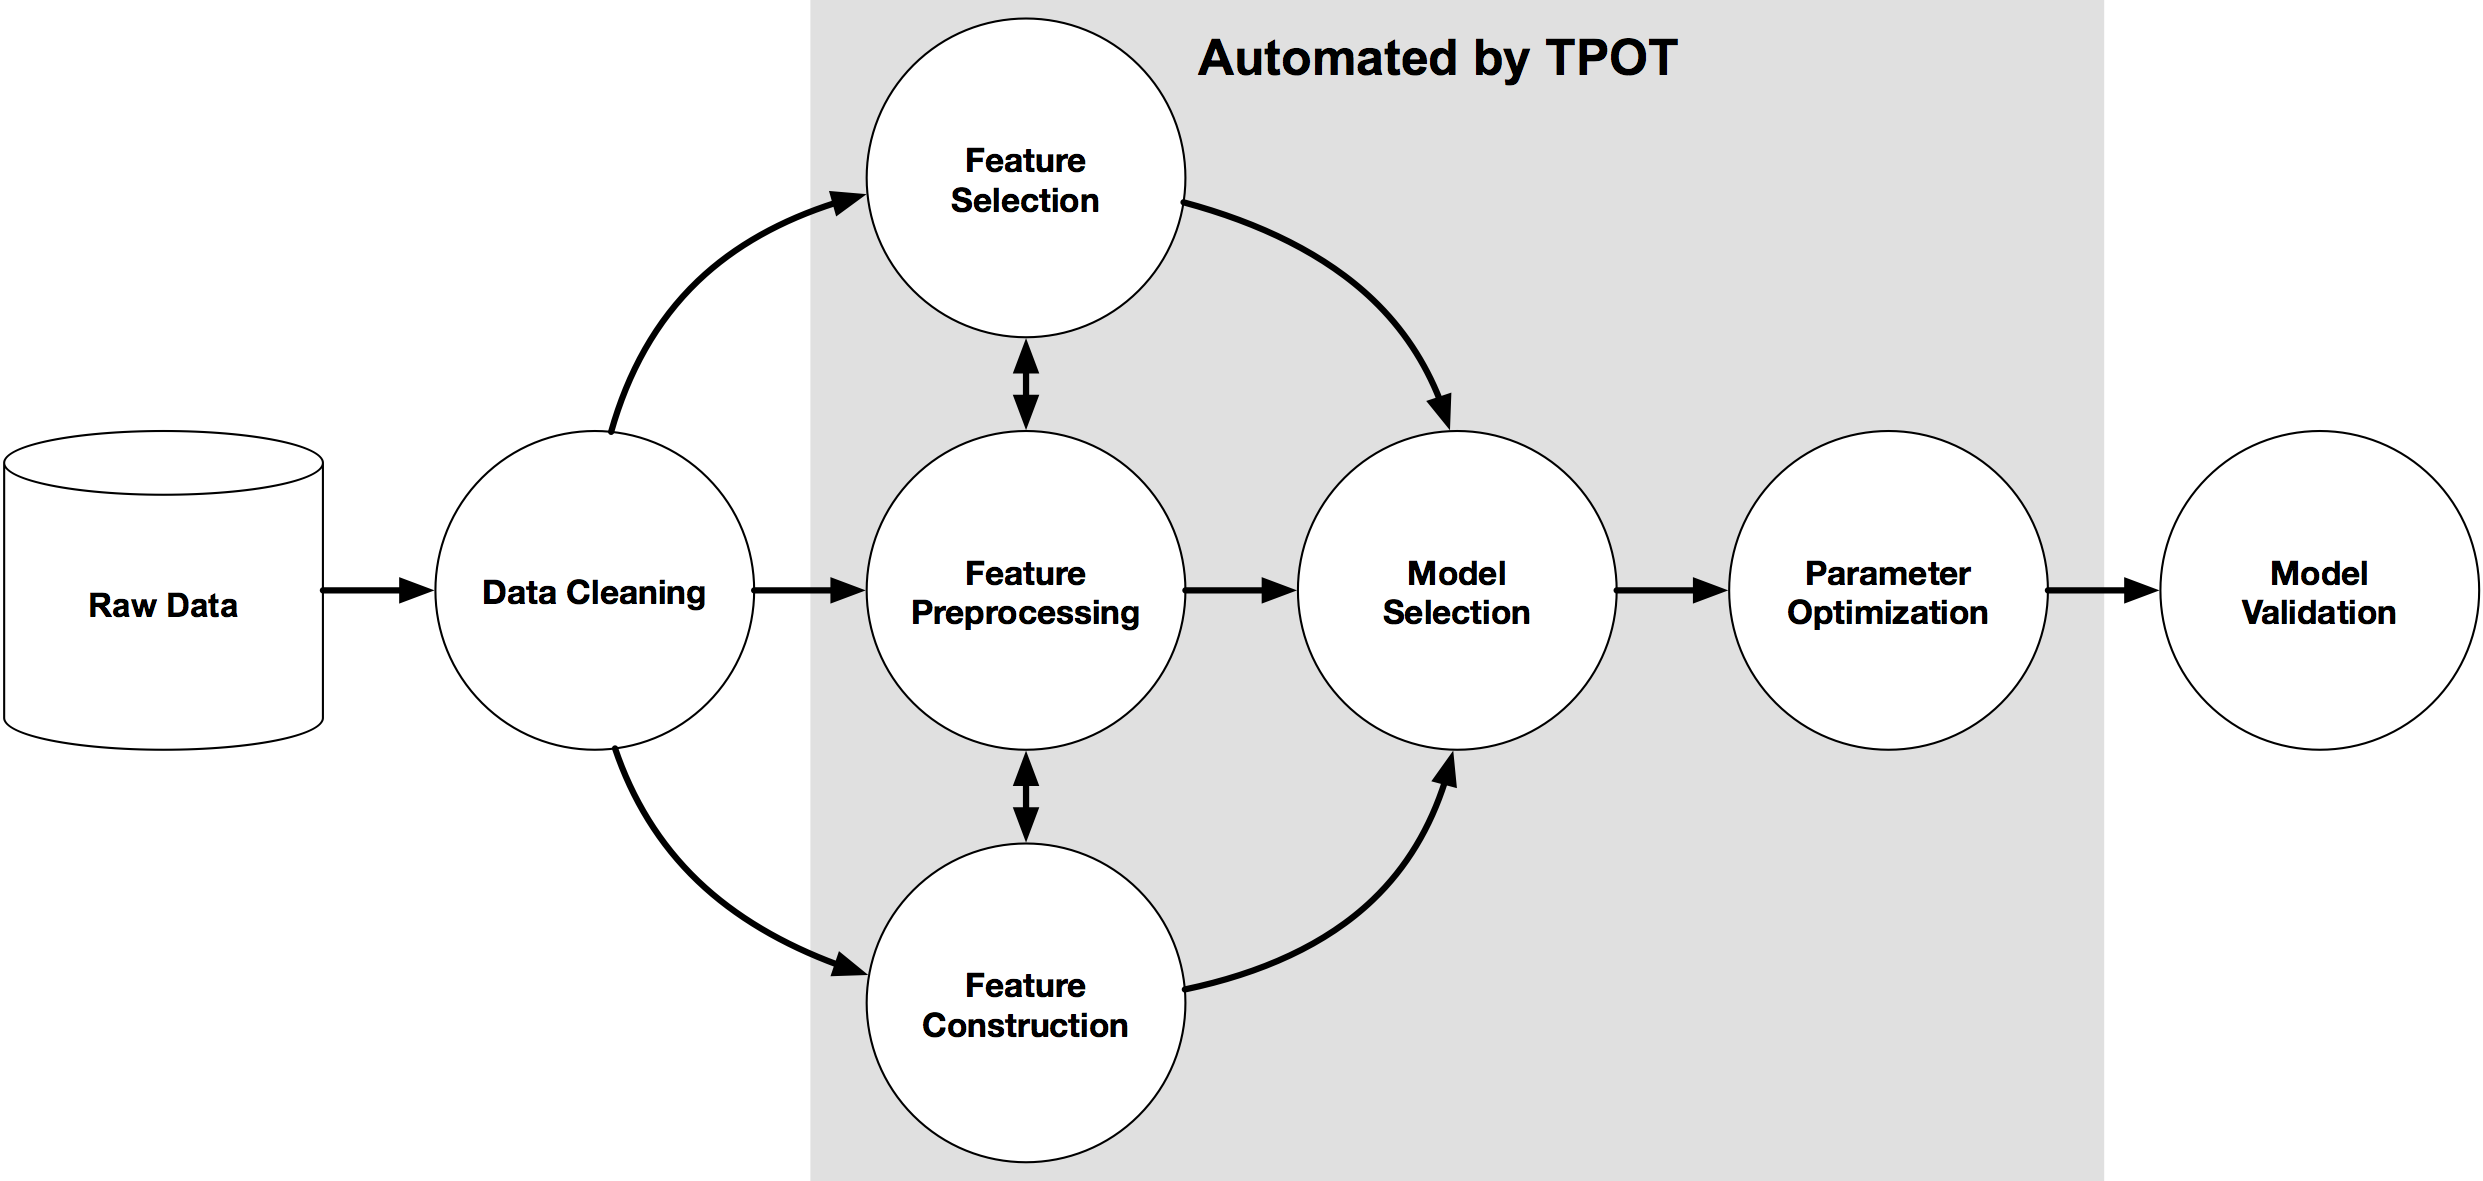
Wenn TPOT die Suche beendet hat, bekommst du den Python-Code für die beste gefundene Pipeline und kannst anschließend nach Belieben daran weiterfeilen.
Um tpot zu installieren, führe im Terminal den Befehl sudo pip install tpot aus oder schau dir diesen Link an. tpot baut auf mehreren bestehenden Python-Bibliotheken auf, darunter numpy, scipy, scikit-learn, DEAP, update_checker, tqdm, stopit, pandas. Die meisten Pakete kannst du über die Anaconda-Distribution installieren – oder einzeln. Optional kannst du auch XGBoost installieren, wenn tpot eXtreme Gradient Boosting-Modelle verwenden soll.
Mit den richtigen Daten, genug Rechenleistung und dem passenden ML-Modell lässt sich beinahe jedes Problem lösen – aber das richtige Modell zu wählen, ist schwierig: Decision Trees, SVM, KNN usw. Hier kann genetische Programmierung enorm helfen. Genetische Algorithmen sind vom darwinistischen Prinzip der natürlichen Selektion inspiriert und lösen Optimierungs- und Suchprobleme in der Informatik.
Ganz grob haben genetische Algorithmen drei Eigenschaften:
Genetische Programmierung ist ein großes Feld. Wenn du tiefer einsteigen willst, sieh dir diese Video-Reihe an.
Aber wie passt das zur Data Science?
Die Wahl des richtigen ML-Modells und seiner Hyperparameter ist selbst ein Optimierungsproblem – perfekt für genetische Programmierung. Die Python-Bibliothek tpot (auf scikit-learn) nutzt genetische Programmierung, um deine Pipeline zu optimieren. Nach der Datenaufbereitung musst du entscheiden, welche Features ins Modell gehen und wie sie konstruiert werden. Danach trainierst du das Modell und stimmst die Hyperparameter ab. Statt alles manuell per Trial-and-Error zu tun, automatisiert TPOT diese Schritte und liefert dir am Ende den optimalen Code.
Zur Veranschaulichung übst du mit tpot auf einem Open-Source-Datensatz: dem MAGIC Gamma Telescope DataSet. Die Daten simulieren die Registrierung hochenergetischer Gammapartikel in einem bodengebundenen Cherenkov-Gammateleskop mit Bildgebungstechnik. Details zur Beschreibung findest du unter diesem Link. Der Datensatz hat folgende Attribute/Features:
Ziel ist es, eine Beobachtung anhand der Attribute als Gamma (gewünschtes Signal) oder Hadron (Hintergrundrauschen) zu klassifizieren.
Starte mit dem Import der Bibliotheken pandas und numpy, um die Daten einzulesen und zu verarbeiten.
import pandas as pd
import numpy as np
Lies den Datensatz mit der pandas-Funktion read_csv() als DataFrame ein. Setze außerdem den Parameter header = None, da der Datensatz noch keine Spaltennamen hat.
telescope_data=pd.read_csv('https://archive.ics.uci.edu/ml/machine-learning-databases/magic/magic04.data',header=None)
Prüfe den Inhalt des DataFrames mit der Methode head().
telescope_data.head()

Vergib nun Spaltennamen, indem du dem Attribut columns des pandas-DataFrames eine Liste mit Namen zuweist.
telescope_data.columns = ['fLength', 'fWidth','fSize','fConc','fConcl','fAsym','fM3Long','fM3Trans','fAlpha','fDist','class']
telescope_data.head()

Jetzt hat dein DataFrame auch Spaltennamen.
Um Basisinformationen zum DataFrame zu erhalten – Anzahl Werte je Spalte, Datentypen, Count, Mittelwert usw. –, nutze die pandas-Methoden info() und describe().
telescope_data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 19020 entries, 0 to 19019
Data columns (total 11 columns):
fLength     19020 non-null float64
fWidth      19020 non-null float64
fSize       19020 non-null float64
fConc       19020 non-null float64
fConcl      19020 non-null float64
fAsym       19020 non-null float64
fM3Long     19020 non-null float64
fM3Trans    19020 non-null float64
fAlpha      19020 non-null float64
fDist       19020 non-null float64
class       19020 non-null object
dtypes: float64(10), object(1)
memory usage: 1.6+ MB
telescope_data.describe()

Alle Features im DataFrame sind kontinuierlich. Die Zielvariable/Feature class ist dagegen kategorial. Die Klassenverteilung der Zielvariablen prüfst du mit value_counts().
telescope_data['class'].value_counts()
g    12332
h     6688
Name: class, dtype: int64
Es ist meist sinnvoll, die Daten vor dem Start zufällig zu mischen, um Reihenfolgeeffekte zu vermeiden. Das geht mit numpy.random und permutation(). Um anschließend die Indizes neu zu setzen, nutze reset_index() mit drop = True.
telescope_shuffle=telescope_data.iloc[np.random.permutation(len(telescope_data))]
tele=telescope_shuffle.reset_index(drop=True)
tele.head()

Bevor du tpot nutzt, solltest du kategoriale Variablen im DataFrame labeln. Mehr dazu in diesem Tutorial. Hier ist nur die Zielvariable class kategorial, daher behandelst du diese Spalte. Ersetze die Klasse g (Signal) durch 0 und h (Hintergrund) durch 1. Das gelingt mit map() und einem Dictionary für die Zuordnung.
tele['class']=tele['class'].map({'g':0,'h':1})

tele.head()

Speichere nun die Klassenlabels, die vorhergesagt werden sollen, in der Variablen tele_class.
tele_class = tele['class'].values
Vor dem Einsatz von tpot solltest du fehlende Werte behandeln. Die Anzahl fehlender Werte je Spalte prüfst du so:
pd.isnull(tele).any()
fLength     False
fWidth      False
fSize       False
fConc       False
fConcl      False
fAsym       False
fM3Long     False
fM3Trans    False
fAlpha      False
fDist       False
class       False
dtype: bool
Dieser Datensatz hat keine fehlenden Werte. Hinweis: Bei fehlenden Werten kannst du Zeilen/Spalten mit dropna() entfernen oder Lücken z. B. mit fillna() ersetzen. Das folgende Snippet füllt NA-Werte mit dem Dummy-Wert -999:
tele = tele.fillna(-999)
Teile den DataFrame wie üblich in Trainings- und Testmenge. Das geht mit train_test_split aus sklearns cross_validation. Parameter: tele.index als Indizes, train_size = 0.75 für 75% Training, test_size = 0.25 für 25% Test und stratify = tele_class zur Beibehaltung der Klassenverteilung. Hinweis: Der Validierungsset dient hier nur als Näherung für den Testfehler und entspricht dem Testset.
from sklearn.cross_validation import train_test_split
training_indices, validation_indices = training_indices, testing_indices = train_test_split(tele.index,
                                                                                            stratify = tele_class,
                                                                                            train_size=0.75, test_size=0.25)
Die Größe von Trainings- und Validierungsmenge prüfst du mit dem Attribut size.
training_indices.size, validation_indices.size
(14265, 4755)
Jetzt kommt die tpot-Bibliothek zum Einsatz, um die beste Pipeline für dieses binäre Klassifikationsproblem vorzuschlagen. Importiere dazu die Klasse TPOTClassifier aus tpot. Bei einem Regressionsproblem würdest du TPOTRegressor importieren.
TPOTClassifier bietet viele Parameter, alle Details findest du hier. Die wichtigsten sind:
accuracy, average_precision, roc_auc, recall. Standard: accuracy.Hinweis: mutation_rate + crossover_rate dürfen zusammen 1,0 nicht überschreiten.
Hier verwendest du tpot mit generations = 5, alle anderen Parameter bleiben auf Standardwerten. Der Parameter verbosity = 2 bestimmt, wie viele Statusmeldungen TPOT während der Laufzeit ausgibt.
Dann rufst du fit() mit dem Trainingsset (ohne Zielspalte) und der Zielspalte auf.
Hinweis: Das Ausführen der folgenden Zelle kann mehrere Stunden dauern. Mit den angegebenen TPOT-Einstellungen (5 Generationen, Population 100) evaluiert TPOT 500 Pipeline-Konfigurationen. Zum Vergleich: Eine Grid-Search mit 500 Hyperparameter-Kombinationen und 5-facher Cross-Validation bedeutet rund 2.500 Modell-Fits – das dauert. Später erfährst du Parameter, mit denen du die Laufzeit steuern kannst.
from tpot import TPOTClassifier
from tpot import TPOTRegressor

tpot = TPOTClassifier(generations=5,verbosity=2)

tpot.fit(tele.drop('class',axis=1).loc[training_indices].values,
         tele.loc[training_indices,'class'].values)
Optimization Progress:  33%|███▎      | 200/600 [41:43<1:51:41, 16.75s/pipeline]

Generation 1 - Current best internal CV score: 0.880266061124

Optimization Progress:  50%|█████     | 300/600 [1:14:37<46:57,  9.39s/pipeline]

Generation 2 - Current best internal CV score: 0.880266061124

Optimization Progress:  67%|██████▋   | 400/600 [1:59:17<2:21:21, 42.41s/pipeline]

Generation 3 - Current best internal CV score: 0.880266061124

Optimization Progress:  84%|████████▎ | 501/600 [3:01:12<1:02:16, 37.74s/pipeline]

Generation 4 - Current best internal CV score: 0.881597992166

Generation 5 - Current best internal CV score: 0.881597992166

Best pipeline: GradientBoostingClassifier(RobustScaler(PolynomialFeatures(input_matrix, degree=2, include_bias=False, interaction_only=False)), learning_rate=0.1, max_depth=6, max_features=0.6000000000000001, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=5, max_eval_time_mins=5,
        max_time_mins=None, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=100, periodic_checkpoint_folder=None,
        population_size=100, random_state=None, scoring=None,
        subsample=1.0, verbosity=2, warm_start=False)
Oben wurden 5 Generationen berechnet, jeweils mit der Trainingsleistung des Modells auf dem Trainingsset. Die beste Pipeline erreicht eine CV-Accuracy von 88,16%. Das Modell ist eine Pipeline aus Preprocessing-Schritten wie PolynomialFeatures und RobustScaler, die synthetische Features erzeugen und normalisieren. Darauf folgt ein Gradient-Boosting-Classifier für die finalen Vorhersagen. tpot liefert dir außerdem die gewählten Hyperparameter wie learning_rate, max_depth usw.
Als Nächstes wird der Testfehler zu Validierungszwecken berechnet.
tpot.score(tele.drop('class',axis=1).loc[validation_indices].values,
           tele.loc[validation_indices, 'class'].values)
0.885173501577287
Die Testgenauigkeit liegt bei 88,51%.
Zum Schluss kannst du TPOT anweisen, den zugehörigen Python-Code für die optimierte Pipeline in eine Textdatei zu exportieren:
tpot.export('tpot_MAGIC_Gamma_Telescope_pipeline.py')
True
## This is the pipeline that tpot generated: tpot_MAGIC_Gamma_Telescope_pipeline.py
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, RobustScaler

# NOTE: Make sure that the class is labeled 'target' in the data file
tpot_data = pd.read_csv('PATH/TO/DATA/FILE', sep='COLUMN_SEPARATOR', dtype=np.float64)
features = tpot_data.drop('target', axis=1).values
training_features, testing_features, training_target, testing_target = \
            train_test_split(features, tpot_data['target'].values, random_state=42)

# Score on the training set was:0.881597992166
exported_pipeline = make_pipeline(
    PolynomialFeatures(degree=2, include_bias=False, interaction_only=False),
    RobustScaler(),
    GradientBoostingClassifier(learning_rate=0.1, max_depth=6, max_features=0.6, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)
)

exported_pipeline.fit(training_features, training_target)
results = exported_pipeline.predict(testing_features)
Ziemlich stark, oder? Ohne langes Herumprobieren liefert dir TPOT nicht nur Infos zum besten Modell, sondern direkt lauffähigen Code dazu!
Wie erwähnt, hat der letzte TPOT-Lauf mehrere Stunden gedauert. Es gibt Parameter, mit denen du die Laufzeit steuern kannst – allerdings mit Trade-off. Wenn du die Zeit begrenzt, kann TPOT nicht alle möglichen Pipelines prüfen und das empfohlene Modell ist am Ende der vorgegebenen Zeit möglicherweise nicht das absolut beste. Mit ausreichend Zeit nähert es sich aber stark dem Optimum an. Wichtige Parameter sind:
None, überschreibt dieser Wert generations und TPOT läuft bis zum Ablauf der Minuten.n_jobs=-1 nutzt alle verfügbaren Kerne. Achtung: Mehr Prozesse können bei großen Datensätzen zu Speicherdruck führen. Standard: 1.Zum Üben startest du TPOT erneut mit zusätzlichen Argumenten max_time_mins = 2 und max_eval_time_mins = 0.04 – diesmal mit reduzierter population_size = 15.
tpot = TPOTClassifier(verbosity=2, max_time_mins=2, max_eval_time_mins=0.04, population_size=15)
tpot.fit(tele.drop('class',axis=1).loc[training_indices].values, tele.loc[training_indices,'class'].values)
Optimization Progress: 42pipeline [00:42,  1.17s/pipeline]

Generation 1 - Current best internal CV score: 0.86119902629

Optimization Progress: 64pipeline [01:03,  1.04s/pipeline]

Generation 2 - Current best internal CV score: 0.86119902629

Optimization Progress: 83pipeline [01:21,  1.14s/pipeline]

Generation 3 - Current best internal CV score: 0.861689811492

Optimization Progress: 104pipeline [01:45,  1.03pipeline/s]

Generation 4 - Current best internal CV score: 0.861759642796

2.03228221667 minutes have elapsed. TPOT will close down.
TPOT closed prematurely. Will use the current best pipeline.

Best pipeline: XGBClassifier(RobustScaler(SelectPercentile(input_matrix, percentile=85)), learning_rate=0.1, max_depth=2, min_child_weight=4, n_estimators=100, nthread=1, subsample=0.1)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=1000000, max_eval_time_mins=0.04,
        max_time_mins=2, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=15, periodic_checkpoint_folder=None,
        population_size=15, random_state=None, scoring=None, subsample=1.0,
        verbosity=2, warm_start=False)
Wie du siehst, ist innerhalb des vorgegebenen Zeitfensters XGBoost der beste Klassifikator, mit SelectPercentile() und RobustScaler() als Preprocessing-Schritten.
TPOT auszuführen ist nicht so simpel wie ein einzelnes Modell zu fitten. Es berücksichtigt mehrere Algorithmen (Random Forests, lineare Modelle, SVMs usw.) in einer Pipeline mit zahlreichen Preprocessing-Schritten (Imputation fehlender Werte, Skalierung, PCA, Feature-Auswahl usw.), die Hyperparameter aller Modelle und Schritte sowie verschiedene Ensemble- oder Stacking-Varianten. Deshalb dauert die Ausführung häufig lange und ist für sehr große Datensätze kaum praktikabel.
Bei komplexeren Datensätzen oder kurzen Laufzeiten können unterschiedliche TPOT-Durchläufe verschiedene Pipelines empfehlen. Das bedeutet, dass die Läufe mangels Zeit nicht konvergiert sind – oder dass mehrere Pipelines auf deinem Datensatz ähnlich gut performen.
Geschafft! Du bist am Ende dieses Tutorials angekommen. Du hast mit einer kurzen Einführung in Automated-Machine-Learning-Plattformen begonnen, dann genetische Programmierung und den Einsatz von TPOT zur Automatisierung von ML-Pipelines erkundet. Außerdem hast du TPOT in Python praktisch auf einen Datensatz angewendet und die wichtigsten Funktionen kennengelernt. Wenn du TPOT künftig nutzen möchtest, empfehle ich dir die hervorragende Dokumentation. Viel Erfolg beim Ausprobieren!
Wenn du mehr über Machine Learning in Python lernen willst, besuche DataCamps Kurs Machine Learning with Tree-Based Models in Python. Lies außerdem DataCamps Tutorial Introduction to Machine Learning in Python.
Die folgenden Webseiten dienten als Quellen für dieses Tutorial.
Mehr über Python und Machine Learning
Kurs
Kurs
Kurs
Tutorial
DataCamp Team
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
Satyabrata Pal
15 Min.


