कोर्स
Understanding Machine Learning
2 घंटा
311.4K
इस ट्यूटोरियल में, आप Python में एक बेहद अनोखी लाइब्रेरी: tpot का उपयोग करना सीखेंगे। यह लाइब्रेरी इसलिए अनोखी है क्योंकि यह पूरी Machine Learning पाइपलाइन को स्वचालित करती है और आपको सबसे बेहतर प्रदर्शन करने वाला मशीन लर्निंग मॉडल प्रदान करती है। खास तौर पर, आप सीखेंगे:
चलिए शुरू करते हैं!
किसी मशीन लर्निंग समस्या को हल करने से पहले आपको कई घटकों पर विचार करना होता है, जैसे डेटा तैयारी, फीचर चयन, फीचर इंजीनियरिंग, मॉडल चयन और मान्यकरण, हाइपरपैरामीटर ट्यूनिंग, आदि। सिद्धांत रूप में, आप इन प्रत्येक घटकों के लिए ढेरों तकनीकों को ढूंढ और लागू कर सकते हैं, लेकिन वे अलग-अलग डेटासेट्स पर अलग तरह से प्रदर्शन कर सकती हैं। चुनौती यह है कि तकनीकों के उस संयोजन को ढूंढा जाए जो सर्वश्रेष्ठ प्रदर्शन दे ताकि आपकी भविष्यवाणियों में त्रुटि न्यूनतम हो। यही मुख्य कारण है कि आजकल लोग Auto-ML एल्गोरिद्म और प्लेटफ़ॉर्म विकसित करने पर काम कर रहे हैं ताकि बिना किसी मशीन लर्निंग विशेषज्ञता के भी कोई व्यक्ति कम समय और प्रयास में मॉडल बना सके। ऐसा ही एक प्लेटफ़ॉर्म Python लाइब्रेरी के रूप में उपलब्ध है: TPOT। आप TPOT को अपना Data Science Assistant मान सकते हैं। TPOT एक Python Automated Machine Learning टूल है जो genetic programming का उपयोग करके मशीन लर्निंग पाइपलाइनों का अनुकूलन करता है। यह आपकी डेटा के लिए सबसे अच्छी पाइपलाइन ढूंढने के लिए बुद्धिमानी से हजारों संभावित पाइपलाइनों का पता लगाकर मशीन लर्निंग के सबसे नीरस हिस्से को स्वचालित कर देता है।
from IPython.core.display import Image
Image(filename="/home/manishpathak/DataCamp/tpot/tpot-ml-pipeline.png",width=800,height=800)
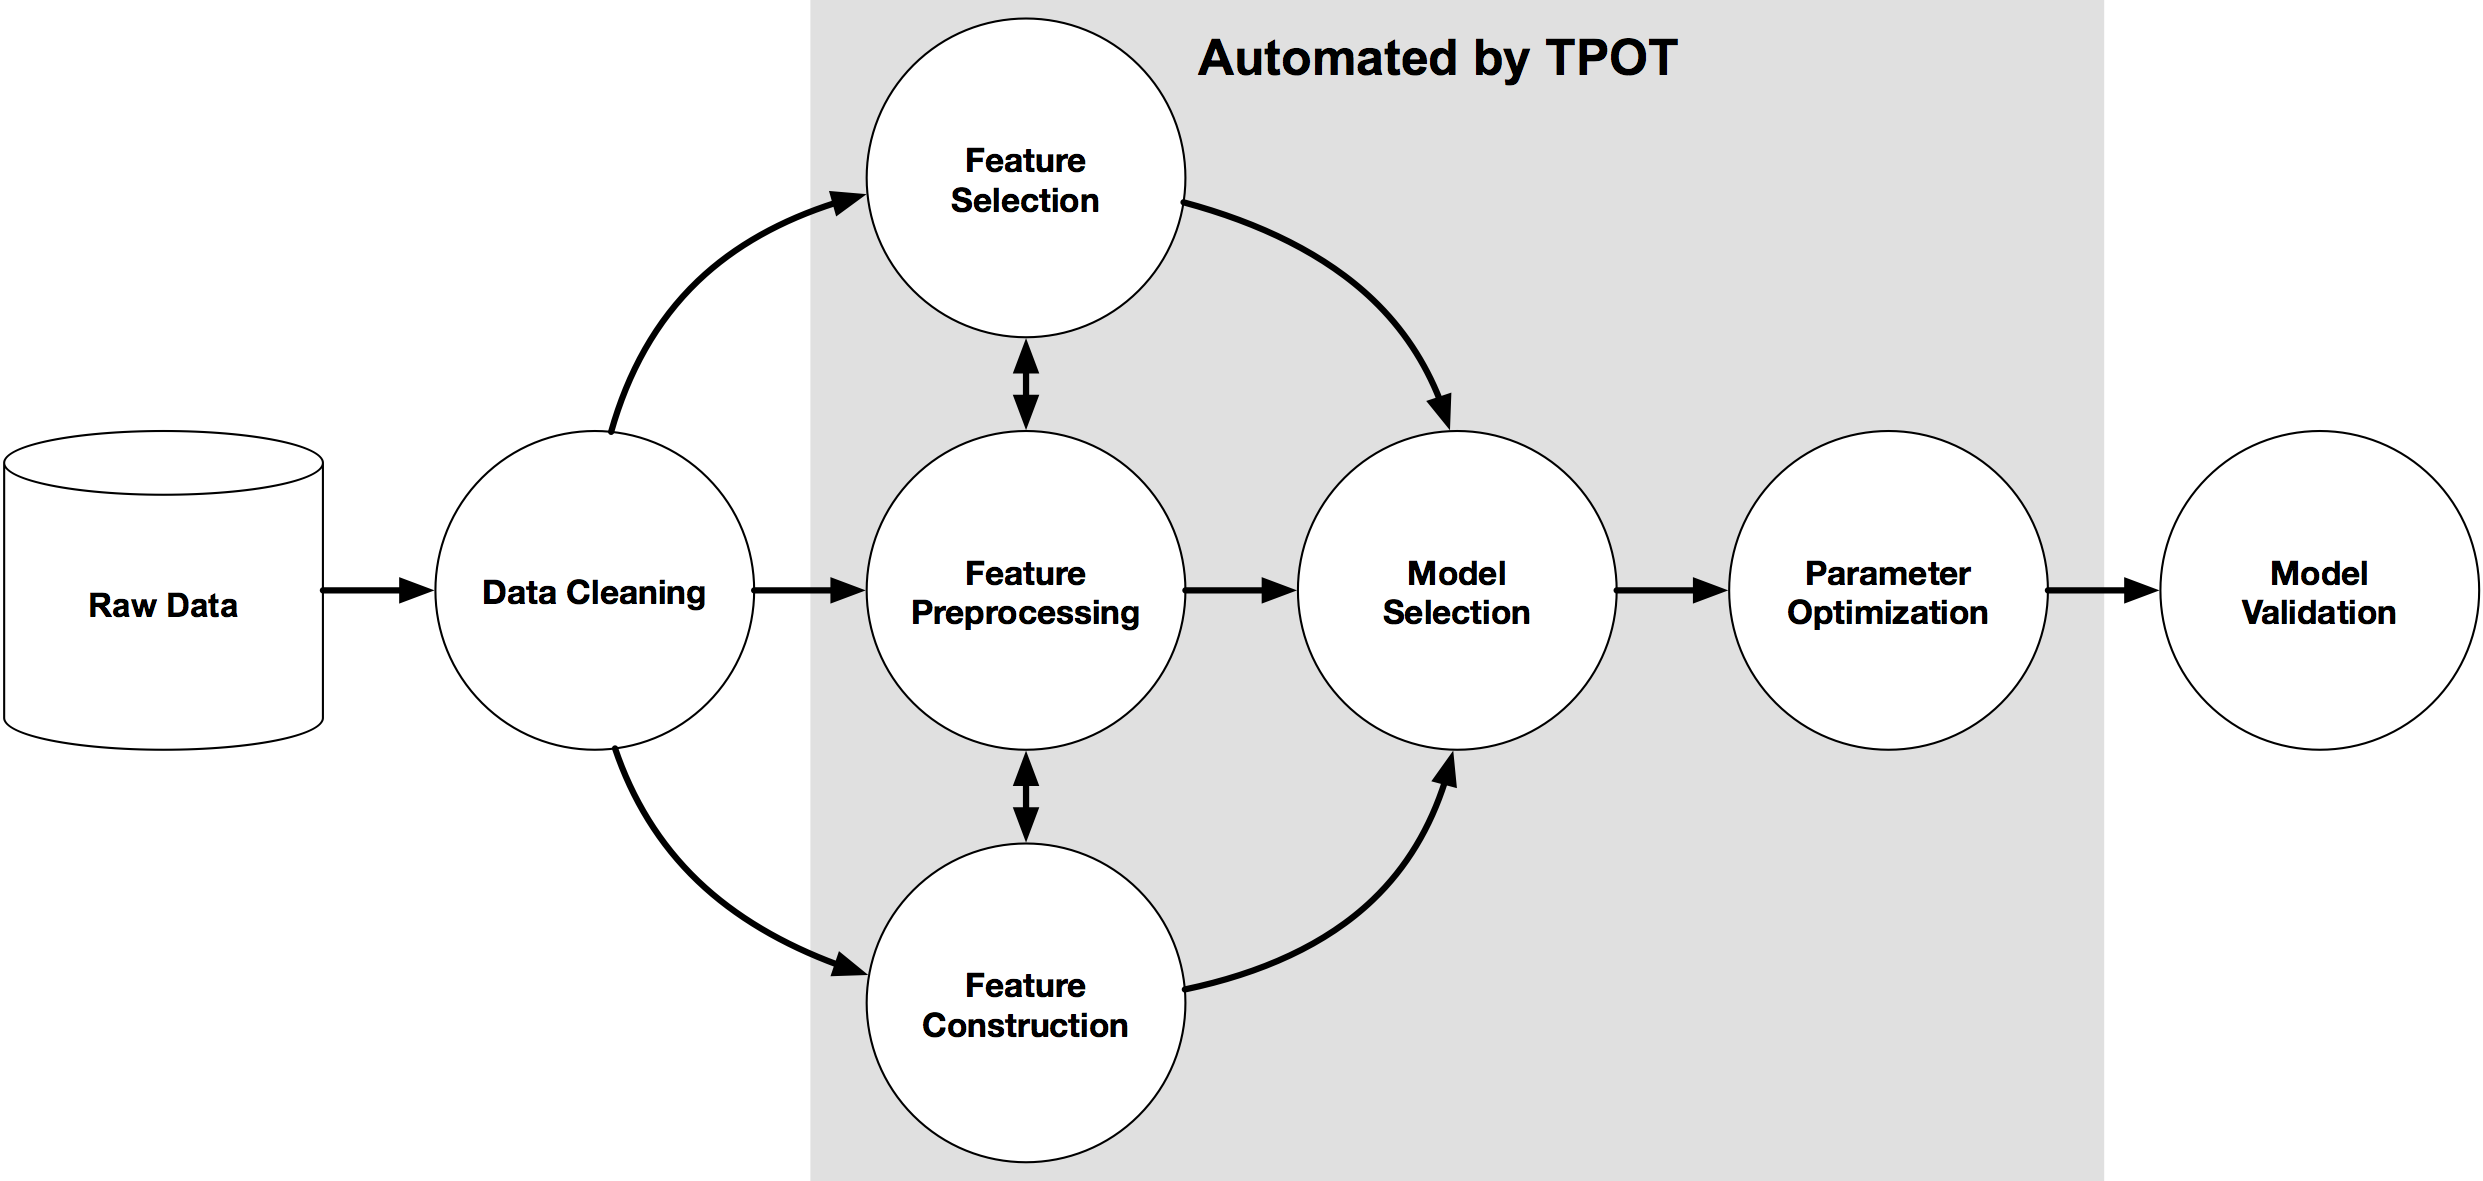
जब TPOT अपनी खोज पूरी कर लेता है, तो यह आपके लिए मिली सर्वश्रेष्ठ पाइपलाइन का Python कोड प्रदान करता है ताकि आप आगे उस पाइपलाइन के साथ छेड़छाड़ कर सकें।
अपने सिस्टम पर tpot इंस्टॉल करने के लिए, आप कमांड लाइन टर्मिनल पर sudo pip install tpot कमांड चला सकते हैं या इस लिंक को देखें। tpot कई मौजूदा Python लाइब्रेरीज़ के ऊपर बनाया गया है, जिनमें numpy, scipy, scikit-learn, DEAP, update_checker, tqdm, stopit, pandas शामिल हैं। अधिकांश आवश्यक Python पैकेज Anaconda Python वितरण के माध्यम से इंस्टॉल किए जा सकते हैं, या आप उन्हें अलग-अलग भी इंस्टॉल कर सकते हैं। वैकल्पिक रूप से, यदि आप चाहते हैं कि tpot eXtreme Gradient Boosting मॉडल्स का उपयोग करे, तो आप XGBoost भी इंस्टॉल कर सकते हैं।
सही डेटा, कंप्यूटिंग पावर और मशीन लर्निंग मॉडल के साथ आप किसी भी समस्या का समाधान खोज सकते हैं, लेकिन किस मॉडल का उपयोग किया जाए यह जानना चुनौतीपूर्ण हो सकता है क्योंकि मॉडल बहुत से हैं, जैसे Decision Trees, SVM, KNN, आदि। ऐसे में genetic programming बहुत काम आती है और मदद करती है। Genetic एल्गोरिद्म Darwin के Natural Selection की प्रक्रिया से प्रेरित होते हैं, और कंप्यूटर विज्ञान में ऑप्टिमाइज़ेशन और सर्च समस्याओं के समाधान उत्पन्न करने के लिए उपयोग किए जाते हैं।
सामान्य तौर पर, Genetic Algorithms की तीन विशेषताएँ होती हैं:
Genetic Programming अपने आप में कंप्यूटर विज्ञान का एक बड़ा विषय है, लेकिन यदि आप genetic algorithms में गहराई से जाना चाहते हैं, तो इस वीडियो श्रृंखला को देखें।
लेकिन यह सब डेटा साइंस में कैसे फिट बैठता है?
असल में, सही मशीन लर्निंग मॉडल और उसके सर्वोत्तम हाइपरपैरामीटर्स चुनना अपने आप में एक ऑप्टिमाइज़ेशन समस्या है, जिसके लिए genetic programming का उपयोग किया जा सकता है। scikit-learn के ऊपर बनी Python लाइब्रेरी tpot genetic programming का उपयोग करके आपकी मशीन लर्निंग पाइपलाइन को ऑप्टिमाइज़ करती है। उदाहरण के लिए, मशीन लर्निंग में, डेटा तैयार करने के बाद आपको यह जानने की ज़रूरत होती है कि अपने मॉडल में कौन से फीचर्स देने हैं और उन फीचर्स का निर्माण कैसे करना है। एक बार आपके पास वे फीचर्स हों, तो आप उन्हें मॉडल को ट्रेन करने के लिए देते हैं, और फिर सर्वोत्तम परिणामों के लिए हाइपरपैरामीटर्स ट्यून करते हैं। ट्रायल-एंड-एरर से यह सब स्वयं करने के बजाय, TPOT इन चरणों को genetic programming के साथ आपके लिए स्वचालित कर देता है और काम पूरा होने पर आपके लिए सर्वोत्तम कोड आउटपुट करता है।
और समझने के लिए, आप एक ओपन सोर्स डेटासेट पर tpot लाइब्रेरी का उपयोग अभ्यास के तौर पर करेंगे। जो डेटासेट आप उपयोग करेंगे वह है MAGIC Gamma Telescope DataSet। यह डेटा इमेजिंग तकनीक का उपयोग करते हुए, ग्राउंड-बेस्ड एटमॉस्फेरिक Cherenkov गामा टेलिस्कोप में उच्च ऊर्जा गामा कणों के रजिस्ट्रेशन का सिमुलेशन करने के लिए जनरेट किया गया है। डेटासेट विवरण के पूरे विवरण के लिए यह लिंक देखें। डेटासेट में निम्नलिखित गुण/फीचर्स हैं:
उद्देश्य यह है कि दिए गए गुणों के आधार पर किसी ऑब्ज़र्वेशन को gamma (वांछित सिग्नल) या hadron (पृष्ठभूमि शोर) के रूप में वर्गीकृत किया जाए।
आप pandas और numpy लाइब्रेरीज़ इम्पोर्ट करके शुरू करेंगे, क्रमशः डेटा पढ़ने और उस पर गणनाएँ करने के लिए।
import pandas as pd
import numpy as np
डेटासेट को DataFrame के रूप में पढ़ने के लिए pandas की read_csv() फ़ंक्शन का उपयोग करें। साथ ही, पैरामीटर header = None निर्दिष्ट करें क्योंकि डेटासेट में अभी कॉलम नाम नहीं हैं।
telescope_data=pd.read_csv('https://archive.ics.uci.edu/ml/machine-learning-databases/magic/magic04.data',header=None)
head() मेथड का उपयोग करके DataFrame की सामग्री जाँचें।
telescope_data.head()

DataFrame के कॉलम्स को नाम देने के लिए आप pandas DataFrame के columns एट्रिब्यूट का उपयोग कर सकते हैं और उसे कॉलम नामों की सूची असाइन कर सकते हैं।
telescope_data.columns = ['fLength', 'fWidth','fSize','fConc','fConcl','fAsym','fM3Long','fM3Trans','fAlpha','fDist','class']
telescope_data.head()

अब आपके DataFrame में कॉलम नाम भी हैं।
DataFrame के बारे में आवश्यक जानकारी पाने के लिए, जैसे प्रत्येक कॉलम में मानों की संख्या, डेटा-टाइप, काउंट, औसत आदि, आप pandas के info() और describe() मेथड्स का उपयोग कर सकते हैं।
telescope_data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 19020 entries, 0 to 19019
Data columns (total 11 columns):
fLength     19020 non-null float64
fWidth      19020 non-null float64
fSize       19020 non-null float64
fConc       19020 non-null float64
fConcl      19020 non-null float64
fAsym       19020 non-null float64
fM3Long     19020 non-null float64
fM3Trans    19020 non-null float64
fAlpha      19020 non-null float64
fDist       19020 non-null float64
class       19020 non-null object
dtypes: float64(10), object(1)
memory usage: 1.6+ MB
telescope_data.describe()

पता चलता है कि DataFrame में सभी फीचर्स सतत प्रकृति के हैं। जबकि टारगेट वैरिएबल/फीचर class श्रेणीबद्ध है। आप टारगेट वैरिएबल में प्रत्येक क्लास की गिनती value_counts() मेथड से जाँच सकते हैं।
telescope_data['class'].value_counts()
g    12332
h     6688
Name: class, dtype: int64
आमतौर पर शुरुआत में डेटा को रैंडम तरीके से शफ़ल करना अच्छा विचार होता है ताकि डेटा में किसी प्रकार का ऑर्डरिंग प्रभाव न रहे। आप numpy के random और permutation() फ़ंक्शन की मदद से DataFrame में डेटा का पुनर्विन्यास कर सकते हैं। शफ़ल के बाद इंडेक्स नंबर रीसेट करने के लिए reset_index() मेथड का उपयोग करें और पैरामीटर के रूप में drop = True दें।
telescope_shuffle=telescope_data.iloc[np.random.permutation(len(telescope_data))]
tele=telescope_shuffle.reset_index(drop=True)
tele.head()

tpot का उपयोग करने से पहले, आपके DataFrame में श्रेणीबद्ध वैरिएबल्स का लेबलिंग करना आवश्यक है। श्रेणीबद्ध वैरिएबल्स की लेबलिंग के बारे में अधिक जानने के लिए यह ट्यूटोरियल देखें। यहाँ केवल टारगेट वैरिएबल class श्रेणीबद्ध फीचर है, इसलिए उसका ही उपचार होना चाहिए। आप g क्लास (signal) को संख्यात्मक मान 0 और h क्लास (background) को संख्यात्मक मान 1 से बदलेंगे। यह map() फ़ंक्शन के जरिए किया जा सकता है, जिसमें आर्गुमेंट के रूप में एक डिक्शनरी दी जाती है जो टारगेट वैरिएबल की कक्षाओं का संबंधित मैपिंग रखती है।
tele['class']=tele['class'].map({'g':0,'h':1})

tele.head()

अब आप उन क्लास लेबल्स को, जिनकी भविष्यवाणी आपको करनी है, एक अलग वैरिएबल tele_class में स्टोर करेंगे।
tele_class = tele['class'].values
tpot का उपयोग करने से पहले आपको मिसिंग वैल्यू ट्रीटमेंट भी करना चाहिए। कॉलम-वाइज मिसिंग वैल्यूज़ की संख्या जाँचने के लिए, आप निम्नलिखित चला सकते हैं:
pd.isnull(tele).any()
fLength     False
fWidth      False
fSize       False
fConc       False
fConcl      False
fAsym       False
fM3Long     False
fM3Trans    False
fAlpha      False
fDist       False
class       False
dtype: bool
इस डेटासेट में कोई मिसिंग वैल्यू नहीं है। ध्यान दें जिन डेटासेट्स में मिसिंग वैल्यूज़ हों, उनमें आप या तो पंक्तियाँ/कॉलम्स dropna() मेथड से हटा सकते हैं या fillna() मेथड से किसी डमी मान से मिसिंग वैल्यू को भर सकते हैं। उदाहरण के तौर पर, नीचे दिया गया कोड-टुकड़ा NA वैल्यूज़ को डमी मान -999 से बदल देगा।
tele = tele.fillna(-999)
अब आप किसी भी मशीन लर्निंग मॉडलिंग की तरह DataFrame को training सेट और testing सेट में बाँटेंगे। आप यह sklearn के cross_validation train_test_split के जरिए कर सकते हैं। पैरामीटर्स हैं tele.index DataFrame के इंडेक्स के रूप में, train_size = 0.75 ताकि 75% डेटा training सेट में रहे, test_size = 0.25 ताकि शेष 25% डेटा testing सेट में रहे और stratify = tele_class डेटासेट में क्लास लेबल्स के मानों के रूप में। ध्यान दें वैलिडेशन सेट केवल हमें टेस्ट सेट एरर का अंदाज़ा देने के लिए है। यहाँ इसे टेस्ट सेट के समान रखा गया है।
from sklearn.cross_validation import train_test_split
training_indices, validation_indices = training_indices, testing_indices = train_test_split(tele.index,
                                                                                            stratify = tele_class,
                                                                                            train_size=0.75, test_size=0.25)
size एट्रिब्यूट का उपयोग करके आप training सेट और validation सेट का आकार जाँच सकते हैं।
training_indices.size, validation_indices.size
(14265, 4755)
अब tpot लाइब्रेरी का उपयोग करके इस बाइनरी क्लासिफिकेशन समस्या के लिए सर्वश्रेष्ठ पाइपलाइन सुझाने का समय है। ऐसा करने के लिए, आपको tpot लाइब्रेरी से TPOTClassifier क्लास इम्पोर्ट करनी होगी। यदि यह एक रिग्रेशन समस्या होती, तो आप TPOTRegressor क्लास इम्पोर्ट करते।
TPOTClassifier में बहुत से पैरामीटर्स होते हैं, और आप उनके बारे में विस्तार से यहाँ पढ़ सकते हैं। लेकिन जिन उल्लेखनीय पैरामीटर्स को आपको जानना चाहिए, वे हैं:
accuracy, average_precision, roc_auc, recall, आदि। डिफ़ॉल्ट accuracy है।साथ ही ध्यान दें mutation_rate + crossover_rate 1.0 से अधिक नहीं हो सकते।
यहाँ आप generations = 5 के साथ tpot का उपयोग करेंगे और बाकी पैरामीटर्स को डिफ़ॉल्ट मानों पर रहने देंगे। पैरामीटर verbosity = 2 यह दर्शाता है कि चलने के दौरान TPOT कितनी जानकारी साझा करता है।
फिर आप fit() मेथड को training सेट (टारगेट कॉलम के बिना) और टारगेट कॉलम को आर्गुमेंट्स के रूप में देकर कॉल करेंगे।
ध्यान दें नीचे की सेल में कोड चलाने में कई घंटे लगेंगे। दिए गए TPOT सेटिंग्स (5 generations और 100 population size) के साथ, TPOT खत्म होने से पहले 500 पाइपलाइन कॉन्फ़िगरेशन का मूल्यांकन करेगा। संदर्भ के लिए सोचें कि किसी मशीन लर्निंग एल्गोरिद्म के 500 हाइपरपैरामीटर कॉम्बिनेशन का grid search कितना समय लेगा। यह 5-fold क्रॉस-वैलिडेशन के साथ 500 मॉडल कॉन्फ़िगरेशन का मूल्यांकन है, यानी एक grid search में लगभग 2500 मॉडल्स को ट्रेन और इवैल्यूएट किया जाता है। यह समय लेने वाली प्रक्रिया है! आगे आप कुछ और आर्गुमेंट्स के बारे में जानेंगे जिन्हें TPOTClassifier को पास करके TPOT के समाप्त होने के समय को नियंत्रित किया जा सकता है।
from tpot import TPOTClassifier
from tpot import TPOTRegressor

tpot = TPOTClassifier(generations=5,verbosity=2)

tpot.fit(tele.drop('class',axis=1).loc[training_indices].values,
         tele.loc[training_indices,'class'].values)
Optimization Progress:  33%|███▎      | 200/600 [41:43<1:51:41, 16.75s/pipeline]

Generation 1 - Current best internal CV score: 0.880266061124

Optimization Progress:  50%|█████     | 300/600 [1:14:37<46:57,  9.39s/pipeline]

Generation 2 - Current best internal CV score: 0.880266061124

Optimization Progress:  67%|██████▋   | 400/600 [1:59:17<2:21:21, 42.41s/pipeline]

Generation 3 - Current best internal CV score: 0.880266061124

Optimization Progress:  84%|████████▎ | 501/600 [3:01:12<1:02:16, 37.74s/pipeline]

Generation 4 - Current best internal CV score: 0.881597992166

Generation 5 - Current best internal CV score: 0.881597992166

Best pipeline: GradientBoostingClassifier(RobustScaler(PolynomialFeatures(input_matrix, degree=2, include_bias=False, interaction_only=False)), learning_rate=0.1, max_depth=6, max_features=0.6000000000000001, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=5, max_eval_time_mins=5,
        max_time_mins=None, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=100, periodic_checkpoint_folder=None,
        population_size=100, random_state=None, scoring=None,
        subsample=1.0, verbosity=2, warm_start=False)
ऊपर 5 generations की गणना की गई, प्रत्येक ने training सेट पर फिटिंग मॉडल की प्रशिक्षण क्षमता दी। स्पष्ट है कि सर्वश्रेष्ठ पाइपलाइन वह है जिसकी CV accuracy स्कोर 88.16% है। इस परिणाम को उत्पन्न करने वाला मॉडल एक पाइपलाइन है, जिसमें प्री-प्रोसेसिंग तकनीकें जैसे PloynomialFeatures और फिर RobustScaler शामिल हैं, जो इनपुट डेटा में कृत्रिम फीचर्स जोड़ते हैं और उन्हें सामान्यीकृत करते हैं, जिन्हें फिर अंतिम भविष्यवाणियाँ बनाने के लिए Gradient Boosting क्लासिफायर द्वारा उपयोग किया जाता है। आप यह भी देख सकते हैं कि tpot क्लासिफायर के साथ learning_rate, max_depth आदि जैसे विभिन्न हाइपरपैरामीटर मान भी देता है।
अगले चरण में वैलिडेशन के लिए टेस्ट त्रुटि की गणना की जाती है।
tpot.score(tele.drop('class',axis=1).loc[validation_indices].values,
           tele.loc[validation_indices, 'class'].values)
0.885173501577287
जैसा कि देखा जा सकता है, टेस्ट accuracy 88.51% है।
अंत में, आप TPOT को export फ़ंक्शन के जरिए ऑप्टिमाइज़्ड पाइपलाइन के संबंधित Python कोड को एक टेक्स्ट फ़ाइल में निर्यात करने के लिए कह सकते हैं:
tpot.export('tpot_MAGIC_Gamma_Telescope_pipeline.py')
True
## This is the pipeline that tpot generated: tpot_MAGIC_Gamma_Telescope_pipeline.py
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, RobustScaler

# NOTE: Make sure that the class is labeled 'target' in the data file
tpot_data = pd.read_csv('PATH/TO/DATA/FILE', sep='COLUMN_SEPARATOR', dtype=np.float64)
features = tpot_data.drop('target', axis=1).values
training_features, testing_features, training_target, testing_target = \
            train_test_split(features, tpot_data['target'].values, random_state=42)

# Score on the training set was:0.881597992166
exported_pipeline = make_pipeline(
    PolynomialFeatures(degree=2, include_bias=False, interaction_only=False),
    RobustScaler(),
    GradientBoostingClassifier(learning_rate=0.1, max_depth=6, max_features=0.6, min_samples_leaf=12, min_samples_split=3, n_estimators=100, subsample=0.55)
)

exported_pipeline.fit(training_features, training_target)
results = exported_pipeline.predict(testing_features)
क्या यह शानदार नहीं है? बिना बहुत से पैरामीटर्स और विकल्पों से छेड़छाड़ किए, TPOT ने न केवल आपको सर्वश्रेष्ठ मॉडल के बारे में जानकारी दी, बल्कि उसका एक काम करने वाला कोड भी दे दिया!
जैसा कि पहले बताया गया, अंतिम TPOT रन को समाप्त होने में कई घंटे लगे। दरअसल कुछ पैरामीटर्स हैं जिन्हें आप TPOT के निष्पादन समय को नियंत्रित करने के लिए निर्दिष्ट कर सकते हैं, पर एक समझौते के साथ। चूँकि आप TPOT के निष्पादन समय को सीमित करेंगे, TPOT सभी संभावित पाइपलाइनों का पता नहीं लगा पाएगा और इसलिए दिए गए समय-सीमा के अंत में TPOT द्वारा सुझाया गया सर्वश्रेष्ठ मॉडल उस डेटासेट के लिए संभवतः सबसे अच्छा मॉडल न भी हो। हालांकि, यदि पर्याप्त समय दिया जाए तो वह सबसे अच्छे संभावित मॉडल के काफ़ी क़रीब होगा। कुछ पैरामीटर्स हैं:
None नहीं है, तो यह सेटिंग generations पैरामीटर को ओवरराइड कर देगी और TPOT को तब तक चलने देगी जब तक max_time_mins मिनट पूरे न हो जाएँ।n_jobs=-1 सेट करने पर कंप्यूटर पर उपलब्ध अधिकतम कोर का उपयोग होगा। सावधान रहें कि एक ही मशीन पर कई विधियाँ उपयोग करने से बड़े डेटासेट्स के लिए मेमोरी समस्याएँ हो सकती हैं। डिफ़ॉल्ट 1 है।सिर्फ़ अभ्यास के लिए, आप फिर से TPOT चलाएँगे, इस बार अतिरिक्त आर्गुमेंट्स max_time_mins = 2 और max_eval_time_mins = 0.04 के साथ, तथा population_size = 15 घटाकर।
tpot = TPOTClassifier(verbosity=2, max_time_mins=2, max_eval_time_mins=0.04, population_size=15)
tpot.fit(tele.drop('class',axis=1).loc[training_indices].values, tele.loc[training_indices,'class'].values)
Optimization Progress: 42pipeline [00:42,  1.17s/pipeline]

Generation 1 - Current best internal CV score: 0.86119902629

Optimization Progress: 64pipeline [01:03,  1.04s/pipeline]

Generation 2 - Current best internal CV score: 0.86119902629

Optimization Progress: 83pipeline [01:21,  1.14s/pipeline]

Generation 3 - Current best internal CV score: 0.861689811492

Optimization Progress: 104pipeline [01:45,  1.03pipeline/s]

Generation 4 - Current best internal CV score: 0.861759642796

2.03228221667 minutes have elapsed. TPOT will close down.
TPOT closed prematurely. Will use the current best pipeline.

Best pipeline: XGBClassifier(RobustScaler(SelectPercentile(input_matrix, percentile=85)), learning_rate=0.1, max_depth=2, min_child_weight=4, n_estimators=100, nthread=1, subsample=0.1)

TPOTClassifier(config_dict={'sklearn.ensemble.GradientBoostingClassifier': {'max_features': array([0.05, 0.1 , 0.15, 0.2 , 0.25, 0.3 , 0.35, 0.4 , 0.45, 0.5 , 0.55,
       0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ]), 'learning_rate': [0.001, 0.01, 0.1, 0.5, 1.0], 'min_samples_leaf': [1, 2, 3, 4, 5, 6, 7...  0.6 , 0.65, 0.7 , 0.75, 0.8 , 0.85, 0.9 , 0.95, 1.  ])}, 'sklearn.preprocessing.RobustScaler': {}},
        crossover_rate=0.1, cv=5, disable_update_check=False,
        early_stop=None, generations=1000000, max_eval_time_mins=0.04,
        max_time_mins=2, memory=None, mutation_rate=0.9, n_jobs=1,
        offspring_size=15, periodic_checkpoint_folder=None,
        population_size=15, random_state=None, scoring=None, subsample=1.0,
        verbosity=2, warm_start=False)
जैसा कि आप देख सकते हैं, निर्दिष्ट समय-सीमा के भीतर सबसे अच्छा प्रदर्शन करने वाला क्लासिफायर अब XGBoost है, जिसमें प्री-प्रोसेसिंग स्टेप्स के रूप में SelectPercentile() और RobustScaler() शामिल हैं।
TPOT चलाना केवल डेटासेट पर एक मॉडल फिट करने जितना सरल नहीं है। यह कई मशीन लर्निंग एल्गोरिद्म (random forests, linear models, SVMs, आदि) को, कई प्रीप्रोसेसिंग स्टेप्स (मिसिंग वैल्यू इंप्यूटेशन, स्केलिंग, PCA, फीचर चयन, आदि) के साथ एक पाइपलाइन में, सभी मॉडलों और प्रीप्रोसेसिंग स्टेप्स के हाइपरपैरामीटर्स के साथ, तथा पाइपलाइन के भीतर एल्गोरिद्म को ensemble या stack करने के कई तरीकों के साथ विचार करता है। यही कारण है कि इसे आमतौर पर निष्पादित होने में लंबा समय लगता है और यह बड़े डेटासेट्स के लिए व्यावहारिक नहीं होता।
यदि आप किसी पर्याप्त जटिल डेटासेट पर काम कर रहे हैं या TPOT को कम समय के लिए चलाते हैं, तो अलग-अलग TPOT रन अलग-अलग पाइपलाइन अनुशंसाओं का परिणाम दे सकते हैं। जब दो TPOT रन अलग पाइपलाइनों की सिफारिश करते हैं, तो इसका मतलब है कि समय की कमी के कारण TPOT रन कन्वर्ज नहीं हुए, या यह कि कई पाइपलाइनों का आपके डेटासेट पर प्रदर्शन लगभग समान है।
वाह! आप इस ट्यूटोरियल के अंत तक पहुँच गए हैं। आपने Automated Machine Learning प्लेटफ़ॉर्म्स के पीछे के विचार का संक्षिप्त परिचय लेकर शुरुआत की। फिर आपने Genetic Programming और यह कि TPOT इसका उपयोग करके मशीन लर्निंग पाइपलाइन बनाने की प्रक्रिया को कैसे स्वचालित करता है, उस पर थोड़ा अन्वेषण किया। आपने Python में एक डेटासेट पर TPOT लाइब्रेरी का उपयोग करने का अभ्यास भी किया और इसके द्वारा प्रदान किए गए फ़ंक्शंस के बारे में जानकारी हासिल की। यदि आप भविष्य में TPOT का उपयोग करने की योजना बना रहे हैं, तो मैं दृढ़ता से इसकी उत्कृष्ट डॉक्यूमेंटेशन देखने का सुझाव देता हूँ। शुभ अन्वेषण!
यदि आप Python में Machine Learning के बारे में और सीखना चाहते हैं, तो DataCamp का Machine Learning with Tree-Based Models in Python कोर्स करें। साथ ही, DataCamp का Introduction to Machine Learning in Python ट्यूटोरियल भी देखें।
इस ट्यूटोरियल को लिखने में निम्नलिखित वेब पेज स्रोत के रूप में उपयोग किए गए:
Python और Machine Learning के बारे में और जानें
कोर्स
कोर्स
कोर्स