Kursus
Pengantar Visualisasi Data dengan ggplot2
4 jam
189.7K
Data hilang menjadi masalah dalam pekerjaan sehari-hari setiap data scientist. Haruskah kita melakukan imputasi? Jika ya, metode mana yang tepat? Atau apakah observasi dengan titik data yang hilang bisa langsung dibuang? Untuk menjawab pertanyaan-pertanyaan ini, kita perlu mengetahui mekanisme di balik data hilang tersebut. Mendeteksinya dengan uji statistik itu kompleks dan terkadang hanya menghasilkan pernyataan yang samar. Sebaliknya, alat visualisasi mudah digunakan dan tidak hanya membantu mendeteksi mekanisme data hilang, tetapi juga memberi wawasan tentang aspek lain dari kualitas data. Dalam tutorial ini, serangkaian metode plotting yang tersedia di paket VIM disajikan untuk menunjukkan bagaimana metode tersebut dapat membantu Anda memahami dengan baik pola cara data menjadi hilang.
Ada banyak alasan mengapa sebuah dataset tidak lengkap. Penting untuk menyelidiki apa kemungkinan penyebab data hilang, karena hal ini dapat memengaruhi cara kita menangani masalah tersebut. Misalnya, jika non-respons dalam survei terkait pekerjaan menjadi perhatian, bisa jadi responden yang sangat kaya dan sangat miskin tidak mengungkapkan penghasilan mereka dalam kuesioner, yang berarti titik data yang hilang tidak tersebar merata di seluruh dataset. Jika demikian, sekadar menghapus observasi yang tidak lengkap sebelum melakukan analisis yang diinginkan akan menghasilkan bias. Di sisi lain, misalnya, jika data hilang karena kegagalan perangkat pengumpul data, bisa jadi lokasi titik yang hilang dalam dataset benar-benar acak.
Ada tiga pola berbeda menurut mana data dapat hilang. Biasanya disebut sebagai mekanisme data hilang.
Missing completely at random (MCAR)
Di bawah MCAR tidak ada pola sistematis pada lokasi titik data yang hilang dalam dataset: kemunculannya sepenuhnya acak. Secara formal, ini berarti probabilitas suatu observasi tidak ada tidak bergantung pada nilai variabel lain maupun nilainya sendiri. Dalam kasus ini, menghapus observasi tidak lengkap tidak akan menimbulkan bias pada hasil analisis berikutnya.
Contoh: Suhu diukur terus-menerus oleh sensor yang mengumpulkan data dan mengirimkannya melalui Internet ke sebuah basis data. Karena alasan yang tidak diketahui, koneksi Internet terkadang terputus.
Missing at random (MAR)
Di bawah MAR, probabilitas suatu observasi tertentu hilang masih independen terhadap nilainya sendiri, tetapi bergantung pada nilai variabel lain. Dalam hal ini, menghapus observasi yang tidak lengkap membuat sampel menjadi kurang representatif.
Contoh: Beberapa data pada jam malam hilang karena pekerjaan pemeliharaan sensor, yang selalu dilakukan pada malam hari.
Missing not at random (MNAR)
Di bawah MNAR, probabilitas suatu observasi hilang bergantung pada nilai tak teramatinya sendiri. Dalam kasus ini, lagi-lagi, menghapus data yang tidak lengkap akan menghasilkan analisis yang bias.
Contoh: Sensor membeku pada -20 derajat Celsius dan tidak mengukur suhu di bawah nilai ini.
Dalam praktiknya, sulit untuk memastikan mekanisme data hilang mana dari ketiganya yang berlaku pada kasus tertentu. Untuk melihat ini, mari kita plot beberapa data MNAR. Kita akan menggunakan paket ggplot2 dan gridExtra yang perlu kita muat terlebih dahulu. Kita juga akan memuat dua paket lain untuk digunakan nanti: VIM untuk analisis visual data hilang dan dplyr untuk beberapa pra-pemrosesan data. Ingat untuk install.packages() terlebih dahulu jika paket-paket tersebut belum ada di workspace Anda.
library("VIM")
library("dplyr")
library("ggplot2")
library("gridExtra")
Mari kita buat sebuah dataset dengan dua variabel yang tidak berkorelasi dan berdistribusi normal, x dan y, dengan beberapa nilai hilang pada y di ekor kanan distribusinya, yaitu di antara nilai-nilai tertingginya. Perhatikan bahwa kita juga menyimpan nilai sebenarnya, dan menyetelnya menjadi hilang pada variabel terpisah.
set.seed(2)
mnar_data <- data.frame(x = rnorm(100), y = rnorm(100)) %>%
    mutate(y_miss = ifelse(y > 1, y, NA),
           y = ifelse(is.na(y_miss), y, NA),
           x_miss = ifelse(is.na(y), x, NA))
Kita sekarang akan menggambar dua scatter plot x terhadap y: satu termasuk titik yang nilai y-nya kita anggap hilang dan satu lagi hanya dengan data yang teramati.
grid.arrange(
  # Plot yang menyoroti titik data hilang
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_point(aes(x, y_miss), col = "red", size = 4, alpha = 0.6) +
    geom_hline(aes(yintercept = y_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("Where the data points are missing"),
  # Apa yang bisa dilihat data scientist
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_vline(aes(xintercept = x_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("What the data scientist can see"),
  # Tata dua plot berdampingan
  ncol = 2
)
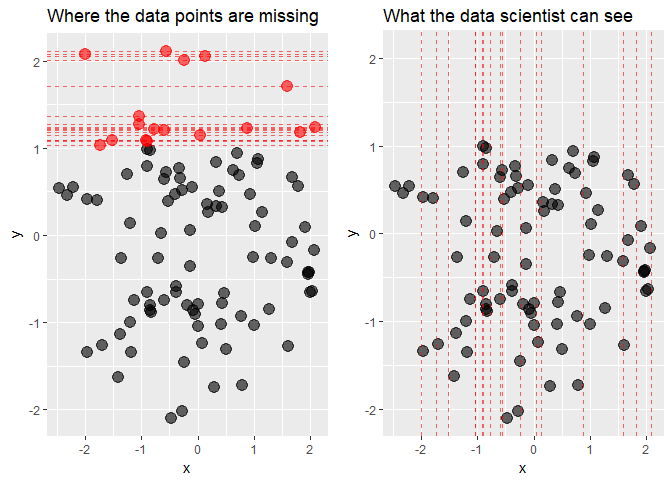
Dari plot pertama jelas bahwa datanya benar-benar MNAR, namun yang bisa dilihat data scientist hanyalah koordinat x dari titik yang hilang. Kesimpulan apa yang bisa diambil dari plot kedua? Apakah data MCAR? Mungkin ya, lokasi nilai hilang tampak tersebar cukup merata di sepanjang sumbu x. Atau apakah MAR? Jika diperiksa lebih saksama, tampaknya ada lebih banyak nilai hilang pada y untuk nilai x yang negatif dibanding yang positif, jadi ini juga mungkin. Terakhir, MNAR tidak pernah bisa diabaikan, karena untuk mengetahui apakah data MNAR atau tidak, secara definisi kita perlu mengamati nilai yang tak teramati.
Untungnya, kita tidak perlu benar-benar buntu. Alat visualisasi data dapat memberi panduan tentang pola apa yang ada pada data hilang. Sekarang kita akan menganalisis sejumlah plot yang berguna untuk mendeteksi pola-pola tersebut berdasarkan dataset biopics dari paket fivethirtyeight, yang berisi beberapa informasi tentang film biografi.
Sebelum beralih ke bagian plotting, data memerlukan pra-pemrosesan. Potongan kode di bawah ini akan melakukan tugas tersebut. Pemanggilan select di awal pipeline dplyr mengekstrak variabel yang relevan dan mutate berikutnya mengelompokkan ras yang terkait agar tiap grup memiliki cukup observasi. Lalu, kelas beberapa variabel disesuaikan: kita memerlukan factor untuk variabel string dan integer untuk variabel logikal. Terakhir, variabel-variabel diganti nama menjadi lebih singkat demi keterbacaan plot.
data(biopics, package = "fivethirtyeight")

biopics <- biopics %>%
  select(country, year_release, box_office, number_of_subjects,
         type_of_subject, subject_race, person_of_color, subject_sex) %>%
  mutate(subject_race = ifelse(grepl("^Hispanic", subject_race), "Hispanic",
                               subject_race),
         subject_race = ifelse(grepl("^African", subject_race), "African",
                               subject_race),
         subject_race = ifelse(grepl("^Middle", subject_race), "Mid Eastern",
                               subject_race),
         subject_race = ifelse(subject_race %in% c("White", "Asian", "African",
                                                   "Hispanic", "Mid Eastern",
                                                   "Multi racial", NA),
                               subject_race, "other")) %>%
  mutate(country = as.factor(country),
         type_of_subject = as.factor(type_of_subject),
         subject_race = as.factor(subject_race),
         subject_sex = as.factor(subject_sex),
         person_of_color = as.integer(person_of_color)) %>%
      as.data.frame()

colnames(biopics) <- c("country", "year", "earnings", "sub_num",
                       "sub_type", "sub_race", "non_white", "sub_sex")
Kita mendapatkan dataset yang terdiri dari delapan variabel:
country - negara asal film,year - tahun rilis,earnings - pendapatan kotor di box office AS,sub_num - jumlah subjek yang ditampilkan dalam film,sub_type - pekerjaan subjek atau alasan pengakuan,sub_race - ras subjek,non_white - variabel dummy yang menunjukkan person of color,sub_sex - jenis kelamin subjek.Pertanyaan mendasar pertama yang perlu diajukan: pada variabel mana terdapat observasi yang hilang, dan berapa banyak? Aggregation plot adalah alat yang berguna untuk menjawab pertanyaan ini. Satu baris kode di bawah sudah cukup.
aggr(biopics, numbers = TRUE, prop = c(TRUE, FALSE))
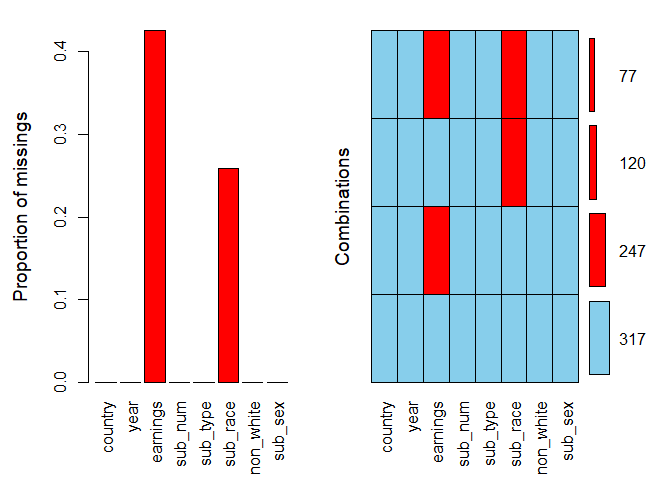
Kita menentukan argumen numbers = TRUE untuk menampilkan angka di atas batang. Argumen prop adalah logikal yang menunjukkan apakah proporsi nilai hilang dan kombinasinya harus digunakan alih-alih jumlah total. Kita setel ke TRUE untuk plot pertama dan FALSE untuk yang kedua.
Jelas bahwa nilai hilang hanya muncul pada dua variabel: nilainya lebih dari 40% pada earnings dan sekitar 25% pada sub_race. Pada plot kombinasi di sisi kanan, kisi menyajikan semua kombinasi nilai hilang (merah) dan teramati (biru) yang ada dalam data. Ada 317 observasi lengkap, dan pada 77 baris kedua variabel tersebut hilang.
Melihat dua plot sekaligus mungkin agak membingungkan, jadi mari kita satukan informasi yang sama ke dalam satu visualisasi dengan baris kode berikut.
aggr(biopics, combined = TRUE, numbers = TRUE)
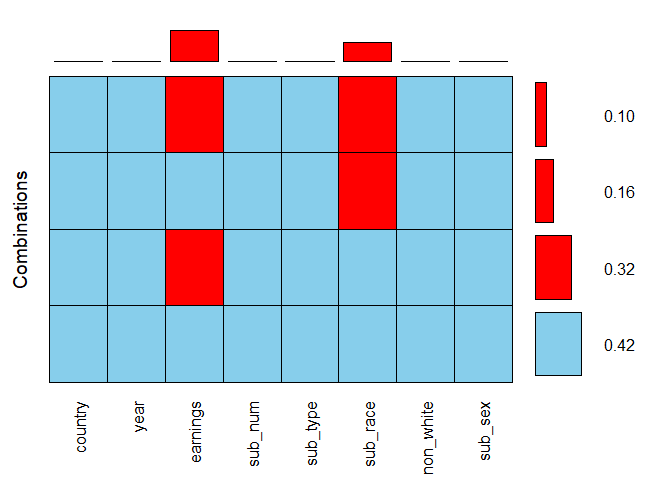
Argumen combined memungkinkan penggabungan dua plot menjadi satu. Di sini, batang horizontal di sebelah kanan kisi menunjukkan frekuensi kombinasi yang sesuai, sementara batang vertikal di atasnya menyajikan proporsi nilai hilang di setiap variabel. Dengan menjumlahkan nilai semua kombinasi yang mungkin untuk earnings, yaitu 0,32 dan 0,10, kita melihat bahwa proporsi keseluruhan nilai hilang pada variabel ini, yang sebelumnya kita perkirakan lebih dari 40% berdasarkan bar plot, ternyata 42%.
Sejauh ini kita telah memperoleh gambaran tingkat tinggi tentang data hilang. Saatnya melihat lebih dekat interaksi antar variabel tertentu. Spinogram dan spineplot memungkinkan kita mengkaji persentase nilai hilang pada satu variabel untuk berbagai nilai variabel lain. Jika variabel pemilah berupa numerik, maka disebut spinogram; ketika berupa kategorikal, visualisasi ini disebut spineplot.
Keduanya dapat dibuat dengan fungsi spineMiss(), yang menerima data frame dua kolom sebagai masukan. Variabel pertama yang ditentukan adalah variabel menurut mana data dipecah. Variabel ini dipetakan ke sumbu horizontal plot. Variabel kedua adalah variabel yang pola data hilangnya kita minati. Untuk melihatnya dalam praktik, mari buat spineplot. Kita tentukan variabel kategorikal sub_race terlebih dahulu, diikuti earnings, yang dapat dibaca: berapa persentase nilai hilang pada earnings untuk setiap kategori sub_race?
spineMiss(biopics[, c("sub_race", "earnings")])
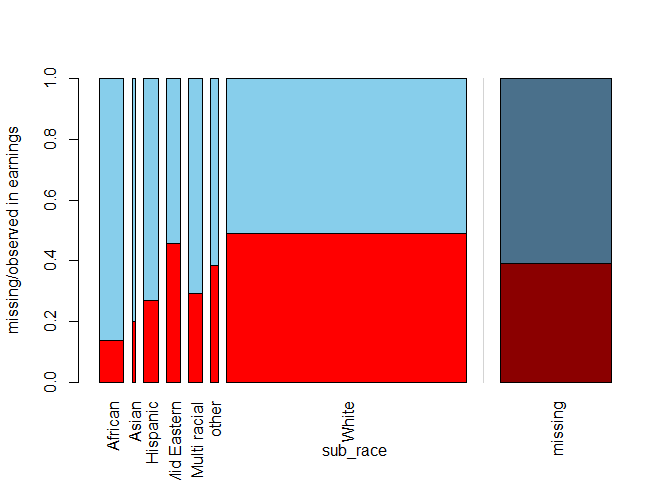
Lebar relatif batang untuk kategori tertentu pada sub_race mencerminkan frekuensi kategori tersebut dalam dataset: misalnya, pada sebagian besar film subjek utamanya berkulit putih. Di dalam setiap batang, ditunjukkan proporsi nilai hilang pada earnings, sementara batang berbayang di sisi kanan menunjukkan proporsi ini untuk keseluruhan dataset. Tampaknya ketika subjek utama adalah African, kita paling mungkin memiliki informasi pendapatan yang lengkap.
Dengan membalik urutan variabel seperti pada baris kode di bawah, kita dapat menghasilkan spinogram untuk menjawab pertanyaan yang dibalik: berapa persentase data hilang pada sub_race untuk berbagai nilai earnings?
spineMiss(biopics[, c("earnings", "sub_race")])
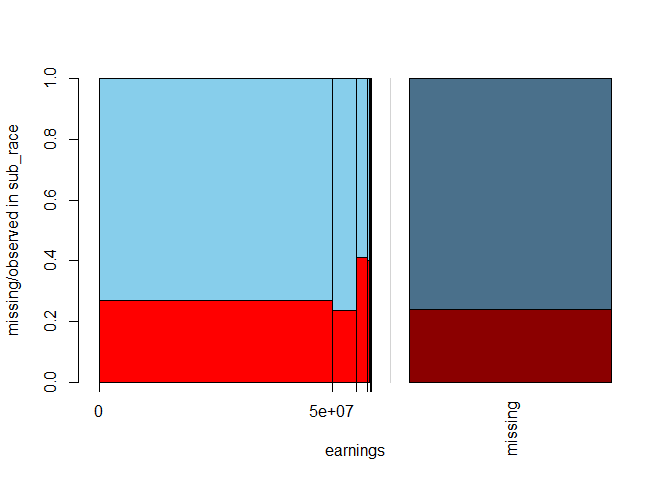
Karena earnings adalah variabel numerik, nilainya dibagi ke dalam bin, di mana lebar bin sesuai dengan distribusi variabel itu sendiri. Spinogram menunjukkan bahwa earnings sangat miring negatif: hanya beberapa film yang meraih keuntungan tertinggi. Menariknya, untuk film-film blockbuster tersebut, kita paling mungkin kehilangan informasi ras subjek, sebagaimana tercermin oleh batang merah tertinggi pada nilai earnings yang paling besar.
Spinogram dan spineplot di atas memungkinkan kita mengkaji interaksi antara dua variabel. Gagasan ini digeneralisasi ke lebih banyak variabel dalam bentuk mosaic plot. Plot ini merupakan kumpulan ubin, di mana setiap ubin sesuai dengan kombinasi spesifik kategori (untuk variabel kategorikal) atau bin (untuk variabel numerik) dari dua variabel atau lebih. Di dalam setiap ubin, ditampilkan persentase titik data yang hilang pada variabel lain. Secara prinsip, mosaic plot dapat dibuat untuk jumlah variabel berapa pun, tetapi dapat menjadi penuh sesak jika terlalu banyak. Selain itu, plot ini lebih mudah dibaca jika variabel pemilah berupa faktor dan tidak memiliki terlalu banyak level.
Mari kita lihat proporsi nilai hilang pada earnings yang dipecah menurut sub_sex dan US_movie. Variabel terakhir, yang dibuat pada potongan kode di bawah, adalah logikal yang menyatakan apakah Amerika Serikat terlibat dalam produksi film. Kita berikan data frame tiga variabel sebagai argumen pertama ke mosaicMiss(). Argumen plotvars diatur ke vektor dengan elemen 1 dan 2 yang berarti kita ingin membagi data menurut dua kolom pertama dari data frame ini. Menetapkan highlight ke 3 berarti kita ingin proporsi nilai hilang dari variabel di kolom ketiga ditampilkan di dalam ubin.
biopics <- biopics %>%
    mutate(US_movie = ifelse(grepl("US", country), TRUE, FALSE))
mosaicMiss(biopics[, c("sub_sex", "US_movie", "earnings")], highlight = 3,
           plotvars = 1:2, miss.labels = FALSE)
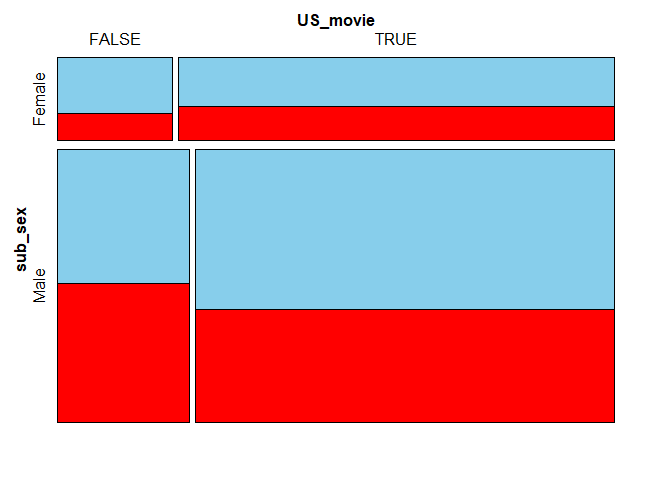
Sekali lagi, ukuran ubin sesuai dengan frekuensi kemunculan kombinasi tertentu dalam dataset. Misalnya, ubin kanan bawah yang terbesar berarti sebagian besar film menampilkan subjek laki-laki dan diproduksi, setidaknya sebagian, di AS.
Untuk film yang menampilkan subjek utama laki-laki, informasi pendapatan lebih mungkin hilang untuk film non-Amerika. Di sisi lain, jika tokoh utamanya perempuan, film AS memiliki sedikit lebih banyak nilai hilang pada pendapatan. Namun, perbedaan ini tampaknya terlalu kecil untuk dianggap signifikan.
Jenis visualisasi lain adalah parallel boxplot. Gagasannya adalah membagi dataset menjadi dua subset: satu hanya dengan nilai teramati dari variabel tidak lengkap dan yang lain hanya dengan nilai hilangnya. Untuk kedua subset tersebut, dibuat boxplot dari variabel numerik yang dipilih. Ini memungkinkan Anda memeriksa apakah distribusi variabel yang dipilih dipengaruhi oleh nilai hilang pada variabel pemilah.
Untuk membuat parallel boxplot, kita dapat menggunakan fungsi pbox(). Kita hanya melewatkan satu argumen: data frame dua kolom. Boxplot akan digambar untuk variabel pada kolom pertama, sementara yang pada kolom kedua digunakan untuk pemisahan. Pada contoh di bawah, kita mengambil logaritma dari earnings karena sangat miring dan tanpa transformasi ini, boxplot akan tampak seperti satu garis.
biopics <- biopics %>%
  mutate(log_earnings = log(earnings))
pbox(biopics[, c("log_earnings", "sub_race")])
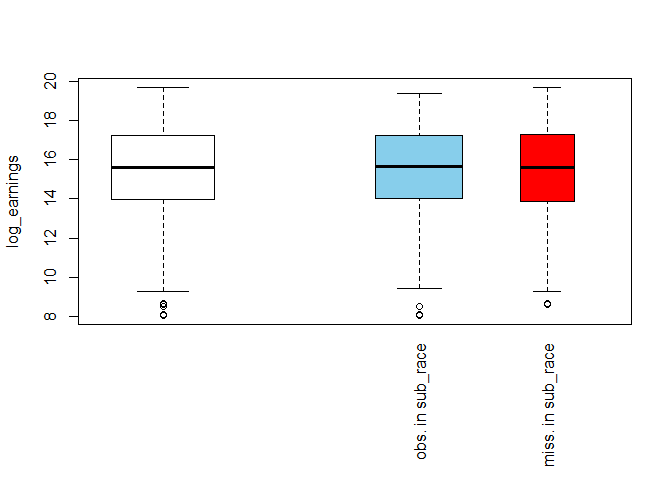
Kotak putih di sisi kiri menunjukkan distribusi keseluruhan log_earnings, sedangkan kotak biru dan merah menunjukkan distribusinya untuk subset nilai teramati dan nilai hilang pada sub_race, masing-masing. Lebar relatif kotak mencerminkan ukuran subset yang menjadi dasarnya: kotak biru yang lebih lebar berarti terdapat lebih banyak nilai teramati daripada nilai hilang pada sub_race. Selain itu, kedua kotak terlihat mirip satu sama lain dan juga kotak putih keseluruhan. Ini menunjukkan bahwa informasi ras yang hilang tidak berdampak pada distribusi pendapatan.
Kita telah melihat variabel tunggal dan interaksinya. Sekarang mari beralih menganalisis semua variabel dalam dataset sekaligus. Visualisasi yang memungkinkan hal ini adalah parallel coordinate plot. Dalam plot ini, setiap variabel ditransformasikan ke skala yang sama dan direpresentasikan oleh sumbu paralel. Untuk variabel kategorikal, skala sumbu koordinat dipecah menjadi sekumpulan titik yang berjarak sama, satu untuk setiap kategori. Nilai hilang ditempatkan di atas sumbu vertikal, di luar area plot. Setiap garis pada plot sesuai dengan satu observasi dalam data, dengan warna garis menunjukkan nilai hilang pada variabel yang dipilih.
Kita dapat membuat parallel coordinate plot dengan fungsi parcoordMiss(). Secara default, fungsi ini menggunakan semua variabel yang ada dalam data frame yang diberikan sebagai argumen pertama. Menetapkan highlight ke earnings menandai garis yang merepresentasikan observasi dengan nilai hilang pada earnings dengan warna berbeda. Menetapkan alpha-blending ke 0,6 membuat garis sedikit transparan, meningkatkan keterbacaan plot.
# Hapus variabel yang dibuat untuk plot sebelumnya
biopics <- biopics %>%
  select(- US_movie, - log_earnings)

parcoordMiss(biopics, highlight = 'earnings', alpha = 0.6)
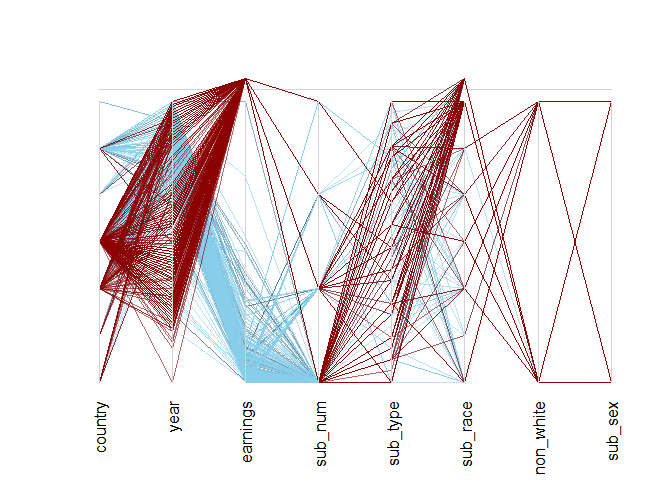
Pada plot di atas, garis merah tua menandakan observasi dengan nilai hilang pada earnings. Observasi yang disorot ini tampak berperilaku berbeda dari data lainnya. Khususnya, hanya sedikit dari mereka yang sesuai dengan level kedua tertinggi dari country, yang sebaliknya mencakup banyak observasi! Ternyata itu adalah film AS/UK (untuk melihatnya, jalankan saja levels(biopics$country) dan cari nilai kedua dari belakang!).
Selain itu, inspeksi cepat pada sumbu year menunjukkan bagian sekitar dua pertiga tinggi sumbu dengan lebih sedikit garis merah tua yang melintas. Tampaknya ada masa belum lama ini ketika data pendapatan lebih lengkap. Ini menunjukkan bahwa baik country maupun year mungkin membantu menjelaskan sebaran nilai hilang pada earnings!
Alat visualisasi terakhir yang akan kita tinjau adalah matrix plot. Plot ini memvisualisasikan semua sel matriks data dengan persegi panjang. Data yang teramati ditampilkan dalam skema warna abu-abu-hitam kontinu (semakin gelap warnanya, semakin tinggi nilainya), sedangkan nilai hilang disorot dalam merah. Praktik yang baik adalah mengurutkan data berdasarkan salah satu variabel yang tidak lengkap — ini membuat plot lebih mudah ditafsirkan. Potongan kode di bawah melakukan hal tersebut, mengurutkan berdasarkan earnings.
matrixplot(biopics, sortby = c('earnings'))
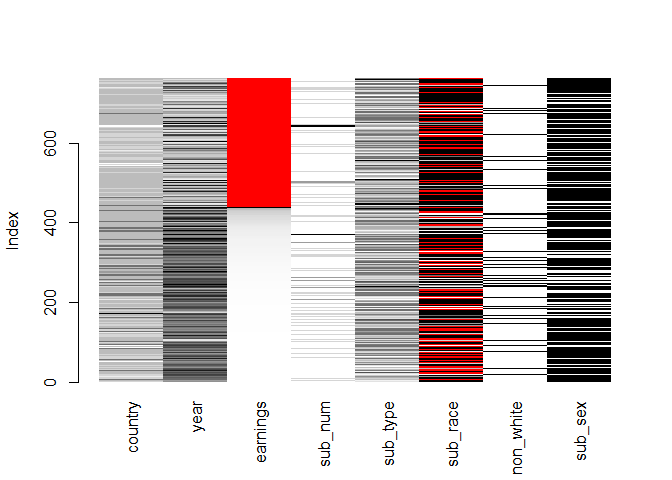
Plot ini memvalidasi beberapa temuan sebelumnya: observasi dengan nilai hilang pada earnings cenderung berasal dari waktu yang lama (nilai year rendah) dan juga bernilai rendah pada country — ini ditandai oleh warna yang lebih terang pada dua variabel tersebut pada baris-baris ketika earnings berwarna merah. Selain itu, tampaknya ada lebih sedikit film dengan subjek non-white ketika earnings hilang.
Singkatnya, tampaknya data hilang dalam dataset biopics bukan MCAR. Lokasi titik data yang hilang pada earnings dan sub_race saling membantu menjelaskan, sebagaimana dibuktikan oleh spineplot dan spinogram. Selain itu, matrix plot dan parallel coordinate plot menunjukkan bahwa country, year, dan non_white juga mungkin membantu menjelaskan sebaran nilai hilang pada earnings. Oleh karena itu, bukan ide yang baik untuk membuang observasi tidak lengkap, karena hal ini kemungkinan besar akan memperkenalkan bias pada inferensi kita.
Pemikiran Akhir
Perjalanan Anda sudah jauh! Kini Anda tahu apa itu mekanisme data hilang dan bagaimana perbedaannya, dan yang lebih penting, bagaimana menyimpulkan tentangnya dengan berbagai alat visualisasi. Kerja bagus! Anda sekarang siap menganalisis dataset Anda sendiri yang tidak lengkap!
Jika Anda tertarik untuk mempelajari R lebih lanjut, ikuti kursus Data Visualization with ggplot2 (Bagian 1) dari DataCamp dan lihat R Formula Tutorial kami.
Pelajari lebih lanjut tentang R dan Visualisasi Data
Kursus
Kursus
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



