Kurs
ggplot2 ile Veri Görselleştirmeye Giriş
4 sa
189.9K
Eksik veriler, her veri bilimcisinin günlük işinde bir sorun teşkil eder. Onları atamalı mıyız? Atanacaksa, hangi yöntem uygundur? Yoksa eksik veri noktaları olan gözlemler basitçe atılabilir mi? Bu soruları yanıtlamak için, eksik verilerin arkasındaki mekanizmanın ne olduğunu bilmek gerekir. İstatistiksel testlerle bunu tespit etmek karmaşıktır ve bazen yalnızca muğlak ifadelere yol açar. Buna karşılık, görselleştirme araçları kullanımı kolaydır ve yalnızca eksik veri mekanizmalarını tespit etmeye yardımcı olmakla kalmaz, aynı zamanda veri kalitesinin diğer yönlerine dair içgörüler de sağlar. Bu eğitimde, VIM paketinde sunulan bir dizi çizim yöntemi tanıtılarak verilerin ne şekilde eksik olduğuna ilişkin örüntüler hakkında sağlam bir kavrayış elde etmeye nasıl yardımcı olabilecekleri gösterilmektedir.
Bir veri kümesinin eksik olmasının birden fazla nedeni olabilir. Eksik verilerin olası nedenlerini araştırmak kritik önemdedir; çünkü bu, sorunu ele alış biçimimizi etkileyebilir. Örneğin, iş ile ilgili anketlerde yanıt vermeme söz konusuysa, en zengin ve en yoksul katılımcıların anket formunda gelirlerini açıklamaması beklenebilir; bu da eksik veri noktalarının veri kümesine eşit dağılmadığı anlamına gelir. Bu durumda, ilgi duyulan analizi yapmadan önce eksik gözlemleri basitçe kaldırmak önyargılı sonuçlara yol açar. Öte yandan, örneğin verilerin toplanmasını sağlayan cihazın arızası nedeniyle veriler eksikse, veri kümesindeki eksik noktaların konumları tamamen rastlantısal olabilir.
Verilerin eksik olabileceği üç farklı örüntü vardır. Bunlara genellikle eksik veri mekanizmaları denir.
Eksiksizlik tamamen rastgele (MCAR)
MCAR altında, veri kümesinde eksik veri noktalarının konumunda sistematik bir örüntü yoktur: tamamen rastgele ortaya çıkarlar. Biçimsel olarak bu, bir gözlemin eksik olma olasılığının ne diğer değişkenlerin değerlerine ne de kendi değerlerine bağlı olmadığı anlamına gelir. Bu durumda, eksik gözlemleri çıkarmak sonraki analizin sonuçlarına önyargı katmaz.
Örnek: Sıcaklık, verileri toplayıp internet üzerinden bir veritabanına gönderen bir sensör tarafından sürekli ölçülmektedir. Bilinmeyen nedenlerle internet bağlantısı bazen kopar.
Rastgele eksik (MAR)
MAR altında, belirli bir gözlemin eksik olma olasılığı kendi değerlerinden bağımsızdır, ancak diğer değişkenlerin değerlerine bağlıdır. Bu durumda, eksik gözlemleri kaldırmak örneklemin temsil gücünü azaltır.
Örnek: Sensörün bakım çalışmaları her zaman gece yapıldığı için gece saatlerine ait bazı veriler eksiktir.
Rastgele olmayan eksik (MNAR)
MNAR altında, bir gözlemin eksik olma olasılığı kendi gözlemlenmemiş değerlerine bağlıdır. Bu durumda da eksik verileri çıkarmak önyargılı bir analize yol açar.
Örnek: Sensör -20 santigrat derecede donar ve bu değerin altındaki sıcaklığı ölçmez.
Uygulamada, üç eksik veri mekanizmasından hangisinin belirli bir durumda geçerli olduğunu söylemek zordur. Bunu görmek için biraz MNAR veri çizelim. Daha önce yüklememiz gereken ggplot2 ve gridExtra paketlerini kullanacağız. Ayrıca, eksik verilerin görsel analizi için VIM ve bazı veri ön işleme adımları için dplyr paketlerini de daha sonra kullanmak üzere yükleyeceğiz. Çalışma alanınızda hâlâ yoklarsa önce install.packages() ile kurmayı unutmayın.
library("VIM")
library("dplyr")
library("ggplot2")
library("gridExtra")
Dağılımı normal olan ve birbiriyle ilişkisiz iki değişken, x ve y, içeren bir veri kümesi oluşturalım; y değişkeninin dağılımının sağ kuyruğunda, yani en yüksek değerleri arasında bazı eksikler olsun. Dikkat edin: gerçek değerleri de saklıyor, bunları ayrı bir değişkende eksik olarak işaretliyoruz.
set.seed(2)
mnar_data <- data.frame(x = rnorm(100), y = rnorm(100)) %>%
    mutate(y_miss = ifelse(y > 1, y, NA),
           y = ifelse(is.na(y_miss), y, NA),
           x_miss = ifelse(is.na(y), x, NA))
Şimdi x'e karşı y'nin iki saçılım grafiğini çizeceğiz: biri, y değerlerini eksikmiş gibi kabul ettiğimiz noktaları da içerecek; diğeri ise yalnızca gözlemlenen verileri gösterecek.
grid.arrange(
  # Eksik veri noktalarını vurgulayan grafik
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_point(aes(x, y_miss), col = "red", size = 4, alpha = 0.6) +
    geom_hline(aes(yintercept = y_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("Where the data points are missing"),
  # Veri bilimcisinin görebildiği
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_vline(aes(xintercept = x_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("What the data scientist can see"),
  # İki grafiği yan yana yerleştir
  ncol = 2
)
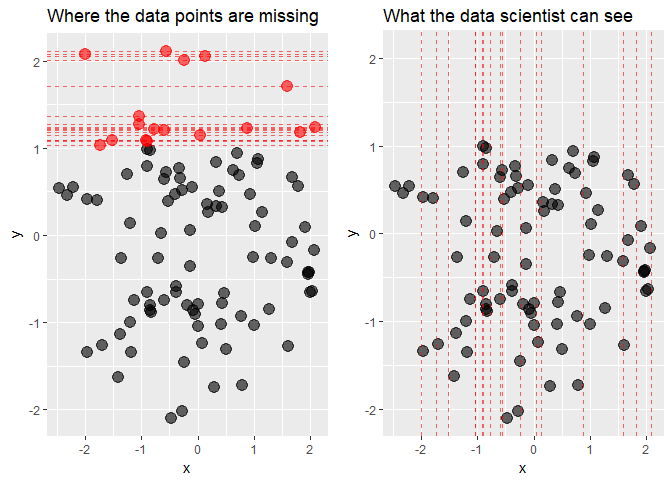
İlk grafikten verilerin gerçekten MNAR olduğu açıkken, veri bilimcisinin görebildiği yalnızca eksik noktaların x-koordinatlarıdır. İkinci grafikten ne sonuç çıkarılabilir? Veriler MCAR mı? Muhtemelen evet; eksik değerlerin konumları x ekseni boyunca oldukça eşit dağılmış görünüyor. Yoksa MAR mı? Daha yakından incelendiğinde, x'in negatif değerleri için y'de daha fazla eksik değer var gibi görünüyor; bu da olası. Son olarak, MNAR asla tamamen dışlanamaz, çünkü verilerin MNAR olup olmadığını bilmek için, tanımı gereği gözlemlenmemiş değerleri gözlemlememiz gerekir.
Neyse ki tamamen çaresiz kalmamız gerekmiyor. Veri görselleştirme araçları, eksik verilerde hangi örüntülerin olduğuna dair bize rehberlik sağlayabilir. Şimdi, biyografik filmler hakkında bazı bilgiler içeren fivethirtyeight paketindeki biopics veri kümesi üzerinden bu örüntüleri tespit etmekte yararlı bir dizi grafiği inceleyeceğiz.
Çizim kısmına geçmeden önce, verilerin biraz ön işlenmeye ihtiyacı var. Aşağıdaki kod bloğu işi görecektir. dplyr boru hattının başındaki select çağrısı ilgi duyulan değişkenleri çıkarır; ardından mutate ile ilgili ırklar bir araya getirilerek her grupta yeterli gözlem olması sağlanır. Daha sonra, bazı değişkenlerin sınıfı ayarlanır: metin değişkenleri için faktörlere, mantıksal olan için tamsayıya ihtiyaç duyarız. Son olarak, grafiklerin okunabilirliği için değişken adları kısaltılır.
data(biopics, package = "fivethirtyeight")

biopics <- biopics %>%
  select(country, year_release, box_office, number_of_subjects,
         type_of_subject, subject_race, person_of_color, subject_sex) %>%
  mutate(subject_race = ifelse(grepl("^Hispanic", subject_race), "Hispanic",
                               subject_race),
         subject_race = ifelse(grepl("^African", subject_race), "African",
                               subject_race),
         subject_race = ifelse(grepl("^Middle", subject_race), "Mid Eastern",
                               subject_race),
         subject_race = ifelse(subject_race %in% c("White", "Asian", "African",
                                                   "Hispanic", "Mid Eastern",
                                                   "Multi racial", NA),
                               subject_race, "other")) %>%
  mutate(country = as.factor(country),
         type_of_subject = as.factor(type_of_subject),
         subject_race = as.factor(subject_race),
         subject_sex = as.factor(subject_sex),
         person_of_color = as.integer(person_of_color)) %>%
      as.data.frame()

colnames(biopics) <- c("country", "year", "earnings", "sub_num",
                       "sub_type", "sub_race", "non_white", "sub_sex")
Sonuçta sekiz değişkenden oluşan bir veri kümesi elde ediyoruz:
country - filmin menşe ülkesi veya ülkeleri,year - gösterim yılı,earnings - ABD gişesindeki brüt hasılat,sub_num - filmde yer alan kişi sayısı,sub_type - konunun mesleği veya tanınma nedeni,sub_race - konunun ırkı,non_white - renkli bir kişiyi belirtmeye yarayan kukla değişken,sub_sex - konunun cinsiyeti.İlk ve temel soru şudur: Hangi değişkenlerde gözlemler eksik ve kaç tane? Toplulaştırma grafikleri bu soruları yanıtlamak için yararlı araçlardır. Aşağıdaki tek satırlık komut yeterlidir.
aggr(biopics, numbers = TRUE, prop = c(TRUE, FALSE))
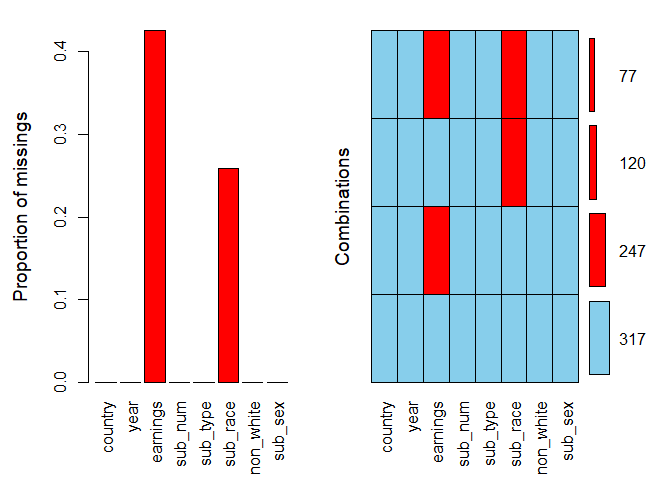
Çubukların üstünde sayıları göstermek için numbers = TRUE argümanını belirtiyoruz. prop argümanı, toplam sayı yerine eksik değerlerin ve kombinasyonların oranlarının kullanılıp kullanılmayacağını belirten mantıksal bir değerdir. İlk grafik için TRUE, ikinci için FALSE olarak ayarladık.
Eksik değerlerin yalnızca iki değişkende göründüğü açıktır: earnings değişkeninde %40'ın üzerinde ve sub_race değişkeninde yaklaşık %25 oranındadır. Sağ taraftaki kombinasyonlar grafiğinde, ızgara verilerde bulunan eksik (kırmızı) ve gözlemlenen (mavi) değerlerin tüm kombinasyonlarını sunar. 317 tam gözlem vardır ve 77 satırda her iki değişken de eksiktir.
Aynı anda iki grafiğe bakmak biraz kafa karıştırıcı gelebilir; o hâlde aşağıdaki kod satırıyla aynı bilgiyi tek bir görselleştirmeye dönüştürelim.
aggr(biopics, combined = TRUE, numbers = TRUE)
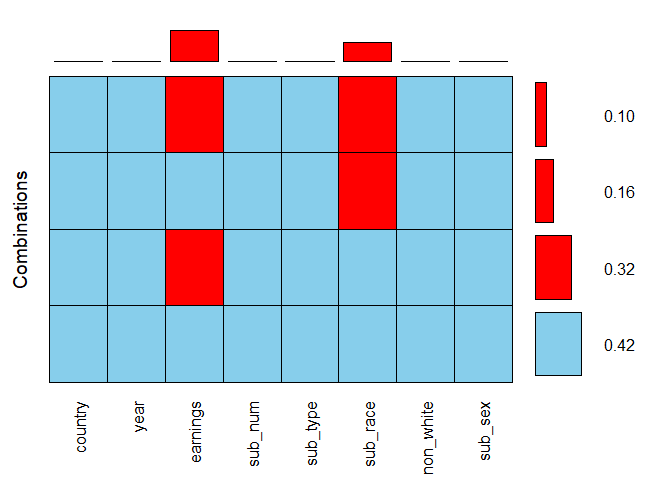
combined argümanı iki grafiğin birleştirilmesine olanak tanır. Burada, ızgaranın sağındaki yatay çubuklar ilgili kombinasyonların frekanslarını gösterirken, üstündeki dikey çubuklar her değişkendeki eksik değerlerin oranlarını sunar. earnings değişkeni için tüm olası kombinasyonların değerlerini, yani 0.32 ve 0.10'u toplayarak, önceki çubuk grafiğe dayanarak %40'ın üzerinde tahmin ettiğimiz bu değişkende eksik değerlerin toplam oranının aslında %42 olduğunu görürüz.
Şimdiye dek eksik verilere dair üst düzey bir genel görünüm edindik. Artık belirli değişkenler arasındaki etkileşimlere daha yakından bakma zamanı. Spinogram ve omurga grafiği (spineplot), bir değişkendeki eksik değerlerin yüzdesini diğerinin farklı değerleri için incelemeye imkân tanır. İkincisi sayısal bir değişkense spinogram; kategorikse omurga grafiği adını alır.
Her ikisi de girdi olarak iki sütunlu bir veri çerçevesi alan spineMiss() işleviyle üretilebilir. İlk belirtilen değişken, verilerin ona göre bölündüğü değişkendir ve grafiğin yatay eksenine eşlenir. İkinci değişken ise eksik veri örüntüsünü merak ettiğimiz değişkendir. Bunu pratikte görmek için bir omurga grafiği oluşturalım. Önce kategorik bir değişken olan sub_race'i, ardından earnings'i belirtiyoruz; yani şu şekilde okuyabilirsiniz: sub_race'in her kategorisi için earnings'deki eksik değerlerin yüzdesi nedir?
spineMiss(biopics[, c("sub_race", "earnings")])
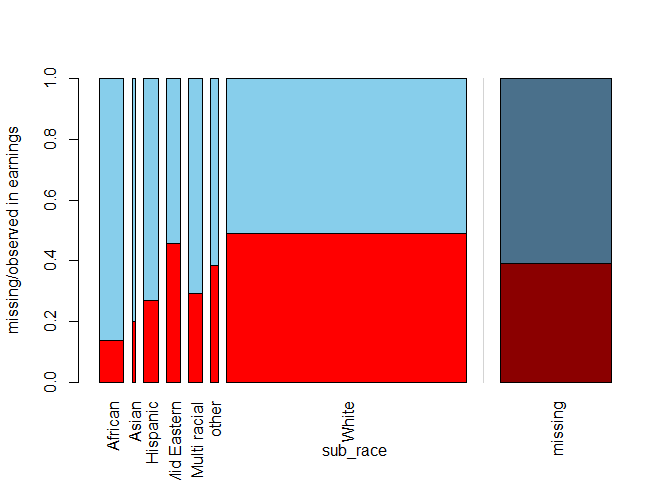
sub_race içindeki belirli kategoriler için çubukların göreli genişliği, bu kategorinin veri kümesindeki sıklığını yansıtır: örneğin, filmlerin büyük çoğunluğunda ana konu beyazdır. Her bir çubuk içinde earnings'in eksik oranı gösterilir; sağdaki gölgeli çubuk ise bu oranın tüm veri kümesi için olanını sunar. Ana konu Afrikalı olduğunda, hasılat bilgisine en çok bu durumda tam olarak sahip olduğumuz görülüyor.
Aşağıdaki kod satırında değişkenlerin sırasını değiştirerek şu tersine çevrilmiş soruyu yanıtlayan bir spinogram üretebiliriz: earnings'in farklı değerleri için sub_race'deki eksik verilerin yüzdesi nedir?
spineMiss(biopics[, c("earnings", "sub_race")])
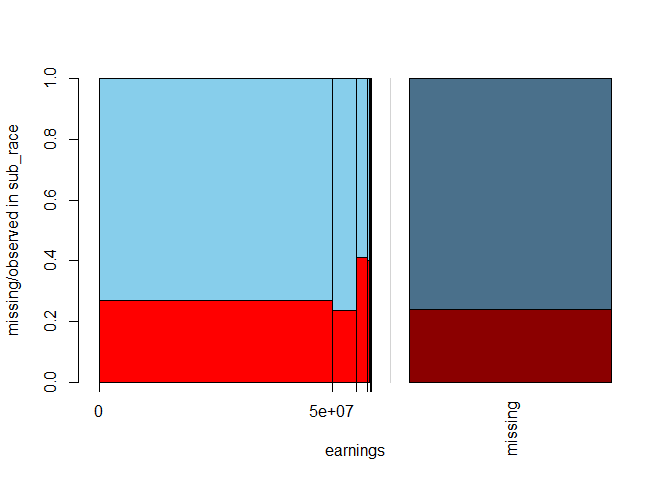
earnings sayısal bir değişken olduğundan, değerleri kutulara (bin) ayrılır; kutu genişlikleri değişkenin dağılımına karşılık gelir. Spinogram, earnings'in yüksek derecede negatif çarpık olduğunu gösterir: yalnızca birkaç film en yüksek kârı elde etmiştir. İlginç biçimde, bu gişe rekortmeni filmlerde konunun ırkı bilgisinin eksik olma olasılığı en yüksektir; bu durum earnings'in en yüksek değerleri için en yüksek kırmızı çubukla yansıtılmıştır.
Yukarıda tartışılan spinogram ve omurga grafiği iki değişken arasındaki etkileşimleri incelemeye olanak tanır. Bu fikir, bir mozaik grafik biçiminde daha çok değişkene genellenir. Bu grafik, her bir karo iki veya daha fazla değişkenin kategorilerinin (kategorik değişkenler için) veya kutularının (sayısal değişkenler için) belirli bir kombinasyonuna karşılık gelecek şekilde karolardan oluşur. Her karoda, başka bir değişkendeki eksik veri noktalarının yüzdesi gösterilir. İlke olarak mozaik grafikler herhangi bir sayıda değişken için oluşturulabilir; ancak çok fazla değişkene giderseniz kalabalıklaşabilirler. Ayrıca, bölen değişkenler faktör olduğunda ve çok fazla seviyeye sahip olmadıklarında daha okunaklıdırlar.
sub_sex ve US_movie ile bölünmüş earnings'deki eksik oranına bakalım. Aşağıdaki kod bloğunda oluşturulan ikincisi, Amerika Birleşik Devletleri'nin filmin yapımına dahil olup olmadığını belirten mantıksal bir değişkendir. Üç değişkenli veri çerçevesini mosaicMiss()'e ilk argüman olarak veriyoruz. plotvars argümanını 1 ve 2 öğelerinden oluşan bir vektör olarak ayarlamak, verileri bu veri çerçevesinin ilk iki sütununa göre bölmek istediğimiz anlamına gelir. highlight'ı 3 olarak ayarlamak ise üçüncü sütundaki değişkenin eksik oranının karoların içinde gösterilmesini istediğimiz anlamına gelir.
biopics <- biopics %>%
    mutate(US_movie = ifelse(grepl("US", country), TRUE, FALSE))
mosaicMiss(biopics[, c("sub_sex", "US_movie", "earnings")], highlight = 3,
           plotvars = 1:2, miss.labels = FALSE)
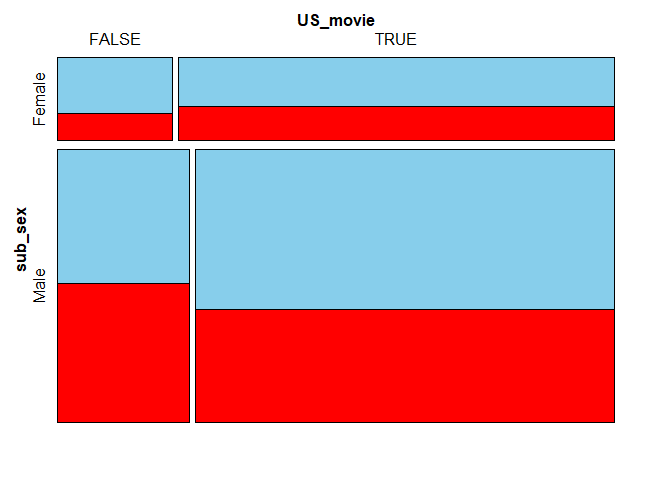
Yine, karoların boyutları veri kümesindeki belirli kombinasyonların gerçekleşme sıklıklarını yansıtır. Örneğin, en büyük sağ alt karo, filmlerin çoğunda ana konunun erkek olduğunu ve filmlerin en azından kısmen ABD'de üretildiğini gösterir.
Ana konusu erkek olan filmlerde, Amerikan yapımı olmayanlarda hasılat bilgisinin eksik olma olasılığı daha yüksektir. Öte yandan, ana karakter kadınsa, ABD filmlerinde hasılatta eksik değerler biraz daha fazladır. Ancak bu farklılıklar, anlamlı sayılacak kadar büyük görünmemektedir.
Bir diğer görselleştirme türü paralel kutu grafiğidir. Bunun ardındaki fikir, veri kümesini iki alt kümeye bölmektir: biri eksik bir değişkenin yalnızca gözlemlenen değerlerini, diğeri ise yalnızca eksik değerlerini içerir. Her iki alt küme için seçilen bir sayısal değişkenin kutu grafiği üretilir. Bu, seçilen değişkenin dağılımının, bölen değişkendeki eksik değerlerden etkilenip etkilenmediğini kontrol etmenizi sağlar.
Paralel kutu grafiği üretmek için pbox() işlevini kullanabiliriz. Yalnızca bir argüman geçiririz: iki sütunlu bir veri çerçevesi. Kutu grafikleri ilk sütundaki değişken için çizilirken, ikinci sütundaki değişken bölme için kullanılır. Aşağıdaki örnekte, earnings değişkeninin dağılımı yüksek derecede çarpık olduğundan logaritmasını alıyoruz; bu dönüşüm olmadan kutu grafiği tek bir çizgiyi andırırdı.
biopics <- biopics %>%
  mutate(log_earnings = log(earnings))
pbox(biopics[, c("log_earnings", "sub_race")])
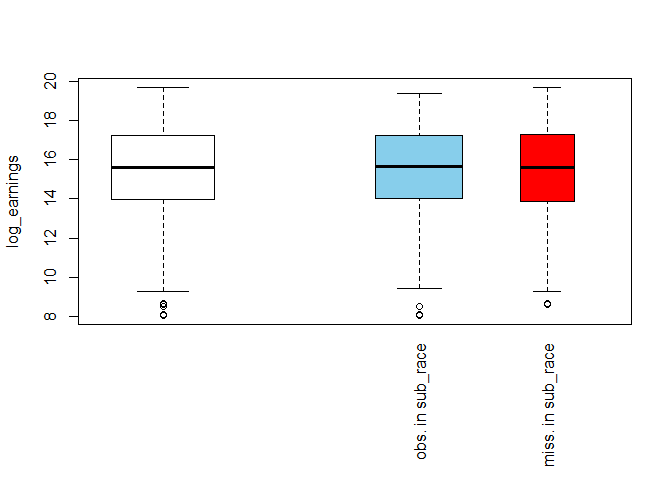
Soldaki beyaz kutu log_earnings'in genel dağılımını gösterirken, mavi ve kırmızı kutular sırasıyla sub_race'de gözlemlenen ve eksik değerlere sahip alt kümeler için dağılımı gösterir. Kutuların göreli genişliği, dayandıkları alt kümelerin boyutlarını yansıtır: daha geniş mavi kutu, sub_race'de eksik değerlere göre daha fazla gözlemlenen değer olduğunu gösterir. Bunun dışında iki kutu birbirine ve genel beyaz kutuya benzer görünmektedir. Bu, eksik ırk bilgisinin hasılat dağılımı üzerinde etkisi olmadığını düşündürür.
Tekil değişkenlere ve etkileşimlerine baktık. Şimdi veri kümesindeki tüm değişkenleri aynı anda analiz etmeye dönelim. Bunu sağlayan görselleştirme paralel koordinat grafiğidir. Bu grafikte, her değişken aynı ölçeğe dönüştürülerek paralel bir eksenle temsil edilir. Kategorik değişkenler söz konusu olduğunda, koordinat ekseninin ölçeği, her kategori için birer tane olmak üzere eşit aralıklı noktalar kümesine bölünür. Eksik değerler dikey eksenlerin üzerine, grafik alanının dışına yerleştirilir. Grafikteki her çizgi verilerdeki bir gözleme karşılık gelir; çizginin rengi seçilen değişkendeki eksik veriyi belirtir.
parcoordMiss() işleviyle paralel koordinat grafiğini üretebiliriz. Varsayılan olarak, ilk argüman olarak verilen veri çerçevesinde bulunan tüm değişkenleri kullanır. highlight'ı earnings olarak ayarlamak, earnings'de eksik değeri olan gözlemleri temsil eden çizgileri farklı bir renkle işaretler. Alfa karışımını 0.6 yapmak, çizgileri biraz saydamlaştırarak grafiğin okunabilirliğini artırır.
# Önceki grafikler için oluşturulan değişkenleri kaldırın
biopics <- biopics %>%
  select(- US_movie, - log_earnings)

parcoordMiss(biopics, highlight = 'earnings', alpha = 0.6)
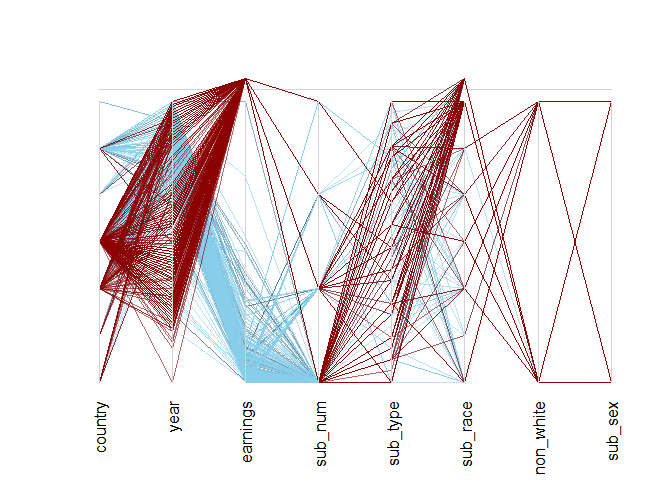
Yukarıdaki grafikte koyu kırmızı çizgiler, earnings'de eksik değeri olan gözlemleri gösterir. Bu vurgulanan gözlemler verilerin geri kalanından farklı davranıyor gibi görünüyor. Özellikle, yalnızca çok azı, aksi hâlde birçok gözlemi kapsayan country'nin sondan bir önceki düzeyine karşılık geliyor! Bunun ABD/İngiltere filmleri olduğu ortaya çıkıyor (bunu görmek için levels(biopics$country) komutunu çalıştırıp sondan bir önceki değere bakın!).
Ayrıca, year ekseninin hızlıca incelenmesi, yüksekliğinin yaklaşık üçte ikisi civarında koyu kırmızı çizgilerin daha az geçtiği bir dönem olduğunu ortaya koyuyor. Demek ki yakın geçmişte bir süre, hasılat verileri daha eksiksizmiş. Bu, hem country hem de year değişkenlerinin hasılattaki eksik değerlerin dağılımını açıklamaya yardımcı olabileceğini düşündürür!
İnceleyeceğimiz son görselleştirme aracı bir matris grafiğidir. Veri matrisinin tüm hücrelerini dikdörtgenlerle görselleştirir. Gözlemlenen veriler sürekli bir gri-siyah renk şemasında gösterilir (renk ne kadar koyuysa değer o kadar yüksektir); eksik değerler kırmızıyla vurgulanır. Grafiği yorumlamayı kolaylaştırdığı için, verileri eksik değişkenlerden birine göre sıralamak iyi bir uygulamadır. Aşağıdaki kod bloğu, earnings'e göre sıralayarak bunu yapar.
matrixplot(biopics, sortby = c('earnings'))
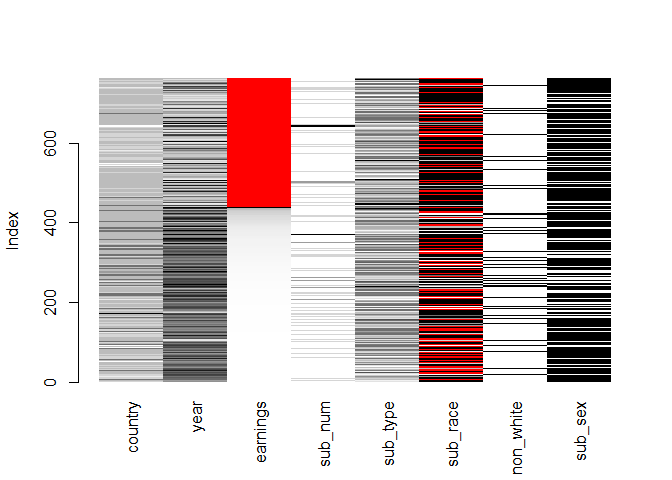
Grafik, önceki bulguların bir kısmını doğrular: earnings'de eksik değerleri olan gözlemler genellikle çok eski dönemlerden gelir (year'ın düşük değeri) ve ayrıca country'de düşük skor alır — bu, hasılatın kırmızı olduğu satırlarda bu iki değişkenin daha açık rengiyle belirtilmiştir. Ayrıca, earnings eksikken ana konusu beyaz olmayan filmlerin daha az olduğu da görülmektedir.
Özetle, biopics veri kümesindeki eksik verilerin MCAR olmadığı görülmektedir. earnings ve sub_race içindeki eksik veri noktalarının konumları birbirlerini açıklamaya yardımcı olur; bu, omurga grafiği ve spinogram ile gösterilmiştir. Dahası, matris grafiği ve paralel koordinat grafiği, country, year ve non_white değişkenlerinin de earnings'deki eksik değerlerin dağılımını açıklamaya yardımcı olabileceğini düşündürür. Bu nedenle, eksik gözlemleri atmak iyi bir fikir değildir; muhtemelen çıkarımlarımıza önyargı katacaktır.
Son Düşünceler
Uzun bir yol kat ettiniz! Artık eksik veri mekanizmalarının ne olduğunu, nasıl farklılaştıklarını ve daha da önemlisi, çeşitli görselleştirme araçlarıyla onlar hakkında nasıl çıkarım yapacağınızı biliyorsunuz. Harika iş! Kendi eksik veri içeren veri kümelerinizi analiz etmek için artık tam donanımlısınız!
R hakkında daha fazla bilgi edinmek isterseniz DataCamp'in Data Visualization with ggplot2 (Part 1) kursunu alın ve R Formula Tutorial yazımıza göz atın.
R ve Veri Görselleştirme hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



