
Last chance! 50% off DataCamp Premium
Sale ends in
Jika dipikir, banyak fungsi di R memanfaatkan rumus (formula): paket seperti ggplot2, stats, lattice, dan dplyr semuanya menggunakannya! Contoh umum fungsi tempat Anda akan menggunakan objek R ini adalah glm(), lm(), facet_wrap(), dan sebagainya. Namun, sebenarnya apa itu formula, dan mengapa Anda harus menggunakannya?
Karena formula adalah kelas khusus dalam bahasa pemrograman R, ada baiknya meninjau singkat tipe data dan struktur data yang tersedia dalam bahasa ini.
Ingat R adalah bahasa pemrograman berorientasi objek: bahasa ini diorganisasikan di sekitar objek. Segala sesuatu di R adalah objek.
Mari mulai dari awal: dalam pemrograman, Anda bekerja dengan struktur data yang menyimpan data, dan fungsi yang memprosesnya. Struktur data adalah antarmuka ke data yang diorganisasikan dalam memori komputer. Seperti yang dinyatakan dalam Definisi Bahasa R, R tidak menyediakan akses langsung ke memori komputer, melainkan menyediakan sejumlah struktur data khusus yang dapat Anda sebut sebagai "objek". Setiap struktur data dirancang untuk mengoptimalkan beberapa aspek penyimpanan, akses, atau pemrosesan.
Lima struktur data utama di R adalah:
# Create variables
a <- c(1,2,3,4,5,6,7,8,9)

b <- list(x = LifeCycleSavings[,1], y = LifeCycleSavings[,2])
Tip: Anda dapat menggunakan fungsi typeof() untuk mengembalikan tipe dari sebuah objek R. Tipe objek memberi tahu Anda lebih banyak tentang tipe (internal R) atau mode penyimpanan dari objek apa pun:
# Retrieve the types of `a` and `b`
typeof(a)

typeof(b)
'double'
'list'
Pada contoh di atas ketika Anda mendefinisikan variabel a dan b, Anda dapat melihat bahwa struktur data berisi deretan elemen data. Elemen-elemen ini bisa bertipe data sama atau berbeda. Anda dapat menemukan 6 tipe data atomik berikut di R:
100, 5, 4, termasuk bilangan bulat."Hello", "True", atau "23.4", terdiri dari rangkaian karakter keyboard;TRUE atau FALSE, terdiri dari "nilai kebenaran";48 65 6c 6c 6f, terdiri dari bit;2+5i, mencakup bilangan kompleks; dan terakhir,3.14, mencakup bilangan desimal.Hampir semua objek memiliki atribut yang melekat padanya di R. Misalnya, Anda mungkin sudah tahu bahwa matriks dan array hanyalah vektor dengan atribut dim dan opsional dimnames yang dilekatkan pada vektor. Atribut digunakan untuk mengimplementasikan struktur kelas yang digunakan di R. Sebagai bahasa berorientasi objek, konsep kelas, bersama dengan metode, adalah hal yang sentral. Kelas adalah definisi dari sebuah objek. Kelas menentukan informasi apa yang dimiliki objek dan bagaimana objek tersebut dapat digunakan.
Perhatikan contoh berikut:
# Retrieve the classes of `a` and `b`
class(a)

class(b)
'numeric'
'list'
Catatan bahwa jika sebuah objek tidak memiliki atribut class, maka objek tersebut memiliki kelas implisit, "matrix", "array" atau hasil dari fungsi mode().
Beberapa kelas khusus yang dapat Anda temui adalah Dates dan Formulas; Dan yang terakhir inilah topik tutorial hari ini!
Seperti yang Anda baca di pendahuluan tutorial ini, Anda mungkin sudah melihat formula muncul saat bekerja dengan paket seperti ggplot2 atau dalam fungsi seperti lm(). Karena Anda biasanya menggunakan formula di dalam pemanggilan fungsi ini untuk mengekspresikan gagasan model statistik, masuk akal jika Anda sering menggunakan objek R ini dalam fungsi pemodelan serta beberapa fungsi grafis.
Benar?
Namun, formula tidak terbatas pada model. Formula adalah alat serbaguna yang kuat yang memungkinkan Anda menangkap dua hal:
Ini menjelaskan mengapa formula digunakan di dalam pemanggilan fungsi untuk menghasilkan "perilaku khusus": formula memungkinkan Anda menangkap nilai variabel tanpa mengevaluasinya sehingga dapat ditafsirkan oleh fungsi.
Dengan struktur data masih segar dalam ingatan, Anda kemudian dapat mendeskripsikan objek R ini sebagai objek “bahasa” atau ekspresi yang tidak dievaluasi yang memiliki kelas “formula” dan atribut yang menyimpan environment.
Pada bagian sebelumnya, Anda melihat bahwa objek memiliki tipe tertentu (internal R) yang menunjukkan bagaimana objek disimpan. Dalam kasus ini, sebuah formula adalah objek bertipe "language".
Tapi apa tepatnya artinya?
Nah, Anda biasanya menjumpai tipe objek ini saat Anda memproses bahasa R itu sendiri. Lihat contoh berikut untuk memahaminya lebih baik:
# Retrieve the object type
typeof(quote(x * 10))

# Retrieve the class
class(quote(x * 10))
'language'
'call'
Pada contoh di atas, Anda meminta R untuk mengembalikan tipe dan kelas dari quote(x*10). Hasilnya, Anda melihat bahwa tipe quote(x*10) adalah 'language', dan class-nya adalah 'call'.
Ini jelas bukan formula, karena Anda memerlukan class() mengembalikan 'formula'!
Lalu apa?
Salah satu yang mencirikan formula di R adalah operator tilde ~. Dengan operator ini, Anda sebenarnya bisa mengatakan: "tangkap makna dari kode ini, tanpa langsung mengevaluasinya”. Itu juga menjelaskan mengapa Anda bisa menganggap formula di R sebagai operator "pengutipan".
Tapi seperti apa tepatnya sebuah formula? Perhatikan lebih dekat baris kode berikut:
# A formula
c <- y ~ x
d <- y ~ x + b

# Double check the class of `c`
class(c)
'formula'
Variabel di sisi kiri tilde (~) disebut "variabel dependen", sementara variabel di sisi kanan disebut "variabel independen" dan digabungkan dengan tanda plus +.
Perlu diketahui bahwa penamaan variabel ini berubah tergantung konteks. Anda mungkin sudah melihat variabel independen muncul sebagai "prediktor", "variabel terkontrol", "fitur", dan sebagainya. Demikian pula, Anda mungkin menjumpai variabel dependen sebagai "variabel respons", "variabel keluaran" atau "label".
Catatan bahwa, meskipun formula d yang Anda definisikan pada potongan kode di atas berisi beberapa variabel, struktur dasar sebuah formula sebenarnya hanyalah simbol tilde ~ dan setidaknya satu variabel independen atau variabel sisi kanan.
Ingat bahwa formula sebenarnya adalah objek bahasa dengan atribut yang menyimpan environment:
# Return the type of `d`
typeof(d)

# Retrieve the attributes of `d`
attributes(d)
'language'
$class
[1] "formula"

$.Environment
<environment: R_GlobalEnv>
Seperti yang Anda lihat pada contoh di atas, variabel yang disertakan dalam formula bisa berupa vektor, misalnya. Namun, Anda sering melihat bahwa variabel yang disertakan dalam formula berasal dari sebuah data frame, seperti pada contoh berikut:
Sepal.Width ~ Petal.Width + log(Petal.Length) + Species
Catatan bahwa nilai data apa pun yang telah ditetapkan ke simbol dalam formula tidak diakses ketika formula itu sendiri dibuat.
Sekarang setelah Anda tahu seperti apa formula dan apa itu di R, perlu disebutkan bahwa objek formula yang mendasarinya bervariasi, tergantung apakah Anda memiliki formula satu sisi atau dua sisi. Anda dapat mengenali yang pertama dengan melihat variabel sisi kiri. Jika tidak ada, seperti pada ~ x, Anda memiliki formula satu sisi.
Ini juga berarti bahwa formula satu sisi akan memiliki panjang 2, sedangkan formula dua sisi akan memiliki panjang 3.
Belum sepenuhnya yakin? Lihat potongan kode berikut. Anda dapat mengakses elemen formula dengan bantuan tanda kurung siku: [[ dan ]].
e <- ~ x + y + z
f <- y ~ x + b

# Return the length of `g`
length(e)
length(f)

# Retrieve the elements at index 1 and 2
e[[1]]
e[[2]]
f[[3]]
2
3
`~`


x + y + z


x + bSeperti yang telah Anda lihat, formula adalah alat serbaguna yang kuat yang memungkinkan Anda menangkap nilai variabel tanpa mengevaluasinya sehingga dapat ditafsirkan oleh fungsi. Itu sudah merupakan salah satu bagian dari jawaban mengapa Anda harus menggunakan formula di R.
Selain itu, Anda menggunakan objek R ini untuk mengekspresikan hubungan antarvariabel.
Misalnya, pada baris pertama kode di bawah ini, Anda mengatakan "y adalah fungsi dari x, a, dan b"; Tentu, Anda juga bisa menjumpai formula yang lebih kompleks, seperti pada baris kedua kode, di mana maksudnya adalah "lebar sepal merupakan fungsi dari lebar petal, dikondisikan pada spesies".
y ~ x + a + b

Sepal.Width ~ Petal.Width | Species
y ~ x + a + b


Sepal.Width ~ Petal.Width | SpeciesSekarang setelah Anda lebih tahu tentang "apa" dan "mengapa" dari objek R khusus ini, saatnya mempelajari bagaimana Anda dapat menggunakan formula dasar maupun yang lebih kompleks! Di bagian ini, Anda tidak hanya akan melihat cara membuat dan menggabungkan formula dasar, tetapi juga menemukan cara membangun formula yang lebih kompleks dengan bantuan operator.
Anda sudah tahu caranya! Anda sudah melihat beberapa contoh dalam tutorial ini, tetapi mari kita rekap:
y ~ x
~ x + y + z
g <- y ~ x + b
Betul — Anda bisa langsung mengetik formulanya!
Namun, Anda mungkin akan berada dalam situasi di mana Anda perlu atau ingin membuat formula dari objek R, seperti string. Dalam kasus seperti itu, Anda dapat menggunakan fungsi formula atau as.formula():
"y ~ x1 + x2"

h <- as.formula("y ~ x1 + x2")

h <- formula("y ~ x1 + x2")
Mudah!
Untuk merekatkan atau menggabungkan beberapa formula, Anda punya dua opsi. Pertama, Anda bisa membuat variabel terpisah untuk setiap formula lalu gunakan list():
# Create variables
i <- y ~ x
j <- y ~ x + x1
k <- y ~ x + x1 + x2

# Concatentate
formulae <- list(as.formula(i),as.formula(j),as.formula(k))

# Double check the class of the list elements
class(formulae[[1]])
'formula'
Alternatifnya, Anda juga bisa menggunakan fungsi lapply(), di mana Anda melewatkan sebuah vektor berisi semua formula Anda sebagai argumen pertama dan as.formula sebagai fungsi yang ingin diterapkan ke setiap elemen vektor tersebut:
# Join all with `c()`
l <- c(i, j, k)

# Apply `as.formula` to all elements of `f`
lapply(l, as.formula)
[[1]]
y ~ x

[[2]]
y ~ x + x1

[[3]]
y ~ x + x1 + x2
Dengan dasar-dasar ini, Anda siap menyelami formula yang lebih kompleks! Di atas, Anda sudah melihat bahwa yang mencirikan formula adalah simbol tilde ~. Selain simbol itu, Anda juga memerlukan variabel dependen dan independen dan variabel-variabel tersebut dapat digabungkan dengan tanda plus +.
Tapi masih ada lagi!
Selain simbol +, ada juga simbol lain yang dapat menambahkan makna khusus pada formula Anda:
- untuk menghapus term;: untuk interaksi;* untuk crossing;%in% untuk nesting; dan^ untuk membatasi crossing hingga derajat tertentu.Anda akan melihat contoh semua operator ini di sisa bagian ini! Mari mulai dengan operator + dan -:
# Use multiple independent variables
y ~ x1 + x2

# Ignore objects in an analysis
y ~ x1 - x2
Catatan bahwa Anda paling sering membutuhkan simbol : dan * dalam konteks pemodelan regresi, saat Anda perlu menentukan term interaksi. Seperti yang telah Anda baca di atas, simbol pertama digunakan untuk interaksi, yang berarti Anda hanya menginginkan interaksi variabel, bukan variabelnya sendiri. Ini berbeda dengan simbol kedua, yang digunakan untuk crossing: Anda menggunakannya untuk menyertakan dua variabel dan interaksinya.
Hati-hati! Dengan menggunakan operator ini, beberapa formula bisa terlihat berbeda tetapi sebenarnya ekuivalen. Pertimbangkan contoh berikut, yang akan menghasilkan regresi yang sama:
y ~ x1 * x2

y ~ x1 + x2 + x1:x2
Kurang yakin bagaimana keduanya bisa sama? Pertimbangkan potongan kode R berikut:
# Set seed
set.seed(123)

# Data
x = rnorm(5)
x2 = rnorm(5)
y = rnorm(5)

# Model frame
model.frame(y ~ x * x2, data = data.frame(x = x, y = y, x2=x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
model.frame(y ~ x + x2 + x:x2, data = data.frame(x = x, y = y, x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
Jangan khawatir jika Anda belum tahu fungsi model.frame(); Anda akan melihat lebih lanjut tentang ini nanti dalam tutorial ini!
Selain itu, berikut contoh nesting, yang dapat Anda kembangkan menjadi y ~ a + a:b:
y ~ a + b %in% a
Semua operator ini memang keren, tetapi bagaimana jika Anda ingin benar-benar melakukan operasi aritmetika? Misalnya Anda ingin menyertakan x dan x^2 dalam model Anda. Dalam kasus seperti itu, Anda mungkin tergoda untuk menulis formula berikut: y ~ x + x^2.
Tapi apakah hasilnya akan persis seperti yang Anda inginkan? Lihatlah!
model.frame( y ~ x + x^2, data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + x^2
| y | x |
|---|---|
| -0.2053091 | 1.18231565 |
| -0.3030972 | 0.04779636 |
| -0.7621604 | 0.86382418 |
| -0.1377784 | -1.18333097 |
| -0.3813125 | -1.25247842 |
Itu bukan hasil yang Anda harapkan!
Pada contoh di atas, Anda tidak melindungi ekspresi aritmetika dan akibatnya, R akan menghapus term x^2, karena dianggap duplikat dari x.
Mengapa demikian?
Nah, x akan memberi Anda efek utama dari x, dan x^2 akan memberi Anda efek utama dan interaksi orde kedua dari x. Pada akhirnya, Anda akan tetap menyertakan x dalam model frame karena efek utama x sudah termasuk dari term x dalam formula, dan tidak ada yang untuk "cross" dengan x guna mendapatkan interaksi orde kedua dalam term x^2.
Untuk menghindari ini, Anda punya beberapa solusi:
I() atau "as-is": y ~ x + I(x^2)Lihat contoh berikut untuk memahami konsekuensi menambahkan fungsi I() ke kode Anda:
model.frame( y ~ x + I(x^2), data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + I(x^2)| y | x | I(x^2) |
|---|---|---|
| 1.414090 | -0.1996230 | 0.039849.... |
| 1.777646 | -1.0675904 | 1.139749.... |
| 1.710137 | -1.4071841 | 1.980167.... |
| 1.259111 | -1.3747289 | 1.889879.... |
| -1.490866 | 0.8323668 | 0.692834.... |
Baris kode terakhir ini sebenarnya memberi tahu R untuk menghitung nilai x^2 sebelum menggunakan formula. Catatan juga bahwa Anda dapat menggunakan operator "as-is" untuk menskalakan variabel untuk sebuah model; Anda hanya perlu membungkus nama variabel yang relevan dalam I():
y ~ I(2 * x)
Semua ini mungkin terasa cukup abstrak ketika Anda melihat contoh di atas, jadi mari bahas beberapa kasus lain; Misalnya, regresi polinomial. Dalam kasus seperti itu, Anda perlu bekerja dengan fungsi I(). Untuk model ANOVA faktorial yang dibatasi hingga interaksi depth=2, sebaliknya, Anda tidak membutuhkan fungsi ini karena Anda ingin memperluas ke formula yang berisi efek utama untuk a, b, dan c bersama interaksi orde kedua mereka:
# Polynomial Regression
y ~ x + I(x^2) + I(x^3)

# Factorial ANOVA
y ~ (a*b*c)^2
Terakhir, ada satu fitur lain yang akan berguna saat Anda bekerja dengan banyak variabel, yaitu operator .. Saat Anda menggunakan operator ini dalam sebuah formula, Anda merujuk ke semua variabel lain dalam matriks yang belum dimasukkan ke dalam model. Ini praktis, misalnya, ketika Anda ingin menjalankan regresi pada matriks atau dataframe dan Anda tidak ingin mengetik semua variabel:
y ~ .
Ketika Anda telah membuat formula, Anda mungkin juga ingin memeriksanya. Di bagian ini, Anda akan diperkenalkan dengan beberapa alat yang dapat Anda gunakan untuk mengeksplorasi lebih lanjut objek R khusus yang Anda buat!
Catatan bahwa Anda sudah melihat beberapa cara untuk memeriksa formula di bagian sebelumnya: Anda melihat fungsi seperti attributes(), typeof(), class(), dan sebagainya.
terms() functionUntuk memeriksa dan membandingkan berbagai formula, Anda dapat menggunakan fungsi terms():
m <- formula("y ~ x1 + x2")
terms(m)
y ~ x1 + x2
attr(,"variables")
list(y, x1, x2)
attr(,"factors")
   x1 x2
y   0  0
x1  1  0
x2  0  1
attr(,"term.labels")
[1] "x1" "x2"
attr(,"order")
[1] 1 1
attr(,"intercept")
[1] 1
attr(,"response")
[1] 1
attr(,".Environment")
<environment: R_GlobalEnv>all.varsJika Anda ingin mengetahui nama variabel dalam model, Anda dapat menggunakan all.vars. Dengan fungsi ini, Anda mengembalikan vektor karakter yang berisi semua nama yang muncul dalam sebuah formula:
print(all.vars(m))
[1] "y" "x1" "x2"update() functionUntuk memodifikasi formula tanpa mengonversinya menjadi karakter, Anda dapat menggunakan fungsi update():
update(y ~ x1 + x2, ~. + x3)
y ~ x1 + x2 + x3
Catatan bahwa Anda juga bisa memperbarui formula dengan mengonversinya menjadi karakter dengan as.character(); Lalu, Anda dapat membangun formula dengan sangat cepat menggunakan paste(). Misalnya, jika Anda ingin menambahkan variabel sisi kanan lain ke formula Anda, Anda cukup menempelkannya:
as.formula(paste("y ~ x1 + x2", "x3", sep = "+"))

factors <- c("x2", "x3")
as.formula(paste("y~", paste(factors, collapse="+")))
y ~ x1 + x2 + x3


y ~ x2 + x3
Pada potongan kode di atas, Anda dapat melihat bahwa Anda dapat menggunakan argumen sep atau collapse untuk menunjukkan string karakter guna memisahkan term dalam formula Anda.
Namun, menggunakan paste() jelas bukan satu-satunya cara untuk melakukan penyesuaian pada formula Anda: Anda juga dapat menggunakan reformulate():
reformulate(termlabels = factors, response = 'y')
y ~ x2 + x3
is.formula()Periksa ulang apakah variabel Anda adalah formula dengan meneruskannya ke fungsi is.formula(). Perlu diingat bahwa fungsi ini adalah bagian dari pustaka plyr, jadi Anda perlu membuatnya tersedia di workspace sebelum memanggil is.formula()!
# Load `plyr`
library(plyr)

# Check `m`
is.formula(m)
TRUE
Sampai sekarang, Anda sudah membaca bahwa formula R adalah alat serbaguna yang tidak terbatas pada pemodelan dan Anda telah melihat beberapa contoh penggunaannya. Di bagian ini, Anda akan mendalami topik terakhir ini: Anda akan melihat beberapa kasus di mana Anda dapat menggunakan alat ini untuk keuntungan Anda. Tentu, Anda akan membahas fungsi pemodelan dan grafis dari paket seperti lattice dan stats, tetapi Anda juga akan membahas evaluasi non-standar di dplyr.
R sangat baik ketika Anda perlu melakukan pemodelan statistik. Seperti yang sudah Anda ketahui, pemodelan statistik adalah cara yang disederhanakan dan diformalkan secara matematis untuk mendekati realitas dan opsional untuk membuat prediksi dari pendekatan ini. Sebuah model statistik sering mewakili proses pembangkitan data dalam bentuk yang diidealkan. Untuk melakukan pemodelan statistik, Anda membutuhkan fungsi pemodelan.
Fungsi pemodelan di R adalah salah satu contoh khas di mana Anda memerlukan objek formula sebagai argumen. Argumen lain yang mungkin Anda temukan dalam fungsi ini adalah data, yang memungkinkan Anda menentukan data frame yang ingin Anda lampirkan selama pemodelan, subset untuk memilih data yang ingin Anda gunakan, ... Secara umum, jika Anda ingin mengetahui argumen mana yang harus diteruskan ke fungsi tertentu, jangan ragu menggunakan fungsi help() atau ? di konsol R Anda.
Fungsi pemodelan mengembalikan objek model yang berisi semua informasi tentang hasil pemodelan. Fungsi R generik seperti print(), summary(), plot(), anova(), dan lain-lain akan memiliki metode yang didefinisikan untuk kelas objek tertentu untuk mengembalikan informasi yang sesuai untuk jenis objek tersebut.
Mungkin salah satu fungsi pemodelan yang paling dikenal adalah lm(), yang menggunakan semua argumen yang dijelaskan di atas. Anda menggunakan lm() untuk menyesuaikan model linear. Anda dapat menggunakannya untuk melakukan regresi, analisis ragam satu strata dan analisis kovarians. Mari lihat contoh di mana Anda menggunakan lm() dan memeriksa model dengan bantuan print():
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
        data = iris,
        subset = Sepal.Length > 4.6)

print(lm.m)
Call:
lm(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) +
    Species, data = iris, subset = Sepal.Length > 4.6)

Coefficients:
      (Intercept)        Petal.Width  log(Petal.Length)  Speciesversicolor
           3.1531             0.6620             0.4612            -1.9265
 Speciesvirginica
          -2.3088
lm() pada awalnya menggunakan formula dan environment yang sesuai untuk menerjemahkan hubungan antarvariabel menjadi pembuatan data frame yang berisi data.
Ada juga metode model.frame(), salah satunya sudah Anda lihat contohnya dalam tutorial ini, yang paling sering digunakan untuk mengambil atau membuat ulang model frame dari objek yang telah dipasangkan (fitted object), tanpa argumen lain. Ini memungkinkan Anda mengambil kolom-kolom dari data frame yang sesuai dengan argumen pemanggilan asli selain formula, subset dan weights: misalnya, metode glm() menangani offset, etastart dan mustart.
Pada potongan kode berikut, Anda melihat bahwa Anda menggunakan fungsi model.frame() untuk mendapatkan kembali data frame dari objek yang dipasangkan; Perhatikan bahwa kodenya sedikit berbeda dari potongan kode yang Anda lihat di atas: argumen subset sedikit dimodifikasi.
stats::model.frame(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
                   data = iris,
                   subset = Sepal.Length > 6.9,
                   drop.unused.levels = TRUE)
| Sepal.Width | Petal.Width | log(Petal.Length) | Species | |
|---|---|---|---|---|
| 51 | 3.2 | 1.4 | 1.547563 | versicolor |
| 103 | 3.0 | 2.1 | 1.774952 | virginica |
| 106 | 3.0 | 2.1 | 1.887070 | virginica |
| 108 | 2.9 | 1.8 | 1.840550 | virginica |
| 110 | 3.6 | 2.5 | 1.808289 | virginica |
| 118 | 3.8 | 2.2 | 1.902108 | virginica |
| 119 | 2.6 | 2.3 | 1.931521 | virginica |
| 123 | 2.8 | 2.0 | 1.902108 | virginica |
| 126 | 3.2 | 1.8 | 1.791759 | virginica |
| 130 | 3.0 | 1.6 | 1.757858 | virginica |
| 131 | 2.8 | 1.9 | 1.808289 | virginica |
| 132 | 3.8 | 2.0 | 1.856298 | virginica |
| 136 | 3.0 | 2.3 | 1.808289 | virginica |
Tip: masih ada lebih banyak fungsi di paket stats yang memungkinkan Anda menggunakan formula, seperti aggregate().
Untuk model efek campuran linear, yang memungkinkan Anda memodelkan efek acak untuk mempertimbangkan variasi akibat faktor seperti perbedaan pengamat, Anda dapat menggunakan paket nlme dengan fungsi lme(). Di sini juga, Anda melihat bahwa formula adalah argumen pertama yang perlu Anda berikan ke fungsi pemodelan, dan ada juga argumen data!
# Load packages
library(MASS)
library(nlme)

# Get some data
data(oats)

# Adjust the data names and columns
names(oats) = c('block', 'variety', 'nitrogen', 'yield')
oats$mainplot = oats$variety
oats$subplot = oats$nitrogen

# Fit a non-linear mixed-effects model
nlme.m = lme(yield ~ variety*nitrogen,
             random = ~ 1|block/mainplot,
             data = oats)

# Retrieve a summary
summary(nlme.m)
Linear mixed-effects model fit by REML
 Data: oats
       AIC      BIC    logLik
  559.0285 590.4437 -264.5143

Random effects:
 Formula: ~1 | block
        (Intercept)
StdDev:    14.64496

 Formula: ~1 | mainplot %in% block
        (Intercept) Residual
StdDev:    10.29863 13.30727

Fixed effects: yield ~ variety * nitrogen
                                    Value Std.Error DF   t-value p-value
(Intercept)                      80.00000  9.106958 45  8.784492  0.0000
varietyMarvellous                 6.66667  9.715028 10  0.686222  0.5082
varietyVictory                   -8.50000  9.715028 10 -0.874933  0.4021
nitrogen0.2cwt                   18.50000  7.682957 45  2.407927  0.0202
nitrogen0.4cwt                   34.66667  7.682957 45  4.512152  0.0000
nitrogen0.6cwt                   44.83333  7.682957 45  5.835427  0.0000
varietyMarvellous:nitrogen0.2cwt  3.33333 10.865342 45  0.306786  0.7604
varietyVictory:nitrogen0.2cwt    -0.33333 10.865342 45 -0.030679  0.9757
varietyMarvellous:nitrogen0.4cwt -4.16667 10.865342 45 -0.383482  0.7032
varietyVictory:nitrogen0.4cwt     4.66667 10.865342 45  0.429500  0.6696
varietyMarvellous:nitrogen0.6cwt -4.66667 10.865342 45 -0.429500  0.6696
varietyVictory:nitrogen0.6cwt     2.16667 10.865342 45  0.199411  0.8428
 Correlation:
                                 (Intr) vrtyMr vrtyVc ntr0.2 ntr0.4 ntr0.6
varietyMarvellous                -0.533
varietyVictory                   -0.533  0.500
nitrogen0.2cwt                   -0.422  0.395  0.395
nitrogen0.4cwt                   -0.422  0.395  0.395  0.500
nitrogen0.6cwt                   -0.422  0.395  0.395  0.500  0.500
varietyMarvellous:nitrogen0.2cwt  0.298 -0.559 -0.280 -0.707 -0.354 -0.354
varietyVictory:nitrogen0.2cwt     0.298 -0.280 -0.559 -0.707 -0.354 -0.354
varietyMarvellous:nitrogen0.4cwt  0.298 -0.559 -0.280 -0.354 -0.707 -0.354
varietyVictory:nitrogen0.4cwt     0.298 -0.280 -0.559 -0.354 -0.707 -0.354
varietyMarvellous:nitrogen0.6cwt  0.298 -0.559 -0.280 -0-354 -0.354 -0.707
varietyVictory:nitrogen0.6cwt     0.298 -0.280 -0.559 -0.354 -0.354 -0.707
                                 vM:0.2 vV:0.2 vM:0.4 vV:0.4 vM:0.6
varietyMarvellous
varietyVictory
nitrogen0.2cwt
nitrogen0.4cwt
nitrogen0.6cwt
varietyMarvellous:nitrogen0.2cwt
varietyVictory:nitrogen0.2cwt     0.500
varietyMarvellous:nitrogen0.4cwt  0.500  0.250
varietyVictory:nitrogen0.4cwt     0.250  0.500  0.500
varietyMarvellous:nitrogen0.6cwt  0.500  0.250  0.500  0.250
varietyVictory:nitrogen0.6cwt     0.250  0.500  0.250  0.500  0.500

Standardized Within-Group Residuals:
        Min          Q1         Med          Q3         Max
-1.81300898 -0.56144838  0.01758044  0.63864476  1.57034166

Number of Observations: 72
Number of Groups:
              block mainplot %in% block
                  6                  18
Catatan bahwa selain nlme, ada juga paket lain, seperti paket lme4, yang juga didedikasikan untuk memasangkan model efek campuran linear dan linear tersamar (generalized).
Contoh lain dari fungsi pemodelan dan keberadaan formula adalah nls(), yang akan Anda gunakan untuk membuat model non-linear:
# Set seed
set.seed(20160227)

# Data
x <- seq(0,50,1)
y <- ((runif(1,10,20)*x)/(runif(1,0,10)+x))+rnorm(51,0,1)

# Non-linear model
nls.m <- nls(y ~ a*x/(b+x),
             start=c(a=4, b=1))
Contoh terakhir adalah fungsi untuk membangun Generalized Linear Models (GLM). Di R, Anda dapat menggunakan fungsi glm() untuk melakukan ini. Mungkin sudah terdengar berulang, tetapi di sini juga Anda menggunakan argumen formula dan data:
# Load package
library(MPDiR)

# Get the data
data(Chromatic)

# Model
glm.m <- glm(Thresh ~ Axis:(I(Age^-1) + Age),
             family = Gamma(link = "identity"),
             data = Chromatic)

# Get back a summary
summary(glm.m)
Call:
glm(formula = Thresh ~ Axis:(I(Age^-1) + Age), family = Gamma(link = "identity"),
    data = Chromatic)

Deviance Residuals:
    Min       1Q   Median       3Q      Max
-1.2160  -0.3728  -0.0805   0.2311   1.2932

Coefficients:
                      Estimate Std. Error t value Pr(>|t|)
(Intercept)          3.282e-04  9.965e-05   3.294  0.00106 **
AxisDeutan:I(Age^-1) 7.803e-03  3.686e-04  21.172  < 2e-16 ***
AxisProtan:I(Age^-1) 8.271e-03  3.863e-04  21.410  < 2e-16 ***
AxisTritan:I(Age^-1) 1.166e-02  5.284e-04  22.065  < 2e-16 ***
AxisDeutan:Age       1.521e-05  3.418e-06   4.450 1.06e-05 ***
AxisProtan:Age       1.540e-05  3.434e-06   4.484 9.10e-06 ***
AxisTritan:Age       4.812e-05  5.838e-06   8.241 1.48e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for Gamma family taken to be 0.2054848)

    Null deviance: 543.35  on 510  degrees of freedom
Residual deviance: 100.40  on 504  degrees of freedom
AIC: -4777.6

Number of Fisher Scoring iterations: 6
Sebelum Anda beralih ke fungsi grafis, ada satu hal lagi yang baik untuk diketahui: saat Anda menggunakan formula dalam fungsi pemodelan seperti lm(), terjadi konversi standar dari formula ke fungsi. Untuk menjelaskan jenis konversi apa yang terjadi, Anda harus kembali ke contoh yang Anda lihat sebelumnya dalam tutorial ini:
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
           data = iris,
           subset = Sepal.Length > 4.6)
Meskipun tujuan potongan kode ini adalah untuk memasangkan model regresi linear, formula digunakan untuk menentukan model simbolik serta menghasilkan matriks desain yang dimaksud. Matriks desain adalah representasi dua dimensi dari kumpulan prediktor atau variabel independen di mana instance data berada dalam baris dan atribut variabel dalam kolom. Matriks desain juga dikenal sebagai matriks X.
Dengan demikian, metode formula juga mendefinisikan kolom mana yang harus dimasukkan dalam matriks desain.
Tapi apa sebenarnya artinya semua itu? Mari lihat baris kode berikut:
# A formula
y ~ x

# A converted formula
y = a_1 + a_2 * x
Ini adalah contoh konversi sederhana: y ~ x diterjemahkan menjadi y = a_1 + a_2 * x.
Untuk melihat dan memahami apa yang sebenarnya terjadi di R, Anda dapat menggunakan fungsi model_matrix(). Fungsi ini membuat matriks desain atau matriks model dengan, misalnya, memperluas faktor menjadi sekumpulan variabel dummy, tergantung pada kontras, dan memperluas interaksi dengan cara serupa.
Jangan lupa untuk meneruskan data frame df dan formula untuk mendapatkan kembali tibble yang mendefinisikan persamaan model:
# Load packages
library(tidyverse)
library(modelr)

# A data frame
df <- tribble(
  ~y, ~x1, ~x2,
  4, 2, 5,
  5, 1, 6
)

# Model matrix
model_matrix(df, y ~ x1)
| (Intercept) | x1 |
|---|---|
| 1 | 2 |
| 1 | 1 |
Ada kolom ekstra (Intercept) yang muncul. Ini adalah perilaku default di sisi R. Namun, cara R menambahkan intersep ke model hanyalah dengan memiliki kolom berisi angka satu. Jika Anda tidak menginginkannya, Anda perlu menghapusnya secara eksplisit dengan menambahkan -1 ke formula, seperti ini:
model_matrix(df, y ~ x1-1)
| x1 |
|---|
| 2 |
| 1 |
Catatan juga bahwa matriks model bertambah ukurannya dengan cara yang tidak mengejutkan saat Anda menambahkan lebih banyak variabel ke model.
model_matrix(df, y ~ x1 + x2)
| (Intercept) | x1 | x2 |
|---|---|---|
| 1 | 2 | 5 |
| 1 | 1 | 6 |
Tempat penting lain di mana Anda akan menemukan formula di R adalah fungsi grafis. Ada banyak sekali paket di luar sana, jadi tutorial ini hanya akan berfokus pada graphics, lattice, ggplot2 dan ggformula.
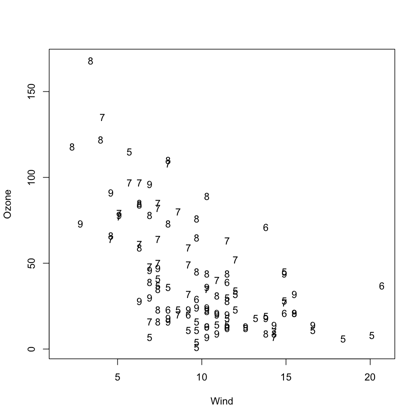
graphicsPaket R dasar graphics memungkinkan Anda menentukan scatterplot atau menambahkan titik, garis, atau teks menggunakan formula. Lihat contoh berikut:
# Get data
data(airquality)

# Plot
plot(Ozone ~ Wind, data = airquality, pch = as.character(Month))
Jika Anda ingin tahu lebih banyak, jangan ragu untuk melihat halaman ini.
latticelattice adalah paket yang dibangun di atas grid graphics. Ini adalah paket grafis serbaguna yang menyediakan implementasi alternatif untuk banyak fungsi plotting yang tersedia di grafis dasar. Contoh spesifik termasuk scatterplot dengan fungsi xyplot(), diagram batang dengan fungsi barchart(), dan boxplot dengan fungsi bwplot().
Tip: ingin belajar lebih banyak tentang lattice? Pertimbangkan untuk mengikuti kursus Data Visualization in R dengan lattice di DataCamp.
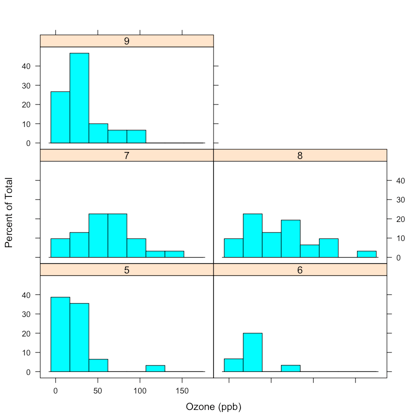
Yang istimewa dari paket ini adalah ia menggunakan notasi formula dari model statistik untuk mendeskripsikan plot yang diinginkan, dan lebih spesifiknya, variabel yang akan diplot. Ia juga menambahkan karakter pipa atau garis vertikal | untuk menentukan variabel pengondisian:
# Load package
library(lattice)

# Plot histogram
histogram(~ Ozone | factor(Month),
          data = airquality,
          layout = c(2, 3),
          xlab = "Ozone (ppb)")
Catatan bahwa seperti halnya fungsi pemodelan, fungsi-fungsi dalam pustaka lattice selain memiliki argumen formula, juga memiliki argumen data, seperti yang diharapkan!
Ingat bahwa Anda juga dapat menghilangkan argumen data pada potongan kode di atas, tetapi kemudian Anda perlu melampirkan (attach) datanya:
# Load package
library(lattice)

# Attach data
attach(airquality)

# Plot
histogram(~ Ozone | factor(Month),
          layout = c(2, 3),
          xlab = "Ozone (ppb)")
ggplot2Anda dapat menggunakan formula dalam berbagai fungsi ggplot2:
geom_smooth() atau stats_smooth(), untuk menentukan formula yang digunakan dalam fungsi smoothing; Ini akan memengaruhi bentuk hasil fitting.facet_wrap(), untuk menentukan panel pemetaan.facet_grid(), untuk menentukan baris dan kolom yang perlu diplot, dengan atau tanpa faceting.# Load package
library(ggplot2)
# Plot
ggplot(mpg, aes(displ, hwy)) +
geom_point() +
geom_smooth(method = "lm",
formula = y ~ splines::bs(x, 3),
se = FALSE)
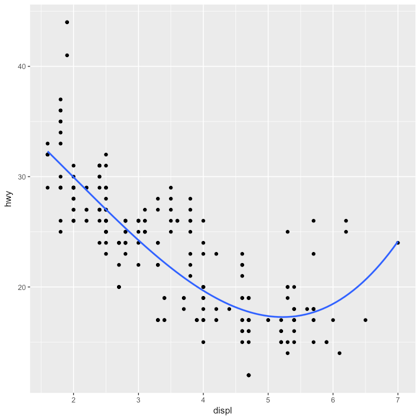
Perhatikan bahwa, untuk membuat plot ini, formula menggunakan huruf x dan y, bukan nama variabelnya. Ini tidak terjadi saat Anda menggunakan facet_wrap():
ggplot(mpg, aes(displ, hwy)) +
  geom_point() +
  geom_smooth(span = 0.8) +
  facet_wrap(~drv)
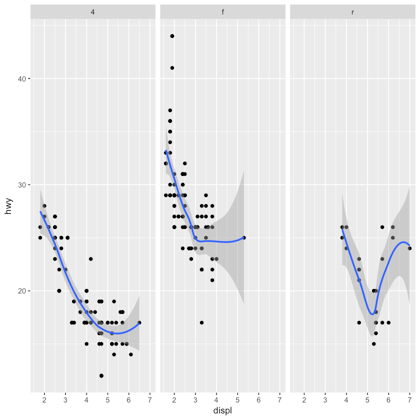
Ingin belajar lebih banyak tentang ggplot2? Lihat kursus ini atau cek dokumentasinya.
ggformulaPaket ggformula saat ini dibangun di atas ggplot2, tetapi menyediakan antarmuka yang berbasis formula. Ini mirip dengan yang Anda temukan pada antarmuka lattice. Anda juga akan menemukan bahwa operator pipa digunakan dalam paket ini untuk membangun grafik yang lebih kompleks dari komponen yang lebih sederhana.
Tip: jika Anda ingin tahu lebih banyak tentang operator pipa di R, pertimbangkan tutorial ini.
Cara dasar membuat plot dengan ggformula adalah
gf_plottype(formula, data = mydata)Catatan bahwa fungsi gf_plottype() sebenarnya diawali dengan gf, yang dimaksudkan untuk mengingatkan Anda bahwa Anda sedang bekerja dengan fungsi yang merupakan antarmuka berbasis formula ke ggplot2; Huruf g untuk ggplot2 dan f untuk “formula.”
Lihat contoh berikut untuk melihat seperti apa ini dalam kode R:
# Load package
library(ggformula)

# Plot
gf_point(mpg ~ hp, data = mtcars)
Tentu, ini hanya grafik dasar; Anda bisa melakukan jauh lebih banyak dengan paket visualisasi ini! Anda dapat memilih jenis glyph yang berbeda dan atribut spesifik untuk glyph tersebut, Anda dapat membuat plot satu atau dua variabel, menyesuaikan posisi glyph, dan seterusnya. Tutorial ini tidak akan masuk lebih jauh ke detail paket ini, namun inti utamanya adalah paket ini menjadikan formula sebagai bahan utama untuk membuat grafik!
Jika Anda memang ingin tahu lebih banyak dari yang dibahas di tutorial ini, baca tentang paket ggformula di sini atau lihat halaman RDocumentation dari paket tersebut.
dplyrdplyr adalah contoh paket yang bekerja dengan Evaluasi Non-Standar (Non-Standard Evaluation). Contoh lain adalah library(magrittr) versus library("magrittr"), yang keduanya berfungsi dengan baik, meskipun ada tanda kutip pada satu baris dan tidak pada yang lain! Bandingkan contoh library() ini dengan install.packages(), misalnya:
# This will work
install.packages("magrittr")

# This won't work
install.packages(magrittr)
Di R, Anda biasanya perlu menggunakan tanda kutip kapan pun Anda menamai bagian dari sebuah objek, tetapi dalam beberapa fungsi —seperti library()— Anda tidak perlu. Fungsi-fungsi ini dirancang untuk bekerja dengan cara yang tidak standar. Lebih jauh lagi, beberapa fungsi ini bahkan tidak memiliki cara standar!
Terkait dplyr, Anda akan menemukan bahwa sebagian besar fungsi dalam paket ini bekerja seperti fungsi lainnya: semua fungsi menggunakan Standard Evaluation (SE). Namun, untuk penggunaan interaktif, fungsi juga memiliki Non-Standard Evaluation (NSE), yang menghemat pengetikan Anda.
(Mari akui, mengetik semua tanda kutip itu bisa jadi melelahkan!)
Itulah mengapa sebagian besar fungsi dplyr menggunakan evaluasi non-standar. Mereka tidak mengikuti aturan evaluasi R biasa. Sebaliknya, mereka menangkap ekspresi yang Anda ketik dan mengevaluasinya dengan cara khusus.
Namun, itu tidak berarti bahwa fungsi-fungsi ini tidak memiliki varian evaluasi standar. Setiap fungsi yang menggunakan evaluasi non-standar memiliki (dan seharusnya memiliki) jalur pelarian evaluasi standar yang melakukan komputasi sebenarnya. Fungsi evaluasi standar seharusnya diakhiri dengan _. Ini berarti ada beberapa verba dalam paket dplyr: select(), select_(), mutate(), mutate_(), dan sebagainya.
Ketika digunakan secara interaktif, fungsi-fungsi ini pertama-tama akan dievaluasi dengan paket lazyeval sebelum dikirim ke versi evaluasi standar dari fungsi tersebut. Artinya, di balik layar, select() dievaluasi dengan paket lazyeval dan dikirim ke select_().
Dengan demikian, ada 3 cara untuk mengutip variabel dalam fungsi evaluasi standar yang dipahami oleh dplyr dan lazyeval:
quote(), dan# Load `dplyr`
library(dplyr)
# NSE evaluation
select(iris, Sepal.Length, Petal.Length)
# standard evaluation
select_(iris, ~Sepal.Length)
select_(iris, ~Sepal.Length, ~Petal.Length) #works
select_(iris, quote(Sepal.Length), quote(Petal.Length)) # yes!
select_(iris, "Sepal.Length", "Petal.Length", "Species")
Tip: jika Anda ingin membaca lebih lanjut tentang evaluasi non-standar, pertimbangkan membaca bab tentang topik ini dalam buku Advanced R karya Hadley Wickham.
Sebelumnya, Anda telah melihat bahwa Anda dapat membuat dan memeriksa formula menggunakan fungsi seperti as.formula, update(), all.vars, ... Itu semua adalah operasi dan manipulasi sederhana, tetapi bagaimana dengan manipulasi tingkat lanjut dengan formula? Mungkin paket-paket berikut akan menarik bagi Anda!
Formula PackageBaru-baru ini, paket ini dipublikasikan di CRAN. Paket ini ideal bagi mereka yang ingin membawa formula ke level berikutnya. Paket ini memperluas kelas dasar formula.
Lebih khusus, objek Formula memperluas objek formula dasar: dengan paket ini, Anda dapat mendefinisikan formula yang menerima operator formula tambahan | yang memisahkan beberapa bagian atau yang berpotensi menampung semua operator formula (termasuk karakter pipa) di sisi kiri untuk mendukung banyak respons.
Contoh formula yang akan dapat Anda buat adalah:
y ~ x1 + x2 | u1 + u2 + u3 | v1 + v2y1 + y2 ~ x1 + x2 + x3y1 | y2 + y3 ~ x, dan# Load package
library(Formula)
# Create formulas
f1 <- y ~ x1 + x2 | z1 + z2 + z3
F1 <- Formula(f1)
# Retrieve the class of `F1`
class(F1)
Catatan bahwa fungsi as.formula() dan is.formula() juga telah diperbarui dalam paket ini: Anda akan menggunakan is.Formula() dan as.Formula() sebagai gantinya!
Baca lebih lanjut di sini.
formula.toolsPaket ini baru-baru ini dirilis dan menyediakan "utilitas programatik untuk memanipulasi formula, ekspresi, pemanggilan (calls), penugasan (assignments) dan Objek R lainnya". Itu sangat banyak, tetapi intinya adalah: Anda dapat menggunakan paket ini untuk mengakses dan memodifikasi struktur formula serta mengekstrak dan mengganti nama serta simbol dari objek R tersebut. Paket ini ditulis oleh Christopher Brown.
Beberapa hal yang mungkin Anda anggap berguna saat bekerja dengan paket ini adalah berikut ini:
get.vars(): alih-alih all.vars(), fungsi ini akan mengekstrak nama variabel dari berbagai objek R, tetapi semua simbol, dll. akan diinterpolasi menjadi nama variabel.invert(): Anda dapat menggunakan fungsi ini untuk membalik operator dalam sebuah objek, seperti formula.is.one.sided(): fungsi ini sangat berguna untuk menentukan apakah sebuah formula satu sisi atau dua sisi.Ingat bahwa formula adalah satu sisi jika terlihat seperti ini: ~x; Ia akan menjadi dua sisi jika diformulasikan sebagai x~y.
Hore! Anda telah menyelesaikan tutorial tentang formula R ini. Jika Anda ingin membaca lebih lanjut, pastikan untuk melihat buku R for Data Science karya Hadley Wickham, yang memiliki satu bab yang sepenuhnya didedikasikan untuk formula dan keluarga model di R.
Lihat Getting Started with the Tidyverse: Tutorial dari DataCamp.
Dapatkah Anda memikirkan lebih banyak contoh di mana Anda dapat menemukan formula atau lebih banyak paket yang dapat Anda gunakan untuk memanipulasi formula? Jangan ragu beri tahu saya di Twitter: @willems_karlijn.
Kursus R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



