Corso
Introduzione alla visualizzazione dei dati con ggplot2
4 ore
189.9K
I dati mancanti sono un problema nel lavoro quotidiano di qualsiasi data scientist. Dovremmo imputarli? Se sì, quale metodo è appropriato? Oppure si possono semplicemente eliminare le osservazioni con valori mancanti? Per rispondere a queste domande, bisognerebbe conoscere il meccanismo alla base dei dati mancanti. Rilevarlo con test statistici è complesso e a volte porta solo a indicazioni vaghe. Gli strumenti di visualizzazione, al contrario, sono facili da usare e aiutano non solo a individuare i meccanismi dei dati mancanti, ma anche a ottenere insight su altri aspetti della qualità dei dati. In questo tutorial, presentiamo una serie di metodi di plotting disponibili nel pacchetto VIM per mostrare come possano aiutarti a capire a fondo quali sono i pattern con cui i dati risultano mancanti.
Le ragioni per cui un dataset è incompleto possono essere molteplici. È fondamentale indagare quali potrebbero essere le cause dei dati mancanti, perché questo influisce sul modo in cui affrontiamo il problema. Per esempio, se il problema è la mancata risposta in sondaggi sul lavoro, ci si potrebbe aspettare che i rispondenti più ricchi e quelli più poveri non dichiarino i loro redditi nel questionario, il che significa che i valori mancanti non sono distribuiti uniformemente nel dataset. In questo caso, rimuovere semplicemente le osservazioni incomplete prima di effettuare l’analisi di interesse porterebbe a risultati distorti. D’altro canto, ad esempio, se i dati mancano a causa di un guasto del dispositivo di raccolta, è possibile che le posizioni dei punti mancanti nel dataset siano puramente casuali.
Esistono tre schemi distinti secondo cui i dati possono risultare mancanti. Di solito sono indicati come meccanismi dei dati mancanti.
Missing completely at random (MCAR)
In condizioni MCAR non c’è alcun pattern sistematico nella posizione dei valori mancanti nel dataset: si verificano del tutto a caso. Formalmente, significa che la probabilità che un’osservazione sia assente non dipende né dai valori delle altre variabili né dai suoi stessi valori. In questo caso, eliminare le osservazioni incomplete non introdurrebbe bias nei risultati dell’analisi successiva.
Esempio: La temperatura viene misurata continuamente da un sensore che raccoglie i dati e li invia via Internet a un database. Per ragioni sconosciute, a volte la connessione Internet cade.
Missing at random (MAR)
In condizioni MAR, la probabilità che una particolare osservazione manchi è ancora indipendente dai suoi valori, ma dipende dai valori di altre variabili. In questo caso, rimuovere le osservazioni incomplete rende il campione meno rappresentativo.
Esempio: Alcuni dati nelle ore notturne mancano a causa di lavori di manutenzione del sensore, che sono sempre effettuati di notte.
Missing not at random (MNAR)
In condizioni MNAR, la probabilità che un’osservazione manchi dipende dai suoi stessi valori non osservati. Anche in questo caso, eliminare i dati incompleti porta a un’analisi distorta.
Esempio: Il sensore si blocca a -20 gradi Celsius e non misura temperature al di sotto di questo valore.
In pratica, è difficile stabilire quale dei tre meccanismi dei dati mancanti si applichi in un caso specifico. Per capirlo, tracciamo dei dati MNAR. Useremo i pacchetti ggplot2 e gridExtra che dobbiamo caricare prima. Caricheremo anche altri due pacchetti per dopo: VIM per l’analisi visiva dei dati mancanti e dplyr per un po’ di pre-processing. Ricordati di eseguire install.packages() in caso manchino ancora nello spazio di lavoro.
library("VIM")
library("dplyr")
library("ggplot2")
library("gridExtra")
Creiamo un dataset con due variabili non correlate e distribuite normalmente, x e y, con alcuni valori mancanti in y nella coda destra della sua distribuzione, cioè tra i valori più alti. Nota che conserviamo anche i valori effettivi e li impostiamo come mancanti in una variabile separata.
set.seed(2)
mnar_data <- data.frame(x = rnorm(100), y = rnorm(100)) %>%
    mutate(y_miss = ifelse(y > 1, y, NA),
           y = ifelse(is.na(y_miss), y, NA),
           x_miss = ifelse(is.na(y), x, NA))
Ora disegneremo due scatter plot di x contro y: uno che include i punti i cui valori di y fingiamo siano mancanti e uno con solo i dati osservati.
grid.arrange(
  # Plot evidenziando i punti mancanti
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_point(aes(x, y_miss), col = "red", size = 4, alpha = 0.6) +
    geom_hline(aes(yintercept = y_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("Where the data points are missing"),
  # Cosa può vedere il data scientist
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_vline(aes(xintercept = x_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("What the data scientist can see"),
  # Disporre i due grafici affiancati
  ncol = 2
)
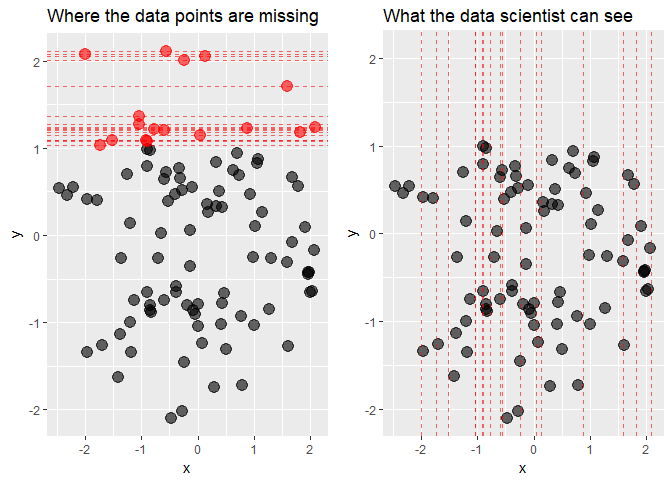
Dal primo grafico è chiaro che i dati sono effettivamente MNAR, ma ciò che il data scientist può vedere sono solo le coordinate x dei punti mancanti. Quale conclusione si può trarre dal secondo grafico? I dati sono MCAR? Forse sì, la posizione dei valori mancanti sembra distribuita piuttosto uniformemente lungo l’asse x. Oppure sono MAR? A un’osservazione più attenta, sembra ci siano più valori mancanti in y per valori negativi di x rispetto a quelli positivi, quindi anche questo è possibile. Infine, l’ipotesi MNAR non può mai essere esclusa, perché per sapere se i dati sono MNAR o meno dovremmo per definizione osservare i valori non osservati.
Per fortuna, non dobbiamo brancolare del tutto nel buio. Gli strumenti di visualizzazione possono guidarci nel capire quali pattern ci sono nei dati mancanti. Ora analizzeremo una serie di grafici utili per rilevare questi pattern basandoci sul dataset biopics del pacchetto fivethirtyeight, che contiene alcune informazioni sui film biografici.
Prima di passare alla parte di plotting, i dati richiedono un po’ di pre-processing. Il blocco di codice seguente fa il necessario. La chiamata a select all’inizio della pipeline dplyr estrae le variabili di interesse e il successivo mutate raggruppa insieme razze affini per avere abbastanza osservazioni in ciascun gruppo. Poi, si modifica la classe di alcune variabili: ci servono fattori per le variabili stringa e interi per quella logica. Infine, le variabili vengono rinominate con nomi più brevi per rendere i grafici più leggibili.
data(biopics, package = "fivethirtyeight")

biopics <- biopics %>%
  select(country, year_release, box_office, number_of_subjects,
         type_of_subject, subject_race, person_of_color, subject_sex) %>%
  mutate(subject_race = ifelse(grepl("^Hispanic", subject_race), "Hispanic",
                               subject_race),
         subject_race = ifelse(grepl("^African", subject_race), "African",
                               subject_race),
         subject_race = ifelse(grepl("^Middle", subject_race), "Mid Eastern",
                               subject_race),
         subject_race = ifelse(subject_race %in% c("White", "Asian", "African",
                                                   "Hispanic", "Mid Eastern",
                                                   "Multi racial", NA),
                               subject_race, "other")) %>%
  mutate(country = as.factor(country),
         type_of_subject = as.factor(type_of_subject),
         subject_race = as.factor(subject_race),
         subject_sex = as.factor(subject_sex),
         person_of_color = as.integer(person_of_color)) %>%
      as.data.frame()

colnames(biopics) <- c("country", "year", "earnings", "sub_num",
                       "sub_type", "sub_race", "non_white", "sub_sex")
Otteniamo così un dataset composto da otto variabili:
country - paese o paesi di origine del film,year - anno di uscita,earnings - incassi lordi al botteghino USA,sub_num - numero di soggetti presenti nel film,sub_type - occupazione del soggetto o motivo di notorietà,sub_race - razza del soggetto,non_white - variabile dummy che indica una persona non bianca,sub_sex - sesso del soggetto.La prima, fondamentale domanda da porsi è: in quali variabili mancano osservazioni e quante? I grafici di aggregazione sono uno strumento utile per rispondere a queste domande. La one-liner qui sotto è tutto ciò che serve.
aggr(biopics, numbers = TRUE, prop = c(TRUE, FALSE))
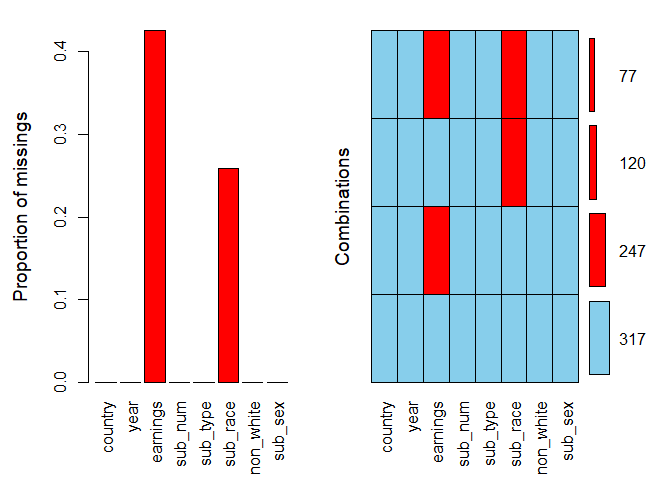
Specifichiamo l’argomento numbers = TRUE per mostrare i numeri sopra le barre. L’argomento prop è un booleano che indica se usare la proporzione dei valori mancanti e delle combinazioni piuttosto che il totale. Lo impostiamo a TRUE per il primo grafico e a FALSE per il secondo.
È evidente che i valori mancanti compaiono solo in due variabili: costituiscono oltre il 40% di earnings e circa il 25% di sub_race. Nel grafico delle combinazioni a destra, la griglia presenta tutte le combinazioni di valori mancanti (rosso) e osservati (blu) presenti nei dati. Ci sono 317 osservazioni complete e in 77 righe entrambe le variabili sono mancanti.
Guardare due grafici contemporaneamente può sembrare un po’ confuso, quindi riportiamo le stesse informazioni in un’unica visualizzazione con la seguente riga di codice.
aggr(biopics, combined = TRUE, numbers = TRUE)
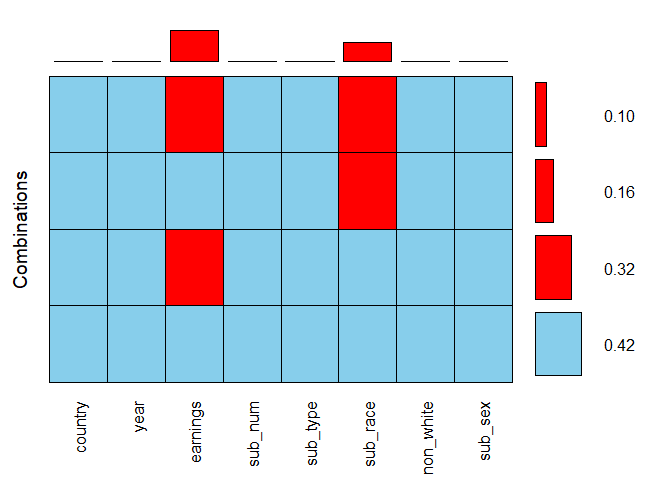
L’argomento combined consente di unire i due grafici in uno. Qui, le barre orizzontali a destra della griglia mostrano le frequenze delle combinazioni corrispondenti, mentre le barre verticali sopra la griglia presentano le proporzioni di valori mancanti in ciascuna variabile. Sommando i valori di tutte le possibili combinazioni per earnings, quindi 0,32 e 0,10, vediamo che la proporzione complessiva di valori mancanti in questa variabile, che avevamo stimato essere superiore al 40% in base al grafico a barre precedente, è in realtà del 42%.
Finora abbiamo ottenuto una panoramica ad alto livello dei dati mancanti. È ora di guardare più da vicino le interazioni tra variabili specifiche. Spinogram e spineplot permettono di studiare la percentuale di valori mancanti in una variabile per diversi valori dell’altra. Se quest’ultima è numerica, abbiamo a che fare con uno spinogram; quando è categoriale, questa visualizzazione è detta spineplot.
Entrambi possono essere generati con la funzione spineMiss(), che prende in input un data frame a due colonne. La prima variabile specificata è quella secondo cui i dati vengono suddivisi. È mappata sull’asse orizzontale del grafico. La seconda variabile è quella di cui ci interessa il pattern di dati mancanti. Per vederlo in pratica, creiamo uno spineplot. Specifichiamo per prima la variabile categoriale sub_race, seguita da earnings, che puoi leggere così: qual è la percentuale di valori mancanti in earnings per ciascuna categoria di sub_race?
spineMiss(biopics[, c("sub_race", "earnings")])
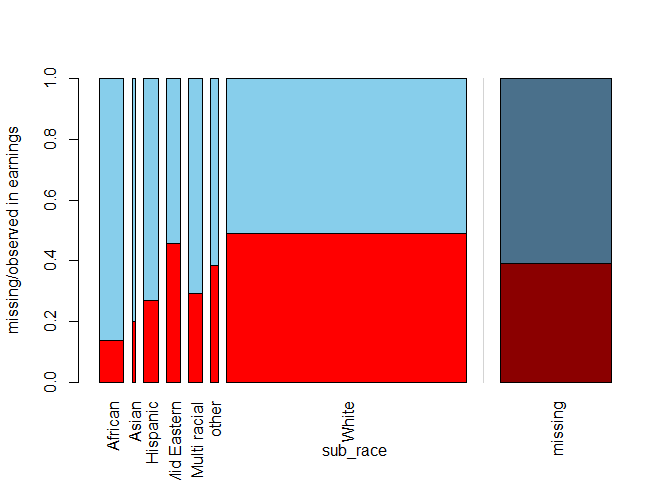
La larghezza relativa delle barre per specifiche categorie in sub_race rispecchia la frequenza di quella categoria nel dataset: ad esempio, in una vasta maggioranza di film il soggetto principale è bianco. All’interno di ciascuna barra è mostrata la proporzione di mancanti in earnings, mentre la barra ombreggiata a destra presenta questa proporzione per l’intero dataset. Sembra che quando il soggetto principale è africano, è più probabile avere informazioni complete sugli incassi.
Invertendo l’ordine delle variabili come nella riga di codice sotto, possiamo produrre uno spinogram che risponde alla seguente domanda, ribaltata: qual è la percentuale di dati mancanti in sub_race per diversi valori di earnings?
spineMiss(biopics[, c("earnings", "sub_race")])
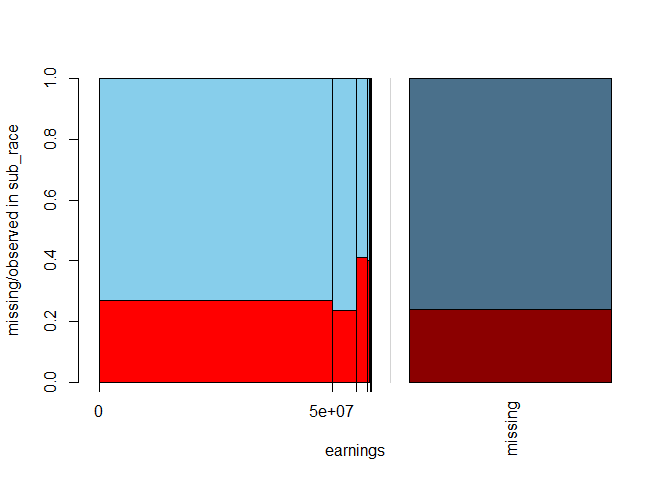
Poiché earnings è una variabile numerica, i suoi valori sono suddivisi in bin, le cui larghezze corrispondono alla distribuzione della variabile stessa. Lo spinogram mostra che earnings sono fortemente asimmetrici a sinistra: solo pochi film hanno realizzato i profitti più alti. Curiosamente, per quei blockbuster è più probabile che manchi la razza del soggetto, come riflesso dalla barra rossa più alta per i valori più elevati di earnings.
Gli spinogram e spineplot discussi sopra permettono di studiare le interazioni tra due variabili. Quest’idea è generalizzata a più variabili sotto forma di mosaic plot. Questo grafico è una raccolta di tasselli, in cui ciascun tassello corrisponde a una specifica combinazione di categorie (per variabili categoriali) o bin (per variabili numeriche) di due o più variabili. All’interno di ciascun tassello è mostrata la percentuale di punti dati mancanti in un’altra variabile. In linea di principio, i mosaic plot possono essere creati per un numero qualsiasi di variabili, ma diventano caotici se se ne usano troppe. Inoltre, sono più leggibili se le variabili di suddivisione sono fattori e con non troppi livelli.
Diamo un’occhiata alla proporzione di mancanti in earnings suddivisa per sub_sex e US_movie. Quest’ultima, creata nel blocco di codice qui sotto, è un booleano che indica se gli Stati Uniti sono stati coinvolti nella produzione del film. Forniamo il data frame a tre variabili come primo argomento di mosaicMiss(). L’argomento plotvars impostato a un vettore con elementi 1 e 2 significa che vogliamo suddividere i dati in base alle prime due colonne di questo data frame. Impostare highlight a 3 significa che vogliamo che all’interno dei tasselli sia mostrata la proporzione di mancanti della variabile nella terza colonna.
biopics <- biopics %>%
    mutate(US_movie = ifelse(grepl("US", country), TRUE, FALSE))
mosaicMiss(biopics[, c("sub_sex", "US_movie", "earnings")], highlight = 3,
           plotvars = 1:2, miss.labels = FALSE)
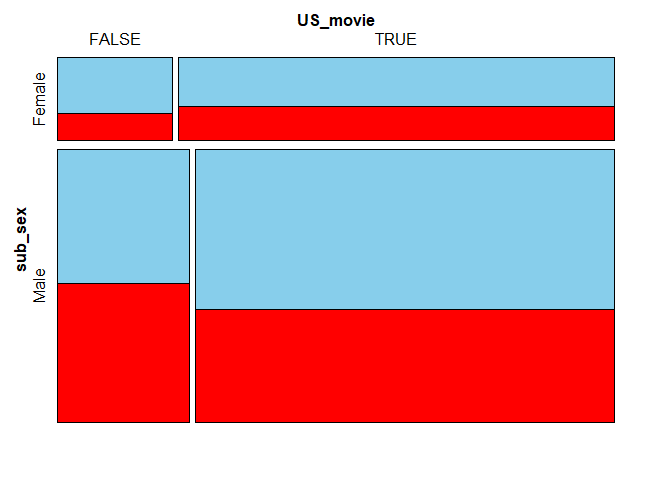
Ancora una volta, le dimensioni dei tasselli corrispondono alle frequenze di occorrenza delle combinazioni nel dataset. Ad esempio, il tassello in basso a destra, il più grande, indica che la maggior parte dei film ha come soggetto un uomo ed è stata prodotta, almeno in parte, negli Stati Uniti.
Per quanto riguarda i film con protagonista un uomo, le informazioni sugli incassi sono più spesso mancanti per i film non americani. D’altra parte, se il personaggio principale è una donna, i film statunitensi hanno leggermente più valori mancanti negli incassi. Tuttavia, queste differenze sembrano troppo piccole per essere considerate significative.
Un altro tipo di visualizzazione è il parallel boxplot. L’idea è suddividere il dataset in due sottoinsiemi: uno con soli valori osservati di una variabile incompleta e l’altro con soli valori mancanti della stessa. Per entrambi i sottoinsiemi si produce un boxplot di una variabile numerica scelta. Questo ti permette di verificare se la distribuzione della variabile scelta è influenzata dai valori mancanti della variabile di suddivisione.
Per produrre un parallel boxplot, possiamo usare la funzione pbox(). Passiamo un solo argomento: un data frame a due colonne. I boxplot verranno disegnati per la variabile nella prima colonna, mentre quella nella seconda colonna sarà usata per la suddivisione. Nell’esempio sotto, prendiamo il logaritmo di earnings perché sono fortemente asimmetrici e senza questa trasformazione il boxplot somiglierebbe a una singola linea.
biopics <- biopics %>%
  mutate(log_earnings = log(earnings))
pbox(biopics[, c("log_earnings", "sub_race")])
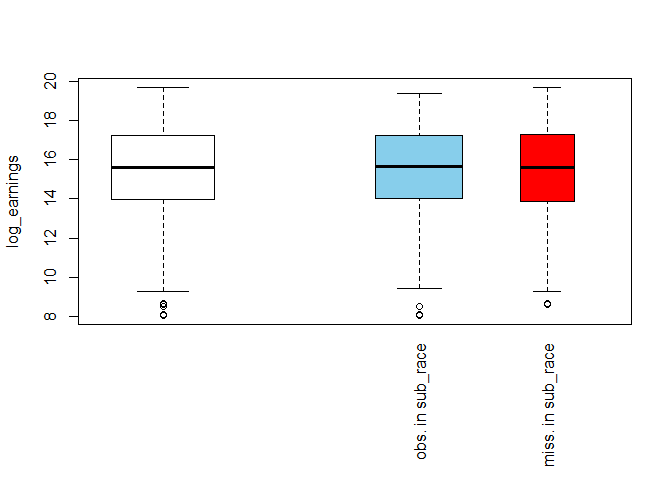
La scatola bianca a sinistra mostra la distribuzione complessiva di log_earnings, mentre quella blu e quella rossa mostrano la sua distribuzione per i sottoinsiemi di valori osservati e mancanti in sub_race, rispettivamente. La larghezza relativa delle scatole riflette la dimensione dei sottoinsiemi su cui si basano: la scatola blu più larga significa che in sub_race ci sono più valori osservati che mancanti. A parte questo, le due scatole sono simili tra loro e anche alla scatola bianca complessiva. Ciò suggerisce che la mancanza di informazioni sulla razza non influisce sulla distribuzione degli incassi.
Abbiamo guardato singole variabili e le loro interazioni. Passiamo ora ad analizzare tutte le variabili del dataset contemporaneamente. La visualizzazione che lo consente è il parallel coordinate plot. In questo grafico, ogni variabile è trasformata sulla stessa scala e rappresentata da un asse parallelo. Nel caso di variabili categoriali, la scala dell’asse è suddivisa in una serie di punti equidistanti, uno per ciascuna categoria. I valori mancanti sono posizionati sopra gli assi verticali, fuori dall’area del grafico. Ogni linea rappresenta un’osservazione nei dati, e il colore della linea indica i dati mancanti nella variabile selezionata.
Possiamo produrre il parallel coordinate plot con la funzione parcoordMiss(). Per impostazione predefinita, usa tutte le variabili presenti nel data frame fornito come primo argomento. Impostando highlight su earnings si evidenziano con un colore diverso le linee che rappresentano osservazioni con un valore mancante in earnings. Impostare l’alpha-blending a 0,6 rende le linee leggermente trasparenti, aumentando la leggibilità del grafico.
# Rimuovere le variabili create per i grafici precedenti
biopics <- biopics %>%
  select(- US_movie, - log_earnings)

parcoordMiss(biopics, highlight = 'earnings', alpha = 0.6)
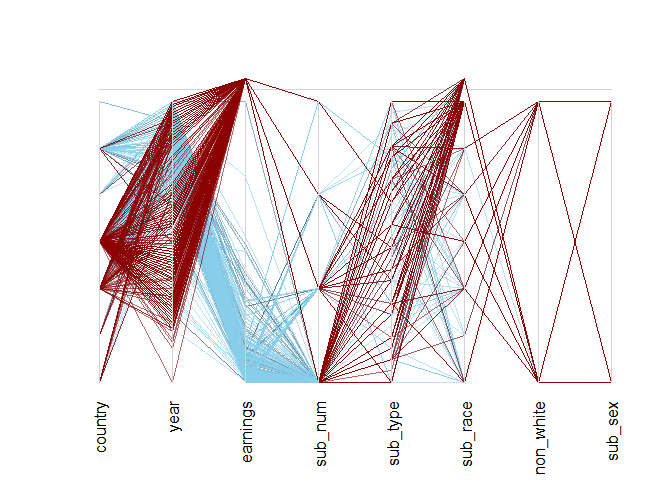
Nel grafico sopra, le linee rosso scuro indicano le osservazioni con un valore mancante in earnings. Queste osservazioni evidenziate sembrano comportarsi diversamente rispetto al resto dei dati. In particolare, solo poche di esse corrispondono al secondo livello più alto di country, che altrimenti comprende molte osservazioni! Si tratta di film US/UK (per verificarlo, esegui levels(biopics$country) e cerca il penultimo valore!).
Inoltre, una rapida ispezione dell’asse year rivela un tratto circa ai due terzi della sua altezza con meno linee rosso scuro che lo attraversano. Sembra ci sia stato un periodo, non troppo tempo fa, in cui i dati sugli incassi erano più completi. Questo suggerisce che sia country che year potrebbero aiutare a spiegare la distribuzione dei valori mancanti in earnings!
L’ultimo strumento di visualizzazione che esamineremo è il matrix plot. Visualizza tutte le celle della matrice dei dati come rettangoli. I dati osservati sono mostrati con una scala di grigi continua (più scuro significa valore più alto), mentre i valori mancanti sono evidenziati in rosso. È buona pratica ordinare i dati in base a una delle variabili incomplete: rende il grafico più facile da interpretare. Il blocco di codice seguente svolge il compito, ordinando per earnings.
matrixplot(biopics, sortby = c('earnings'))
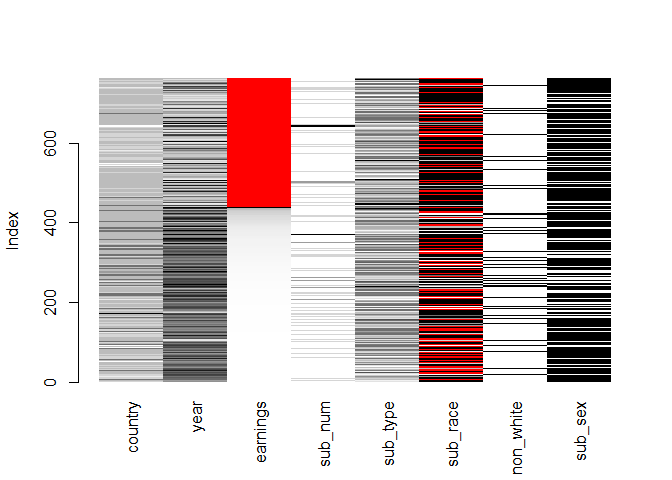
Il grafico conferma alcune delle evidenze precedenti: le osservazioni con valori mancanti in earnings tendono a risalire a molto tempo fa (valori bassi di year) e hanno anche valori bassi in country - ciò è indicato dal colore più chiaro di queste due variabili nelle righe in cui gli incassi sono in rosso. Inoltre, sembra che ci siano meno film con soggetto non bianco quando earnings sono mancanti.
In sintesi, sembra che i dati mancanti nel dataset biopics non siano MCAR. Le posizioni dei valori mancanti in earnings e sub_race aiutano a spiegarsi a vicenda, come mostrato da spineplot e spinogram. Inoltre, il matrix plot e il parallel coordinate plot suggeriscono che country, year e non_white potrebbero anch’essi aiutare a spiegare la distribuzione dei valori mancanti in earnings. Pertanto, non è una buona idea eliminare le osservazioni incomplete, perché ciò introdurrebbe con tutta probabilità un bias nell’inferenza.
Considerazioni finali
Hai fatto molta strada! Ora sai cosa sono i meccanismi dei dati mancanti e in cosa differiscono e, soprattutto, come trarre inferenze su di essi con una varietà di strumenti di visualizzazione. Ottimo lavoro! Ora sei pienamente attrezzato per analizzare i tuoi dataset incompleti!
Se vuoi approfondire R, segui il corso di DataCamp Data Visualization with ggplot2 (Parte 1) e dai un’occhiata al nostro R Formula Tutorial.
Scopri di più su R e Data Visualization
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



