Cursus
Introductie tot datavisualisatie met ggplot2
4 uur
189.9K
Ontbrekende data vormen een probleem in het dagelijkse werk van elke data scientist. Moeten we ze imputeren? Zo ja, welke methode past? Of kun je observaties met missende datapunten gewoon weglaten? Om die vragen te beantwoorden, moet je weten welk mechanisme achter de ontbrekende data zit. Dat via statistische toetsen vaststellen is complex en leidt soms slechts tot vage uitspraken. Visualisatietools zijn daarentegen eenvoudig te gebruiken en helpen niet alleen om mechanismen achter ontbrekende data te detecteren, maar geven ook inzicht in andere aspecten van datakwaliteit. In deze tutorial laten we een set plotmethoden uit het VIM-pakket zien om te laten zien hoe je grip krijgt op patronen in de manier waarop data ontbreken.
Er kunnen meerdere redenen zijn waarom een dataset incompleet is. Het is cruciaal te onderzoeken wat mogelijke oorzaken van ontbrekende data zijn, omdat dit invloed heeft op hoe je het probleem aanpakt. Als het bijvoorbeeld gaat om non-respons in werkgerelateerde enquêtes, kun je verwachten dat de allerrijksten en allerarmsten hun inkomen niet invullen, wat betekent dat de ontbrekende datapunten niet gelijkmatig over de dataset zijn verdeeld. In dat geval leiden het simpelweg verwijderen van incomplete observaties vóór de analyse tot bevooroordeelde resultaten. Aan de andere kant: als data ontbreken door een storing in het verzamelapparaat, kan het zijn dat de locaties van de missende punten in de dataset puur willekeurig zijn.
Er zijn drie verschillende patronen waarvolgens data kunnen ontbreken. Die worden doorgaans aangeduid als mechanismen van ontbrekende data.
Missing completely at random (MCAR)
Bij MCAR is er geen systematisch patroon in waar de missende datapunten zich in de dataset bevinden: ze treden volledig willekeurig op. Formeel betekent dit dat de kans dat een observatie ontbreekt, niet afhangt van de waarden van andere variabelen en ook niet van de eigen waarden. In dit geval introduceert het verwijderen van incomplete observaties geen bias in de resultaten van de vervolganalyse.
Voorbeeld: Temperatuur wordt continu gemeten door een sensor die de data verzamelt en via internet naar een database stuurt. Om onbekende redenen valt de internetverbinding soms weg.
Missing at random (MAR)
Bij MAR is de kans dat een specifieke observatie ontbreekt nog steeds onafhankelijk van de eigen waarden, maar wél afhankelijk van de waarden van andere variabelen. In dit geval maakt het verwijderen van incomplete observaties de steekproef minder representatief.
Voorbeeld: Een deel van de nachtelijke uren ontbreekt door onderhoudswerk aan de sensor, dat altijd ’s nachts plaatsvindt.
Missing not at random (MNAR)
Bij MNAR hangt de kans dat een observatie ontbreekt af van de eigen, niet-geobserveerde waarden. Ook hier leidt het verwijderen van incomplete data tot een bevooroordeelde analyse.
Voorbeeld: De sensor bevriest bij -20 graden Celsius en meet geen temperatuur onder die waarde.
In de praktijk is het lastig vast te stellen welk van de drie mechanismen in een specifiek geval geldt. Om dat te illustreren, plotten we wat MNAR-data. We gebruiken de pakketten ggplot2 en gridExtra, die we eerst moeten laden. We laden ook nog twee andere pakketten voor later: VIM voor visuele analyse van ontbrekende data en dplyr voor wat pre-processing. Vergeet niet om ze eerst met install.packages() te installeren als ze nog niet in je workspace staan.
library("VIM")
library("dplyr")
library("ggplot2")
library("gridExtra")
Laten we een dataset maken met twee ongecorreleerde, normaal verdeelde variabelen, x en y, met wat ontbrekende waarden in y in de rechterstaart van de verdeling, dus bij de hoogste waarden. Let op dat we de werkelijke waarden ook bewaren en ze in een aparte variabele als missend markeren.
set.seed(2)
mnar_data <- data.frame(x = rnorm(100), y = rnorm(100)) %>%
    mutate(y_miss = ifelse(y > 1, y, NA),
           y = ifelse(is.na(y_miss), y, NA),
           x_miss = ifelse(is.na(y), x, NA))
We tekenen nu twee scatterplots van x tegen y: één inclusief de punten waarvan we doen alsof de y-waarden ontbreken en één met alleen geobserveerde data.
grid.arrange(
  # Plot highlighting missing data points
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_point(aes(x, y_miss), col = "red", size = 4, alpha = 0.6) +
    geom_hline(aes(yintercept = y_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("Where the data points are missing"),
  # What data scientist can see
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_vline(aes(xintercept = x_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("What the data scientist can see"),
  # Arrange the two plots side-by-side
  ncol = 2
)
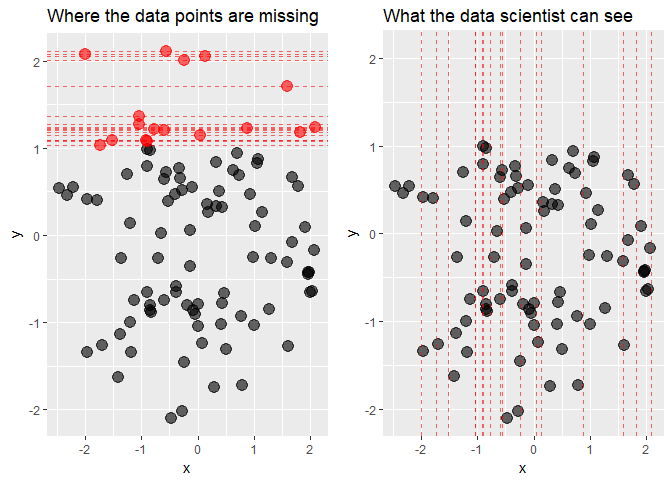
In de eerste plot is duidelijk te zien dat de data echt MNAR zijn, maar de data scientist ziet alleen de x-coördinaten van de ontbrekende punten. Welke conclusie kun je uit de tweede plot trekken? Zijn de data MCAR? Mogelijk wel, de locaties van de missende waarden lijken vrij gelijkmatig over de x-as verspreid. Of zijn ze MAR? Bij nadere inspectie lijken er meer ontbrekende y-waarden te zijn voor negatieve x-waarden dan voor positieve, dus dat kan ook. Tot slot kun je MNAR nooit uitsluiten, want om te weten of data MNAR zijn, moet je per definitie de niet-geobserveerde waarden kennen.
Gelukkig staan we hier niet met lege handen. Datavisualisatie kan aanwijzingen geven over de patronen in de ontbrekende data. We bekijken nu een aantal nuttige plots om die patronen op te sporen, gebaseerd op de biopics-dataset uit het fivethirtyeight-pakket, met informatie over biografische films.
Voor we gaan plotten, hebben de data wat pre-processing nodig. De code hieronder doet dat. De select-aanroep aan het begin van de dplyr-pijplijn selecteert de relevante variabelen en de daaropvolgende mutate voegt gerelateerde rassen samen om genoeg observaties per groep te hebben. Daarna passen we de klasse van sommige variabelen aan: we willen factoren voor tekstvariabelen en integers voor de logische variabele. Tot slot hernoemen we de variabelen naar kortere namen voor de leesbaarheid van de plots.
data(biopics, package = "fivethirtyeight")

biopics <- biopics %>%
  select(country, year_release, box_office, number_of_subjects,
         type_of_subject, subject_race, person_of_color, subject_sex) %>%
  mutate(subject_race = ifelse(grepl("^Hispanic", subject_race), "Hispanic",
                               subject_race),
         subject_race = ifelse(grepl("^African", subject_race), "African",
                               subject_race),
         subject_race = ifelse(grepl("^Middle", subject_race), "Mid Eastern",
                               subject_race),
         subject_race = ifelse(subject_race %in% c("White", "Asian", "African",
                                                   "Hispanic", "Mid Eastern",
                                                   "Multi racial", NA),
                               subject_race, "other")) %>%
  mutate(country = as.factor(country),
         type_of_subject = as.factor(type_of_subject),
         subject_race = as.factor(subject_race),
         subject_sex = as.factor(subject_sex),
         person_of_color = as.integer(person_of_color)) %>%
      as.data.frame()

colnames(biopics) <- c("country", "year", "earnings", "sub_num",
                       "sub_type", "sub_race", "non_white", "sub_sex")
We houden een dataset over met acht variabelen:
country - land of landen van herkomst van de film,year - jaar van release,earnings - bruto-inkomsten aan de Amerikaanse box office,sub_num - het aantal hoofdpersonen in de film,sub_type - het beroep of de reden van bekendheid van de hoofdpersoon,sub_race - het ras van de hoofdpersoon,non_white - dummyvariabele die aangeeft of de persoon van kleur is,sub_sex - geslacht van de hoofdpersoon.De eerste, fundamentele vraag is: in welke variabelen ontbreken observaties, en hoeveel? Aggregatieplots zijn een handig hulpmiddel om dit te beantwoorden. De onderstaande one-liner is alles wat je nodig hebt.
aggr(biopics, numbers = TRUE, prop = c(TRUE, FALSE))
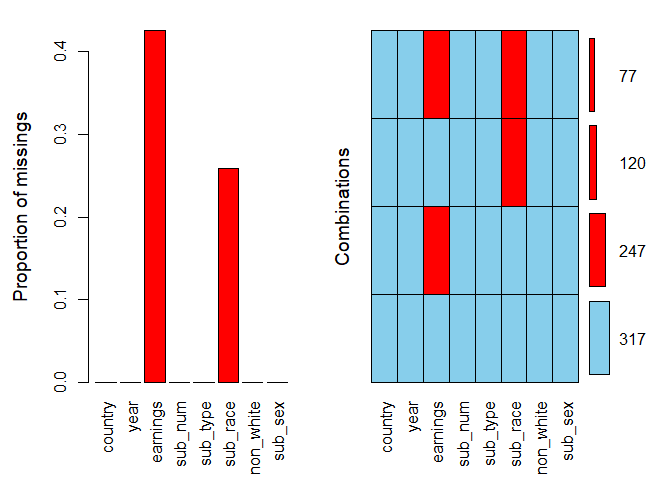
Met het argument numbers = TRUE tonen we de aantallen boven de balken. Het argument prop is logisch en bepaalt of de proportie van missende waarden en combinaties wordt gebruikt in plaats van de totale aantallen. We zetten dit op TRUE voor de eerste plot en FALSE voor de tweede.
Het is duidelijk dat er alleen in twee variabelen waarden ontbreken: ze vormen meer dan 40% van earnings en circa 25% van sub_race. In de combinatiesplot rechts presenteert het raster alle combinaties van missend (rood) en geobserveerd (blauw) die in de data voorkomen. Er zijn 317 complete observaties en in 77 rijen ontbreken beide variabelen.
Twee plots tegelijk bekijken kan wat verwarrend zijn, dus laten we dezelfde informatie in één visualisatie gieten met de volgende code.
aggr(biopics, combined = TRUE, numbers = TRUE)
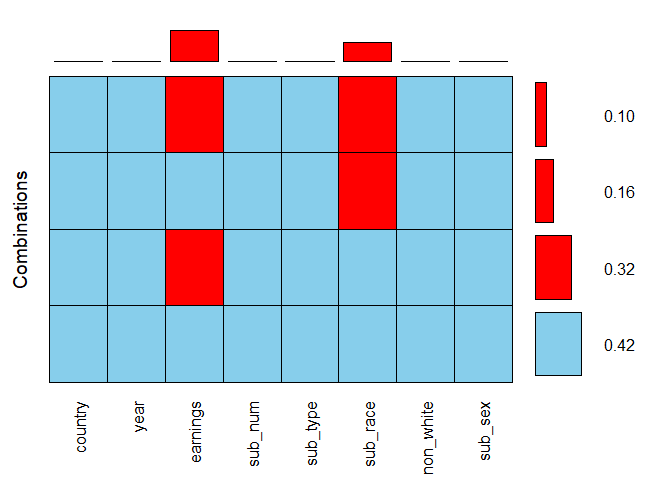
Het argument combined combineert de twee plots tot één. De horizontale balken rechts van het raster tonen de frequenties van de bijbehorende combinaties, terwijl de verticale balken erboven de proporties missende waarden per variabele weergeven. Door de waarden van alle mogelijke combinaties voor earnings op te tellen, dus 0,32 en 0,10, zien we dat de totale proportie missende waarden in deze variabele, die we op basis van de vorige staafdiagram schatten op meer dan 40%, in feite 42% is.
Tot nu toe hebben we een overzicht op hoog niveau van de ontbrekende data. Tijd om dichter naar de interacties tussen specifieke variabelen te kijken. Een spinogram en spineplot laten het percentage missende waarden in de ene variabele zien voor verschillende waarden van de andere. Als die laatste numeriek is, krijg je een spinogram; bij categorisch heet de visualisatie een spineplot.
Beide kun je genereren met de functie spineMiss(), die een dataframe met twee kolommen als input neemt. De eerst gespecificeerde variabele is die waarop de data worden gesplitst. Die wordt op de horizontale as weergegeven. De tweede variabele is degene waarvan het missingspatroon onze interesse heeft. Laten we in de praktijk een spineplot maken. We geven eerst de categorische variabele sub_race op, gevolgd door earnings, wat je kunt lezen als: wat is het percentage missende waarden in earnings voor elke categorie van sub_race?
spineMiss(biopics[, c("sub_race", "earnings")])
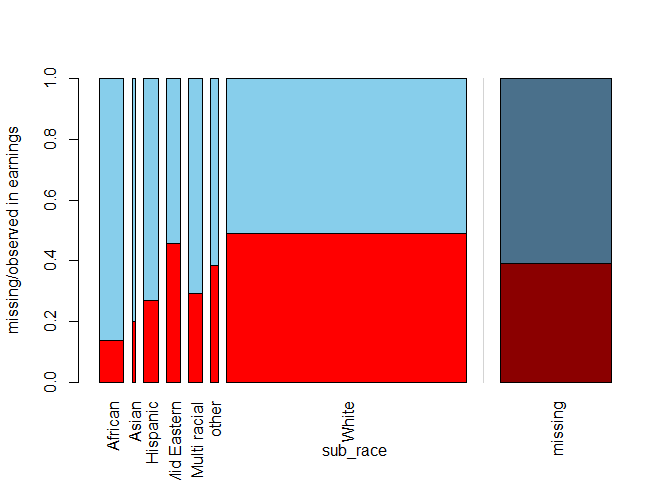
De relatieve breedte van de balken voor specifieke categorieën in sub_race weerspiegelt de frequentie van die categorie in de dataset: in een overgrote meerderheid van de films is de hoofdpersoon bijvoorbeeld wit. Binnen elke balk wordt de missende proportie van earnings weergegeven, terwijl de gearceerde balk rechts die proportie voor de hele dataset toont. Het lijkt erop dat wanneer de hoofdpersoon Afrikaans is, we het vaakst volledige informatie over inkomsten hebben.
Door de volgorde van de variabelen om te draaien zoals in de code hieronder, maken we een spinogram dat de omgekeerde vraag beantwoordt: wat is het percentage missende data in sub_race voor verschillende waarden van earnings?
spineMiss(biopics[, c("earnings", "sub_race")])
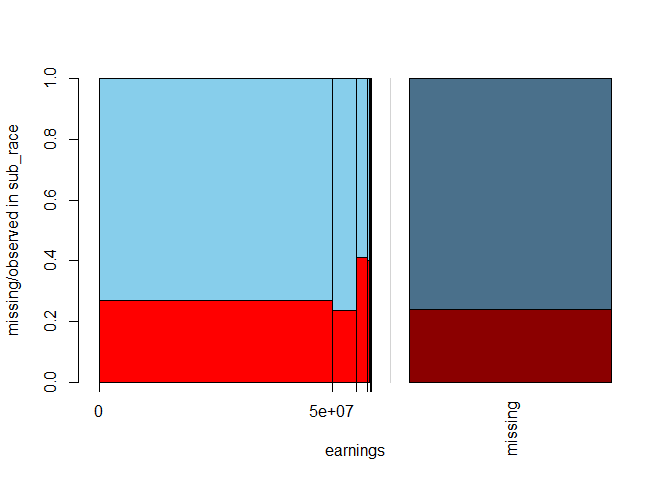
Omdat earnings numeriek is, worden de waarden in bins verdeeld, waarbij de breedtes van de bins overeenkomen met de verdeling van de variabele zelf. Het spinogram laat zien dat earnings sterk negatief scheef verdeeld is: slechts een paar films maakten de hoogste winst. Opvallend genoeg missen we bij die blockbusters het vaakst het ras van de hoofdpersoon, wat te zien is aan de hoogste rode balk voor de grootste waarden van earnings.
Het spinogram en de spineplot hierboven laten interacties tussen twee variabelen zien. Dit idee wordt gegeneraliseerd naar meer variabelen in de vorm van een mozaïekplot. Deze plot is een verzameling tegels, waarbij elke tegel overeenkomt met een specifieke combinatie van categorieën (voor categorische variabelen) of bins (voor numerieke variabelen) van twee of meer variabelen. Binnen elke tegel staat het percentage ontbrekende datapunten in een andere variabele. In principe kun je mozaïekplots maken voor elk aantal variabelen, maar ze raken snel vol als je er te veel kiest. Ze zijn ook beter leesbaar als de split-variabelen factoren zijn met niet al te veel niveaus.
Laten we kijken naar de missende proportie in earnings, gesplitst naar sub_sex en US_movie. De laatste, aangemaakt in de code hieronder, is een logische variabele die aangeeft of de Verenigde Staten bij de productie van de film betrokken waren. We geven het dataframe met drie variabelen als eerste argument aan mosaicMiss(). Het argument plotvars met de vector 1 en 2 betekent dat we de data willen splitsen volgens de eerste twee kolommen van dit dataframe. Met highlight op 3 willen we dat de missende proportie van de variabele in de derde kolom in de tegels wordt getoond.
biopics <- biopics %>%
    mutate(US_movie = ifelse(grepl("US", country), TRUE, FALSE))
mosaicMiss(biopics[, c("sub_sex", "US_movie", "earnings")], highlight = 3,
           plotvars = 1:2, miss.labels = FALSE)
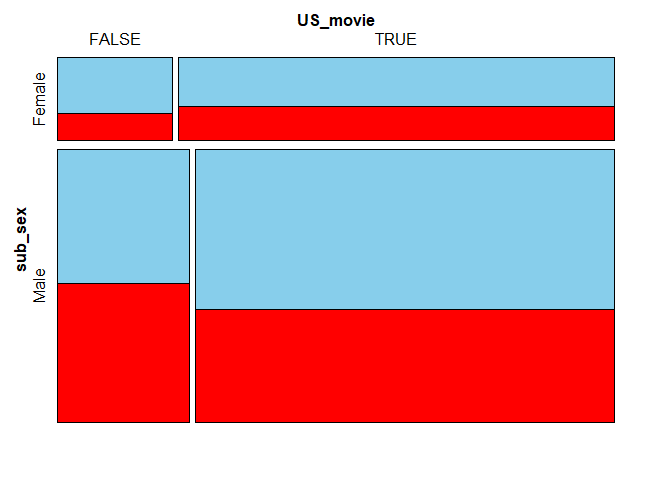
Ook hier komen de groottes van de tegels overeen met de frequenties van de betreffende combinaties in de dataset. De grootste tegel rechtsonder betekent bijvoorbeeld dat de meeste films een man als hoofdpersoon hebben en (deels) in de VS zijn geproduceerd.
Voor films met een mannelijke hoofdpersoon ontbreekt de informatie over inkomsten eerder bij niet-Amerikaanse films. Als de hoofdpersoon vrouw is, hebben de Amerikaanse films juist iets meer missende waarden in inkomsten. Deze verschillen lijken echter te klein om significant te zijn.
Een ander visualisatietype is een parallelle boxplot. Het idee is om de dataset op te splitsen in twee subsets: één met alleen geobserveerde waarden van een incomplete variabele en één met alleen de missende waarden daarvan. Voor beide subsets maak je een boxplot van een gekozen numerieke variabele. Zo kun je controleren of de verdeling van de gekozen variabele beïnvloed wordt door de missende waarden van de splitsvariabele.
Voor een parallelle boxplot gebruiken we de functie pbox(). We geven maar één argument door: een dataframe met twee kolommen. De boxplots worden getekend voor de variabele in de eerste kolom, terwijl de tweede kolom wordt gebruikt voor de splitsing. In het onderstaande voorbeeld nemen we de logaritme van earnings omdat die sterk scheef verdeeld zijn; zonder die transformatie zou de boxplot op een enkele lijn lijken.
biopics <- biopics %>%
  mutate(log_earnings = log(earnings))
pbox(biopics[, c("log_earnings", "sub_race")])
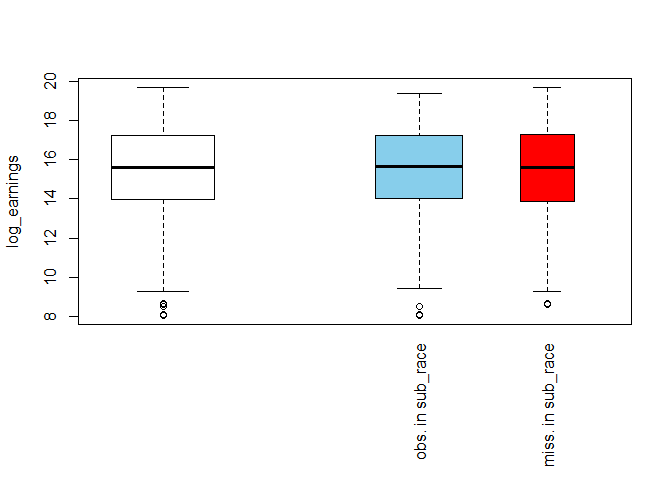
De witte box links toont de totale verdeling van log_earnings, terwijl de blauwe en rode box de verdeling tonen voor de subsets met respectievelijk geobserveerde en missende waarden in sub_race. De relatieve breedte van de boxen weerspiegelt de grootte van de subsets: de bredere blauwe box betekent dat er meer geobserveerde dan missende waarden in sub_race zijn. Verder lijken de twee boxen sterk op elkaar en ook op de totale witte box. Dit suggereert dat missende rasinformatie geen invloed heeft op de verdeling van inkomsten.
We hebben naar afzonderlijke variabelen en hun interacties gekeken. Laten we nu alle variabelen in de dataset in één keer analyseren. De visualisatie daarvoor is de parallelle coördinatenplot. In deze plot wordt elke variabele op dezelfde schaal gezet en weergegeven door een parallelle as. Bij categorische variabelen wordt de schaal van de as opgedeeld in een set equidistante punten, één per categorie. Missende waarden worden boven de verticale assen buiten het plotgebied geplaatst. Elke lijn in de plot komt overeen met één observatie, waarbij de kleur aangeeft dat er een missende waarde zit in de geselecteerde variabele.
We maken de parallelle coördinatenplot met de functie parcoordMiss(). Standaard gebruikt die alle variabelen in het dataframe dat als eerste argument is doorgegeven. Met highlight op earnings worden de lijnen met een missende waarde in earnings anders gekleurd. Met alpha-blending op 0,6 maken we de lijnen iets transparant, wat de leesbaarheid vergroot.
# Remove variables created for the previous plots
biopics <- biopics %>%
  select(- US_movie, - log_earnings)

parcoordMiss(biopics, highlight = 'earnings', alpha = 0.6)
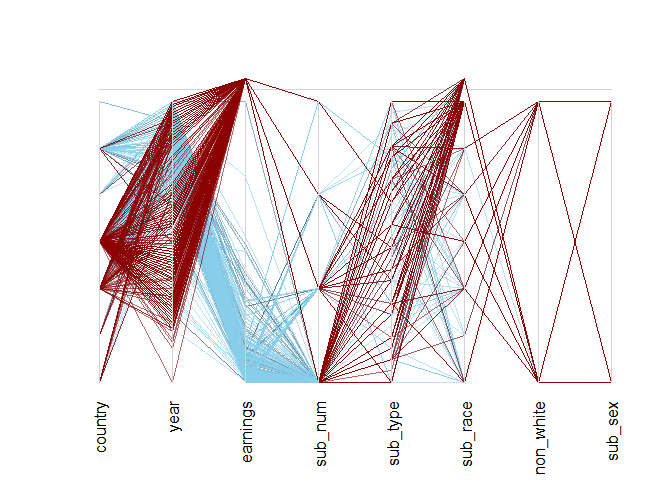
In de plot hierboven geven donkerrode lijnen observaties met een missende waarde in earnings aan. Die uitgelichte observaties lijken zich anders te gedragen dan de rest. Met name corresponderen er maar weinig met het op één na hoogste niveau van country, terwijl dat anders juist veel observaties omvat! Het blijkt te gaan om US/UK-films (om dit te zien, voer levels(biopics$country) uit en kijk naar de voorlaatste waarde!).
Bovendien laat een snelle blik op de as year een strook zien, ergens op twee derde van de hoogte, waar minder donkerrode lijnen doorheen lopen. Er lijkt een periode te zijn geweest, niet zo lang geleden, waarin inkomsten data completer waren. Dit suggereert dat zowel country als year kunnen helpen de verdeling van missende waarden in inkomsten te verklaren!
De laatste visualisatietool die we bekijken is een matrixplot. Die visualiseert alle cellen van de datamatrix als rechthoeken. Geobserveerde data worden getoond in een doorlopende grijs-zwartkleurenschaal (hoe donkerder, hoe hoger de waarde), terwijl missende waarden in rood worden gemarkeerd. Het is aan te raden de data te sorteren op een van de incomplete variabelen – dat maakt de plot makkelijker te interpreteren. De code hieronder doet dat, gesorteerd op earnings.
matrixplot(biopics, sortby = c('earnings'))
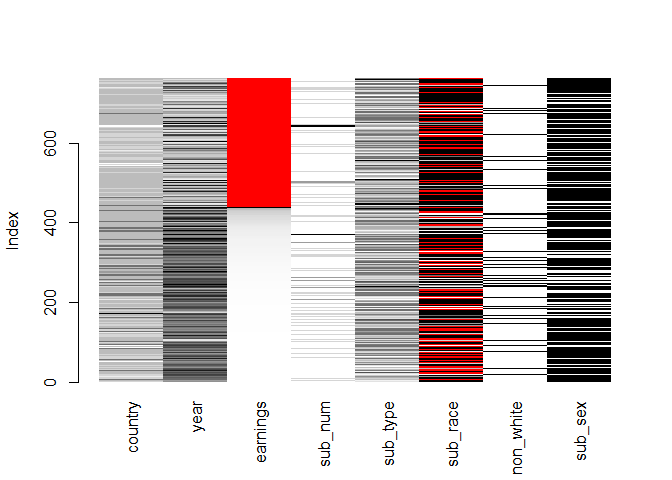
De plot bevestigt enkele eerdere bevindingen: observaties met missende waarden in earnings komen vaker van lang geleden (lage waarde van year) en scoren ook laag op country – dit blijkt uit de lichtere kleur van deze twee variabelen in de rijen waar inkomsten rood zijn. Ook lijkt het erop dat er minder films met een niet-witte hoofdpersoon zijn wanneer earnings ontbreekt.
Samengevat lijken de ontbrekende data in de biopics-dataset niet MCAR. De locaties van missende datapunten in earnings en sub_race helpen elkaar verklaren, zoals blijkt uit de spineplot en het spinogram. Daarnaast suggereren de matrixplot en de parallelle coördinatenplot dat country, year en non_white ook kunnen helpen de verdeling van missende waarden in earnings te verklaren. Het is dus geen goed idee om de incomplete observaties te droppen, want dat zou waarschijnlijk bias in onze inferentie introduceren.
Tot slot
Goed bezig! Je weet nu wat mechanismen van ontbrekende data zijn en hoe ze verschillen, en belangrijker: hoe je er met diverse visualisatietools uitspraken over kunt doen. Mooi werk! Je bent nu klaar om je eigen incomplete datasets te analyseren!
Wil je meer leren over R? Volg dan DataCamps cursus Data Visualization with ggplot2 (Part 1) en bekijk onze R Formula Tutorial.
Leer meer over R en datavisualisatie
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

