Curso
Introducción a la visualización de datos con ggplot2
4 h
188.2K
Los datos ausentes son un problema habitual en el trabajo diario de cualquier científico de datos. ¿Deberíamos imputarlos? Si es así, ¿qué método conviene? ¿O podemos simplemente eliminar las observaciones con valores perdidos? Para responder a estas preguntas, hay que entender el mecanismo que hay detrás de los datos ausentes. Detectarlo con pruebas estadísticas es complejo y a veces solo conduce a conclusiones poco claras. En cambio, las herramientas de visualización son fáciles de usar y ayudan no solo a detectar los mecanismos de ausencia, sino también a obtener información sobre otros aspectos de la calidad de los datos. En este tutorial, se presentan varios métodos de representación disponibles en el paquete VIM para mostrar cómo pueden ayudarte a comprender bien los patrones en la forma en que faltan los datos.
Puede haber muchos motivos por los que un conjunto de datos esté incompleto. Es clave investigar las posibles causas de los datos ausentes, porque de ello dependerá cómo abordemos el problema. Por ejemplo, si nos preocupa la no respuesta en encuestas sobre empleo, podríamos esperar que las personas con ingresos muy altos y muy bajos no indiquen sus ganancias en el cuestionario, lo que implica que los valores perdidos no están distribuidos uniformemente por el dataset. Si este fuera el caso, eliminar sin más las observaciones incompletas antes de realizar el análisis daría lugar a resultados sesgados. En cambio, si los datos faltan por un fallo del dispositivo de recogida, es posible que la ubicación de los valores perdidos en el conjunto de datos sea puramente aleatoria.
Existen tres patrones diferenciados según los cuales pueden faltar datos. Suele hablarse de mecanismos de datos ausentes.
Missing completely at random (MCAR)
Bajo MCAR no hay un patrón sistemático en la ubicación de los valores perdidos: se producen totalmente al azar. Formalmente, la probabilidad de que una observación esté ausente no depende ni de los valores de otras variables ni de sus propios valores. En este caso, eliminar observaciones incompletas no introduce sesgo en los resultados del análisis posterior.
Ejemplo: Un sensor mide continuamente la temperatura, recopila los datos y los envía por Internet a una base de datos. Por motivos desconocidos, a veces se corta la conexión a Internet.
Missing at random (MAR)
Bajo MAR, la probabilidad de que falte una observación concreta sigue sin depender de sus propios valores, pero sí depende de los valores de otras variables. En este caso, eliminar observaciones incompletas hace que la muestra sea menos representativa.
Ejemplo: Faltan algunos datos de horas nocturnas por labores de mantenimiento del sensor, que siempre se realizan de noche.
Missing not at random (MNAR)
Bajo MNAR, la probabilidad de que falte una observación depende de sus propios valores no observados. Aquí, de nuevo, eliminar datos incompletos conduce a un análisis sesgado.
Ejemplo: El sensor se congela a -20 grados Celsius y no mide temperaturas por debajo de ese valor.
En la práctica, es difícil determinar cuál de los tres mecanismos aplica en un caso concreto. Para verlo, vamos a representar datos MNAR. Usaremos los paquetes ggplot2 y gridExtra, que debemos cargar antes. También cargaremos otros dos para usarlos más adelante: VIM para el análisis visual de datos ausentes y dplyr para algo de preprocesamiento. Recuerda ejecutar install.packages() si aún no los tienes en tu espacio de trabajo.
library("VIM")
library("dplyr")
library("ggplot2")
library("gridExtra")
Vamos a crear un conjunto de datos con dos variables no correlacionadas y distribuidas normalmente, x e y, con algunos valores perdidos en y en la cola derecha de su distribución, es decir, entre sus valores más altos. Ten en cuenta que también conservamos los valores reales y los marcamos como ausentes en una variable aparte.
set.seed(2)
mnar_data <- data.frame(x = rnorm(100), y = rnorm(100)) %>%
    mutate(y_miss = ifelse(y > 1, y, NA),
           y = ifelse(is.na(y_miss), y, NA),
           x_miss = ifelse(is.na(y), x, NA))
Ahora dibujaremos dos diagramas de dispersión de x frente a y: uno que incluya los puntos cuyos valores de y simulamos como ausentes y otro solo con los datos observados.
grid.arrange(
  # Gráfico que destaca los puntos con datos ausentes
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_point(aes(x, y_miss), col = "red", size = 4, alpha = 0.6) +
    geom_hline(aes(yintercept = y_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("Where the data points are missing"),
  # Lo que puede ver la persona que analiza datos
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_vline(aes(xintercept = x_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("What the data scientist can see"),
  # Colocar los dos gráficos en paralelo
  ncol = 2
)
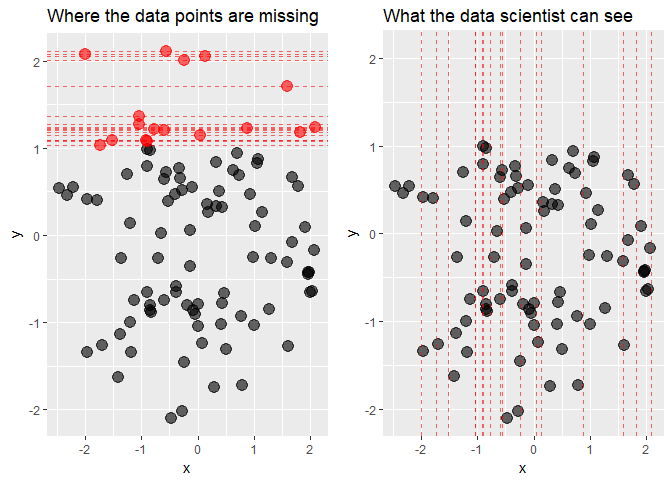
En el primer gráfico se ve con claridad que los datos son realmente MNAR, pero quien analiza los datos solo puede ver las coordenadas x de los puntos ausentes. ¿Qué conclusión se puede extraer del segundo gráfico? ¿Son los datos MCAR? Posiblemente sí: las ubicaciones de los valores perdidos parecen distribuirse de forma bastante uniforme a lo largo del eje x. ¿O son MAR? Si miramos con más detalle, parece haber más valores perdidos en y para valores negativos de x que para los positivos, así que también podría ser el caso. Por último, nunca se puede descartar MNAR, porque para saber si los datos son MNAR por definición necesitaríamos observar los valores no observados.
Por suerte, no estamos totalmente a ciegas. Las herramientas de visualización pueden orientarnos sobre los patrones presentes en los datos ausentes. Ahora analizaremos varios gráficos útiles para detectar esos patrones usando el conjunto de datos biopics del paquete fivethirtyeight, que contiene información sobre películas biográficas.
Antes de pasar a la parte de visualización, los datos necesitan algo de preprocesamiento. El bloque de código siguiente se encarga. La llamada a select al principio del pipeline de dplyr extrae las variables de interés y, a continuación, con mutate agrupamos razas relacionadas para tener suficientes observaciones en cada grupo. Luego ajustamos la clase de algunas variables: necesitamos factores para las variables de texto e enteros para la lógica. Por último, renombramos variables con nombres más cortos para que los gráficos sean más legibles.
data(biopics, package = "fivethirtyeight")

biopics <- biopics %>%
  select(country, year_release, box_office, number_of_subjects,
         type_of_subject, subject_race, person_of_color, subject_sex) %>%
  mutate(subject_race = ifelse(grepl("^Hispanic", subject_race), "Hispanic",
                               subject_race),
         subject_race = ifelse(grepl("^African", subject_race), "African",
                               subject_race),
         subject_race = ifelse(grepl("^Middle", subject_race), "Mid Eastern",
                               subject_race),
         subject_race = ifelse(subject_race %in% c("White", "Asian", "African",
                                                   "Hispanic", "Mid Eastern",
                                                   "Multi racial", NA),
                               subject_race, "other")) %>%
  mutate(country = as.factor(country),
         type_of_subject = as.factor(type_of_subject),
         subject_race = as.factor(subject_race),
         subject_sex = as.factor(subject_sex),
         person_of_color = as.integer(person_of_color)) %>%
      as.data.frame()

colnames(biopics) <- c("country", "year", "earnings", "sub_num",
                       "sub_type", "sub_race", "non_white", "sub_sex")
Terminamos con un conjunto de datos con ocho variables:
country - país o países de origen de la película,year - año de estreno,earnings - recaudación bruta en taquilla de EE. UU.,sub_num - número de personas protagonistas representadas en la película,sub_type - ocupación de la persona protagonista o motivo de su reconocimiento,sub_race - raza de la persona protagonista,non_white - variable indicadora que señala si es una persona de color,sub_sex - sexo de la persona protagonista.La primera pregunta, fundamental, sería: ¿en qué variables faltan observaciones y cuántas? Los gráficos de agregación son muy útiles para responder a esto. Con la siguiente línea lo tienes.
aggr(biopics, numbers = TRUE, prop = c(TRUE, FALSE))
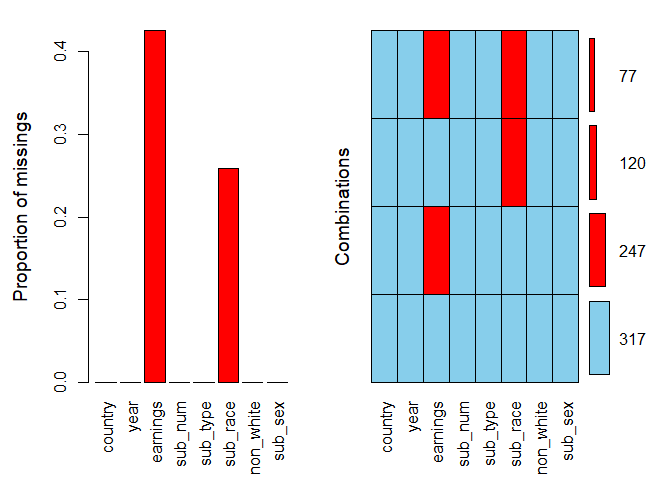
Especificamos el argumento numbers = TRUE para mostrar los números sobre las barras. El argumento prop indica si debe mostrarse la proporción de valores ausentes y de combinaciones en lugar del total. Lo establecemos en TRUE para el primer gráfico y en FALSE para el segundo.
Está claro que los valores perdidos aparecen solo en dos variables: suponen más del 40% de earnings y alrededor del 25% de sub_race. En el gráfico de combinaciones de la derecha, la cuadrícula presenta todas las combinaciones de valores ausentes (rojo) y observados (azul) presentes en los datos. Hay 317 observaciones completas y en 77 filas faltan ambas variables.
Mirar dos gráficos a la vez puede resultar un poco confuso, así que vamos a condensar la misma información en una única visualización con esta línea:
aggr(biopics, combined = TRUE, numbers = TRUE)
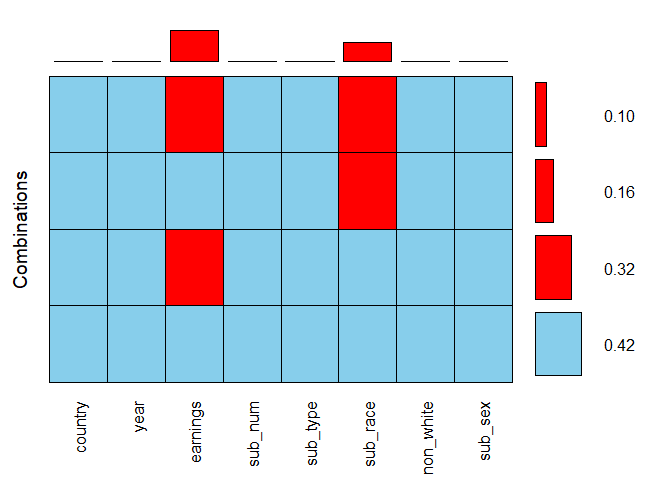
El argumento combined permite combinar ambos gráficos en uno. Aquí, las barras horizontales a la derecha de la cuadrícula indican las frecuencias de las combinaciones correspondientes, mientras que las barras verticales superiores muestran la proporción de valores perdidos en cada variable. Sumando los valores de todas las combinaciones posibles para earnings (0.32 y 0.10) vemos que la proporción total de valores ausentes en esta variable, que habíamos estimado por encima del 40% en el gráfico de barras anterior, es en realidad del 42%.
Hasta ahora tenemos una visión general de los datos ausentes. Es hora de mirar más de cerca las interacciones entre variables concretas. Spinogram y spineplot permiten estudiar el porcentaje de valores perdidos en una variable para diferentes valores de otra. Si esta última es numérica, hablamos de spinogram; si es categórica, la visualización se denomina spineplot.
Ambos se generan con la función spineMiss(), que recibe como entrada un data frame de dos columnas. La primera variable especificada es la que se usa para dividir los datos y se mapea al eje horizontal del gráfico. La segunda es aquella cuyo patrón de valores perdidos nos interesa. Para verlo en la práctica, creemos un spineplot. Especificamos primero la variable categórica sub_race y después earnings, que puedes leer así: ¿cuál es el porcentaje de valores perdidos en earnings para cada categoría de sub_race?
spineMiss(biopics[, c("sub_race", "earnings")])
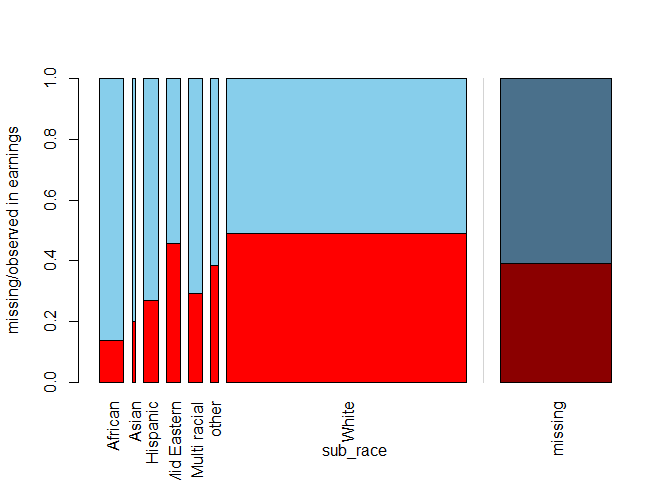
La anchura relativa de las barras para cada categoría de sub_race refleja la frecuencia de dicha categoría en el conjunto de datos: por ejemplo, en una gran mayoría de películas la persona protagonista es blanca. Dentro de cada barra se muestra la proporción de valores perdidos de earnings, mientras que la barra sombreada de la derecha presenta esa proporción para todo el conjunto. Parece que, cuando la persona protagonista es africana, es más probable que tengamos información completa sobre la recaudación.
Si invertimos el orden de las variables como en la línea siguiente, obtenemos un spinogram que responde a la pregunta inversa: ¿qué porcentaje de datos ausentes hay en sub_race para distintos valores de earnings?
spineMiss(biopics[, c("earnings", "sub_race")])
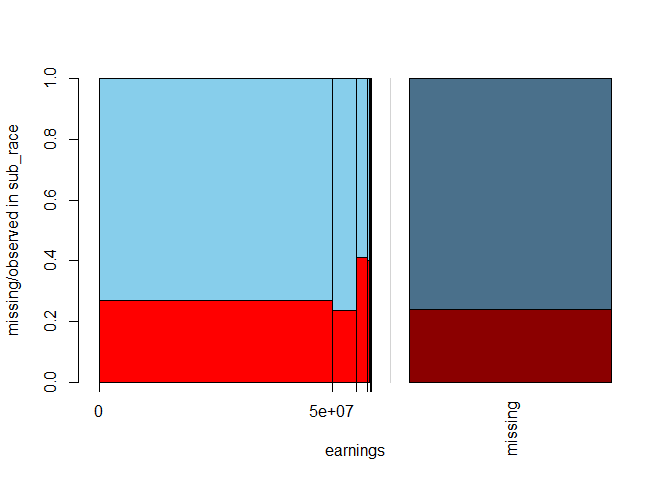
Como earnings es numérica, sus valores se dividen en intervalos, cuyas anchuras corresponden a la distribución de la propia variable. El spinogram muestra que earnings está fuertemente sesgada a la izquierda: solo unas pocas películas obtuvieron los mayores beneficios. Curiosamente, para esos taquillazos es donde más probablemente falta la raza de la persona protagonista, como refleja la barra roja más alta en los valores más grandes de earnings.
El spinogram y el spineplot permiten estudiar interacciones entre dos variables. Esta idea se generaliza a más variables en forma de gráfico mosaico. Este gráfico es una colección de teselas, donde cada tesela corresponde a una combinación específica de categorías (para variables categóricas) o intervalos (para variables numéricas) de dos o más variables. En cada tesela se muestra el porcentaje de valores perdidos en otra variable. En principio, se pueden crear gráficos mosaico para cualquier número de variables, pero si añades demasiadas puede quedar recargado. Además, son más legibles si las variables de partición son factores y no tienen demasiados niveles.
Echemos un vistazo a la proporción de valores ausentes en earnings dividida por sub_sex y US_movie. Esta última, creada en el siguiente bloque, es una lógica que indica si Estados Unidos participó en la producción de la película. Pasamos el data frame con tres variables como primer argumento a mosaicMiss(). El argumento plotvars establecido en un vector con elementos 1 y 2 indica que queremos dividir los datos según las dos primeras columnas de ese data frame. Establecer highlight en 3 significa que queremos que en las teselas se muestre la proporción de valores perdidos de la variable en la tercera columna.
biopics <- biopics %>%
    mutate(US_movie = ifelse(grepl("US", country), TRUE, FALSE))
mosaicMiss(biopics[, c("sub_sex", "US_movie", "earnings")], highlight = 3,
           plotvars = 1:2, miss.labels = FALSE)
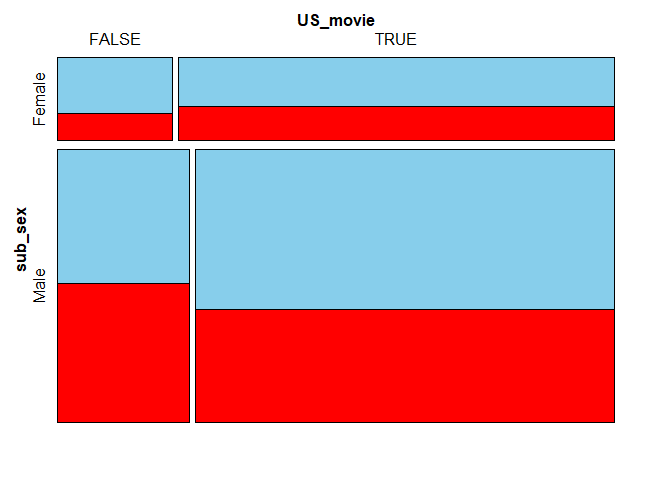
De nuevo, el tamaño de las teselas corresponde a la frecuencia de aparición de cada combinación en el conjunto de datos. Por ejemplo, la tesela inferior derecha, la mayor, indica que la mayoría de películas presentan a un hombre como protagonista y se produjeron, al menos en parte, en EE. UU.
En las películas con protagonista masculino, es más probable que falte información de recaudación si no son estadounidenses. En cambio, si la protagonista es una mujer, las películas de EE. UU. tienen ligeramente más valores perdidos en recaudación. No obstante, estas diferencias parecen demasiado pequeñas para considerarlas significativas.
Otro tipo de visualización es el boxplot paralelo. La idea es dividir el conjunto de datos en dos subconjuntos: uno con solo valores observados de una variable incompleta y otro con solo sus valores perdidos. Para ambos subconjuntos se dibuja un boxplot de una variable numérica elegida. Esto te permite comprobar si la distribución de la variable elegida se ve afectada por la ausencia de la variable de partición.
Para crear un boxplot paralelo, podemos usar la función pbox(). Pasamos un único argumento: un data frame de dos columnas. Los boxplots se dibujarán para la variable de la primera columna, mientras que la segunda se usará para la partición. En el ejemplo siguiente tomamos el logaritmo de earnings porque está muy sesgada y, sin esta transformación, el boxplot se parecería a una línea.
biopics <- biopics %>%
  mutate(log_earnings = log(earnings))
pbox(biopics[, c("log_earnings", "sub_race")])
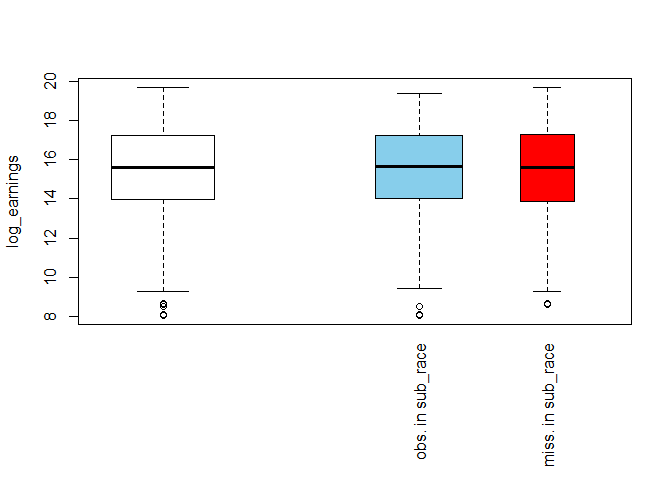
La caja blanca de la izquierda muestra la distribución global de log_earnings, mientras que la azul y la roja muestran su distribución para los subconjuntos con valores observados y perdidos en sub_race, respectivamente. La anchura relativa de las cajas refleja el tamaño de los subconjuntos: la caja azul más ancha indica que hay más valores observados que perdidos en sub_race. Por lo demás, las dos cajas se parecen entre sí y también a la caja blanca general. Esto sugiere que la ausencia de información sobre la raza no afecta a la distribución de la recaudación.
Hemos mirado variables individuales y sus interacciones. Pasemos ahora a analizar todas las variables del conjunto a la vez. La visualización adecuada es el gráfico de coordenadas paralelas. En él, cada variable se transforma a la misma escala y se representa con un eje paralelo. En variables categóricas, la escala del eje se divide en puntos equidistantes, uno por categoría. Los valores perdidos se sitúan por encima de los ejes verticales, fuera del área del gráfico. Cada línea corresponde a una observación, y el color de la línea indica datos ausentes en la variable seleccionada.
Podemos crear este gráfico con la función parcoordMiss(). Por defecto, usa todas las variables presentes en el data frame pasado como primer argumento. Establecer highlight en earnings marca con un color distinto las líneas de observaciones con un valor ausente en earnings. Ajustar la mezcla alfa a 0.6 hace las líneas algo transparentes y mejora la legibilidad.
# Eliminar variables creadas para los gráficos anteriores
biopics <- biopics %>%
  select(- US_movie, - log_earnings)

parcoordMiss(biopics, highlight = 'earnings', alpha = 0.6)
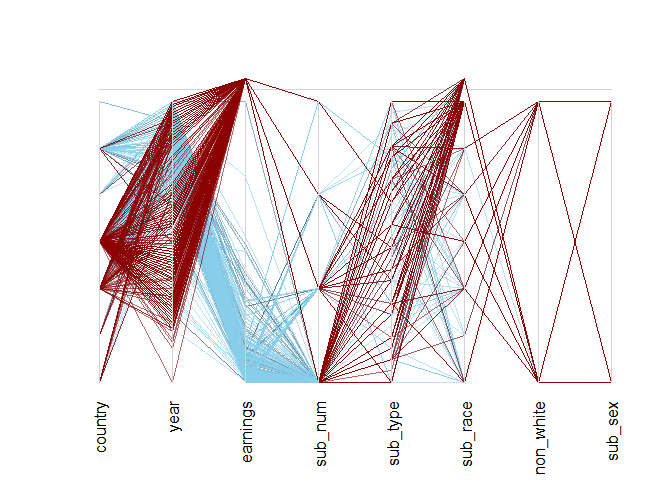
En el gráfico, las líneas rojo oscuro denotan observaciones con un valor ausente en earnings. Estas observaciones destacadas parecen comportarse de forma distinta al resto. En particular, solo unas pocas corresponden al segundo nivel más alto de country, que por lo demás agrupa muchas observaciones. Resulta que son películas US/UK (para verlo, ejecuta levels(biopics$country) y busca el penúltimo valor).
Además, una inspección rápida del eje year revela un tramo hacia los dos tercios de su altura con menos líneas rojo oscuro cruzándolo. Parece que hubo un periodo no hace mucho en el que la recaudación estaba más completa. Esto sugiere que tanto country como year podrían ayudar a explicar la distribución de valores ausentes en earnings.
La última herramienta de visualización que veremos es el gráfico de matriz. Representa todas las celdas de la matriz de datos como rectángulos. Los datos observados se muestran en una escala continua de grises (cuanto más oscuro, mayor valor), mientras que los valores perdidos se resaltan en rojo. Es buena práctica ordenar los datos por una de las variables incompletas: facilita la interpretación. El siguiente bloque lo hace, ordenando por earnings.
matrixplot(biopics, sortby = c('earnings'))
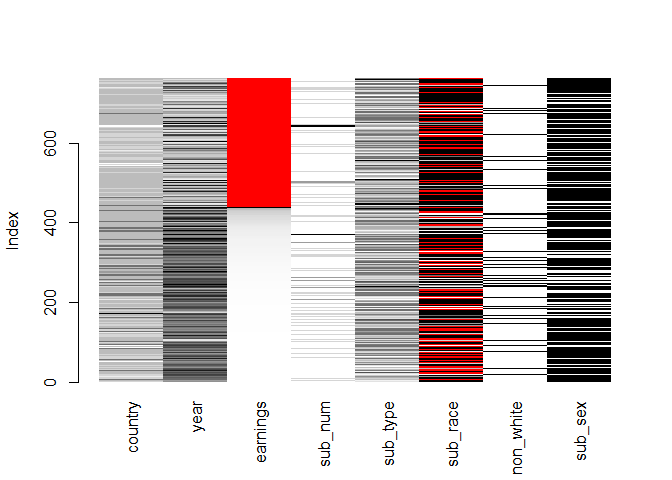
El gráfico confirma algunas conclusiones previas: las observaciones con valores perdidos en earnings tienden a ser de hace mucho (valor bajo de year) y también puntúan bajo en country, lo que se aprecia por el color más claro de estas dos variables en las filas en las que earnings está en rojo. Además, parece que hay menos películas con protagonista no blanca cuando faltan los earnings.
En resumen, parece que los datos ausentes en el conjunto biopics no son MCAR. Las ubicaciones de los valores perdidos en earnings y sub_race se ayudan a explicar mutuamente, como muestran el spineplot y el spinogram. Además, el gráfico de matriz y el de coordenadas paralelas sugieren que country, year y non_white también podrían ayudar a explicar la distribución de valores perdidos en earnings. Por tanto, no es buena idea eliminar las observaciones incompletas, ya que muy probablemente introduciría sesgo en la inferencia.
Reflexiones finales
¡Has llegado lejos! Ahora sabes qué son los mecanismos de datos ausentes, en qué se diferencian y, lo más importante, cómo inferir sobre ellos con distintas herramientas de visualización. ¡Buen trabajo! Ya tienes todo lo necesario para analizar tus propios conjuntos de datos incompletos.
Si te interesa aprender más sobre R, echa un vistazo al curso Data Visualization with ggplot2 (Part 1) de DataCamp y a nuestro R Formula Tutorial.
Aprende más sobre R y visualización de datos
Curso
Curso
Curso
blog
Javier Canales Luna
12 min
blog
Javier Canales Luna
12 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Aditya Sharma
8 min
Tutorial
Jess Ahmet
12 min
Tutorial
Zoumana Keita
15 min