
Last chance! 50% off DataCamp Premium
Sale ends in
Missing डेटा हर डेटा साइंटिस्ट के रोज़मर्रा के काम में चुनौती पैदा करता है। क्या हमें इन्हें इम्प्यूट करना चाहिए? अगर हां, तो कौन-सी विधि उपयुक्त है? या क्या Missing डेटा पॉइंट्स वाले observations को सीधे हटा देना चाहिए? इन प्रश्नों का उत्तर देने के लिए, यह जानना ज़रूरी है कि Missing डेटा के पीछे का तंत्र क्या है। इसे सांख्यिकीय परीक्षणों से पहचानना जटिल है और कई बार केवल अस्पष्ट निष्कर्ष मिलते हैं। इसके विपरीत, विज़ुअलाइज़ेशन टूल्स उपयोग में आसान होते हैं और न केवल Missing डेटा मैकेनिज़्म पहचानने में मदद करते हैं, बल्कि डेटा क्वालिटी के अन्य पहलुओं की भी समझ देते हैं। इस ट्यूटोरियल में, VIM पैकेज में उपलब्ध plotting विधियों का एक सेट प्रस्तुत किया गया है ताकि देखा जा सके कि वे डेटा Missing होने के पैटर्न्स को अच्छी तरह समझने में कैसे मदद करते हैं।
किसी डेटासेट के अधूरा होने के कई कारण हो सकते हैं। Missing डेटा के संभावित कारणों की जांच करना महत्वपूर्ण है, क्योंकि यह इस बात को प्रभावित कर सकता है कि हम समस्या को कैसे संबोधित करें। उदाहरण के लिए, अगर नौकरी से संबंधित सर्वे में non-response चिंता का विषय है, तो यह संभव है कि सबसे अमीर और सबसे गरीब उत्तरदाता अपनी आमदनी न बताएं—अर्थात Missing डेटा पॉइंट्स डेटासेट में समान रूप से फैले नहीं होंगे। अगर ऐसा है, तो विश्लेषण से पहले अधूरे observations को हटाने से पक्षपाती परिणाम मिलेंगे। दूसरी ओर, यदि डेटा किसी उपकरण की विफलता के कारण Missing हैं, तो संभव है कि डेटासेट में Missing पॉइंट्स के स्थान पूरी तरह यादृच्छिक हों।
डेटा Missing होने के तीन अलग-अलग पैटर्न होते हैं। इन्हें आमतौर पर Missing Data Mechanisms कहा जाता है।
Missing completely at random (MCAR)
MCAR में डेटासेट में Missing पॉइंट्स के स्थान में कोई व्यवस्थित पैटर्न नहीं होता: वे पूरी तरह रैंडम होते हैं। औपचारिक रूप से, किसी observation के अनुपस्थित होने की संभावना न तो अन्य वेरिएबल्स के मानों पर निर्भर करती है और न ही उसके अपने मानों पर। इस स्थिति में, अधूरे observations को हटाने से बाद के विश्लेषण में पक्षपात नहीं आता।
उदाहरण: तापमान एक सेंसर द्वारा लगातार मापा जाता है जो डेटा एकत्र कर इंटरनेट के जरिए डेटाबेस को भेजता है। अज्ञात कारणों से इंटरनेट कनेक्शन कभी-कभी टूट जाता है।
Missing at random (MAR)
MAR में, किसी विशेष observation के Missing होने की संभावना उसके अपने मानों से तो स्वतंत्र रहती है, लेकिन अन्य वेरिएबल्स के मानों पर निर्भर करती है। इस स्थिति में, अधूरे observations को हटाने से नमूना कम प्रतिनिधिक बन जाता है।
उदाहरण: कुछ रात के घंटों के डेटा सेंसर के रखरखाव कार्यों के कारण Missing हैं, जो हमेशा रात में किए जाते हैं।
Missing not at random (MNAR)
MNAR में, किसी observation के Missing होने की संभावना उसके अपने ही अप्रेक्षित मानों पर निर्भर करती है। इस स्थिति में भी, अधूरे डेटा हटाने से पक्षपाती विश्लेषण होता है।
उदाहरण: सेंसर -20 डिग्री सेल्सियस पर फ्रीज़ हो जाता है और इस मान से नीचे तापमान नहीं मापता।
व्यवहार में, किसी विशिष्ट मामले में इन तीनों में से कौन-सा Missing डेटा मैकेनिज़्म लागू होता है, यह बताना कठिन होता है। इसे देखने के लिए, आइए कुछ MNAR डेटा प्लॉट करते हैं। हम ggplot2 और gridExtra पैकेज का उपयोग करेंगे जिन्हें पहले लोड करना होगा। आगे उपयोग के लिए दो और पैकेज लोड करेंगे: Missing डेटा के विज़ुअल विश्लेषण के लिए VIM और कुछ प्री-प्रोसेसिंग के लिए dplyr। याद रखें, अगर ये आपके workspace में इंस्टॉल नहीं हैं तो पहले install.packages() करें।
library("VIM")
library("dplyr")
library("ggplot2")
library("gridExtra")
आइए दो असंबद्ध, सामान्य वितरण वाले वेरिएबल्स x और y का एक डेटासेट बनाते हैं, जिसमें y के वितरण के दाएँ टेल—अर्थात उच्च मानों—में कुछ Missing वैल्यूज़ हों। ध्यान दें कि हम वास्तविक मान भी रखते हैं, और उन्हें एक अलग वेरिएबल में Missing के रूप में सेट करते हैं।
set.seed(2)
mnar_data <- data.frame(x = rnorm(100), y = rnorm(100)) %>%
    mutate(y_miss = ifelse(y > 1, y, NA),
           y = ifelse(is.na(y_miss), y, NA),
           x_miss = ifelse(is.na(y), x, NA))
अब हम x बनाम y के दो स्कैटर प्लॉट बनाएंगे: एक जिसमें वे पॉइंट्स शामिल हों जिनके y-वैल्यूज़ को हम Missing मानते हैं, और एक केवल observed डेटा के साथ।
grid.arrange(
  # Plot highlighting missing data points
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_point(aes(x, y_miss), col = "red", size = 4, alpha = 0.6) +
    geom_hline(aes(yintercept = y_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("Where the data points are missing"),
  # What data scientist can see
  ggplot(mnar_data, aes(x, y)) +
    geom_point(size = 4, alpha = 0.6) +
    geom_vline(aes(xintercept = x_miss), col = "red", alpha = 0.6,
               linetype = "dashed") +
    ylim(NA, max(mnar_data$y_miss, na.rm = TRUE)) +
    ggtitle("What the data scientist can see"),
  # Arrange the two plots side-by-side
  ncol = 2
)
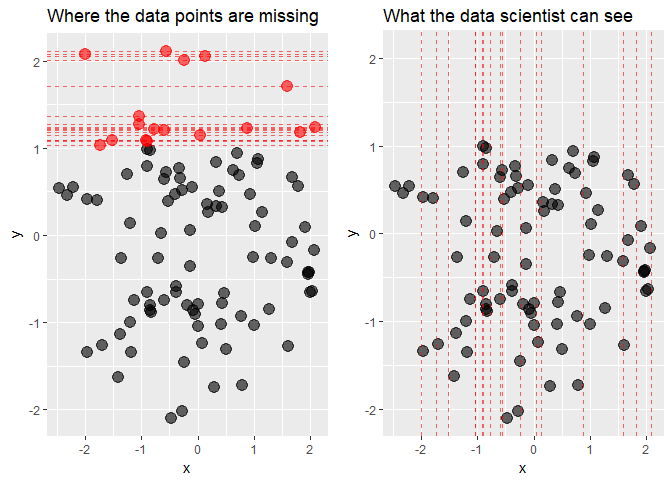
पहले प्लॉट से स्पष्ट है कि डेटा वास्तव में MNAR हैं, लेकिन डेटा साइंटिस्ट को केवल Missing पॉइंट्स के x-कोऑर्डिनेट्स ही दिखते हैं। दूसरे प्लॉट से क्या निष्कर्ष निकाला जा सकता है? क्या डेटा MCAR हैं? संभव है, Missing वैल्यूज़ के स्थान x-अक्ष पर काफ़ी समान रूप से फैले दिखते हैं। या क्या वे MAR हैं? गहराई से देखने पर, x के नकारात्मक मानों पर y में Missing वैल्यूज़ ज़्यादा दिखती हैं बनिस्बत सकारात्मक मानों के, तो यह भी संभव है। अंततः, MNAR को कभी पूर्णतः खारिज नहीं किया जा सकता, क्योंकि यह जानने के लिए कि डेटा MNAR हैं या नहीं, परिभाषा अनुसार हमें अप्रेक्षित मानों को देखना पड़ेगा।
अच्छी बात यह है कि हम पूरी तरह असमंजस में नहीं हैं। डेटा विज़ुअलाइज़ेशन टूल्स Missing डेटा में मौजूद पैटर्न्स के बारे में कुछ दिशा-निर्देश दे सकते हैं। अब हम fivethirtyeight पैकेज के biopics डेटासेट पर आधारित कुछ ऐसे प्लॉट्स का विश्लेषण करेंगे जो इन पैटर्न्स का पता लगाने में उपयोगी हैं और जिनमें जीवनीपरक फ़िल्मों की जानकारी है।
प्लॉटिंग पर बढ़ने से पहले, डेटा को कुछ प्री-प्रोसेसिंग की आवश्यकता है। नीचे दिया गया कोड यह काम करेगा। dplyr पाइपलाइन की शुरुआत में select कॉल इच्छित वेरिएबल्स निकालती है और उसके बाद की mutate संबंधित races को समूहित करती है ताकि हर समूह में पर्याप्त observations हों। फिर, कुछ वेरिएबल्स की क्लास समायोजित की जाती है: स्ट्रिंग वेरिएबल्स को फैक्टर और लॉजिकल को इंटीजर चाहिए। अंत में, प्लॉट्स की पठनीयता के लिए वेरिएबल्स के नाम छोटे कर दिए जाते हैं।
data(biopics, package = "fivethirtyeight")

biopics <- biopics %>%
  select(country, year_release, box_office, number_of_subjects,
         type_of_subject, subject_race, person_of_color, subject_sex) %>%
  mutate(subject_race = ifelse(grepl("^Hispanic", subject_race), "Hispanic",
                               subject_race),
         subject_race = ifelse(grepl("^African", subject_race), "African",
                               subject_race),
         subject_race = ifelse(grepl("^Middle", subject_race), "Mid Eastern",
                               subject_race),
         subject_race = ifelse(subject_race %in% c("White", "Asian", "African",
                                                   "Hispanic", "Mid Eastern",
                                                   "Multi racial", NA),
                               subject_race, "other")) %>%
  mutate(country = as.factor(country),
         type_of_subject = as.factor(type_of_subject),
         subject_race = as.factor(subject_race),
         subject_sex = as.factor(subject_sex),
         person_of_color = as.integer(person_of_color)) %>%
      as.data.frame()

colnames(biopics) <- c("country", "year", "earnings", "sub_num",
                       "sub_type", "sub_race", "non_white", "sub_sex")
अंत में हमारे पास आठ वेरिएबल्स वाला एक डेटासेट है:
country - फ़िल्म का देश या देशों का मूल,year - रिलीज़ वर्ष,earnings - U.S. बॉक्स ऑफिस पर सकल कमाई,sub_num - फ़िल्म में दिखाए गए विषयों (subjects) की संख्या,sub_type - विषय का पेशा या पहचान का कारण,sub_race - विषय की रेस,non_white - व्यक्ति के रंगीन (person of color) होने का डमी वेरिएबल,sub_sex - विषय का लिंग।पहला और बुनियादी प्रश्न यह होगा: किन वेरिएबल्स में observations Missing हैं, और कितने? इन प्रश्नों के उत्तर के लिए Aggregation प्लॉट्स उपयोगी हैं। नीचे दिया गया एक-लाइनर ही पर्याप्त है।
aggr(biopics, numbers = TRUE, prop = c(TRUE, FALSE))
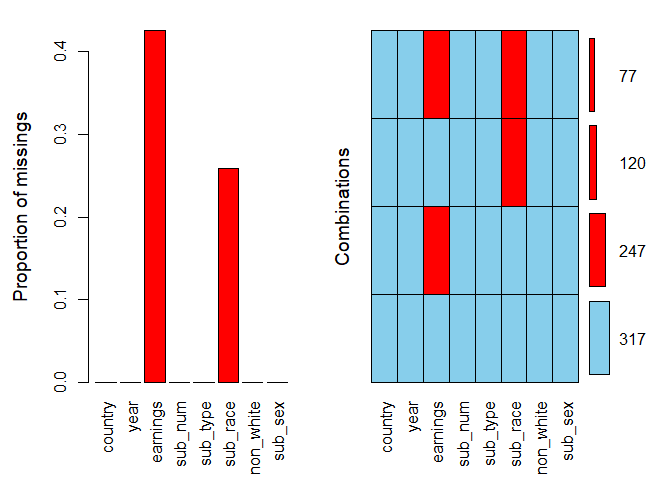
हमने numbers = TRUE आर्गुमेंट दिया है ताकि बार्स के ऊपर संख्याएँ दिखें। prop एक लॉजिकल है जो बताता है कि कुल संख्या की बजाय Missing मानों और संयोजनों का proportion दिखाया जाए या नहीं। हमने पहले प्लॉट के लिए इसे TRUE और दूसरे के लिए FALSE सेट किया है।
स्पष्ट है कि Missing वैल्यूज़ केवल दो वेरिएबल्स में हैं: earnings में 40% से अधिक और sub_race में लगभग 25%। दाहिनी ओर के combinations प्लॉट में ग्रिड डेटा में मौजूद Missing (लाल) और observed (नीला) मानों के सभी संयोजन दिखाता है। 317 पूर्ण observations हैं, और 77 पंक्तियों में दोनों वेरिएबल्स Missing हैं।
एक साथ दो प्लॉट्स देखना थोड़ा भ्रमित कर सकता है, तो आइए इसी जानकारी को एकल विज़ुअलाइज़ेशन में समेटते हैं, नीचे की लाइन से।
aggr(biopics, combined = TRUE, numbers = TRUE)
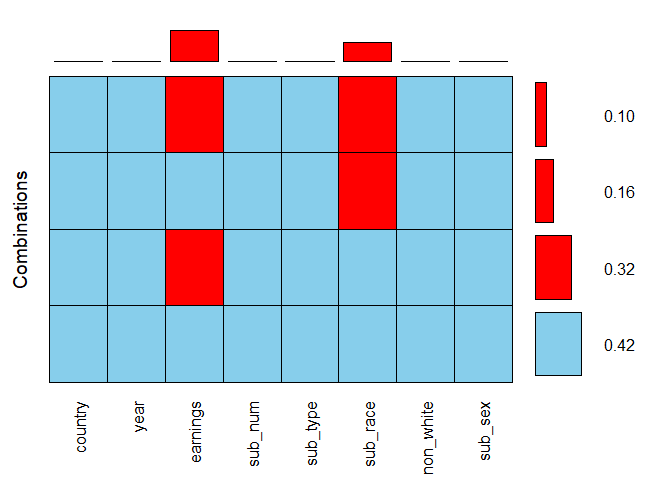
combined आर्गुमेंट दो प्लॉट्स को एक में जोड़ने देता है। यहाँ, ग्रिड के दाहिने क्षैतिज बार्स संबंधित संयोजनों की आवृत्तियाँ दिखाते हैं, जबकि ऊपर के ऊर्ध्वाधर बार्स प्रत्येक वेरिएबल में Missing वैल्यूज़ का proportion प्रस्तुत करते हैं। earnings के लिए सभी संभावित संयोजनों के मान, यानी 0.32 और 0.10, जोड़ने पर दिखता है कि इस वेरिएबल में Missing वैल्यूज़ का कुल proportion, जिसे पहले हमने 40% से अधिक आंका था, वास्तव में 42% है।
अब तक हमने Missing डेटा का उच्च-स्तरीय अवलोकन पाया है। अब विशिष्ट वेरिएबल्स के बीच अंतःक्रिया पर नज़र डालने का समय है। Spinogram और spineplot किसी एक वेरिएबल में Missing वैल्यूज़ का प्रतिशत दूसरे वेरिएबल के विभिन्न मानों के लिए अध्ययन करने की अनुमति देते हैं। अगर दूसरा वेरिएबल numeric है, तो यह spinogram होता है; और अगर वह categorical है, तो इसे spineplot कहा जाता है।
दोनों को spineMiss() फ़ंक्शन से बनाया जा सकता है, जो इनपुट के रूप में दो-कालम वाला डेटा फ़्रेम लेता है। पहला निर्दिष्ट वेरिएबल वह है जिसके अनुसार डेटा विभाजित होते हैं—यह प्लॉट की क्षैतिज धुरी पर मैप होता है। दूसरा वेरिएबल वह है जिसका Missing डेटा पैटर्न हम देखना चाहते हैं। इसे व्यवहार में देखने के लिए, एक spineplot बनाते हैं। हम पहले श्रेणीबद्ध वेरिएबल sub_race और फिर earnings देते हैं—अर्थात पढ़ें: sub_race की प्रत्येक श्रेणी के लिए earnings में Missing वैल्यूज़ का प्रतिशत क्या है?
spineMiss(biopics[, c("sub_race", "earnings")])
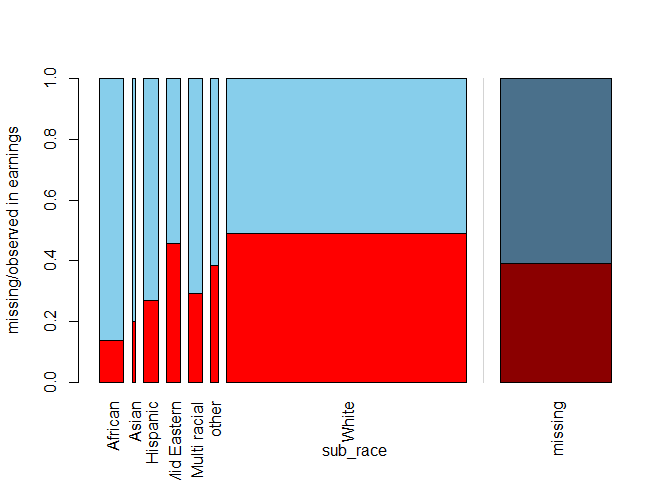
sub_race की विशिष्ट श्रेणियों के लिए बार्स की सापेक्ष चौड़ाई इस श्रेणी की डेटासेट में आवृत्ति को दर्शाती है: उदाहरण के लिए, भारी बहुमत वाली फ़िल्मों में मुख्य विषय white है। हर बार के भीतर, earnings का Missing proportion दिखाया गया है, जबकि दाहिनी ओर छायांकित बार पूरे डेटासेट के लिए यह proportion दिखाता है। लगता है कि जब मुख्य विषय African है, तो earnings की पूर्ण जानकारी मिलने की संभावना सबसे अधिक है।
नीचे दिए कोड में वेरिएबल्स का क्रम बदलकर, हम एक spinogram बना सकते हैं जो उलटा प्रश्न पूछता है: earnings के विभिन्न मानों के लिए sub_race में Missing डेटा का प्रतिशत क्या है?
spineMiss(biopics[, c("earnings", "sub_race")])
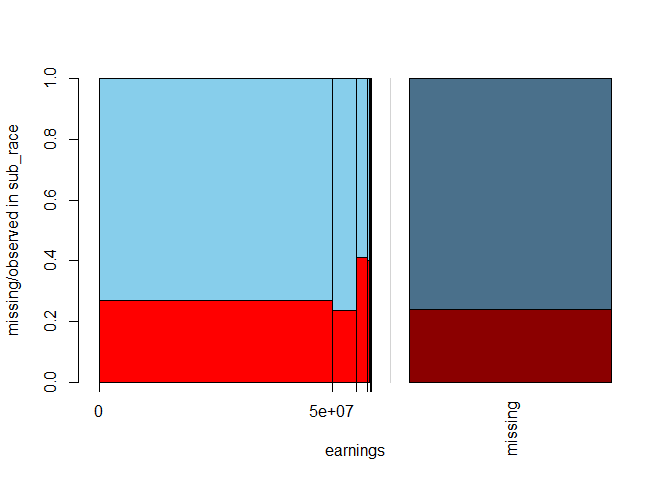
क्योंकि earnings numeric है, इसके मानों को बिन्स में बाँटा जाता है, जहाँ बिन्स की चौड़ाई स्वयं वेरिएबल के वितरण के अनुरूप होती है। spinogram दिखाता है कि earnings बहुत अधिक नकारात्मक रूप से skewed हैं: केवल कुछ फ़िल्मों ने सबसे अधिक लाभ कमाया। रोचक बात यह है कि उन blockbusters के लिए विषय की race सबसे अधिक Missing रहने की संभावना है, जैसा कि earnings के सबसे बड़े मानों पर सबसे ऊँची लाल पट्टी से प्रतिबिंबित होता है।
ऊपर चर्चा किए गए spinogram और spineplot दो वेरिएबल्स के बीच अंतःक्रिया का अध्ययन करने देते हैं। इसे और अधिक वेरिएबल्स तक सामान्यीकृत करने का रूप है mosaic plot। यह प्लॉट टाइल्स का संग्रह है, जहाँ हर टाइल दो या अधिक वेरिएबल्स की विशिष्ट श्रेणियों (categorical वेरिएबल्स के लिए) या बिन्स (numeric वेरिएबल्स के लिए) के संयोजन से मेल खाती है। हर टाइल के भीतर, किसी अन्य वेरिएबल में Missing डेटा पॉइंट्स का प्रतिशत दिखाया जाता है। सिद्धांततः, mosaic प्लॉट्स किसी भी संख्या के वेरिएबल्स पर बनाए जा सकते हैं, लेकिन बहुत अधिक वेरिएबल्स होने पर वे भरे-भरे लग सकते हैं। साथ ही, जब विभाजन करने वाले वेरिएबल्स फैक्टर्स हों और उनके स्तर बहुत अधिक न हों, तो वे अधिक पठनीय होते हैं।
आइए sub_sex और US_movie के अनुसार विभाजित earnings में Missing proportion देखें। US_movie (नीचे दिए कोड में बनाया गया) एक लॉजिकल है जो बताता है कि संयुक्त राज्य अमेरिका फ़िल्म के निर्माण में शामिल था या नहीं। हम तीन-वेरिएबल वाला डेटा फ़्रेम mosaicMiss() के पहले आर्गुमेंट के रूप में देते हैं। plotvars को 1 और 2 वाले वेक्टर पर सेट करने का मतलब है कि हम डेटा को इस डेटा फ़्रेम के पहले दो कॉलम्स के अनुसार विभाजित करना चाहते हैं। highlight को 3 पर सेट करने का अर्थ है कि हम तीसरे कॉलम वाले वेरिएबल के Missing proportion को टाइल्स के भीतर दिखाना चाहते हैं।
biopics <- biopics %>%
    mutate(US_movie = ifelse(grepl("US", country), TRUE, FALSE))
mosaicMiss(biopics[, c("sub_sex", "US_movie", "earnings")], highlight = 3,
           plotvars = 1:2, miss.labels = FALSE)
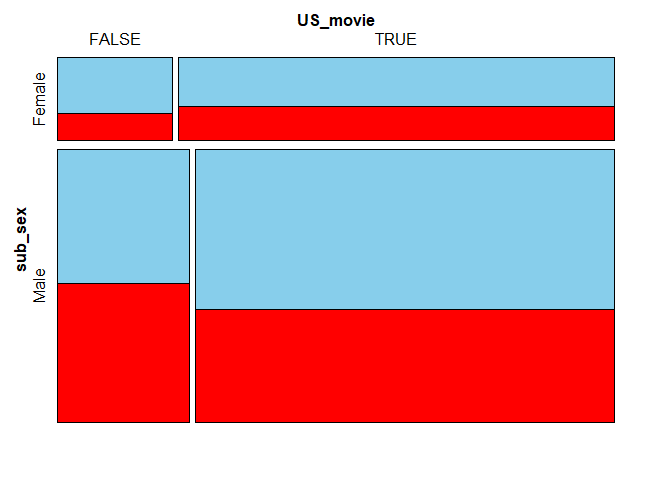
फिर से, टाइल्स के आकार डेटासेट में दी गई संयोजन-आवृत्तियों के अनुरूप होते हैं। उदाहरणतः, सबसे बड़ा निचला-दाहिना टाइल बताता है कि अधिकांश फ़िल्में पुरुष विषय पर आधारित हैं और कम-से-कम आंशिक रूप से US में निर्मित हुईं।
जहाँ मुख्य विषय पुरुष है, वहाँ non-American फ़िल्मों के लिए earnings जानकारी Missing होने की संभावना अधिक है। दूसरी ओर, यदि मुख्य पात्र महिला है, तो US फ़िल्मों में earnings में Missing वैल्यूज़ थोड़ा अधिक हैं। हालांकि, ये अंतर इतने छोटे लगते हैं कि इन्हें सार्थक मानना कठिन है।
एक और विज़ुअलाइज़ेशन प्रकार है parallel boxplot। इसका विचार यह है कि डेटासेट को दो सबसेट्स में बाँटा जाए: एक जिसमें अधूरे वेरिएबल के केवल observed मान हों और दूसरा जिसमें केवल उसके Missing मान हों। दोनों सबसेट्स के लिए, चुने हुए किसी numeric वेरिएबल का बॉक्सप्लॉट बनाया जाता है। इससे आप जाँच सकते हैं कि चुने गए वेरिएबल का वितरण, स्प्लिटिंग वेरिएबल में Missing वैल्यूज़ से प्रभावित होता है या नहीं।
parallel boxplot बनाने के लिए हम pbox() फ़ंक्शन उपयोग कर सकते हैं। हम केवल एक आर्गुमेंट पास करते हैं: दो-कालम वाला डेटा फ़्रेम। पहले कॉलम वाले वेरिएबल के बॉक्सप्लॉट बनेंगे, जबकि दूसरा कॉलम स्प्लिटिंग के लिए उपयोग होगा। नीचे के उदाहरण में, हम earnings का लघुगणक लेते हैं क्योंकि वे बहुत skewed हैं और इस रूपांतरण के बिना बॉक्सप्लॉट लगभग एक रेखा जैसा लगता।
biopics <- biopics %>%
  mutate(log_earnings = log(earnings))
pbox(biopics[, c("log_earnings", "sub_race")])
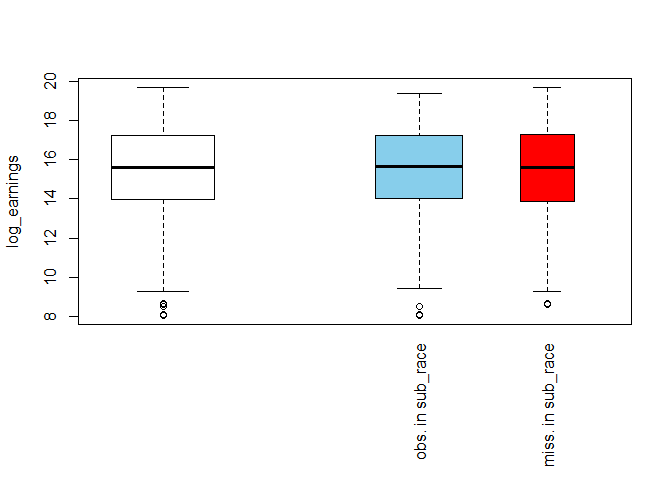
बाईं ओर का सफेद बॉक्स log_earnings का समग्र वितरण दिखाता है, जबकि नीला और लाल बॉक्स क्रमशः sub_race में observed और Missing मानों वाले सबसेट्स का वितरण दिखाते हैं। बक्सों की सापेक्ष चौड़ाई उन सबसेट्स के आकार को दर्शाती है: चौड़ा नीला बॉक्स बताता है कि sub_race में observed मान Missing की तुलना में अधिक हैं। इसके अलावा, दोनों बॉक्स एक-दूसरे और समग्र सफेद बॉक्स से मिलते-जुलते दिखते हैं। यह सुझाता है कि Missing race जानकारी, earnings के वितरण को प्रभावित नहीं करती।
हमने एकल वेरिएबल्स और उनकी अंतःक्रियाएँ देख लीं। अब पूरे डेटासेट के सभी वेरिएबल्स को एक साथ विश्लेषित करें। इसके लिए जो विज़ुअलाइज़ेशन उपयुक्त है, वह है parallel coordinate plot। इस प्लॉट में प्रत्येक वेरिएबल को एक ही स्केल पर रूपांतरित कर समानांतर अक्ष द्वारा दर्शाया जाता है। श्रेणीबद्ध वेरिएबल्स के मामले में, अक्ष का स्केल समान दूरी पर बिंदुओं के सेट में टूटता है—प्रत्येक श्रेणी के लिए एक। Missing मानों को ऊर्ध्वाधर अक्षों के ऊपर, प्लॉट क्षेत्र के बाहर रखा जाता है। प्लॉट पर प्रत्येक रेखा डेटा में एक observation का प्रतिनिधित्व करती है, और रेखा का रंग चुने गए वेरिएबल में Missing डेटा को दर्शाता है।
parcoordMiss() फ़ंक्शन से हम parallel coordinate plot बना सकते हैं। डिफ़ॉल्ट रूप से, यह अपने पहले आर्गुमेंट के रूप में दिए डेटा फ़्रेम के सभी वेरिएबल्स का उपयोग करता है। highlight को earnings पर सेट करने से उन observations की रेखाएँ अलग रंग में चिन्हित होती हैं जिनमें earnings Missing हैं। alpha-blending को 0.6 पर सेट करने से रेखाएँ हल्की पारदर्शी हो जाती हैं और प्लॉट की पठनीयता बढ़ती है।
# Remove variables created for the previous plots
biopics <- biopics %>%
  select(- US_movie, - log_earnings)

parcoordMiss(biopics, highlight = 'earnings', alpha = 0.6)
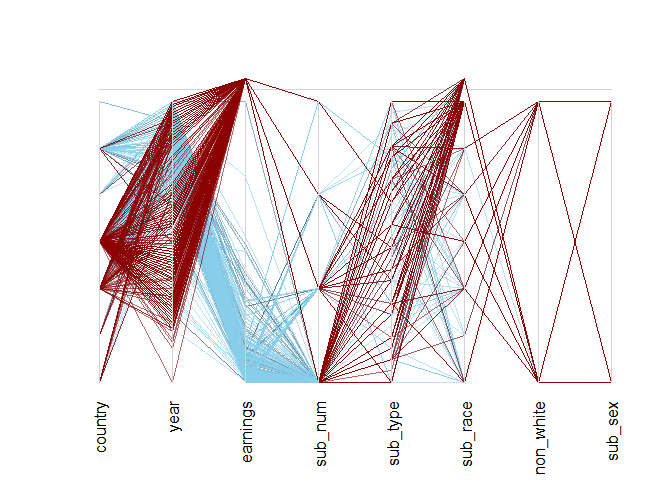
ऊपर के प्लॉट में, गहरी लाल रेखाएँ वे observations दर्शाती हैं जिनमें earnings Missing हैं। ये हाइलाइटेड observations बाकी डेटा से अलग तरह का व्यवहार करते दिखते हैं। खासकर, इनमें से बहुत कम ही country के दूसरे-सबसे-ऊँचे स्तर से मेल खाते हैं, जबकि आम तौर पर इस स्तर पर कई observations हैं! यह US/UK फ़िल्में निकलती हैं (देखने के लिए बस levels(biopics$country) चलाएँ और अंतिम से दूसरे मान को देखें!).
इसके अलावा, year अक्ष पर एक त्वरित नज़र से ऊँचाई के लगभग दो-तिहाई हिस्से के आस-पास एक ऐसा दौर दिखता है जहाँ गहरी लाल रेखाएँ कम पार करती हैं। लगता है कि कुछ समय पहले तक earnings डेटा अधिक पूर्ण थे। यह सुझाता है कि country और year दोनों, earnings में Missing वैल्यूज़ के वितरण को समझाने में मदद कर सकते हैं!
अंतिम विज़ुअलाइज़ेशन टूल जिसे हम देखेंगे, वह है matrix plot। यह डेटा मैट्रिक्स की सभी कोशिकाओं को आयतों द्वारा दर्शाता है। observed डेटा सतत gray-black रंग योजना में दिखते हैं (रंग जितना गहरा, मान उतना उच्च), जबकि Missing मानों को लाल रंग में हाइलाइट किया जाता है। किसी अधूरे वेरिएबल के अनुसार डेटा को sort करना अच्छा अभ्यास है—इससे प्लॉट की व्याख्या आसान होती है। नीचे दिया गया कोड यही करता है, earnings के अनुसार sort करते हुए।
matrixplot(biopics, sortby = c('earnings'))
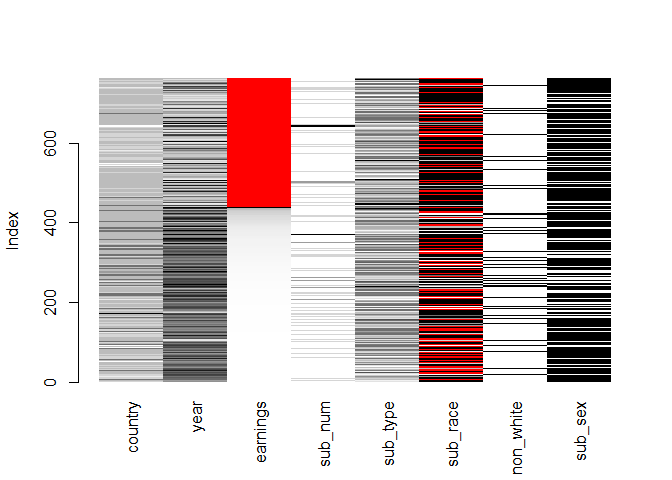
यह प्लॉट कुछ पूर्व निष्कर्षों की पुष्टि करता है: जिन observations में earnings Missing हैं वे प्रायः काफी पहले के समय (कम year मान) से आते हैं और country पर भी कम स्कोर करते हैं—यह उन पंक्तियों में इन दोनों वेरिएबल्स के हल्के रंग से दिखता है जिनमें earnings लाल हैं। साथ ही, जब earnings Missing हैं, तब non-white विषय वाली फ़िल्में कम लगती हैं।
सारांशतः, biopics डेटासेट में Missing डेटा MCAR नहीं लगते। earnings और sub_race में Missing डेटा पॉइंट्स के स्थान एक-दूसरे की व्याख्या करने में मदद करते हैं, जैसा कि spineplot और spinogram से सिद्ध होता है। इसके अलावा, matrix plot और parallel coordinate plot सुझाते हैं कि country, year और non_white भी earnings में Missing वैल्यूज़ के वितरण को समझाने में मदद कर सकते हैं। अतः अधूरे observations को हटा देना अच्छा विचार नहीं है, क्योंकि इससे हमारी inference में संभवतः पक्षपात आ जाएगा।
Final Thoughts
आप काफी आगे आ चुके हैं! अब आप जानते हैं कि Missing डेटा मैकेनिज़्म क्या होते हैं, वे कैसे भिन्न होते हैं, और इससे भी महत्वपूर्ण—विभिन्न विज़ुअलाइज़ेशन टूल्स की मदद से उनके बारे में निष्कर्ष कैसे निकाले जाएँ। बहुत बढ़िया! अब आप अपने स्वयं के अधूरे डेटासेट्स का विश्लेषण करने के लिए पूरी तरह तैयार हैं!
यदि आप R के बारे में और सीखने में रुचि रखते हैं, तो DataCamp का Data Visualization with ggplot2 (Part 1) कोर्स लें और हमारा R Formula Tutorial देखें।
R और Data Visualization के बारे में और जानें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}