
Cursus
Generatieve AI-concepten
2 uur
121.1K
Weaviate is een open-source, cloud-native, modulaire, realtime vectorzoekmachine waarmee je data-objecten en vectorembeddings kunt opslaan en ze kunt opvragen op basis van gelijkenis. In deze tutorial verkennen we Weaviate en de kernconcepten, leer je hoe je het instelt, een schema maakt, er data aan toevoegt en de data opvraagt via de GraphQL-interface van Weaviate. We behandelen ook hoe je Weaviate met Python gebruikt en bespreken best practices en tips voor schemadesign, data-import en query-optimalisatie.
Weaviate is een vector database die zowel objecten als vectoren opslaat, waardoor je vector search kunt combineren. Het is modulair, cloud-native en realtime, waardoor het eenvoudig is om machinelearningmodellen op te schalen. Weaviate wordt geleverd met optionele modules voor tekst, afbeeldingen en andere mediatypen, die je kunt kiezen op basis van je taak en data. Afhankelijk van de variëteit aan data kun je ook meer dan één module gebruiken.
Ongestructureerde data, zoals tekst, afbeeldingen en audio, heeft geen vooraf gedefinieerd formaat, wat het lastig maakt voor traditionele databases en methoden.
Om deze data bruikbaar te maken in AI- en machinelearningtoepassingen, wordt deze met embeddings omgezet in numerieke vectoren.
Embeddings werken als gespecialiseerde woordenboeken die hoog-dimensionale data omzetten in compacte numerieke vormen, zodat AI-modellen deze efficiënt kunnen verwerken.
Ze zijn cruciaal bij het verlagen van de dimensionaliteit van data en het overwinnen van de beperkingen van traditionele encodering, waardoor AI complexe relaties en context in de data kan begrijpen.
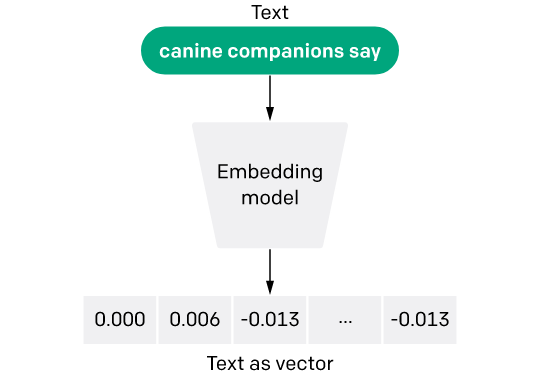
Tekst-embeddingmodel - Bron afbeelding
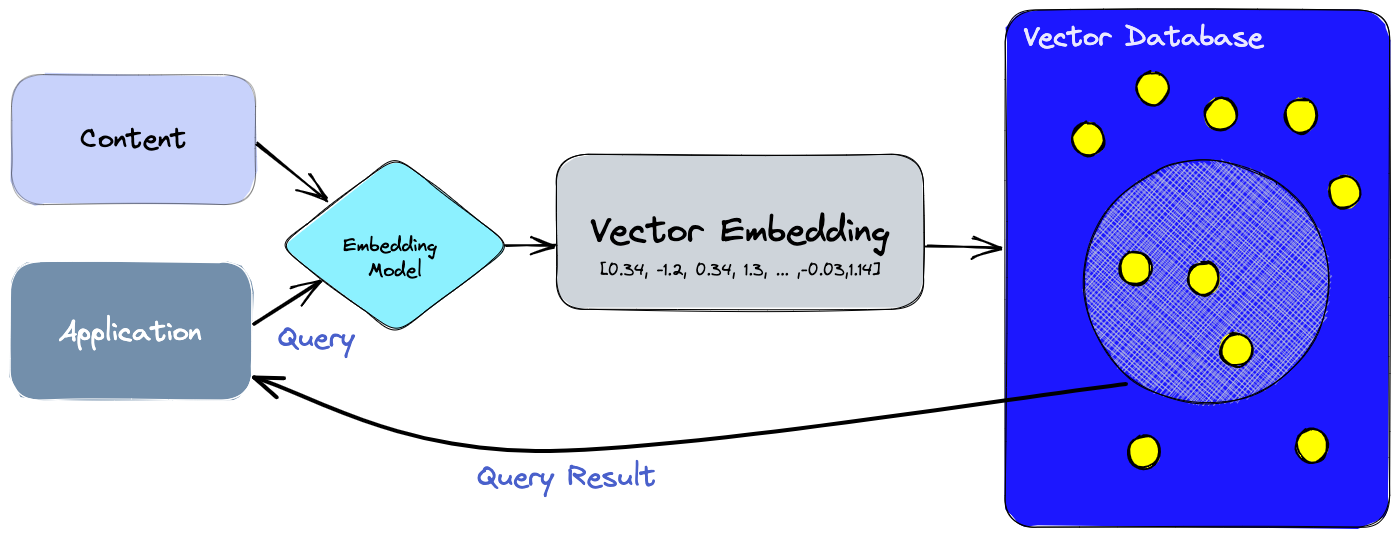
Traditionele databases slaan data op in tabellen die je met SQL kunt bevragen. SQL is echter niet goed geschikt voor het doorzoeken van ongestructureerde data, zoals tekst of afbeeldingen. Vector databases daarentegen slaan data op als vectoren, die kunnen worden bevraagd met gelijkenismaatstaven.
Dit maakt ze zeer geschikt voor taken zoals semantisch zoeken, vraagbeantwoording en generative search. Vectoren worden verkregen met het ML-embeddingsmodel. Het is simpelweg de numerieke representatie van het oorspronkelijke object, zoals tekst, afbeelding, audio, video, enz.
Stel dat je een taalmodel gebruikt om grote sets tekstdocumenten te analyseren en te categoriseren. Elk document kan worden omgezet in een hoog-dimensionale vector die de semantische essentie vastlegt.
Het opslaan van deze vectoren in een traditionele database is mogelijk niet efficiënt voor taken als gelijkeniszoektocht of clusteren.
Hier komt een vector database van pas. Deze is geoptimaliseerd voor het opslaan van vectoren en het uitvoeren van snelle vectorbewerkingen, zoals het vinden van dichtstbijzijnde buren of het berekenen van de cosinusgelijkenis tussen vectoren.
Pinecone is een andere populaire vector database en een goed alternatief voor Weaviate. Wil je meer weten over Pinecone, bekijk dan Mastering Vector Databases with Pinecone Tutorial.
Om Weaviate in te stellen kun je Docker Compose gebruiken of het handmatig installeren. Docker Compose is de aanbevolen methode omdat die het installatieproces vereenvoudigt. Zodra je Weaviate hebt geïnstalleerd, kun je de installatie verifiëren door een eenvoudige query uit te voeren.
Voor Docker Compose download je dit yaml-bestand van Weaviate. Zodra je dit bestand hebt, kun je simpelweg draaien:
docker compose up -dDe andere opties om Weaviate te gebruiken zijn:
Om Weaviate in Python te gebruiken, kun je de Weaviate Python-client installeren met pip.
!pip install -U weaviate-clientIn Weaviate hoort elk data-item bij een groep die een "Class" wordt genoemd en heeft het bepaalde kenmerken, "Properties". Deze data-items (weergegeven als JSON-documenten) zijn klassen gebaseerde collecties.
Elk data-item wordt gerepresenteerd door een vector (machinelearning-embeddingsmodel). Elke klassen gebaseerde collectie bevat objecten van dezelfde klasse, die worden gedefinieerd door een gemeenschappelijk schema.
Weaviate is flexibel opgebouwd, zodat je optionele functies kunt toevoegen, zoals het omzetten van data naar vectoren of het maken van back-ups.
Zonder deze add-ons fungeert de basisversie van Weaviate als een database die specifiek is ontworpen voor vectordata.
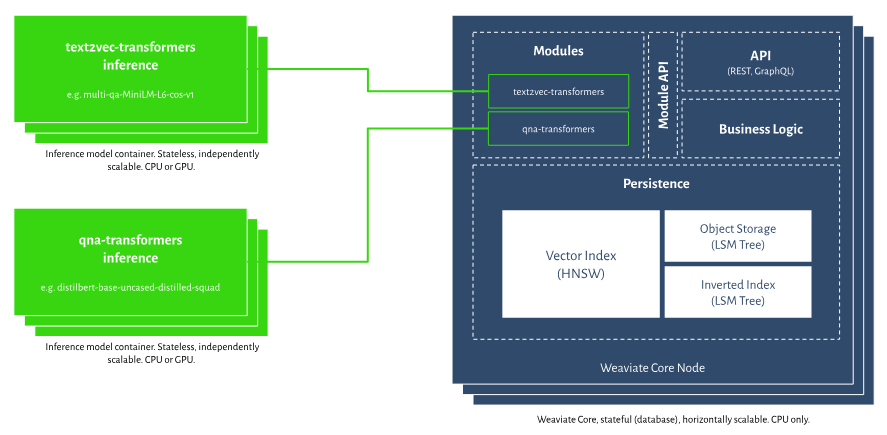
Weaviate is een betrouwbare database die data direct opslaat en zowel software- als hardwarefouten kan opvangen.
Wanneer je iets zoekt met vectoren, geeft Weaviate je het volledige data-item (soms in andere databases een "document" genoemd) in plaats van alleen een identifier zoals een ID.
Als je zowel reguliere als vectorgebaseerde zoekopdrachten gebruikt, worden de filters toegepast vóór de vectorzoektocht, zodat je precies het aantal resultaten krijgt waar je om vroeg. Dit is anders dan filteren na de zoekopdracht, waarbij het aantal resultaten kan variëren.
Je kunt data en hun vectoren vrij updaten of verwijderen, zelfs terwijl je uit de database leest.
Je kunt met Weaviate communiceren via de API's, waaronder zowel een RESTful API als een GraphQL API. Clientbibliotheken voor alle programmeertalen zijn compatibel met deze API-functies.
GraphQL is een querytaal voor API's waarmee je precies de data kunt opvragen die je nodig hebt. Het biedt een efficiëntere en flexibelere manier om met databases te werken dan traditionele methoden zoals REST.
De GraphQL-interface is om meerdere redenen gekozen, waaronder:
Elk Weaviate-object behoort tot één class. Je kunt de class handmatig maken of Auto-schema van Weaviate gebruiken om er één te genereren. Als je een class handmatig maakt, heb je meer controle over het datamodel.
Een class maken met de Python-clientbibliotheek:
class_name = "Item description"
class_object = {"class": class_name}
client.schema.create_class(class_object)
Doorgaans specificeer je ook extra configuraties; een realistischer voorbeeld, overgenomen van Weaviate.io, is:
{
"class": "Article",
"vectorizer": "text2vec-cohere",
"vectorIndexConfig": {
"distance": "cosine",
},
"moduleConfig": {
"generative-openai": {}
},
"properties": [
{
"name": "title",
"dataType": ["text"]
},
{
"name": "chunk",
"dataType": ["text"]
},
{
"name": "chunk_no",
"dataType": ["int"]
},
{
"name": "url",
"dataType": ["text"],
"tokenization": "field"
},
],
}
Let op dat een model voor vectorisatie text2vec-cohere is gedefinieerd evenals de afstandsmaat cosine. Merk op hoe properties zijn gedefinieerd als een lijst met dictionaries.
Een object hoort bij een class. Objecten kunnen class-eigenschappen weglaten en ook nieuwe eigenschappen toevoegen. Hieronder staat een voorbeeld van het toevoegen van een object aan de class Article.
uuid = client.data_object.create({
'question': 'question here ...',
'answer': 'answer here ...'
}, 'Article')
Je kunt optioneel een vector toewijzen om elk object te representeren. Als je geen vector definieert, gebruikt Weaviate de standaard vectorizer.
uuid = client.data_object.create(
data_object={
'question': 'question here ...',
'answer': 'answer here ...',
},
class_name='Article',
vector=[0.12345] * 1536Dit is een voorbeeld waarin we laten zien hoe je een class maakt en vervolgens een object aan de class toevoegt met de Python-client van Weaviate. Je moet eerst de Python-client met pip installeren.
!pip install -U weaviate-clientOm met Weaviate te werken heb je een werkende instantie van Weaviate nodig. Er zijn twee manieren om die te gebruiken: via een volledig beheerde, gehoste instantie op de Weaviate cloudservice. Of je gebruikt Embedded Weaviate, dat de instantie op de achtergrond van je app draait.
# For using embedded
import weaviate
from weaviate.embedded import EmbeddedOptions
import json
import os


client = weaviate.Client(
    embedded_options=EmbeddedOptions(),
    additional_headers = {
        "X-OpenAI-Api-Key": "YOUR_OPENAI_KEY"
    }
)
Een class maken is heel eenvoudig:
class_obj = {
    "class": "Question",
    "vectorizer": "text2vec-openai",
"moduleConfig": {
        "text2vec-openai": {},
        "generative-openai": {}
    }
}


client.schema.create_class(class_obj)
Als de vectorizer is ingesteld op None, moet je zelf vectoren aanleveren als een lijst.
We kunnen nu objecten toevoegen aan de aangemaakte class Question via het batchimportproces. We gebruiken jeopardy Q&A in json-formaat. Dat ziet er zo uit:
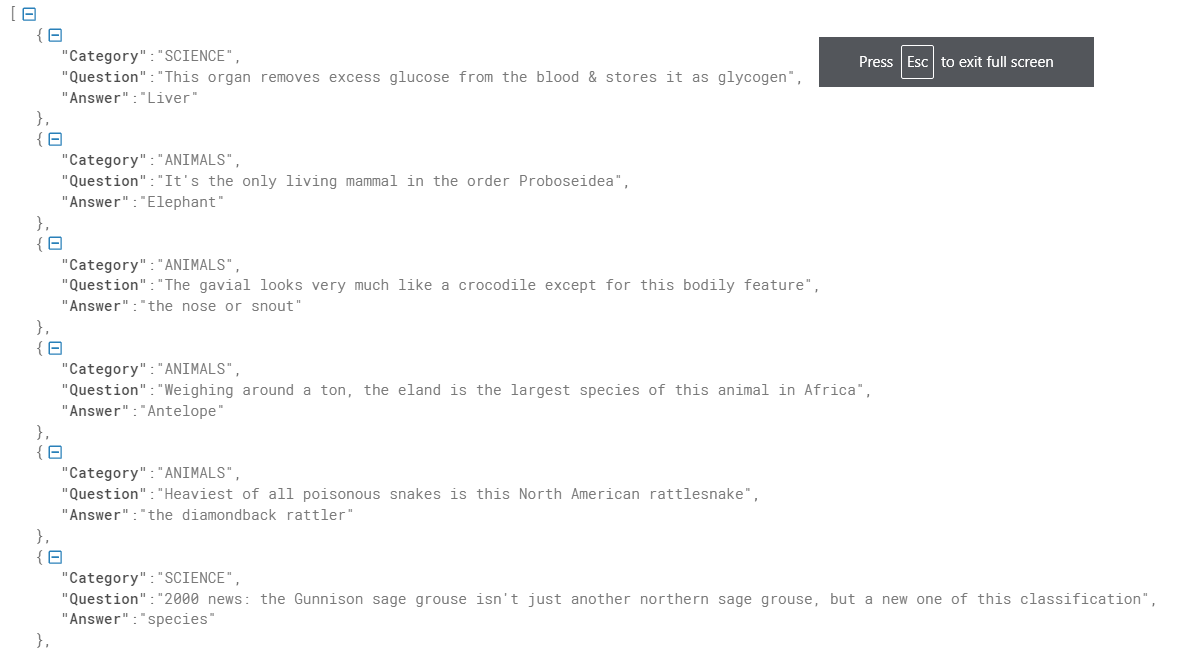
Databron (Credit: Weaviate Official)
# Load data
import requests
url = 'https://raw.githubusercontent.com/weaviate-tutorials/quickstart/main/data/jeopardy_tiny.json'
resp = requests.get(url)
data = json.loads(resp.text)


# Configure a batch process
with client.batch(
    batch_size=100
) as batch:
    # Batch import all Questions
    for i, d in enumerate(data):
        print(f"importing question: {i+1}")


        properties = {
            "answer": d["Answer"],
            "question": d["Question"],
            "category": d["Category"],
        }


        client.batch.add_data_object(
            properties,
            "Question",
        )
Dit voorbeeld is gereproduceerd met behulp van de Weaviate-documentatie.
Laten we ingaan op een paar handige tips om Weaviate effectief te gebruiken. Of je nu je schema ontwerpt, data importeert of queries optimaliseert, met deze best practices haal je het maximale uit de mogelijkheden van Weaviate.
ChromaDB is een andere populaire open-source vector database in de data science-community. Met Chroma DB kun je eenvoudig tekstdocumenten beheren, tekst omzetten naar embeddings en gelijkeniszoektochten uitvoeren. Wil je meer leren over ChromaDB, bekijk dan de Chroma DB-tutorial.
De Weaviate-tutorial biedt een uitgebreide gids om Weaviate te begrijpen en te gebruiken, een open-source, cloud-native, realtime vectorzoekmachine. De blog behandelt een breed scala aan onderwerpen: van de basis van wat Weaviate is en hoe het verschilt van traditionele databases, tot de details van de installatie en effectief gebruik.
Weaviate blinkt uit in het verwerken van ongestructureerde data via vectorembeddings, wat het tot een krachtig hulpmiddel maakt voor machine learning en AI-toepassingen. De modulaire architectuur biedt flexibiliteit, zodat je optionele modules kunt kiezen op basis van je specifieke behoeften. De blog gaat ook in op het belang van embeddings en legt uit hoe ze hoog-dimensionale data transformeren naar een formaat dat eenvoudig door AI-modellen kan worden verwerkt.
Wil je verder leren over Weaviate, bekijk dan onze webinar over Vector Databases for Data Science with Weaviate in Python.
Ga vandaag nog met AI aan de slag!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

