

Cours
Concepts d'IA générative
2 h
120.9K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleWeaviate est un moteur de recherche vectorielle open source, cloud-native, modulaire et temps réel, qui vous permet de stocker des objets de données et des embeddings vectoriels, puis de les interroger selon des mesures de similarité. Dans ce tutoriel, nous allons découvrir Weaviate et ses concepts clés, apprendre à l’installer, créer un schéma, y ajouter des données et les interroger via l’interface GraphQL de Weaviate. Nous verrons aussi comment utiliser Weaviate avec Python et partagerons des bonnes pratiques et conseils pour la conception de schémas, l’import de données et l’optimisation des requêtes.
Weaviate est une base de données vectorielle qui stocke à la fois des objets et des vecteurs, permettant de combiner recherche vectorielle et métadonnées. Modulaire, cloud-native et temps réel, elle facilite la mise à l’échelle des modèles de machine learning. Weaviate propose des modules optionnels pour le texte, l’image et d’autres types de médias, à sélectionner selon votre usage et vos données. Vous pouvez également combiner plusieurs modules en fonction de la variété des données.
Les données non structurées, comme le texte, les images et l’audio, n’ont pas de format prédéfini, ce qui complique leur traitement par les bases de données et méthodes traditionnelles.
Pour rendre ces données exploitables dans les applications d’IA et de machine learning, on les convertit en vecteurs numériques grâce aux embeddings.
Les embeddings jouent le rôle de dictionnaires spécialisés : ils transforment des données de haute dimension en représentations numériques compactes, facilitant leur traitement par les modèles d’IA.
Ils sont essentiels pour réduire la dimensionalité et dépasser les limites des méthodes d’encodage traditionnelles, permettant à l’IA de saisir les relations complexes et le contexte au sein des données.
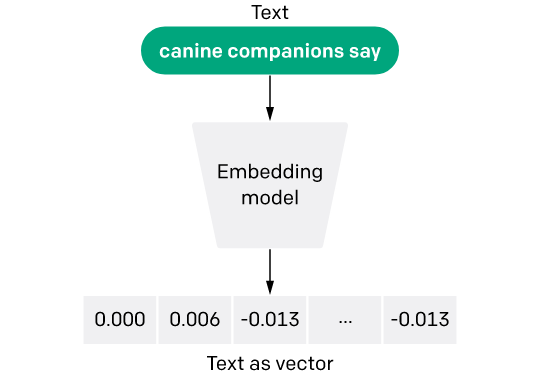
Modèle d’embedding de texte - Source de l’image
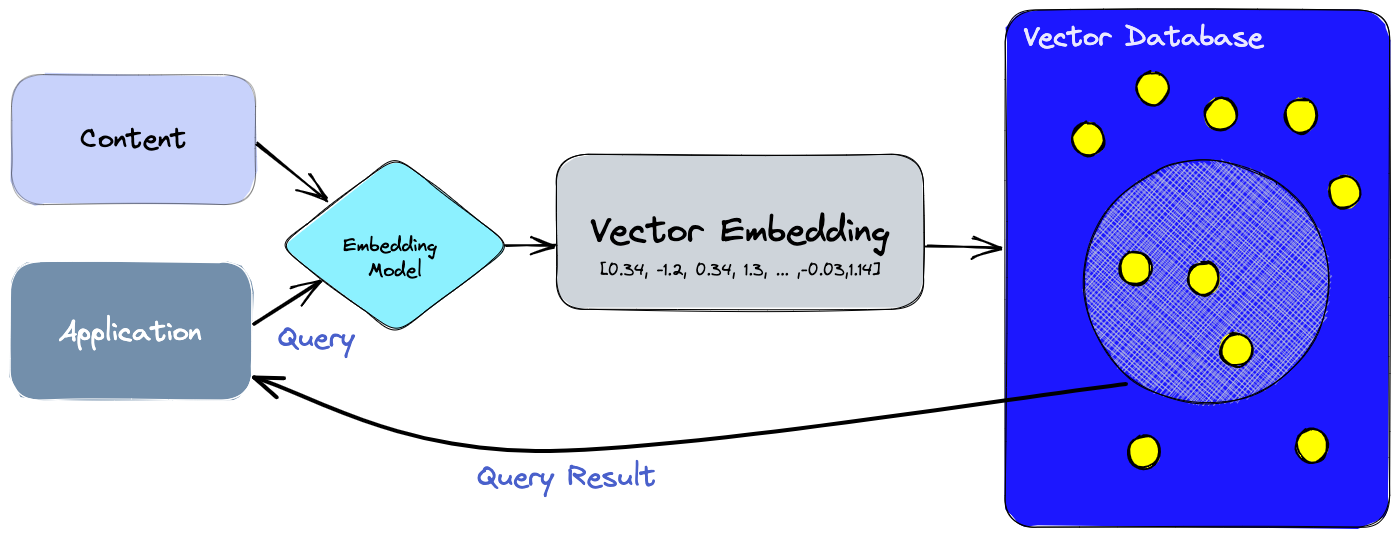
Les bases de données traditionnelles stockent les données en tables, interrogeables via SQL. Or SQL n’est pas adapté à la recherche dans des données non structurées comme le texte ou l’image. Les bases de données vectorielles, elles, stockent les données sous forme de vecteurs, interrogeables par des mesures de similarité.
Elles conviennent ainsi parfaitement à des usages comme la recherche sémantique, le question-réponse ou la recherche générative. Les vecteurs sont obtenus via un modèle d’embeddings de ML : il s’agit de la représentation numérique de l’objet d’origine (texte, image, audio, vidéo, etc.).
Imaginez un scénario où un modèle de langue analyse et classe de grands ensembles de documents textuels. Chaque document peut être transformé en un vecteur de haute dimension qui en capture l’essence sémantique.
Stocker ces vecteurs dans une base traditionnelle n’est pas optimal pour des tâches comme la recherche de similarité ou le clustering.
C’est là qu’une base vectorielle est utile : elle est optimisée pour stocker des vecteurs et effectuer des opérations vectorielles à grande vitesse, comme la recherche de plus proches voisins ou le calcul de similarité cosinus.
Pinecone est une autre base de données vectorielle très populaire, une excellente alternative à Weaviate. Pour en savoir plus sur Pinecone, consultez Mastering Vector Databases with Pinecone Tutorial.
Pour configurer Weaviate, vous pouvez utiliser Docker Compose ou l’installer manuellement. Docker Compose est recommandé car il simplifie l’installation. Une fois Weaviate installé, vous pouvez vérifier le déploiement en exécutant une requête simple.
Avec Docker Compose, téléchargez ce fichier YAML de Weaviate. Une fois le fichier en place, exécutez simplement :
docker compose up -dAutres options pour utiliser Weaviate :
Pour utiliser Weaviate en Python, installez le client Python weaviate via pip.
!pip install -U weaviate-clientDans Weaviate, chaque élément de données appartient à un groupe appelé « Class » et possède des caractéristiques appelées « Properties ». Ces éléments (représentés sous forme de documents JSON) constituent des collections basées sur des classes.
Chaque élément est représenté par un vecteur (provenant d’un modèle d’embeddings). Chaque collection regroupe des objets de même classe, définie par un schéma commun.
Weaviate est conçu de manière flexible, ce qui vous permet d’ajouter des fonctionnalités optionnelles comme la vectorisation des données ou la sauvegarde.
Sans ces modules, la version de base de Weaviate fonctionne comme une base de données spécialisée dans les données vectorielles.
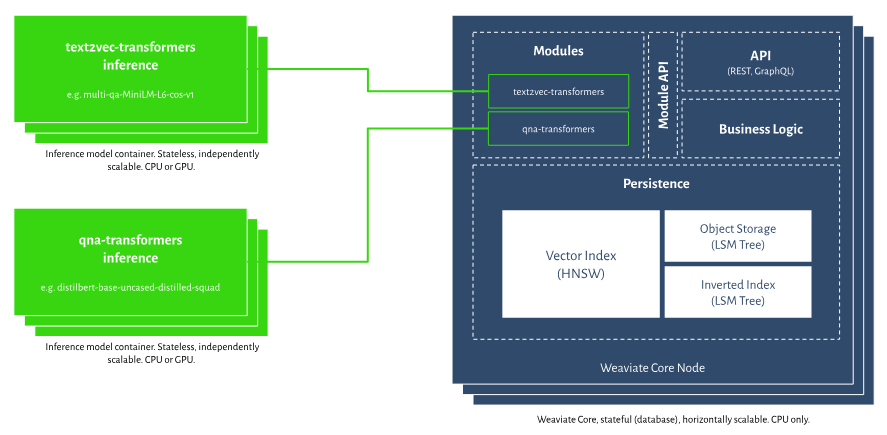
Weaviate est une base fiable, qui persiste les données immédiatement et résiste aux pannes logicielles comme matérielles.
Lors d’une recherche vectorielle, Weaviate renvoie l’objet complet (parfois appelé « document » dans d’autres bases) plutôt qu’un simple identifiant.
Si vous combinez recherche classique et vectorielle, les filtres sont appliqués avant la recherche vectorielle, ce qui garantit d’obtenir exactement le nombre de résultats demandé. C’est différent d’un filtrage après coup, où le nombre de résultats peut varier.
Vous pouvez mettre à jour ou supprimer librement des données et leurs vecteurs, même en cours de lecture.
Vous pouvez interagir avec Weaviate via ses API, notamment une API REST et une API GraphQL. Les bibliothèques clientes pour différents langages sont compatibles avec ces API.
GraphQL est un langage de requête pour API qui vous permet de demander exactement les données dont vous avez besoin. Il offre un moyen plus efficace et flexible d’interagir avec les bases de données que des approches traditionnelles comme REST.
L’interface GraphQL a été choisie pour plusieurs raisons, notamment :
Chaque objet Weaviate appartient à une classe. Vous pouvez créer la classe manuellement ou utiliser la fonction Auto-schema de Weaviate. La création manuelle offre davantage de contrôle sur le modèle de données.
Pour créer une classe via la bibliothèque cliente Python :
class_name = "Item description"
class_object = {"class": class_name}
client.schema.create_class(class_object)
En pratique, vous spécifierez aussi des paramétrages supplémentaires. Un exemple plus réaliste, inspiré de Weaviate.io, serait :
{
"class": "Article",
"vectorizer": "text2vec-cohere",
"vectorIndexConfig": {
"distance": "cosine",
},
"moduleConfig": {
"generative-openai": {}
},
"properties": [
{
"name": "title",
"dataType": ["text"]
},
{
"name": "chunk",
"dataType": ["text"]
},
{
"name": "chunk_no",
"dataType": ["int"]
},
{
"name": "url",
"dataType": ["text"],
"tokenization": "field"
},
],
}
Remarquez qu’un modèle de vectorisation text2vec-cohere ainsi qu’une mesure de distance cosine sont définis. Notez aussi que les propriétés sont indiquées sous forme d’une liste de dictionnaires.
Un objet appartient à une classe. Les objets peuvent omettre certaines propriétés de la classe ou en ajouter de nouvelles. Ci-dessous, un exemple d’ajout d’un objet à la classe Article.
uuid = client.data_object.create({
'question': 'question here ...',
'answer': 'answer here ...'
}, 'Article')
Vous pouvez également attribuer un vecteur à chaque objet. Si vous n’en fournissez pas, Weaviate utilisera son vectoriseur par défaut.
uuid = client.data_object.create(
data_object={
'question': 'question here ...',
'answer': 'answer here ...',
},
class_name='Article',
vector=[0.12345] * 1536Voici un exemple qui montre comment créer une classe puis y ajouter un objet avec le client Python de Weaviate. Vous devez d’abord installer le client Python via pip.
!pip install -U weaviate-clientPour travailler avec Weaviate, vous devez disposer d’une instance opérationnelle. Deux options : utiliser une instance hébergée et entièrement managée sur le service cloud Weaviate, ou utiliser Weaviate en mode Embedded, qui exécute l’instance en arrière-plan de votre application.
# For using embedded
import weaviate
from weaviate.embedded import EmbeddedOptions
import json
import os


client = weaviate.Client(
    embedded_options=EmbeddedOptions(),
    additional_headers = {
        "X-OpenAI-Api-Key": "YOUR_OPENAI_KEY"
    }
)
La création d’une classe est très simple :
class_obj = {
    "class": "Question",
    "vectorizer": "text2vec-openai",
"moduleConfig": {
        "text2vec-openai": {},
        "generative-openai": {}
    }
}


client.schema.create_class(class_obj)
Si le vectoriseur est défini à None, vous devrez alors fournir vous-même les vecteurs sous forme de liste.
Nous pouvons maintenant ajouter des objets à la classe Question via un import par lots. Nous utiliserons les Q&R de Jeopardy au format JSON. Voici à quoi cela ressemble :
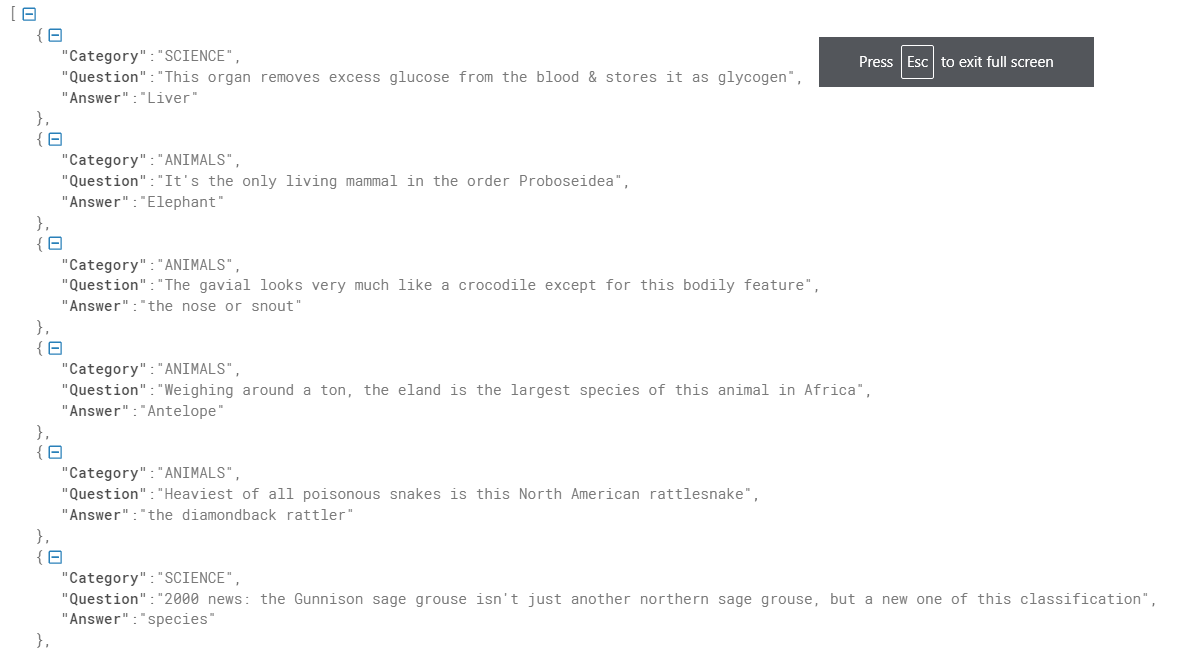
Source des données (Crédit : Weaviate officiel)
# Load data
import requests
url = 'https://raw.githubusercontent.com/weaviate-tutorials/quickstart/main/data/jeopardy_tiny.json'
resp = requests.get(url)
data = json.loads(resp.text)


# Configure a batch process
with client.batch(
    batch_size=100
) as batch:
    # Batch import all Questions
    for i, d in enumerate(data):
        print(f"importing question: {i+1}")


        properties = {
            "answer": d["Answer"],
            "question": d["Question"],
            "category": d["Category"],
        }


        client.batch.add_data_object(
            properties,
            "Question",
        )
Cet exemple a été reproduit à partir de la documentation Weaviate.
Passons en revue quelques astuces pour utiliser Weaviate efficacement. Que vous conçoivez votre schéma, importiez des données ou optimisiez des requêtes, ces bonnes pratiques vous aideront à tirer le meilleur parti de Weaviate.
ChromaDB est une autre base de données vectorielle open source prisée dans la communauté data. Avec ChromaDB, vous gérez facilement des documents texte, convertissez le texte en embeddings et effectuez des recherches de similarité. Pour en savoir plus, consultez le tutoriel ChromaDB.
Ce tutoriel Weaviate est un guide complet pour comprendre et exploiter Weaviate, un moteur de recherche vectorielle open source, cloud-native et temps réel. L’article couvre un large éventail de sujets : définition de Weaviate et différences avec les bases traditionnelles, jusqu’à la mise en place et l’utilisation au quotidien.
Weaviate excelle dans la gestion des données non structurées via les embeddings, ce qui en fait un outil puissant pour les applications de machine learning et d’IA. Son architecture modulaire offre une grande flexibilité, vous permettant de choisir des modules optionnels selon vos besoins. L’article insiste aussi sur l’importance des embeddings, qui transforment des données de haute dimension en un format facilement exploitable par les modèles d’IA.
Pour poursuivre votre apprentissage sur Weaviate, visionnez notre webinaire Vector Databases for Data Science with Weaviate in Python.
Commencez à travailler avec l’IA dès aujourd’hui !
Cours
Cursus
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Kurtis Pykes
15 min
blog
Kurtis Pykes
9 min
Tutoriel
Tutoriel
Laiba Siddiqui
14 min
Tutoriel
Aditya Sharma
7 min
Tutoriel
Laiba Siddiqui
6 min




