Curso
Conceitos de IA Generativa
2 h
117.2K
Weaviate é um mecanismo de busca vetorial open source, cloud-native, modular e em tempo real, que permite armazenar objetos de dados e embeddings vetoriais e consultá-los com base em medidas de similaridade. Neste tutorial, vamos explorar o Weaviate e seus conceitos centrais, aprender como configurá-lo, criar um esquema, inserir dados e consultar essas informações usando a interface GraphQL do Weaviate. Também veremos como usar o Weaviate com Python e discutiremos boas práticas e dicas para design de esquema, importação de dados e otimização de consultas.
Weaviate é um banco de dados vetorial que armazena objetos e vetores, permitindo combinar busca vetorial. Ele é modular, cloud-native e em tempo real, o que facilita a escala de modelos de machine learning. O Weaviate vem com módulos opcionais para texto, imagem e outros tipos de mídia, que você pode escolher de acordo com sua tarefa e seus dados. Também é possível usar mais de um módulo, dependendo da variedade de dados.
Dados não estruturados, como textos, imagens e áudios, não têm um formato pré-definido, o que dificulta o tratamento por bancos de dados e métodos tradicionais.
Para tornar esses dados utilizáveis em aplicações de IA e machine learning, eles são convertidos em vetores numéricos por meio de embeddings.
Embeddings funcionam como dicionários especializados que transformam dados de alta dimensionalidade em representações numéricas compactas, facilitando o processamento eficiente pelos modelos de IA.
Eles são essenciais para reduzir a dimensionalidade dos dados e superar limitações de métodos tradicionais de codificação, permitindo que a IA compreenda relações complexas e contexto dentro dos dados.
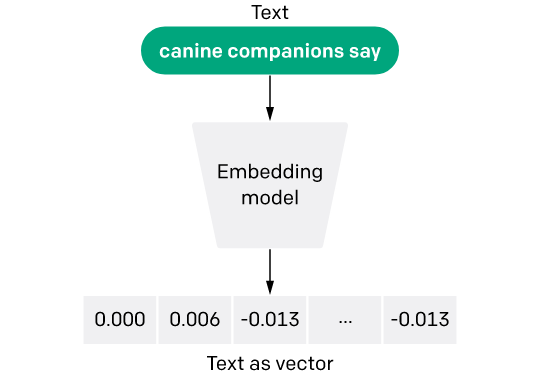
Modelo de embedding de texto - fonte da imagem
Bancos de dados tradicionais armazenam dados em tabelas, que podem ser consultadas usando SQL. No entanto, SQL não é adequado para buscar dados não estruturados, como textos ou imagens. Já os bancos de dados vetoriais armazenam dados como vetores, que podem ser consultados por meio de medidas de similaridade.
Isso os torna ideais para tarefas como busca semântica, resposta a perguntas e busca generativa. Os vetores são obtidos usando modelos de embeddings de ML. São apenas representações numéricas do objeto original, como texto, imagem, áudio, vídeo etc.
Considere um cenário em que um modelo de linguagem é usado para analisar e categorizar grandes conjuntos de documentos de texto. Cada documento pode ser transformado em um vetor de alta dimensionalidade que encapsula sua essência semântica.
Armazenar esses vetores em um banco tradicional pode não ser eficiente para tarefas como busca por similaridade ou clustering.
É aí que entra um banco de dados vetorial. Ele é otimizado para armazenar vetores e realizar operações vetoriais em alta velocidade, como encontrar vizinhos mais próximos ou calcular a similaridade do cosseno entre vetores.
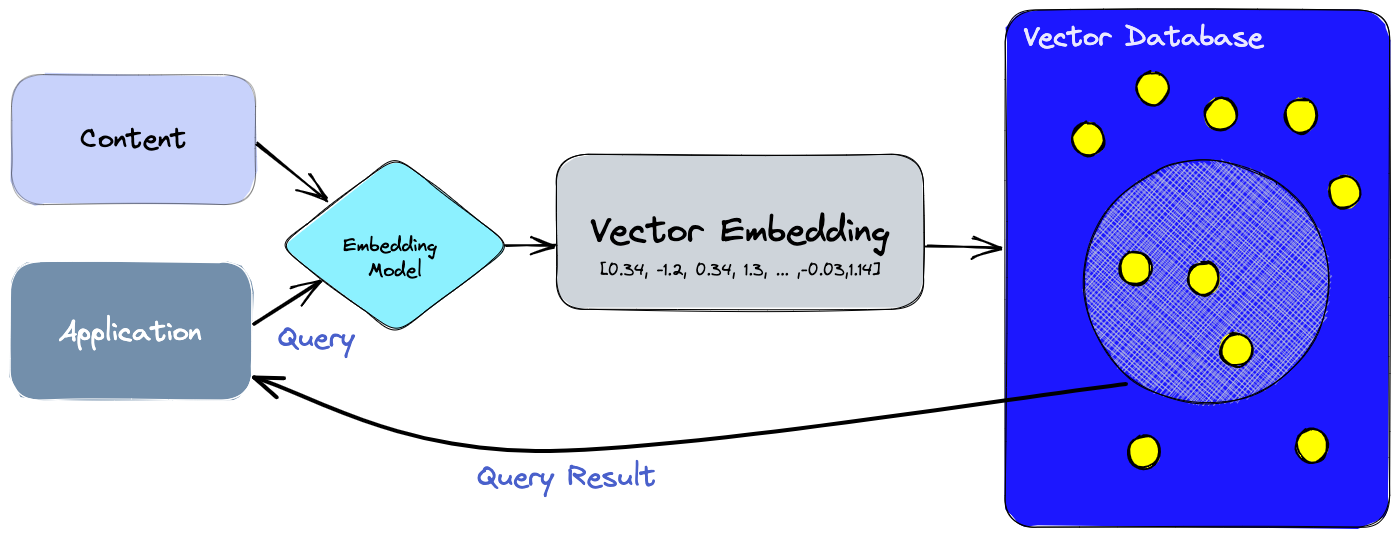
Pinecone é outro banco de dados vetorial popular e uma ótima alternativa ao Weaviate. Se quiser saber mais sobre Pinecone, confira o tutorial Mastering Vector Databases with Pinecone.
Para configurar o Weaviate, você pode usar Docker Compose ou fazer a instalação manualmente. O Docker Compose é o método recomendado, pois simplifica o processo. Depois de instalar o Weaviate, você pode validar a instalação executando uma consulta simples.
Para o Docker Compose, baixe este arquivo YAML do Weaviate. Com o arquivo em mãos, basta executar:
docker compose up -dOutras formas de usar o Weaviate:
Para usar o Weaviate em Python, instale o cliente Python do weaviate via pip.
!pip install -U weaviate-clientNo Weaviate, cada item de dado pertence a um grupo chamado "Class" e possui certas características chamadas "Properties". Esses itens de dados (representados como documentos JSON) formam coleções baseadas em classes.
Cada item é representado por um vetor (modelo de embeddings de machine learning). Cada coleção baseada em classe contém objetos da mesma classe, definidos por um esquema comum.
O Weaviate foi construído de forma flexível, permitindo adicionar recursos opcionais como vetorização de dados ou criação de backups.
Sem esses complementos, a versão básica do Weaviate funciona como um banco de dados projetado especificamente para dados vetoriais.
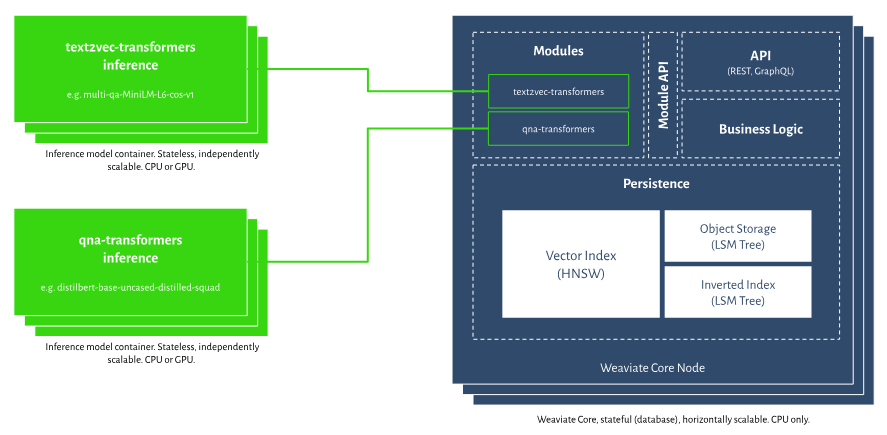
Weaviate é um banco de dados confiável que grava os dados imediatamente e lida bem com falhas de software e hardware.
Quando você busca algo usando vetores, o Weaviate retorna o item completo (às vezes chamado de "document" em outros bancos) em vez de apenas um identificador como um ID.
Se você combinar buscas tradicionais e vetoriais, os filtros são aplicados antes da busca vetorial, garantindo que você receba exatamente a quantidade de resultados solicitada. Isso difere do filtro depois da busca, quando a contagem de resultados pode variar.
Você pode atualizar ou excluir dados e seus vetores livremente, mesmo enquanto lê do banco.
Você pode interagir com o Weaviate usando suas APIs, que incluem uma API RESTful e uma API GraphQL. As bibliotecas cliente de todas as linguagens são compatíveis com esses recursos de API.
GraphQL é uma linguagem de consultas para APIs que permite solicitar exatamente os dados de que você precisa. Ela oferece uma forma mais eficiente e flexível de interagir com bancos de dados em comparação a métodos tradicionais como REST.
A interface GraphQL foi escolhida por vários motivos, incluindo:
Cada objeto do Weaviate pertence a uma classe. Você pode criar a classe manualmente ou usar o Auto-schema do Weaviate para gerá-la. Ao criar a classe manualmente, você tem mais controle sobre o modelo de dados.
Para criar uma classe usando a biblioteca cliente em Python:
class_name = "Item description"
class_object = {"class": class_name}
client.schema.create_class(class_object)
Normalmente, você também vai especificar configurações adicionais. Um exemplo mais realista, retirado do Weaviate.io, seria:
{
"class": "Article",
"vectorizer": "text2vec-cohere",
"vectorIndexConfig": {
"distance": "cosine",
},
"moduleConfig": {
"generative-openai": {}
},
"properties": [
{
"name": "title",
"dataType": ["text"]
},
{
"name": "chunk",
"dataType": ["text"]
},
{
"name": "chunk_no",
"dataType": ["int"]
},
{
"name": "url",
"dataType": ["text"],
"tokenization": "field"
},
],
}
Note que um modelo de vetorização text2vec-cohere foi definido, bem como a métrica de distância cosine. Observe também como as propriedades são definidas como uma lista de dicionários.
O objeto pertence a uma classe. Objetos podem omitir propriedades da classe e também adicionar novas propriedades. Abaixo está um exemplo de inclusão de um objeto na classe Article.
uuid = client.data_object.create({
'question': 'question here ...',
'answer': 'answer here ...'
}, 'Article')
Você pode, opcionalmente, atribuir um vetor para representar cada objeto. Se não definir um vetor, o Weaviate usará seu vetorizador padrão.
uuid = client.data_object.create(
data_object={
'question': 'question here ...',
'answer': 'answer here ...',
},
class_name='Article',
vector=[0.12345] * 1536Este é um exemplo que mostra como criar uma classe e depois adicionar um objeto à classe usando o cliente Python do Weaviate. Antes, você precisa instalar o cliente Python com pip.
!pip install -U weaviate-clientPara trabalhar com o Weaviate, você precisa de uma instância funcional do Weaviate. Há duas formas de usá-lo: utilizando uma instância totalmente gerenciada e hospedada no serviço em nuvem do Weaviate ou usando o Weaviate Embedded, que executa a instância em segundo plano no seu app.
# For using embedded
import weaviate
from weaviate.embedded import EmbeddedOptions
import json
import os


client = weaviate.Client(
    embedded_options=EmbeddedOptions(),
    additional_headers = {
        "X-OpenAI-Api-Key": "YOUR_OPENAI_KEY"
    }
)
Criar uma classe é bem direto:
class_obj = {
    "class": "Question",
    "vectorizer": "text2vec-openai",
"moduleConfig": {
        "text2vec-openai": {},
        "generative-openai": {}
    }
}


client.schema.create_class(class_obj)
Se o vetorizador for definido como None, você precisará fornecer os vetores manualmente como uma lista.
Agora podemos adicionar objetos à classe Question criada por meio do processo de importação em lote. Vamos usar o conjunto Jeopardy Q&A em formato JSON. Ele se parece com isto:
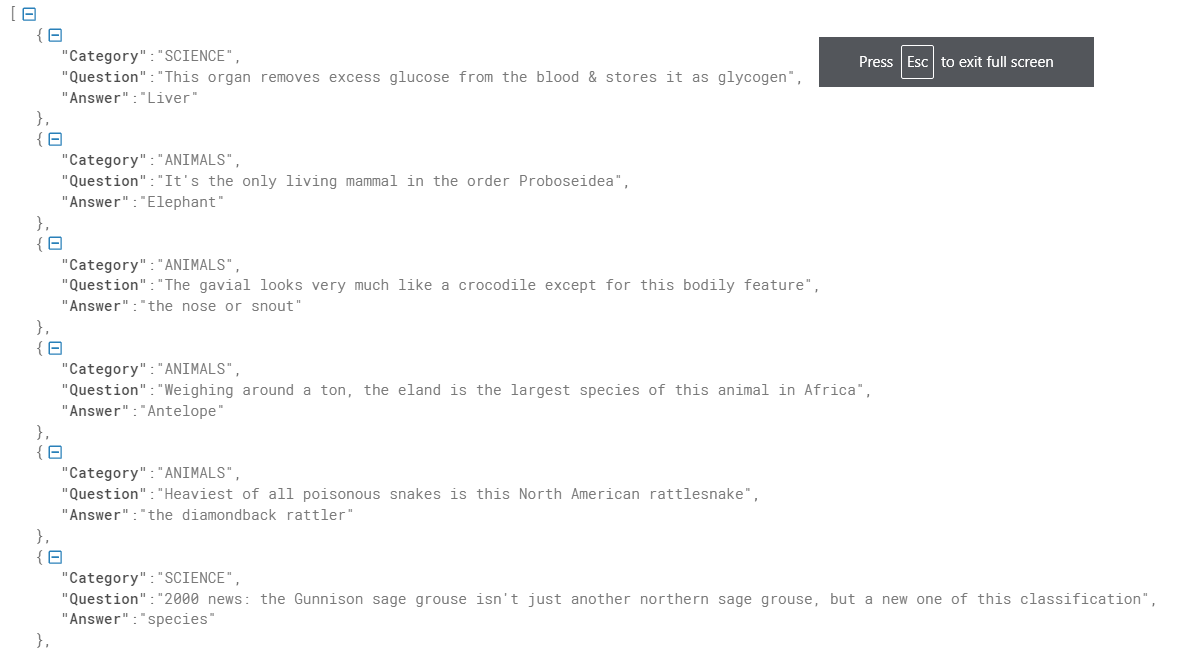
fonte dos dados (Crédito: Weaviate Official)
# Load data
import requests
url = 'https://raw.githubusercontent.com/weaviate-tutorials/quickstart/main/data/jeopardy_tiny.json'
resp = requests.get(url)
data = json.loads(resp.text)


# Configure a batch process
with client.batch(
    batch_size=100
) as batch:
    # Batch import all Questions
    for i, d in enumerate(data):
        print(f"importing question: {i+1}")


        properties = {
            "answer": d["Answer"],
            "question": d["Question"],
            "category": d["Category"],
        }


        client.batch.add_data_object(
            properties,
            "Question",
        )
Este exemplo foi reproduzido com base na documentação do Weaviate.
Vamos ver algumas dicas úteis para usar o Weaviate com eficiência. Seja ao projetar seu esquema, importar dados ou otimizar consultas, estas boas práticas vão ajudar você a extrair o máximo das capacidades do Weaviate.
ChromaDB é outro banco vetorial open source bastante popular na comunidade de ciência de dados. Com o Chroma DB, você gerencia documentos de texto com facilidade, converte texto em embeddings e realiza buscas por similaridade. Para saber mais sobre o ChromaDB, confira o tutorial do Chroma DB.
Este tutorial do Weaviate oferece um guia completo para entender e usar o Weaviate, um mecanismo de busca vetorial open source, cloud-native e em tempo real. O conteúdo aborda desde o básico sobre o que é o Weaviate e como ele difere dos bancos tradicionais até os detalhes de configuração e uso eficaz.
O destaque do Weaviate é lidar com dados não estruturados por meio de embeddings vetoriais, tornando-o uma ferramenta poderosa para aplicações de machine learning e IA. Sua arquitetura modular traz flexibilidade, permitindo escolher módulos opcionais de acordo com suas necessidades. O conteúdo também aprofunda a importância dos embeddings, explicando como eles transformam dados de alta dimensionalidade em um formato facilmente processado por modelos de IA.
Se quiser continuar aprendendo sobre Weaviate, confira nosso webinar sobre bancos de dados vetoriais para data science com Weaviate em Python.
Comece a trabalhar com IA hoje mesmo!
Curso
Programa
Curso
blog
Moez Ali
14 min
Tutorial
Moez Ali
10 min
Tutorial
Tutorial
Zoumana Keita
14 min
Tutorial
Zoumana Keita
7 min
Tutorial
Arunn Thevapalan
12 min