
Khóa học
Các khái niệm về Generative AI
2 giờ
121.1K
Weaviate là một công cụ tìm kiếm vector thời gian thực, mô-đun, gốc đám mây và mã nguồn mở, cho phép bạn lưu trữ các đối tượng dữ liệu và vector embedding, đồng thời truy vấn chúng dựa trên các thước đo tương đồng. Trong bài hướng dẫn này, chúng ta sẽ khám phá Weaviate và các khái niệm cốt lõi của nó, học cách thiết lập, tạo lược đồ (schema), thêm dữ liệu và truy vấn dữ liệu bằng giao diện GraphQL của Weaviate. Chúng ta cũng sẽ đề cập cách sử dụng Weaviate với Python và thảo luận các best practice cùng mẹo về thiết kế lược đồ, nhập dữ liệu và tối ưu truy vấn.
Weaviate là một cơ sở dữ liệu vector lưu trữ cả đối tượng và vector, cho phép kết hợp tìm kiếm vector. Nó có kiến trúc mô-đun, gốc đám mây và thời gian thực, giúp dễ dàng mở rộng các mô hình học máy. Weaviate đi kèm các mô-đun tùy chọn cho văn bản, hình ảnh và các loại phương tiện khác, có thể chọn dựa trên tác vụ và dữ liệu của bạn. Bạn cũng có thể sử dụng nhiều hơn một mô-đun, tùy thuộc vào sự đa dạng của dữ liệu.
Dữ liệu phi cấu trúc như văn bản, hình ảnh và âm thanh không có định dạng cố định, khiến các cơ sở dữ liệu và phương pháp truyền thống gặp khó khăn khi xử lý.
Để dữ liệu này có thể sử dụng trong ứng dụng AI và học máy, nó được chuyển đổi thành các vector số bằng embedding.
Embedding đóng vai trò như các "từ điển" chuyên biệt, biến đổi dữ liệu có số chiều cao thành dạng số gọn nhẹ, giúp mô hình AI xử lý hiệu quả.
Chúng rất quan trọng trong việc giảm chiều dữ liệu và khắc phục hạn chế của các phương pháp mã hóa truyền thống, cho phép AI hiểu các mối quan hệ phức tạp và ngữ cảnh trong dữ liệu.
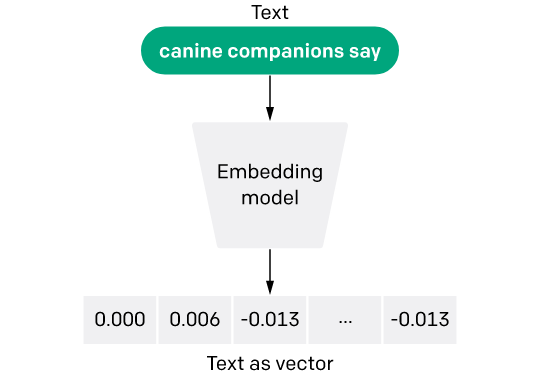
Text Embedding Model - Nguồn ảnh
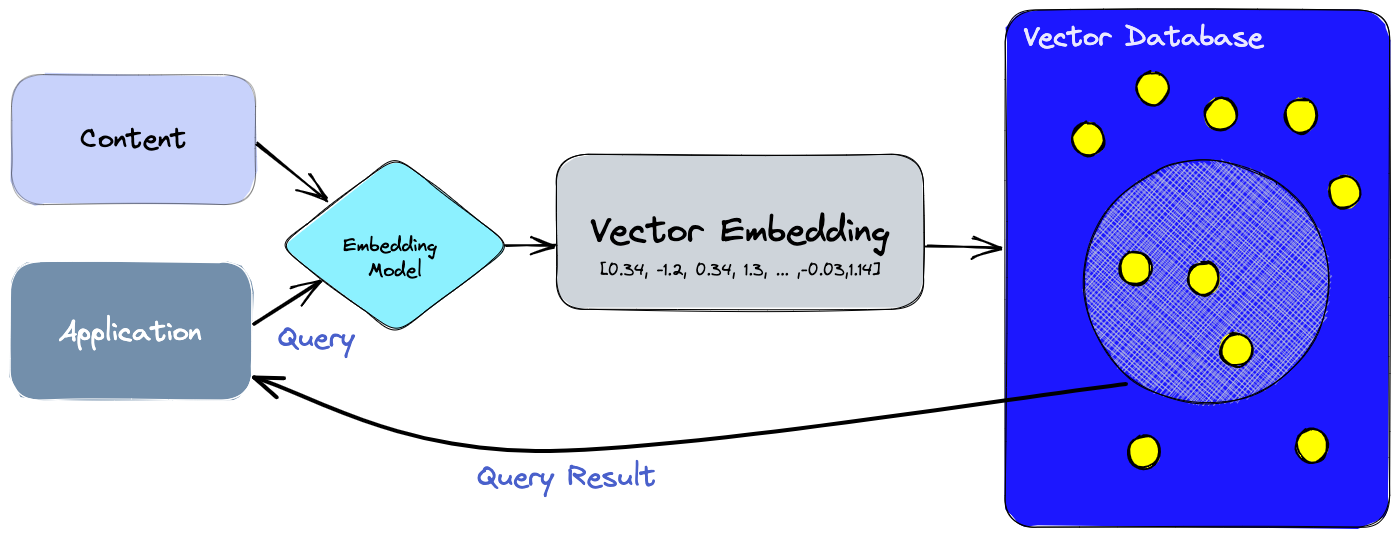
Các cơ sở dữ liệu truyền thống lưu dữ liệu trong bảng và có thể truy vấn bằng SQL. Tuy nhiên, SQL không phù hợp để tìm kiếm dữ liệu phi cấu trúc như văn bản hoặc hình ảnh. Cơ sở dữ liệu vector, ngược lại, lưu dữ liệu dưới dạng vector và có thể truy vấn bằng các thước đo tương đồng.
Điều này khiến chúng phù hợp với các tác vụ như tìm kiếm ngữ nghĩa, hỏi đáp và tìm kiếm sinh (generative search). Vector được thu được bằng mô hình embedding ML. Đây chỉ là biểu diễn số của đối tượng gốc như văn bản, hình ảnh, âm thanh, video, v.v.
Hãy xét một tình huống nơi một mô hình ngôn ngữ được dùng để phân tích và phân loại các tập tài liệu văn bản lớn. Mỗi tài liệu có thể được biến đổi thành một vector không gian chiều cao bao quát bản chất ngữ nghĩa của nó.
Lưu các vector này trong cơ sở dữ liệu truyền thống có thể không hiệu quả cho các tác vụ như tìm kiếm tương đồng hoặc gom cụm.
Đó là lúc cơ sở dữ liệu vector phát huy tác dụng. Nó được tối ưu để lưu trữ vector và thực hiện các phép toán vector tốc độ cao, như tìm láng giềng gần nhất hoặc tính độ tương đồng cosine giữa các vector.
Pinecone là một cơ sở dữ liệu vector phổ biến khác và là lựa chọn thay thế tuyệt vời cho Weaviate. Nếu bạn muốn tìm hiểu thêm về Pinecone, hãy xem Hướng dẫn làm chủ cơ sở dữ liệu vector với Pinecone.
Để thiết lập Weaviate, bạn có thể dùng Docker Compose hoặc cài đặt thủ công. Docker Compose là phương pháp được khuyến nghị vì đơn giản hóa quá trình cài đặt. Sau khi cài xong Weaviate, bạn có thể kiểm tra bằng cách chạy một truy vấn đơn giản.
Với Docker compose, hãy tải tệp yaml này từ Weaviate. Khi có tệp này, bạn chỉ cần chạy:
docker compose up -dCác cách khác để sử dụng Weaviate gồm:
Để dùng Weaviate trong Python, bạn có thể cài weaviate python client bằng pip.
!pip install -U weaviate-clientTrong Weaviate, mỗi mục dữ liệu thuộc về một nhóm gọi là "Class" và có các đặc trưng gọi là "Properties". Các mục dữ liệu này (được biểu diễn dưới dạng tài liệu JSON) là các bộ sưu tập dựa trên lớp.
Mỗi mục dữ liệu được biểu diễn bằng một vector (mô hình embedding học máy). Mỗi bộ sưu tập dựa trên lớp chứa các đối tượng của cùng một lớp, được xác định bởi một lược đồ chung.
Weaviate được xây dựng linh hoạt, cho phép bạn thêm các tính năng tùy chọn như biến dữ liệu thành vector hoặc tạo bản sao lưu.
Không có các tiện ích bổ sung này, phiên bản cơ bản của Weaviate đóng vai trò là một cơ sở dữ liệu được thiết kế riêng cho dữ liệu vector.
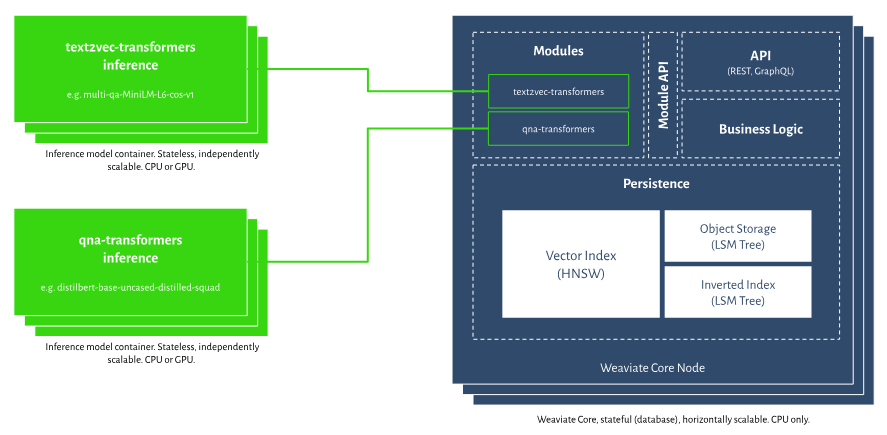
Weaviate là một cơ sở dữ liệu đáng tin cậy, lưu dữ liệu ngay lập tức và có thể chịu lỗi cả phần mềm lẫn phần cứng.
Khi bạn tìm kiếm bằng vector, Weaviate trả về toàn bộ mục dữ liệu (đôi khi được gọi là "tài liệu" trong các cơ sở dữ liệu khác) thay vì chỉ một định danh như ID.
Nếu bạn dùng cả tìm kiếm thường và tìm kiếm dựa trên vector, các bộ lọc sẽ được áp dụng trước tìm kiếm vector, đảm bảo bạn nhận đúng số lượng kết quả yêu cầu. Điều này khác với việc lọc sau khi tìm kiếm, nơi số lượng kết quả có thể thay đổi.
Bạn có thể tự do cập nhật hoặc xóa dữ liệu và vector của chúng, ngay cả khi đang đọc từ cơ sở dữ liệu.
Bạn có thể tương tác với Weaviate bằng các API của nó, bao gồm RESTful API và GraphQL API. Thư viện client cho mọi ngôn ngữ lập trình đều tương thích với các tính năng API này.
GraphQL là một ngôn ngữ truy vấn cho API cho phép bạn yêu cầu chính xác dữ liệu mình cần. Nó cung cấp cách tương tác với cơ sở dữ liệu hiệu quả và linh hoạt hơn so với các phương pháp truyền thống như REST.
Giao diện GraphQL được chọn vì nhiều lý do, bao gồm:
Mỗi đối tượng Weaviate thuộc về một class. Bạn có thể tạo class thủ công hoặc dùng Auto-schema của Weaviate để tạo. Khi tạo thủ công, bạn có sự kiểm soát nhiều hơn đối với mô hình dữ liệu.
Để tạo class bằng thư viện client python:
class_name = "Item description"
class_object = {"class": class_name}
client.schema.create_class(class_object)
Thông thường, bạn cũng sẽ chỉ định thêm các cấu hình; một ví dụ thực tế hơn lấy từ Weaviate.io như sau:
{
"class": "Article",
"vectorizer": "text2vec-cohere",
"vectorIndexConfig": {
"distance": "cosine",
},
"moduleConfig": {
"generative-openai": {}
},
"properties": [
{
"name": "title",
"dataType": ["text"]
},
{
"name": "chunk",
"dataType": ["text"]
},
{
"name": "chunk_no",
"dataType": ["int"]
},
{
"name": "url",
"dataType": ["text"],
"tokenization": "field"
},
],
}
Lưu ý rằng một mô hình để vector hóa text2vec-cohere được xác định cũng như thước đo khoảng cách cosine. Lưu ý cách các thuộc tính được định nghĩa như một danh sách các dictionary.
Object thuộc về một class. Object có thể bỏ qua các thuộc tính của class cũng như thêm thuộc tính mới. Dưới đây là ví dụ thêm một object vào class Article.
uuid = client.data_object.create({
'question': 'question here ...',
'answer': 'answer here ...'
}, 'Article')
Bạn có thể tùy chọn gán một vector để biểu diễn mỗi object. Nếu bạn không định nghĩa vector, Weaviate sẽ dùng vectorizer mặc định của nó.
uuid = client.data_object.create(
data_object={
'question': 'question here ...',
'answer': 'answer here ...',
},
class_name='Article',
vector=[0.12345] * 1536Đây là ví dụ minh họa cách tạo một class rồi thêm object vào class bằng python client của Weaviate. Trước tiên bạn phải cài python client bằng pip.
!pip install -U weaviate-clientĐể làm việc với Weaviate, bạn phải có một phiên bản Weaviate đang chạy. Có hai cách để sử dụng: thứ nhất là dùng phiên bản lưu trữ được quản lý hoàn toàn trên dịch vụ đám mây của Weaviate. Hoặc bạn có thể dùng Weaviate Embedded, chạy phiên bản ở hậu cảnh ứng dụng của bạn.
# For using embedded
import weaviate
from weaviate.embedded import EmbeddedOptions
import json
import os


client = weaviate.Client(
    embedded_options=EmbeddedOptions(),
    additional_headers = {
        "X-OpenAI-Api-Key": "YOUR_OPENAI_KEY"
    }
)
Tạo một class rất đơn giản:
class_obj = {
    "class": "Question",
    "vectorizer": "text2vec-openai",
"moduleConfig": {
        "text2vec-openai": {},
        "generative-openai": {}
    }
}


client.schema.create_class(class_obj)
Nếu vectorizer được đặt là None thì bạn sẽ phải tự cung cấp vector dưới dạng danh sách.
Giờ chúng ta có thể thêm object vào class Question vừa tạo thông qua quy trình nhập theo lô. Chúng ta sẽ dùng dữ liệu hỏi đáp Jeopardy ở định dạng json. Dữ liệu trông như sau:
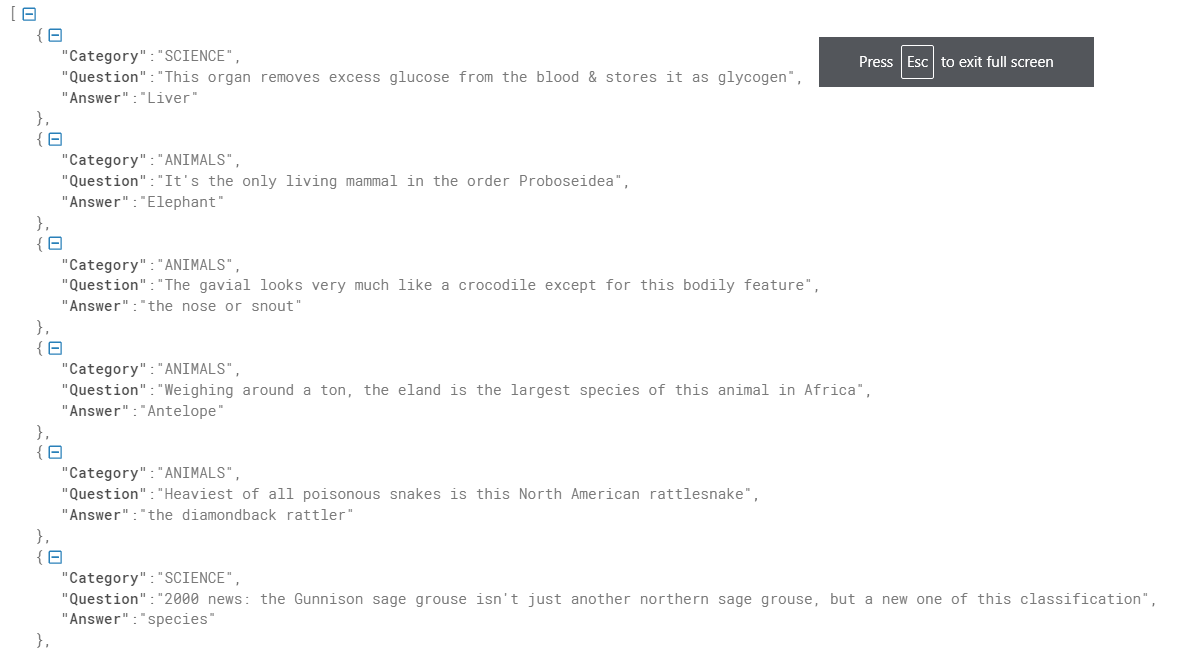
Nguồn dữ liệu (Nguồn: Weaviate Official)
# Load data
import requests
url = 'https://raw.githubusercontent.com/weaviate-tutorials/quickstart/main/data/jeopardy_tiny.json'
resp = requests.get(url)
data = json.loads(resp.text)


# Configure a batch process
with client.batch(
    batch_size=100
) as batch:
    # Batch import all Questions
    for i, d in enumerate(data):
        print(f"importing question: {i+1}")


        properties = {
            "answer": d["Answer"],
            "question": d["Question"],
            "category": d["Category"],
        }


        client.batch.add_data_object(
            properties,
            "Question",
        )
Ví dụ này được tái hiện dựa trên tài liệu của Weaviate.
Hãy đi sâu vào một số gợi ý hữu ích để sử dụng Weaviate hiệu quả. Dù bạn đang thiết kế lược đồ, nhập dữ liệu hay tối ưu truy vấn, các best practice này sẽ giúp bạn khai thác tối đa khả năng của Weaviate.
ChromaDB là một cơ sở dữ liệu vector mã nguồn mở phổ biến khác trong cộng đồng khoa học dữ liệu. Với Chroma DB, bạn có thể dễ dàng quản lý tài liệu văn bản, chuyển văn bản thành embedding và thực hiện tìm kiếm tương đồng. Nếu muốn tìm hiểu thêm về ChromaDB, hãy xem Hướng dẫn Chroma DB.
Hướng dẫn Weaviate cung cấp cái nhìn toàn diện để hiểu và sử dụng Weaviate, một công cụ tìm kiếm vector thời gian thực, gốc đám mây và mã nguồn mở. Bài viết bao quát nhiều chủ đề, từ những điều cơ bản về Weaviate là gì và khác gì so với cơ sở dữ liệu truyền thống, đến chi tiết cách thiết lập và sử dụng hiệu quả.
Weaviate nổi bật ở khả năng xử lý dữ liệu phi cấu trúc thông qua embedding vector, trở thành công cụ mạnh mẽ cho các ứng dụng học máy và AI. Kiến trúc mô-đun mang lại sự linh hoạt, cho phép bạn chọn các mô-đun tùy chọn theo nhu cầu cụ thể. Bài viết cũng đi sâu vào tầm quan trọng của embedding, giải thích cách chúng biến đổi dữ liệu có số chiều cao thành định dạng mà mô hình AI có thể xử lý dễ dàng.
Nếu bạn muốn tiếp tục học về Weaviate, hãy xem hội thảo trực tuyến của chúng tôi về Cơ sở dữ liệu vector cho Khoa học Dữ liệu với Weaviate trong Python.
Bắt đầu làm việc với AI ngay hôm nay!
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
