
Kurs
Konzeptuelle Einführung in generative KI
2 Std.
117.2K
Weaviate ist eine Open-Source-, Cloud-native, modulare Vektorsuchmaschine in Echtzeit. Sie speichert Datenobjekte und Vektoreinbettungen und erlaubt Abfragen auf Basis von Ähnlichkeitsmaßen. In diesem Tutorial schauen wir uns Weaviate und seine Kernkonzepte an, richten eine Instanz ein, erstellen ein Schema, fügen Daten hinzu und stellen Abfragen über die GraphQL-Schnittstelle von Weaviate. Außerdem zeigen wir, wie du Weaviate mit Python nutzt, und geben Best Practices sowie Tipps zu Schemadesign, Datenimport und Query-Optimierung.
Weaviate ist eine Vektordatenbank, die sowohl Objekte als auch Vektoren speichert und damit Vektorsuche ermöglicht. Sie ist modular, Cloud-native und für den Echtzeitbetrieb ausgelegt, wodurch sich Machine-Learning-Modelle leicht skalieren lassen. Weaviate bringt optionale Module für Text, Bilder und andere Medientypen mit, die du je nach Aufgabe und Daten auswählen kannst. Je nach Datenvielfalt kannst du auch mehrere Module kombinieren.
Unstrukturierte Daten wie Text, Bilder und Audio haben kein vordefiniertes Format und sind für klassische Datenbanken und Methoden schwer zu handhaben.
Damit solche Daten in KI- und Machine-Learning-Anwendungen nutzbar werden, werden sie mit Embeddings in numerische Vektoren umgewandelt.
Embeddings fungieren wie spezialisierte Wörterbücher, die hochdimensionale Daten in kompakte Zahlenformen übertragen, sodass KI-Modelle sie effizient verarbeiten können.
Sie sind entscheidend, um die Dimensionalität zu reduzieren und Grenzen klassischer Kodierungsmethoden zu überwinden. So kann KI komplexe Beziehungen und Kontexte in den Daten erfassen.
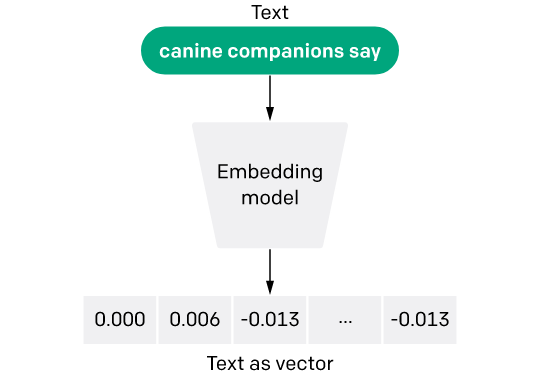
Text Embedding Model - Image Source
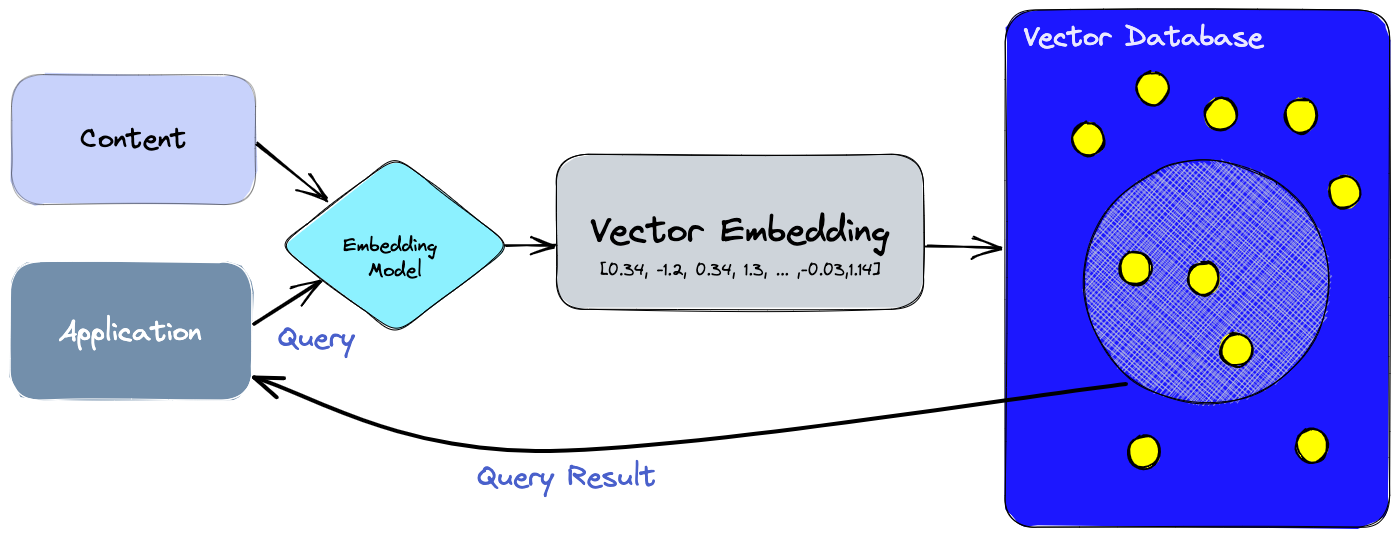
Klassische Datenbanken speichern Daten in Tabellen, die sich mit SQL abfragen lassen. SQL eignet sich jedoch kaum für die Suche in unstrukturierten Daten wie Texten oder Bildern. Vektordatenbanken hingegen speichern Daten als Vektoren, die über Ähnlichkeitsmaße abgefragt werden.
Damit sind sie ideal für Aufgaben wie semantische Suche, Question Answering und generative Suche. Vektoren entstehen über ML-Embedding-Modelle. Sie sind die numerische Repräsentation des ursprünglichen Objekts, etwa Text, Bild, Audio, Video usw.
Stell dir vor, ein Sprachmodell soll große Mengen an Textdokumenten analysieren und kategorisieren. Jedes Dokument wird in einen hochdimensionalen Vektor überführt, der seine semantische Essenz abbildet.
Das Speichern dieser Vektoren in einer klassischen Datenbank ist für Aufgaben wie Ähnlichkeitssuche oder Clustering meist ineffizient.
Hier kommen Vektordatenbanken ins Spiel. Sie sind darauf optimiert, Vektoren zu speichern und schnelle Vektoroperationen auszuführen, etwa die Suche nach nächsten Nachbarn oder die Berechnung der Kosinusähnlichkeit zwischen Vektoren.
Pinecone ist eine weitere beliebte Vektordatenbank und eine starke Alternative zu Weaviate. Wenn du mehr über Pinecone wissen willst, sieh dir das Mastering Vector Databases with Pinecone Tutorial an.
Zur Einrichtung von Weaviate kannst du Docker Compose verwenden oder eine manuelle Installation vornehmen. Empfohlen wird Docker Compose, da es die Installation stark vereinfacht. Nach der Installation kannst du die Instanz mit einer einfachen Abfrage prüfen.
Für Docker Compose lädst du diese YAML-Datei von Weaviate herunter. Mit der Datei kannst du einfach ausführen:
docker compose up -dWeitere Optionen für die Nutzung von Weaviate sind:
Um Weaviate in Python zu nutzen, installierst du den Weaviate-Python-Client mit pip.
!pip install -U weaviate-clientIn Weaviate gehört jedes Datenelement zu einer Gruppe namens "Class" und besitzt bestimmte Merkmale, die als "Properties" bezeichnet werden. Diese Datenelemente (als JSON-Dokumente dargestellt) sind klassenbasierte Sammlungen.
Jedes Datenelement wird durch einen Vektor repräsentiert (Embedding-Modell aus dem Machine Learning). Jede klassenbasierte Sammlung enthält Objekte derselben Klasse, die durch ein gemeinsames Schema definiert ist.
Weaviate ist flexibel aufgebaut und erlaubt es dir, optionale Funktionen hinzuzufügen, etwa das Vektorisieren von Daten oder das Erstellen von Backups.
Ohne diese Add-ons dient die Basisversion von Weaviate als Datenbank, die speziell für Vektordaten entwickelt wurde.
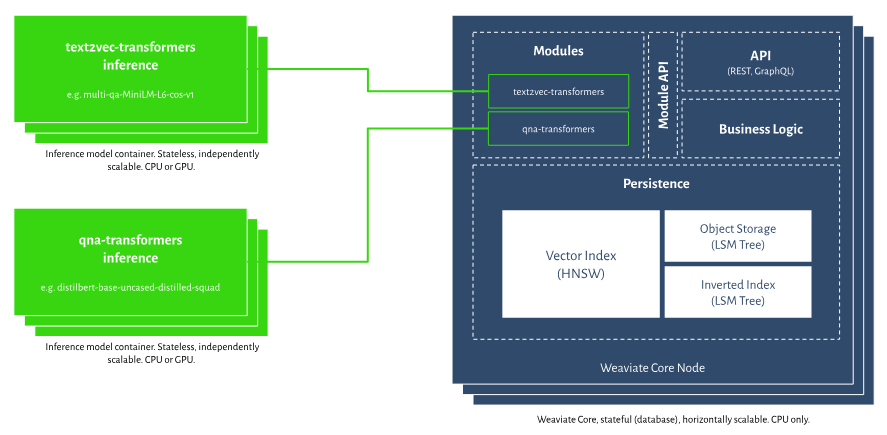
Weaviate ist eine ausfallsichere Datenbank, die Daten sofort speichert und sowohl Software- als auch Hardwarefehler verkraftet.
Bei einer Vektorsuche liefert Weaviate das komplette Datenelement (in anderen Datenbanken oft als "Dokument" bezeichnet) statt nur eines Identifikators wie einer ID.
Wenn du klassische und vektorbasiere Suchen kombinierst, werden Filter vor der Vektorsuche angewendet. So erhältst du genau die Anzahl an Ergebnissen, die du angefordert hast. Das unterscheidet sich vom Filtern nach der Suche, bei dem die Trefferzahl variieren kann.
Du kannst Daten und ihre Vektoren jederzeit aktualisieren oder löschen, auch während aus der Datenbank gelesen wird.
Du kannst per API mit Weaviate interagieren: Es gibt sowohl eine RESTful API als auch eine GraphQL-API. Client-Bibliotheken aller Programmiersprachen unterstützen diese API-Funktionen.
GraphQL ist eine Abfragesprache für APIs, mit der du genau die Daten anfordern kannst, die du brauchst. Im Vergleich zu klassischen Ansätzen wie REST ist die Interaktion effizienter und flexibler.
Die GraphQL-Schnittstelle wurde aus mehreren Gründen gewählt, unter anderem:
Jedes Weaviate-Objekt gehört zu genau einer Klasse. Du kannst die Klasse manuell anlegen oder mit dem Auto-schema von Weaviate erzeugen. Bei der manuellen Erstellung hast du mehr Kontrolle über das Datenmodell.
So erstellst du eine Klasse mit der Python-Clientbibliothek:
class_name = "Item description"
class_object = {"class": class_name}
client.schema.create_class(class_object)
In der Praxis gibst du in der Regel weitere Konfigurationen an. Ein realistischeres Beispiel, angelehnt an Weaviate.io, wäre:
{
"class": "Article",
"vectorizer": "text2vec-cohere",
"vectorIndexConfig": {
"distance": "cosine",
},
"moduleConfig": {
"generative-openai": {}
},
"properties": [
{
"name": "title",
"dataType": ["text"]
},
{
"name": "chunk",
"dataType": ["text"]
},
{
"name": "chunk_no",
"dataType": ["int"]
},
{
"name": "url",
"dataType": ["text"],
"tokenization": "field"
},
],
}
Beachte, dass ein Modell zur Vektorisierung text2vec-cohere sowie das Distanzmaß cosine definiert ist. Außerdem sind die Properties als Liste von Dictionaries angelegt.
Ein Objekt gehört zu einer Klasse. Objekte können Klassen-Properties auslassen oder zusätzliche Properties hinzufügen. Unten ein Beispiel, wie du ein Objekt zur Klasse Article hinzufügst.
uuid = client.data_object.create({
'question': 'question here ...',
'answer': 'answer here ...'
}, 'Article')
Optional kannst du jedem Objekt einen eigenen Vektor zuweisen. Wenn du keinen Vektor angibst, nutzt Weaviate den Standard-Vektorisierer.
uuid = client.data_object.create(
data_object={
'question': 'question here ...',
'answer': 'answer here ...',
},
class_name='Article',
vector=[0.12345] * 1536Dieses Beispiel zeigt, wie du eine Klasse erstellst und anschließend ein Objekt mit dem Python-Client von Weaviate hinzufügst. Installiere den Python-Client zuvor mit pip.
!pip install -U weaviate-clientUm mit Weaviate zu arbeiten, brauchst du eine laufende Instanz. Dafür gibt es zwei Wege: Entweder nutzt du eine vollständig verwaltete, gehostete Instanz über den Weaviate Cloud Service. Alternativ kannst du Embedded Weaviate verwenden, das die Instanz im Hintergrund deiner App startet.
# For using embedded
import weaviate
from weaviate.embedded import EmbeddedOptions
import json
import os


client = weaviate.Client(
    embedded_options=EmbeddedOptions(),
    additional_headers = {
        "X-OpenAI-Api-Key": "YOUR_OPENAI_KEY"
    }
)
Das Erstellen einer Klasse ist sehr unkompliziert:
class_obj = {
    "class": "Question",
    "vectorizer": "text2vec-openai",
"moduleConfig": {
        "text2vec-openai": {},
        "generative-openai": {}
    }
}


client.schema.create_class(class_obj)
Wenn der Vektorisierer auf None gesetzt ist, musst du die Vektoren selbst als Liste bereitstellen.
Jetzt können wir über den Batch-Import Objekte zur erstellten Klasse Question hinzufügen. Wir verwenden Jeopardy Q&A im JSON-Format. So sieht das aus:
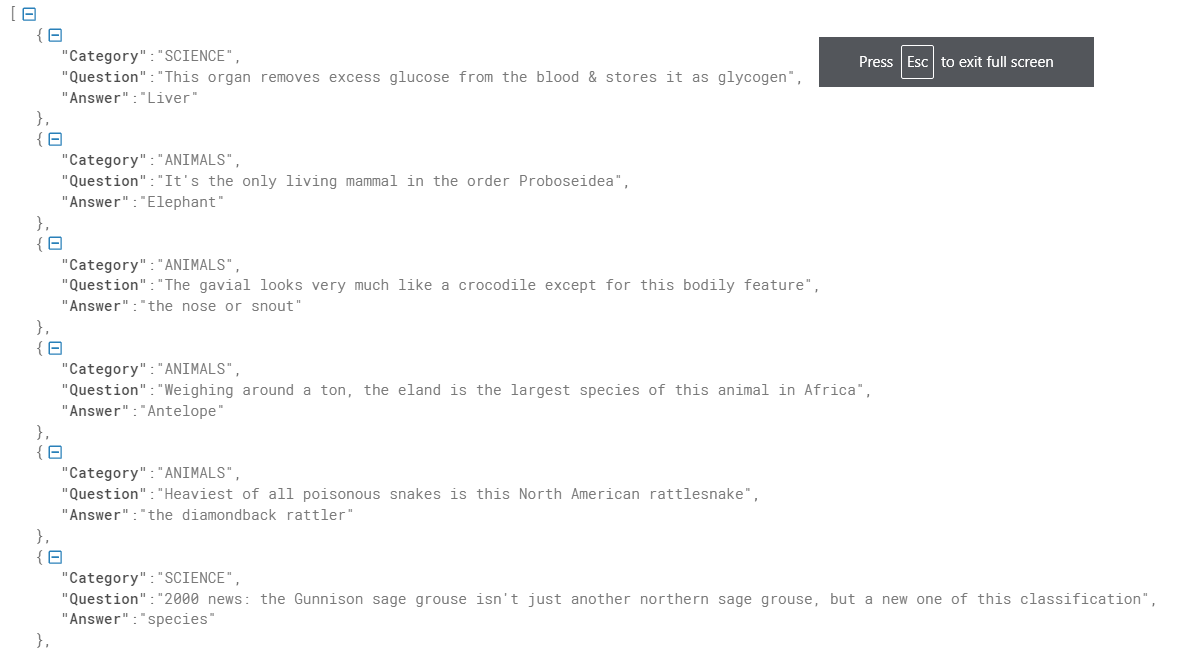
Data Source (Credit: Weaviate Official)
# Load data
import requests
url = 'https://raw.githubusercontent.com/weaviate-tutorials/quickstart/main/data/jeopardy_tiny.json'
resp = requests.get(url)
data = json.loads(resp.text)


# Configure a batch process
with client.batch(
    batch_size=100
) as batch:
    # Batch import all Questions
    for i, d in enumerate(data):
        print(f"importing question: {i+1}")


        properties = {
            "answer": d["Answer"],
            "question": d["Question"],
            "category": d["Category"],
        }


        client.batch.add_data_object(
            properties,
            "Question",
        )
Dieses Beispiel wurde anhand der Weaviate-Dokumentation nachgebildet.
Schauen wir uns hilfreiche Hinweise für die effiziente Nutzung von Weaviate an. Ob Schemadesign, Datenimport oder Query-Optimierung – diese Best Practices helfen dir, das Potenzial von Weaviate voll auszuschöpfen.
ChromaDB ist eine weitere beliebte Open-Source-Vektordatenbank in der Data-Science-Community. Mit ChromaDB verwaltest du Textdokumente, wandelst Text in Embeddings um und führst Ähnlichkeitssuchen durch. Wenn du mehr über ChromaDB erfahren willst, sieh dir das ChromaDB Tutorial an.
Das Weaviate-Tutorial ist ein umfassender Leitfaden, um Weaviate – eine Open-Source-, Cloud-native Vektorsuchmaschine in Echtzeit – zu verstehen und produktiv einzusetzen. Der Beitrag deckt alles ab: von den Grundlagen und den Unterschieden zu klassischen Datenbanken bis hin zur Einrichtung und effektiven Nutzung.
Weaviate spielt seine Stärken beim Umgang mit unstrukturierten Daten über Vektorembeddings aus und ist damit ein leistungsstarkes Werkzeug für Machine Learning und KI-Anwendungen. Dank der modularen Architektur bleibst du flexibel und wählst optionale Module nach Bedarf. Der Beitrag beleuchtet außerdem die Bedeutung von Embeddings und erklärt, wie sie hochdimensionale Daten in ein Format überführen, das KI-Modelle effizient verarbeiten können.
Wenn du dein Wissen zu Weaviate vertiefen möchtest, schau dir unser Webinar zu Vektordatenbanken für Data Science mit Weaviate in Python an.
Starte heute mit KI!
Kurs
Lernpfad
Kurs