Curso
Conceptos de la IA generativa
2 h
117.2K
Weaviate es un motor de búsqueda vectorial en tiempo real, modular, nativo en la nube y de código abierto que te permite almacenar objetos de datos y embeddings vectoriales y consultarlos en función de medidas de similitud. En este tutorial, veremos qué es Weaviate y sus conceptos clave, aprenderemos a ponerlo en marcha, crear un esquema, añadir datos y consultarlos con la interfaz GraphQL de Weaviate. También cubriremos cómo usar Weaviate con Python y hablaremos de buenas prácticas y consejos para el diseño del esquema, la importación de datos y la optimización de consultas.
Weaviate es una base de datos vectorial que almacena tanto objetos como vectores, lo que permite combinar la búsqueda vectorial. Es modular, nativo en la nube y en tiempo real, lo que facilita escalar modelos de machine learning. Weaviate incluye módulos opcionales para texto, imagen y otros tipos de medios que puedes seleccionar según tu tarea y tus datos. También puedes usar más de un módulo si trabajas con datos variados.
Los datos no estructurados, como texto, imágenes y audio, no tienen un formato predefinido, lo que dificulta su gestión con bases de datos y métodos tradicionales.
Para que estos datos sean utilizables en aplicaciones de IA y machine learning, se convierten en vectores numéricos mediante embeddings.
Los embeddings actúan como diccionarios especializados que transforman datos de alta dimensión en representaciones numéricas compactas, facilitando su procesamiento eficiente por modelos de IA.
Son esenciales para reducir la dimensionalidad y superar las limitaciones de los métodos de codificación tradicionales, permitiendo a la IA entender relaciones complejas y el contexto dentro de los datos.
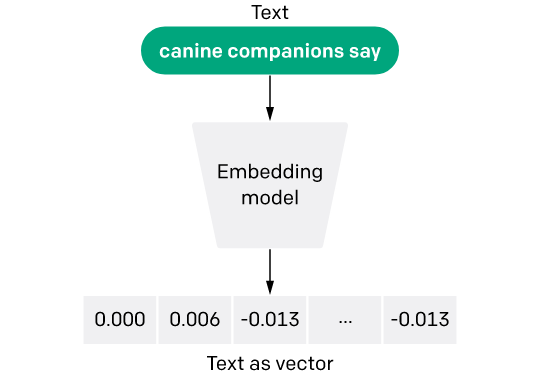
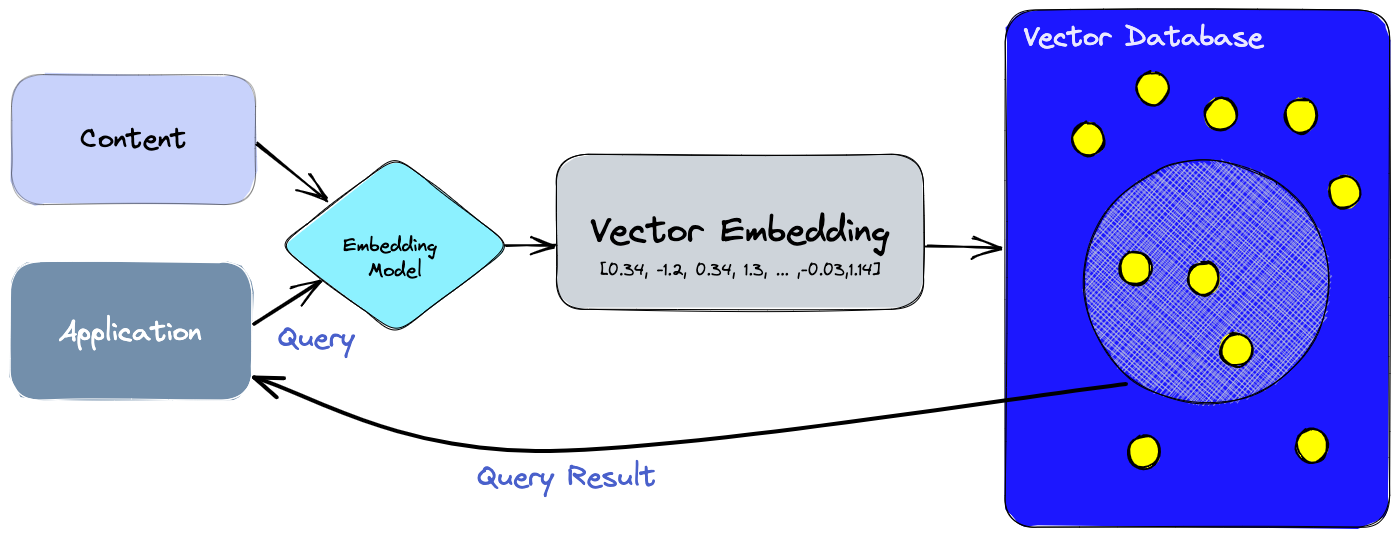
Modelo de embedding de texto - Fuente de la imagen
Las bases de datos tradicionales almacenan datos en tablas, que se pueden consultar con SQL. Sin embargo, SQL no está bien preparado para buscar en datos no estructurados, como texto o imágenes. Las bases de datos vectoriales, en cambio, almacenan los datos como vectores que se consultan con medidas de similitud.
Esto las hace idóneas para tareas como la búsqueda semántica, las preguntas y respuestas y la búsqueda generativa. Los vectores se obtienen con un modelo de embeddings de ML: no son más que la representación numérica del objeto original (texto, imagen, audio, vídeo, etc.).
Imagina un escenario en el que se usa un modelo de lenguaje para analizar y clasificar grandes conjuntos de documentos de texto. Cada documento podría transformarse en un vector de alta dimensión que capture su esencia semántica.
Almacenar estos vectores en una base de datos tradicional puede no ser eficiente para tareas como la búsqueda por similitud o el clustering.
Aquí es donde una base de datos vectorial resulta muy útil. Está optimizada para almacenar vectores y realizar operaciones vectoriales de alta velocidad, como buscar los vecinos más cercanos o calcular la similitud del coseno entre vectores.
Pinecone es otra base de datos vectorial muy popular y una gran alternativa a Weaviate. Si quieres saber más sobre Pinecone, echa un vistazo al tutorial Mastering Vector Databases with Pinecone.
Para configurar Weaviate, puedes usar Docker Compose o instalarlo manualmente. Se recomienda Docker Compose porque simplifica el proceso de instalación. Una vez instalado Weaviate, puedes verificar la instalación ejecutando una consulta sencilla.
Para Docker Compose, descarga este archivo YAML de Weaviate. Cuando lo tengas, simplemente ejecuta:
docker compose up -dOtras formas de usar Weaviate son:
Para usar Weaviate en Python puedes instalar el cliente de Python de weaviate con pip.
!pip install -U weaviate-clientEn Weaviate, cada elemento de datos pertenece a un grupo llamado "Class" y tiene ciertas características llamadas "Properties". Estos elementos (representados como documentos JSON) son colecciones basadas en clases.
Cada elemento de datos se representa con un vector (modelo de embeddings de machine learning). Cada colección basada en clases contiene objetos de la misma clase, definidos por un esquema común.
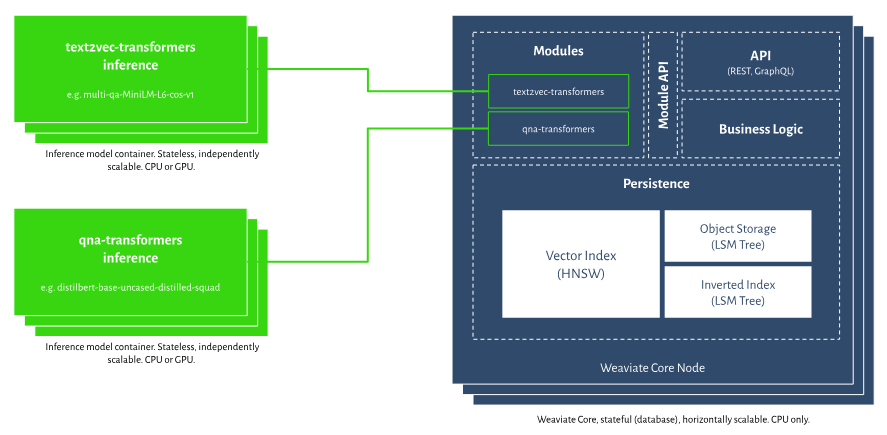
Weaviate está diseñado de forma flexible, lo que te permite añadir funciones opcionales como convertir datos a vectores o crear copias de seguridad.
Sin estos complementos, la versión básica de Weaviate funciona como una base de datos específicamente diseñada para datos vectoriales.
Weaviate es una base de datos fiable que guarda los datos al instante y soporta fallos tanto de software como de hardware.
Cuando buscas algo usando vectores, Weaviate te devuelve el elemento completo (a veces llamado "documento" en otras bases de datos) y no solo un identificador como un ID.
Si combinas búsquedas tradicionales y vectoriales, los filtros se aplican antes de la búsqueda vectorial, garantizando que recibas exactamente el número de resultados que has pedido. Esto es distinto a filtrar después de la búsqueda, donde el número de resultados puede variar.
Puedes actualizar o borrar libremente datos y sus vectores incluso mientras lees de la base de datos.
Puedes interactuar con Weaviate usando sus APIs, que incluyen una API RESTful y una API GraphQL. Las bibliotecas cliente de todos los lenguajes de programación son compatibles con estas funcionalidades.
GraphQL es un lenguaje de consultas para APIs que te permite solicitar exactamente los datos que necesitas. Ofrece una forma más eficiente y flexible de interactuar con bases de datos que métodos tradicionales como REST.
Se eligió la interfaz GraphQL por varios motivos, entre ellos:
Cada objeto de Weaviate pertenece a una clase. Puedes crear la clase manualmente o usar la función Auto-schema de Weaviate para generarla. Si la creas manualmente, tendrás más control sobre el modelo de datos.
Para crear una clase con la biblioteca cliente de Python:
class_name = "Item description"
class_object = {"class": class_name}
client.schema.create_class(class_object)
Normalmente también especificarás configuraciones adicionales. Un ejemplo más realista, tomado de Weaviate.io, sería:
{
"class": "Article",
"vectorizer": "text2vec-cohere",
"vectorIndexConfig": {
"distance": "cosine",
},
"moduleConfig": {
"generative-openai": {}
},
"properties": [
{
"name": "title",
"dataType": ["text"]
},
{
"name": "chunk",
"dataType": ["text"]
},
{
"name": "chunk_no",
"dataType": ["int"]
},
{
"name": "url",
"dataType": ["text"],
"tokenization": "field"
},
],
}
Fíjate en que se define un modelo de vectorización text2vec-cohere y una métrica de distancia cosine. Observa cómo las propiedades se definen como una lista de diccionarios.
El objeto pertenece a una clase. Los objetos pueden omitir propiedades de la clase y también añadir propiedades nuevas. A continuación tienes un ejemplo de cómo añadir un objeto a la clase Article.
uuid = client.data_object.create({
'question': 'question here ...',
'answer': 'answer here ...'
}, 'Article')
Puedes asignar opcionalmente un vector para representar cada objeto. Si no defines un vector, Weaviate usará su vectorizador por defecto.
uuid = client.data_object.create(
data_object={
'question': 'question here ...',
'answer': 'answer here ...',
},
class_name='Article',
vector=[0.12345] * 1536Este es un ejemplo que muestra cómo crear una clase y luego añadir un objeto a esa clase usando el cliente de Python de Weaviate. Primero debes instalar el cliente de Python con pip.
!pip install -U weaviate-clientPara trabajar con Weaviate, debes tener una instancia operativa de Weaviate. Tienes dos opciones: usar una instancia alojada y totalmente gestionada en el servicio en la nube de Weaviate, o usar Weaviate en modo Embedded, que ejecuta la instancia en segundo plano dentro de tu aplicación.
# Para usar embedded
import weaviate
from weaviate.embedded import EmbeddedOptions
import json
import os


client = weaviate.Client(
    embedded_options=EmbeddedOptions(),
    additional_headers = {
        "X-OpenAI-Api-Key": "YOUR_OPENAI_KEY"
    }
)
Crear una clase es muy sencillo:
class_obj = {
    "class": "Question",
    "vectorizer": "text2vec-openai",
"moduleConfig": {
        "text2vec-openai": {},
        "generative-openai": {}
    }
}


client.schema.create_class(class_obj)
Si estableces el vectorizer en None, tendrás que proporcionar los vectores tú mismo como una lista.
Ahora podemos añadir objetos a la clase creada Question mediante el proceso de importación por lotes. Usaremos el jeopardy Q&A en formato JSON. Tiene este aspecto:
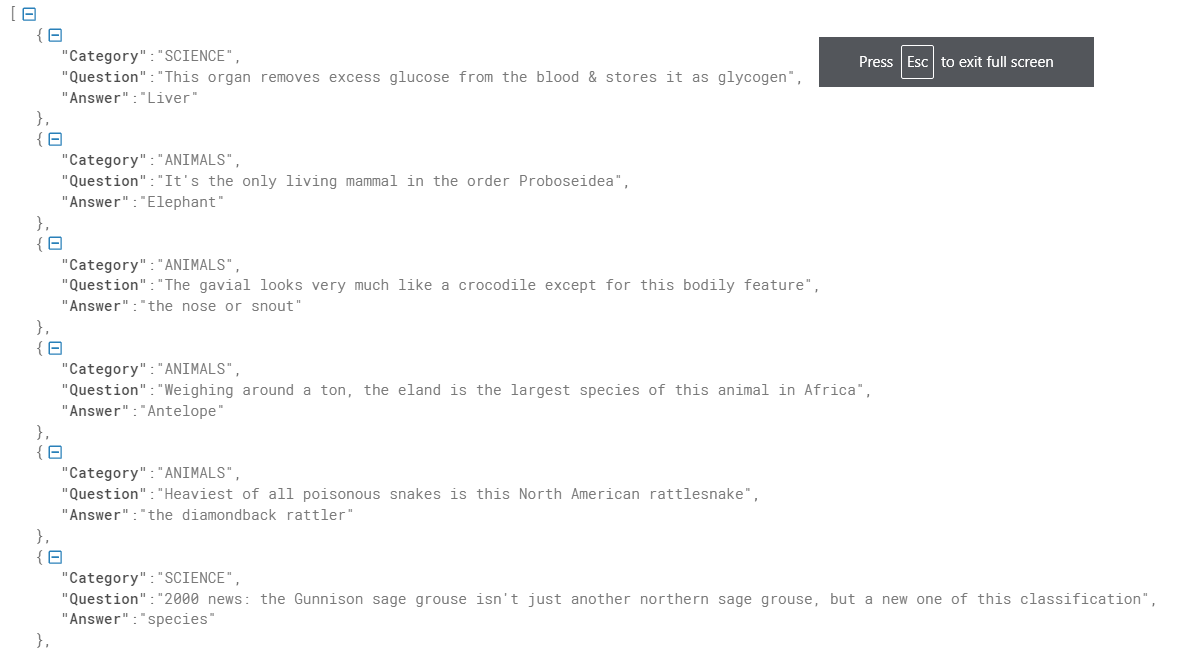
Fuente de datos (crédito: Weaviate oficial)
# Cargar datos
import requests
url = 'https://raw.githubusercontent.com/weaviate-tutorials/quickstart/main/data/jeopardy_tiny.json'
resp = requests.get(url)
data = json.loads(resp.text)


# Configurar un proceso por lotes
with client.batch(
    batch_size=100
) as batch:
    # Importar por lotes todas las preguntas
    for i, d in enumerate(data):
        print(f"importing question: {i+1}")


        properties = {
            "answer": d["Answer"],
            "question": d["Question"],
            "category": d["Category"],
        }


        client.batch.add_data_object(
            properties,
            "Question",
        )
Este ejemplo se ha reproducido a partir de la documentación de Weaviate.
Veamos algunas recomendaciones útiles para usar Weaviate de forma eficaz. Ya sea al diseñar tu esquema, importar datos u optimizar consultas, estas buenas prácticas te ayudarán a sacarle el máximo partido a Weaviate.
ChromaDB es otra base de datos vectorial de código abierto muy popular en la comunidad de ciencia de datos. Con Chroma DB puedes gestionar documentos de texto, convertir texto en embeddings y hacer búsquedas por similitud con facilidad. Si quieres saber más sobre ChromaDB, consulta el tutorial de Chroma DB.
Este tutorial de Weaviate es una guía completa para entender y sacar partido a Weaviate, un motor de búsqueda vectorial en tiempo real, nativo en la nube y de código abierto. El artículo cubre desde los fundamentos de qué es Weaviate y cómo se diferencia de las bases de datos tradicionales, hasta los detalles de su configuración y uso efectivo.
Weaviate destaca por su capacidad para manejar datos no estructurados mediante embeddings vectoriales, lo que lo convierte en una herramienta potente para aplicaciones de machine learning e IA. Su arquitectura modular aporta flexibilidad y te permite elegir módulos opcionales según tus necesidades. El artículo también profundiza en la importancia de los embeddings y explica cómo transforman datos de alta dimensión en un formato fácil de procesar por los modelos de IA.
Si quieres seguir aprendiendo sobre Weaviate, echa un vistazo a nuestro webinar sobre bases de datos vectoriales para data science con Weaviate en Python.
¡Empieza a trabajar con IA hoy!
Curso
programa
Curso
blog
Moez Ali
14 min
Tutorial
Moez Ali
10 min
Tutorial
Avinash Navlani
15 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Arunn Thevapalan
12 min
Tutorial