
Kursus
Membangun Alur Kerja Agentic dengan LlamaIndex
2 jam
1.5K
MetaStone AI baru-baru ini merilis XBai-o4, sebuah model penalaran open-source yang menghadirkan skala waktu-uji paralel dan arsitektur generatif reflektif. Dengan 32,8 miliar parameter dan head evaluasi mandiri terintegrasi, XBai o4 melampaui o3-mini (mode medium) dari OpenAI pada tolok ukur inti penalaran matematis sambil berjalan secara lokal.
Fokus saya dalam blog ini adalah kemampuan penalaran reflektif unik XBai o4, menunjukkan bagaimana model ini menghasilkan dan mengevaluasi beberapa lintasan solusi untuk soal matematika melalui antarmuka Streamlit yang dideploy secara lokal dan didukung oleh LM Studio.
Dalam tutorial ini, saya akan menjelaskan langkah demi langkah cara:
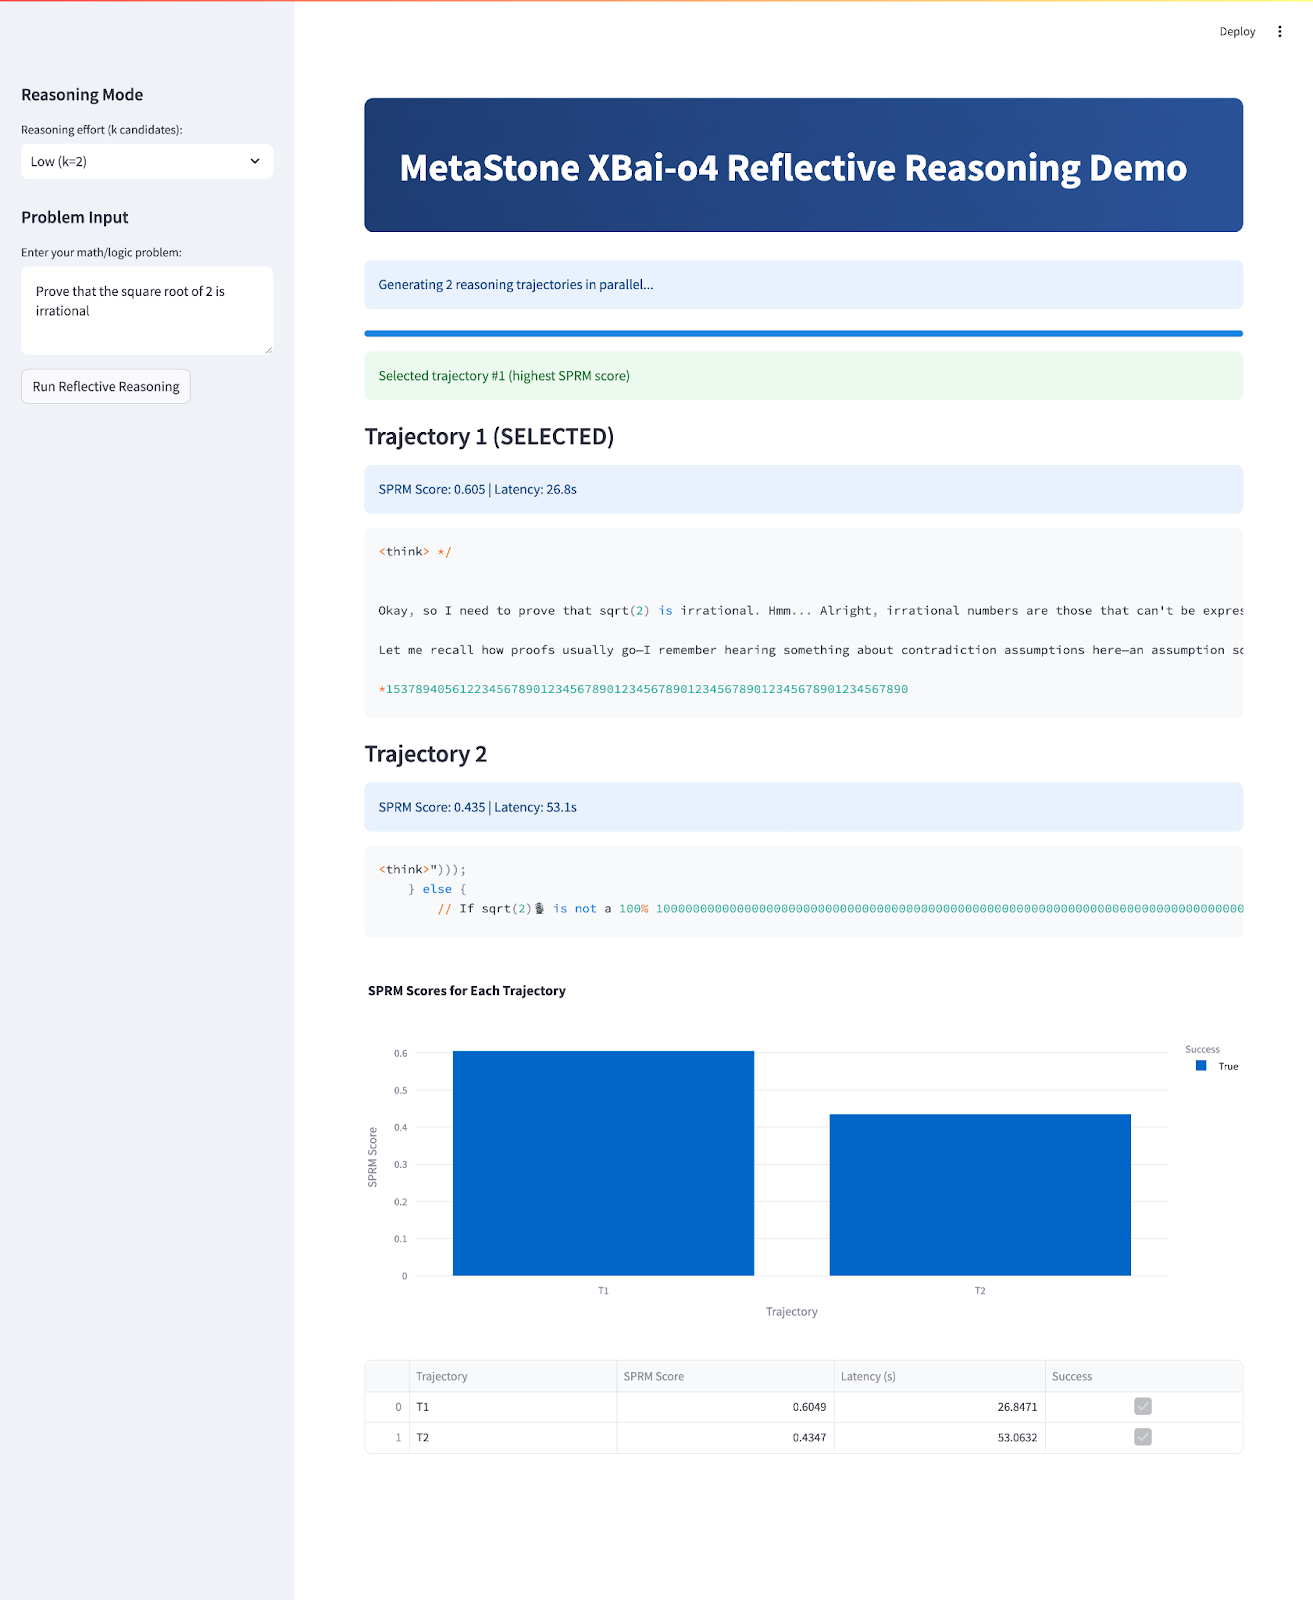
Pada akhirnya, aplikasi Anda akan terlihat seperti ini:
XBai-o4 adalah model penalaran open-source generasi keempat dari MetaStone AI, yang memperkenalkan arsitektur generatif reflektif yang berupaya mendefinisikan ulang cara AI mendekati pemecahan masalah yang kompleks. Tidak seperti LLM tradisional yang memperlakukan pembuatan jawaban dan evaluasi jawaban sebagai dua proses terpisah, XBai o4 menggabungkan keduanya dalam satu model terpadu menggunakan Shared Process Reward Model (SPRM). Desain ini memungkinkan model untuk menghasilkan, memberi skor, dan memilih beberapa jalur penalaran secara paralel.
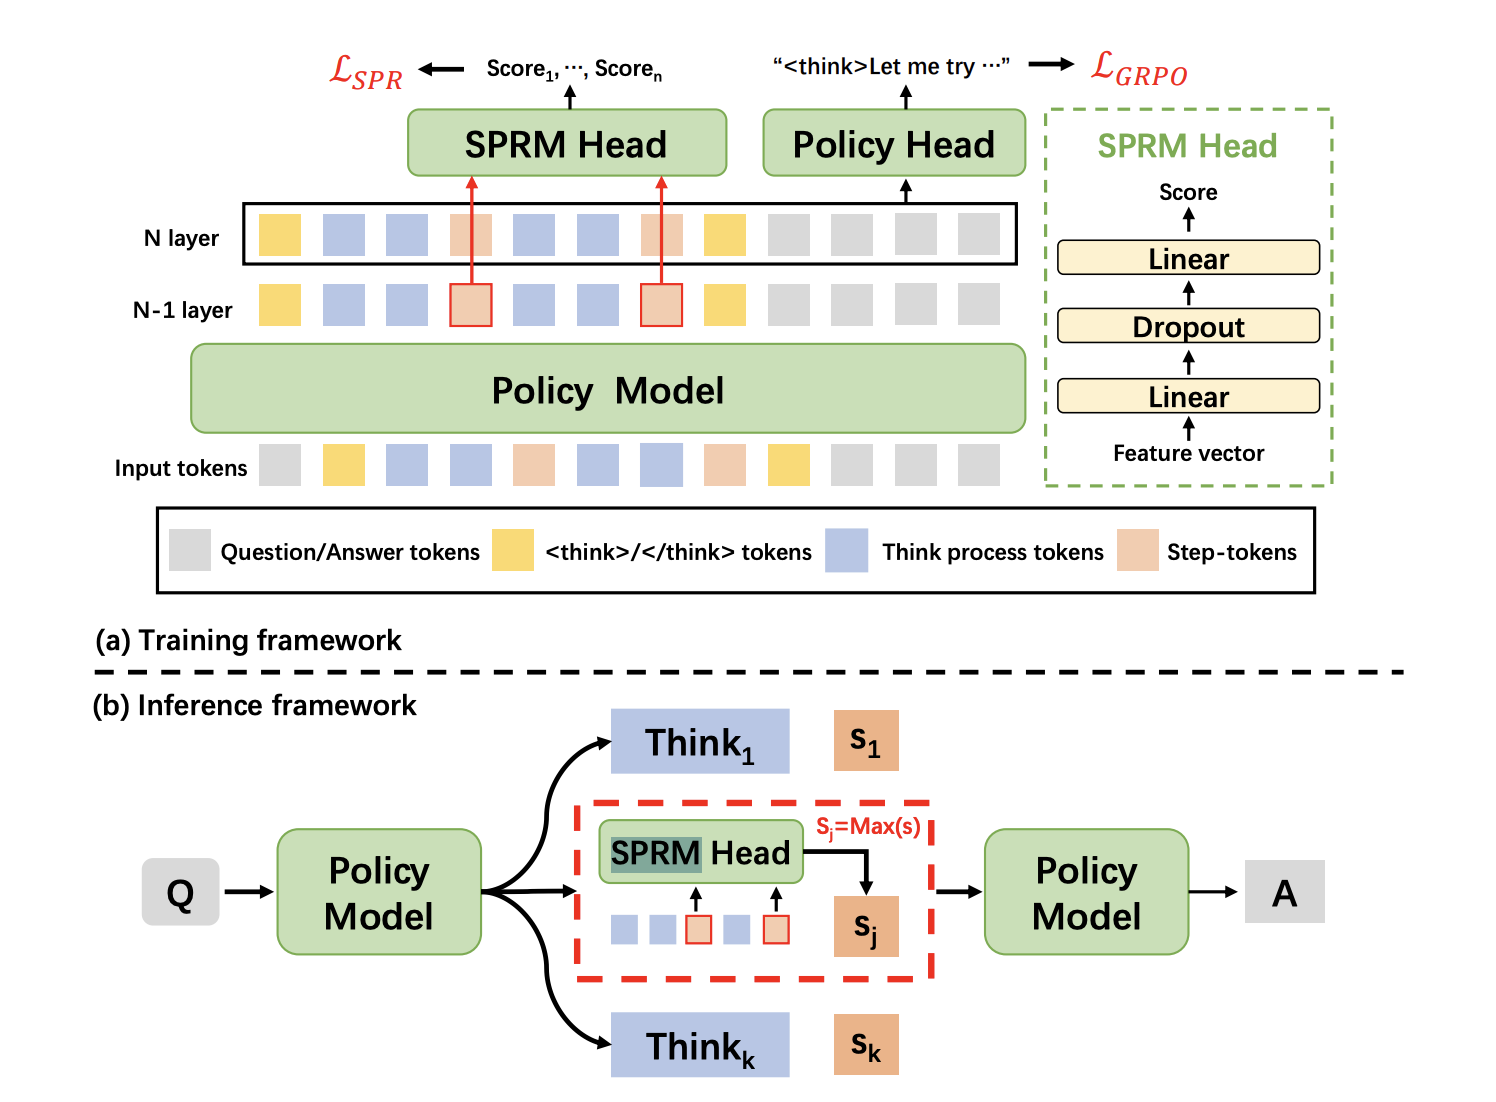
Sumber: SPRM Head
Pada intinya, XBai o4 menggabungkan reinforcement learning dengan rantai pemikiran panjang (Long-CoT) dan pembelajaran reward proses ke dalam satu pipeline pelatihan. Berikut beberapa inovasi kunci yang diperkenalkan dalam model ini:
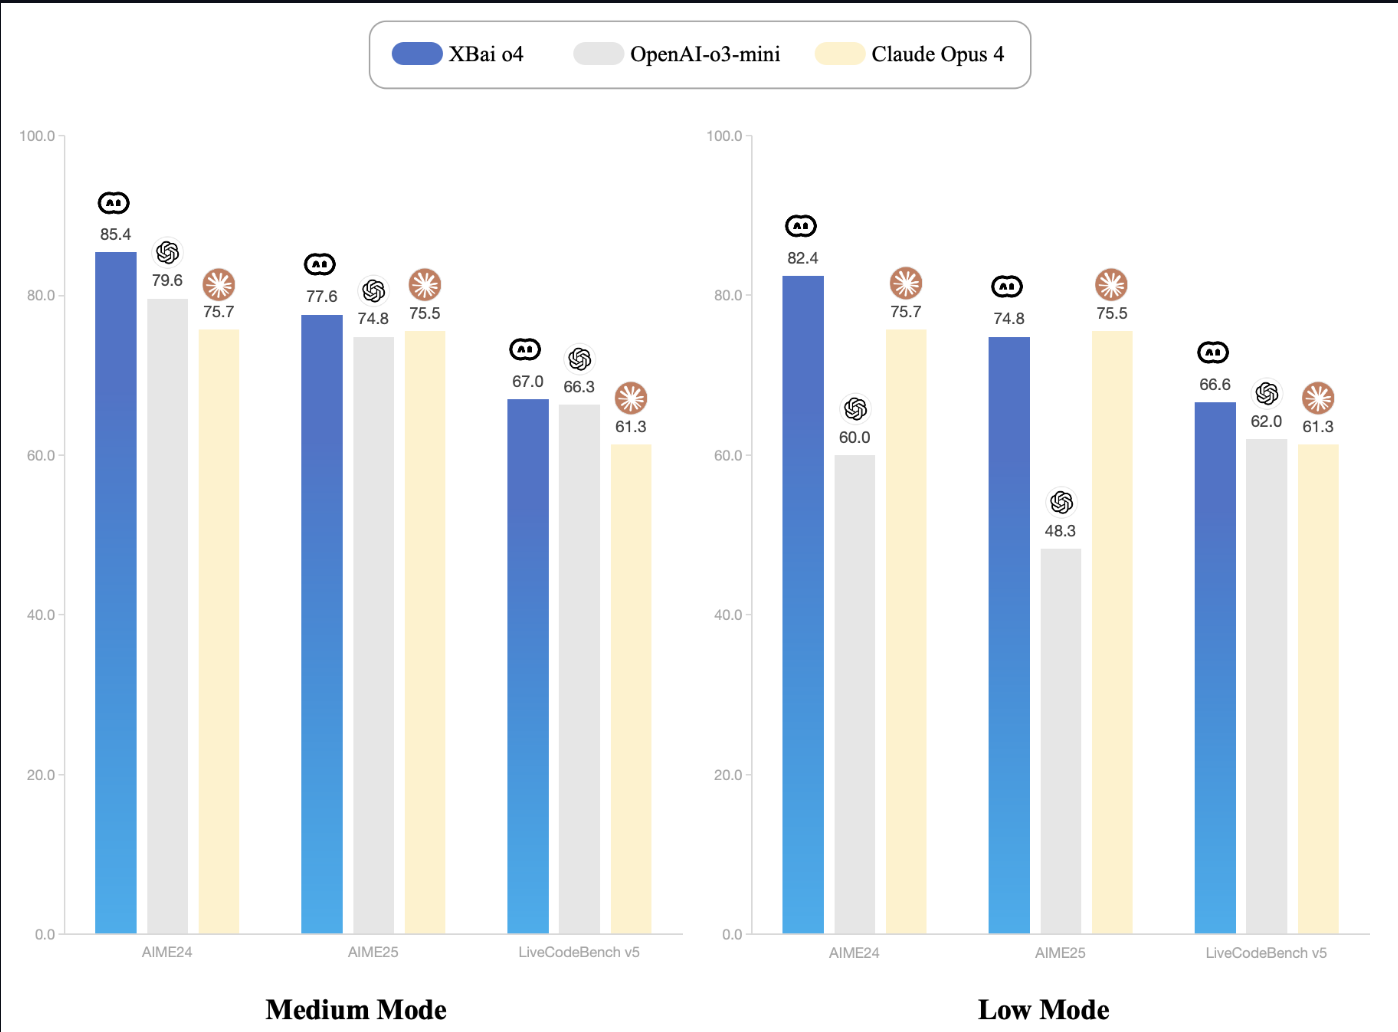
Sumber: Dokumentasi XBai-O4
Anda dapat menjalankan XBai o4 secara lokal menggunakan LM Studio, yang secara otomatis memanfaatkan akselerasi GPU sistem Anda atau Apple Silicon (Metal/MLX) bila tersedia (tanpa perlu penyiapan manual). Untuk kinerja dan kompatibilitas optimal, saya merekomendasikan menggunakan versi model yang dikuantisasi GGUF.
Standar GGUF (GPT-Generated Unified Format) memungkinkan inferensi lokal yang sangat efisien dengan mengurangi presisi bobot model. Dalam proyek ini, kita akan menggunakan varian kuantisasi Q3_K_S, yang populer karena trade-off yang sangat baik antara kualitas dan penggunaan memori.
Q3_K_S menawarkan performa penalaran yang kuat dengan kehilangan kualitas minimal dibandingkan model presisi penuh.Mari kita ikuti proses langkah demi langkah untuk menyiapkan model GGUF terkuantisasi guna inferensi lokal yang efisien menggunakan LM Studio.
LM Studio menawarkan dukungan GGUF dan secara otomatis memilih backend inferensi optimal untuk perangkat keras Anda, baik itu Metal, GPU, atau CPU.
Jika Anda belum menginstal LM Studio, cukup unduh dari lmstudio.ai dan ikuti petunjuk instalasi.
Di LM Studio:
mradermacher/XBai-o4-GGUFXBai-o4.Q3_K_S.gguf (14,39 GB).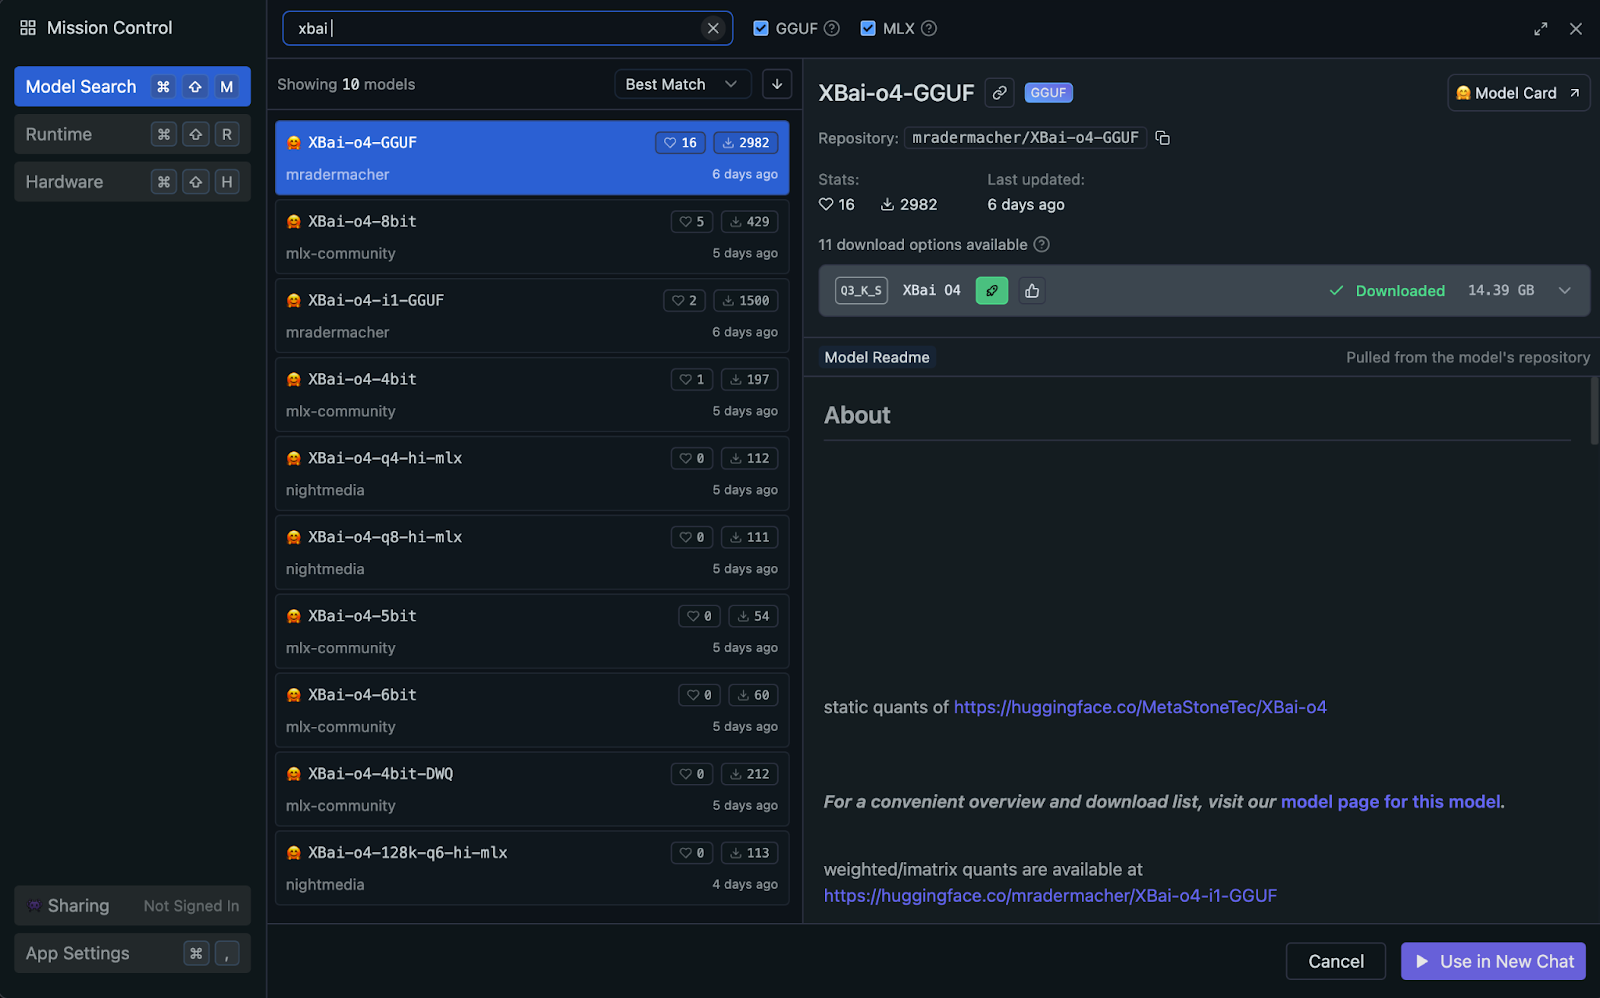
Setelah LM Studio terinstal, kita memuat dan mengonfigurasi model XBai o4 untuk inferensi lokal:
XBai-o4.Q3_K_S.gguf dari daftar model yang diunduh.Setelah berjalan, sistem Anda siap untuk penalaran multi-lintasan dengan XBai o4.
Sekarang kita akan membangun aplikasi Streamlit yang mendemonstrasikan kemampuan penalaran reflektif XBai o4 dengan perbandingan performa secara real-time.
Mulailah dengan memasang dependensi:
pip install streamlit plotly pandas numpy requestsPerintah ini memastikan Anda memiliki semua dependensi inti untuk UI, penanganan data, plotting, dan permintaan API.
Selanjutnya, impor semua pustaka yang diperlukan dan konfigurasikan tata letak halaman Streamlit serta pengaturan dasar.
import streamlit as st
import time
import requests
import numpy as np
import pandas as pd
import plotly.express as px
from typing import List, Dict, Any
LM_STUDIO_URL = "http://localhost:1234/v1"   # change as per your server
REASONING_MODES = {"Low (k=2)": 2, "Medium (k=8)": 8, "High (k=32)": 8}
st.set_page_config(page_title="MetaStone-XBai-o4 Reflective Reasoning Demo", layout="wide")
st.markdown("""
<style>
    .main-header {
        background: linear-gradient(90deg, #1e3c72 0%, #2a5298 100%);

        border-radius: 10px;
        color: white;
        text-align: center;

    }
</style>
""", unsafe_allow_html=True)
Blok kode ini mengimpor semua pustaka inti yang diperlukan untuk demo kita, termasuk Streamlit untuk UI web, serta pustaka dasar lainnya seperti time, requests, numpy, pandas, plotly.express, dan alat pengetikan.
Kemudian, ia menetapkan endpoint API model LM_STUDIO_URL agar aplikasi mengetahui ke mana mengirim permintaan, dan mendefinisikan mode penalaran (REASONING_MODES) sehingga pengguna dapat dengan mudah memilih berapa banyak cabang solusi yang akan dihasilkan.
Terakhir, kita menggunakan st.set_page_config() untuk mengonfigurasi UI Streamlit dengan judul khusus, tata letak lebar, dan header gradien bergaya CSS.
Catatan: LM_STUDIO_URL adalah URL dasar server LLM, yang dapat Anda salin dari LM Studio. Biasanya - "http://localhost:1234/v1" namun bisa bervariasi. Juga, pilih mode penalaran sesuai kemampuan server Anda.
Sekarang, mari kita membangun serangkaian fungsi bantu yang menjalankan logika inti “penalaran reflektif” aplikasi kita. Fungsi-fungsi ini memudahkan bekerja dengan banyak lintasan, memilih solusi terbaik, dan memberi skor pada setiap jawaban.
Langkah ini memperkenalkan fungsi bantu sederhana yang secara otomatis memeriksa apakah server LM Studio kita dapat menangani sampling multi-lintasan. Beberapa server mendukung parameter n, yang memungkinkan kita meminta beberapa completion independen dalam satu panggilan API, sehingga mempercepat proses secara signifikan.
def supports_n_param():
    payload = {
        "messages": [{"role": "user", "content": "What is 1+1?"}],
        "max_tokens": 80,
        "temperature": 0.1,
        "n": 2,
        "stream": False
    }
    try:
        resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
        if resp.status_code == 200 and len(resp.json().get("choices", [])) == 2:
            return True
    except Exception:
        pass
    return False
Fungsi ini memeriksa apakah server LM Studio Anda mendukung pembuatan beberapa jawaban (“lintasan”) dalam satu panggilan API menggunakan parameter n. Fungsi ini mengirim permintaan uji cepat dan mengembalikan True jika fitur tersedia, sehingga memungkinkan sampling “Best-of-N” yang sesungguhnya untuk penalaran yang lebih cepat dan skalabel.
Setelah kita mengetahui apakah backend mendukung sampling multi-lintasan, langkah berikutnya adalah menghasilkan beberapa jalur penalaran untuk suatu masalah. Bagian ini memperkenalkan serangkaian fungsi bantu yang menggunakan multi-sampling di sisi server (bila tersedia) atau memparalelkan completion tunggal secara efisien, memastikan aplikasi tetap cepat dan skalabel.
def lm_studio_generate_multiple(problem, k, temperature=0.8, seed=2025):
    prompt = f"<think> {problem}\n</think>"
    payload = {
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 196,
        "temperature": temperature,
        "top_p": 0.9,
        "top_k": 30,
        "n": k,
        "stream": False,
        "seed": seed
    }
    start = time.time()
    resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
    latency = time.time() - start
    if resp.status_code == 200:
        result = resp.json()
        return [{
            "content": choice["message"]["content"].strip(),
            "latency": latency / k,
            "success": True,
        } for choice in result.get("choices", [])]
    else:
        raise RuntimeError(f"LM Studio error: {resp.status_code}: {resp.text}")
def lm_studio_generate_single(problem, temperature, seed=None):
    prompt = f"<think> {problem}\n</think>"
    payload = {
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 196,
        "temperature": temperature,
        "top_p": 0.9,
        "top_k": 30,
        "stream": False,
        "seed": seed
    }
    start = time.time()
    resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
    latency = time.time() - start
    if resp.status_code == 200:
        content = resp.json()["choices"][0]["message"]["content"].strip()
        return {"content": content, "latency": latency, "success": True}
    else:
        return {"success": False, "error": f"HTTP {resp.status_code}: {resp.text}", "latency": latency}
def parallel_candidate_generation(problem, k, progress_cb=None):
    import concurrent.futures
    temperatures = np.linspace(0.1, 1.0, k)
    results = []
    with concurrent.futures.ThreadPoolExecutor(max_workers=min(8, k)) as executor:
        futures = []
        for i in range(k):
            seed = 2025 + i * 31
            futures.append(executor.submit(lm_studio_generate_single, problem, temperatures[i], seed))
        for i, future in enumerate(concurrent.futures.as_completed(futures)):
            res = future.result()
            res["trajectory_id"] = i + 1
            results.append(res)
            if progress_cb:
                progress_cb(i + 1, k)
    results.sort(key=lambda x: x.get("trajectory_id", 0))
    return results
Berikut cara setiap fungsi masuk dalam pipeline multi-lintasan:
lm_studio_generate_multiple(): Saat server LM Studio mendukung parameter n, fungsi ini mengirim satu permintaan API untuk menghasilkan k solusi yang beragam sekaligus. Ini mode yang paling efisien, memungkinkan skala waktu-uji yang sebenarnya.lm_studio_generate_single(): Jika server tidak mendukung multi-sampling, fungsi ini menyediakan fallback yang menghasilkan satu lintasan solusi per permintaan, memungkinkan temperatur yang berbeda dan reprodusibilitas melalui seed.parallel_candidate_generation(): Untuk menjaga performa dalam mode fallback, utilitas ini menjalankan beberapa pemanggilan lm_studio_generate_single() secara paralel, masing-masing dengan temperatur sampling yang berbeda, lalu menggabungkan semua respons. Ini memastikan kita tetap mendapatkan beragam solusi dengan cepat, meskipun multi-sampling sejati tidak tersedia.Setelah menghasilkan beberapa jalur penalaran, kita memerlukan cara terstruktur untuk mengidentifikasi solusi terkuat. Langkah ini memperkenalkan alat penilaian dan seleksi yang meniru teknik reward modeling (SPRM) yang digunakan dalam makalah MetaStone tentang Penalaran Reflektif.
def step_tokenize(trajectory: str) -> List[str]:
    steps = [step.strip() for step in trajectory.split('.\n\n') if step.strip()]
    return steps
def dummy_sprm_score(trajectory: str, problem: str) -> float:
    steps = step_tokenize(trajectory)
    n = len(steps)
    def step_score(step):
        s = 0.2
        if any(x in step.lower() for x in ["therefore", "thus", "so", "finally", "conclude"]): s += 0.15
        if any(sym in step for sym in ["=", "+", "-", "*", "/", "(", ")"]): s += 0.1
        if len(step.split()) > 10: s += 0.1
        return min(1.0, s)
    step_scores = [step_score(s) for s in steps] or [0.01]
    geometric_mean = np.exp(np.mean(np.log(np.maximum(step_scores, 1e-3))))
    return min(1.0, geometric_mean + 0.05 * np.log1p(n))
def best_of_n_selection(candidates: List[Dict]) -> int:
    best_idx = int(np.argmax([c["sprm_score"] for c in candidates]))
    return best_idx
Berikut fungsi masing-masing:
step_tokenize(): Memecah lintasan penalaran menjadi langkah atau segmen logis, memungkinkan analisis dan penilaian per langkah.dummy_sprm_score(): Memberikan skor reward pada setiap lintasan kandidat dan mendorong respons yang multi-langkah, terstruktur baik, dan menggunakan penalaran matematis. Fungsi ini bertindak sebagai pengganti Shared Process Reward Model (SPRM) pada makalah, yang secara internal mengevaluasi solusinya.Fungsi best_of_n_selection(): Diberi sekumpulan jawaban kandidat, fungsi ini memilih satu lintasan terbaik berdasarkan skor SPRM tertinggi, sama seperti model reflektif dalam makalah yang secara otomatis memilih jawabannya yang paling tangguh saat waktu uji.Pada langkah ini, kita menyatukan semua bagian untuk membuat demo penalaran interaktif dengan Streamlit.
st.markdown("""
<div class="main-header">
    <h1> MetaStone XBai-o4 Reflective Reasoning Demo</h1>
</div>
""", unsafe_allow_html=True)
st.sidebar.header("Reasoning Mode")
mode = st.sidebar.selectbox("Reasoning effort (k candidates):", list(REASONING_MODES.keys()))
k = REASONING_MODES[mode]
st.sidebar.header("Problem Input")
problem = st.sidebar.text_area("Enter your math/logic problem:", "Prove that the square root of 2 is irrational")
if st.sidebar.button("Run Reflective Reasoning"):
    st.session_state.run = True
    st.session_state.results = None
    st.session_state.best_idx = None
if "run" not in st.session_state:
    st.session_state.run = False
if st.session_state.run:
    st.info(f"Generating {k} reasoning trajectories in parallel...")
    progress = st.progress(0)
    def update_progress(done, total):
        progress.progress(done / total)
    try:
        if supports_n_param():
            results = lm_studio_generate_multiple(problem, k, temperature=0.7)
            for idx, res in enumerate(results):
                res["trajectory_id"] = idx + 1
        else:
            results = parallel_candidate_generation(problem, k, progress_cb=update_progress)
        for res in results:
            if res.get("success"):
                res["sprm_score"] = dummy_sprm_score(res["content"], problem)
            else:
                res["sprm_score"] = 0.0
        best_idx = best_of_n_selection(results)
        st.session_state.results = results
        st.session_state.best_idx = best_idx
        st.session_state.run = False
    except Exception as e:
        st.error(f"Failed to generate trajectories: {str(e)}")
        st.session_state.run = False
if st.session_state.get("results"):
    results = st.session_state.results
    best_idx = st.session_state.best_idx
    st.success(f"Selected trajectory #{best_idx+1} (highest SPRM score)")
    df = pd.DataFrame({
        "Trajectory": [f"T{i+1}" for i in range(len(results))],
        "SPRM Score": [r["sprm_score"] for r in results],
        "Latency (s)": [r.get("latency", 0.0) for r in results],
        "Success": [r.get("success", False) for r in results]
    })
    for i, res in enumerate(results):
        is_best = (i == best_idx)
        st.markdown(f"### {'' if is_best else ''} Trajectory {i+1} {'(SELECTED)' if is_best else ''}")
        if res.get("success"):
            st.info(f"SPRM Score: {res['sprm_score']:.3f} | Latency: {res['latency']:.1f}s")
            st.code(res["content"])
        else:
            st.error(f"Failed: {res.get('error', 'Unknown error')}")
    fig = px.bar(df, x="Trajectory", y="SPRM Score", color="Success", title="SPRM Scores for Each Trajectory")
    st.plotly_chart(fig, use_container_width=True)
    st.dataframe(df)
Alur aplikasi utama mencapai beberapa tujuan kunci:
dummy_sprm_score) yang meniru Shared Process Reward Model (SPRM). best_of_n_selection). Semua solusi yang dihasilkan, beserta skor SPRM dan latensi pembuatannya masing-masing, ditampilkan dalam format tekstual dan grafis untuk analisis berdampingan.Untuk mencobanya sendiri, simpan kode sebagai xbai_demo.py dan jalankan:
streamlit run xbai_demo.pyPelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




