
Cursus
Agentische workflows bouwen met LlamaIndex
2 uur
1.5K
MetaStone AI bracht onlangs XBai-o4 uit, een open-source redeneermodel dat parallelle test-time scaling en een reflectieve generatieve architectuur introduceert. Met 32,8 miljard parameters en een geïntegreerde zelfevaluatie-head overtreft XBai o4 OpenAI’s o3-mini (medium-modus) op kernbenchmarks voor wiskundige redenering, terwijl het lokaal draait.
In deze blog focus ik op de unieke reflectieve redeneercapaciteiten van XBai o4. Ik laat zien hoe het via een lokaal geïmplementeerde Streamlit-interface, aangedreven door LM Studio, meerdere oplossingspaden voor wiskundige problemen genereert en beoordeelt.
In deze tutorial leg ik stap voor stap uit hoe je:
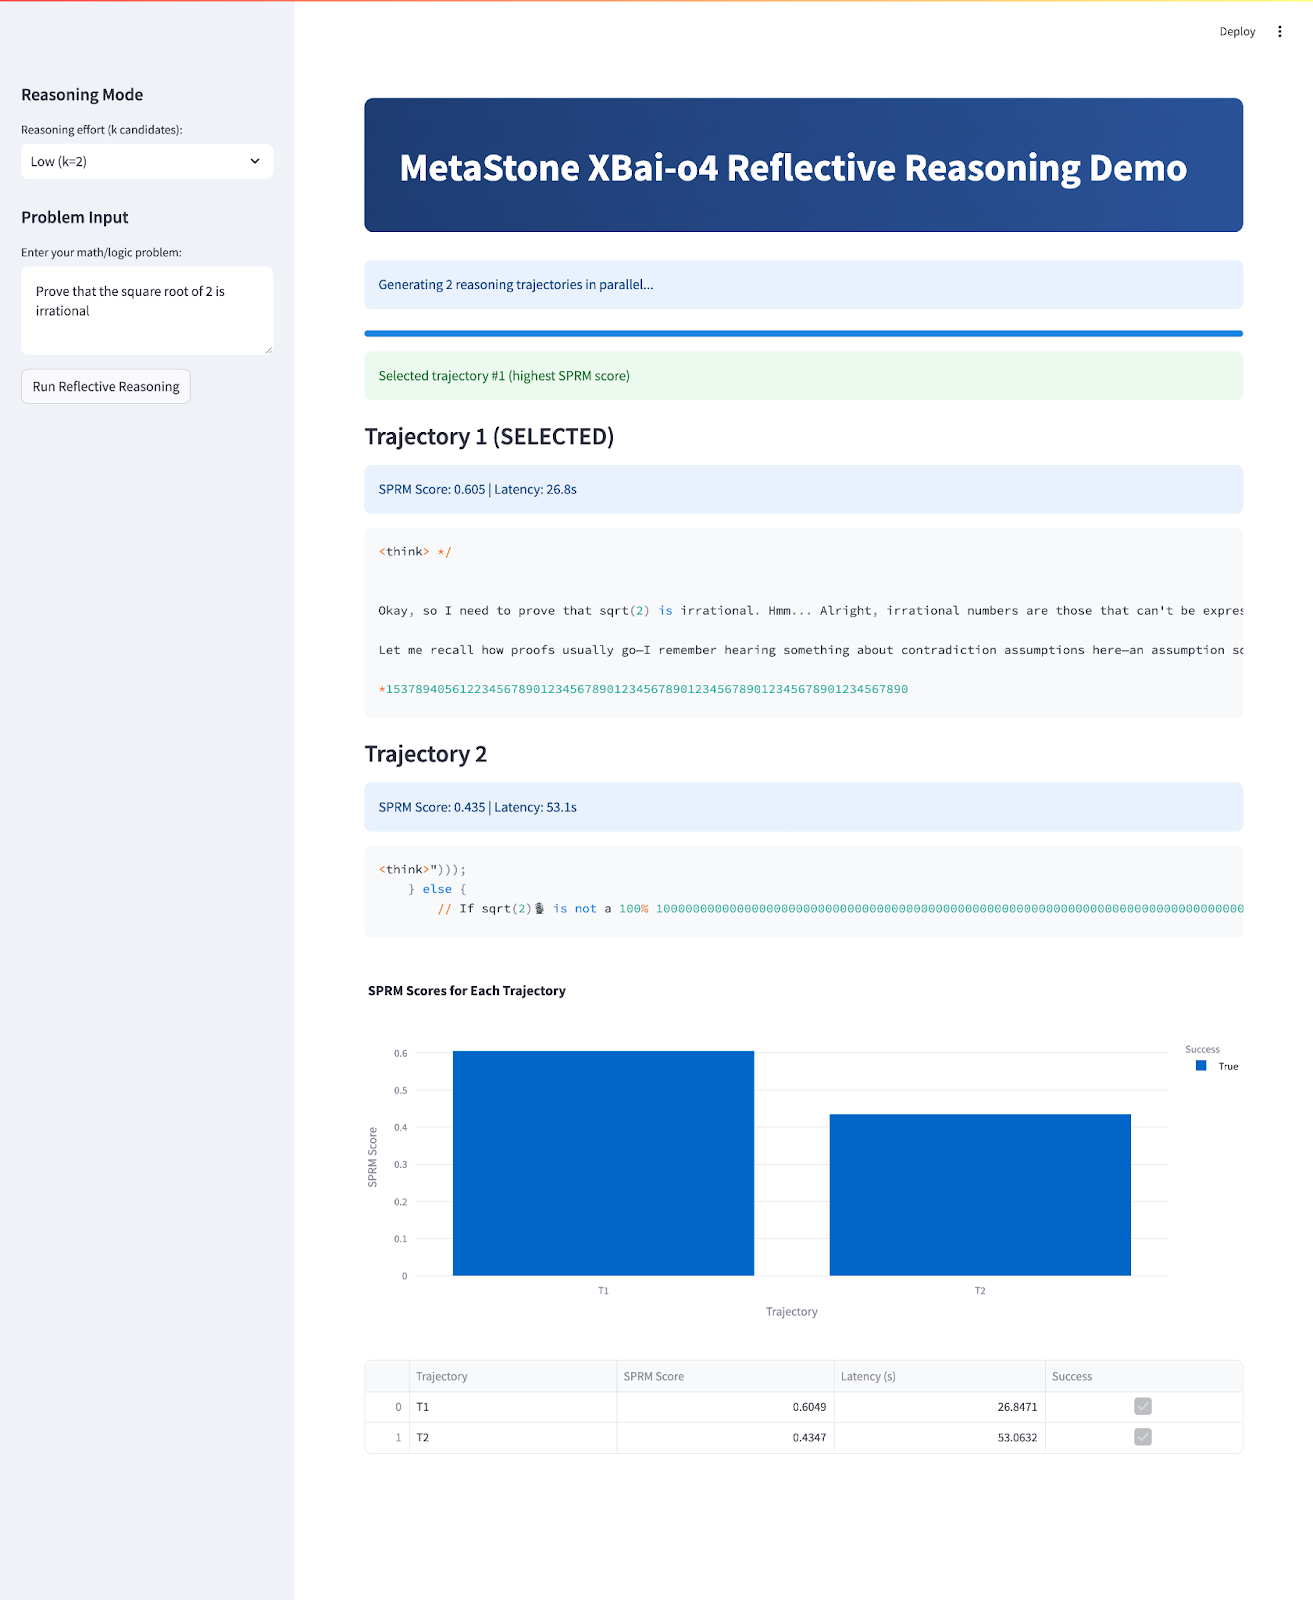
Aan het eind ziet je app er zo uit:
XBai-o4 is MetaStone AI’s vierde generatie open-source redeneermodel met een reflectieve generatieve architectuur die probeert te herdefiniëren hoe AI complexe probleemoplossing benadert. In tegenstelling tot traditionele LLM’s die het genereren en beoordelen van antwoorden als twee afzonderlijke processen behandelen, voegt XBai o4 deze samen in één verenigd model via een Shared Process Reward Model (SPRM). Dit ontwerp stelt het model in staat om meerdere redeneerroutes parallel te genereren, scoren en selecteren.
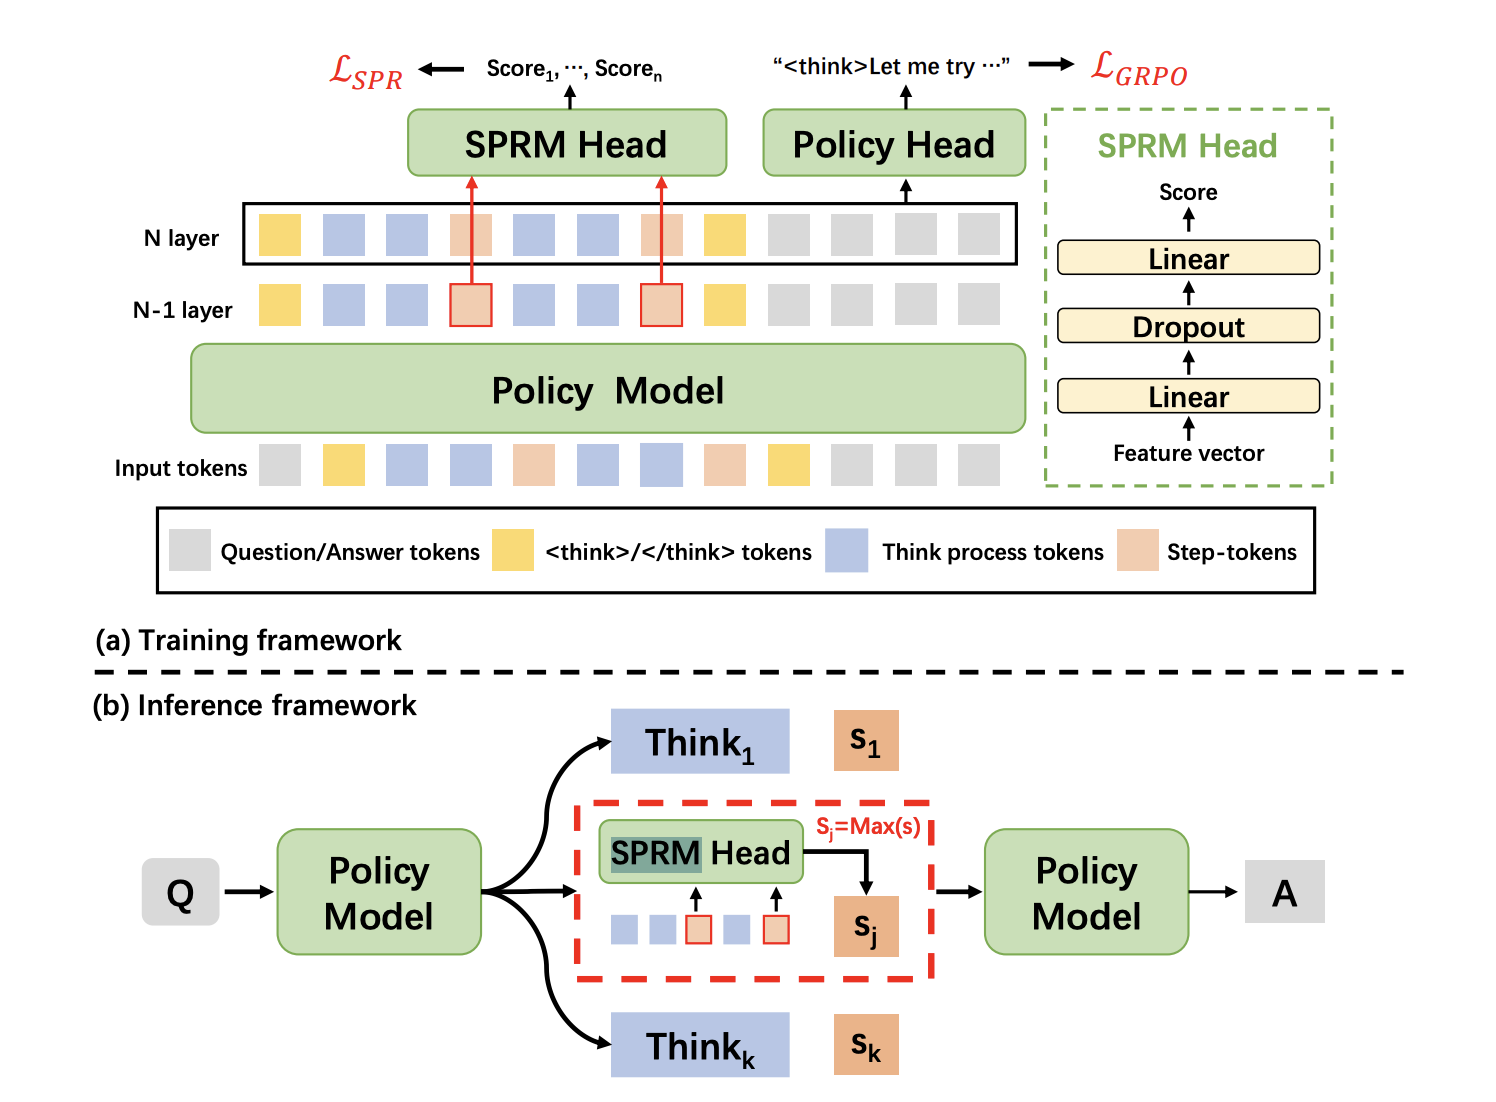
Bron: SPRM Head
In de kern combineert XBai o4 long chain-of-thought (Long-CoT) reinforcement learning en process reward learning in één trainingspipeline. Enkele belangrijke innovaties in dit model:
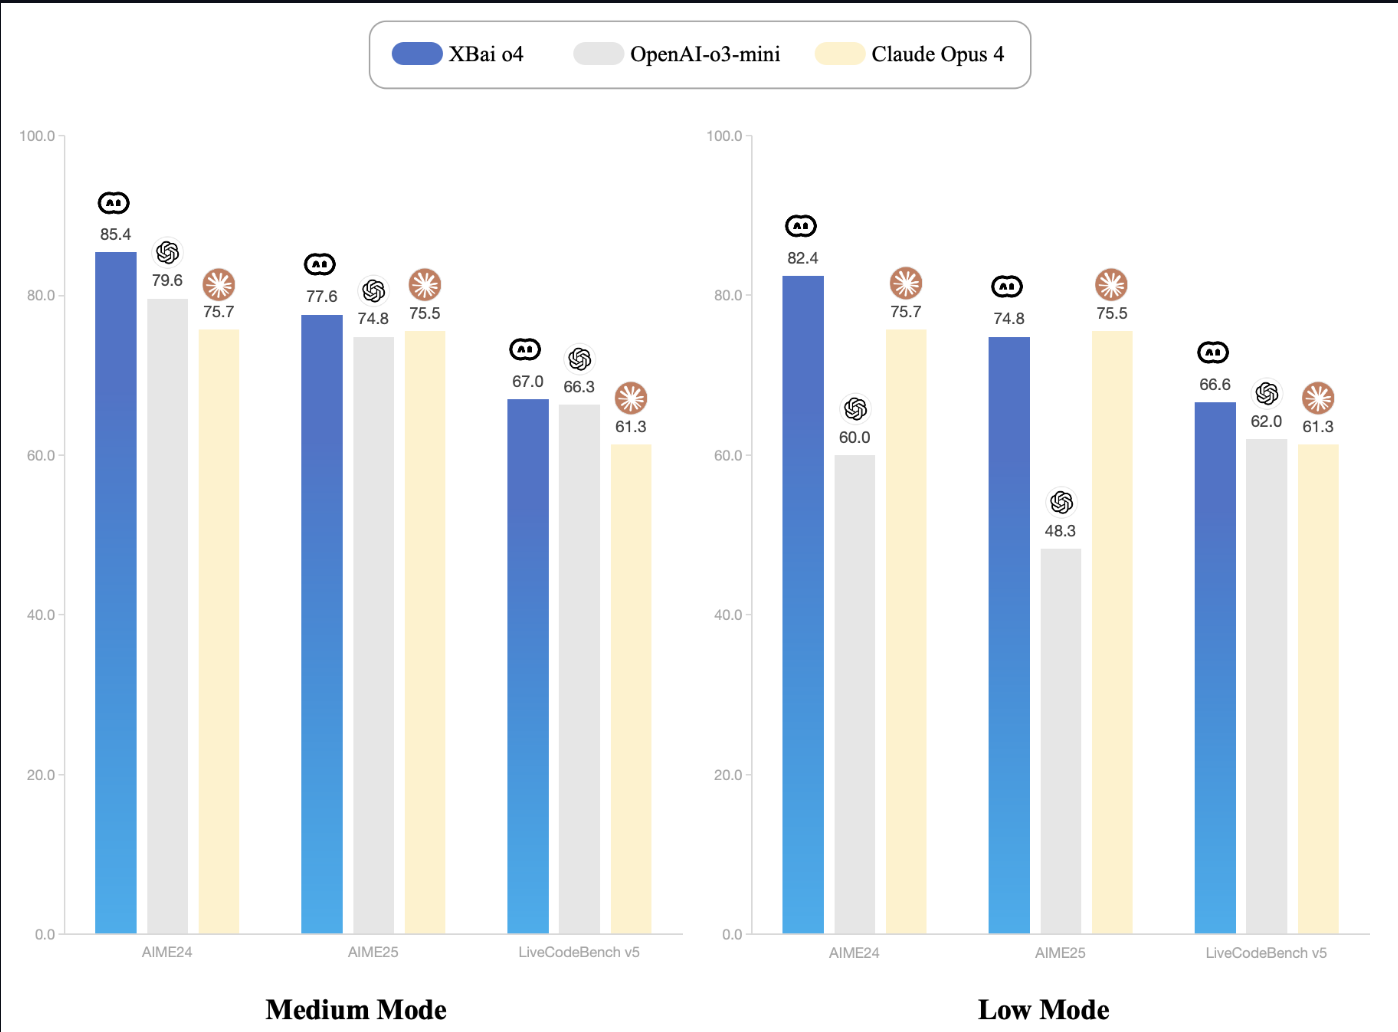
Bron: XBai-O4-documentatie
Je kunt XBai o4 lokaal draaien met LM Studio, dat automatisch de GPU of Apple Silicon (Metal/MLX) van je systeem gebruikt wanneer beschikbaar (geen handmatige setup nodig). Voor optimale prestaties en compatibiliteit raad ik de gequantiseerde GGUF-versie van het model aan.
De GGUF-standaard (GPT-Generated Unified Format) maakt zeer efficiënte lokale inferentie mogelijk door de precisie van modelgewichten te verlagen. In dit project gebruiken we de gequantiseerde variant Q3_K_S, een populaire keuze vanwege de uitstekende balans tussen kwaliteit en geheugengebruik.
Q3_K_S-formaat sterke redeneerprestaties met minimale kwaliteitsverlies ten opzichte van full-precision modellen.Laten we stap voor stap het proces doorlopen om het gequantiseerde GGUF-model in te stellen voor efficiënte lokale inferentie met LM Studio.
LM Studio biedt GGUF-ondersteuning en selecteert automatisch de optimale inferentie-backend voor je hardware, of dat nu Metal, GPU of CPU is.
Heb je LM Studio nog niet geïnstalleerd, download het dan via lmstudio.ai en volg de installatie-instructies.
In LM Studio:
mradermacher/XBai-o4-GGUFXBai-o4.Q3_K_S.gguf (14,39 GB).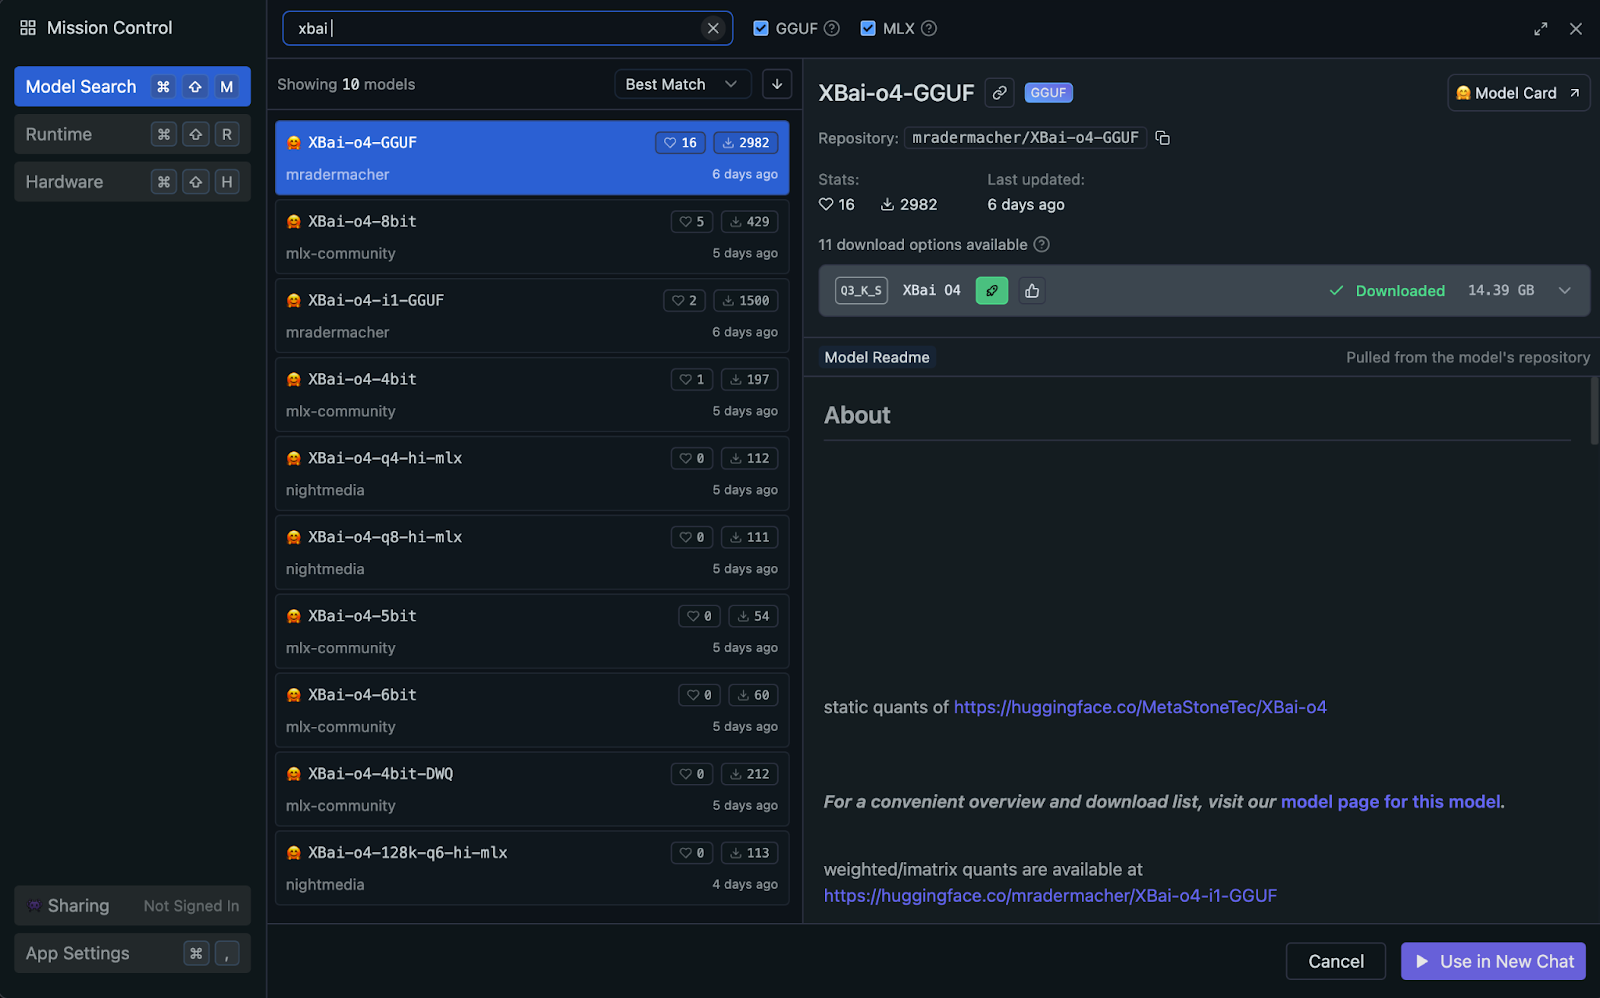
Zodra LM Studio is geïnstalleerd, laden en configureren we het XBai o4-model voor lokale inferentie:
XBai-o4.Q3_K_S.gguf uit je lijst met gedownloade modellen.Als de server draait, is je systeem klaar voor redeneren met meerdere trajecten met XBai o4.
We bouwen nu een Streamlit-applicatie die de reflectieve redeneercapaciteiten van XBai o4 demonstreert met een realtime prestatievergelijking.
Begin met het installeren van dependencies:
pip install streamlit plotly pandas numpy requestsMet dit commando installeer je alle kerndependencies voor de UI, data-afhandeling, visualisaties en API-requests.
Importeer vervolgens alle vereiste libraries en configureer je Streamlit-paginalay-out en basisinstellingen.
import streamlit as st
import time
import requests
import numpy as np
import pandas as pd
import plotly.express as px
from typing import List, Dict, Any
LM_STUDIO_URL = "http://localhost:1234/v1"   # change as per your server
REASONING_MODES = {"Low (k=2)": 2, "Medium (k=8)": 8, "High (k=32)": 8}
st.set_page_config(page_title="MetaStone-XBai-o4 Reflective Reasoning Demo", layout="wide")
st.markdown("""
<style>
    .main-header {
        background: linear-gradient(90deg, #1e3c72 0%, #2a5298 100%);

        border-radius: 10px;
        color: white;
        text-align: center;

    }
</style>
""", unsafe_allow_html=True)
Dit codeblok importeert alle kernbibliotheken voor onze demo, waaronder Streamlit voor de web-UI, en andere basistools zoals time, requests, numpy, pandas, plotly.express en typing-hulpmiddelen.
Vervolgens stelt het de model-API-endpoint LM_STUDIO_URL in zodat de app weet waar requests naartoe moeten, en definieert het redeneermodi (REASONING_MODES) zodat gebruikers eenvoudig kunnen kiezen hoeveel oplossingspaden ze willen genereren.
Tot slot gebruiken we st.set_page_config() om de Streamlit-UI te configureren met een aangepaste titel, breed lay-out en een CSS-gestylede verloopkop.
Let op: de LM_STUDIO_URL is de basis-URL van de LLM-server, die je kunt kopiëren uit LM Studio. Meestal is dat "http://localhost:1234/v1", maar dit kan variëren. Kies ook redeneermodi op basis van de capaciteiten van je server.
We bouwen nu een set helperfuncties die de kernlogica van “reflectieve redenering” in onze app aandrijven. Deze functies maken het eenvoudig om met meerdere trajecten te werken, de beste oplossing te kiezen en elk antwoord te scoren.
Deze stap introduceert een eenvoudige helperfunctie die automatisch controleert of onze LM Studio-server multi-trajectory sampling aankan. Sommige servers ondersteunen de n-parameter, waarmee we meerdere onafhankelijke completions in één API-call kunnen opvragen en zo het proces aanzienlijk versnellen.
def supports_n_param():
    payload = {
        "messages": [{"role": "user", "content": "What is 1+1?"}],
        "max_tokens": 80,
        "temperature": 0.1,
        "n": 2,
        "stream": False
    }
    try:
        resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
        if resp.status_code == 200 and len(resp.json().get("choices", [])) == 2:
            return True
    except Exception:
        pass
    return False
Deze functie controleert of je LM Studio-server meerdere antwoorden (“trajecten”) kan genereren in één API-call met behulp van de n-parameter. Er wordt een snelle testrequest verzonden en True geretourneerd als de functie beschikbaar is. Zo wordt echte “Best-of-N”-sampling mogelijk voor snellere, schaalbare redenering.
Als we weten of onze backend multi-trajectory sampling ondersteunt, is de volgende stap het genereren van meerdere redeneerroutes voor een gegeven probleem. In deze sectie komen helperfuncties aan bod die óf server-side multisampling gebruiken (wanneer beschikbaar), óf efficiënt single completions paralleliseren, zodat de app snel en schaalbaar blijft.
def lm_studio_generate_multiple(problem, k, temperature=0.8, seed=2025):
    prompt = f"<think> {problem}\n</think>"
    payload = {
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 196,
        "temperature": temperature,
        "top_p": 0.9,
        "top_k": 30,
        "n": k,
        "stream": False,
        "seed": seed
    }
    start = time.time()
    resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
    latency = time.time() - start
    if resp.status_code == 200:
        result = resp.json()
        return [{
            "content": choice["message"]["content"].strip(),
            "latency": latency / k,
            "success": True,
        } for choice in result.get("choices", [])]
    else:
        raise RuntimeError(f"LM Studio error: {resp.status_code}: {resp.text}")
def lm_studio_generate_single(problem, temperature, seed=None):
    prompt = f"<think> {problem}\n</think>"
    payload = {
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 196,
        "temperature": temperature,
        "top_p": 0.9,
        "top_k": 30,
        "stream": False,
        "seed": seed
    }
    start = time.time()
    resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
    latency = time.time() - start
    if resp.status_code == 200:
        content = resp.json()["choices"][0]["message"]["content"].strip()
        return {"content": content, "latency": latency, "success": True}
    else:
        return {"success": False, "error": f"HTTP {resp.status_code}: {resp.text}", "latency": latency}
def parallel_candidate_generation(problem, k, progress_cb=None):
    import concurrent.futures
    temperatures = np.linspace(0.1, 1.0, k)
    results = []
    with concurrent.futures.ThreadPoolExecutor(max_workers=min(8, k)) as executor:
        futures = []
        for i in range(k):
            seed = 2025 + i * 31
            futures.append(executor.submit(lm_studio_generate_single, problem, temperatures[i], seed))
        for i, future in enumerate(concurrent.futures.as_completed(futures)):
            res = future.result()
            res["trajectory_id"] = i + 1
            results.append(res)
            if progress_cb:
                progress_cb(i + 1, k)
    results.sort(key=lambda x: x.get("trajectory_id", 0))
    return results
Zo past elke functie in de multi-trajectory pipeline:
lm_studio_generate_multiple(): als de LM Studio-server de n-parameter ondersteunt, stuurt deze functie één API-request om in één keer k diverse oplossingen te genereren. Dit is de efficiëntste modus en maakt echte test-time scaling mogelijk.lm_studio_generate_single(): als de server geen multisampling ondersteunt, biedt deze functie een fallback die per request één oplossingspad genereert, met ruimte voor verschillende temperaturen en reproduceerbaarheid via seeds.parallel_candidate_generation(): om de prestaties in fallback-modus op peil te houden, start deze utility meerdere aanroepen van lm_studio_generate_single() parallel, elk met verschillende samplingtemperaturen, en voegt alle responses samen. Zo krijgen we snel een brede variatie aan oplossingen, ook zonder echte multisampling.Na het genereren van meerdere redeneerroutes hebben we een gestructureerde manier nodig om de sterkste oplossing te identificeren. Deze stap introduceert tools voor scoring en selectie die de rewardmodelling (SPRM) uit de MetaStone Reflective Reasoning-paper nabootsen.
def step_tokenize(trajectory: str) -> List[str]:
    steps = [step.strip() for step in trajectory.split('.\n\n') if step.strip()]
    return steps
def dummy_sprm_score(trajectory: str, problem: str) -> float:
    steps = step_tokenize(trajectory)
    n = len(steps)
    def step_score(step):
        s = 0.2
        if any(x in step.lower() for x in ["therefore", "thus", "so", "finally", "conclude"]): s += 0.15
        if any(sym in step for sym in ["=", "+", "-", "*", "/", "(", ")"]): s += 0.1
        if len(step.split()) > 10: s += 0.1
        return min(1.0, s)
    step_scores = [step_score(s) for s in steps] or [0.01]
    geometric_mean = np.exp(np.mean(np.log(np.maximum(step_scores, 1e-3))))
    return min(1.0, geometric_mean + 0.05 * np.log1p(n))
def best_of_n_selection(candidates: List[Dict]) -> int:
    best_idx = int(np.argmax([c["sprm_score"] for c in candidates]))
    return best_idx
Dit doet elke functie:
step_tokenize(): splitst een redeneertraject in logische stappen of segmenten, zodat je per stap kunt analyseren en scoren.dummy_sprm_score(): kent een rewardscore toe aan elke kandidaat en beloont antwoorden die meerstaps, goed gestructureerd en wiskundig onderbouwd zijn. Het fungeert als vervanging voor het Shared Process Reward Model (SPRM) uit de paper, dat intern oplossingen beoordeelt.best_of_n_selection(): gegeven een batch kandidaat-antwoorden selecteert deze functie het beste traject op basis van de hoogste SPRM-score, net zoals het reflectieve model in de paper op testtijd automatisch het meest robuuste antwoord kiest.In deze stap brengen we alles samen tot een interactieve redeneer-demo met Streamlit.
st.markdown("""
<div class="main-header">
    <h1> MetaStone XBai-o4 Reflective Reasoning Demo</h1>
</div>
""", unsafe_allow_html=True)
st.sidebar.header("Reasoning Mode")
mode = st.sidebar.selectbox("Reasoning effort (k candidates):", list(REASONING_MODES.keys()))
k = REASONING_MODES[mode]
st.sidebar.header("Problem Input")
problem = st.sidebar.text_area("Enter your math/logic problem:", "Prove that the square root of 2 is irrational")
if st.sidebar.button("Run Reflective Reasoning"):
    st.session_state.run = True
    st.session_state.results = None
    st.session_state.best_idx = None
if "run" not in st.session_state:
    st.session_state.run = False
if st.session_state.run:
    st.info(f"Generating {k} reasoning trajectories in parallel...")
    progress = st.progress(0)
    def update_progress(done, total):
        progress.progress(done / total)
    try:
        if supports_n_param():
            results = lm_studio_generate_multiple(problem, k, temperature=0.7)
            for idx, res in enumerate(results):
                res["trajectory_id"] = idx + 1
        else:
            results = parallel_candidate_generation(problem, k, progress_cb=update_progress)
        for res in results:
            if res.get("success"):
                res["sprm_score"] = dummy_sprm_score(res["content"], problem)
            else:
                res["sprm_score"] = 0.0
        best_idx = best_of_n_selection(results)
        st.session_state.results = results
        st.session_state.best_idx = best_idx
        st.session_state.run = False
    except Exception as e:
        st.error(f"Failed to generate trajectories: {str(e)}")
        st.session_state.run = False
if st.session_state.get("results"):
    results = st.session_state.results
    best_idx = st.session_state.best_idx
    st.success(f"Selected trajectory #{best_idx+1} (highest SPRM score)")
    df = pd.DataFrame({
        "Trajectory": [f"T{i+1}" for i in range(len(results))],
        "SPRM Score": [r["sprm_score"] for r in results],
        "Latency (s)": [r.get("latency", 0.0) for r in results],
        "Success": [r.get("success", False) for r in results]
    })
    for i, res in enumerate(results):
        is_best = (i == best_idx)
        st.markdown(f"### {'' if is_best else ''} Trajectory {i+1} {'(SELECTED)' if is_best else ''}")
        if res.get("success"):
            st.info(f"SPRM Score: {res['sprm_score']:.3f} | Latency: {res['latency']:.1f}s")
            st.code(res["content"])
        else:
            st.error(f"Failed: {res.get('error', 'Unknown error')}")
    fig = px.bar(df, x="Trajectory", y="SPRM Score", color="Success", title="SPRM Scores for Each Trajectory")
    st.plotly_chart(fig, use_container_width=True)
    st.dataframe(df)
De hoofdapplicatieflow bereikt meerdere doelen:
dummy_sprm_score), dat het Shared Process Reward Model (SPRM) nabootst. best_of_n_selection). Alle gegenereerde oplossingen, met hun respectieve SPRM-scores en generatielatenties, worden zowel tekstueel als grafisch naast elkaar weergegeven voor analyse.Wil je het zelf proberen, sla de code dan op als xbai_demo.py en start:
streamlit run xbai_demo.pyLeer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

