
Khóa học
Xây dựng quy trình Agentic với LlamaIndex
2 giờ
1.5K
MetaStone AI gần đây đã ra mắt XBai-o4, một mô hình lập luận mã nguồn mở giới thiệu cơ chế mở rộng ở thời điểm suy luận theo chiều song song và kiến trúc sinh phản chiếu. Với 32,8 tỷ tham số và một đầu tự đánh giá tích hợp, XBai o4 vượt trội so với o3-mini (chế độ trung bình) của OpenAI trên các bộ chuẩn lập luận toán học cốt lõi, đồng thời có thể chạy cục bộ.
Trọng tâm của tôi trong bài viết này là khả năng lập luận phản chiếu độc đáo của XBai o4, minh họa cách mô hình tạo và đánh giá nhiều quỹ đạo lời giải cho các bài toán toán học thông qua giao diện Streamlit triển khai cục bộ, được vận hành bởi LM Studio.
Trong hướng dẫn này, tôi sẽ giải thích từng bước cách:
Cuối cùng, ứng dụng của bạn sẽ trông như thế này:
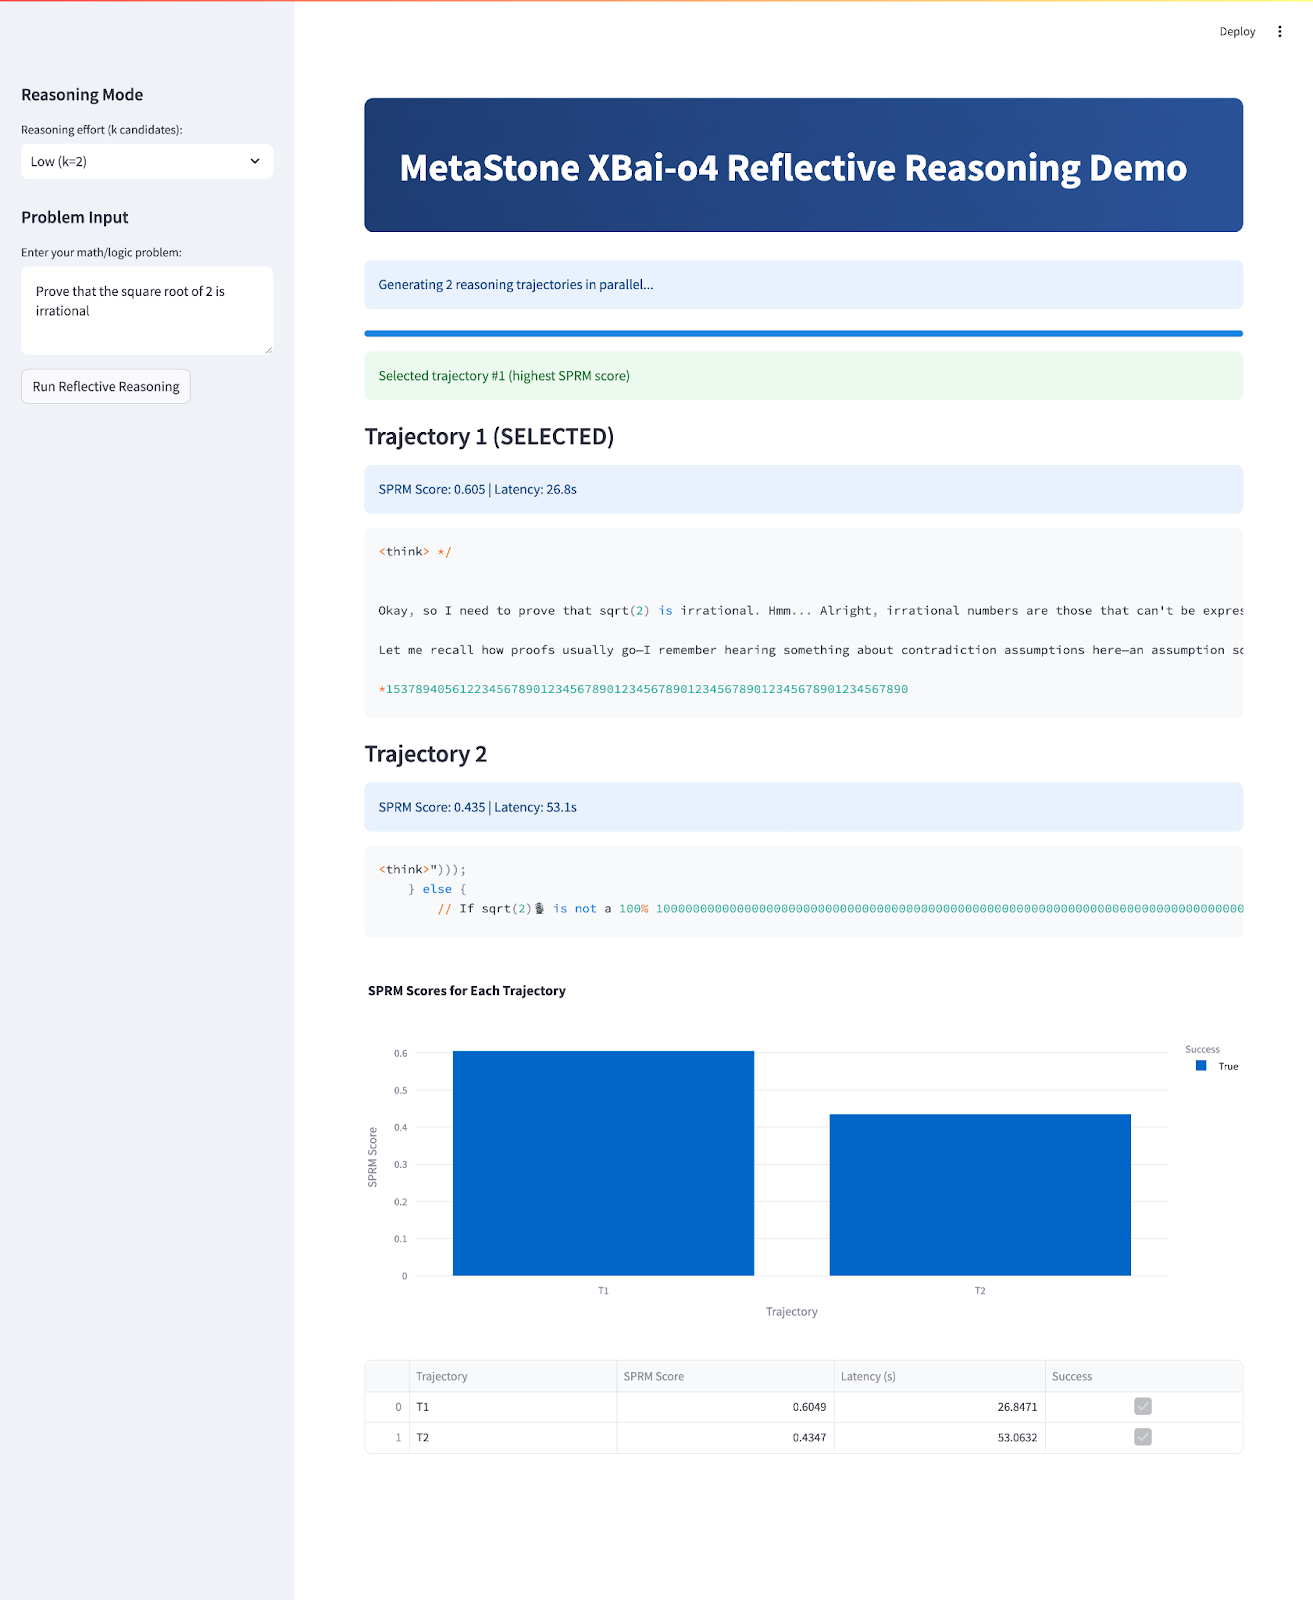
XBai-o4 là mô hình lập luận mã nguồn mở thế hệ thứ tư của MetaStone AI, giới thiệu kiến trúc sinh phản chiếu nhằm tái định nghĩa cách AI tiếp cận giải quyết vấn đề phức tạp. Khác với các LLM truyền thống tách rời việc sinh đáp án và đánh giá đáp án thành hai quy trình, XBai o4 hợp nhất cả hai trong một mô hình thống nhất sử dụng Shared Process Reward Model (SPRM). Thiết kế này cho phép mô hình tạo, chấm điểm và chọn nhiều đường lập luận song song.
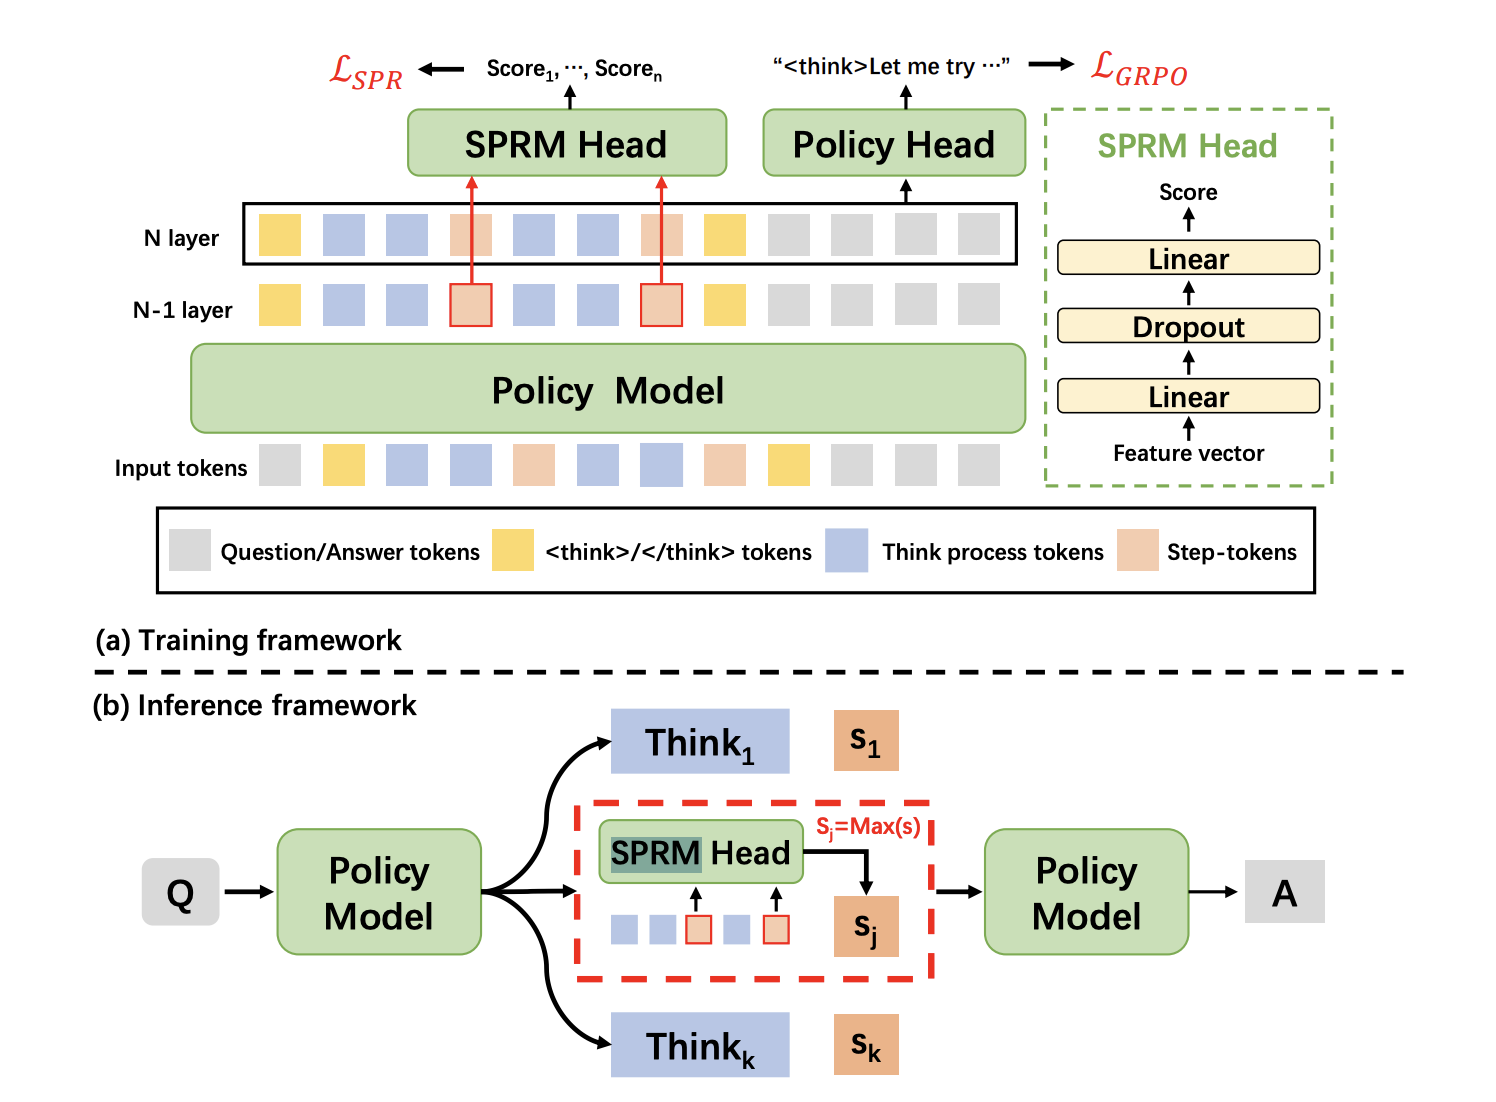
Nguồn: SPRM Head
Cốt lõi của XBai o4 kết hợp tăng cường học chuỗi suy nghĩ dài (Long-CoT) và học phần thưởng theo tiến trình trong một quy trình huấn luyện duy nhất. Dưới đây là một số đổi mới nổi bật của mô hình:
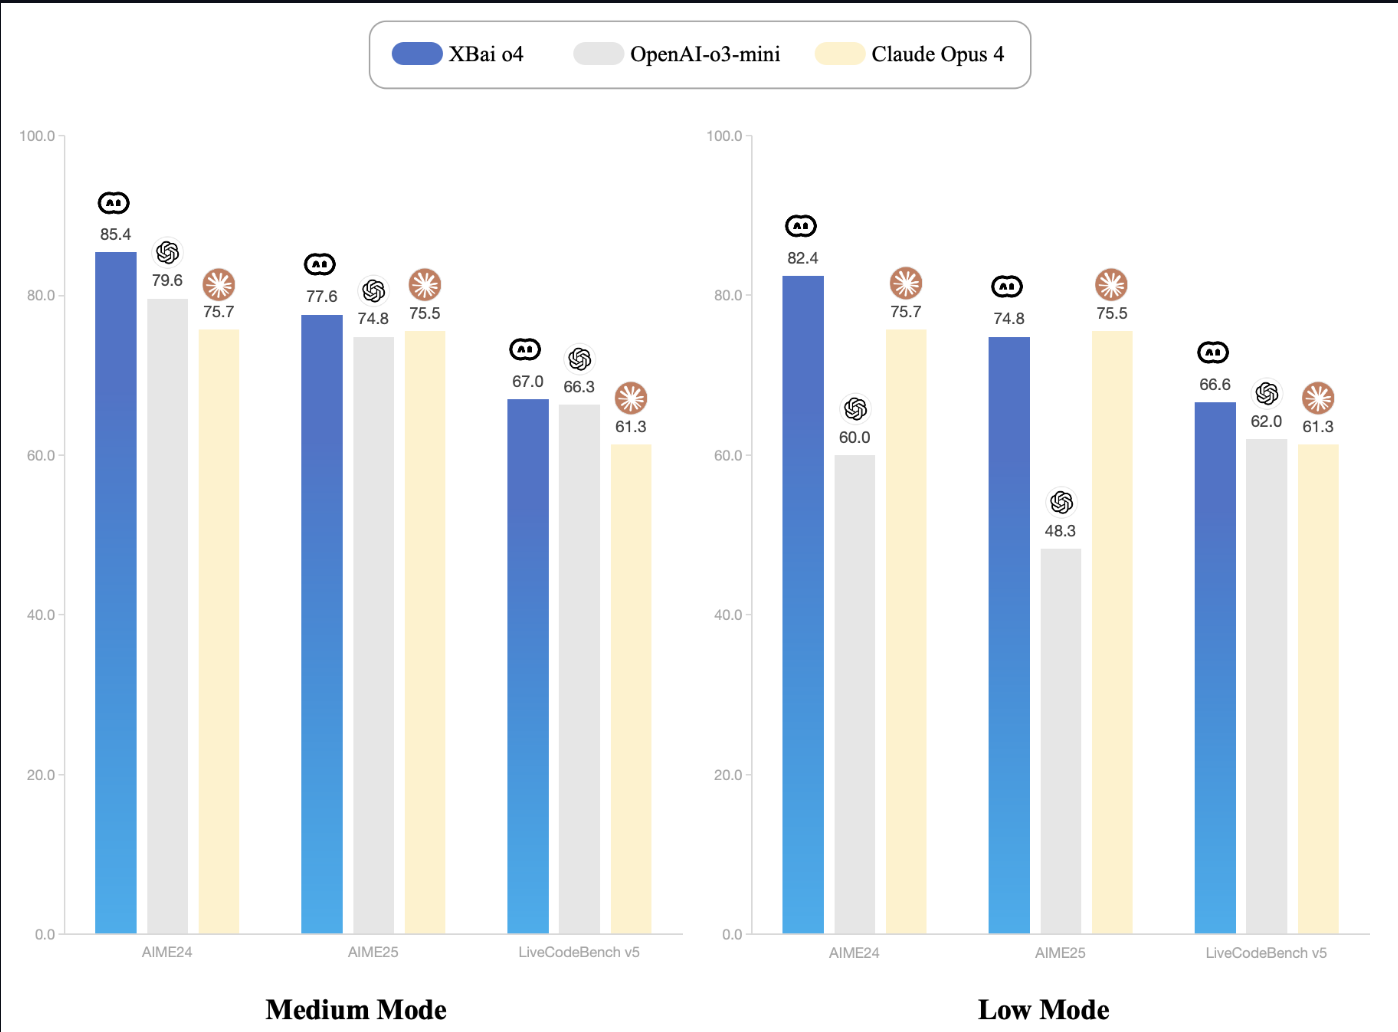
Nguồn: Tài liệu XBai-O4
Bạn có thể chạy XBai o4 cục bộ bằng LM Studio, tự động sử dụng GPU của hệ thống hoặc tăng tốc Apple Silicon (Metal/MLX) khi khả dụng (không cần cấu hình thủ công). Để có hiệu năng và khả năng tương thích tối ưu, tôi khuyến nghị dùng phiên bản mô hình đã lượng tử hóa GGUF.
Chuẩn GGUF (GPT-Generated Unified Format) cho phép suy luận cục bộ hiệu quả cao bằng cách giảm độ chính xác của trọng số mô hình. Trong dự án này, chúng ta sẽ dùng biến thể lượng tử hóa Q3_K_S, một lựa chọn phổ biến nhờ cân bằng tốt giữa chất lượng và mức sử dụng bộ nhớ.
Q3_K_S mang lại hiệu năng lập luận mạnh với tổn thất chất lượng tối thiểu so với mô hình độ chính xác đầy đủ.Hãy cùng đi qua quy trình từng bước để thiết lập mô hình GGUF đã lượng tử hóa cho suy luận cục bộ hiệu quả bằng LM Studio.
LM Studio hỗ trợ GGUF và tự động chọn backend suy luận tối ưu cho phần cứng của bạn, dù là Metal, GPU hay CPU.
Nếu bạn chưa cài LM Studio, chỉ cần tải từ lmstudio.ai và làm theo hướng dẫn cài đặt.
Trong LM Studio:
mradermacher/XBai-o4-GGUFXBai-o4.Q3_K_S.gguf (14,39 GB).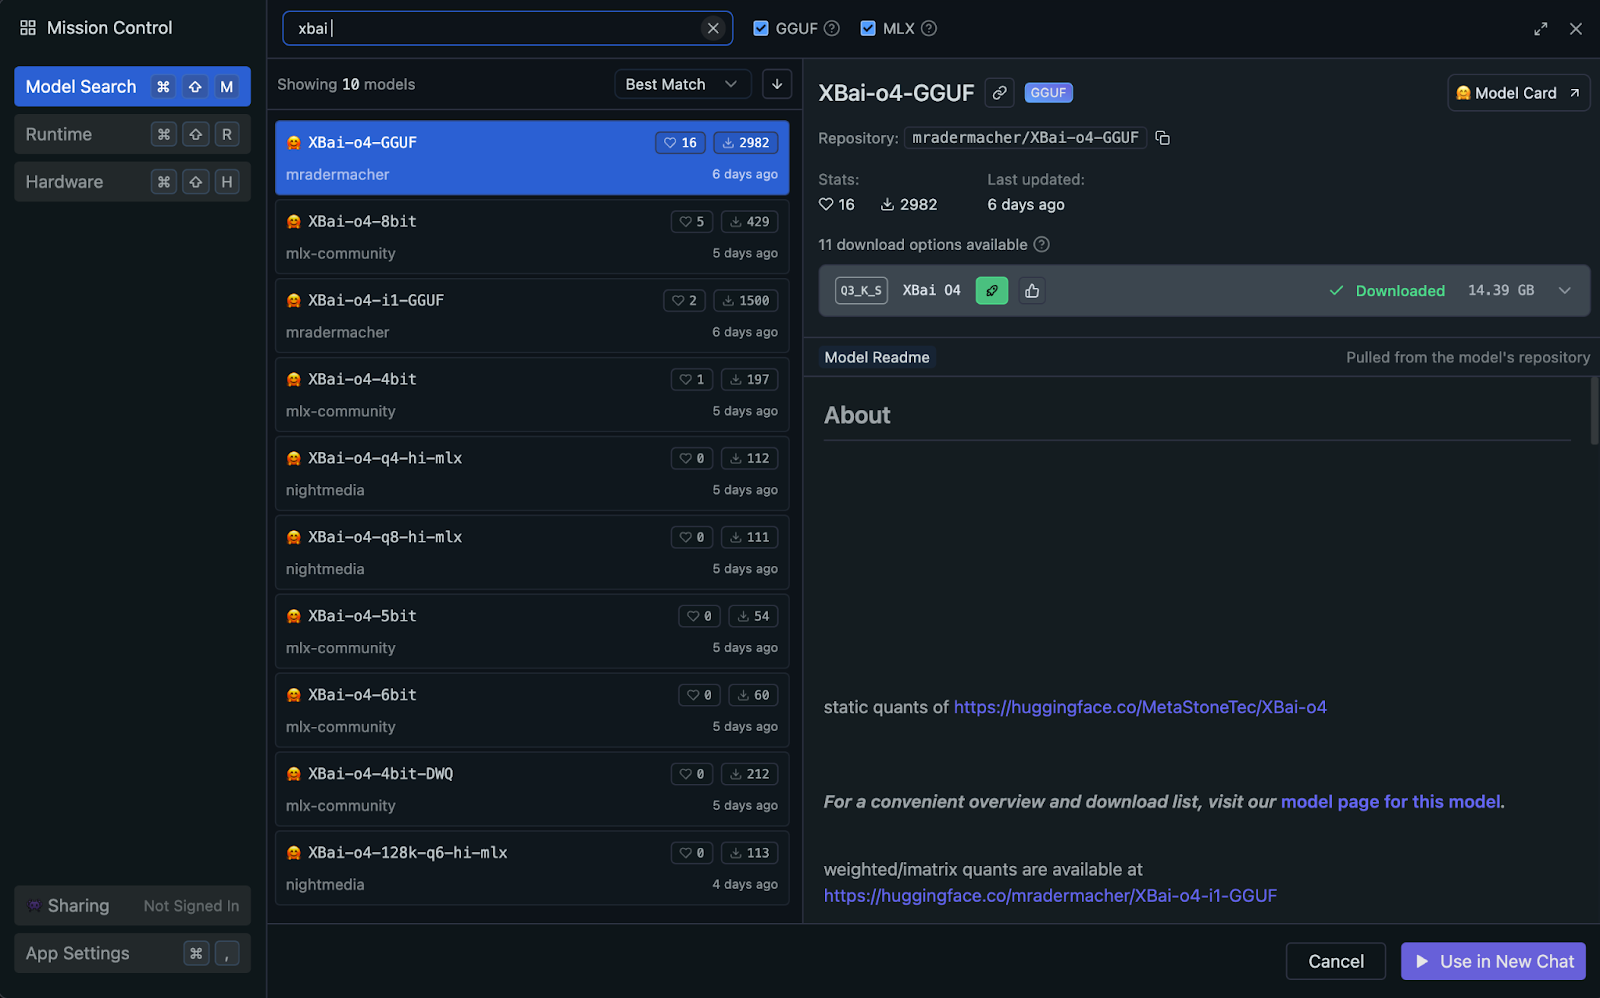
Sau khi cài LM Studio, chúng ta nạp và cấu hình mô hình XBai o4 để suy luận cục bộ:
XBai-o4.Q3_K_S.gguf từ danh sách mô hình đã tải.Khi đã chạy, hệ thống của bạn sẵn sàng cho lập luận đa quỹ đạo với XBai o4.
Giờ chúng ta sẽ xây dựng một ứng dụng Streamlit minh họa khả năng lập luận phản chiếu của XBai o4 với so sánh hiệu năng theo thời gian thực.
Bắt đầu bằng cách cài đặt các phụ thuộc:
pip install streamlit plotly pandas numpy requestsLệnh này đảm bảo bạn có đủ phụ thuộc cốt lõi cho giao diện người dùng, xử lý dữ liệu, vẽ biểu đồ và gọi API.
Tiếp theo, import toàn bộ thư viện cần thiết và cấu hình bố cục trang Streamlit cùng các thiết lập cơ bản.
import streamlit as st
import time
import requests
import numpy as np
import pandas as pd
import plotly.express as px
from typing import List, Dict, Any
LM_STUDIO_URL = "http://localhost:1234/v1"   # change as per your server
REASONING_MODES = {"Low (k=2)": 2, "Medium (k=8)": 8, "High (k=32)": 8}
st.set_page_config(page_title="MetaStone-XBai-o4 Reflective Reasoning Demo", layout="wide")
st.markdown("""
<style>
    .main-header {
        background: linear-gradient(90deg, #1e3c72 0%, #2a5298 100%);

        border-radius: 10px;
        color: white;
        text-align: center;

    }
</style>
""", unsafe_allow_html=True)
Khối mã này import toàn bộ thư viện cốt lõi cho demo, bao gồm Streamlit cho giao diện web, cùng các thư viện cơ bản như time, requests, numpy, pandas, plotly.express và công cụ gợi ý kiểu.
Sau đó đặt endpoint API mô hình LM_STUDIO_URL để ứng dụng biết nơi gửi yêu cầu, và định nghĩa các chế độ lập luận (REASONING_MODES) để người dùng dễ chọn số nhánh lời giải cần tạo.
Cuối cùng, chúng ta dùng st.set_page_config() để cấu hình UI Streamlit với tiêu đề tùy chỉnh, bố cục rộng và phần đầu trang có nền chuyển sắc bằng CSS.
Lưu ý: LM_STUDIO_URL là URL gốc của máy chủ LLM, bạn có thể sao chép từ LM Studio. Thông thường là "http://localhost:1234/v1" nhưng có thể thay đổi. Ngoài ra, hãy chọn chế độ lập luận phù hợp với khả năng máy chủ của bạn.
Giờ chúng ta xây dựng bộ hàm trợ giúp vận hành logic "lập luận phản chiếu" cốt lõi của ứng dụng. Các hàm này giúp làm việc với nhiều quỹ đạo, chọn lời giải tốt nhất và chấm điểm từng câu trả lời.
Bước này giới thiệu hàm đơn giản tự động kiểm tra máy chủ LM Studio có xử lý được lấy mẫu đa quỹ đạo hay không. Một số máy chủ hỗ trợ tham số n, cho phép yêu cầu nhiều phản hồi độc lập trong một lần gọi API, từ đó tăng tốc đáng kể.
def supports_n_param():
    payload = {
        "messages": [{"role": "user", "content": "What is 1+1?"}],
        "max_tokens": 80,
        "temperature": 0.1,
        "n": 2,
        "stream": False
    }
    try:
        resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
        if resp.status_code == 200 and len(resp.json().get("choices", [])) == 2:
            return True
    except Exception:
        pass
    return False
Hàm này kiểm tra máy chủ LM Studio của bạn có hỗ trợ tạo nhiều câu trả lời (“quỹ đạo”) trong một lệnh gọi API bằng tham số n hay không. Nó gửi một yêu cầu thử nhanh và trả về True nếu tính năng khả dụng, từ đó kích hoạt lấy mẫu “Best-of-N” đích thực để lập luận nhanh và mở rộng.
Sau khi xác định backend có hỗ trợ lấy mẫu đa quỹ đạo hay không, bước tiếp theo là tạo nhiều đường lập luận cho một bài toán. Phần này giới thiệu các hàm trợ giúp dùng lấy mẫu phía máy chủ (khi có) hoặc song song hóa các lần sinh đơn lẻ một cách hiệu quả, đảm bảo ứng dụng vẫn nhanh và có khả năng mở rộng.
def lm_studio_generate_multiple(problem, k, temperature=0.8, seed=2025):
    prompt = f"<think> {problem}\n</think>"
    payload = {
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 196,
        "temperature": temperature,
        "top_p": 0.9,
        "top_k": 30,
        "n": k,
        "stream": False,
        "seed": seed
    }
    start = time.time()
    resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
    latency = time.time() - start
    if resp.status_code == 200:
        result = resp.json()
        return [{
            "content": choice["message"]["content"].strip(),
            "latency": latency / k,
            "success": True,
        } for choice in result.get("choices", [])]
    else:
        raise RuntimeError(f"LM Studio error: {resp.status_code}: {resp.text}")
def lm_studio_generate_single(problem, temperature, seed=None):
    prompt = f"<think> {problem}\n</think>"
    payload = {
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 196,
        "temperature": temperature,
        "top_p": 0.9,
        "top_k": 30,
        "stream": False,
        "seed": seed
    }
    start = time.time()
    resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
    latency = time.time() - start
    if resp.status_code == 200:
        content = resp.json()["choices"][0]["message"]["content"].strip()
        return {"content": content, "latency": latency, "success": True}
    else:
        return {"success": False, "error": f"HTTP {resp.status_code}: {resp.text}", "latency": latency}
def parallel_candidate_generation(problem, k, progress_cb=None):
    import concurrent.futures
    temperatures = np.linspace(0.1, 1.0, k)
    results = []
    with concurrent.futures.ThreadPoolExecutor(max_workers=min(8, k)) as executor:
        futures = []
        for i in range(k):
            seed = 2025 + i * 31
            futures.append(executor.submit(lm_studio_generate_single, problem, temperatures[i], seed))
        for i, future in enumerate(concurrent.futures.as_completed(futures)):
            res = future.result()
            res["trajectory_id"] = i + 1
            results.append(res)
            if progress_cb:
                progress_cb(i + 1, k)
    results.sort(key=lambda x: x.get("trajectory_id", 0))
    return results
Cách mỗi hàm tham gia vào chuỗi xử lý đa quỹ đạo:
lm_studio_generate_multiple(): Khi máy chủ LM Studio hỗ trợ tham số n, hàm này gửi một yêu cầu API duy nhất để tạo k lời giải đa dạng cùng lúc. Đây là chế độ hiệu quả nhất, cho phép mở rộng ở thời điểm suy luận thực sự.lm_studio_generate_single(): Nếu máy chủ không hỗ trợ đa lấy mẫu, hàm này là phương án dự phòng để tạo một quỹ đạo lời giải mỗi lần gọi, cho phép thiết lập nhiệt độ khác nhau và tái lập bằng seed.parallel_candidate_generation(): Để giữ hiệu năng ở chế độ dự phòng, tiện ích này kích hoạt nhiều lời gọi lm_studio_generate_single() song song, mỗi lời gọi với nhiệt độ lấy mẫu khác nhau, rồi tổng hợp kết quả. Nhờ đó ta vẫn thu được phổ lời giải rộng một cách nhanh chóng, ngay cả khi không có đa lấy mẫu thực thụ.Sau khi tạo nhiều đường lập luận, chúng ta cần cách có cấu trúc để xác định lời giải mạnh nhất. Bước này giới thiệu công cụ chấm điểm và chọn lọc mô phỏng kỹ thuật mô hình thưởng (SPRM) được sử dụng trong bài báo Lập luận Phản chiếu của MetaStone.
def step_tokenize(trajectory: str) -> List[str]:
    steps = [step.strip() for step in trajectory.split('.\n\n') if step.strip()]
    return steps
def dummy_sprm_score(trajectory: str, problem: str) -> float:
    steps = step_tokenize(trajectory)
    n = len(steps)
    def step_score(step):
        s = 0.2
        if any(x in step.lower() for x in ["therefore", "thus", "so", "finally", "conclude"]): s += 0.15
        if any(sym in step for sym in ["=", "+", "-", "*", "/", "(", ")"]): s += 0.1
        if len(step.split()) > 10: s += 0.1
        return min(1.0, s)
    step_scores = [step_score(s) for s in steps] or [0.01]
    geometric_mean = np.exp(np.mean(np.log(np.maximum(step_scores, 1e-3))))
    return min(1.0, geometric_mean + 0.05 * np.log1p(n))
def best_of_n_selection(candidates: List[Dict]) -> int:
    best_idx = int(np.argmax([c["sprm_score"] for c in candidates]))
    return best_idx
Cụ thể từng hàm:
step_tokenize(): Tách một quỹ đạo lập luận thành các bước hoặc đoạn hợp lý, cho phép phân tích và chấm điểm theo bước.dummy_sprm_score(): Gán điểm thưởng cho mỗi quỹ đạo ứng viên và khuyến khích phản hồi có nhiều bước, cấu trúc tốt và sử dụng lập luận toán học. Hàm đóng vai trò thay thế cho Shared Process Reward Model (SPRM) trong bài báo, nơi mô hình tự đánh giá lời giải của mình.Hàm best_of_n_selection(): Với một lô câu trả lời ứng viên, hàm chọn quỹ đạo tốt nhất dựa trên điểm SPRM cao nhất, tương tự mô hình phản chiếu trong bài báo tự động chọn đáp án vững vàng nhất ở thời điểm suy luận.Ở bước này, chúng ta ghép mọi mảnh lại để tạo một demo lập luận tương tác với Streamlit.
st.markdown("""
<div class="main-header">
    <h1> MetaStone XBai-o4 Reflective Reasoning Demo</h1>
</div>
""", unsafe_allow_html=True)
st.sidebar.header("Reasoning Mode")
mode = st.sidebar.selectbox("Reasoning effort (k candidates):", list(REASONING_MODES.keys()))
k = REASONING_MODES[mode]
st.sidebar.header("Problem Input")
problem = st.sidebar.text_area("Enter your math/logic problem:", "Prove that the square root of 2 is irrational")
if st.sidebar.button("Run Reflective Reasoning"):
    st.session_state.run = True
    st.session_state.results = None
    st.session_state.best_idx = None
if "run" not in st.session_state:
    st.session_state.run = False
if st.session_state.run:
    st.info(f"Generating {k} reasoning trajectories in parallel...")
    progress = st.progress(0)
    def update_progress(done, total):
        progress.progress(done / total)
    try:
        if supports_n_param():
            results = lm_studio_generate_multiple(problem, k, temperature=0.7)
            for idx, res in enumerate(results):
                res["trajectory_id"] = idx + 1
        else:
            results = parallel_candidate_generation(problem, k, progress_cb=update_progress)
        for res in results:
            if res.get("success"):
                res["sprm_score"] = dummy_sprm_score(res["content"], problem)
            else:
                res["sprm_score"] = 0.0
        best_idx = best_of_n_selection(results)
        st.session_state.results = results
        st.session_state.best_idx = best_idx
        st.session_state.run = False
    except Exception as e:
        st.error(f"Failed to generate trajectories: {str(e)}")
        st.session_state.run = False
if st.session_state.get("results"):
    results = st.session_state.results
    best_idx = st.session_state.best_idx
    st.success(f"Selected trajectory #{best_idx+1} (highest SPRM score)")
    df = pd.DataFrame({
        "Trajectory": [f"T{i+1}" for i in range(len(results))],
        "SPRM Score": [r["sprm_score"] for r in results],
        "Latency (s)": [r.get("latency", 0.0) for r in results],
        "Success": [r.get("success", False) for r in results]
    })
    for i, res in enumerate(results):
        is_best = (i == best_idx)
        st.markdown(f"### {'' if is_best else ''} Trajectory {i+1} {'(SELECTED)' if is_best else ''}")
        if res.get("success"):
            st.info(f"SPRM Score: {res['sprm_score']:.3f} | Latency: {res['latency']:.1f}s")
            st.code(res["content"])
        else:
            st.error(f"Failed: {res.get('error', 'Unknown error')}")
    fig = px.bar(df, x="Trajectory", y="SPRM Score", color="Success", title="SPRM Scores for Each Trajectory")
    st.plotly_chart(fig, use_container_width=True)
    st.dataframe(df)
Luồng ứng dụng chính đạt được một số mục tiêu then chốt:
dummy_sprm_score), mô phỏng Shared Process Reward Model (SPRM). best_of_n_selection). Tất cả lời giải tạo ra, kèm điểm SPRM và độ trễ sinh tương ứng, được hiển thị ở dạng văn bản và đồ họa để so sánh song song.Để tự thử, lưu mã thành xbai_demo.py và khởi chạy:
streamlit run xbai_demo.pyHọc AI với các khóa học sau!
Khóa học
Khóa học
Khóa học