
Corso
Creare workflow agentici con LlamaIndex
2 ore
1.5K
MetaStone AI ha rilasciato di recente XBai-o4, un modello di ragionamento open source che introduce il test-time scaling in parallelo e un’architettura generativa riflessiva. Con 32,8 miliardi di parametri e una testa di auto-valutazione integrata, XBai o4 supera l’o3-mini di OpenAI (modalità media) nei benchmark chiave di ragionamento matematico, pur girando in locale.
In questo blog mi concentrerò sulle particolari capacità di ragionamento riflessivo di XBai o4, mostrando come generi e valuti più traiettorie di soluzione per problemi matematici tramite un’interfaccia Streamlit in locale alimentata da LM Studio.
In questo tutorial, ti spiegherò passo dopo passo come:
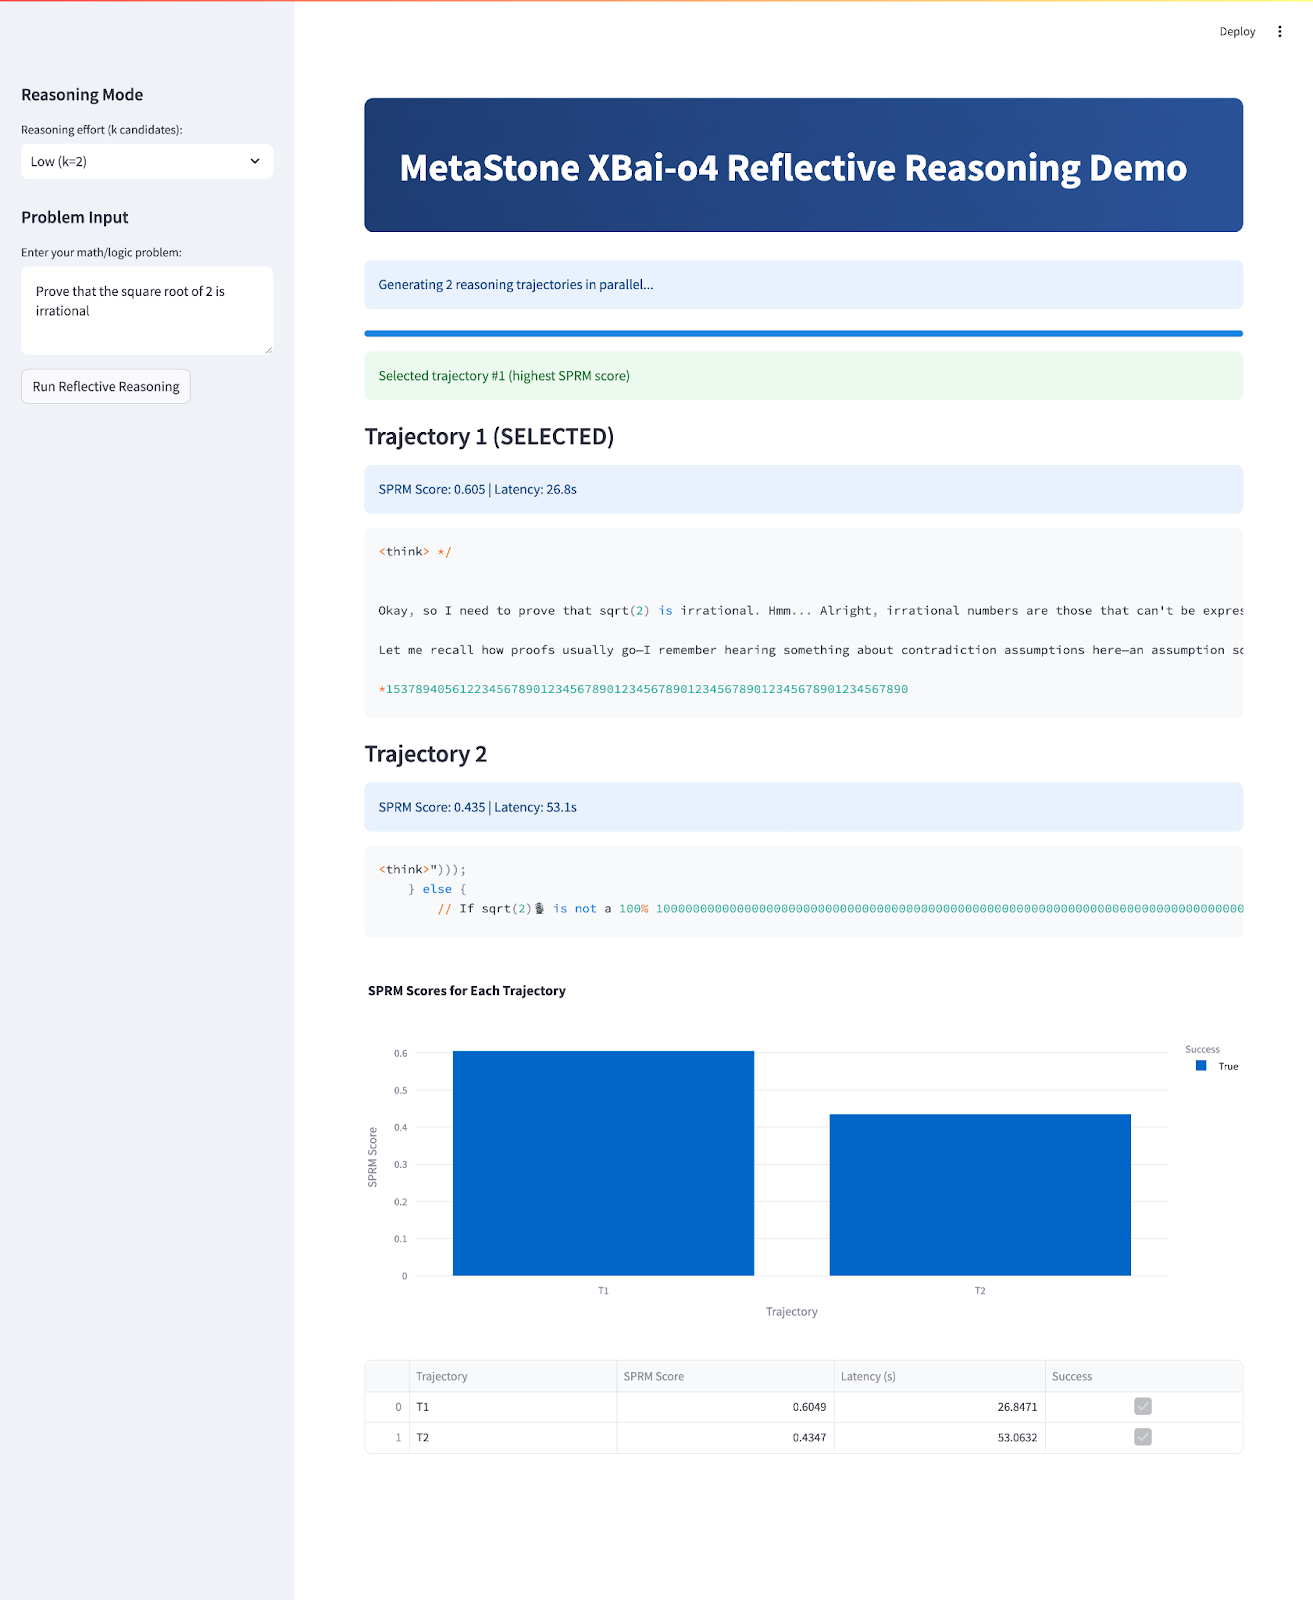
Alla fine, la tua app sarà così:
XBai-o4 è il modello di ragionamento open source di quarta generazione di MetaStone AI, che introduce un’architettura generativa riflessiva con l’obiettivo di ridefinire come l’IA affronta la risoluzione di problemi complessi. A differenza dei LLM tradizionali che trattano la generazione e la valutazione della risposta come due processi distinti, XBai o4 unisce entrambi in un modello unico usando uno Shared Process Reward Model (SPRM). Questo design permette al modello di generare, valutare e selezionare più percorsi di ragionamento in parallelo.
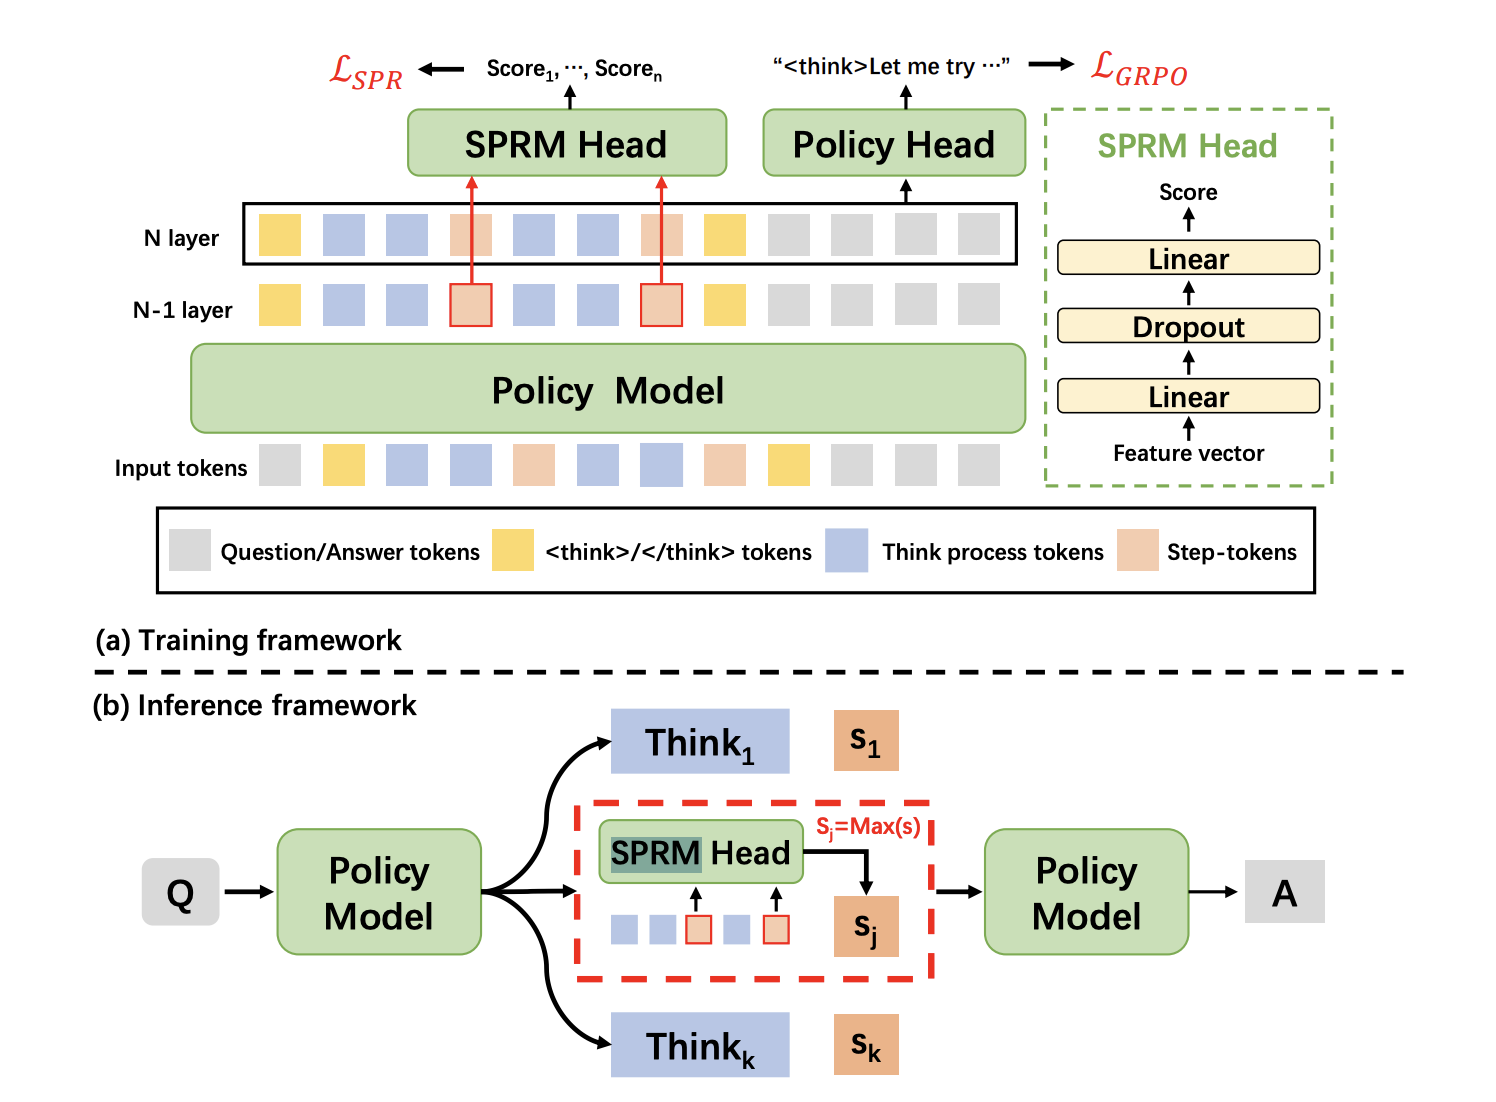
Fonte: SPRM Head
Alla base, XBai o4 combina long chain-of-thought (Long-CoT) reinforcement learning e process reward learning in un’unica pipeline di training. Ecco alcune innovazioni chiave introdotte da questo modello:
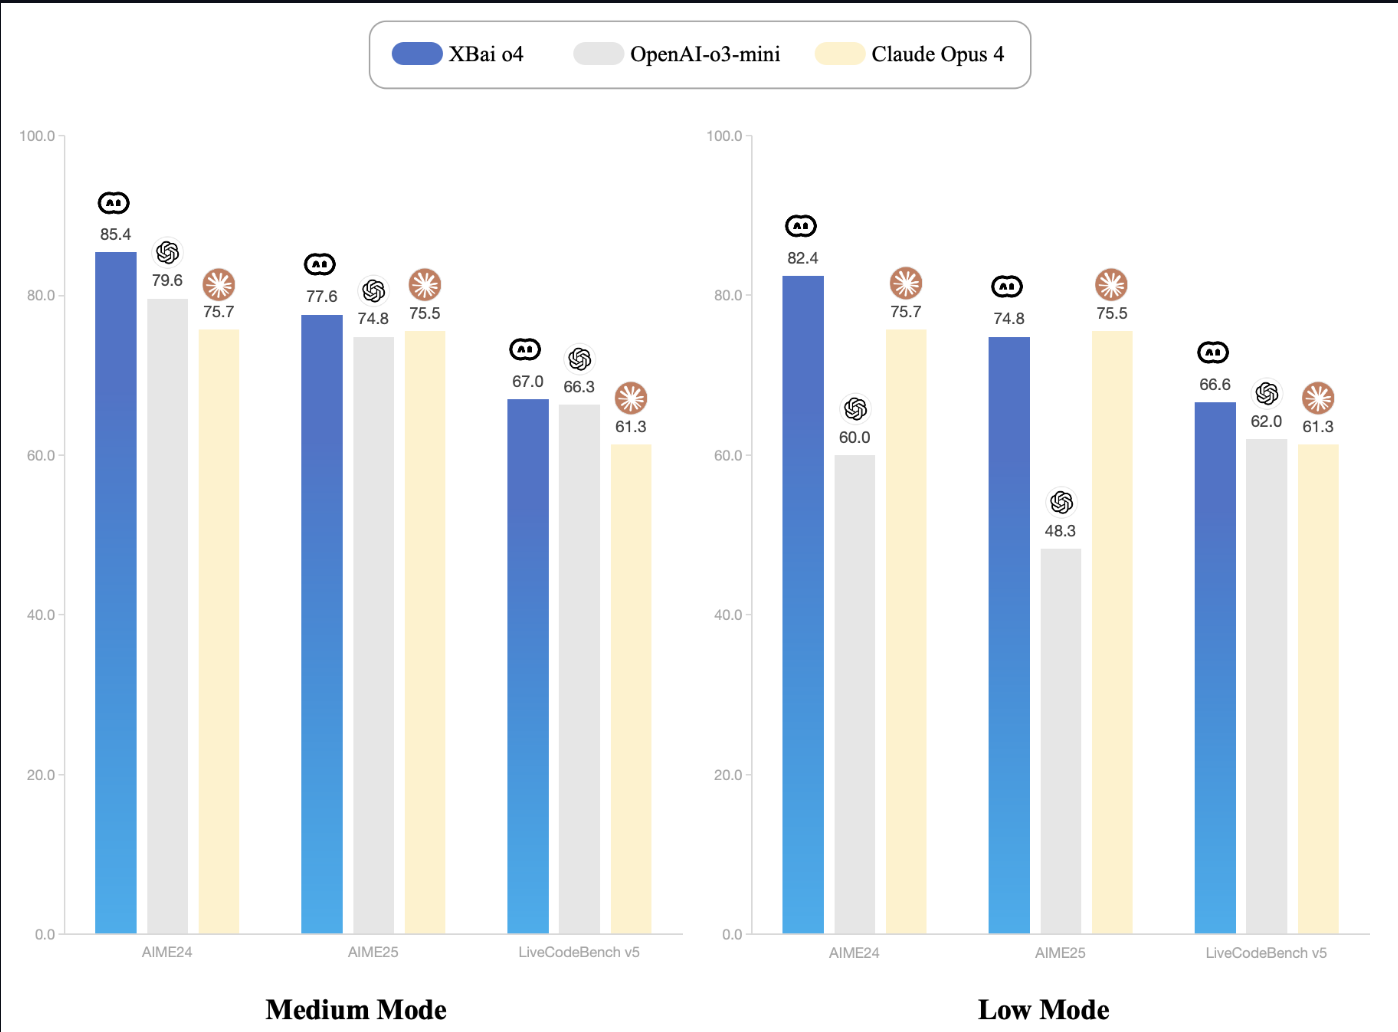
Fonte: Documentazione XBai-O4
Puoi eseguire XBai o4 in locale usando LM Studio, che utilizza automaticamente la GPU del tuo sistema o l’accelerazione Apple Silicon (Metal/MLX) quando disponibile (nessuna configurazione manuale necessaria). Per prestazioni e compatibilità ottimali, consiglio di usare la versione quantizzata GGUF del modello.
Lo standard GGUF (GPT-Generated Unified Format) consente un’inferenza locale altamente efficiente riducendo la precisione dei pesi del modello. In questo progetto useremo la variante quantizzata Q3_K_S, una scelta diffusa per l’ottimo compromesso tra qualità e uso di memoria.
Q3_K_S offre prestazioni di ragionamento solide con minima perdita di qualità rispetto ai modelli a piena precisione.Vediamo passo passo come configurare il modello GGUF quantizzato per un’inferenza locale efficiente usando LM Studio.
LM Studio offre supporto GGUF e seleziona automaticamente il backend di inferenza ottimale per il tuo hardware, che sia Metal, GPU o CPU.
Se non hai ancora installato LM Studio, scaricalo semplicemente da lmstudio.ai e segui le istruzioni di installazione.
In LM Studio:
mradermacher/XBai-o4-GGUFXBai-o4.Q3_K_S.gguf (14,39 GB).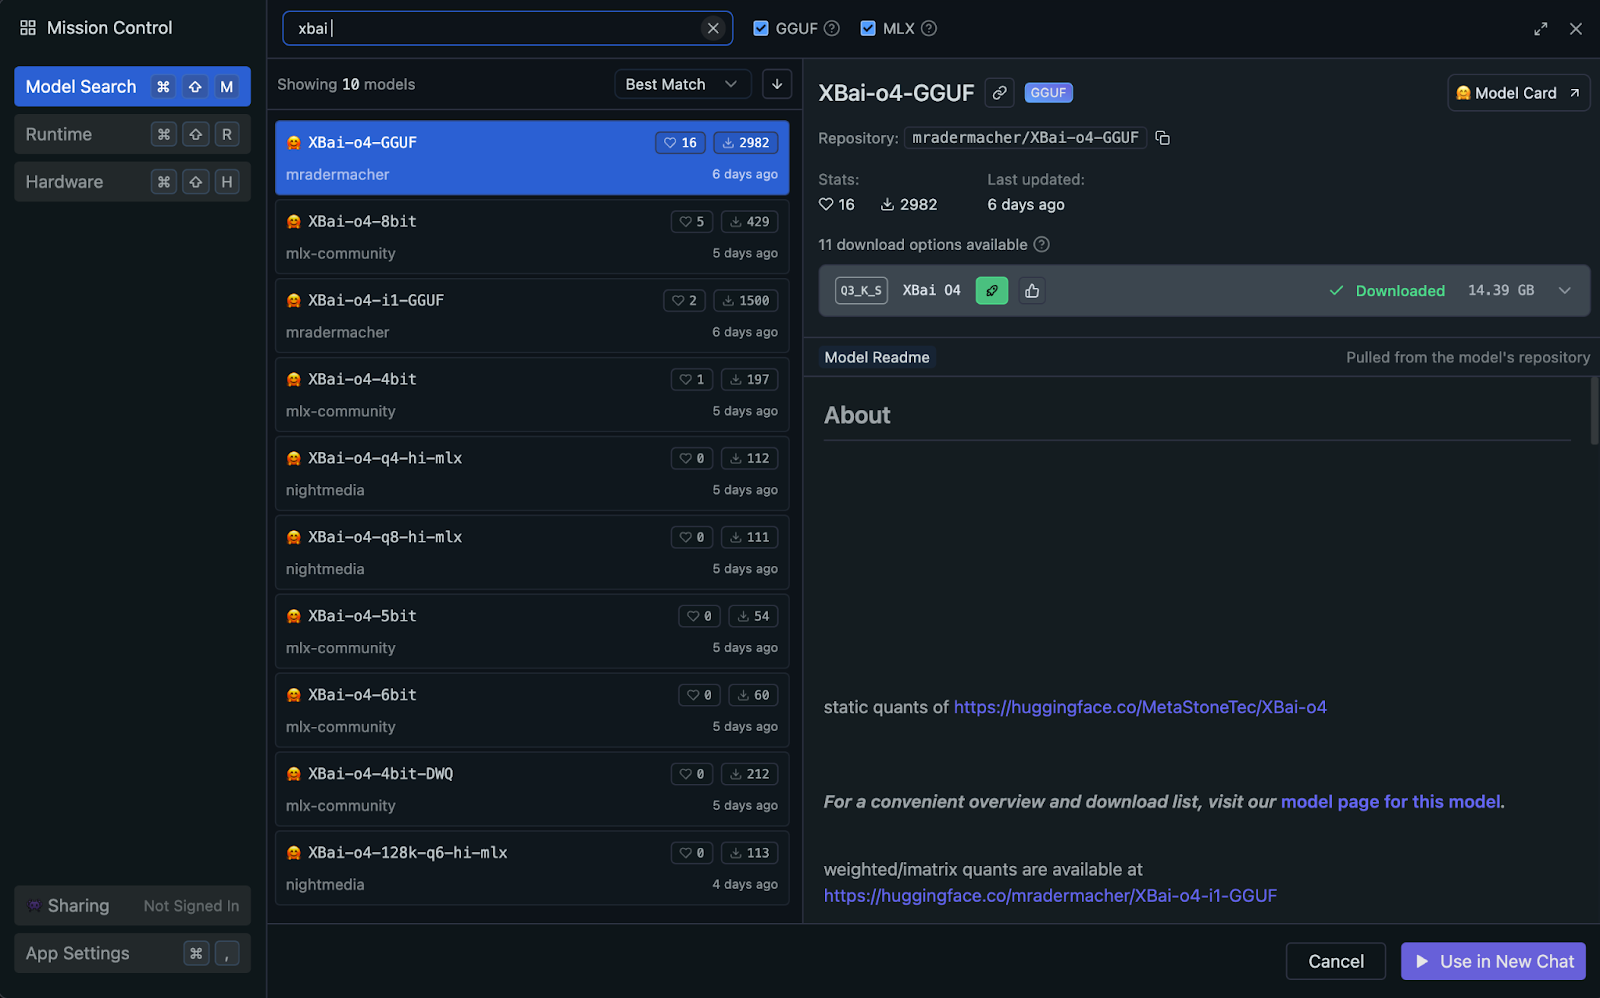
Una volta installato LM Studio, carichiamo e configuriamo il modello XBai o4 per l’inferenza locale:
XBai-o4.Q3_K_S.gguf dall’elenco dei modelli scaricati.Una volta in esecuzione, il tuo sistema è pronto per il ragionamento multi-traiettoria con XBai o4.
Ora costruiremo un’applicazione Streamlit che dimostra le capacità di ragionamento riflessivo di XBai o4 con confronto delle prestazioni in tempo reale.
Inizia installando le dipendenze:
pip install streamlit plotly pandas numpy requestsQuesto comando assicura che tu abbia tutte le dipendenze principali per UI, gestione dei dati, grafici e richieste API.
Poi, importa tutte le librerie richieste e configura il layout e le impostazioni di base della tua pagina Streamlit.
import streamlit as st
import time
import requests
import numpy as np
import pandas as pd
import plotly.express as px
from typing import List, Dict, Any
LM_STUDIO_URL = "http://localhost:1234/v1"   # change as per your server
REASONING_MODES = {"Low (k=2)": 2, "Medium (k=8)": 8, "High (k=32)": 8}
st.set_page_config(page_title="MetaStone-XBai-o4 Reflective Reasoning Demo", layout="wide")
st.markdown("""
<style>
    .main-header {
        background: linear-gradient(90deg, #1e3c72 0%, #2a5298 100%);

        border-radius: 10px;
        color: white;
        text-align: center;

    }
</style>
""", unsafe_allow_html=True)
Questo blocco di codice importa tutte le librerie principali necessarie per la nostra demo, tra cui Streamlit per la UI web, oltre a librerie di base come time, requests, numpy, pandas, plotly.express e strumenti di typing.
Imposta poi l’endpoint API del modello LM_STUDIO_URL così che l’app sappia dove inviare le richieste, e definisce le modalità di ragionamento (REASONING_MODES) per consentire agli utenti di scegliere facilmente quante traiettorie di soluzione generare.
Infine, usiamo st.set_page_config() per configurare la UI di Streamlit con un titolo personalizzato, layout ampio e un’intestazione con gradiente stilizzata via CSS.
Nota: LM_STUDIO_URL è la base URL del server LLM, che puoi copiare da LM Studio. Di solito è "http://localhost:1234/v1" ma può variare. Inoltre, scegli le modalità di ragionamento in base alle capacità del tuo server.
Ora, realizziamo un set di funzioni di supporto che alimentano la logica principale di “ragionamento riflessivo” della nostra app. Queste funzioni semplificano il lavoro con più traiettorie, la selezione della soluzione migliore e lo scoring di ciascuna risposta.
Questo passaggio introduce una semplice funzione di supporto che verifica automaticamente se il nostro server LM Studio può gestire il campionamento multi-traiettoria. Alcuni server supportano il parametro n, che ci consente di richiedere più completamenti indipendenti in una sola chiamata API, velocizzando notevolmente il processo.
def supports_n_param():
    payload = {
        "messages": [{"role": "user", "content": "What is 1+1?"}],
        "max_tokens": 80,
        "temperature": 0.1,
        "n": 2,
        "stream": False
    }
    try:
        resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
        if resp.status_code == 200 and len(resp.json().get("choices", [])) == 2:
            return True
    except Exception:
        pass
    return False
Questa funzione verifica se il tuo server LM Studio supporta la generazione di più risposte (“traiettorie”) in una singola chiamata API usando il parametro n. Invia una rapida richiesta di test e restituisce True se la funzione è disponibile, abilitando così un vero “Best-of-N” sampling per un ragionamento più veloce e scalabile.
Una volta determinato se il nostro backend supporta il campionamento multi-traiettoria, il passo successivo è generare più percorsi di ragionamento per un dato problema. Questa sezione introduce un set di funzioni di supporto che usano il multi-sampling lato server (quando disponibile) o parallelizzano in modo efficiente i completamenti singoli, garantendo che l’app rimanga veloce e scalabile.
def lm_studio_generate_multiple(problem, k, temperature=0.8, seed=2025):
    prompt = f"<think> {problem}\n</think>"
    payload = {
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 196,
        "temperature": temperature,
        "top_p": 0.9,
        "top_k": 30,
        "n": k,
        "stream": False,
        "seed": seed
    }
    start = time.time()
    resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
    latency = time.time() - start
    if resp.status_code == 200:
        result = resp.json()
        return [{
            "content": choice["message"]["content"].strip(),
            "latency": latency / k,
            "success": True,
        } for choice in result.get("choices", [])]
    else:
        raise RuntimeError(f"LM Studio error: {resp.status_code}: {resp.text}")
def lm_studio_generate_single(problem, temperature, seed=None):
    prompt = f"<think> {problem}\n</think>"
    payload = {
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 196,
        "temperature": temperature,
        "top_p": 0.9,
        "top_k": 30,
        "stream": False,
        "seed": seed
    }
    start = time.time()
    resp = requests.post(f"{LM_STUDIO_URL}/chat/completions", json=payload, timeout=120)
    latency = time.time() - start
    if resp.status_code == 200:
        content = resp.json()["choices"][0]["message"]["content"].strip()
        return {"content": content, "latency": latency, "success": True}
    else:
        return {"success": False, "error": f"HTTP {resp.status_code}: {resp.text}", "latency": latency}
def parallel_candidate_generation(problem, k, progress_cb=None):
    import concurrent.futures
    temperatures = np.linspace(0.1, 1.0, k)
    results = []
    with concurrent.futures.ThreadPoolExecutor(max_workers=min(8, k)) as executor:
        futures = []
        for i in range(k):
            seed = 2025 + i * 31
            futures.append(executor.submit(lm_studio_generate_single, problem, temperatures[i], seed))
        for i, future in enumerate(concurrent.futures.as_completed(futures)):
            res = future.result()
            res["trajectory_id"] = i + 1
            results.append(res)
            if progress_cb:
                progress_cb(i + 1, k)
    results.sort(key=lambda x: x.get("trajectory_id", 0))
    return results
Ecco come ogni funzione si inserisce nella pipeline multi-traiettoria:
lm_studio_generate_multiple(): quando il server LM Studio supporta il parametro n, questa funzione invia una singola richiesta API per generare k soluzioni diverse in una volta sola. È la modalità più efficiente, che abilita il vero test-time scaling.lm_studio_generate_single(): se il server non supporta il multi-sampling, questa funzione fornisce un fallback che genera una traiettoria di soluzione per richiesta, consentendo temperature diverse e riproducibilità tramite seed.parallel_candidate_generation(): per mantenere le prestazioni in modalità fallback, questa utility avvia in parallelo più chiamate a lm_studio_generate_single(), ognuna con temperature di campionamento diverse, quindi aggrega tutte le risposte. In questo modo otteniamo comunque rapidamente un’ampia gamma di soluzioni, anche se il vero multi-sampling non è disponibile.Dopo aver generato più percorsi di ragionamento, ci serve un modo strutturato per identificare la soluzione più robusta. Questo passaggio introduce strumenti di scoring e selezione che imitano le tecniche di reward modeling (SPRM) usate nel paper sul Ragionamento Riflessivo di MetaStone.
def step_tokenize(trajectory: str) -> List[str]:
    steps = [step.strip() for step in trajectory.split('.\n\n') if step.strip()]
    return steps
def dummy_sprm_score(trajectory: str, problem: str) -> float:
    steps = step_tokenize(trajectory)
    n = len(steps)
    def step_score(step):
        s = 0.2
        if any(x in step.lower() for x in ["therefore", "thus", "so", "finally", "conclude"]): s += 0.15
        if any(sym in step for sym in ["=", "+", "-", "*", "/", "(", ")"]): s += 0.1
        if len(step.split()) > 10: s += 0.1
        return min(1.0, s)
    step_scores = [step_score(s) for s in steps] or [0.01]
    geometric_mean = np.exp(np.mean(np.log(np.maximum(step_scores, 1e-3))))
    return min(1.0, geometric_mean + 0.05 * np.log1p(n))
def best_of_n_selection(candidates: List[Dict]) -> int:
    best_idx = int(np.argmax([c["sprm_score"] for c in candidates]))
    return best_idx
Ecco cosa fa ciascuna funzione:
step_tokenize(): suddivide una traiettoria di ragionamento in passaggi o segmenti logici, consentendo un’analisi e uno scoring per step.dummy_sprm_score(): assegna un punteggio di ricompensa a ciascuna traiettoria candidata e favorisce risposte multi-step, ben strutturate e con uso di ragionamento matematico. Agisce come sostituto dello Shared Process Reward Model (SPRM) del paper, che valuta internamente le sue soluzioni.best_of_n_selection() function: dato un batch di risposte candidate, seleziona la traiettoria migliore in base al punteggio SPRM più alto, proprio come il modello riflessivo del paper sceglie automaticamente la risposta più solida in fase di test.In questo passaggio, mettiamo insieme tutti i pezzi per creare una demo di ragionamento interattiva con Streamlit.
st.markdown("""
<div class="main-header">
    <h1> MetaStone XBai-o4 Reflective Reasoning Demo</h1>
</div>
""", unsafe_allow_html=True)
st.sidebar.header("Reasoning Mode")
mode = st.sidebar.selectbox("Reasoning effort (k candidates):", list(REASONING_MODES.keys()))
k = REASONING_MODES[mode]
st.sidebar.header("Problem Input")
problem = st.sidebar.text_area("Enter your math/logic problem:", "Prove that the square root of 2 is irrational")
if st.sidebar.button("Run Reflective Reasoning"):
    st.session_state.run = True
    st.session_state.results = None
    st.session_state.best_idx = None
if "run" not in st.session_state:
    st.session_state.run = False
if st.session_state.run:
    st.info(f"Generating {k} reasoning trajectories in parallel...")
    progress = st.progress(0)
    def update_progress(done, total):
        progress.progress(done / total)
    try:
        if supports_n_param():
            results = lm_studio_generate_multiple(problem, k, temperature=0.7)
            for idx, res in enumerate(results):
                res["trajectory_id"] = idx + 1
        else:
            results = parallel_candidate_generation(problem, k, progress_cb=update_progress)
        for res in results:
            if res.get("success"):
                res["sprm_score"] = dummy_sprm_score(res["content"], problem)
            else:
                res["sprm_score"] = 0.0
        best_idx = best_of_n_selection(results)
        st.session_state.results = results
        st.session_state.best_idx = best_idx
        st.session_state.run = False
    except Exception as e:
        st.error(f"Failed to generate trajectories: {str(e)}")
        st.session_state.run = False
if st.session_state.get("results"):
    results = st.session_state.results
    best_idx = st.session_state.best_idx
    st.success(f"Selected trajectory #{best_idx+1} (highest SPRM score)")
    df = pd.DataFrame({
        "Trajectory": [f"T{i+1}" for i in range(len(results))],
        "SPRM Score": [r["sprm_score"] for r in results],
        "Latency (s)": [r.get("latency", 0.0) for r in results],
        "Success": [r.get("success", False) for r in results]
    })
    for i, res in enumerate(results):
        is_best = (i == best_idx)
        st.markdown(f"### {'' if is_best else ''} Trajectory {i+1} {'(SELECTED)' if is_best else ''}")
        if res.get("success"):
            st.info(f"SPRM Score: {res['sprm_score']:.3f} | Latency: {res['latency']:.1f}s")
            st.code(res["content"])
        else:
            st.error(f"Failed: {res.get('error', 'Unknown error')}")
    fig = px.bar(df, x="Trajectory", y="SPRM Score", color="Success", title="SPRM Scores for Each Trajectory")
    st.plotly_chart(fig, use_container_width=True)
    st.dataframe(df)
Il flusso principale dell’applicazione raggiunge diversi obiettivi chiave:
dummy_sprm_score), che imita lo Shared Process Reward Model (SPRM). best_of_n_selection). Tutte le soluzioni generate, insieme ai rispettivi punteggi SPRM e alle latenze di generazione, sono mostrate in formato testuale e grafico per un’analisi comparativa affiancata.Per provarlo tu stesso, salva il codice come xbai_demo.py e avvia:
streamlit run xbai_demo.pyImpara l’AI con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



