



Programma
Fondamenti della ChatGPT
3 ore
Pratica and corso your progress.
Continua Con Googleo3 è l’ultimo modello frontier di OpenAI, progettato per far progredire le capacità di ragionamento su una gamma di compiti complessi come coding, matematica, scienza e percezione visiva.
Il modello di ragionamento o3 è il primo modello di ragionamento con accesso all’uso autonomo degli strumenti. Ciò significa che o3 può usare ricerca, Python, generazione e interpretazione di immagini per portare a termine i suoi compiti.
Questo si è tradotto in prestazioni elevate su benchmark avanzati che testano la risoluzione di problemi del mondo reale, dove i modelli precedenti hanno faticato. OpenAI evidenzia i miglioramenti di o3 rispetto a o1, posizionandolo come il suo modello più capace e versatile di sempre.
o3 si basa direttamente sulle fondamenta gettate da o1, ma i miglioramenti sono significativi nelle aree chiave. OpenAI ha posizionato o3 come un modello pensato per gestire compiti di ragionamento più complessi, con guadagni di prestazioni riflessi nei suoi benchmark.
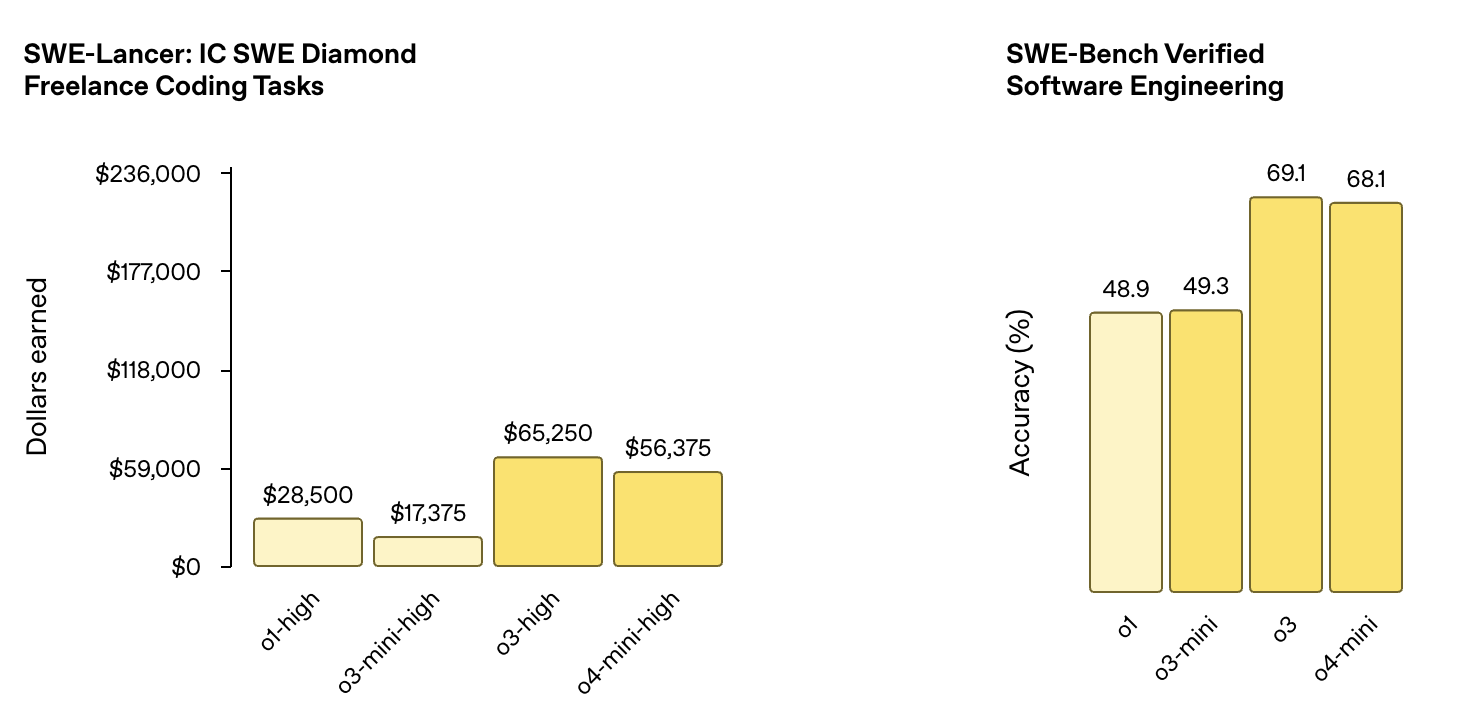
Nei test su compiti di ingegneria del software, o3 ha raggiunto il 69,1% di accuratezza nel benchmark SWE-Bench Verified Software Engineering, un miglioramento sostanziale rispetto al 48,9% di o1.
Fonte: OpenAI
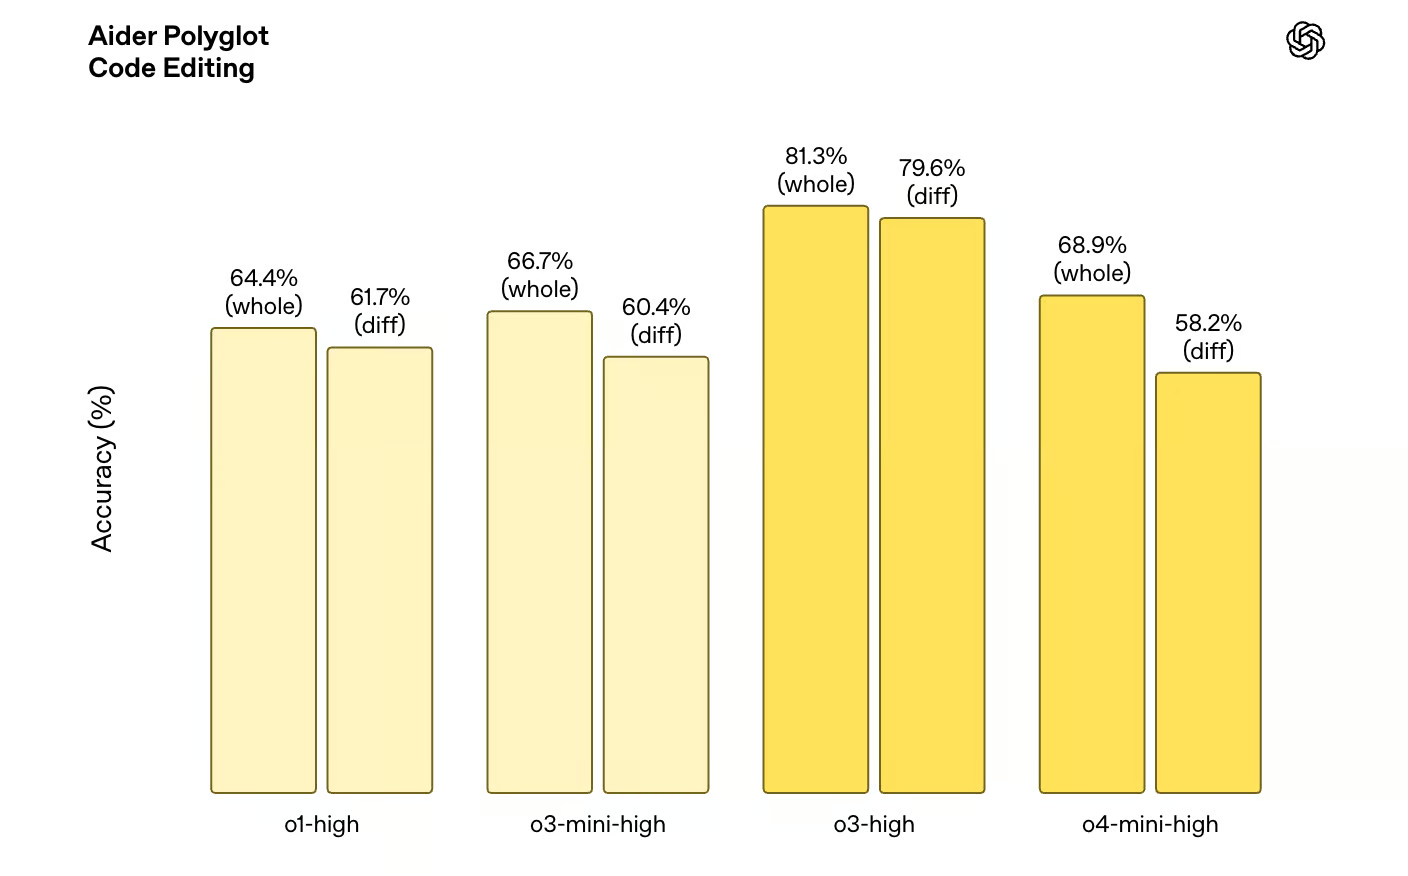
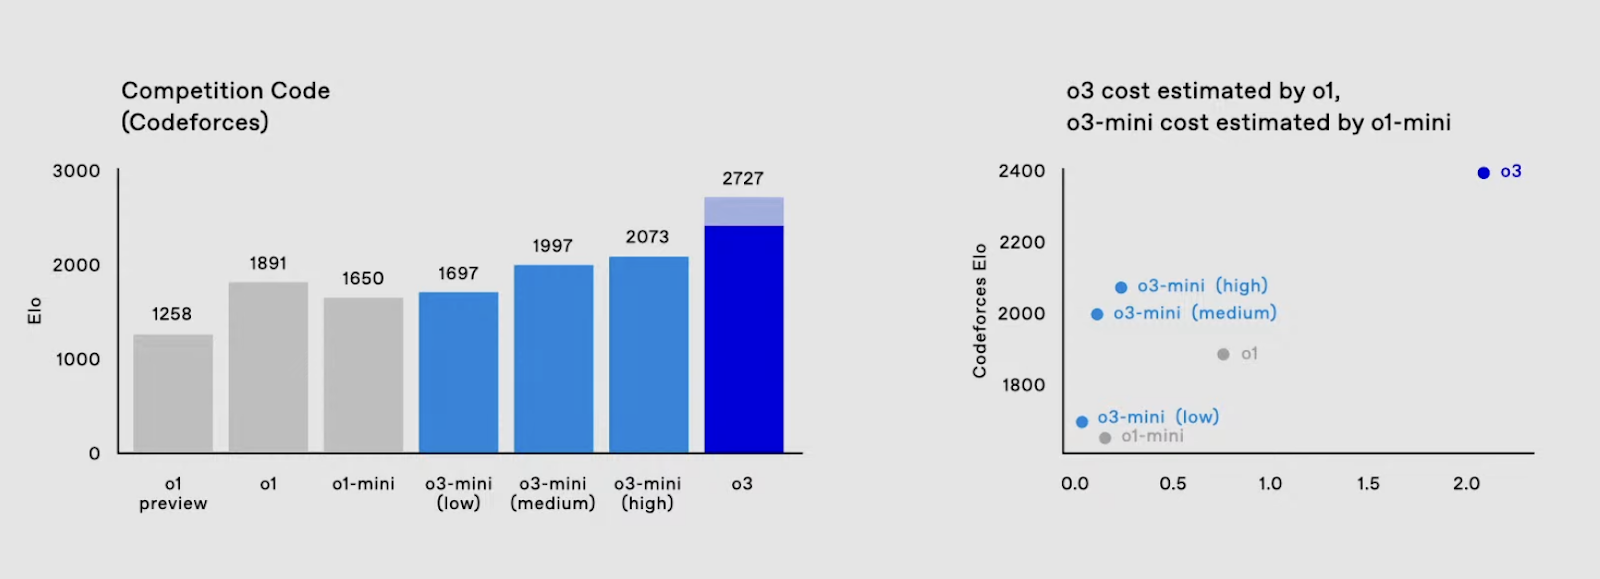
Allo stesso modo, nella programmazione competitiva, o3 ha raggiunto un punteggio ELO di 2706, superando di gran lunga il precedente massimo di o1 pari a 1891. Inoltre, o3 ottiene risultati significativamente migliori nei benchmark di editing del codice, con le varianti di o3 che superano o1 su tutta la linea nel benchmark Aider Polyglot Code Editing.
Fonte: OpenAI
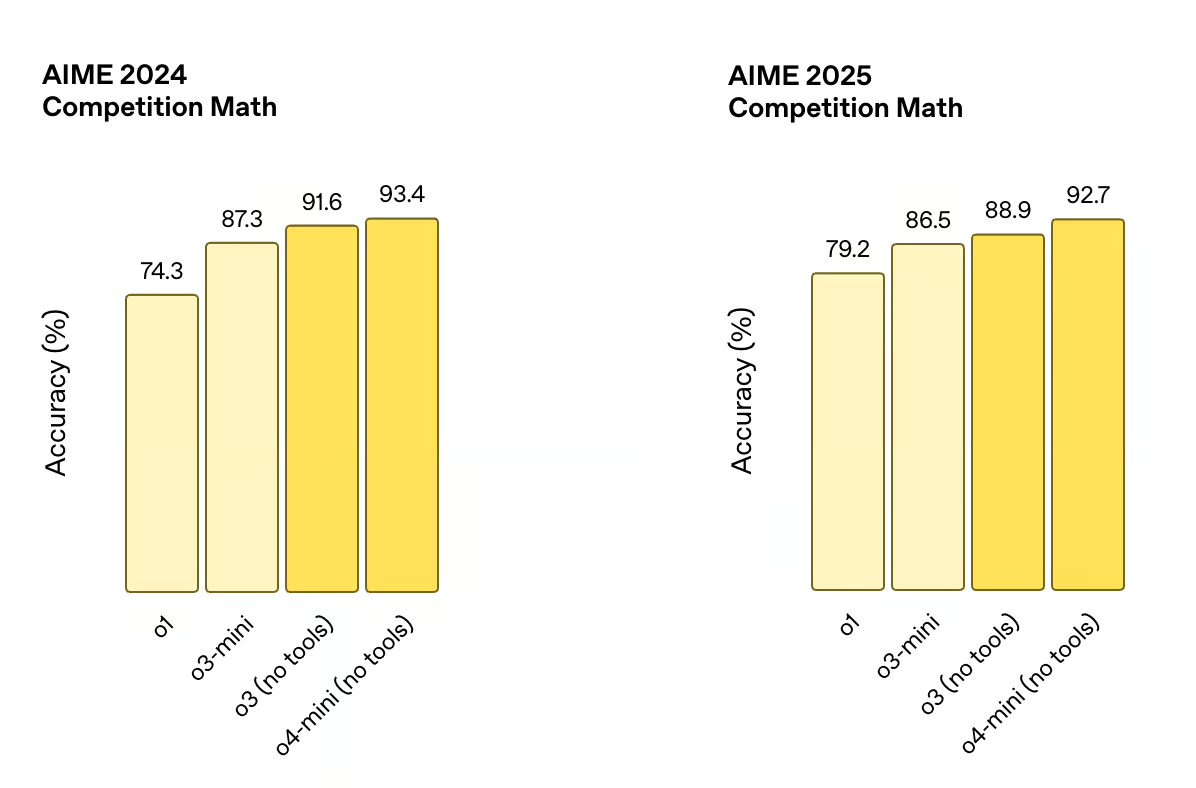
I miglioramenti non si limitano al coding. o3 eccelle anche nel ragionamento matematico, con un’accuratezza del 91,6% su AIME 2024, rispetto al 74,3% di o1. Ha inoltre ottenuto l’88,9% su AIME 2025. Questi progressi suggeriscono un modello capace di affrontare problemi più sfumati e difficili, avvicinandosi a benchmark tradizionalmente dominati da esperti umani.
Fonte: OpenAI
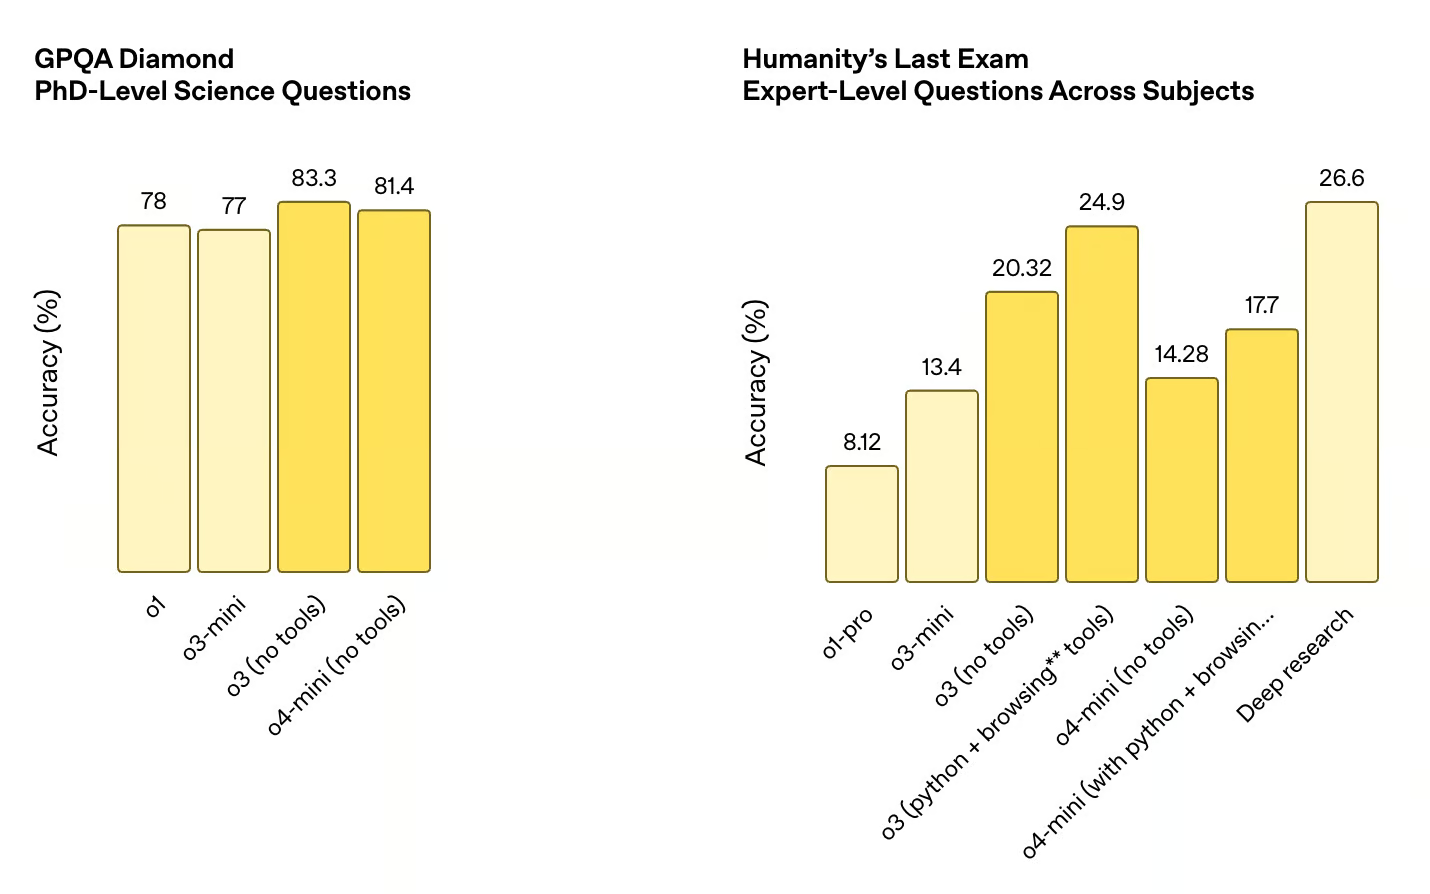
Il salto è evidente anche nei benchmark legati alle scienze. Su GPQA Diamond, che misura le prestazioni su domande scientifiche a livello di dottorato, o3 ha raggiunto un’accuratezza dell’83,3%, rispetto al 78% di o1. Questi guadagni mostrano un miglioramento ampio nella capacità del modello di risolvere problemi tecnicamente impegnativi in diverse discipline.
Fonte: OpenAI
Uno degli aspetti più sorprendenti del nuovo modello o3 è la capacità di ragionare con le immagini direttamente nella sua catena di pensiero. Ciò significa che o3 può fondere ragionamento visivo e testuale durante la risoluzione dei problemi, e questo si riflette nelle sue prestazioni su vari benchmark di ragionamento visivo.
Fonte: OpenAI
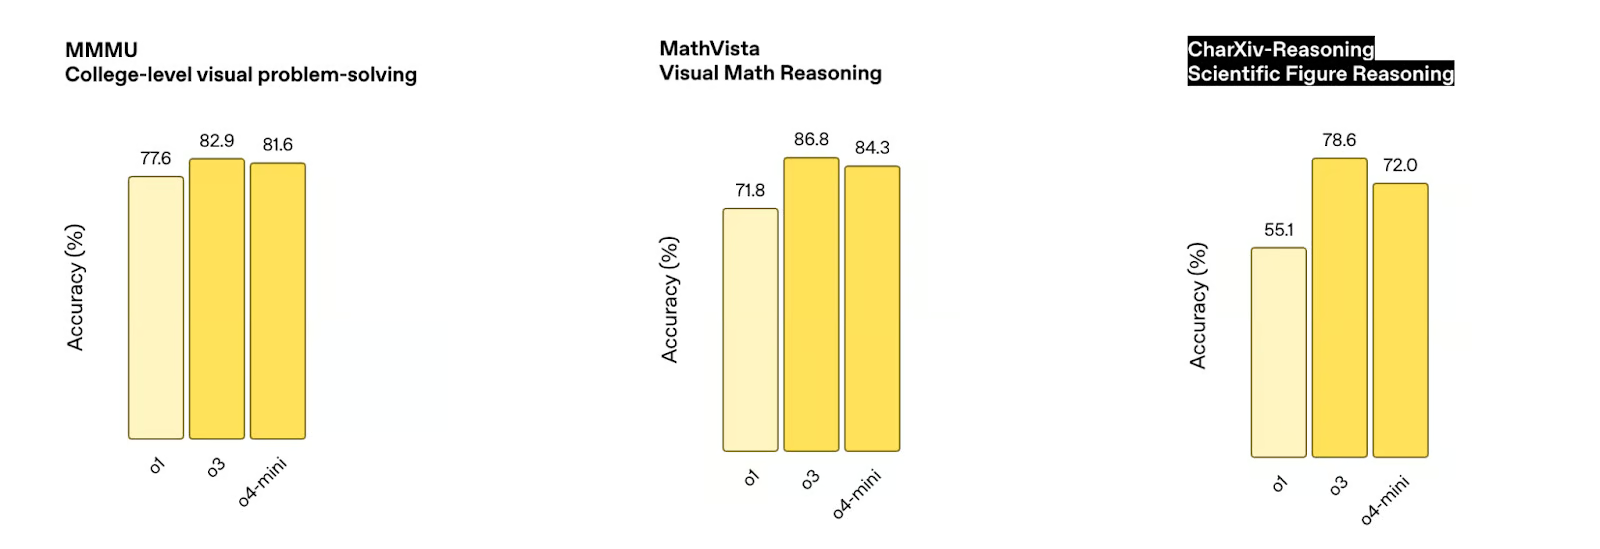
Per esempio, o3 supera o1 in diversi benchmark di ragionamento visivo, tra cui MMMU (problem solving visivo a livello universitario, 82,9% contro il 77,6% di o1), MathVista (ragionamento matematico visivo, 86,8% contro il 71,8% di o1) e CharXiv-Reasoning (ragionamento su figure scientifiche, 78,6% contro il 55,1% di o1).
Fonte: OpenAI
Un ambito in cui i progressi di o3 sono particolarmente degni di nota è il benchmark EpochAI Frontier Math.
È considerato uno dei benchmark più difficili nell’IA perché consiste in problemi nuovi, inediti e intenzionalmente molto più difficili dei dataset standard. Molti di questi problemi sono a livello di ricerca matematica e richiedono spesso ore o persino giorni a matematici professionisti per risolverne uno. I sistemi di IA attuali in genere ottengono meno del 2% in questo benchmark, a riprova della sua difficoltà.
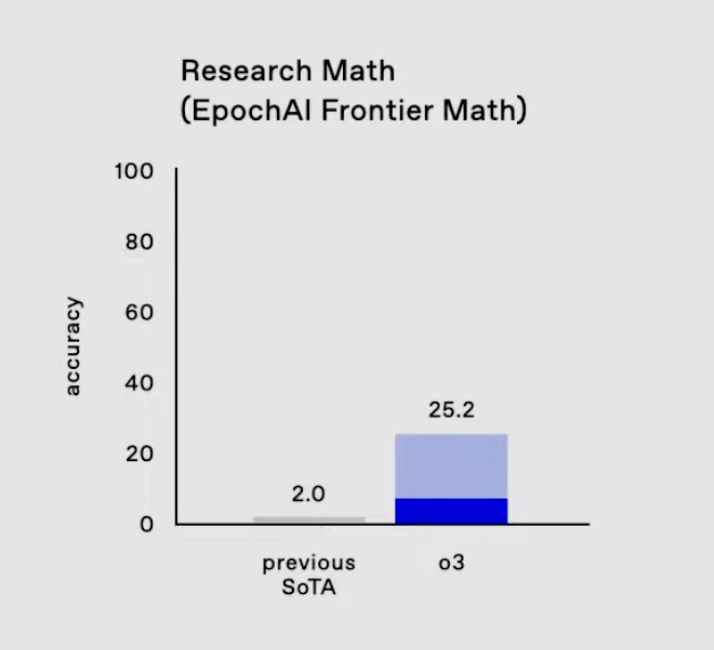
O3 su EpochAI Frontier Math. Fonte: OpenAI
Frontier Math di EpochAI è importante perché spinge i modelli oltre la memorizzazione meccanica o l’ottimizzazione di schemi noti. Invece, ne testa la capacità di generalizzare, ragionare in modo astratto e affrontare problemi mai incontrati prima—tratti essenziali per far progredire le capacità di ragionamento dell’IA. Il punteggio di o3 pari al 25,2% in questo benchmark rappresenta un salto in avanti rispetto al precedente stato dell’arte.
Uno dei risultati più sorprendenti di o3 è la sua performance sul benchmark ARC AGI, un test ampiamente considerato un gold standard per valutare l’intelligenza generale nell’IA.
Sviluppato nel 2019 da François Chollet, ARC (Abstraction and Reasoning Corpus) si concentra sulla capacità di un’IA di apprendere e generalizzare nuove abilità a partire da esempi minimi. A differenza dei benchmark tradizionali, che spesso testano conoscenze pre-addestrate o riconoscimento di schemi, i compiti di ARC sono progettati per sfidare i modelli a dedurre regole e trasformazioni al volo—compiti che gli esseri umani risolvono intuitivamente ma con cui l’IA ha storicamente avuto difficoltà.
Ciò che rende ARC AGI particolarmente difficile è che ogni task richiede abilità di ragionamento distinte. I modelli non possono affidarsi a soluzioni memorizzate o modelli; devono invece adattarsi a sfide completamente nuove in ogni test. Per esempio, un task può richiedere di identificare schemi in trasformazioni geometriche, mentre un altro può richiedere di ragionare su sequenze numeriche. Questa varietà rende ARC AGI una misura potente di quanto bene un’IA sappia davvero pensare e imparare come un umano.
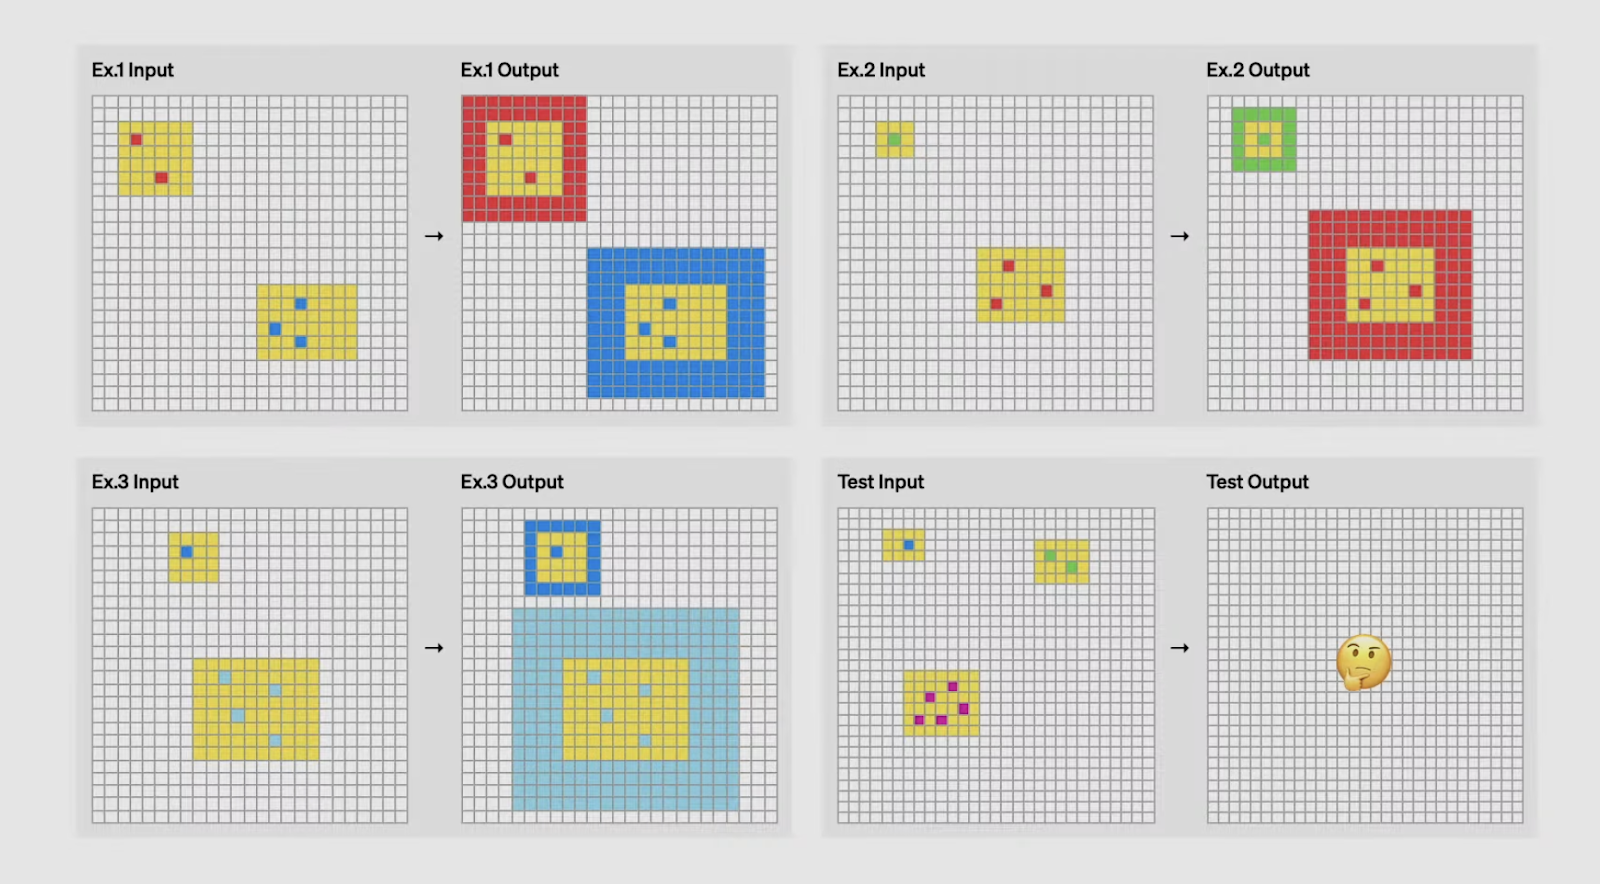
Sai indovinare la logica con cui l’input viene trasformato in output? Fonte: OpenAI
Le prestazioni di o3 su ARC AGI segnano un traguardo significativo. Con impostazioni di calcolo ridotte, o3 ha ottenuto il 76% sul set semi-privato di holdout—una cifra di gran lunga superiore a qualsiasi modello precedente.
Con impostazioni ad alto calcolo, ha raggiunto un impressionante 88%, superando la soglia dell’85% spesso citata come prestazioni a livello umano. È la prima volta che un’IA supera gli umani su questo benchmark, stabilendo un nuovo standard per i compiti basati sul ragionamento.
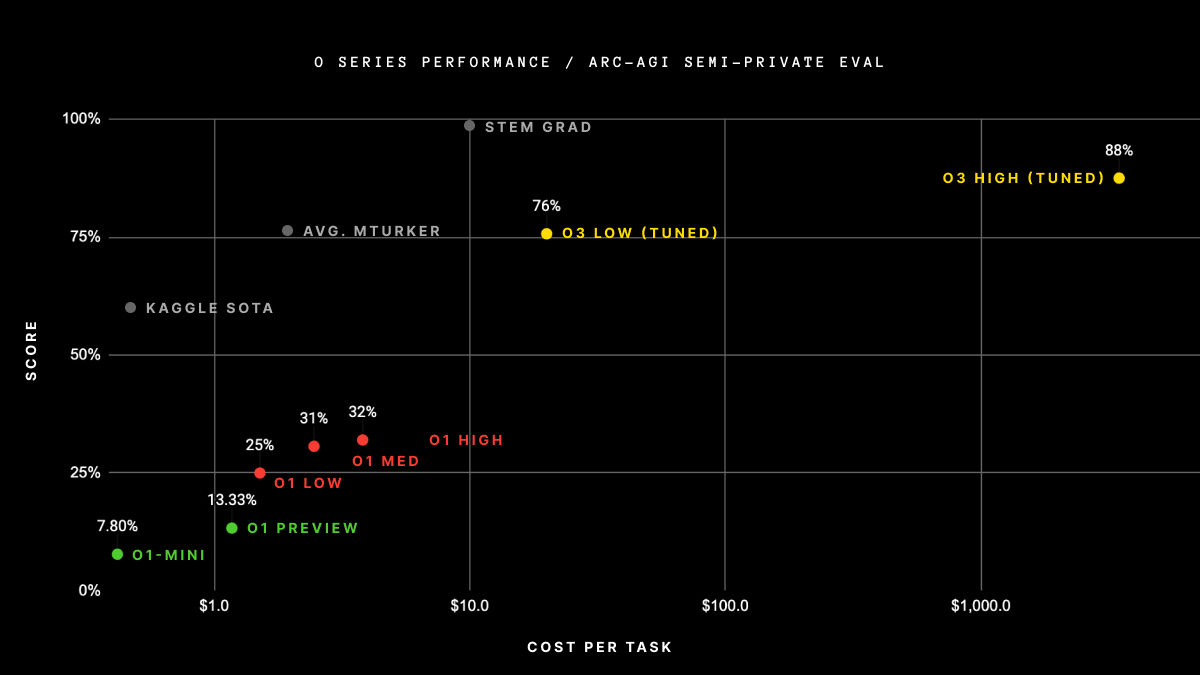
Fonte: ArcPrize
Riteniamo che questi risultati siano particolarmente notevoli perché dimostrano la capacità di o3 di gestire compiti che richiedono adattabilità e generalizzazione, piuttosto che conoscenze meccaniche o pura forza bruta computazionale. È un chiaro segnale che o3 si sta avvicinando a una vera intelligenza generale, andando oltre capacità specifiche di dominio e spingendosi in aree che si pensava appartenessero esclusivamente al territorio umano.
Detto ciò, i risultati sopra si basano sulla versione di o3 presentata nell’evento 12 Days of Christmas di OpenAI a dicembre, e OpenAI ha confermato che la versione appena rilasciata di o3 è diversa da quella mostrata nei test sopra. ARC AGI pubblicherà presto i risultati aggiornati delle prestazioni di o3.
Un miglioramento di prestazioni così ampio non avviene per caso. Il team di OpenAI ha scoperto alcune innovazioni per raggiungere questi numeri:
OpenAI ha scoperto che aumentare il budget di calcolo durante l’addestramento con reinforcement learning migliora le prestazioni del modello—rispecchiando il comportamento di scaling visto nel pretraining supervisionato dei modelli GPT. Ma questa volta, invece di ottimizzare la previsione della parola successiva, o3 impara massimizzando le ricompense del reinforcement learning, spesso in ambienti potenziati dagli strumenti.
In altre parole, OpenAI sta trattando il reinforcement learning più come un pretraining—scalandolo in durata e calcolo—e sembra funzionare. Questo sblocca capacità che beneficiano di pianificazione a lungo termine e ragionamento sequenziale, come la programmazione competitiva e le dimostrazioni matematiche multi-step. Quando abbinato all’uso di strumenti, i guadagni di performance diventano ancora più evidenti.
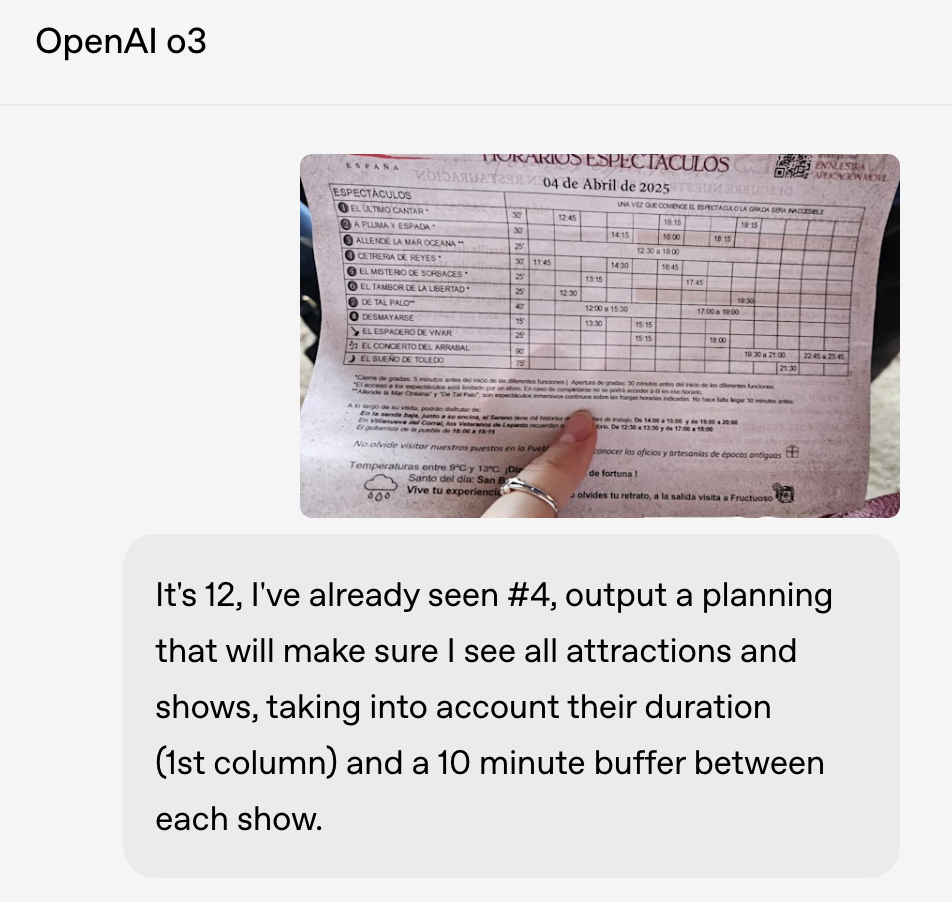
o3 mostra anche miglioramenti significativi nel ragionamento visivo. Non si limita a comprendere le immagini—le integra direttamente nel suo loop di ragionamento. Ciò include interpretare, manipolare e riesaminare le immagini durante la risoluzione dei problemi. Questo è uno dei motivi per cui o3 si comporta bene in compiti che coinvolgono figure scientifiche, diagrammi matematici e persino pianificazioni a partire da foto.
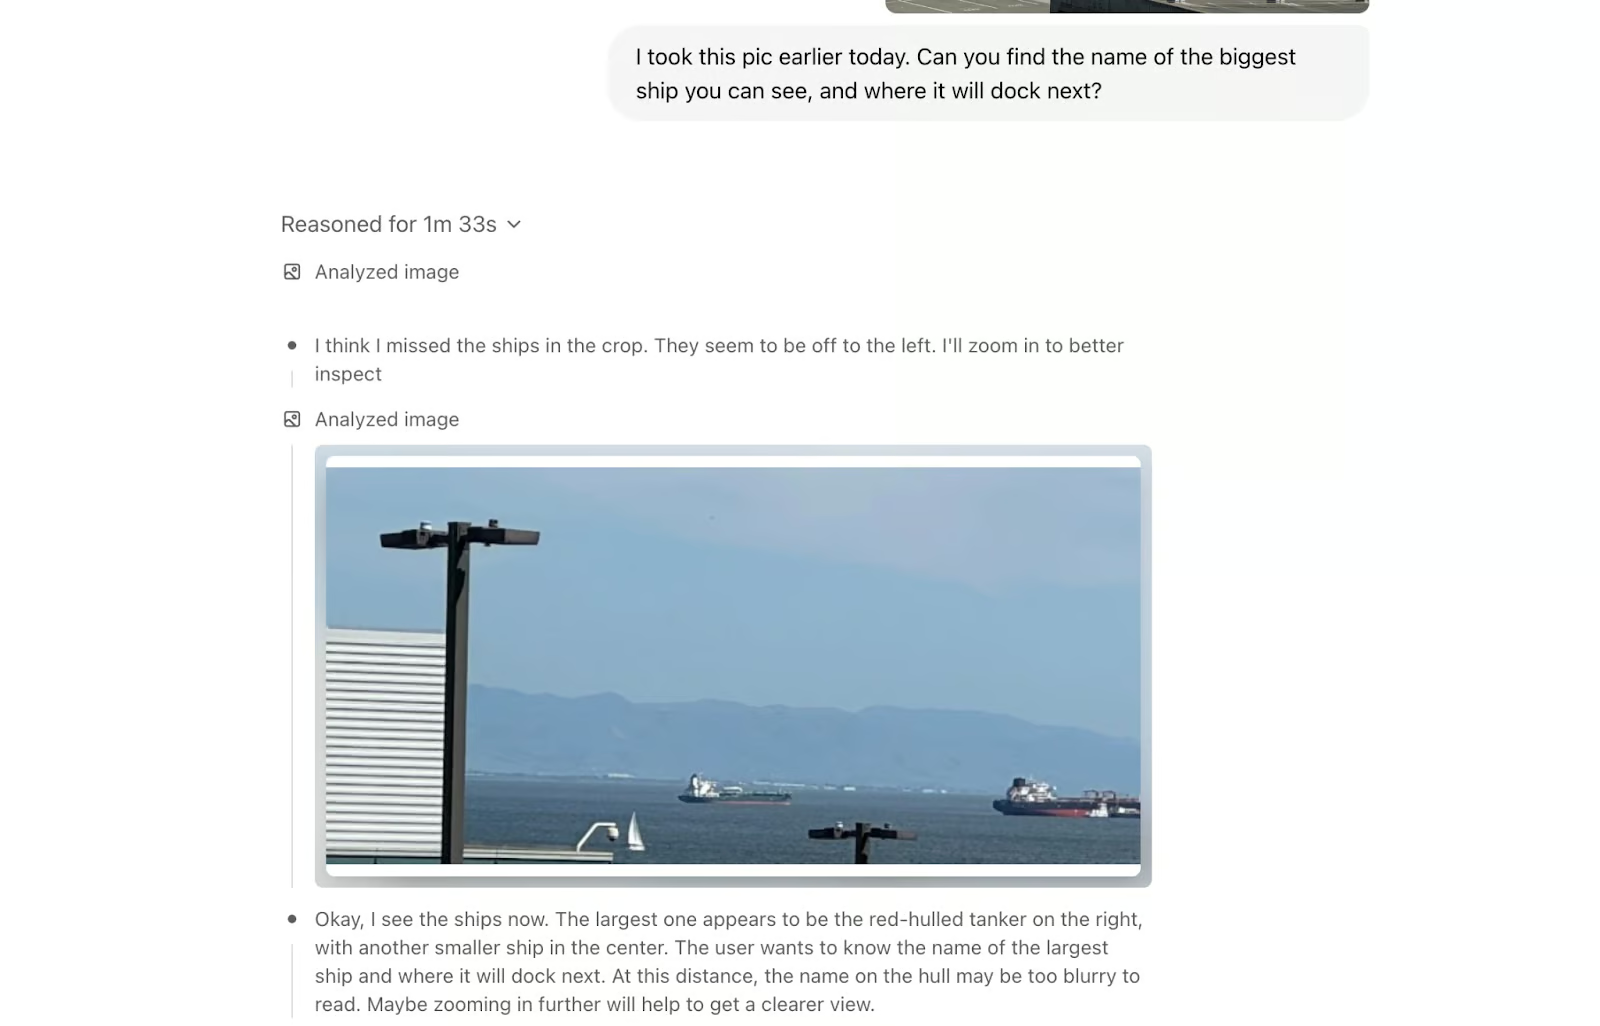
Un’innovazione chiave è il modo in cui o3 mantiene in memoria l’immagine grezza durante tutto il processo di ragionamento. Invece di processare una didascalia statica e scartare l’immagine, può ingrandire, ruotare o rivisitare a richiesta parti diverse dell’immagine tramite strumenti. Questo rende il suo ragionamento più dinamico e gli consente di affrontare input visivi “disordinati”, come una lavagna sfuocata, un diagramma disegnato a mano o la foto di un programma di conferenza.
In un esempio, OpenAI ha usato o3 per leggere un’immagine di bassa qualità di un programma di spettacoli e pianificare un itinerario che includesse tutti gli eventi con pause di dieci minuti tra uno e l’altro—qualcosa che richiede sia l’analisi del layout visivo sia l’applicazione di vincoli in tempo reale.
Volevamo mettere alla prova le abilità visive con un test rapido tutto nostro. Abbiamo prima dato a o1 un disegno rudimentale e chiesto: “Quale frattale stiamo iniziando a disegnare?”
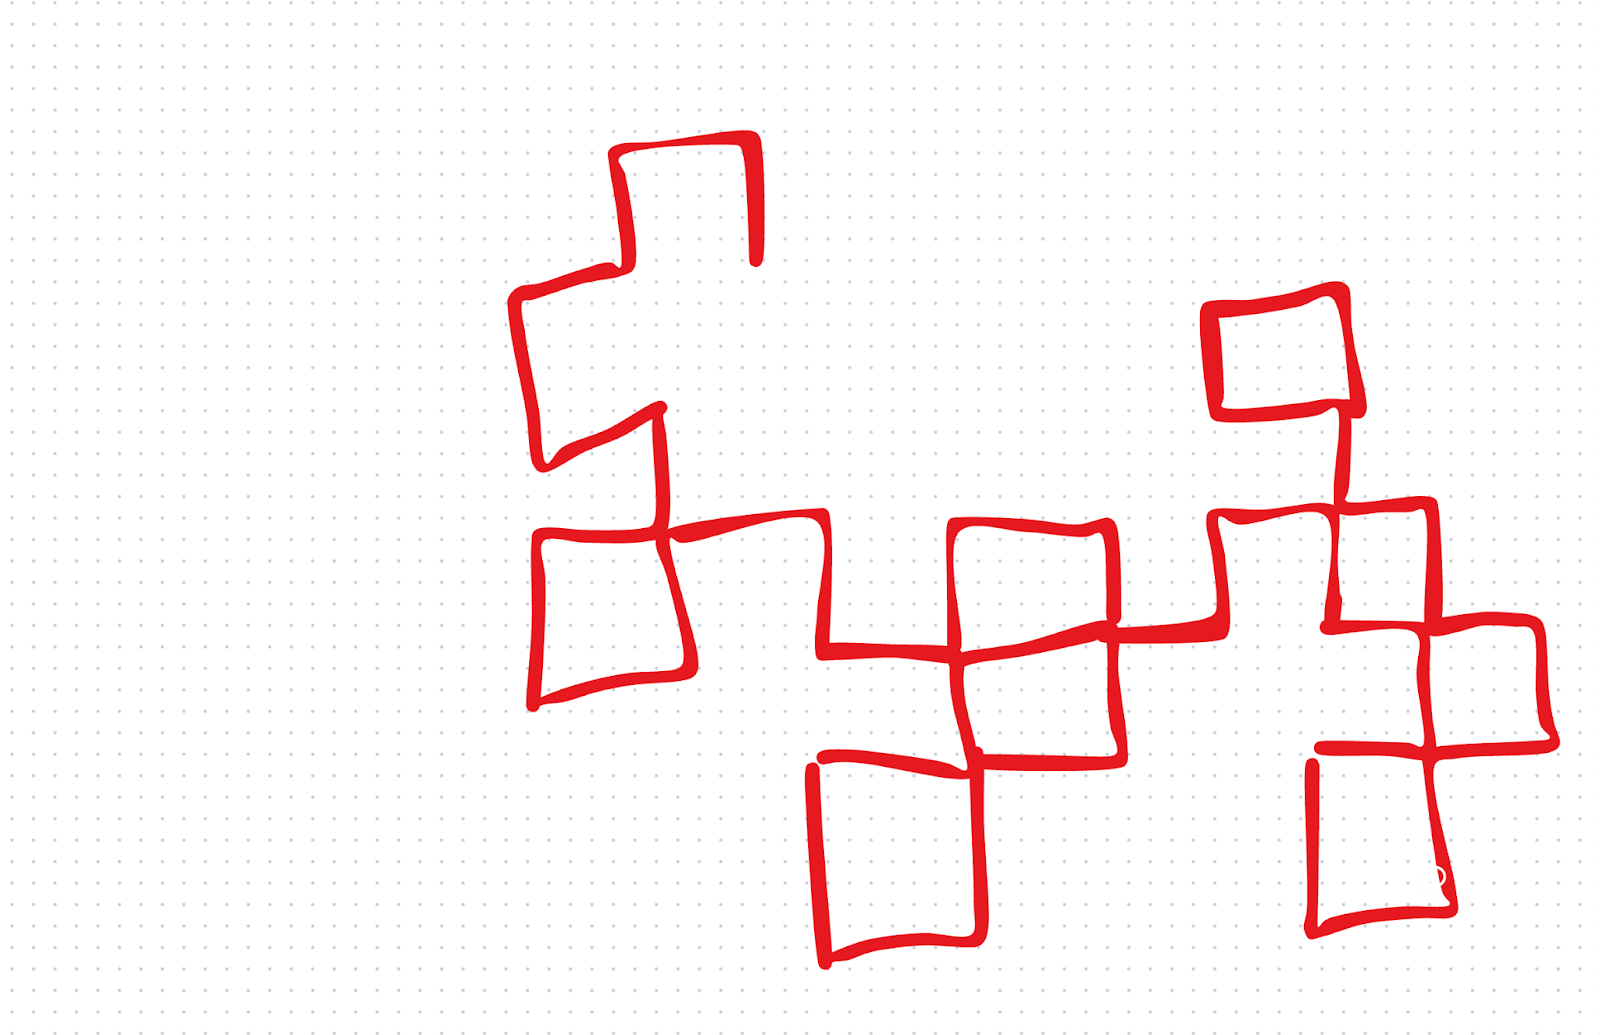
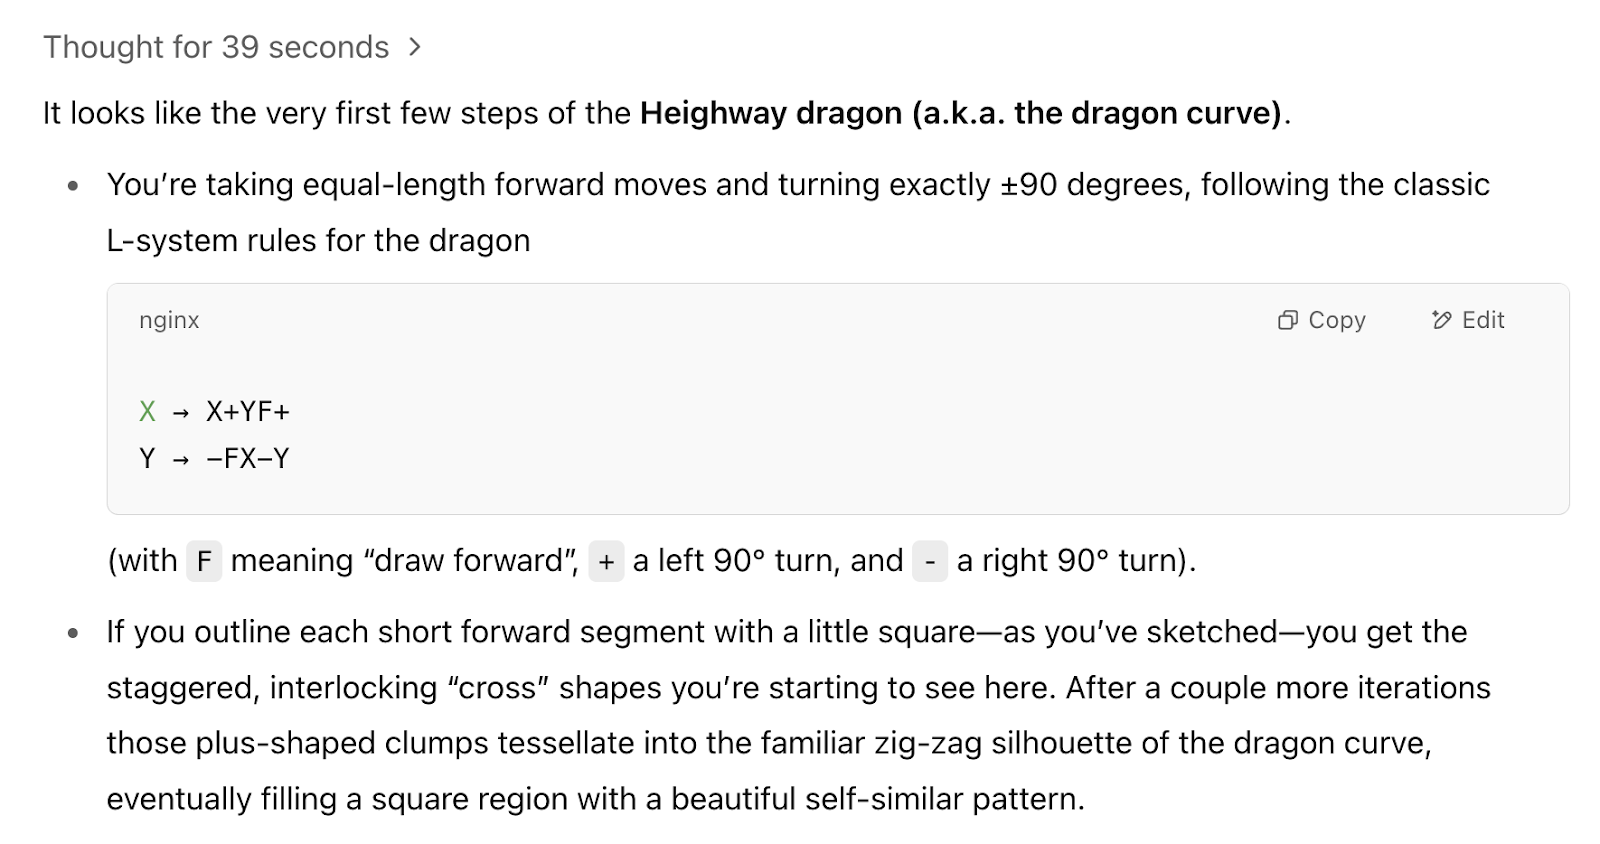
o1 ha risposto in modo errato. o3, invece, ha indovinato: ci ha detto che stavamo iniziando a disegnare la curva del drago. Era un piccolo test, ma il risultato ci ha colpiti perché non avevamo dato a o3 molti indizi.
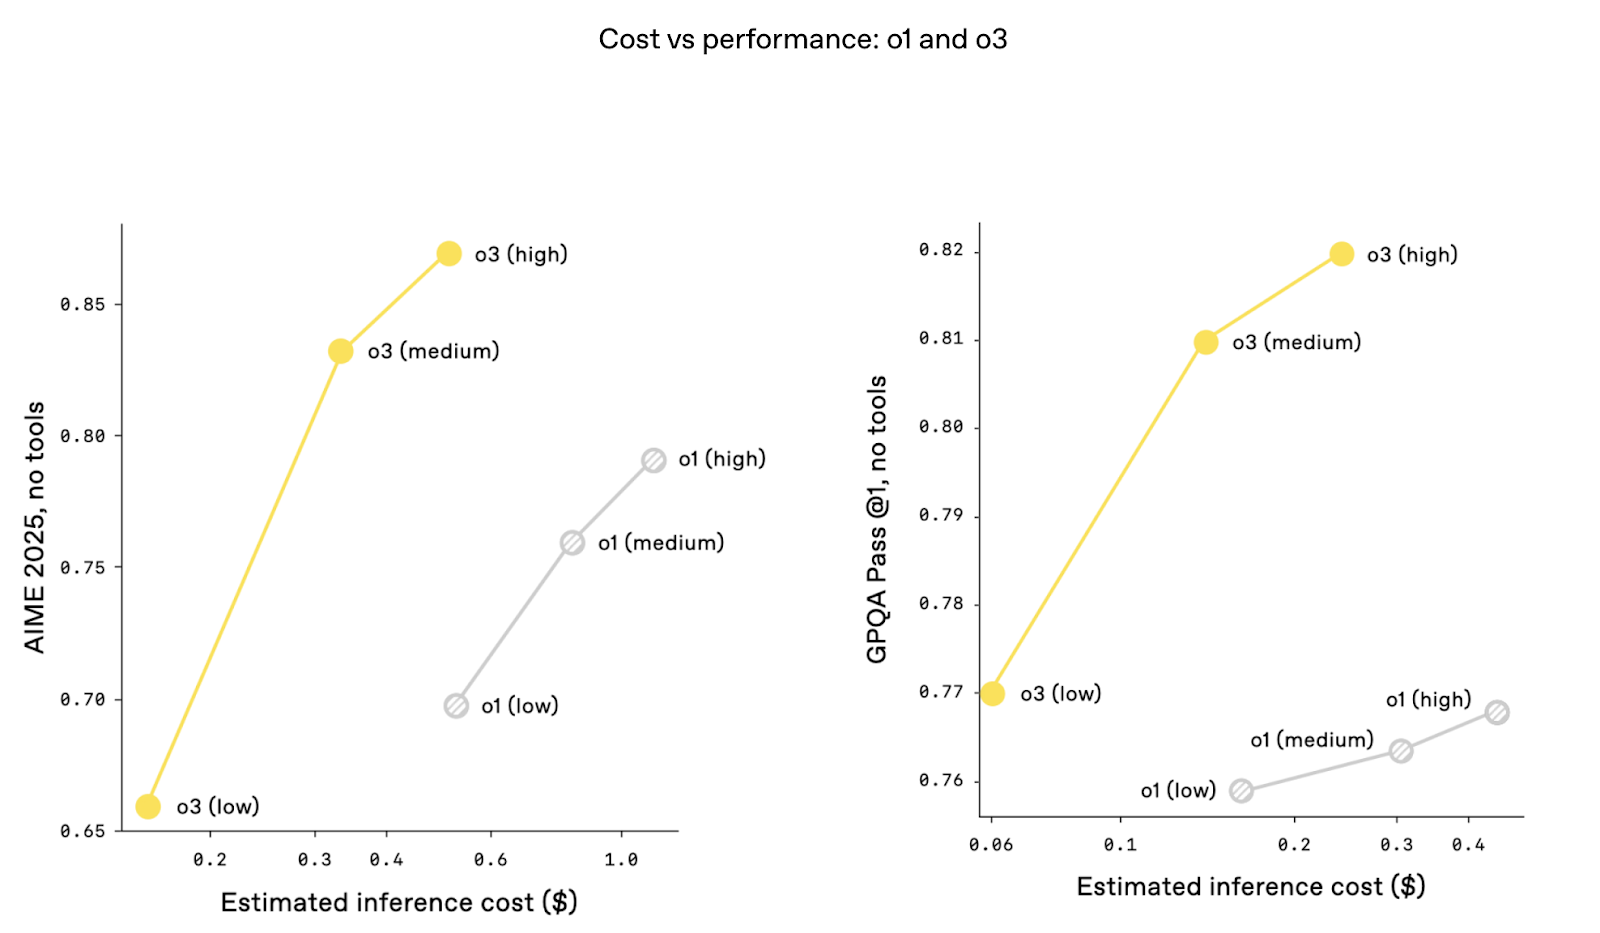
Interessante notare che i rapporti costo-prestazioni sono migliori con o3. Vale a dire, le prestazioni sono più alte agli stessi livelli di costo d’inferenza. Ciò potrebbe dipendere da ottimizzazioni architetturali che migliorano il throughput di token e riducono la latenza. Il costo è stato un grande tema di discussione da quando Deepseek-R1 ha annunciato prestazioni altissime a una frazione del costo di ChatGPT.
Da aprile 2025, o3-mini è stato completamente sostituito da o4-mini in ChatGPT e nell’API. o4-mini offre prestazioni migliori nella maggior parte dei benchmark, aggiunge input multimodale nativo e mantiene la compatibilità con gli strumenti—il tutto restando più veloce e conveniente di o3. Di fatto, o4-mini assume ora il ruolo per cui o3-mini era stato progettato. I contenuti qui sotto, però, restano validi per o3-mini.
o3-mini è stato introdotto insieme a o3 come alternativa conveniente, pensata per portare capacità avanzate di ragionamento a più utenti mantenendo buone prestazioni. OpenAI ha descritto o3-mini come una ridefinizione della “frontiera costo-prestazioni” nei modelli di ragionamento, rendendolo accessibile per compiti che richiedono alta accuratezza ma devono bilanciare i vincoli di risorse.
Una delle caratteristiche principali di o3-mini è il tempo di pensiero adattivo, che consente agli utenti di regolare lo sforzo di ragionamento del modello in base alla complessità del compito. Per problemi più semplici, si può selezionare ragionamento a basso sforzo per massimizzare velocità ed efficienza.
Per compiti più impegnativi, opzioni con sforzo di ragionamento più alto consentono al modello di performare a livelli paragonabili a o3 stesso, ma a una frazione del costo. Questa flessibilità è particolarmente interessante per sviluppatori e ricercatori che lavorano su casi d’uso diversi.
Fonte: OpenAI
La demo dal vivo ha mostrato come o3-mini mantenga la promessa. Per esempio, in un compito di coding, a o3-mini è stato chiesto di generare uno script Python per creare un server locale con una UI interattiva per i test. Nonostante la complessità del compito, il modello si è comportato bene, dimostrando di saper affrontare sfide di programmazione.
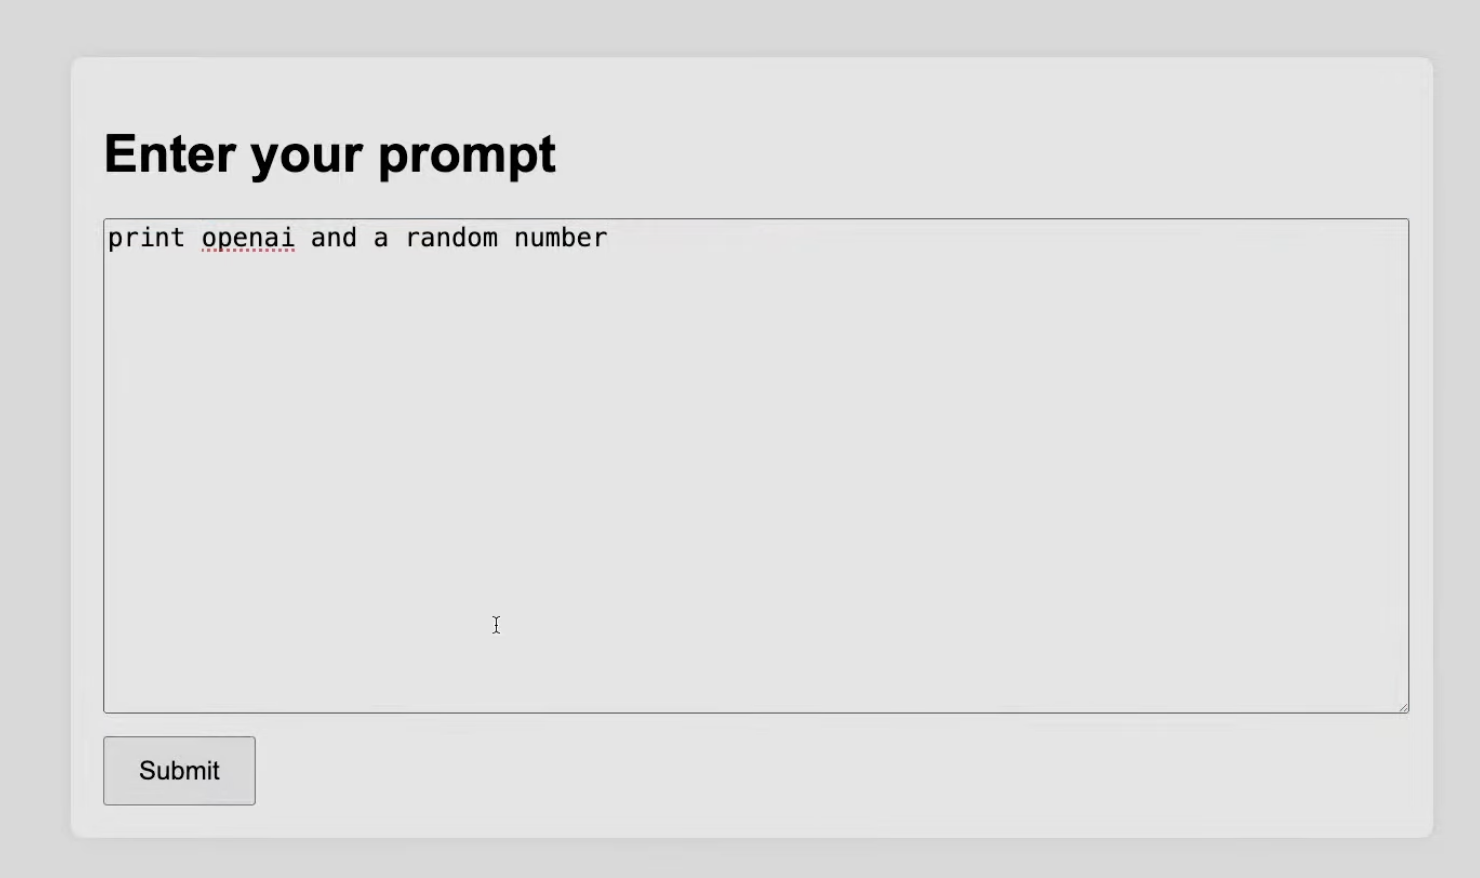
Fonte: OpenAI
Vediamo o3-mini come una soluzione pratica per scenari in cui economicità e prestazioni devono allinearsi.
Ci è voluto un po’ di tempo in più perché O3 diventasse disponibile, e alcune ragioni potrebbero essere legate a innovazioni nella sicurezza.
OpenAI ha dichiarato di aver ricostruito i dataset di training sulla sicurezza e introdotto migliaia di prompt mirati ai rifiuti. Hanno evidenziato categorie specifiche: minacce biologiche, generazione di malware e tecniche di jailbreak. Questi dati di training aggiornati hanno permesso a o3 di mostrare un’elevata accuratezza nei rifiuti su benchmark interni, come la gestione delle istruzioni gerarchiche e la resilienza al jailbreak. Per riuscirci, a quanto si dice, i membri del team OpenAI hanno passato mille ore a contrassegnare contenuti non sicuri.
OpenAI ha anche implementato un monitor basato sul ragionamento di un LLM (quello che chiamano un “monitor di ragionamento incentrato sulla sicurezza”). Quindi, oltre ad addestrare il modello a dire “no” ai prompt non sicuri, OpenAI ha introdotto un ulteriore livello di sicurezza, costituito da un LLM basato sul ragionamento. Pensalo come un modello “cane da guardia” che gira in parallelo, addestrato specificamente per ragionare su intento e rischi potenziali degli input degli utenti, usando regole di sicurezza scritte da umani come guida.
OpenAI ha adottato un approccio proattivo al testing di sicurezza per o3 e o3 mini aprendo l’accesso ai ricercatori per valutazioni pubbliche di sicurezza prima del rilascio completo dei modelli.
Una caratteristica centrale della strategia di sicurezza di OpenAI per o3 è il deliberative alignment, un metodo che va oltre gli approcci tradizionali alla sicurezza. Il grafico seguente evidenzia come il deliberative alignment differisca da altri metodi come RLHF (Reinforcement Learning with Human Feedback), RLAIF (Reinforcement Learning with AI Feedback) e tecniche di raffinamento in fase d’inferenza come Self-REFINE.
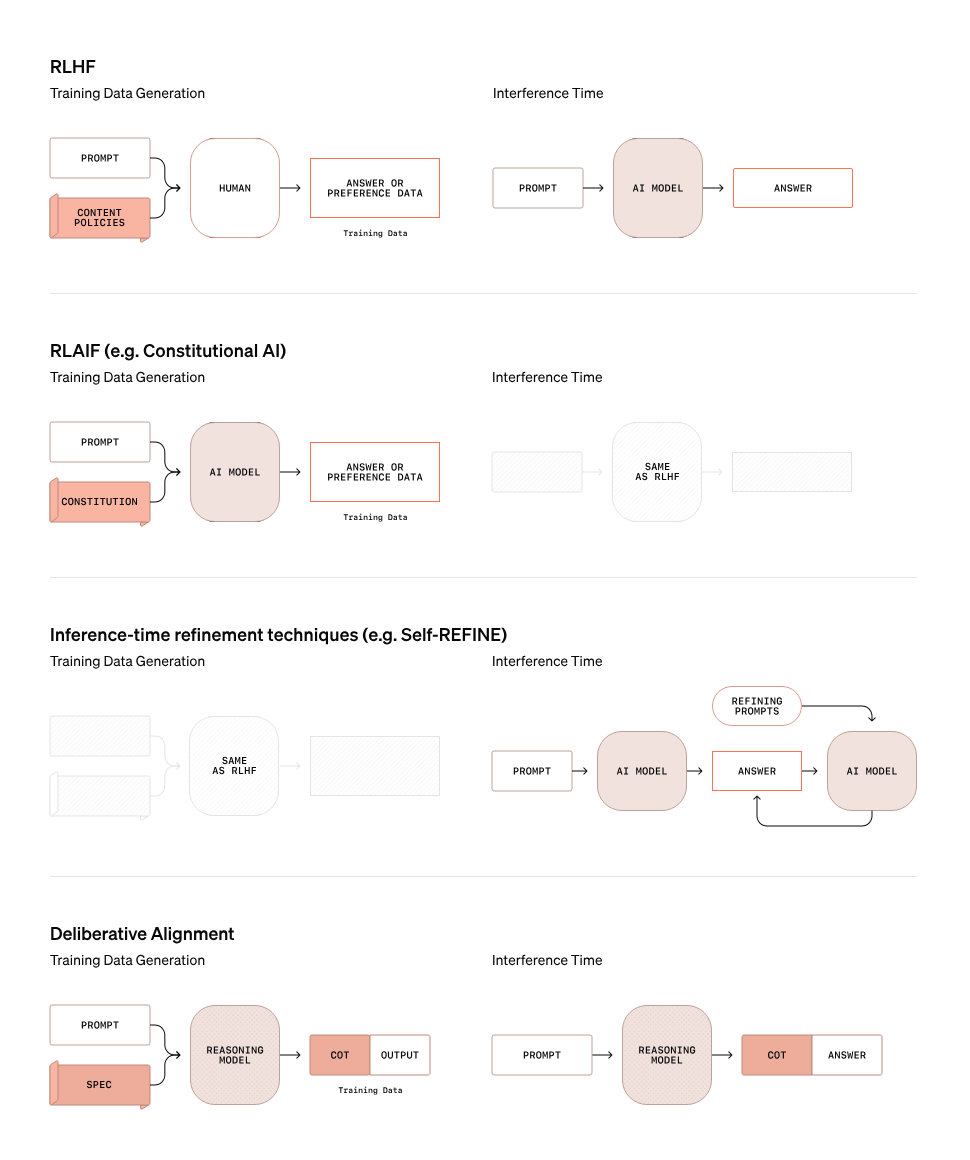
Fonte: OpenAI
Nel deliberative alignment, il modello non si limita a regole statiche o dataset di preferenze per determinare se un prompt è sicuro o meno. Invece, usa le sue capacità di ragionamento per valutare i prompt in tempo reale. Il grafico sopra illustra questo processo:
OpenAI si aspetta che vorremo continuare a informarci sulla sicurezza. In previsione, ha rilasciato il suo Preparedness Framework con le proprie idee su come misurare e proteggersi da danni gravi.
Nel selettore modelli di ChatGPT ora vedrai disponibili o3 e o4-mini. Secondo l’annuncio di OpenAI, o3-pro è previsto in uscita nelle prossime settimane. Includerà le stesse capacità di uso degli strumenti—come Python, navigazione e analisi delle immagini—degli altri modelli della serie o.
Se ti interessano aggiornamenti sulla disponibilità di o3-pro, iscriviti alla newsletter di DataCamp, The Median, e ti avviseremo non appena sarà disponibile.
O3 e o3 mini mettono in luce la crescente complessità dei sistemi di IA e le sfide del loro rilascio responsabile. Anche se i benchmark sono impressionanti, siamo ancora più interessati alle domande che questi modelli sollevano: quanto bene continueranno a performare in scenari reali? Le misure di sicurezza sono abbastanza robuste da gestire casi limite su larga scala?
Per noi, o3 e o3 mini sono segnali anticipatori di sistemi di IA che si avvicinano a una maggiore autonomia. Il loro ragionamento e adattabilità impressionanti suggeriscono un passaggio da strumenti che usiamo ad agenti che agiscono per nostro conto. Cosa succede quando questi sistemi affrontano compiti aperti senza un prompt umano? Come valutiamo modelli che generano i propri obiettivi, non solo i propri output?
Se vuoi esplorare altri temi di IA, ti consigliamo:
Impara l’IA con questi corsi!
Programma
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



