Corso
Machine Learning con modelli ad alberi in Python
5 ore
119.3K
Immagina di cercare su Google un determinato articolo di ricerca sul machine learning. Trovi qualcosa di interessante e vuoi vedere l’implementazione del codice, il dataset e i risultati. Finirai per passare ore e ore a cercarli singolarmente. Ora immagina di dover ripetere questo passaggio altre 30 volte per la tua tesi o un progetto di ricerca. Può essere un incubo.
Papers With Code ti semplifica la vita. Rende molto più facile leggere gli articoli di ricerca, offrendo a colpo d’occhio il loro riepilogo, l’implementazione del codice, i risultati e il dataset. Inoltre, puoi confrontare i risultati dell’architettura di modelli diversi su un argomento simile grazie alla funzione di classifica (leaderboard).
È molto più che cercare un articolo di ricerca. Puoi filtrare la tua ricerca usando tag su vari task, sotto-task, modelli, dataset e metodi per esplorare l’argomento in profondità.
In questo blog, esploreremo le varie funzionalità chiave di Papers With Code e vedremo il modo migliore per condurre ricerche per progetti di machine learning.
Nella pagina iniziale vedrai gli articoli di ricerca di tendenza in base al numero di stelle all’ora.
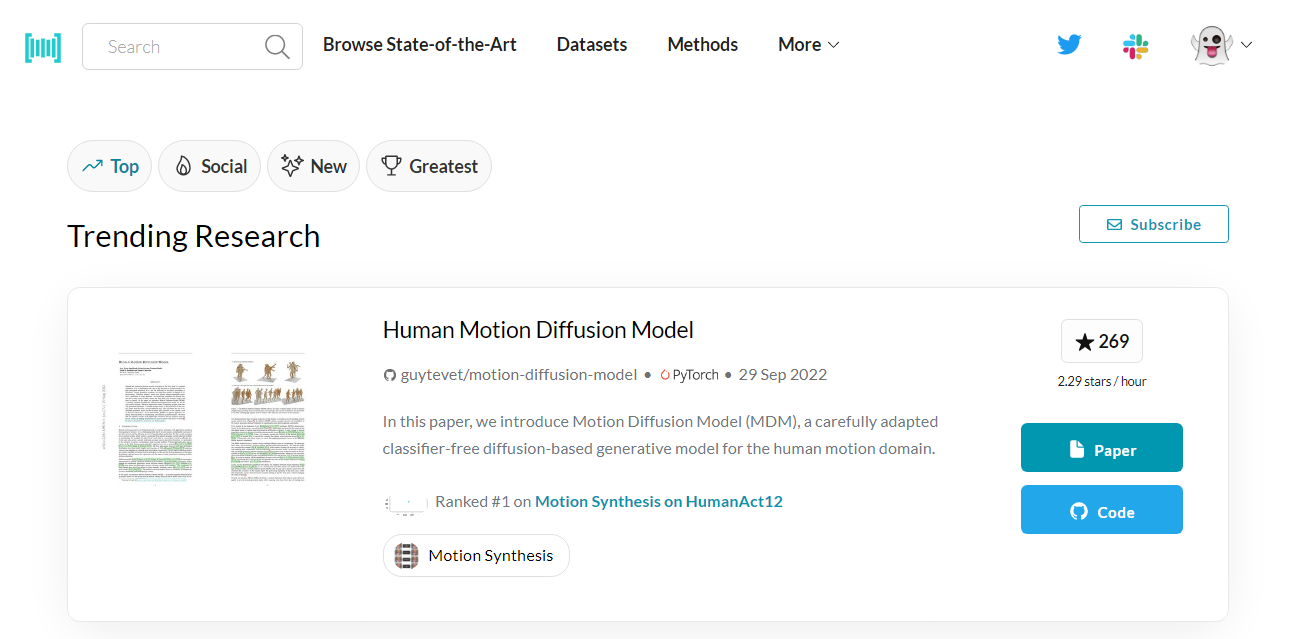
Papers With Code | Trending
Se ti piace l’articolo di ricerca, fai clic sul pulsante Paper per leggere l’abstract e vedere risultati, dataset e varie implementazioni del codice. Oppure, se ti interessa l’implementazione, puoi cliccare su Code e accedere al repository GitHub con risultati, implementazioni del codice e dipendenze.
La pagina dei trend è simile alla homepage di un social. Puoi continuare a scorrere verso il basso per vedere gli articoli in tendenza passati con oltre 1000 stelle e più implementazioni di codice contribuite dalla community.
Papers With Code è una piattaforma guidata dalla community per conoscere gli articoli di ricerca all’avanguardia sul machine learning. Fornisce un ecosistema completo per contributor open source, machine learning engineer, data scientist, ricercatori e studenti, rendendo facile condividere idee e accelerare lo sviluppo del machine learning.
Tutti i contenuti su Papers With Code sono rilasciati con licenza aperta CC-BY-SA e chiunque può contribuire usando i pulsanti “Edit”.
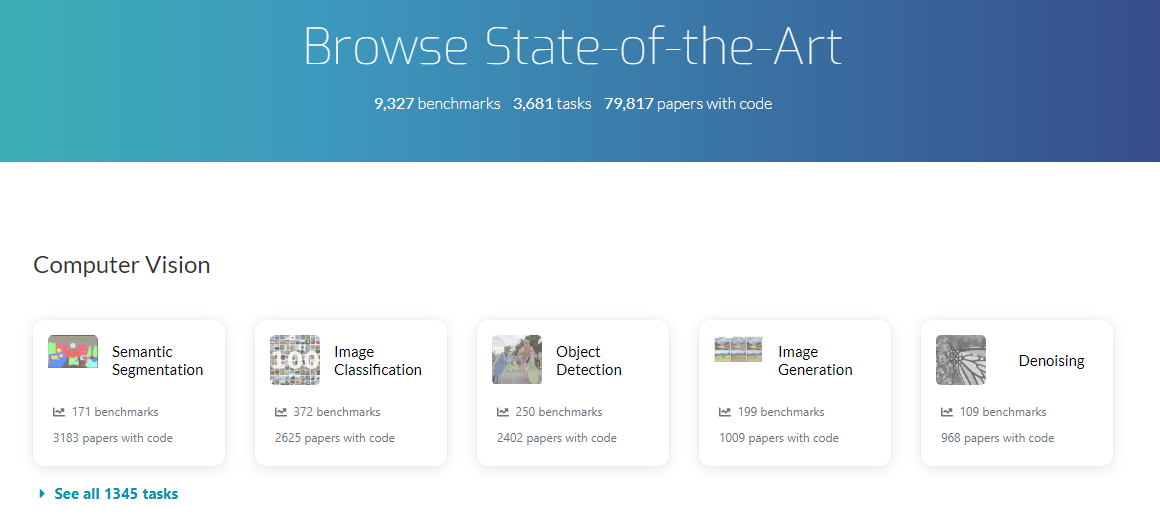
Papers With Code | Sfoglia lo stato dell’arte
Cliccando sulla scheda Browse State-of-the-Art vedrai categorie e sottocategorie basate su vari ambiti di studio del machine learning. Per esempio:
Ognuna delle categorie sopra ha sottocategorie. E quando clicchi su una scheda di sottocategoria, vedi una breve definizione della sottocategoria e il benchmark.
Lo scopo principale della sezione Browse State-of-the-Art è offrirti informazioni sui modelli con le migliori prestazioni su un dato dataset, le librerie più popolari, l’elenco dei dataset, dei sotto-task e gli articoli più implementati. Inoltre, puoi confrontare varie metriche di prestazione dei modelli sullo stesso dataset.
Se vuoi conoscere le varie categorie del machine learning, dai un’occhiata alla nostra pagina dei Corsi di Machine Learning. Include una raccolta di corsi per principianti, machine learning con Python e R e corsi basati su progetti. Puoi anche dare un’occhiata a template, tutorial e cheat sheet popolari.
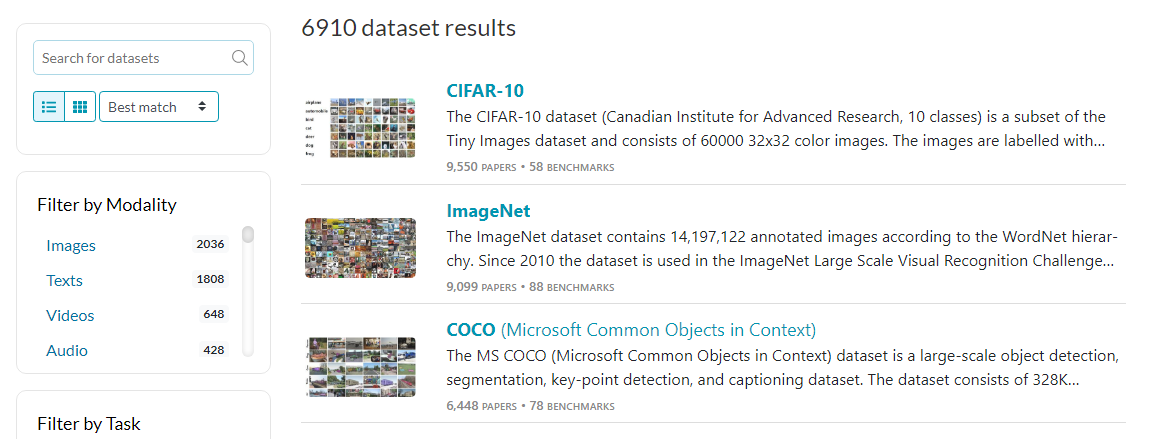
Papers With Code | Datasets
Invece di categorie e sottocategorie, puoi cercare un dataset specifico o usare vari filtri per trovarlo.
In generale, il sito è interconnesso e non devi cercare i dataset uno a uno. Ma, se stai lavorando a una ricerca che richiede più dataset su un problema specifico di machine learning, la scheda Dataset ti aiuterà a trovare qualsiasi dataset popolare usando le funzioni di ricerca e filtro. Puoi filtrare i dataset in base a modalità, task e lingue.
La parte divertente inizia quando clicchi su un particolare dataset. Troverai varie sezioni interattive come:
In breve, la scheda Dataset è pienamente integrata con le altre parti del sito per offrire un’esperienza fluida nell’esecuzione di ricerche approfondite.
Puoi anche consultare la sezione Datasets su DataCamp per scaricare vari tipi di dataset. Inoltre, puoi avviare gratuitamente un Jupyter Notebook in cloud con un solo clic.
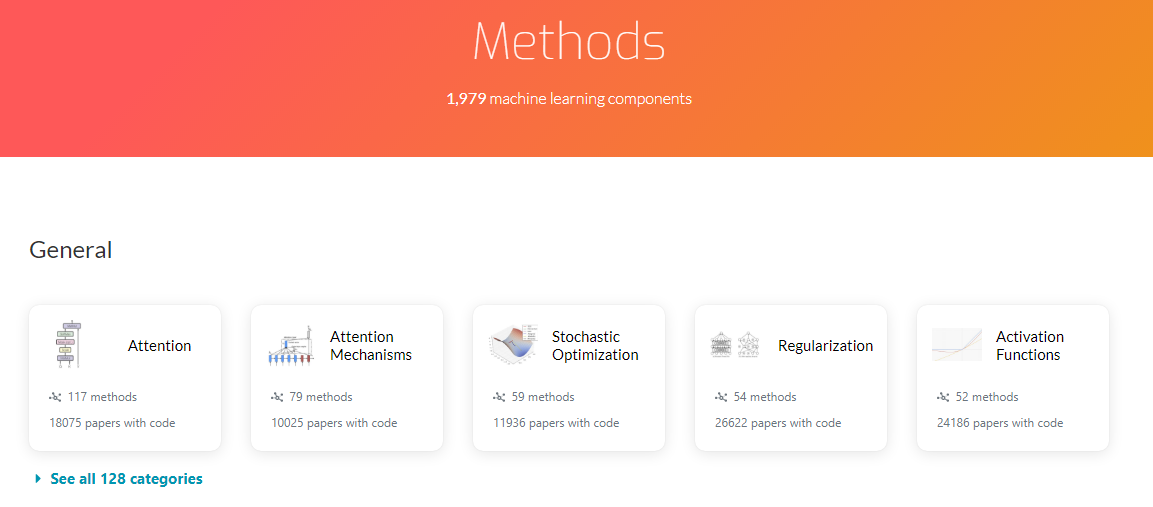
Papers With Code | Methods
La scheda Methods è simile a Browse State-of-the-Art. Presenta categorie e sottocategorie sotto forma di schede. La scheda Methods è pensata per i ricercatori che vogliono approfondire metodologie specifiche di machine learning. Per esempio, Word Embedding, Image Feature Extraction e funzioni di attivazione.
Comprende 7 categorie:
Quando clicchi su una scheda di metodo, vedrai la definizione, un diagramma e la sezione Methods. Nel caso della scheda Attention, vedrai Multi-Head Attention, Scaled Dot-Product Attention, Fixed Factorized Attention e tutti i metodi di Attention. Ogni metodo mostra l’anno di pubblicazione e il numero di articoli che lo utilizzano.
Dopo aver cliccato sul metodo Multi-Head Attention, vedrai una pagina con un riepilogo dell’equazione, un PDF scaricabile dell’articolo e il codice sorgente. Vedrai anche le sezioni Papers, Tasks, Usage Over Time, Components e Categories.
È un modo piacevole per imparare i metodi di machine learning, perché tutto è ottimizzato per migliorare l’esperienza dei ricercatori.
Papers With Code | Paper
In cima alla pagina dell’articolo di ricerca vedrai il titolo, i nomi degli autori, la data e l’abstract. Subito dopo troverai il pulsante PDF, che porta all’articolo completo, e il pulsante Abstract, che porta alla pagina dell’abstract su arxiv.org.
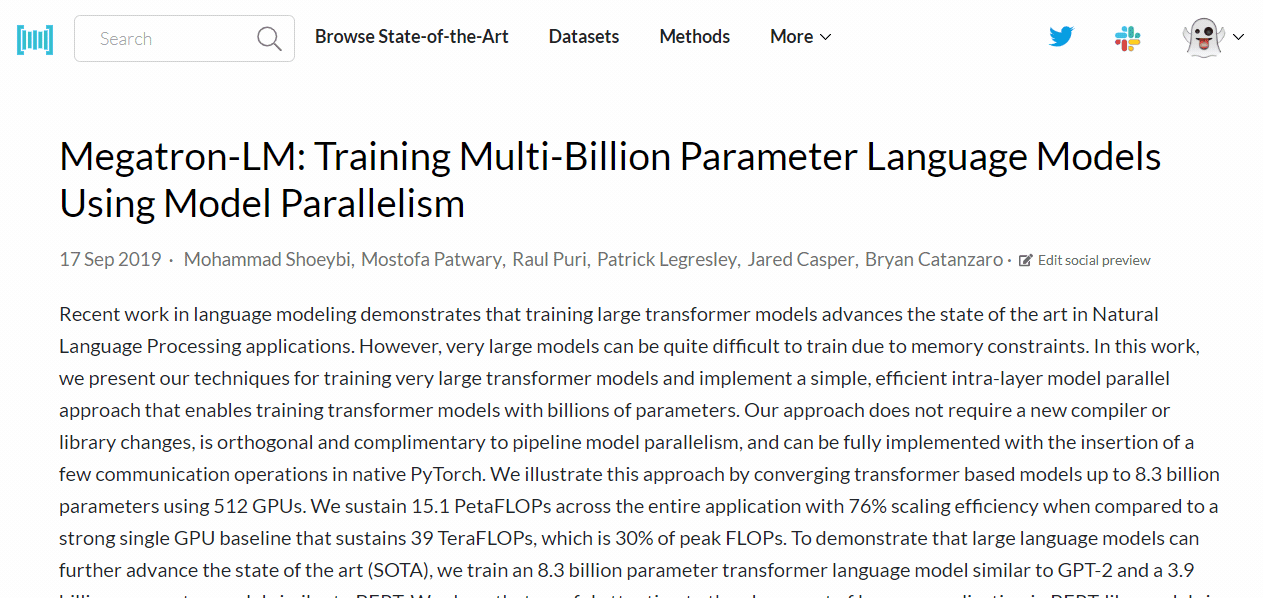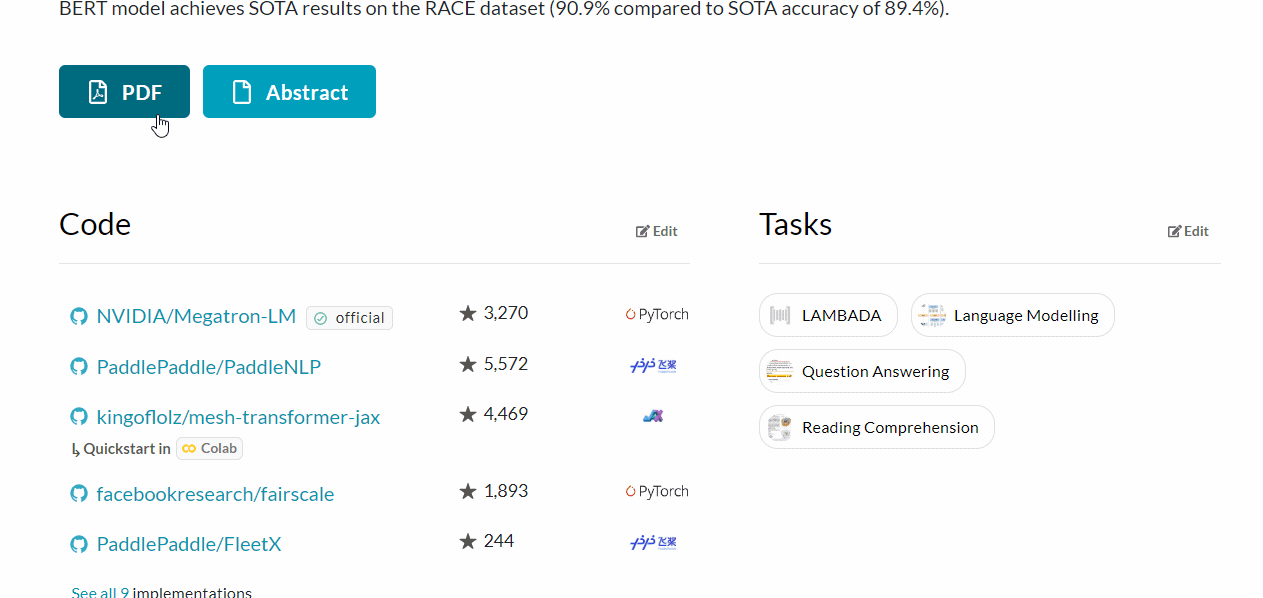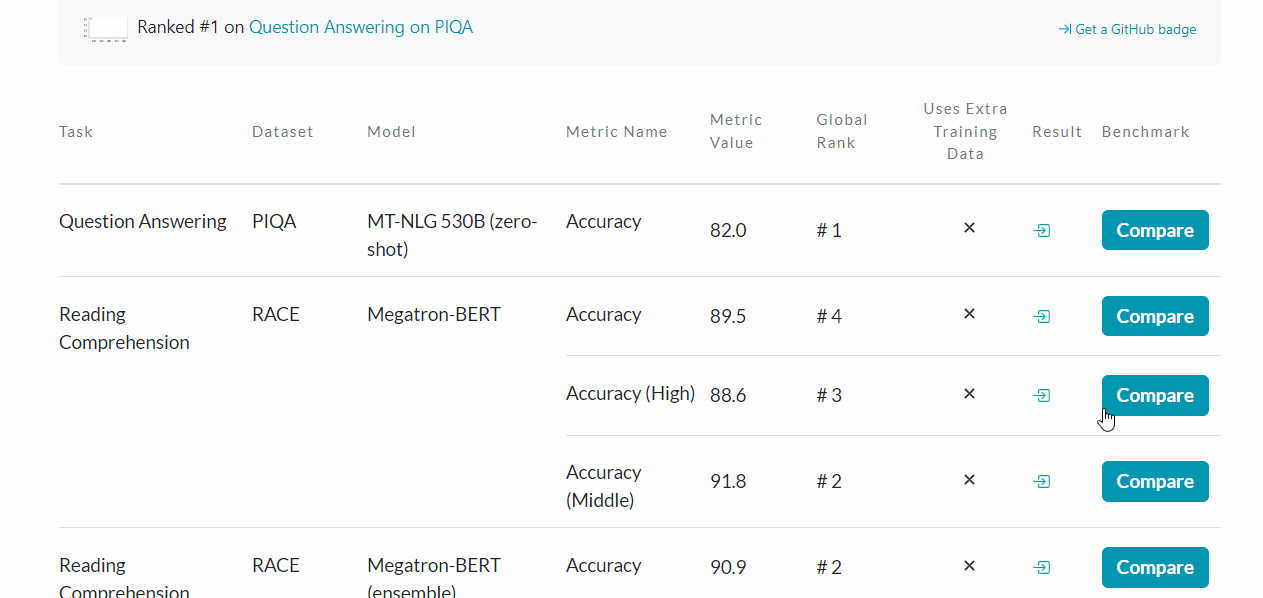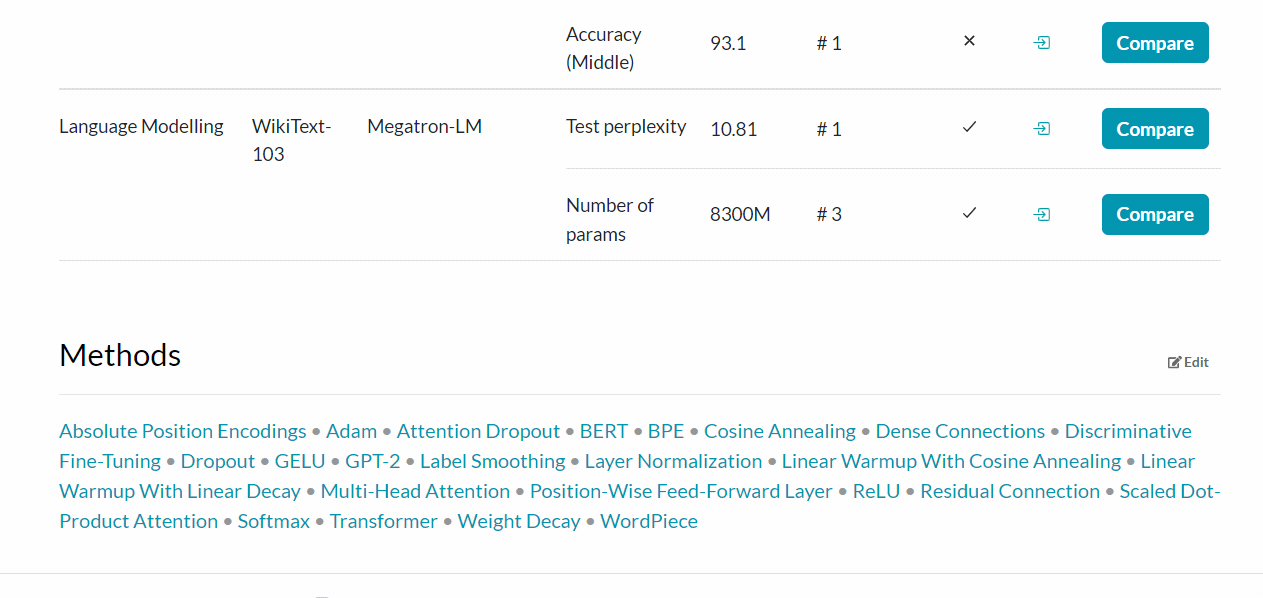
Inoltre, un articolo di ricerca comprende 5 sezioni:
Leggere un articolo su Papers With Code è facile e interattivo. Invece di scaricare e leggere l’intero paper, puoi imparare quasi tutto consultando tag, implementazioni del codice, task e risultati.
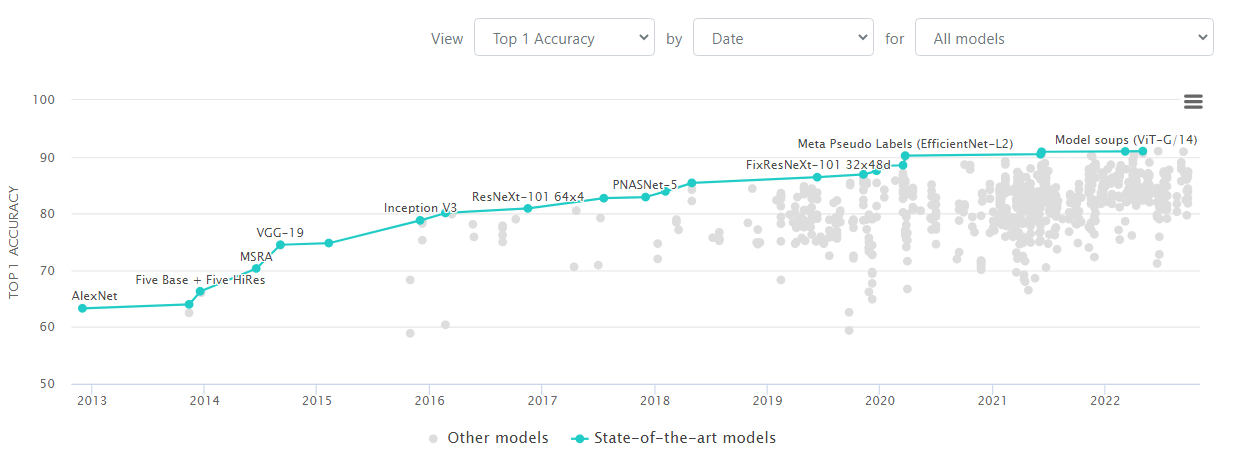
Papers With Code | Classifica per Image Classification su ImageNet
Se guardi l’immagine sopra, le linee e i punti color teal rappresentano il modello di classificazione di immagini allo stato dell’arte sul dataset ImageNet. I punti grigi sono i modelli di classificazione di immagini con prestazioni più basse in un determinato periodo.
L’intero ecosistema di Papers With Code ruota attorno a una classifica e mette in evidenza le ricerche all’avanguardia. In homepage vedrai le ricerche di tendenza in base alle stelle e alla popolarità. Ogni scheda mette in risalto dataset popolari, implementazioni di codice e le migliori metodologie e articoli di ricerca.
L’idea alla base di classifiche, trend e benchmark è promuovere la qualità della ricerca. In questo modo, ogni giorno spingiamo i confini del machine learning per raggiungere risultati all’avanguardia.
Qui sotto trovi alcuni consigli utili per usare la piattaforma Papers With Code e ottimizzare il tuo progetto di ricerca:
Gli sviluppatori aggiungono continuamente nuove funzionalità per migliorare l’esperienza d’uso e, se hai qualcosa di nuovo da condividere o richieste di funzionalità, puoi contattarli su Twitter o Slack.
La piattaforma Papers With Code riunisce menti provenienti da background diversi. Il sito è mantenuto da Meta AI, ma è gestito dalla community. L’apertura al contributo favorisce l’inclusività, un fattore cruciale nella rapida crescita dell’industria del machine learning e dell’intelligenza artificiale.
In questo blog, abbiamo visto l’importanza di una piattaforma interattiva e interconnessa come Papers With Code. Abbiamo anche scoperto le funzionalità chiave del sito e alcuni consigli per ottimizzare la ricerca.
Papers With Code è ottimo per articoli di ricerca sul machine learning, codice, dataset e benchmark. È uno dei posti migliori per iniziare il tuo progetto di fine corso. Anche se sei alle prime armi, puoi iscriverti al percorso professionale Machine Learning Scientist with Python o con R per iniziare il tuo percorso professionale.
Se cerchi dei progetti di machine learning su cui lavorare, dai un’occhiata al nostro blog dettagliato con idee per studenti di tutti i livelli.
Corsi di Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



