{count, plural, one {कोर्स} other {कोर्स}}
Python में Tree-Based Models के साथ Machine Learning
{hours} घंटा
119.4K
कल्पना करें कि आप Google पर किसी विशेष मशीन लर्निंग शोध-पत्र को खोज रहे हैं। आपको कुछ रुचिकर मिलता है और आप उसका कोड इम्प्लीमेंटेशन, डेटा सेट और परिणाम देखना चाहते हैं। इन्हें अलग-अलग ढूंढने में आपके घंटों लग जाएंगे। अब सोचें कि अपने थीसिस या शोध परियोजना के लिए यह चरण आपको 30 बार दोहराना पड़े। यह किसी बुरे सपने जैसा हो सकता है।
Papers With Code आपकी मदद के लिए है। इसने शोध-पत्र पढ़ना बहुत आसान बना दिया है—एक नज़र में सारांश, कोड इम्प्लीमेंटेशन, परिणाम और डेटा सेट दिख जाते हैं। साथ ही, आप लीडरबोर्ड फीचर के जरिए समान विषय पर अलग-अलग मॉडलों की आर्किटेक्चर के परिणामों की तुलना भी कर सकते हैं।
यह केवल शोध-पत्र ढूंढने से कहीं अधिक है। आप कार्य, उप-कार्य, मॉडल, डेटा सेट और विधियों के टैग्स के जरिए फ़िल्टर लगाकर किसी विषय को गहराई से खोज सकते हैं।
इस ब्लॉग में, हम Papers With Code की प्रमुख विशेषताओं का अन्वेषण करेंगे और मशीन लर्निंग परियोजनाओं के लिए शोध करने का सर्वोत्तम तरीका सीखेंगे।
लैंडिंग पेज पर, आपको प्रति घंटे मिलने वाले सितारों (stars) की संख्या के आधार पर ट्रेंडिंग शोध-पत्र दिखाई देंगे।
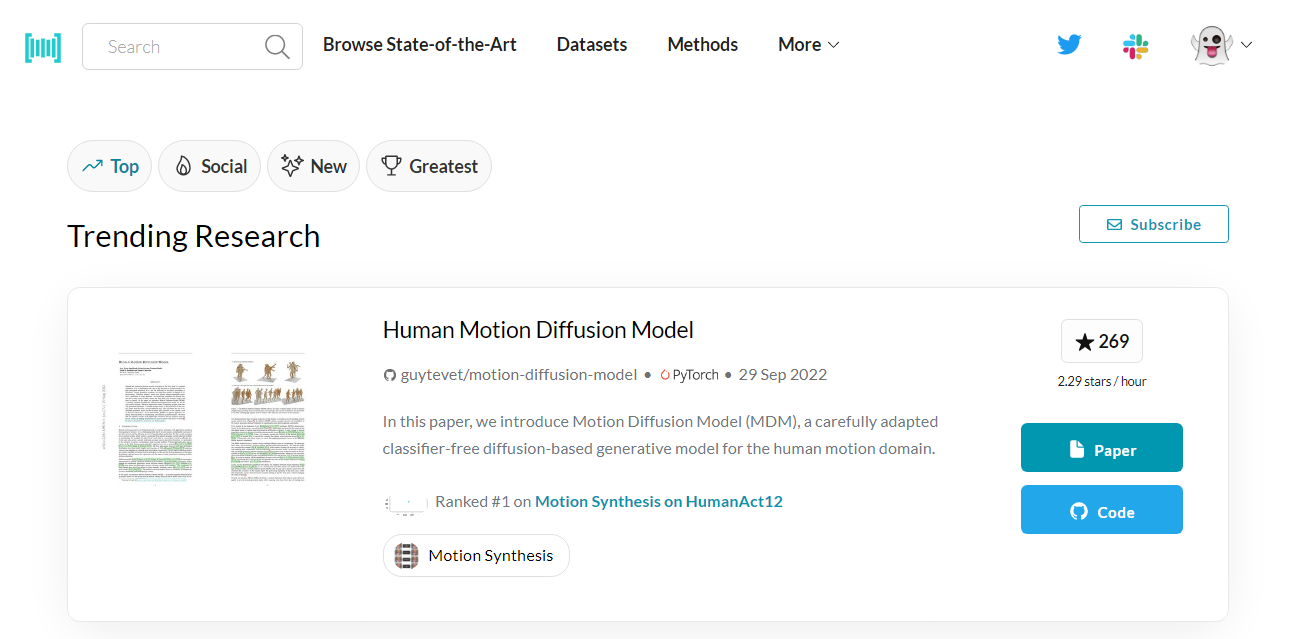
Papers With Code | ट्रेंडिंग
यदि आपको कोई शोध-पत्र पसंद आता है, तो Paper बटन पर क्लिक करके एब्स्ट्रैक्ट पढ़ें और परिणाम, डेटा सेट तथा विभिन्न कोड इम्प्लीमेंटेशन देखें। या, यदि आप इम्प्लीमेंटेशन में रुचि रखते हैं, तो Code पर क्लिक कर GitHub रेपो तक पहुँचें, जहाँ परिणाम, कोड इम्प्लीमेंटेशन और डिपेंडेंसीज़ मिलेंगी।
ट्रेंडिंग पेज किसी सोशल मीडिया लैंडिंग पेज जैसा ही है। आप नीचे स्क्रॉल करते जाएँ और बीते समय के ट्रेंडिंग पेपर्स देखें जिन पर 1000+ सितारे और समुदाय द्वारा योगदान किए गए कई कोड इम्प्लीमेंटेशन मिलेंगे।
Papers With Code मशीन लर्निंग पर अत्याधुनिक शोध-पत्रों के बारे में सीखने के लिए एक समुदाय-चालित प्लेटफॉर्म है। यह ओपन-सोर्स योगदानकर्ताओं, मशीन लर्निंग इंजीनियर्स, डेटा साइंटिस्ट्स, शोधकर्ताओं और छात्रों के लिए विचार साझा करना और एमएल विकास को आगे बढ़ाना आसान बनाते हुए एक संपूर्ण इकोसिस्टम प्रदान करता है।
Papers With Code पर सारा कंटेंट CC-BY-SA लाइसेंस के अंतर्गत खुला है, और कोई भी “Edit” बटन का उपयोग करके योगदान कर सकता है।
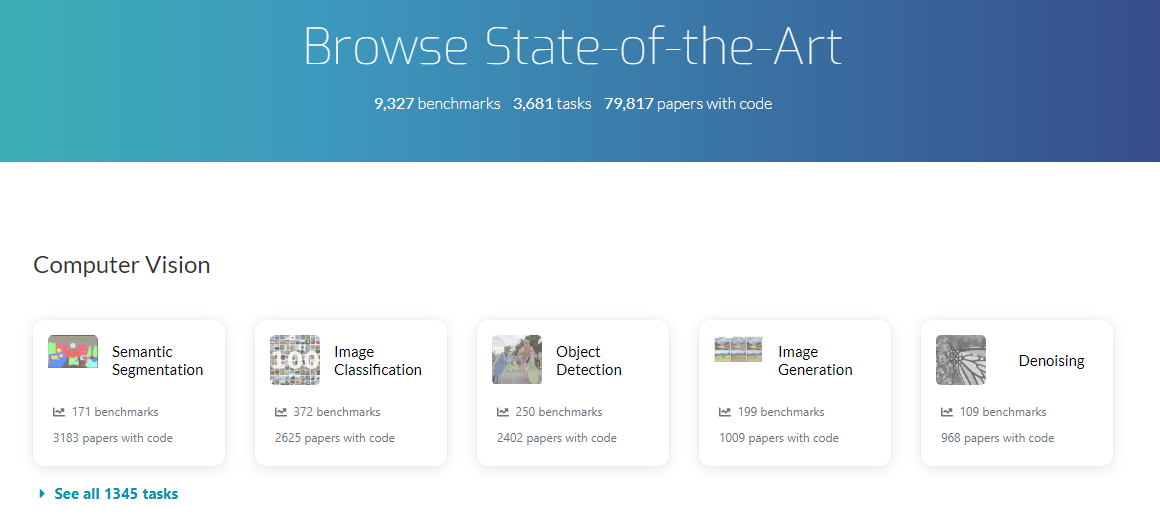
Papers With Code | State-of-the-Art ब्राउज़ करें
Browse State-of-the-Art टैब पर क्लिक करने पर आपको मशीन लर्निंग के विभिन्न क्षेत्रों के आधार पर श्रेणियाँ और उप-श्रेणियाँ दिखेंगी। उदाहरण के लिए:
उपरोक्त प्रत्येक श्रेणी की उप-श्रेणियाँ होती हैं। और जब आप किसी उप-श्रेणी कार्ड पर क्लिक करते हैं, तो आपको उसका संक्षिप्त अर्थ और बेंचमार्क दिखाई देंगे।
Browse State-of-the-Art खंड का मुख्य उद्देश्य आपको किसी दिए गए डेटा सेट पर सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडलों, लोकप्रिय लाइब्रेरीज़, डेटा सेट्स, उप-कार्यों और सबसे अधिक इम्प्लीमेंट किए गए पेपर्स की जानकारी देना है। साथ ही, आप एक ही डेटा सेट पर विभिन्न मॉडलों के परफॉर्मेंस मेट्रिक्स की तुलना कर सकते हैं।
यदि आप मशीन लर्निंग की विभिन्न श्रेणियों के बारे में सीखना चाहते हैं, तो हमारे Machine Learning Courses पेज पर नज़र डालें। इसमें शुरुआती-अनुकूल कोर्सेज़, Python और R के साथ मशीन लर्निंग, और प्रोजेक्ट-आधारित कोर्स शामिल हैं। आप लोकप्रिय टेम्प्लेट्स, ट्यूटोरियल्स और चीट शीट्स भी देख सकते हैं।
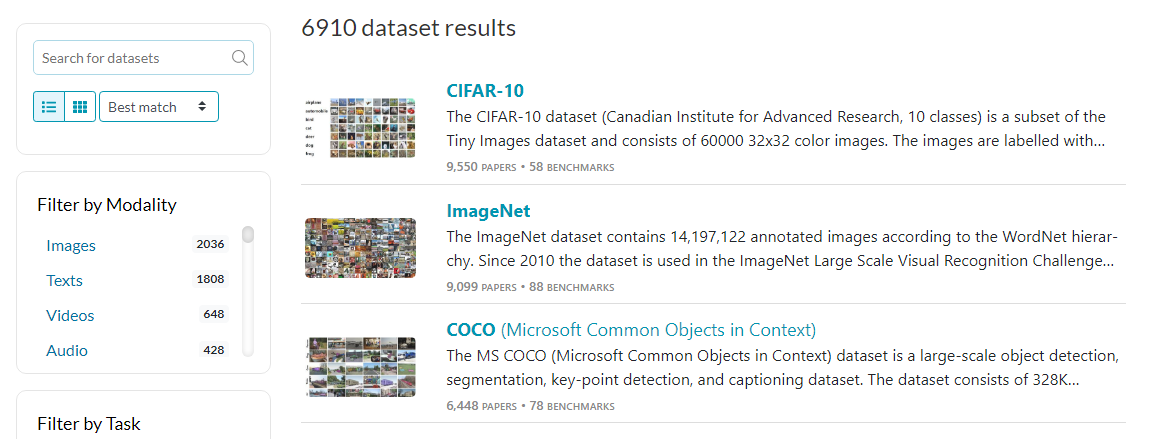
Papers With Code | डेटा सेट्स
श्रेणियों और उप-श्रेणियों के बजाय, आप किसी विशेष डेटा सेट को खोज सकते हैं या विभिन्न फ़िल्टर्स का उपयोग कर उसे ढूंढ सकते हैं।
आम तौर पर, वेबसाइट आपस में जुड़ी हुई है और आपको डेटा सेट्स अलग-अलग ढूंढने की ज़रूरत नहीं पड़ती। लेकिन यदि आप ऐसे शोध पर काम कर रहे हैं जिसमें किसी विशिष्ट मशीन लर्निंग समस्या पर कई डेटा सेट्स की आवश्यकता है, तो Dataset टैब आपको सर्च और फ़िल्टर सुविधाओं के माध्यम से लोकप्रिय डेटा सेट ढूंढने में मदद करेगा। आप मोडैलिटी, टास्क्स और लैंग्वेजेज़ के आधार पर डेटा सेट्स को फ़िल्टर कर सकते हैं।
मज़ेदार भाग तब शुरू होता है जब आप किसी विशेष डेटा सेट पर क्लिक करते हैं। आपको कई इंटरएक्टिव सेक्शन्स मिलेंगे, जैसे:
संक्षेप में, Dataset टैब वेबसाइट के अन्य भागों के साथ पूरी तरह एकीकृत है, ताकि गहन शोध के लिए एक सहज उपयोगकर्ता अनुभव मिल सके।
आप DataCamp के Datasets सेक्शन में भी विभिन्न प्रकार के डेटा सेट्स डाउनलोड कर सकते हैं। साथ ही, आप केवल एक क्लिक में क्लाउड Jupyter Notebook निःशुल्क शुरू कर सकते हैं।
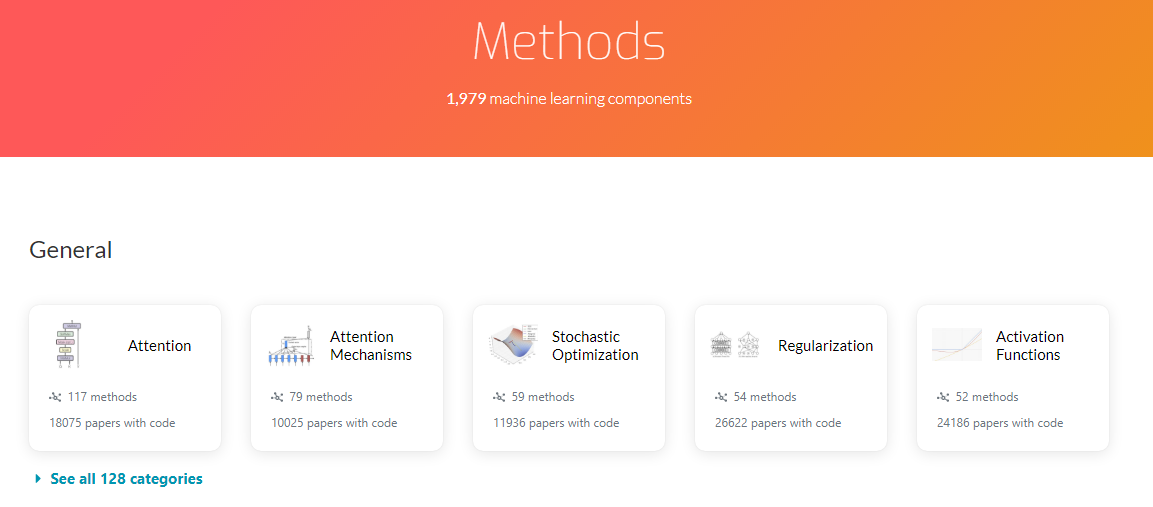
Papers With Code | Methods
Methods टैब Browse State-of-the-Art टैब जैसा ही है। इसमें डिस्प्ले कार्ड्स के रूप में श्रेणियाँ और उप-श्रेणियाँ हैं। Method टैब उन शोधकर्ताओं के लिए है जो विशिष्ट मशीन लर्निंग कार्य-विधियों के बारे में सीखना चाहते हैं। उदाहरण के लिए, Word Embedding, Image Feature Extractions और Activation Functions।
यह 7 श्रेणियों से मिलकर बना है:
किसी भी मेथड कार्ड पर क्लिक करने पर, आपको उसकी परिभाषा, आरेख, और Methods सेक्शन दिखेगा। उदाहरण के लिए, Attention मेथड कार्ड में Multi-Head Attention, Scaled Dot-Product Attention, Fixed Factorized Attention और अन्य सभी Attention मेथड्स दिखते हैं। प्रत्येक मेथड पर प्रकाशन वर्ष और इस मेथड का उपयोग करने वाले पेपर्स की संख्या दी होती है।
Multi-Head Attention मेथड पर क्लिक करने के बाद, आपको समीकरण का सारांश, पेपर की डाउनलोड करने योग्य PDF, और सोर्स कोड के साथ एक पेज दिखेगा। साथ ही Papers, Tasks, Usage Over Time, Components, और Categories सेक्शन्स भी मिलेंगे।
मशीन लर्निंग मेथड्स के बारे में सीखने का यह एक रोचक तरीका है, क्योंकि हर चीज़ शोधकर्ता के अनुभव को बेहतर बनाने के लिए अनुकूलित है।
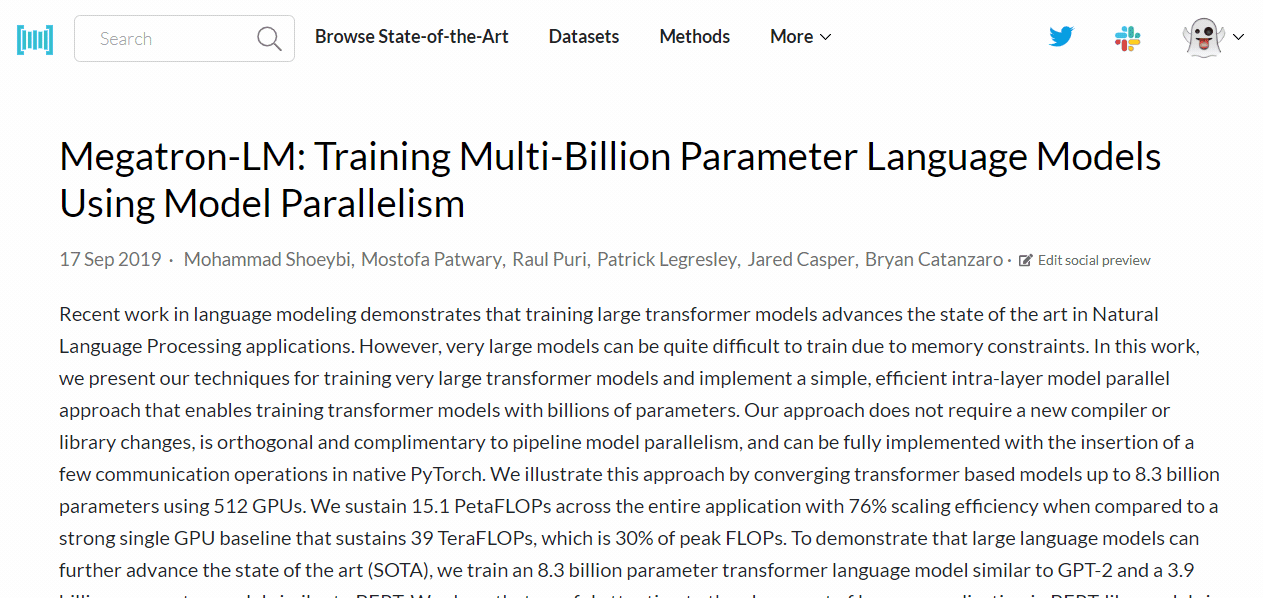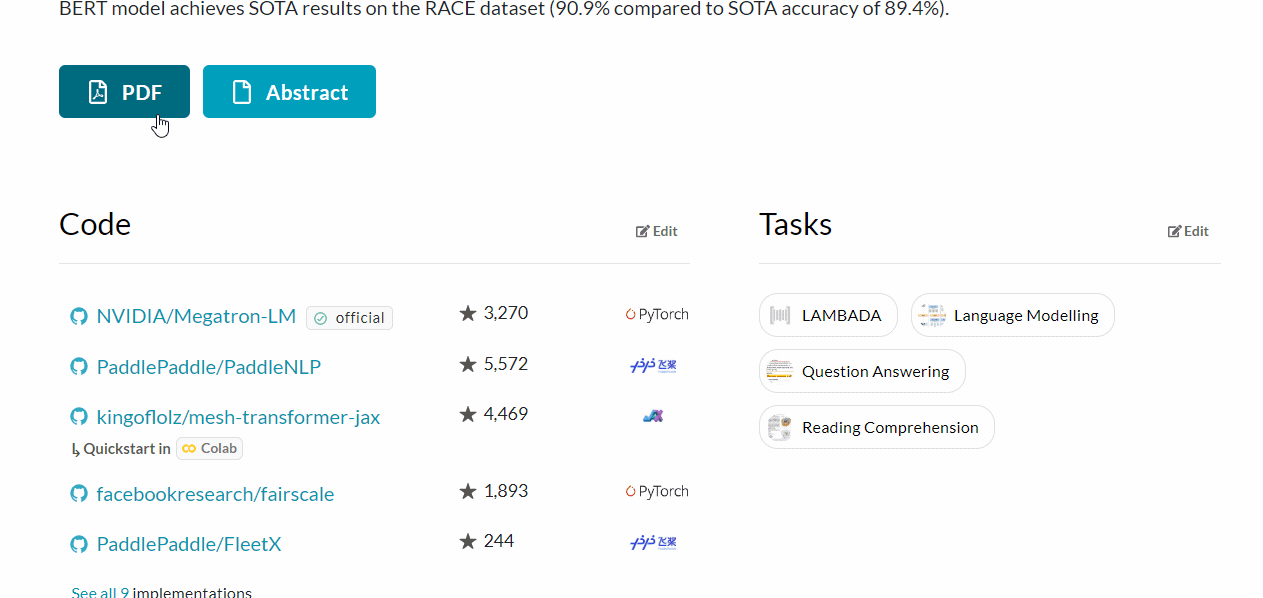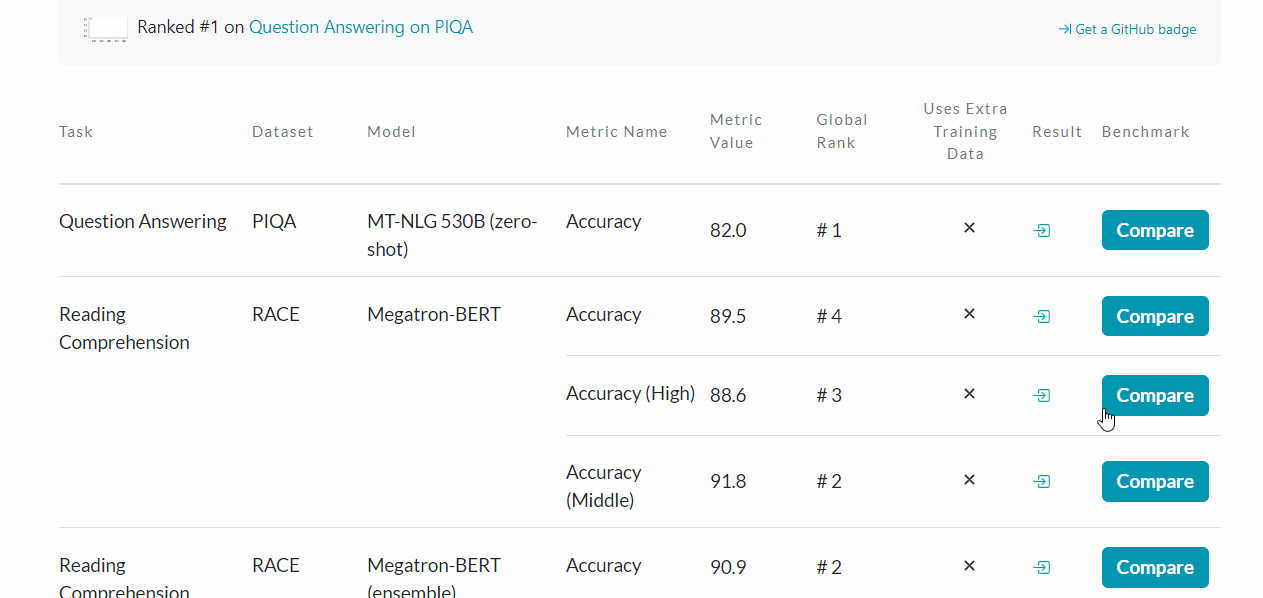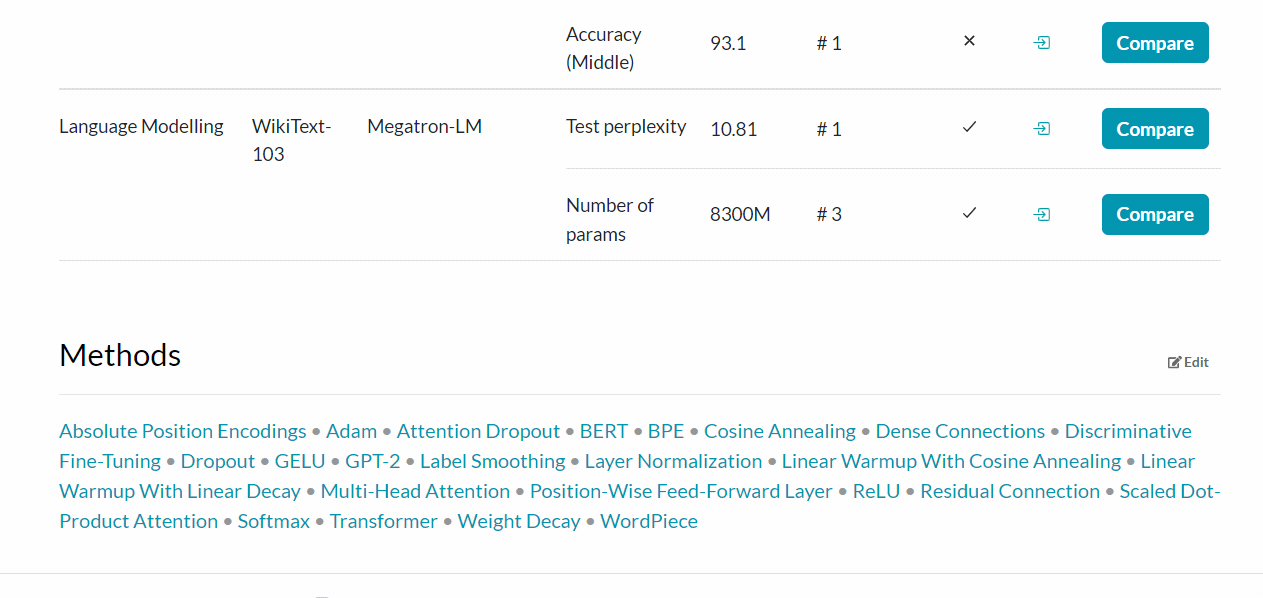
Papers With Code | पेपर
रिसर्च पेपर पेज के शीर्ष पर आपको शीर्षक, लेखक का नाम, तारीख और एब्स्ट्रैक्ट दिखाई देंगे। उसके बाद आपको PDF बटन दिखेगा, जो आपको पूरे शोध-पत्र तक ले जाएगा, और Abstract बटन, जो आपको arxiv.org के एब्स्ट्रैक्ट पेज पर ले जाएगा।
इसके अलावा, एक रिसर्च पेपर 5 सेक्शन्स से मिलकर बना होता है:
Papers With Code पर रिसर्च पेपर पढ़ना आसान और इंटरएक्टिव है। पूरे पेपर को डाउनलोड करके पढ़ने के बजाय, आप टैग्स, कोड इम्प्लीमेंटेशन, टास्क्स और परिणाम देखकर लगभग सब कुछ सीख सकते हैं।
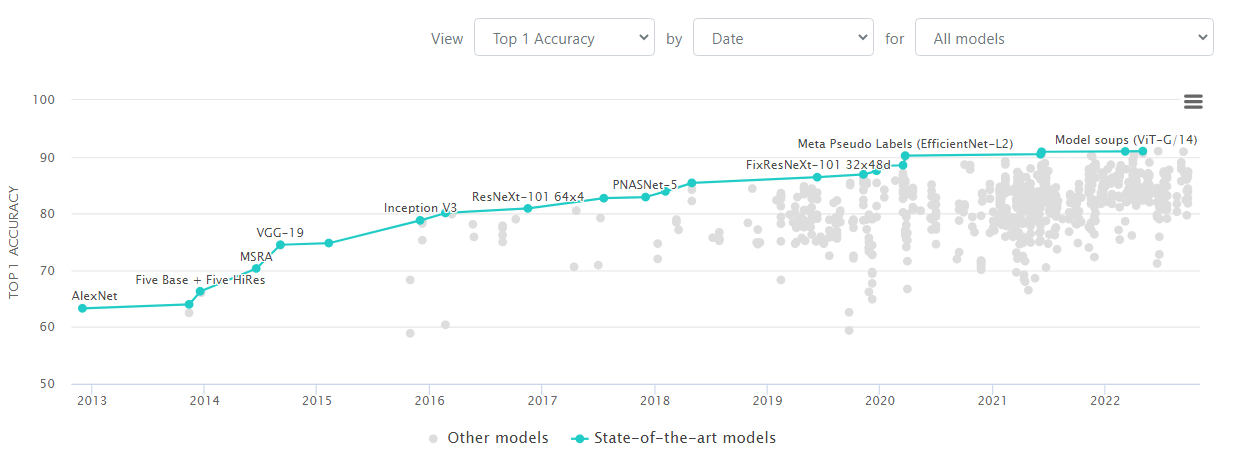
Papers With Code | ImageNet पर इमेज क्लासिफिकेशन लीडरबोर्ड
ऊपर की तस्वीर में, टील रंग की रेखाएँ और बिंदु Imagenet डेटा सेट पर स्टेट-ऑफ-द-आर्ट इमेज क्लासिफिकेशन मॉडल का प्रतिनिधित्व करते हैं। ग्रे बिंदु किसी विशेष अवधि में कम प्रदर्शन करने वाले इमेज क्लासिफिकेशन मॉडलों को दर्शाते हैं।
Papers With Code का पूरा इकोसिस्टम लीडरबोर्ड के इर्द-गिर्द घूमता है और शीर्ष पर स्टेट-ऑफ-द-आर्ट शोध को बढ़ावा देता है। फ्रंट पेज पर आपको सितारों और लोकप्रियता के आधार पर ट्रेंडिंग शोध दिखेंगे। हर टैब लोकप्रिय डेटा सेट्स, कोड इम्प्लीमेंटेशन, श्रेष्ठ कार्य-विधियों और शोध-पत्रों को बढ़ावा देता है।
लीडरबोर्ड, ट्रेंड्स और बेंचमार्क्स के पीछे की पूरी दृष्टि शोध की गुणवत्ता को बढ़ावा देना है। इस तरह, हम हर दिन मशीन लर्निंग की सीमाओं को आगे बढ़ाकर स्टेट-ऑफ-द-आर्ट स्थिति हासिल करने का प्रयास करते हैं।
नीचे Papers With Code प्लेटफॉर्म का उपयोग करने और अपने शोध प्रोजेक्ट को बेहतर बनाने के लिए कुछ उपयोगी सुझाव दिए गए हैं:
डेवलपर्स उपयोगकर्ता अनुभव सुधारने के लिए हमेशा नए फीचर्स जोड़ते रहते हैं, और यदि आपके पास कोई नया विचार या फीचर अनुरोध है, तो आप उनसे Twitter या Slack पर संपर्क कर सकते हैं।
Papers With Code प्लेटफॉर्म विभिन्न पृष्ठभूमियों के लोगों को साथ लाता है। वेबसाइट का रखरखाव Meta AI करता है, लेकिन इसे समुदाय चलाता है। योगदान के प्रति खुलापन समावेशन को बढ़ाता है, जो मशीन लर्निंग और आर्टिफिशियल इंटेलिजेंस उद्योग की तेज़ी से वृद्धि का एक अहम कारक है।
इस ब्लॉग में, हमने Papers With Code नामक इंटरएक्टिव और इंटरकनेक्टेड प्लेटफॉर्म के महत्व के बारे में सीखा। साथ ही, वेबसाइट की प्रमुख विशेषताएँ और शोध को अनुकूल बनाने के सुझाव भी खोजे।
Paper With Code मशीन लर्निंग शोध-पत्रों, कोड, डेटा सेट्स और बेंचमार्क्स के लिए शानदार है। यह आपके अंतिम वर्ष की परियोजना शुरू करने के सर्वोत्तम स्थानों में से एक है। यदि आप इस क्षेत्र में नए हैं, तो आप Machine Learning Scientist with Python या R करियर ट्रैक में शामिल होकर अपनी पेशेवर यात्रा शुरू कर सकते हैं।
यदि आप काम करने के लिए कुछ मशीन लर्निंग प्रोजेक्ट्स ढूंढ रहे हैं, तो सभी स्तरों के शिक्षार्थियों के लिए विचारों के साथ हमारा विस्तृत ब्लॉग देखें।
Machine Learning Courses
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}