Curso
Aprendizado de máquina com modelos baseados em árvores em Python
5 h
118.7K
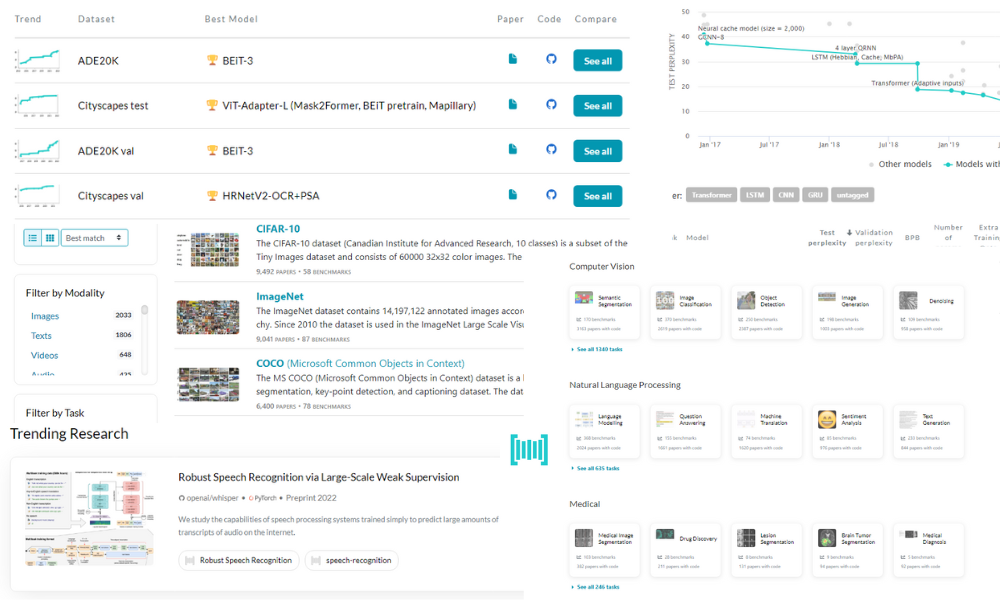
Imagine buscar no Google um artigo específico de pesquisa em machine learning. Você encontra algo interessante e quer ver a implementação de código, o dataset e os resultados. Vai gastar horas procurando cada um separadamente. Agora imagine repetir isso mais 30 vezes para sua tese ou projeto de pesquisa. Vira um pesadelo.
Papers With Code resolve esse problema. Ele facilita muito a leitura de artigos, oferecendo um resumo rápido, a implementação em código, os resultados e o dataset. Além disso, você pode comparar o desempenho de diferentes arquiteturas de modelos sobre um mesmo tema usando o recurso de ranking (leaderboard).
É muito mais do que só procurar artigos. Você pode filtrar sua busca com tags de tarefas, subtarefas, modelos, datasets e métodos para explorar o assunto a fundo.
Neste blog, vamos explorar os principais recursos do Papers With Code e aprender a melhor forma de conduzir pesquisas para projetos de machine learning.
Na página inicial, você vê os artigos em alta com base no número de estrelas por hora.
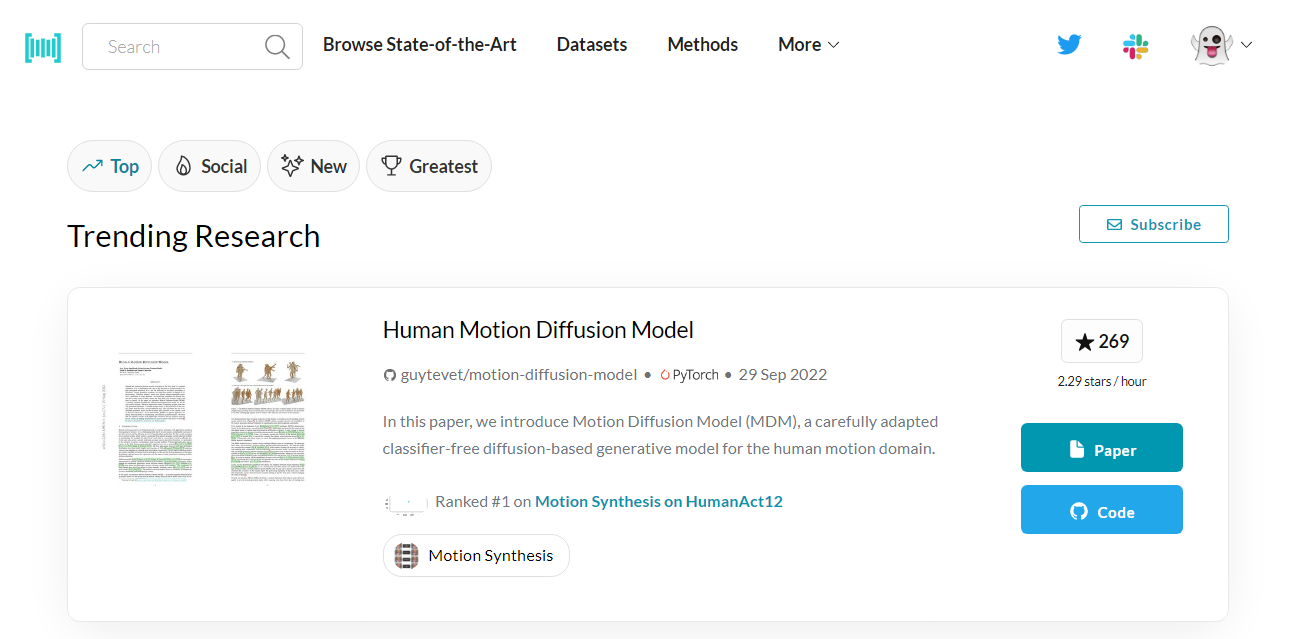
Papers With Code | Em alta
Se você curtir o artigo, clique no botão Paper para ler o resumo e ver resultados, datasets e diferentes implementações de código. Ou, se seu foco for a implementação, clique em Code e acesse o repositório no GitHub com resultados, código e dependências.
A página de tendências lembra um feed de rede social. Você pode rolar para ver artigos que já bombaram, com 1000+ estrelas e várias implementações de código da comunidade.
O Papers With Code é uma plataforma colaborativa para acompanhar artigos de ponta em machine learning. Ele oferece um ecossistema completo para contribuidores open source, engenheiros de machine learning, cientistas de dados, pesquisadores e estudantes compartilharem ideias e acelerarem o desenvolvimento da área.
Todo o conteúdo no Papers With Code tem licença aberta CC-BY-SA, e qualquer pessoa pode contribuir usando os botões “Edit”.
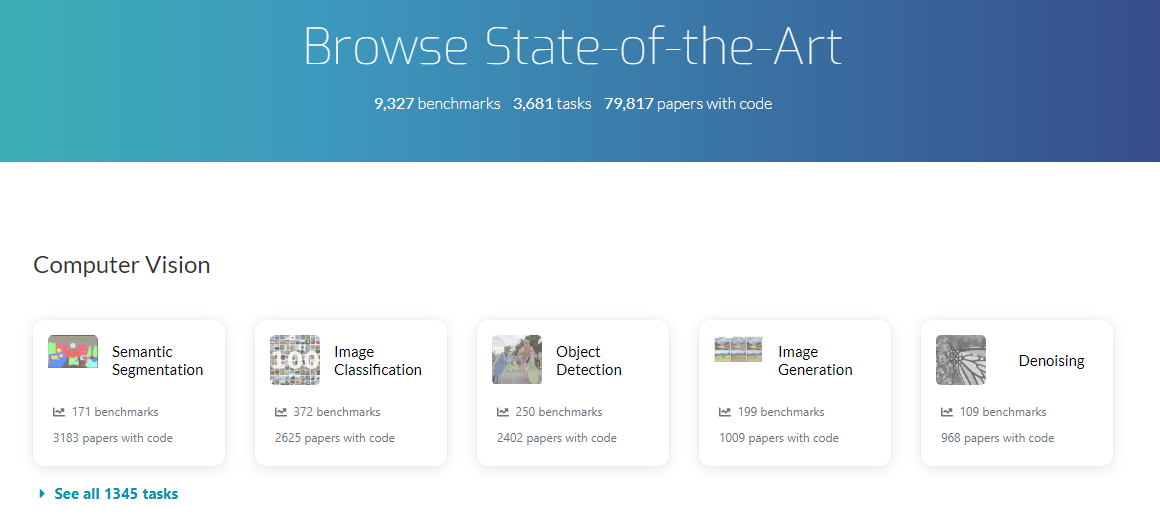
Papers With Code | Explorar o state-of-the-art
Ao clicar na aba Browse State-of-the-Art, você vê categorias e subcategorias de diferentes áreas de estudo em machine learning. Por exemplo:
Cada categoria tem suas subcategorias. Ao clicar em uma subcategoria, você vê uma definição breve e o benchmark.
O objetivo principal da seção Browse State-of-the-Art é mostrar os modelos com melhor desempenho em um dado dataset, bibliotecas populares, lista de datasets, subtarefas e os artigos mais implementados. Além disso, você consegue comparar diferentes métricas de performance de modelos no mesmo dataset.
Se quiser aprender sobre as várias categorias de machine learning, confira a página de Machine Learning Courses. Ela reúne cursos para iniciantes, ML com Python e R e cursos baseados em projetos. Você também pode explorar templates, tutoriais e cheat sheets populares.
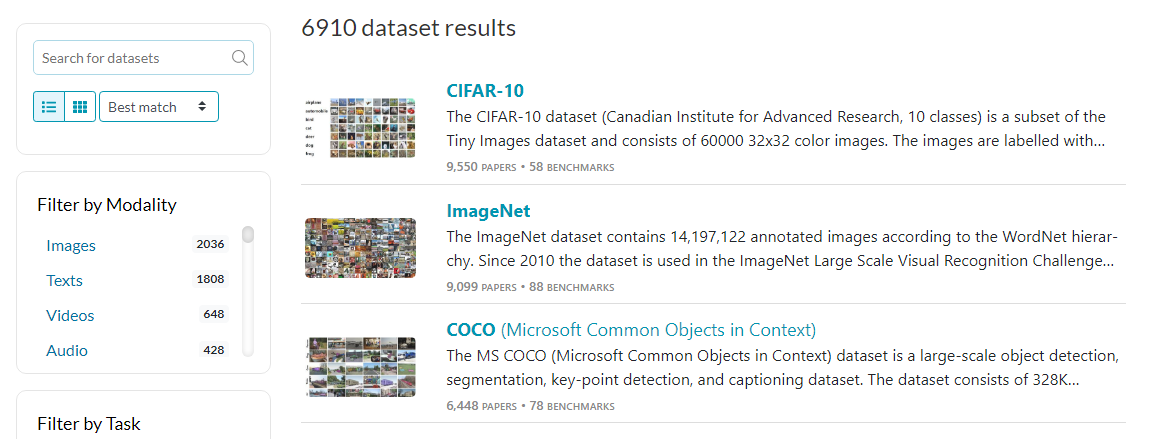
Papers With Code | Datasets
Em vez de navegar por categorias e subcategorias, você pode procurar um dataset específico ou usar filtros para encontrá-lo.
No geral, o site é todo interligado, então você não precisa caçar datasets um a um. Mas, se sua pesquisa exige múltiplos datasets para um problema específico de machine learning, a aba Dataset ajuda a localizar qualquer dataset popular com busca e filtros. É possível filtrar por modalidade, tarefas e idiomas.
A parte legal começa quando você clica em um dataset. Você encontra seções interativas como:
Em resumo, a aba Dataset é totalmente integrada ao restante do site para oferecer uma experiência fluida e apoiar pesquisas aprofundadas.
Você também pode visitar a seção de Datasets da DataCamp para baixar vários tipos de dados. E dá para iniciar um Jupyter Notebook na nuvem grátis com um clique.
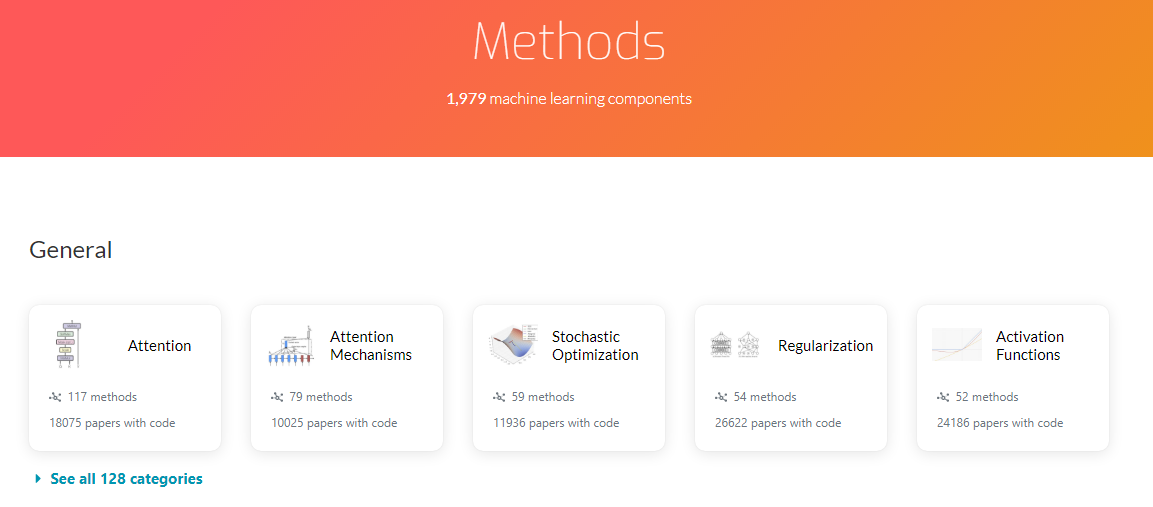
Papers With Code | Methods
A aba Methods é parecida com a Browse State-of-the-Art. Ela reúne categorias e subcategorias em cartões. É ideal para quem quer estudar metodologias específicas de ML, como word embeddings, extração de features de imagem e funções de ativação.
Ela inclui 7 categorias:
Ao abrir um cartão de método, você vê a definição, um diagrama e a seção Methods. No cartão de Attention, por exemplo, aparecem Multi-Head Attention, Scaled Dot-Product Attention, Fixed Factorized Attention e todas as variações de Attention. Cada método mostra o ano de publicação e quantos artigos o utilizam.
Ao clicar em Multi-Head Attention, você acessa um resumo com a equação, o PDF do artigo para download e o código-fonte. Você também encontra as seções Papers, Tasks, Usage Over Time, Components e Categories.
É uma forma envolvente de estudar métodos de ML, com tudo otimizado para melhorar a experiência do pesquisador.
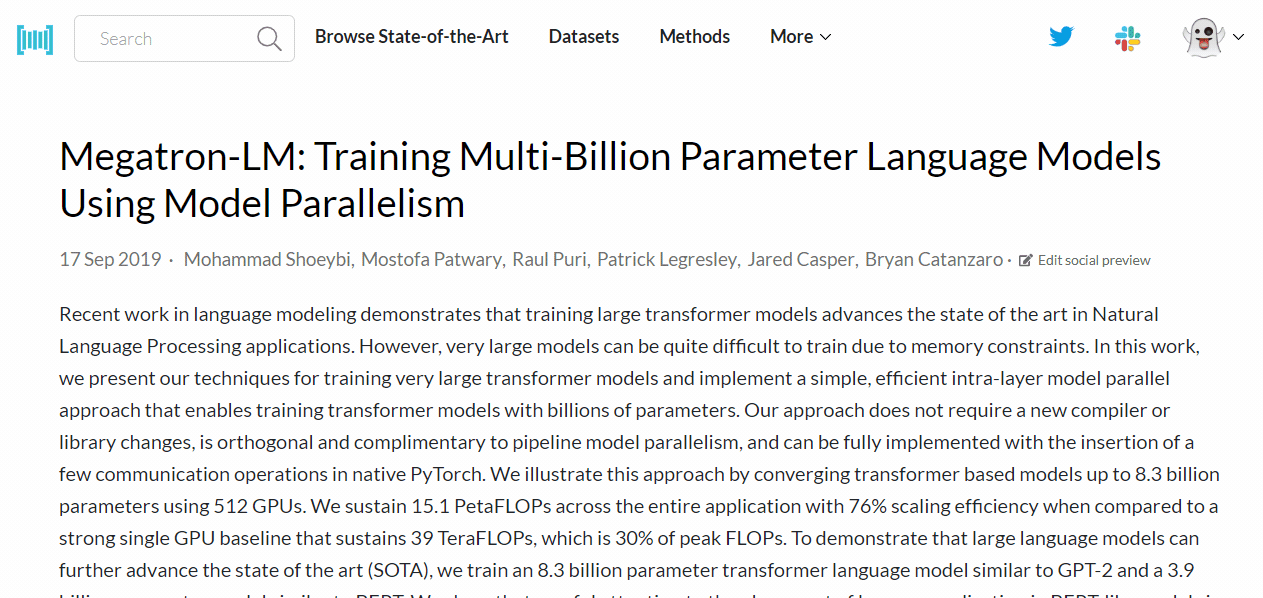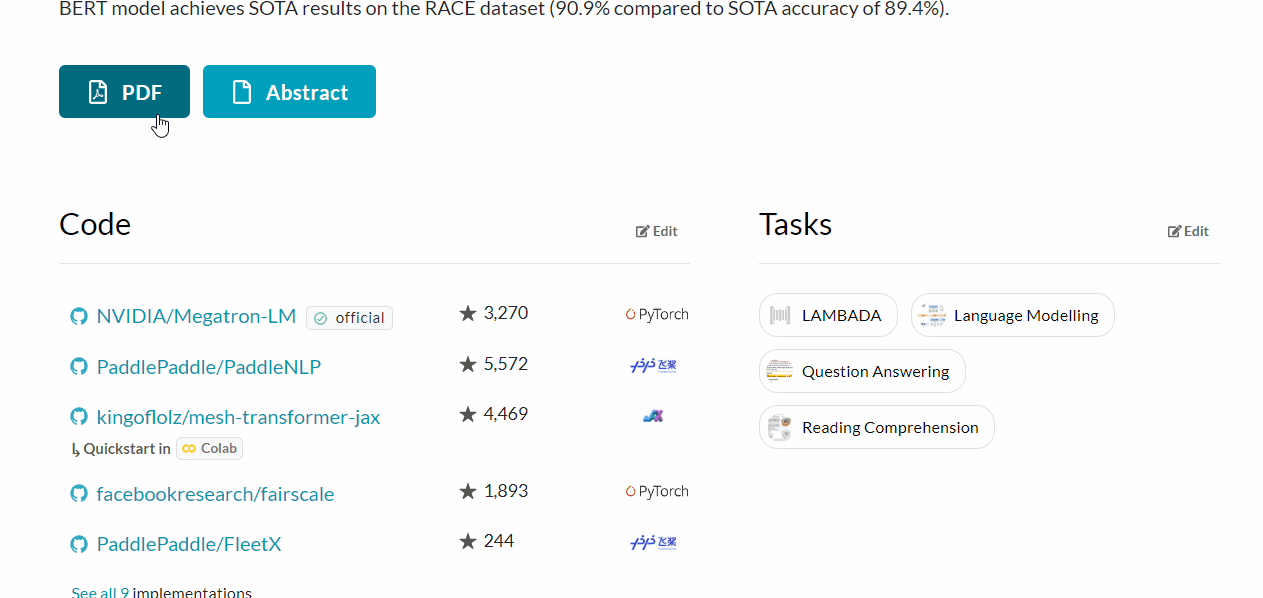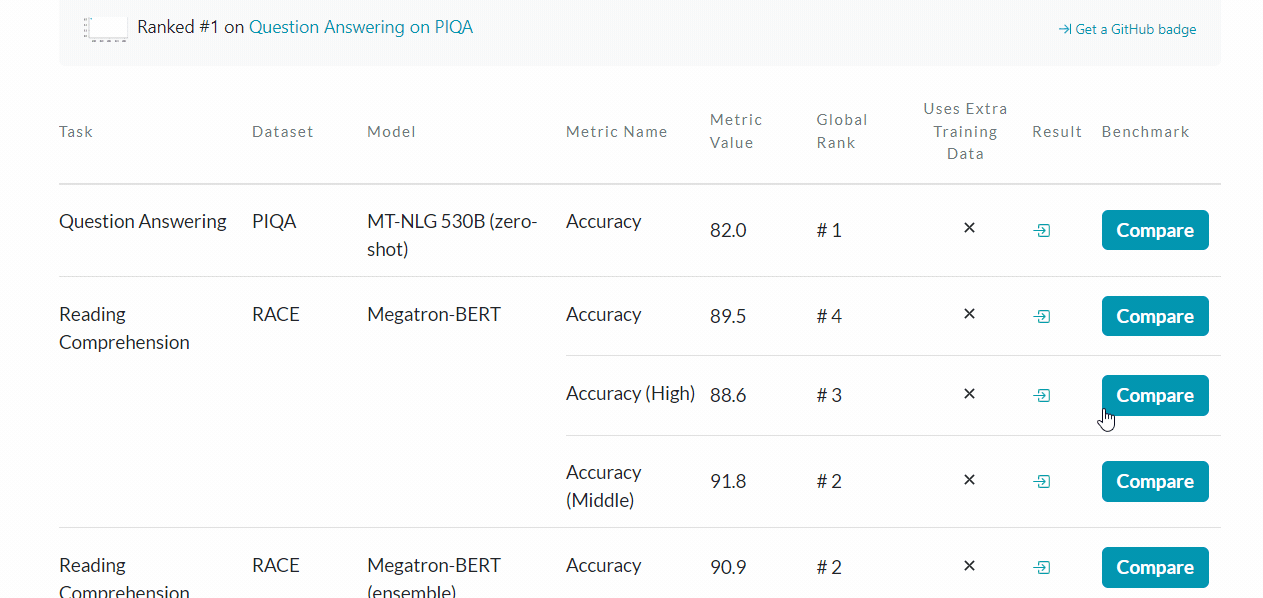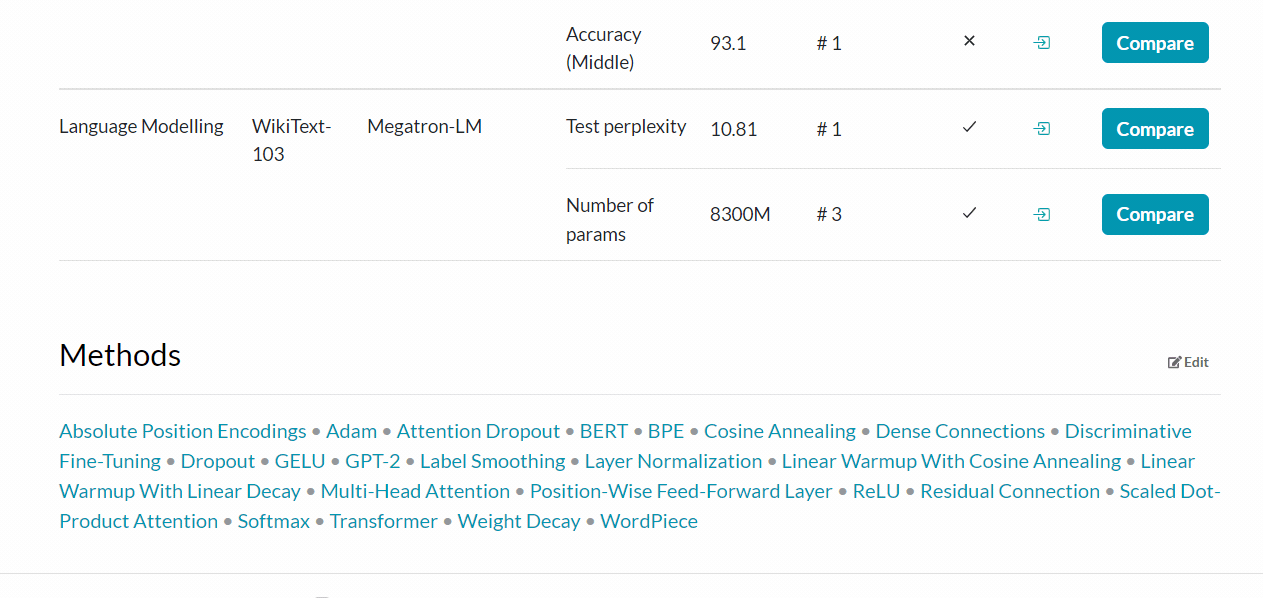
Papers With Code | Paper
No topo da página do artigo, você vê o título, autores, data e o resumo. Em seguida, há o botão PDF, que leva ao artigo completo, e o botão Abstract, que direciona para a página do arXiv.
Além disso, a página de um artigo traz 5 seções:
Ler um artigo no Papers With Code é simples e interativo. Em vez de baixar e ler tudo, você aprende quase tudo pelos tags, implementações de código, tarefas e resultados.
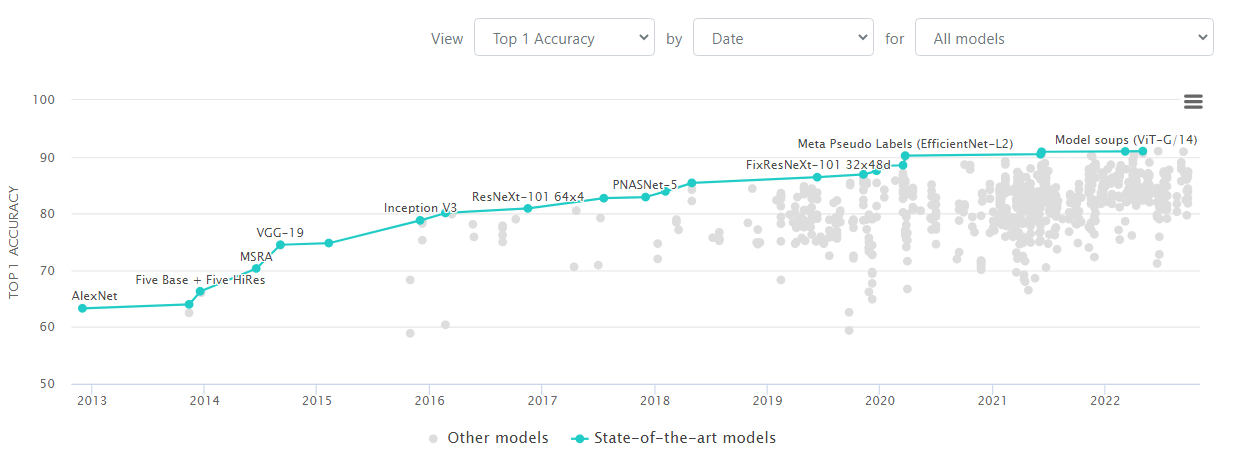
Papers With Code | Leaderboard de classificação de imagens no ImageNet
No gráfico acima, as linhas e pontos em verde-azulado representam os modelos de classificação de imagens com desempenho de ponta no dataset ImageNet. Os pontos cinza são modelos com desempenho inferior em determinado período.
Todo o ecossistema do Papers With Code gira em torno de leaderboards e destaca as pesquisas de ponta. Na página inicial, você vê o que está em alta por estrelas e popularidade. Cada aba valoriza datasets, implementações de código, metodologias e artigos mais relevantes.
A visão por trás de leaderboards, tendências e benchmarks é promover a qualidade da pesquisa. Assim, empurramos os limites do machine learning todos os dias para alcançar o estado da arte.
Abaixo estão algumas dicas valiosas para usar o Papers With Code e potencializar sua pesquisa:
Os desenvolvedores estão sempre lançando novidades para melhorar a experiência. Se você tem algo para compartilhar ou sugestões de recursos, fale com eles no Twitter ou Slack.
O Papers With Code reúne pessoas de diferentes áreas. O site é mantido pela Meta AI, mas quem faz acontecer é a comunidade. A abertura para contribuir promove inclusão — um fator essencial para o crescimento acelerado de machine learning e inteligência artificial.
Neste blog, vimos a importância de uma plataforma interativa e conectada como o Papers With Code. Também exploramos seus principais recursos e dicas para otimizar a pesquisa.
O Paper With Code é excelente para encontrar artigos, código, datasets e benchmarks de machine learning. É um dos melhores pontos de partida para seu projeto de conclusão. Mesmo que você esteja começando, pode se inscrever na trilha de carreira Machine Learning Scientist with Python ou em R para iniciar sua jornada profissional.
Se você quer ideias de projetos de machine learning para praticar, confira nosso blog com sugestões para todos os níveis.
Cursos de machine learning
Curso
Curso
Curso
blog
Abid Ali Awan
15 min
blog
Yolanda Ferreiro
7 min
blog
Natassha Selvaraj
15 min
blog
Matt Crabtree
14 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Javier Canales Luna
7 min