
想象一下,您在 Google 上搜索某篇机器学习研究论文。您找到了一些有趣的内容,接着想查看其代码实现、数据集和结果。您可能要花上好几个小时分别去找。现在再想象一下,您为了论文或研究项目还要这样重复 30 次。这简直是场噩梦。
Papers With Code 可以帮您摆脱困境。它让阅读研究论文变得更轻松,您可以快速浏览摘要、代码实现、结果和数据集。此外,您还可以利用排行榜功能,在同一主题下对比不同模型的架构与结果。
它远不止是搜索一篇研究论文。您可以通过在各类任务、子任务、模型、数据集和方法上使用标签来筛选搜索结果,从而深入探索某个主题。
在本文中,我们将介绍 Papers With Code 的各项关键功能,并学习开展机器学习项目研究的最佳方式。
Papers With Code 关键功能
在首页,您将看到按每小时新增星标数量排序的热门研究论文。
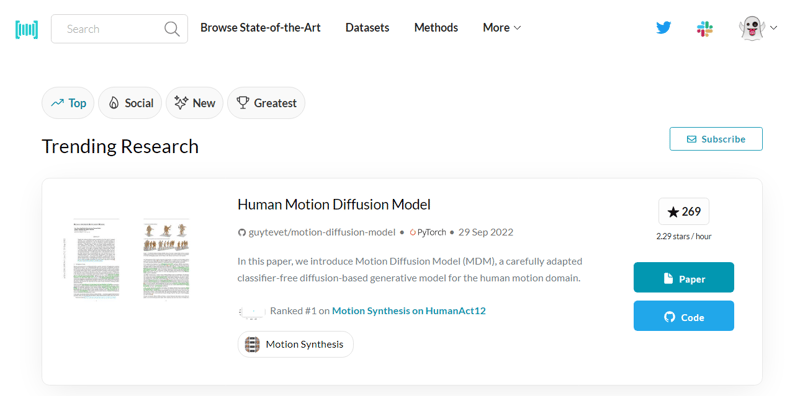
Papers With Code | 热门
如果您喜欢某篇论文,点击Paper按钮即可阅读摘要并查看结果、数据集和各类代码实现。或者,如果您更关注实现细节,可以点击Code访问 GitHub 仓库,其中包含结果、代码实现和依赖。
热门页面类似于社交媒体的首页。您可以不断向下滚动,查看过去上过热榜、拥有 1000+ 星标及多项社区贡献实现的论文。
Papers With Code 是一个由社区驱动的平台,帮助大家了解机器学习领域的最新前沿论文。它为开源贡献者、机器学习工程师、数据科学家、研究人员和学生提供了一个完整的生态,便于分享想法并推动机器学习的发展。
Papers With Code 上的所有内容都采用 CC-BY-SA 开放许可,任何人都可以通过“Edit”按钮进行贡献。
浏览最新前沿
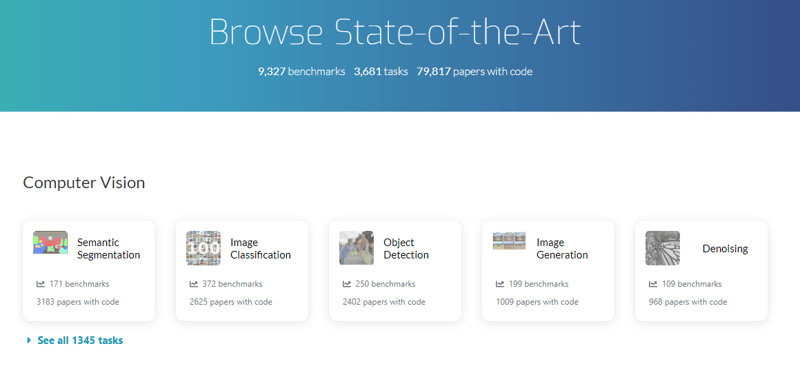
Papers With Code | 浏览最新前沿
点击Browse State-of-the-Art标签,您将看到按不同机器学习研究方向划分的类别和子类别。例如:
- 计算机视觉
- 自然语言处理
- 医疗
- 杂项
- 方法论
- 时间序列
- 图
- 语音
- 推理
- 游戏对弈
- 计算机代码
- 音频
- 对抗
- 机器人
- 知识库
- 知识库
- 音乐
上述每个类别都包含子类别。点击某个子类别卡片后,您会看到该子类别的简要定义和基准。
Browse State-of-the-Art部分的主要目的,是向您提供在给定数据集上表现最佳的模型、常用库、数据集列表、子任务以及最常被实现的论文等信息。此外,您还能在同一数据集上比较各类模型的性能指标。
如果您想了解机器学习的各个类别,欢迎访问我们的机器学习课程页面。该页面涵盖了适合初学者的课程、使用 Python 和 R 的机器学习课程,以及基于项目的课程。您还可以查看常用模板、教程和备忘单。
数据集
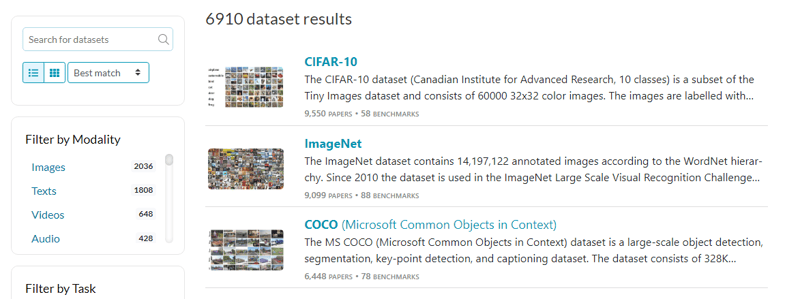
Papers With Code | 数据集
除了按照类别和子类别浏览,您也可以直接搜索特定数据集,或使用多种筛选条件来查找数据集。
总体而言,网站内容是相互关联的,您不必逐个去找数据集。不过,如果您的研究需要在某个特定机器学习问题上使用多个数据集,Dataset标签可以通过搜索和筛选功能帮助您找到任何热门数据集。您可以基于模态、任务和语言来筛选数据集。
点击某个具体数据集后,精彩之处就开始了。您会看到多个交互式板块,例如:
- 样例图像:数据集中各类图像的集合
- 使用情况:每年使用该数据集的论文数量
- 基准:基于该数据集,在某项任务上的最佳模型排名。
- 许可证:许可证名称及链接
- 模态:带链接的各类模态标签
- 语言:NLP 数据集会展示自然语言的标签。
- 论文:使用该数据集的优秀研究论文列表,包含代码、结果、日期以及仓库的星标数量。
- 数据集加载器:将数据集下载并加载到 TensorFlow、PyTorch、Jax 等各类机器学习框架中。
- 任务:如图像生成、图分类、随机优化等机器学习任务标签。
- 相似数据集:基于任务和模态的相似数据集列表。
简而言之,Dataset 标签与网站的其他部分深度整合,为深入开展研究提供了流畅的用户体验。
您也可以前往 DataCamp 的Datasets版块下载各类数据集。此外,您只需一键即可免费启动云端 Jupyter Notebook。
方法
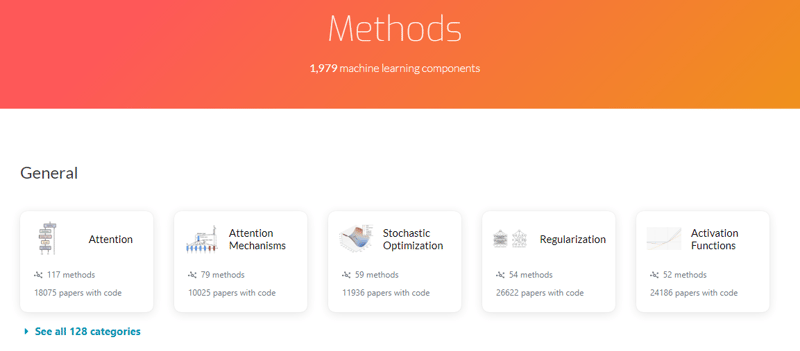
Papers With Code | 方法
Methods标签与Browse State-of-the-Art标签类似。它以展示卡片的形式呈现类别与子类别。Methods 标签面向希望了解特定机器学习方法论的研究者,例如词嵌入、图像特征提取和激活函数等。
它包含 7 大类别:
- 通用:注意力、注意力机制、随机优化。
- 计算机视觉:卷积神经网络、图像模型模块、生成式模型。
- 自然语言处理:语言模型、Transformer、注意力模式。
- 强化学习:策略梯度方法、Q 学习网络、分布式强化学习。
- 音频:音频模型模块、文本转语音模型、语音分离模型。
- 序列:循环神经网络、时间卷积、时间序列分析。
- 图:图嵌入、图表示学习、图数据增强。
点击任意方法卡片,您将看到定义、示意图和 Methods 板块。以 Attention 方法卡为例,您会看到多头注意力、缩放点积注意力、固定分解注意力等所有注意力方法。每种方法都会展示发表年份以及采用该方法的论文数量。
点击Multi-Head Attention方法后,您会进入一个页面,其中包含公式概要、可下载的论文 PDF 和源码。页面还包含 Papers、Tasks、Usage Over Time、Components 和 Categories 等板块。
这是学习机器学习方法的有趣途径,因为一切都围绕提升研究者体验而优化。
研究论文

Papers With Code | 论文
在论文页面顶部,您将看到标题、作者姓名、日期和摘要。其后是PDF按钮(跳转至论文全文)和Abstract按钮(跳转至 arxiv.org 的摘要页面)。
此外,一篇论文通常包含 5 个板块:
- Code:您将看到官方代码实现以及多项带有应用演示的社区贡献。
- Tasks:包含各类机器学习任务。例如语言模型和问答。
- Datasets:论文中使用的数据集列表。
- Results from the Paper:模型在不同数据集、任务及同一模型不同版本上的表现。同时展示全球排名、结果对比和指标数值。
- Methods:论文中用于达到最新前沿结果的方法列表。
在 Papers With Code 上阅读论文既轻松又具互动性。您无需下载并阅读全文,只需通过阅读标签、代码实现、任务和结果,就能学到几乎所有关键信息。
排行榜
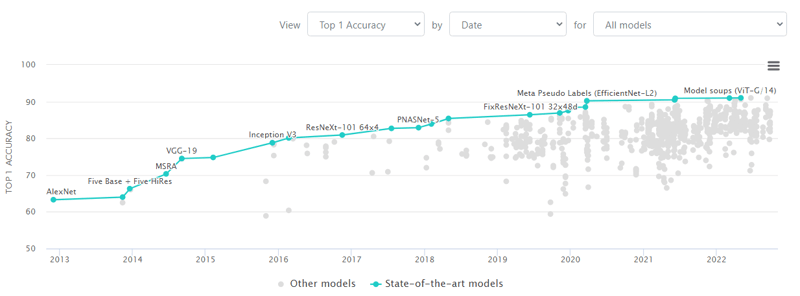
Papers With Code | ImageNet 图像分类排行榜
如上图所示,青色线条和点代表了在 ImageNet 数据集上的最新前沿图像分类模型。灰色点表示在特定时期内表现较低的图像分类模型。
Papers With Code 的整个生态都围绕排行榜展开,将最新前沿研究推至顶部。在首页,您会看到基于星标数和热度的热门研究。每个标签页都会展示热门数据集、代码实现、最佳方法论和研究论文。
设置排行榜、趋势和基准的整体愿景是提升研究质量。通过这种方式,我们每天都在推动机器学习的边界,力求达到最新前沿的水平。
Papers With Code 使用贴士
下面是一些在 Papers With Code 平台上开展研究并优化项目的实用建议:
- 如果您在为机器学习研究选题发愁,请查看热门页面。
- 如果您已经确定了主题,正在寻找论文、代码实现和数据集,请查看Browse State-of-the-Art页面。
- Methods页面适合希望改进方法论(如损失函数和激活函数)的机器学习工程师。
- Datasets页面适合正在寻找针对特定机器学习任务的清洗且标准化数据集的数据科学家。
- 学术界和业界研究人员可以使用该平台添加有关数据集、模型、任务、代码、已发表论文和结果的信息。
- 在 GitHub 仓库的 README.md 文件中添加官方的最新前沿徽章。
- 您可以使用API Client,通过 Python 对象读取和写入更改。您还可以镜像您的竞赛并在排行榜上展示结果。
- Portal页面允许您访问计算机科学、物理学、天文学、数学和统计学方面的论文。其他学科的论文也会附带代码实现链接,您可以据此复现实验结果。
开发者们一直在不断加入新功能以提升用户体验。如果您有新想法或功能需求,可以通过 Twitter 或 Slack 与他们联系。
结语
Papers With Code 平台汇聚了来自不同背景的智慧。网站由 Meta AI 维护,但由社区共同运营。对外开放的贡献机制带来了包容性,而这正是机器学习和人工智能行业快速增长的关键因素之一。
在本文中,我们了解了名为 Papers With Code 的互动、互联平台的重要性,也认识了网站的关键功能以及优化研究的实用贴士。
Paper With Code 非常适合查找机器学习研究论文、代码、数据集和基准。这是开启毕业设计的最佳去处之一。即使您是该领域的新手,也可以报名Python 机器学习科学家或R职业路径,开启您的职业旅程。
如果您正在寻找可动手实践的机器学习项目,不妨查看我们的详细博文,里面为各个水平的学习者提供了灵感。