Curso
Machine learning con modelos basados en árboles en Python
5 h
118.7K
Imagina que buscas en Google un artículo de investigación concreto sobre machine learning. Encuentras algo interesante y quieres ver la implementación del código, el conjunto de datos y los resultados. Te pasarás horas buscándolos por separado. Ahora imagina repetir este proceso 30 veces más para tu tesis o proyecto de investigación. Puede ser una pesadilla.
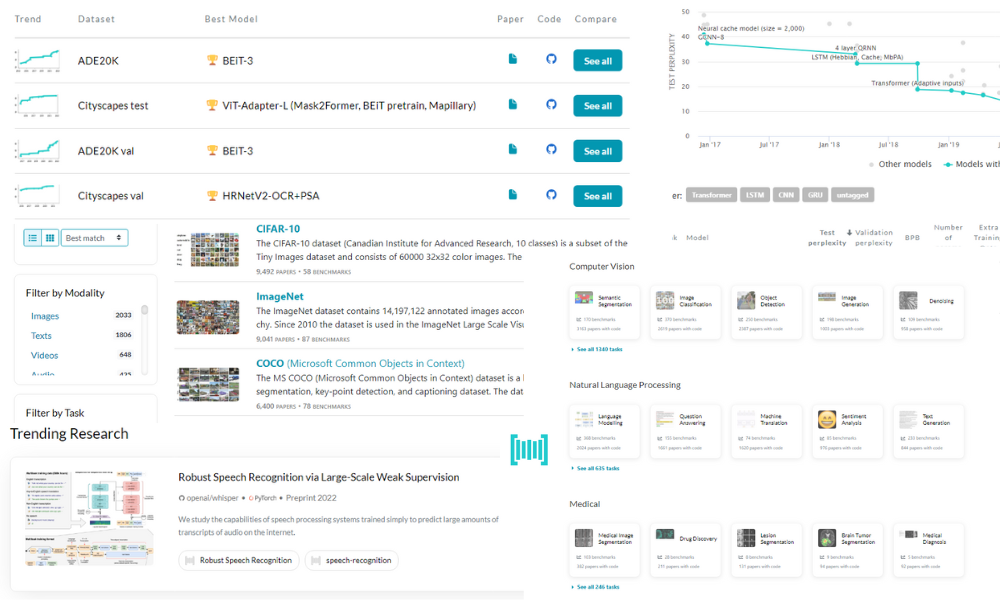
Papers With Code te lo pone fácil. Hace mucho más sencillo leer artículos: te ofrece de un vistazo el resumen, la implementación en código, los resultados y el dataset. Además, puedes comparar los resultados de arquitecturas de distintos modelos sobre un mismo tema con el panel de clasificación (leaderboard).
Es mucho más que buscar artículos. Puedes filtrar con etiquetas por tareas, subtareas, modelos, datasets y métodos para profundizar en el tema.
En este blog, exploraremos las funciones clave de Papers With Code y veremos la mejor manera de investigar para proyectos de machine learning.
En la página de inicio verás los artículos en tendencia según el número de estrellas por hora.
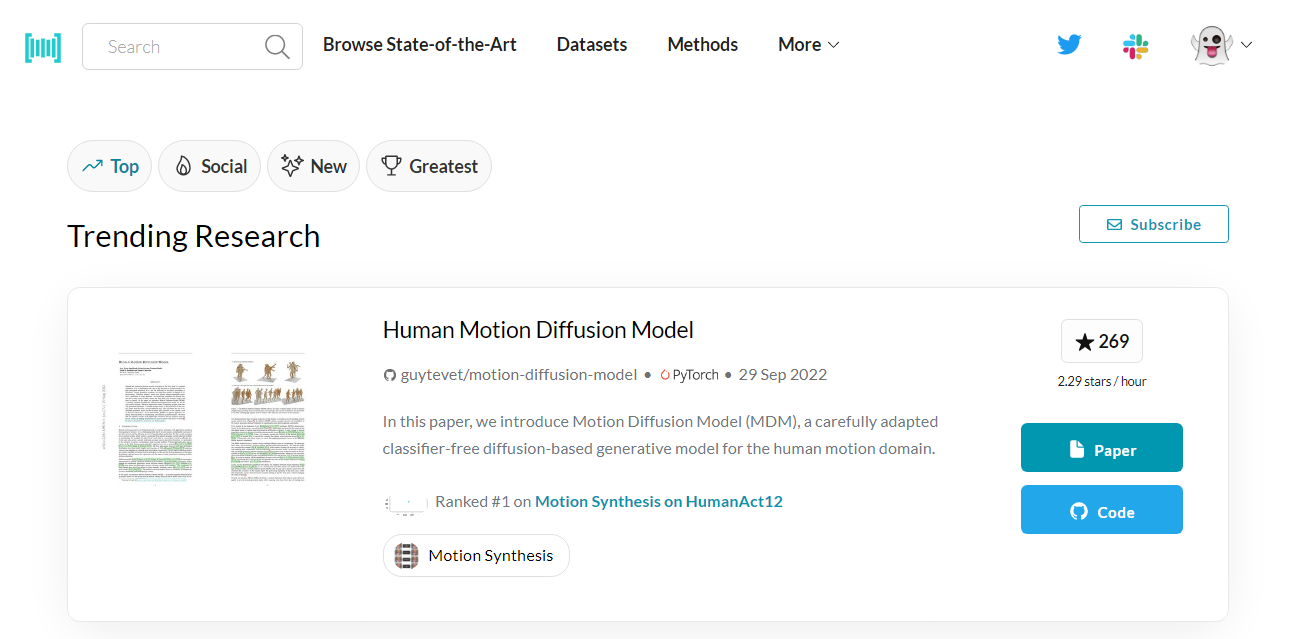
Papers With Code | Tendencias
Si te gusta un artículo, haz clic en el botón Paper para leer el abstract y ver resultados, datasets y distintas implementaciones de código. O, si te interesa la implementación, puedes hacer clic en Code y acceder al repositorio de GitHub con resultados, implementaciones y dependencias.
La página de tendencias se parece a la de cualquier red social: puedes seguir desplazándote para ver artículos anteriores con más de 1000 estrellas y múltiples implementaciones aportadas por la comunidad.
Papers With Code es una plataforma impulsada por la comunidad para conocer artículos de última generación en machine learning. Ofrece un ecosistema completo para contribuidores open source, ingenieros de machine learning, data scientists, investigadores y estudiantes, facilitando compartir ideas y acelerar el desarrollo en ML.
Todo el contenido de Papers With Code tiene licencia abierta CC-BY-SA, y cualquiera puede contribuir con los botones "Edit".
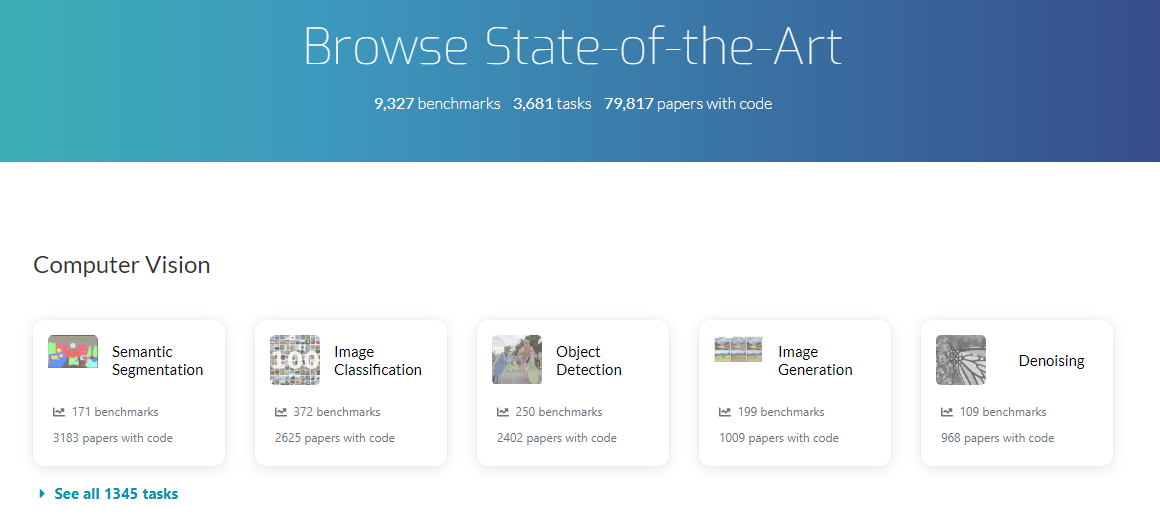
Papers With Code | Explorar el estado del arte
Al hacer clic en la pestaña Browse State-of-the-Art, verás categorías y subcategorías por áreas de estudio de machine learning. Por ejemplo:
Cada categoría tiene subcategorías. Al hacer clic en una subcategoría, verás una breve definición y el benchmark.
El objetivo principal de la sección Browse State-of-the-Art es darte información sobre los mejores modelos en un dataset concreto, las bibliotecas populares, el listado de datasets, subtareas y los artículos más implementados. Además, puedes comparar métricas de rendimiento de varios modelos en el mismo dataset.
Si quieres aprender sobre distintas categorías de machine learning, visita nuestra página de Machine Learning Courses. Incluye cursos para principiantes, ML con Python y R, y cursos basados en proyectos. También puedes consultar plantillas, tutoriales y chuletas populares.
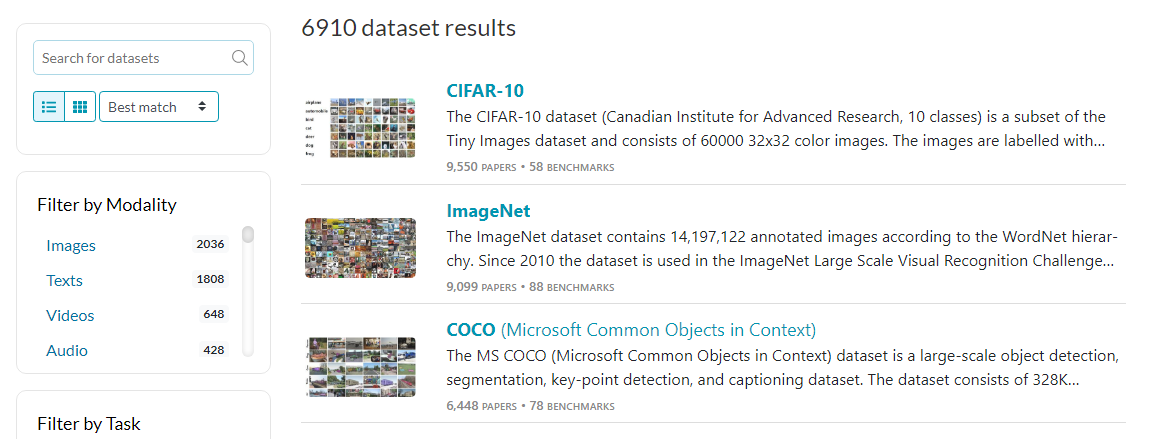
Papers With Code | Datasets
En lugar de categorías y subcategorías, puedes buscar un dataset concreto o usar filtros para encontrarlo.
En general, el sitio está interconectado y no necesitas buscar datasets uno a uno. Pero si tu investigación requiere múltiples datasets sobre un problema específico de ML, la pestaña Dataset te ayudará a encontrar cualquier dataset popular con búsqueda y filtros. Puedes filtrarlos por modalidad, tareas e idiomas.
La parte interesante comienza al entrar en un dataset concreto. Encontrarás secciones interactivas como:
En resumen, la pestaña de Datasets está totalmente integrada con el resto del sitio para ofrecer una experiencia fluida al investigar en profundidad.
También puedes visitar la sección Datasets en DataCamp para descargar distintos tipos de conjuntos de datos. Además, puedes abrir un Jupyter Notebook en la nube gratis con un solo clic.
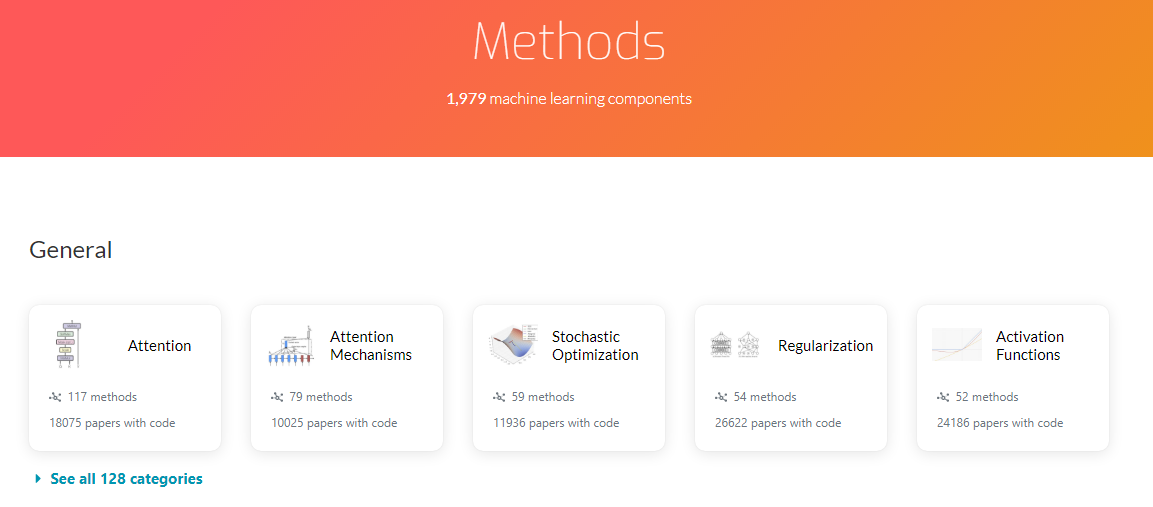
Papers With Code | Methods
La pestaña Methods es similar a Browse State-of-the-Art. Presenta categorías y subcategorías en tarjetas. Está pensada para quienes quieren conocer metodologías específicas de ML. Por ejemplo, word embeddings, extracción de características de imagen y funciones de activación.
Incluye 7 categorías:
Al entrar en cualquier método, verás la definición, un diagrama y la sección de Methods. En el caso de la tarjeta de Atención (Attention), verás Multi-Head Attention, Scaled Dot-Product Attention, Fixed Factorized Attention y todos los métodos de Attention. Cada método muestra el año de publicación y cuántos artículos lo utilizan.
Tras hacer clic en Multi-Head Attention, accederás a una página con el resumen de la ecuación, el PDF descargable del paper y el código fuente. También verás las secciones Papers, Tasks, Usage Over Time, Components y Categories.
Es una forma amena de aprender métodos de ML, ya que todo está optimizado para mejorar la experiencia de investigación.
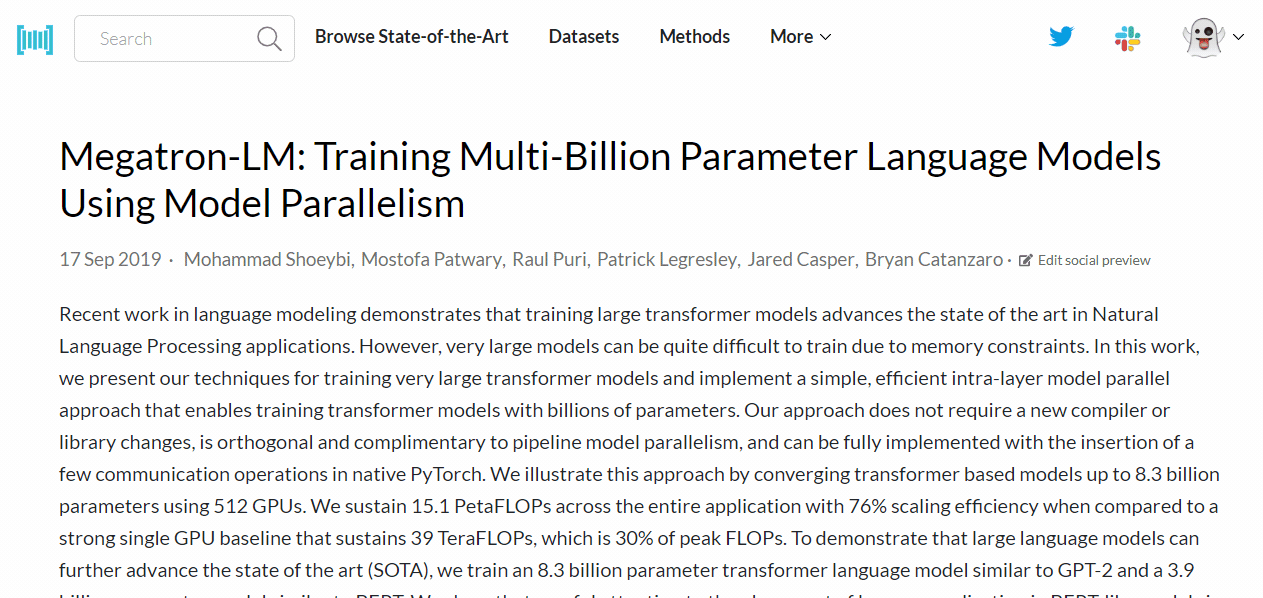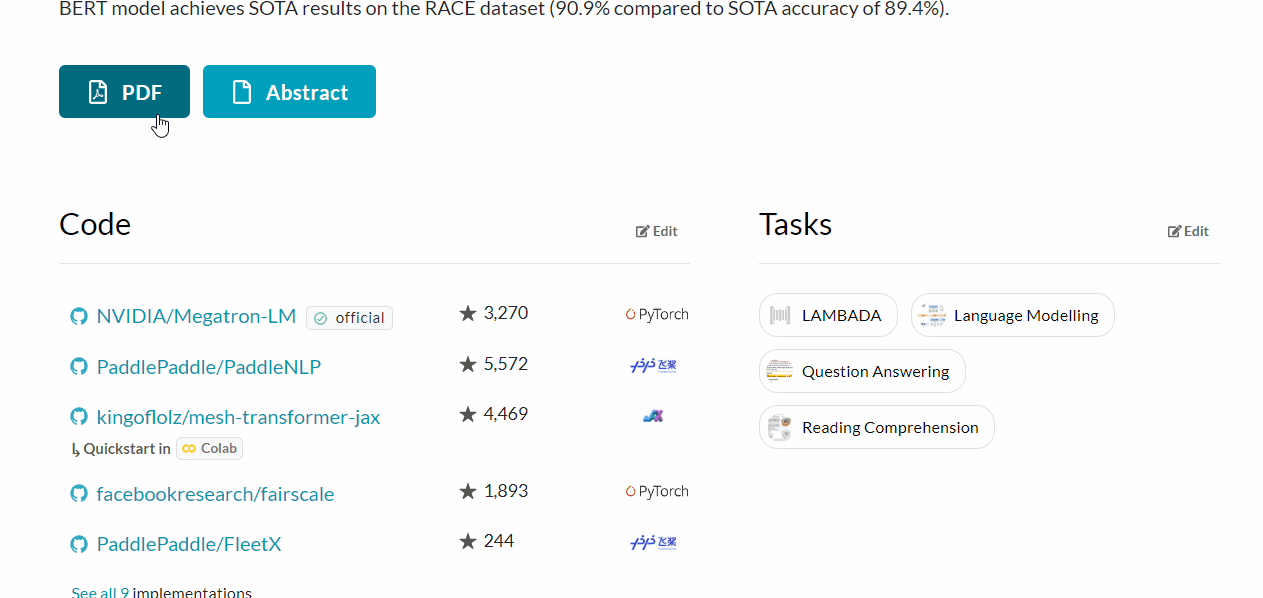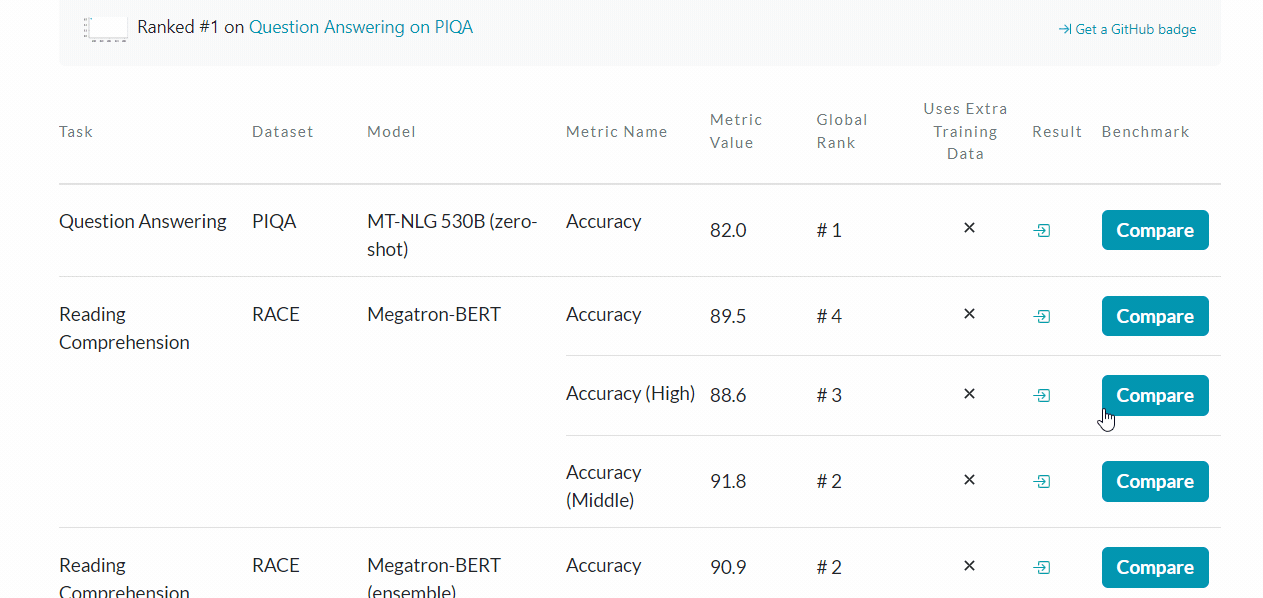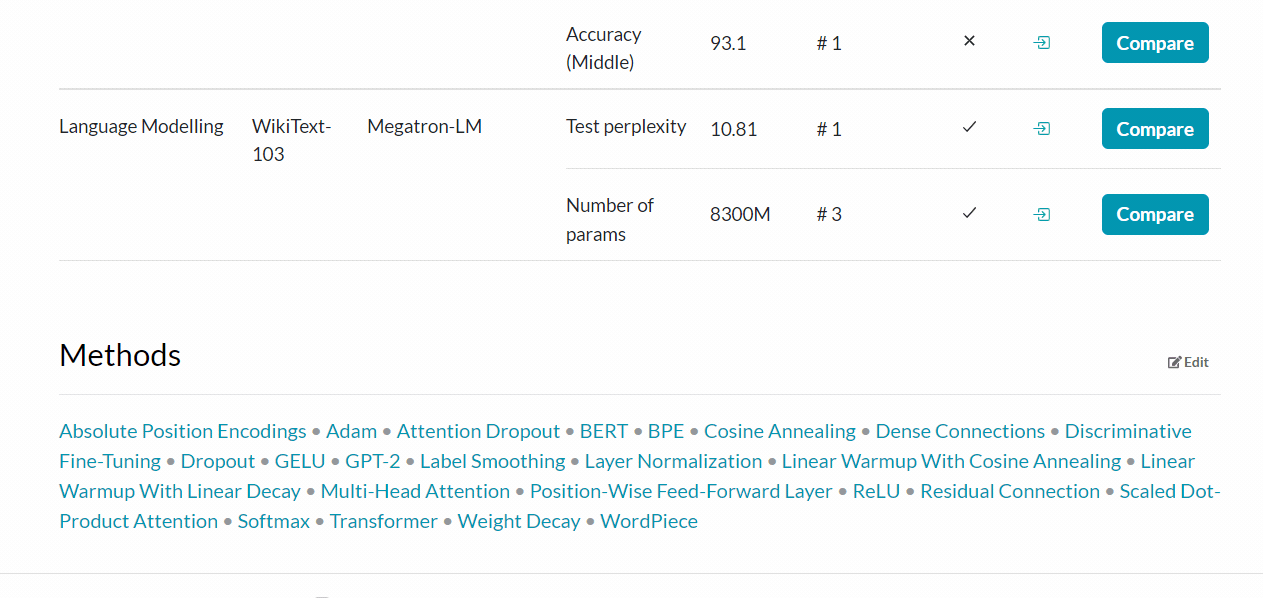
Papers With Code | Paper
En la parte superior de la página del artículo verás el título, el nombre de los autores, la fecha y el abstract. A continuación, encontrarás el botón PDF, que te lleva al artículo completo, y el botón Abstract, que te lleva a la página del abstract en arxiv.org.
Además, un artículo incluye 5 secciones:
Leer un artículo en Papers With Code es fácil e interactivo. En lugar de descargar y leer el paper completo, puedes aprender casi todo revisando etiquetas, implementaciones de código, tareas y resultados.
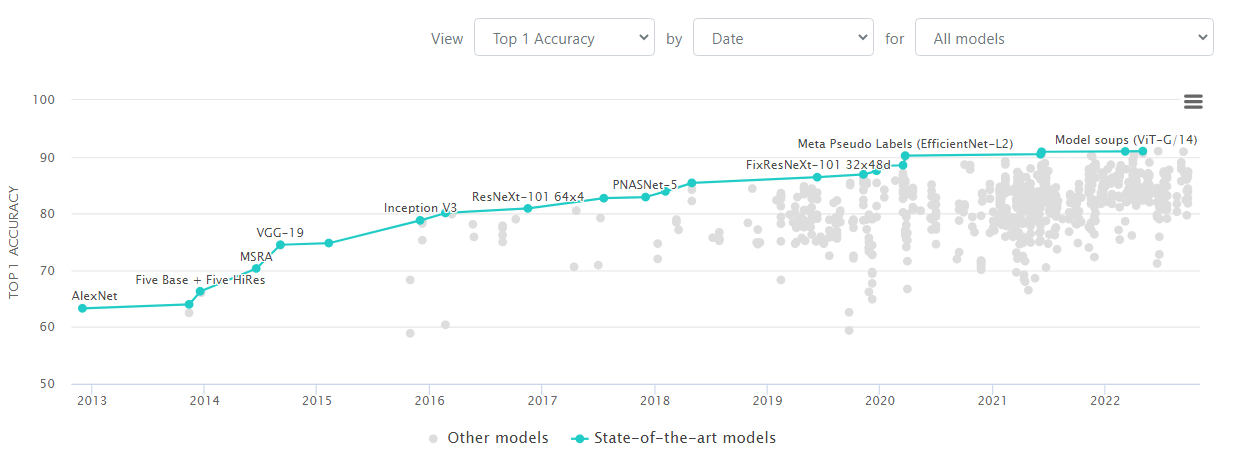
Papers With Code | Clasificación en ImageNet para clasificación de imágenes
En la imagen superior, las líneas y puntos en color verde azulado representan el modelo de clasificación de imágenes de referencia en el dataset ImageNet. Los puntos grises son modelos de menor rendimiento en un periodo concreto.
Todo el ecosistema de Papers With Code gira en torno a un leaderboard y promociona la investigación de vanguardia en la parte superior. En la portada verás lo que está en tendencia según estrellas y popularidad. Cada pestaña destaca datasets populares, implementaciones de código y las mejores metodologías y artículos.
La visión detrás de los leaderboards, tendencias y benchmarks es impulsar la calidad de la investigación. Así, cada día llevamos más lejos los límites del machine learning para alcanzar el estado del arte.
A continuación encontrarás algunos consejos para usar Papers With Code y optimizar tu proyecto de investigación:
Los desarrolladores añaden continuamente funciones para mejorar la experiencia. Si quieres proponer algo nuevo o pedir funcionalidades, puedes contactarles por Twitter o Slack.
La plataforma Papers With Code reúne a mentes de distintos ámbitos. El sitio lo mantiene Meta AI, pero lo impulsa la comunidad. La apertura a contribuir fomenta la inclusión, un factor clave en el rápido crecimiento de la industria del machine learning y la inteligencia artificial.
En este blog hemos visto la importancia de una plataforma interactiva e interconectada como Papers With Code. También hemos repasado sus funciones clave y consejos para optimizar la investigación.
Papers With Code es ideal para encontrar artículos de ML, código, datasets y benchmarks. Es uno de los mejores lugares para iniciar tu proyecto de fin de grado. Aunque estés empezando, puedes apuntarte al itinerario profesional Machine Learning Scientist with Python o al de R para comenzar tu carrera profesional.
Si buscas proyectos de machine learning en los que trabajar, consulta nuestro artículo con ideas para todos los niveles.
Cursos de machine learning
Curso
Curso
Curso
blog
Zoumana Keita
14 min
blog
Abid Ali Awan
15 min
blog
Javier Canales Luna
8 min
blog
Natassha Selvaraj
15 min
blog
Abid Ali Awan
10 min
Tutorial
Joanne Xiong
11 min