Cours
Machine learning avec des modèles arborescents en Python
5 h
118.8K
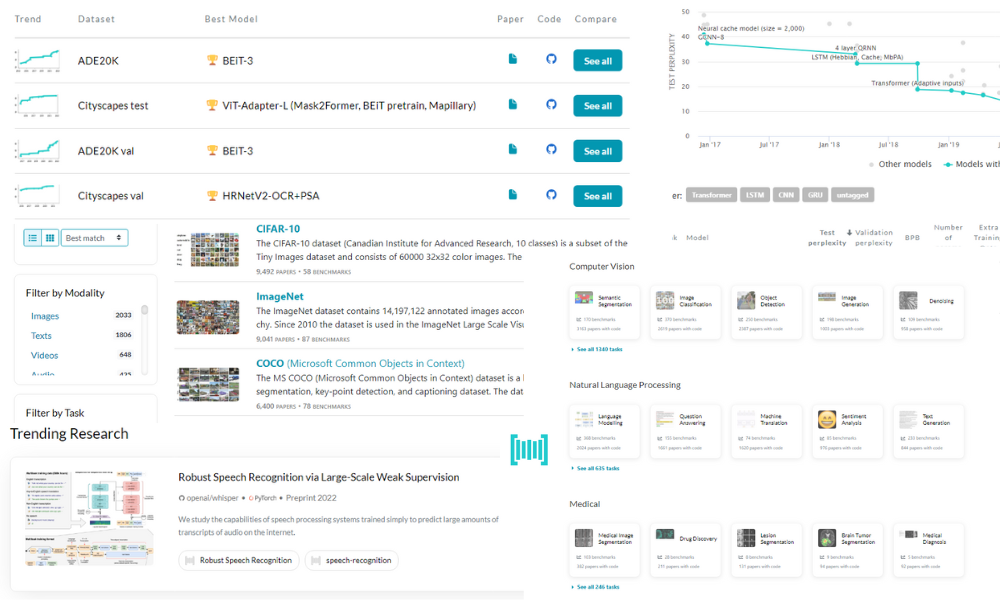
Imaginez chercher sur Google un article de recherche en apprentissage automatique bien précis. Vous trouvez un papier intéressant et souhaitez consulter son code, le jeu de données et les résultats. Vous risquez d'y passer des heures à tout retrouver séparément. Et maintenant, imaginez devoir répéter l'exercice 30 fois pour votre mémoire ou votre projet de recherche. Le cauchemar.
Papers With Code change la donne. La plateforme facilite grandement la lecture des articles : un coup d’œil suffit pour voir le résumé, les implémentations de code, les résultats et les jeux de données. Vous pouvez en plus comparer les performances de différentes architectures de modèles sur un même sujet grâce au classement (leaderboard).
C’est bien plus qu’un simple moteur de recherche d’articles : vous filtrez par étiquettes, tâches, sous-tâches, modèles, jeux de données et méthodes pour explorer un thème en profondeur.
Dans cet article, nous allons passer en revue les fonctionnalités clés de Papers With Code et voir comment mener au mieux vos recherches pour des projets en apprentissage automatique.
Sur la page d'accueil, vous trouverez les articles de recherche qui montent en puissance, mesurés au nombre d’étoiles par heure.
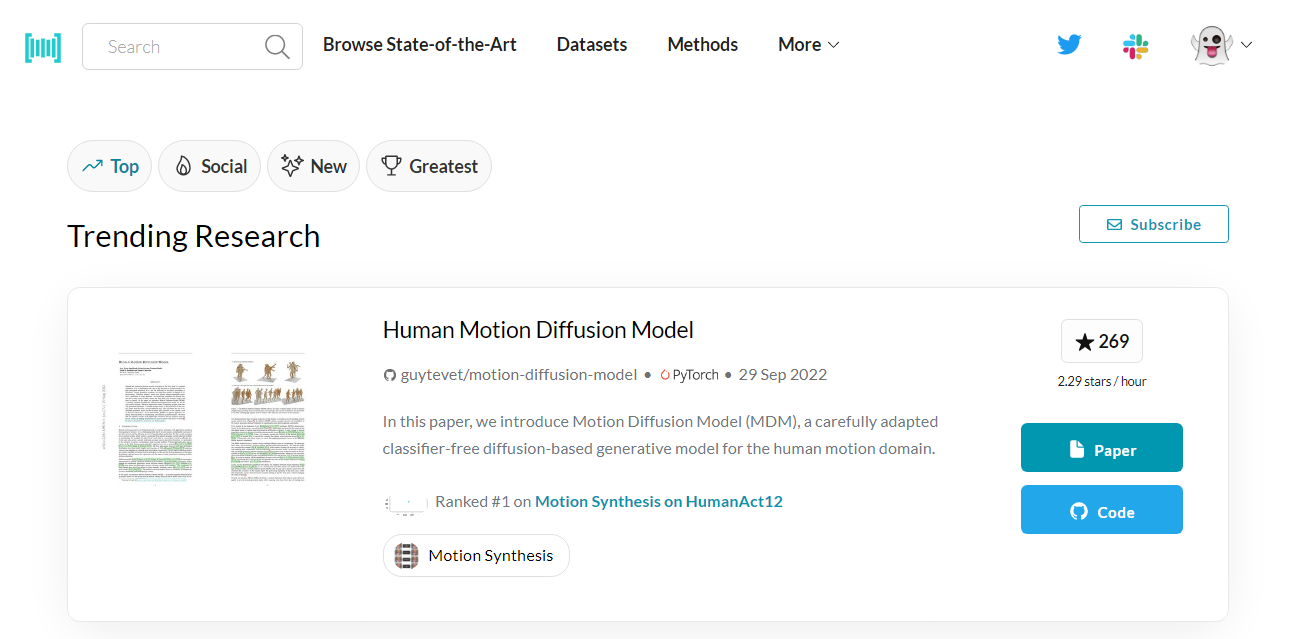
Papers With Code | Tendance
Si un article vous plaît, cliquez sur le bouton Paper pour lire le résumé et voir les résultats, jeux de données et implémentations de code. Si vous cherchez directement l’implémentation, cliquez sur Code pour accéder au dépôt GitHub avec les résultats, le code et les dépendances.
La page des tendances rappelle le fil d’actualité d’un réseau social : faites défiler pour retrouver les articles populaires passés, avec 1 000 étoiles et plus, et de multiples implémentations issues de la communauté.
Papers With Code est une plateforme animée par la communauté pour suivre l’état de l’art en apprentissage automatique. Elle offre un écosystème complet pour les contributeurs open source, ingénieurs en machine learning, data scientists, chercheurs et étudiants, afin de partager des idées et accélérer les avancées.
Tous les contenus de Papers With Code sont sous licence ouverte CC-BY-SA, et chacun peut contribuer via les boutons « Edit ».
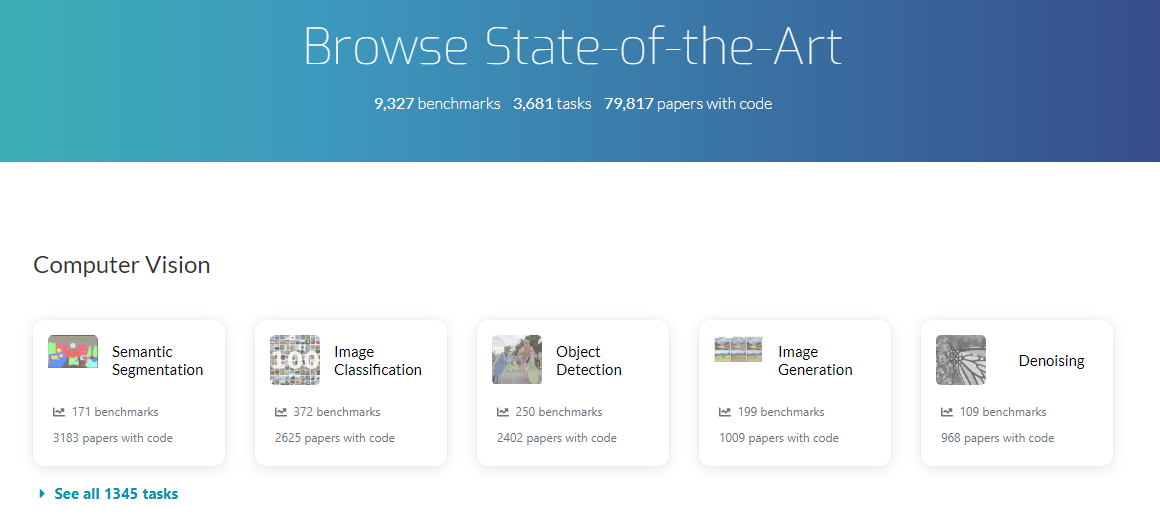
Papers With Code | Parcourir l’état de l’art
En cliquant sur l’onglet Browse State-of-the-Art, vous accédez aux catégories et sous-catégories couvrant différents domaines de l’apprentissage automatique. Par exemple :
Chaque catégorie comprend des sous-catégories. En cliquant sur une carte de sous-catégorie, vous accédez à une définition succincte et aux benchmarks associés.
L’objectif principal de la section Browse State-of-the-Art est de vous donner les informations sur les meilleurs modèles pour un jeu de données donné, les bibliothèques populaires, la liste des jeux de données, les sous-tâches et les articles les plus implémentés. Vous pouvez également comparer les métriques de performance de différents modèles sur un même jeu de données.
Pour approfondir vos connaissances sur les différentes catégories du machine learning, consultez notre page Machine Learning Courses. Elle regroupe des cours pour débutants, du machine learning avec Python et R, ainsi que des cours par projets. Vous y trouverez également des templates, tutoriels et fiches mémo populaires.
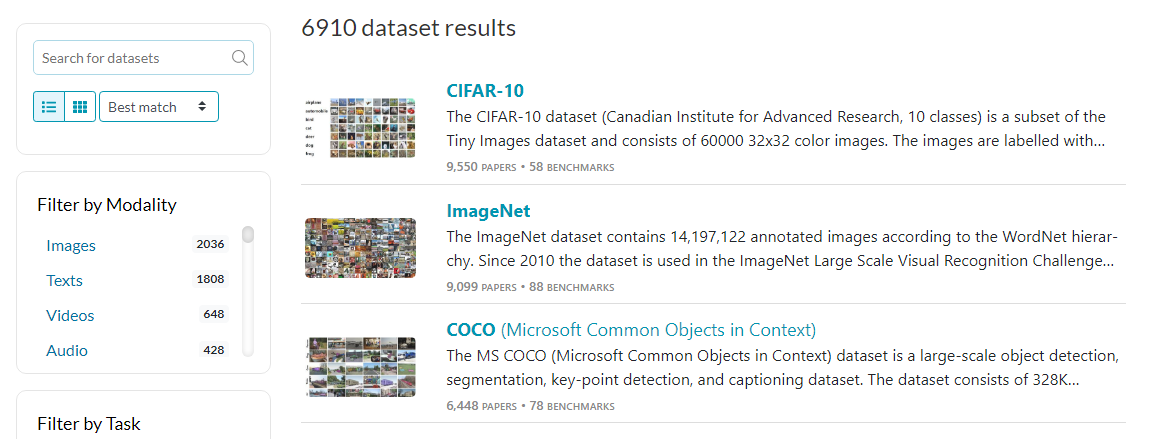
Papers With Code | Datasets
Au lieu de parcourir par catégories et sous-catégories, vous pouvez chercher un jeu de données précis ou utiliser des filtres pour le trouver.
De manière générale, le site est interconnecté : vous n’avez pas besoin de tout chercher manuellement. Mais si votre recherche exige plusieurs jeux de données autour d’un même problème de machine learning, l’onglet Dataset vous aide à repérer rapidement les jeux de données populaires via la recherche et les filtres. Vous pouvez filtrer par modalité, tâches et langues.
Le plus intéressant commence quand vous ouvrez la page d’un jeu de données : vous y trouverez des sections interactives comme :
En bref, l’onglet Dataset est pleinement intégré au reste du site pour offrir une expérience fluide et propice à une recherche approfondie.
Vous pouvez aussi consulter la rubrique Datasets sur DataCamp pour télécharger différents types de jeux de données. Et vous lancer gratuitement en un clic dans un Jupyter Notebook dans le cloud.
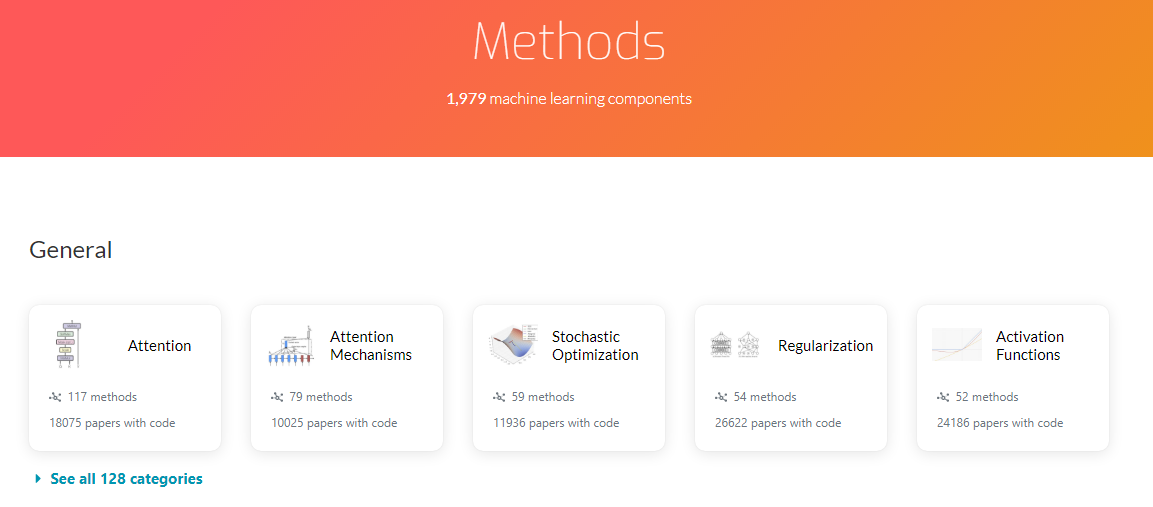
Papers With Code | Methods
L’onglet Methods fonctionne comme Browse State-of-the-Art : catégories et sous-catégories présentées sous forme de cartes. Il s’adresse aux chercheurs qui souhaitent approfondir des méthodologies précises de machine learning : Word Embedding, extraction de caractéristiques d’images, fonctions d’activation, etc.
On y trouve 7 catégories :
En cliquant sur une carte, vous trouverez une définition, un schéma et une section Méthodes. Pour la carte Attention, par exemple : Multi-Head Attention, Scaled Dot-Product Attention, Fixed Factorized Attention, etc. Chaque méthode indique l’année de parution et le nombre d’articles qui l’utilisent.
Après avoir ouvert la méthode Multi-Head Attention, vous accédez à une page avec un résumé de l’équation, un PDF téléchargeable et le code source. Vous y verrez aussi les sections Papers, Tasks, Usage Over Time, Components et Categories.
Apprendre les méthodes de machine learning devient ludique : tout est conçu pour optimiser l’expérience du chercheur.
Papers With Code | Paper
En haut de la page d’un article, vous trouverez le titre, le nom des auteurs, la date et le résumé. Viennent ensuite le bouton PDF pour accéder au papier complet et le bouton Abstract qui renvoie à la page de résumé sur arxiv.org.
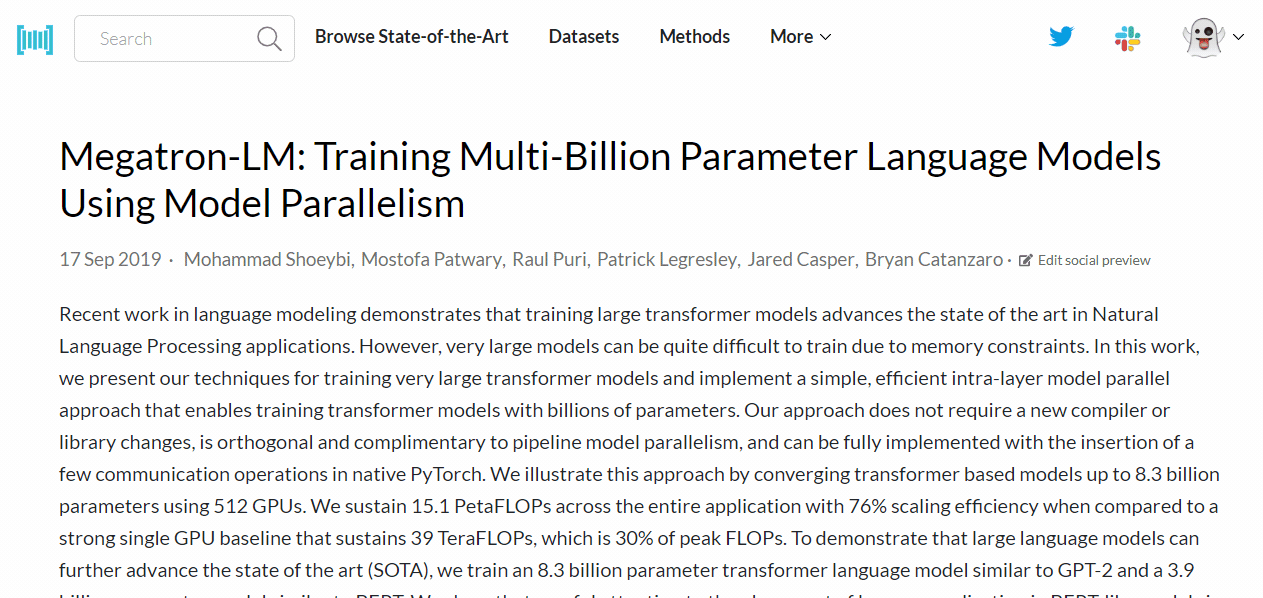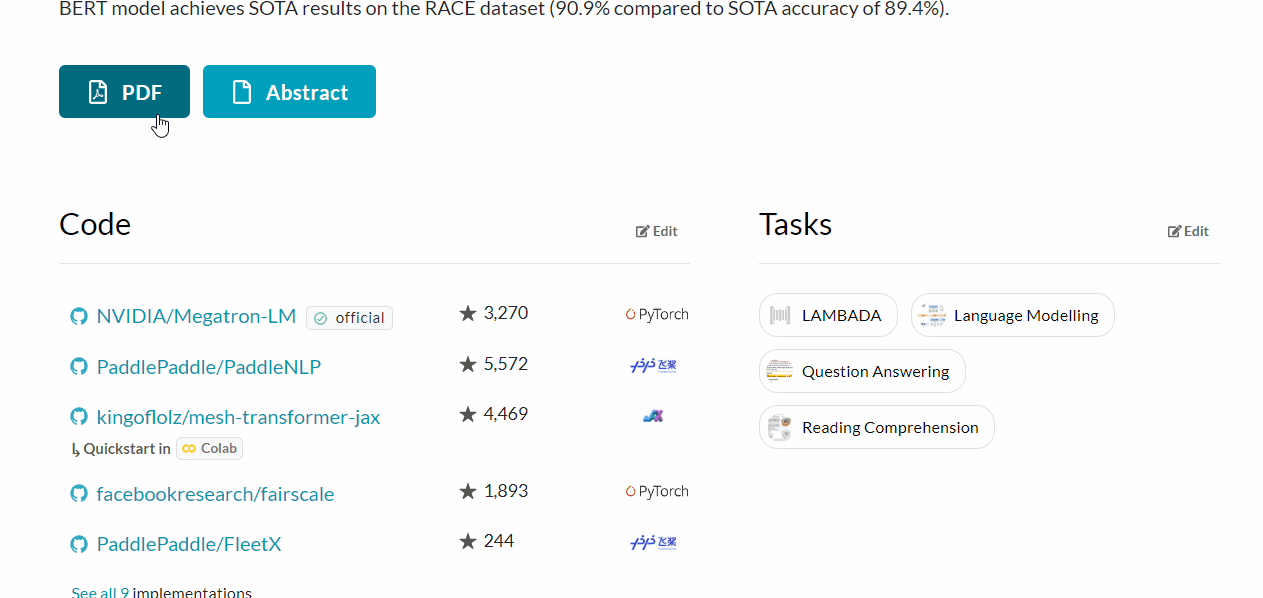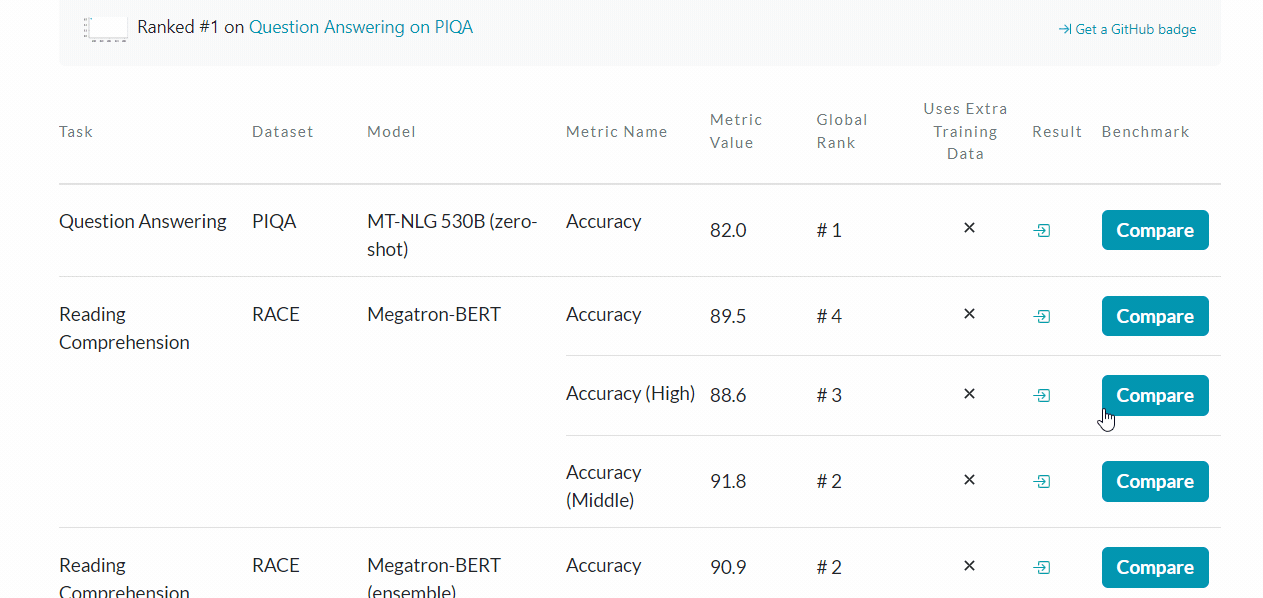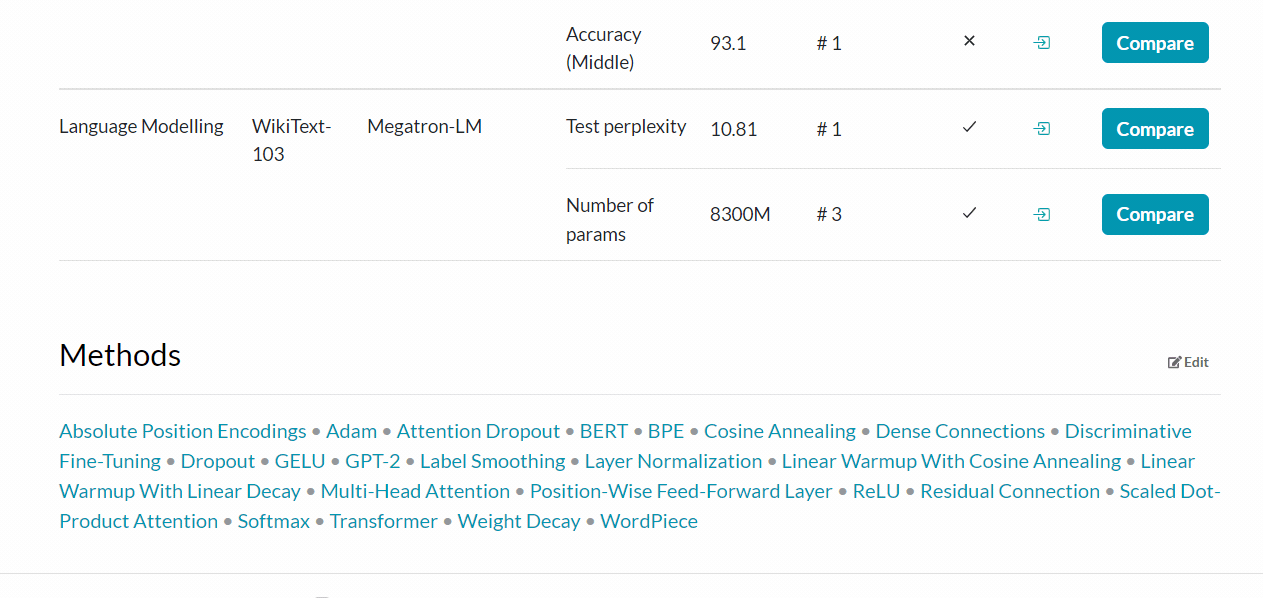
Un article est ensuite structuré en 5 sections :
Lire un article sur Papers With Code est simple et interactif. Sans télécharger l’intégralité du papier, vous apprenez l’essentiel via les étiquettes, le code, les tâches et les résultats.
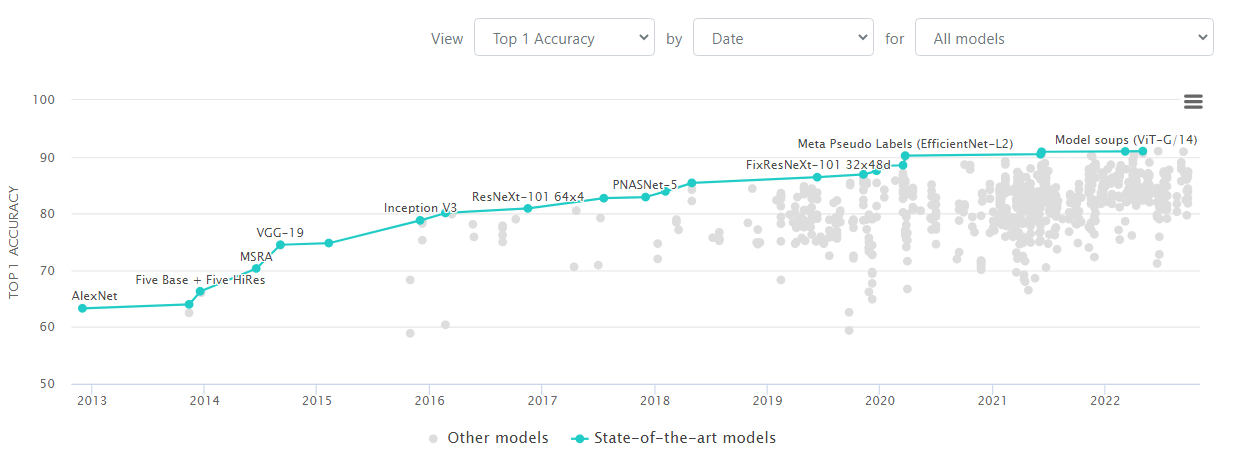
Papers With Code | Classement pour la classification d'images sur ImageNet
Sur l’image ci-dessus, les lignes et points turquoise représentent les meilleurs modèles de classification d’images sur le jeu de données ImageNet. Les points gris indiquent des modèles moins performants à une période donnée.
Tout l’écosystème de Papers With Code s’articule autour des leaderboards pour mettre en avant l’état de l’art. En page d’accueil, vous verrez les articles tendance selon les étoiles et la popularité. Chaque onglet met à l’honneur les jeux de données, les implémentations de code, les meilleures méthodologies et les articles de référence.
La vision derrière ces classements, tendances et benchmarks : promouvoir la qualité de la recherche. Jour après jour, cela fait progresser les frontières du machine learning pour atteindre l’état de l’art.
Voici quelques conseils pratiques pour tirer le meilleur parti de Papers With Code et optimiser votre projet de recherche :
Les développeurs ajoutent régulièrement de nouvelles fonctionnalités pour améliorer l’expérience. Si vous avez des idées ou des demandes, contactez-les sur Twitter ou Slack.
La plateforme Papers With Code réunit des talents de tous horizons. Le site est maintenu par Meta AI, mais animé par la communauté. Cette ouverture à la contribution favorise l’inclusivité : un facteur clé dans la croissance rapide de l’apprentissage automatique et de l’intelligence artificielle.
Dans cet article, nous avons vu l’intérêt d’une plateforme à la fois interactive et interconnectée comme Papers With Code, ses fonctionnalités clés, et des conseils pour optimiser vos recherches.
Papers With Code est idéal pour les articles de machine learning, le code, les jeux de données et les benchmarks. C’est l’un des meilleurs points de départ pour un projet de fin d’études. Même si vous débutez, inscrivez-vous au Machine Learning Scientist with Python ou au parcours R pour lancer votre carrière.
Si vous cherchez des projets de machine learning sur lesquels travailler, consultez notre article détaillé avec des idées pour tous les niveaux.
Cours de machine learning
Cours
Cours
Cours