
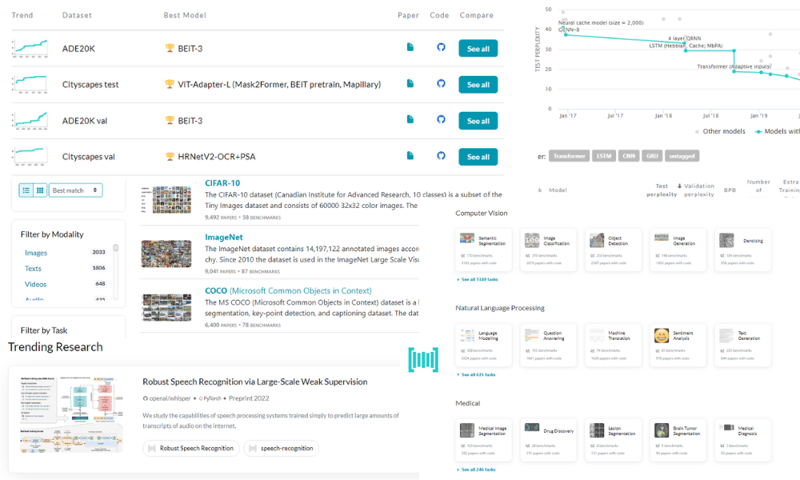
Hãy tưởng tượng bạn tìm kiếm một bài báo nghiên cứu về học máy cụ thể trên Google. Bạn thấy điều gì đó thú vị và muốn xem mã triển khai, bộ dữ liệu và kết quả. Bạn sẽ phải mất hàng giờ để tìm từng thứ một. Giờ hãy tưởng tượng bạn phải lặp lại bước này thêm 30 lần nữa cho luận văn hoặc dự án nghiên cứu. Đó thật sự có thể là một cơn ác mộng.
Papers With Code sẽ hỗ trợ bạn. Nền tảng này giúp việc đọc các bài báo nghiên cứu trở nên dễ dàng hơn nhiều, cho phép bạn lướt nhanh tóm tắt, mã triển khai, kết quả và bộ dữ liệu. Hơn nữa, bạn có thể so sánh kết quả kiến trúc của các mô hình khác nhau trên cùng một chủ đề bằng tính năng bảng xếp hạng.
Nó còn hơn cả việc tìm kiếm một bài báo nghiên cứu. Bạn có thể lọc tìm kiếm bằng thẻ theo nhiều tác vụ, tác vụ con, mô hình, bộ dữ liệu và phương pháp để khám phá chủ đề một cách chuyên sâu.
Trong bài viết này, chúng ta sẽ khám phá các tính năng chính của Papers With Code và học cách tốt nhất để tiến hành nghiên cứu cho các dự án học máy.
Các tính năng chính của Papers With Code
Trên trang chủ, bạn sẽ thấy các bài báo nghiên cứu đang thịnh hành dựa trên số lượt gắn sao mỗi giờ.
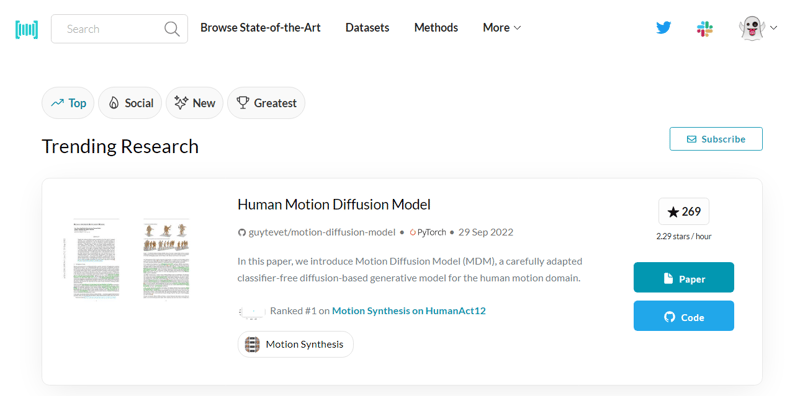
Papers With Code | Xu hướng
Nếu bạn thích bài báo nghiên cứu, hãy nhấp vào nút Paper để đọc tóm tắt và xem kết quả, bộ dữ liệu, cùng các mã triển khai khác nhau. Hoặc nếu bạn quan tâm đến phần triển khai, bạn có thể nhấp vào Code để truy cập kho GitHub bao gồm kết quả, mã triển khai và các phụ thuộc.
Trang xu hướng giống như trang chủ của bất kỳ mạng xã hội nào. Bạn có thể cuộn xuống để xem các bài báo từng thịnh hành trước đây với 1000+ sao và nhiều mã triển khai do cộng đồng đóng góp.
Papers With Code là một nền tảng do cộng đồng vận hành để học về các bài báo nghiên cứu tiên tiến nhất trong học máy. Nó cung cấp một hệ sinh thái hoàn chỉnh cho cộng tác viên nguồn mở, kỹ sư học máy, nhà khoa học dữ liệu, nhà nghiên cứu và sinh viên, giúp việc chia sẻ ý tưởng và thúc đẩy phát triển học máy trở nên dễ dàng.
Tất cả nội dung trên Papers With Code đều được cấp phép mở theo CC-BY-SA, và bất kỳ ai cũng có thể đóng góp bằng các nút “Edit”.
Duyệt State-of-the-Art
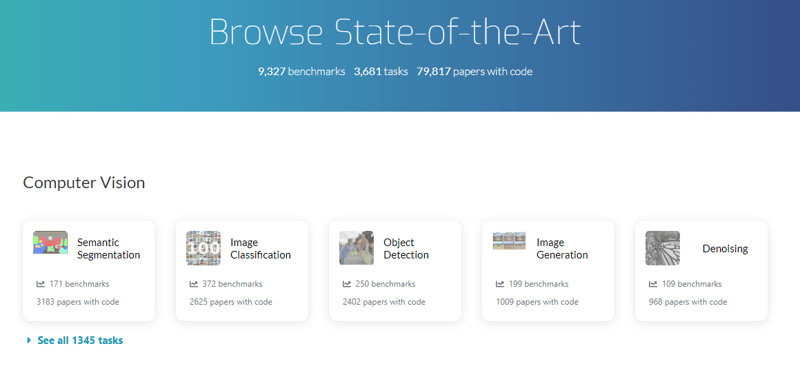
Papers With Code | Duyệt State-of-the-Art
Bằng cách nhấp vào thẻ Browse State-of-the-Art, bạn sẽ thấy các danh mục và danh mục con dựa trên nhiều lĩnh vực nghiên cứu của học máy. Ví dụ:
- Thị giác máy tính
- Xử lý ngôn ngữ tự nhiên
- Y học
- Khác
- Phương pháp luận
- Chuỗi thời gian
- Đồ thị
- Giọng nói
- Lý luận
- Chơi game
- Mã máy tính
- Âm thanh
- Đối kháng
- Robot
- Cơ sở tri thức
- Cơ sở tri thức
- Âm nhạc
Mỗi danh mục trên đều có các danh mục con. Và khi bạn nhấp vào một thẻ danh mục con, bạn sẽ thấy định nghĩa ngắn gọn về danh mục con đó và các chuẩn đánh giá (benchmark).
Mục đích chính của phần Browse State-of-the-Art là cung cấp thông tin về các mô hình đạt hiệu năng tốt nhất trên một bộ dữ liệu nhất định, thư viện phổ biến, danh sách bộ dữ liệu, tác vụ con và các bài báo được triển khai nhiều nhất. Hơn nữa, bạn có thể so sánh nhiều chỉ số hiệu năng mô hình trên cùng một bộ dữ liệu.
Nếu bạn muốn tìm hiểu về các danh mục khác nhau của học máy, hãy xem trang Khóa học Machine Learning của chúng tôi. Trang này bao gồm bộ sưu tập khóa học thân thiện với người mới bắt đầu, học máy với Python và R, cùng các khóa học dựa trên dự án. Bạn cũng có thể xem các mẫu, hướng dẫn và cheat sheet phổ biến.
Bộ dữ liệu
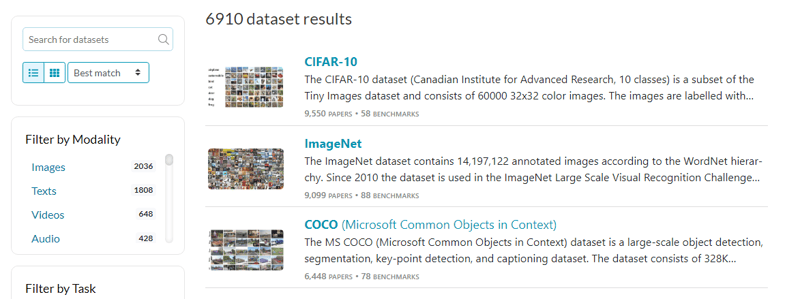
Papers With Code | Datasets
Thay vì danh mục và danh mục con, bạn có thể tìm kiếm một bộ dữ liệu cụ thể hoặc dùng nhiều bộ lọc để tìm bộ dữ liệu.
Nhìn chung, website được liên kết chặt chẽ, và bạn không cần tìm các bộ dữ liệu riêng lẻ. Tuy nhiên, nếu bạn đang làm nghiên cứu cần nhiều bộ dữ liệu cho một bài toán học máy cụ thể, thẻ Dataset sẽ giúp bạn tìm bất kỳ bộ dữ liệu phổ biến nào bằng tính năng tìm kiếm và lọc. Bạn có thể lọc bộ dữ liệu dựa trên phương thức (modality), tác vụ và ngôn ngữ.
Phần thú vị bắt đầu khi bạn nhấp vào một bộ dữ liệu cụ thể. Bạn sẽ thấy nhiều mục tương tác như:
- Hình ảnh mẫu: bộ sưu tập nhiều hình ảnh trong một bộ dữ liệu
- Mức độ sử dụng: số lượng bài báo mỗi năm đã sử dụng bộ dữ liệu
- Benchmark: xếp hạng mô hình đạt hiệu năng tốt nhất trên một tác vụ cụ thể bằng bộ dữ liệu.
- Giấy phép: tên và liên kết giấy phép
- Phương thức: các thẻ modality kèm liên kết
- Ngôn ngữ: với bộ dữ liệu NLP sẽ hiển thị các thẻ ngôn ngữ tự nhiên.
- Bài báo: danh sách các bài báo nghiên cứu hay nhất dùng bộ dữ liệu. Bao gồm mã, kết quả, ngày và số lượng sao của kho lưu trữ.
- Bộ nạp dữ liệu: tải xuống và nạp bộ dữ liệu vào các khung học máy như TensorFlow, PyTorch và Jax.
- Tác vụ: các thẻ tác vụ học máy như Sinh ảnh, Phân loại đồ thị và Tối ưu ngẫu nhiên.
- Bộ dữ liệu tương tự: danh sách các bộ dữ liệu tương tự dựa trên tác vụ và modality.
Tóm lại, thẻ Dataset được tích hợp đầy đủ với các phần khác của website để mang lại trải nghiệm mượt mà khi tiến hành nghiên cứu chuyên sâu.
Bạn cũng có thể xem mục Datasets trên DataCamp để tải xuống nhiều loại bộ dữ liệu khác nhau. Hơn nữa, bạn có thể khởi chạy Jupyter Notebook trên đám mây miễn phí chỉ với một cú nhấp.
Phương pháp
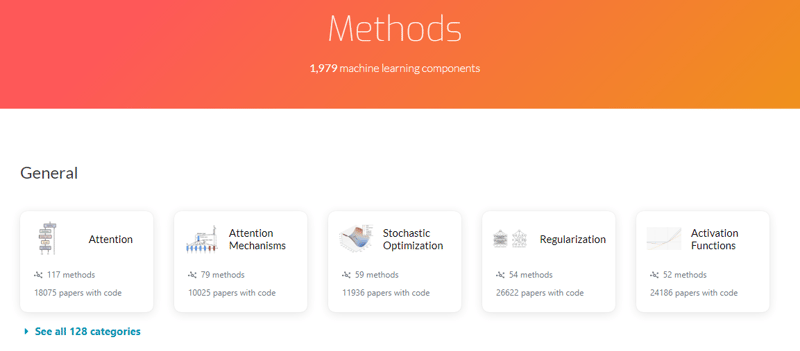
Papers With Code | Methods
Thẻ Methods tương tự thẻ Browse State-of-the-Art. Nó có các danh mục và danh mục con dưới dạng thẻ hiển thị. Thẻ Methods dành cho các nhà nghiên cứu muốn tìm hiểu về những phương pháp luận học máy cụ thể. Ví dụ: Word Embedding, Trích xuất đặc trưng ảnh và Hàm kích hoạt.
Nó gồm 7 danh mục:
- Chung: Attention, Cơ chế Attention, Tối ưu ngẫu nhiên.
- Thị giác máy tính: Mạng nơ-ron tích chập, Khối mô hình ảnh, Mô hình sinh.
- Xử lý ngôn ngữ tự nhiên: Mô hình ngôn ngữ, Transformers, Mẫu Attention.
- Học tăng cường: Phương pháp Gradient theo chính sách, Mạng Q-Learning, Học tăng cường phân tán.
- Âm thanh: Khối mô hình âm thanh, Mô hình chuyển văn bản thành giọng nói, Mô hình tách giọng nói.
- Tuần tự: Mạng nơ-ron hồi quy, Tích chập theo thời gian, Phân tích chuỗi thời gian.
- Đồ thị: Nhúng đồ thị, Học biểu diễn đồ thị, Tăng cường dữ liệu đồ thị.
Khi bạn nhấp vào bất kỳ thẻ phương pháp nào, bạn sẽ thấy định nghĩa, sơ đồ và phần Methods. Với thẻ phương pháp Attention, bạn sẽ thấy Multi-Head Attention, Scaled Dot-Product Attention, Fixed Factorized Attention và tất cả các phương pháp Attention. Mỗi phương pháp hiển thị thông tin về năm công bố và số lượng bài báo sử dụng phương pháp đó.
Sau khi nhấp vào phương pháp Multi-Head Attention, bạn sẽ thấy trang có phần tóm tắt phương trình, tệp PDF bài báo có thể tải xuống và mã nguồn. Bạn cũng sẽ thấy các phần Papers, Tasks, Usage Over Time, Components và Categories.
Đây là một cách thú vị để học về các phương pháp học máy, vì mọi thứ đều được tối ưu hóa nhằm cải thiện trải nghiệm của nhà nghiên cứu.
Bài báo nghiên cứu

Papers With Code | Paper
Ở đầu trang bài báo nghiên cứu, bạn sẽ thấy tiêu đề, tên tác giả, ngày và tóm tắt. Sau đó là nút PDF dẫn đến toàn bộ bài báo và nút Abstract dẫn đến trang tóm tắt trên arxiv.org.
Thêm vào đó, một bài báo nghiên cứu gồm 5 phần:
- Code: bạn sẽ thấy mã triển khai chính thức và nhiều đóng góp từ cộng đồng kèm các bản demo ứng dụng.
- Tasks: gồm nhiều tác vụ học máy. Ví dụ: mô hình ngôn ngữ và Hỏi đáp.
- Datasets: danh sách các bộ dữ liệu được sử dụng trong bài báo.
- Kết quả từ bài báo: hiệu năng mô hình trên nhiều bộ dữ liệu, tác vụ và phiên bản của cùng một mô hình. Nó cũng hiển thị xếp hạng toàn cầu, so sánh kết quả và giá trị chỉ số.
- Methods: danh sách các phương pháp được dùng trong bài để tạo ra kết quả state-of-the-art.
Đọc một bài báo nghiên cứu trên Papers With Code rất dễ và mang tính tương tác. Thay vì tải về và đọc toàn bộ, bạn có thể nắm gần như mọi thứ bằng cách đọc các thẻ, mã triển khai, tác vụ và kết quả.
Bảng xếp hạng
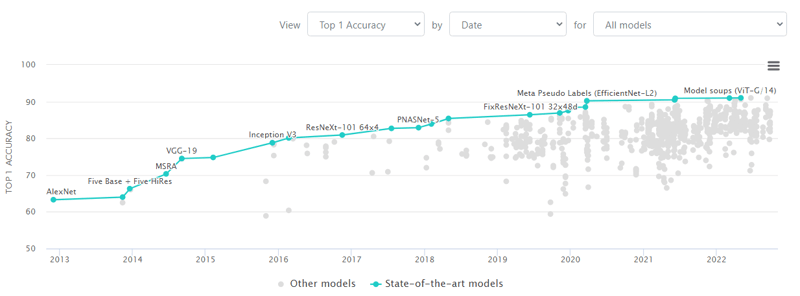
Papers With Code | Bảng xếp hạng phân loại ảnh trên ImageNet
Nếu bạn nhìn vào hình trên, các đường và điểm màu xanh đậm (teal) thể hiện những mô hình phân loại ảnh đạt state-of-the-art trên bộ dữ liệu Imagenet. Các điểm màu xám là những mô hình phân loại ảnh có hiệu năng thấp hơn trong một giai đoạn nhất định.
Toàn bộ hệ sinh thái của Papers With Code xoay quanh bảng xếp hạng và đưa những nghiên cứu state-of-the-art lên hàng đầu. Trên trang chủ, bạn sẽ thấy các nghiên cứu thịnh hành dựa trên số sao và mức độ phổ biến. Mỗi thẻ đều làm nổi bật các bộ dữ liệu phổ biến, mã triển khai, cũng như những phương pháp và bài báo tốt nhất.
Tầm nhìn đằng sau các bảng xếp hạng, xu hướng và chuẩn đánh giá là thúc đẩy chất lượng nghiên cứu. Bằng cách này, chúng ta đang mở rộng ranh giới học máy mỗi ngày để đạt tới trạng thái state-of-the-art.
Mẹo hữu ích khi dùng Papers With Code
Dưới đây là một số mẹo hữu ích để sử dụng nền tảng Papers With Code và tối ưu hóa dự án nghiên cứu của bạn:
- Nếu bạn đang gặp khó khăn trong việc tìm chủ đề nghiên cứu học máy, hãy xem trang xu hướng.
- Nếu bạn đã quyết định chủ đề và đang tìm bài báo, mã triển khai và bộ dữ liệu, hãy xem trang Browse State-of-the-Art.
- Trang Methods dành cho kỹ sư học máy đang tìm các phiên bản cải tiến của phương pháp như hàm mất mát và hàm kích hoạt.
- Trang Datasets dành cho nhà khoa học dữ liệu đang tìm các bộ dữ liệu đã được làm sạch và tiêu chuẩn hóa cho một tác vụ học máy cụ thể.
- Các nhà nghiên cứu học thuật và công nghiệp có thể dùng nền tảng để thêm thông tin về bộ dữ liệu, mô hình, tác vụ, mã, bài báo đã công bố và kết quả.
- Thêm huy hiệu state-of-the-art chính thức vào tệp README.md trên kho GitHub.
- Bạn có thể dùng API Client để đọc và ghi thay đổi bằng các đối tượng Python. Bạn cũng có thể mirror đối thủ của mình và hiển thị kết quả trên bảng xếp hạng.
- Trang Portal cho phép bạn truy cập các bài báo về Khoa học máy tính, Vật lý, Thiên văn học, Toán học và Thống kê. Các bài báo ở lĩnh vực khác đi kèm liên kết mã triển khai để bạn có thể theo dõi và tái tạo kết quả.
Các nhà phát triển luôn bổ sung tính năng mới để cải thiện trải nghiệm người dùng, và nếu bạn có điều gì mới để chia sẻ hoặc yêu cầu tính năng, bạn có thể liên hệ họ trên Twitter hoặc Slack.
Kết luận
Nền tảng Papers With Code quy tụ những bộ óc từ nhiều lĩnh vực khác nhau. Website do Meta AI duy trì, nhưng được vận hành bởi cộng đồng. Tính cởi mở trong việc đóng góp tạo ra sự bao hàm, yếu tố then chốt cho sự phát triển nhanh của ngành học máy và trí tuệ nhân tạo.
Trong bài viết này, chúng ta đã tìm hiểu về tầm quan trọng của một nền tảng tương tác và kết nối có tên Papers With Code. Chúng ta cũng đã khám phá các tính năng chính và mẹo để tối ưu hóa nghiên cứu.
Papers With Code rất hữu ích cho các bài báo nghiên cứu học máy, mã, bộ dữ liệu và chuẩn đánh giá. Đây là một trong những nơi tốt nhất để bắt đầu dự án năm cuối của bạn. Ngay cả khi bạn mới bước vào lĩnh vực này, bạn có thể đăng ký lộ trình sự nghiệp Machine Learning Scientist with Python hoặc R để bắt đầu hành trình chuyên nghiệp.
Nếu bạn đang tìm một số dự án học máy để thực hành, hãy xem bài viết chi tiết của chúng tôi với nhiều ý tưởng cho mọi cấp độ.

