Cursus
Machine Learning met boomgebaseerde modellen in Python
5 uur
119.3K
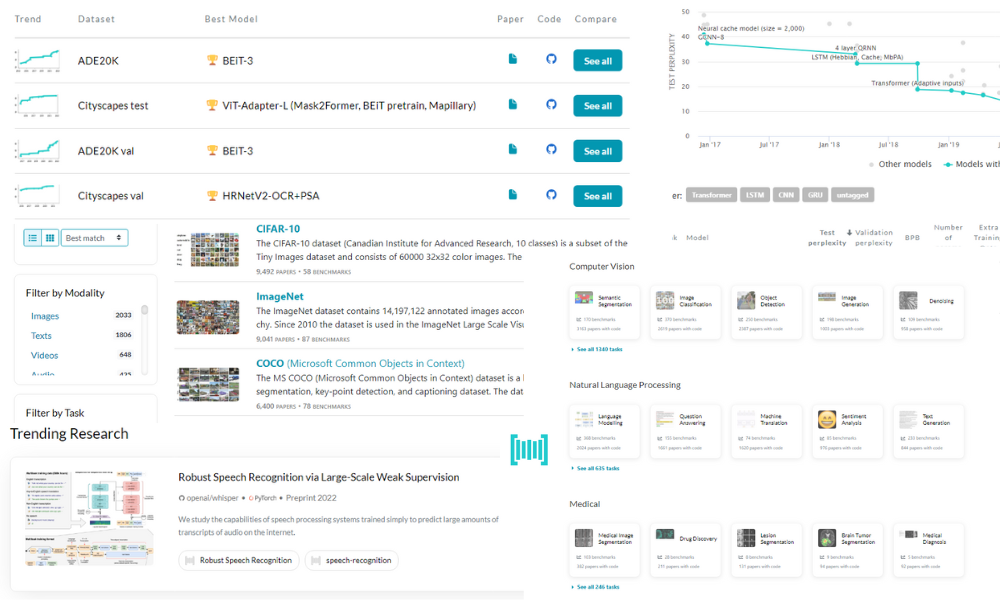
Stel je voor dat je op Google zoekt naar een specifiek onderzoeksartikel over machine learning. Je vindt iets interessants en wilt de code-implementatie, dataset en resultaten zien. Je bent vervolgens uren bezig om die stuk voor stuk op te sporen. En stel je nu voor dat je dit nog 30 keer moet herhalen voor je scriptie of onderzoeksproject. Dat is een nachtmerrie.
Papers With Code schiet te hulp. Het maakt het een stuk makkelijker om onderzoeksartikelen te lezen, met in één oogopslag een samenvatting, code-implementatie, resultaten en dataset. Bovendien kun je met de leaderboard-functie de resultaten van verschillende modelarchitecturen over een vergelijkbaar onderwerp vergelijken.
Het is veel meer dan alleen zoeken naar een paper. Je kunt je zoekopdracht filteren met tags op diverse taken, subtaken, modellen, datasets en methoden om het onderwerp diepgaand te verkennen.
In deze blog verkennen we de belangrijkste functies van Papers With Code en leer je hoe je het beste onderzoek doet voor machinelearningprojecten.
Op de landingspagina zie je de trending papers op basis van het aantal sterren per uur.
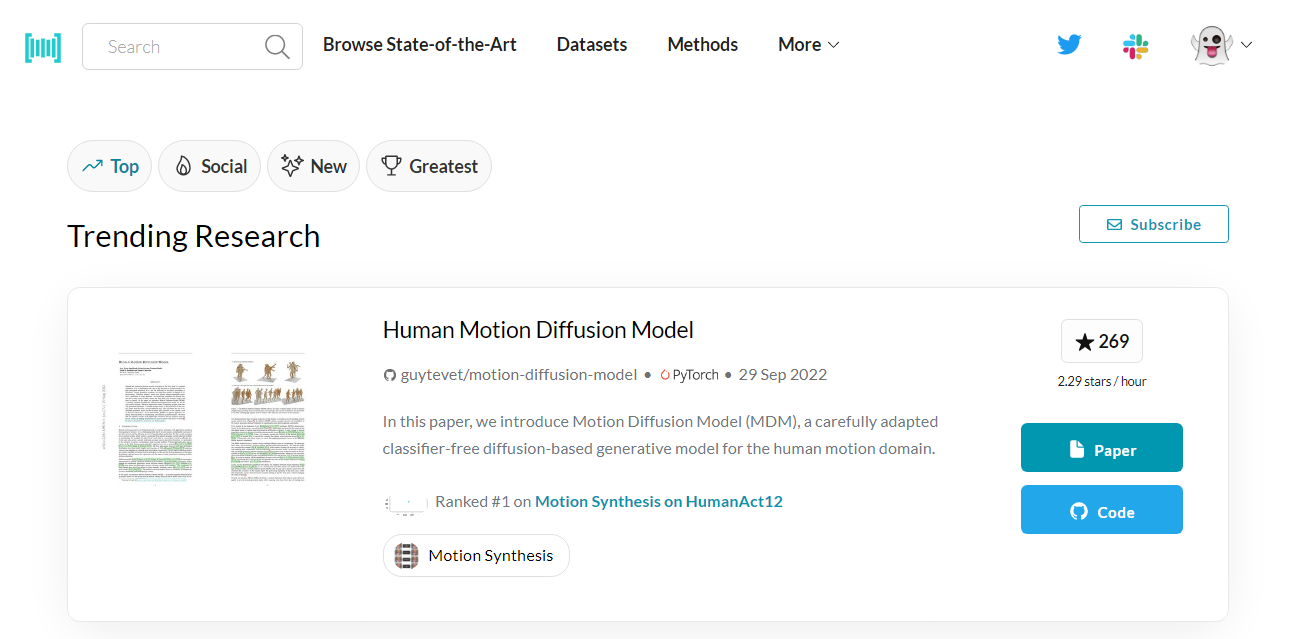
Papers With Code | Trending
Als je de paper interessant vindt, klik je op de knop Paper om de samenvatting te lezen en resultaten, datasets en verschillende code-implementaties te bekijken. Of als je vooral geïnteresseerd bent in de implementatie, klik je op Code en ga je naar de GitHub-repository met resultaten, code-implementaties en dependencies.
De trendingpagina lijkt op de landingspagina van sociale media. Je kunt blijven scrollen om eerdere trending papers te zien met 1000+ sterren en meerdere community-bijdragen aan de code.
Papers With Code is een communitygedreven platform om meer te leren over state-of-the-art papers op het gebied van machine learning. Het biedt een compleet ecosysteem voor open-sourcebijdragers, machinelearningengineers, data scientists, onderzoekers en studenten om ideeën makkelijk te delen en de ontwikkeling van machine learning te versnellen.
Alle content op Papers With Code is open gelicenseerd onder CC-BY-SA en iedereen kan bijdragen via de knoppen "Edit".
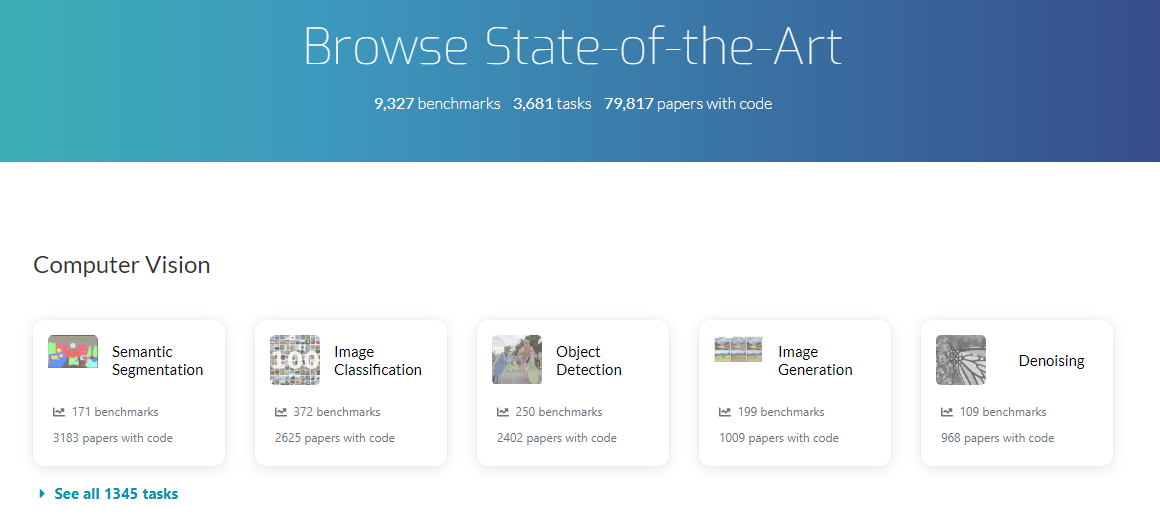
Papers With Code | Browse State-of-the-Art
Als je op de tab Browse State-of-the-Art klikt, zie je categorieën en subcategorieën gebaseerd op verschillende machinelearningdomeinen. Bijvoorbeeld:
Elke categorie hierboven heeft subcategorieën. En wanneer je op een subcategoriekaart klikt, zie je een korte definitie van de subcategorie en de benchmark.
Het primaire doel van de sectie Browse State-of-the-Art is om je informatie te geven over best presterende modellen op een gegeven dataset, populaire libraries, een lijst met datasets, subtaken en de meest geïmplementeerde papers. Daarnaast kun je de prestaties van diverse modellen op dezelfde dataset vergelijken.
Wil je meer leren over verschillende categorieën binnen machine learning? Bekijk dan onze pagina met Machine Learning-cursussen. Die bevat een verzameling beginnersvriendelijke cursussen, machine learning met Python en R, en projectgebaseerde cursussen. Je vindt er ook populaire templates, tutorials en cheatsheets.
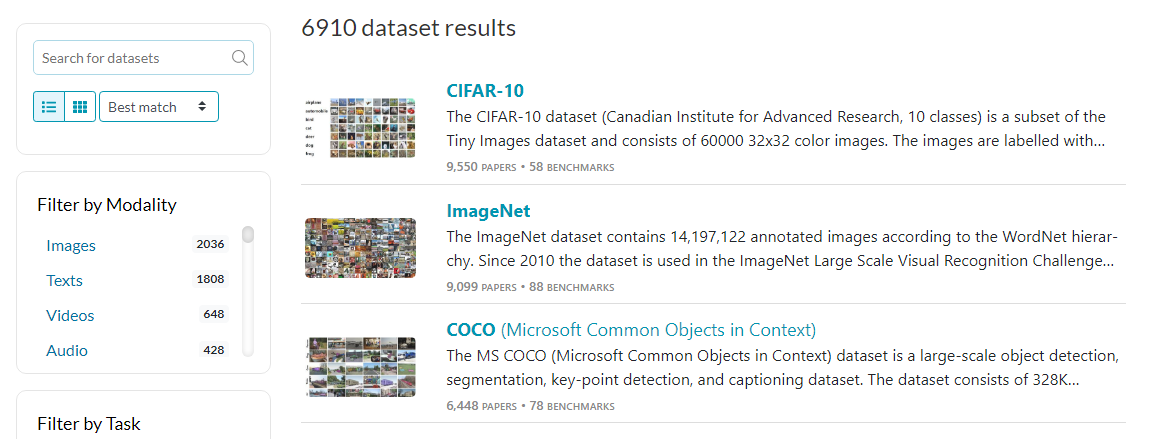
Papers With Code | Datasets
In plaats van categorieën en subcategorieën kun je zoeken naar een specifieke dataset of verschillende filters gebruiken om de dataset te vinden.
Over het algemeen is de website onderling verbonden en hoef je datasets niet één voor één op te sporen. Maar als je onderzoek doet waarvoor meerdere datasets nodig zijn voor een specifiek machinelearningprobleem, helpt de tab Dataset je om elke populaire dataset te vinden met behulp van zoek- en filterfuncties. Je kunt datasets filteren op modaliteit, taken en talen.
Het wordt pas echt leuk wanneer je op een bepaalde dataset klikt. Je vindt er verschillende interactieve secties, zoals:
Kortom, de tab Dataset is volledig geïntegreerd met andere delen van de website om een soepele gebruikerservaring te bieden voor diepgaand onderzoek.
Je kunt ook de sectie Datasets op DataCamp bekijken om verschillende soorten datasets te downloaden. Bovendien kun je met één klik gratis een cloud Jupyter Notebook starten.
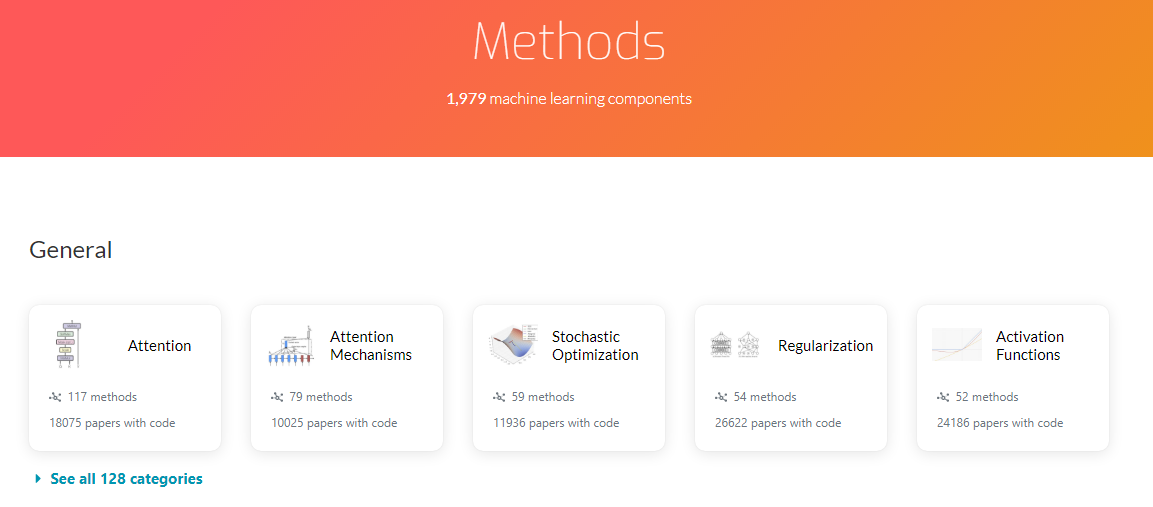
Papers With Code | Methods
De tab Methods lijkt op de tab Browse State-of-the-Art. Hij heeft categorieën en subcategorieën in de vorm van kaarten. De tab Methods is voor onderzoekers die specifieke machinelearningmethodologieën willen leren. Bijvoorbeeld word embeddings, extractie van afbeeldingsfeatures en activatiefuncties.
Hij bestaat uit 7 categorieën:
Wanneer je op een methodekaart klikt, zie je de definitie, een diagram en de sectie Methods. In het geval van de Attention-kaart zie je Multi-Head Attention, Scaled Dot-Product Attention, Fixed Factorized Attention en alle Attention-methoden. Bij elke methode staat het jaar van publicatie en het aantal papers waarin deze methode is gebruikt.
Na het klikken op de methode Multi-Head Attention zie je een pagina met een samenvatting van de vergelijking, een downloadbare PDF van de paper en broncode. Je ziet ook de secties Papers, Tasks, Usage Over Time, Components en Categories.
Het is een leuke manier om over machinelearningmethoden te leren, omdat alles is geoptimaliseerd om de ervaring van de onderzoeker te verbeteren.
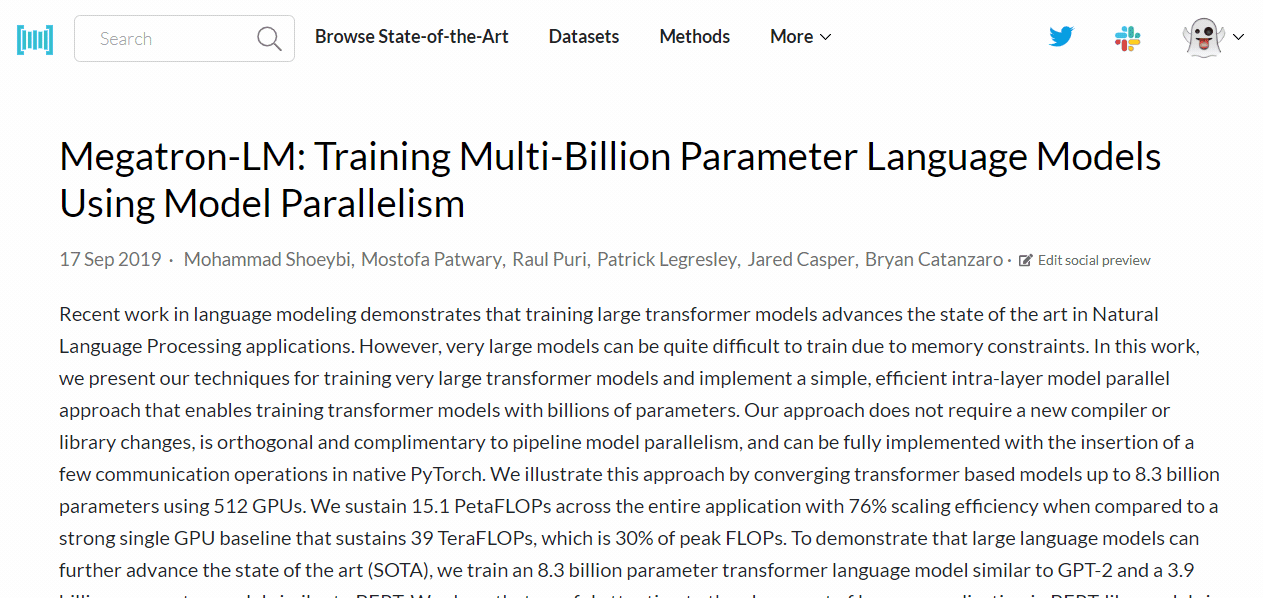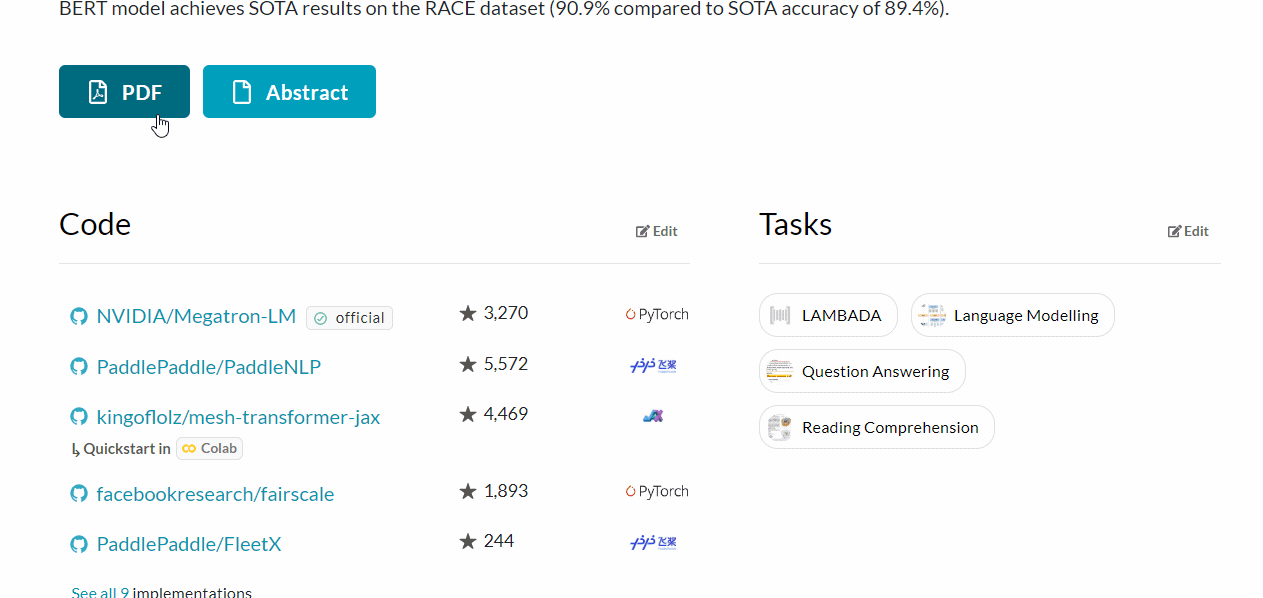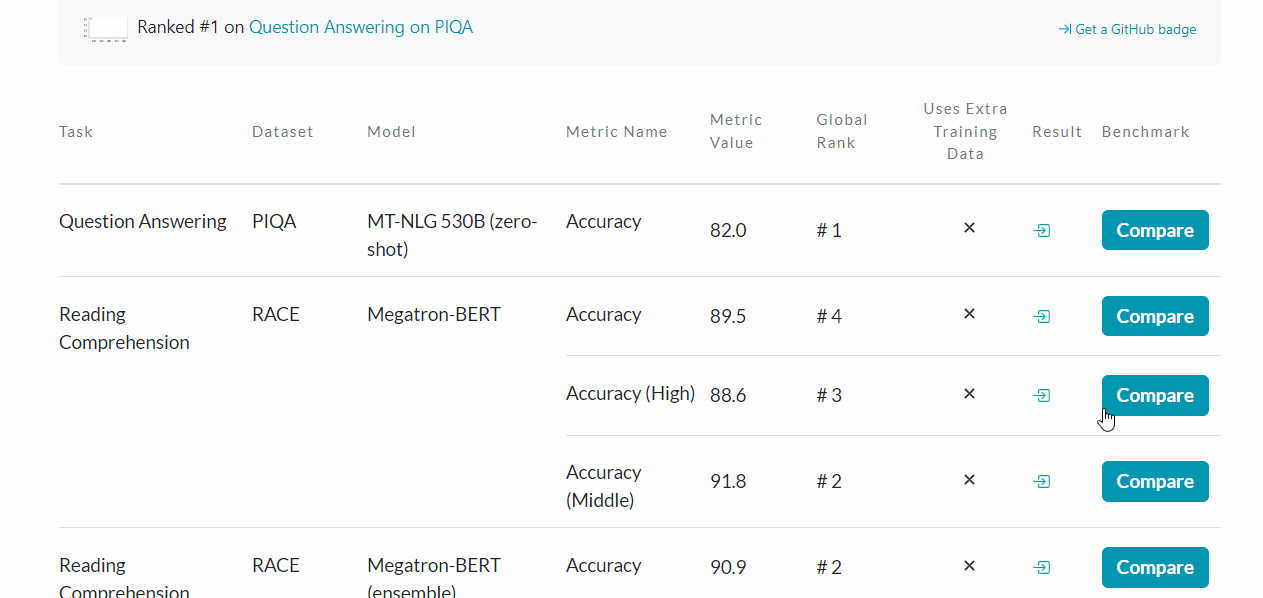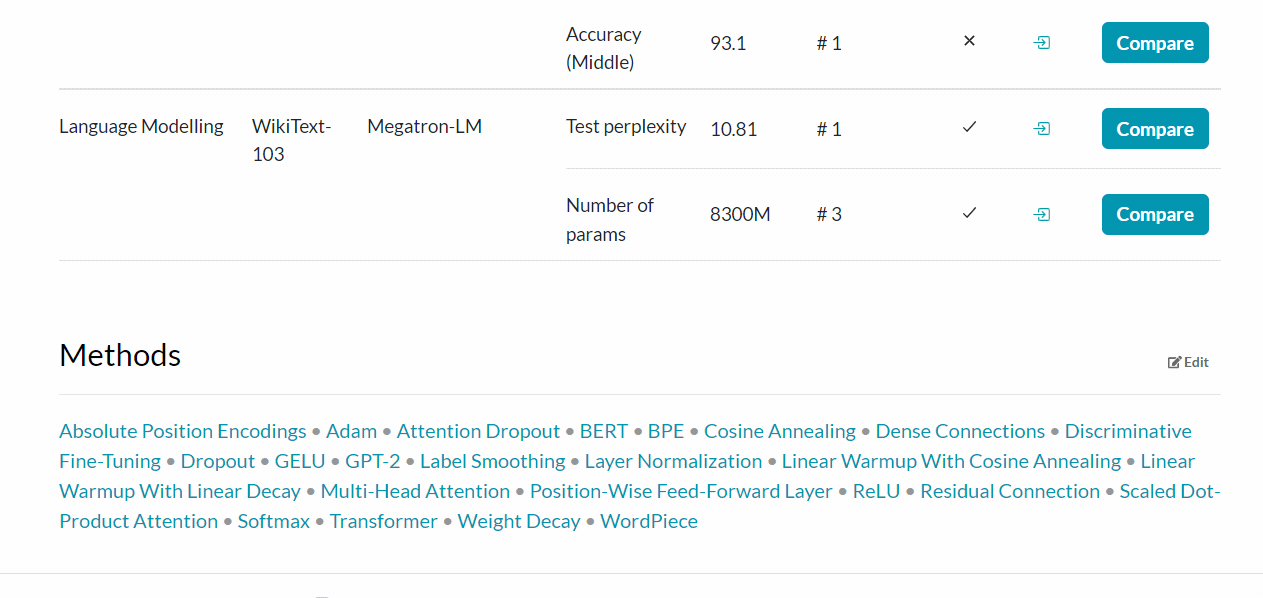
Papers With Code | Paper
Bovenaan de pagina van een paper zie je de titel, naam van de auteur, datum en abstract. Daaronder vind je de knop PDF, die je naar de volledige paper brengt, en de knop Abstract, die je naar de abstractpagina op arxiv.org brengt.
Een paper bestaat verder uit 5 secties:
Een paper lezen op Papers With Code is eenvoudig en interactief. In plaats van de hele paper te downloaden en te lezen, kun je bijna alles leren via de tags, code-implementatie, taken en resultaten.
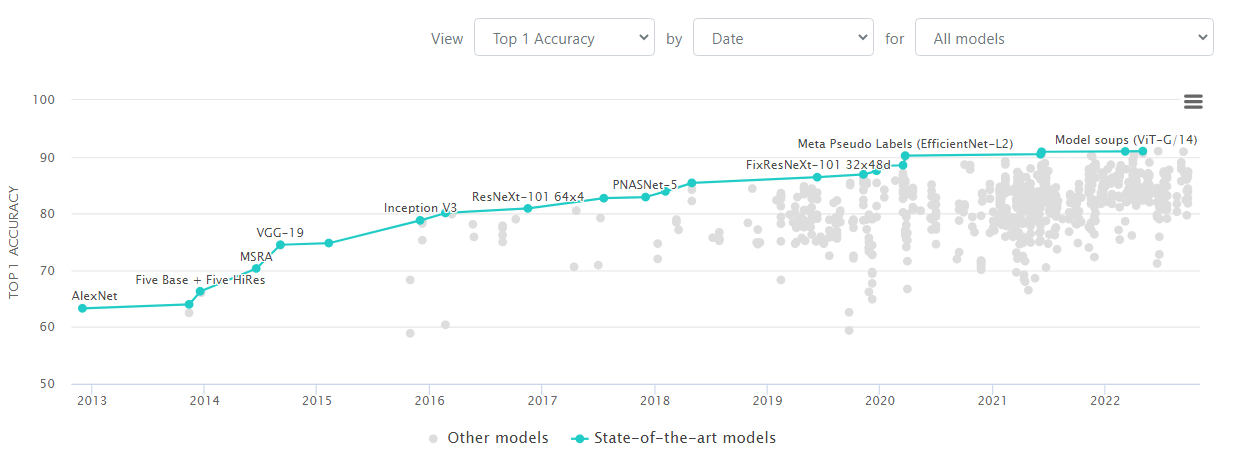
Papers With Code | Image Classification on ImageNet Leaderboard
Als je naar de bovenstaande afbeelding kijkt, geven de tealkleurige lijnen en punten de state-of-the-art beeldclassificatiemodellen op de ImageNet-dataset weer. De grijze punten zijn de minder presterende beeldclassificatiemodellen in een bepaalde periode.
Het hele ecosysteem van Papers With Code draait om een leaderboard en zet state-of-the-art onderzoek bovenaan. Op de voorpagina zie je trending onderzoek op basis van sterren en populariteit. Elke tab zet populaire datasets, code-implementaties en de beste methodologieën en papers in de spotlight.
De visie achter leaderboards, trends en benchmarks is het bevorderen van de kwaliteit van onderzoek. Zo verleggen we elke dag de grenzen van machine learning om een state-of-the-art status te bereiken.
Hieronder vind je een paar waardevolle tips om het Papers With Code-platform te gebruiken en je onderzoeksproject te optimaliseren:
De ontwikkelaars voegen voortdurend nieuwe functies toe om de gebruikerservaring te verbeteren. Als je iets nieuws wilt delen of featureverzoeken hebt, kun je ze bereiken via Twitter of Slack.
Het Papers With Code-platform brengt mensen met verschillende achtergronden samen. De website wordt onderhouden door Meta AI, maar draait op de community. De openheid om bij te dragen zorgt voor inclusiviteit, een cruciale factor in de snelle groei van de machinelearning- en AI-industrie.
In deze blog hebben we geleerd over het belang van een interactief en onderling verbonden platform genaamd Papers With Code. We hebben ook de belangrijkste functies van de website en tips ontdekt om je onderzoek te optimaliseren.
Papers With Code is geweldig voor machinelearningpapers, code, datasets en benchmarks. Het is een van de beste plekken om aan je afstudeerproject te beginnen. Ook als je nieuw bent in het vakgebied, kun je je inschrijven voor het carrièrepad Machine Learning Scientist with Python of R om je professionele reis te starten.
Ben je op zoek naar machinelearningprojecten om aan te werken? Bekijk dan onze uitgebreide blog met ideeën voor lerenden van elk niveau.
Machine Learning-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

