Kurs
Maschinelles Lernen mit baumbasierten Modellen in Python
5 Std.
118.8K
Stell dir vor, du suchst bei Google nach einem bestimmten Forschungsartikel zu Machine Learning. Du findest etwas Spannendes und willst dir die Code-Implementierung, das Dataset und die Ergebnisse ansehen. Du verbringst Stunden damit, alles einzeln aufzuspüren. Und jetzt stell dir vor, du musst das für deine Thesis oder dein Forschungsprojekt 30 weitere Male wiederholen. Das kann zur Nervenprobe werden.
Papers With Code nimmt dir diese Mühe ab. Dort liest du Forschungsarbeiten viel bequemer: Zusammenfassung, Code, Ergebnisse und Datensätze auf einen Blick. Außerdem kannst du mit der Leaderboard-Funktion die Ergebnisse verschiedener Modellarchitekturen zum selben Thema vergleichen.
Es geht um weit mehr, als nur nach Papers zu suchen. Du kannst deine Suche mit Tags zu Aufgaben, Subtasks, Modellen, Datensätzen und Methoden filtern und so tief ins Thema eintauchen.
In diesem Blog sehen wir uns die wichtigsten Funktionen von Papers With Code an und lernen, wie du deine Recherche für Machine-Learning-Projekte am besten aufsetzt.
Auf der Startseite siehst du trendende Forschungsartikel, basierend auf der Anzahl an Stars pro Stunde.
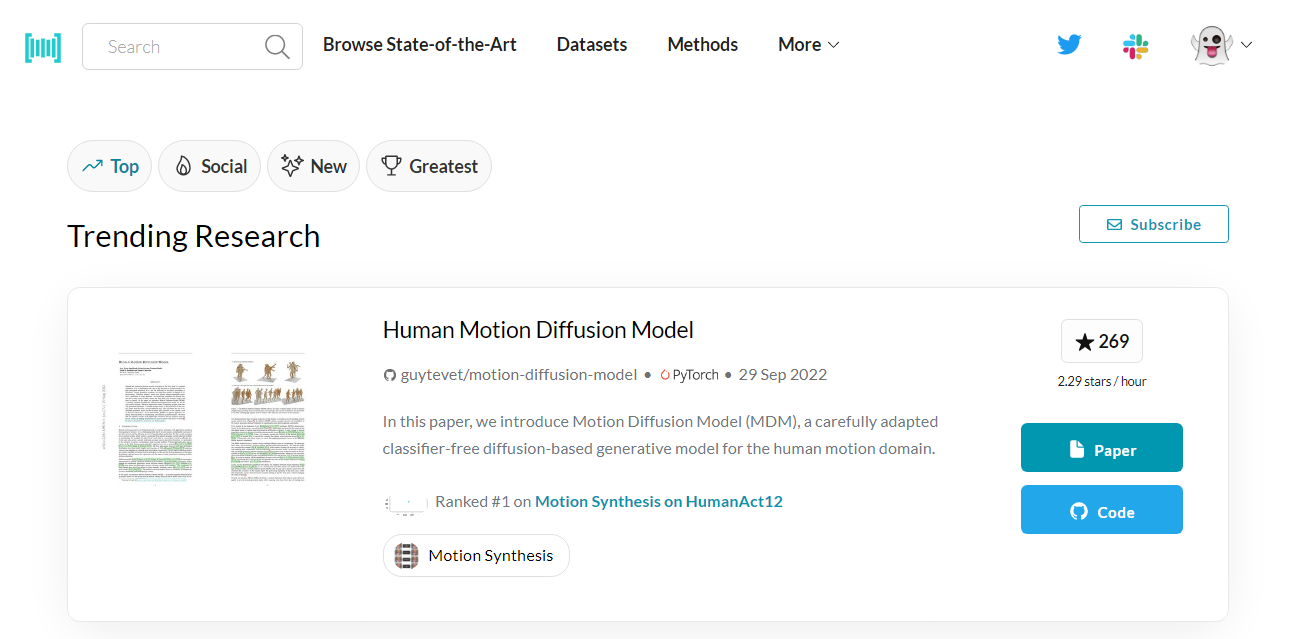
Papers With Code | Trending
Wenn dir ein Paper gefällt, klick auf den Button Paper, um Abstract, Ergebnisse, Datensätze und verschiedene Code-Implementierungen zu sehen. Oder klick auf Code, wenn dich die Implementierung interessiert, und du landest im GitHub-Repository mit Ergebnissen, Code und Abhängigkeiten.
Die Trending-Seite funktioniert ähnlich wie eine Social-Media-Startseite. Du kannst endlos scrollen und frühere Trend-Papers mit 1000+ Stars und zahlreichen Community-Implementierungen entdecken.
Papers With Code ist eine Community-Plattform, um State-of-the-Art-Forschung zu Machine Learning kennenzulernen. Sie bietet ein komplettes Ökosystem für Open-Source-Beitragende, ML Engineers, Data Scientists, Forschende und Studierende, damit Ideen leichter geteilt werden und die ML-Entwicklung schneller vorankommt.
Alle Inhalte auf Papers With Code sind offen unter CC-BY-SA lizenziert, und jede Person kann über die „Edit“-Buttons beitragen.
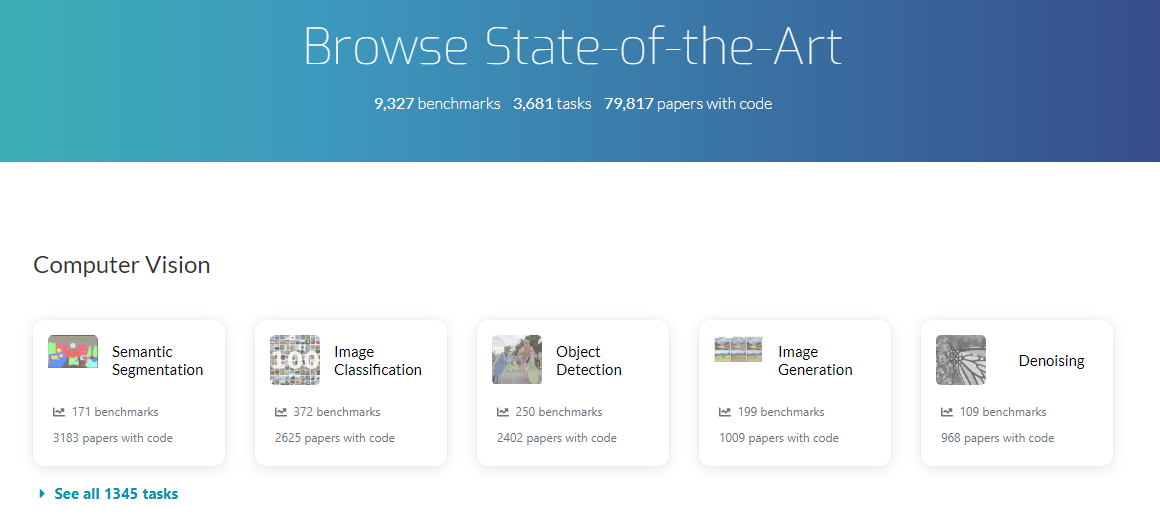
Papers With Code | State of the Art durchstöbern
Über den Tab Browse State-of-the-Art findest du Kategorien und Unterkategorien zu verschiedenen Bereichen des Machine Learnings. Zum Beispiel:
Jede dieser Kategorien hat Unterkategorien. Klickst du auf eine Unterkategorie, siehst du eine kurze Definition und die Benchmarks.
Der Hauptzweck des Bereichs Browse State-of-the-Art ist es, dir Informationen zu den bestperformenden Modellen auf einem Datensatz, beliebten Libraries, Datensatzlisten, Subtasks und den am häufigsten implementierten Papers bereitzustellen. Außerdem kannst du verschiedene Modellmetriken auf demselben Datensatz vergleichen.
Wenn du mehr über die ML-Kategorien lernen willst, schau dir unsere Seite zu Machine-Learning-Kursen an. Dort findest du ein Paket an Einsteigerkursen, Machine Learning mit Python und R sowie projektbasierten Kursen. Außerdem warten beliebte Vorlagen, Tutorials und Cheat Sheets.
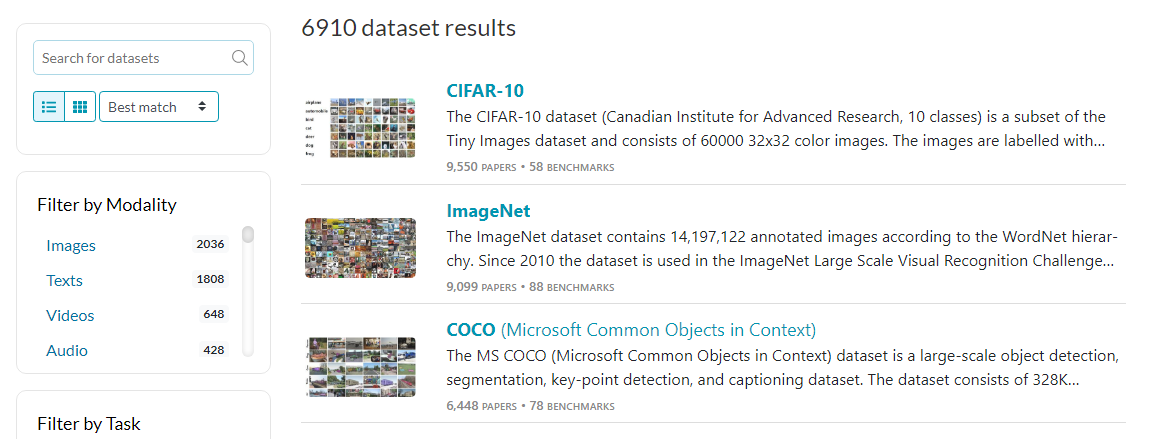
Papers With Code | Datasets
Statt über Kategorien kannst du direkt nach einem bestimmten Datensatz suchen oder Filter verwenden, um passende Datasets zu finden.
Grundsätzlich ist die Website stark vernetzt, du musst Datensätze nicht mühsam einzeln zusammensuchen. Wenn du aber für deine Forschung mehrere Datasets zu einem spezifischen ML-Problem brauchst, hilft dir der Tab Dataset, beliebte Datensätze per Suche und Filter zu finden. Du kannst nach Modalität, Aufgaben und Sprachen filtern.
Spannend wird es, wenn du auf einen konkreten Datensatz klickst. Dann findest du unter anderem folgende interaktive Bereiche:
Kurz gesagt: Der Dataset-Tab ist nahtlos mit den anderen Bereichen verknüpft und macht tiefe Recherchen sehr angenehm.
Schau dir auch den Bereich Datasets bei DataCamp an, um verschiedenste Datensätze herunterzuladen. Außerdem kannst du mit einem Klick ein cloudbasiertes Jupyter Notebook kostenlos starten.
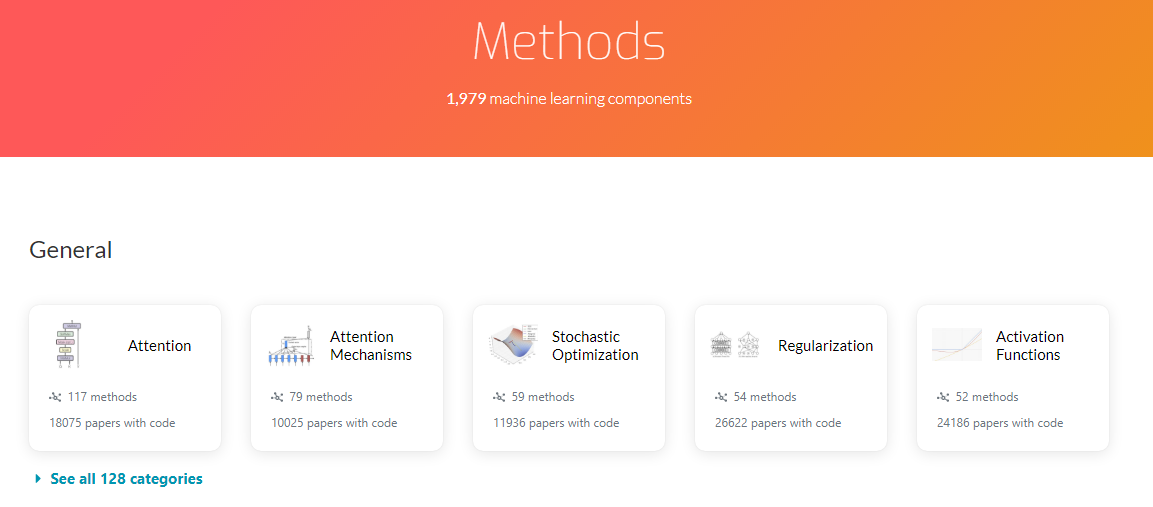
Papers With Code | Methods
Der Tab Methods ähnelt Browse State-of-the-Art. Es gibt Kategorien und Unterkategorien als Karten. Der Bereich richtet sich an Forschende, die bestimmte ML-Methodiken vertiefen wollen, etwa Word Embeddings, Bildmerkmalsextraktion oder Aktivierungsfunktionen.
Er umfasst 7 Kategorien:
Klickst du auf eine Methodenkarte, siehst du Definition, Diagramm und den Methodenbereich. Beim Attention-Eintrag findest du zum Beispiel Multi-Head Attention, Scaled Dot-Product Attention, Fixed Factorized Attention und alle Attention-Varianten. Zu jeder Methode werden Erscheinungsjahr und die Anzahl der Papers angezeigt, die sie nutzen.
Nach dem Klick auf die Methode Multi-Head Attention erhältst du eine Seite mit einer Gleichungszusammenfassung, einem downloadbaren PDF des Papers und dem Quellcode. Außerdem siehst du die Bereiche Papers, Tasks, Nutzung über die Zeit, Komponenten und Kategorien.
So macht das Lernen über ML-Methoden Spaß, denn alles ist konsequent auf ein gutes Rechercheerlebnis optimiert.
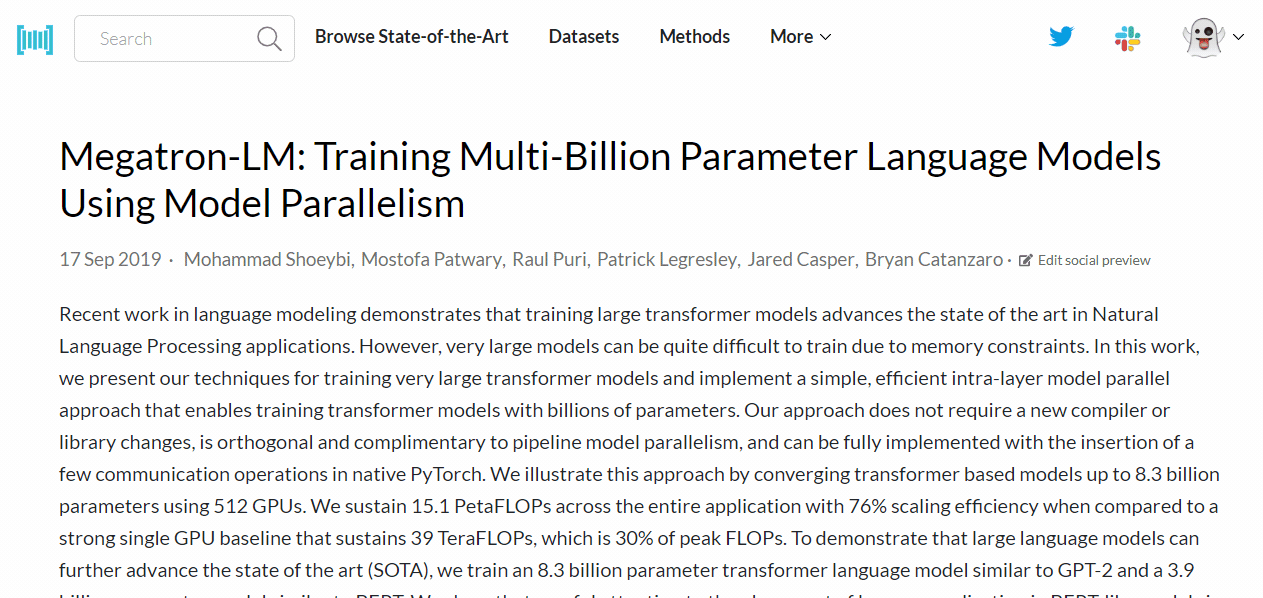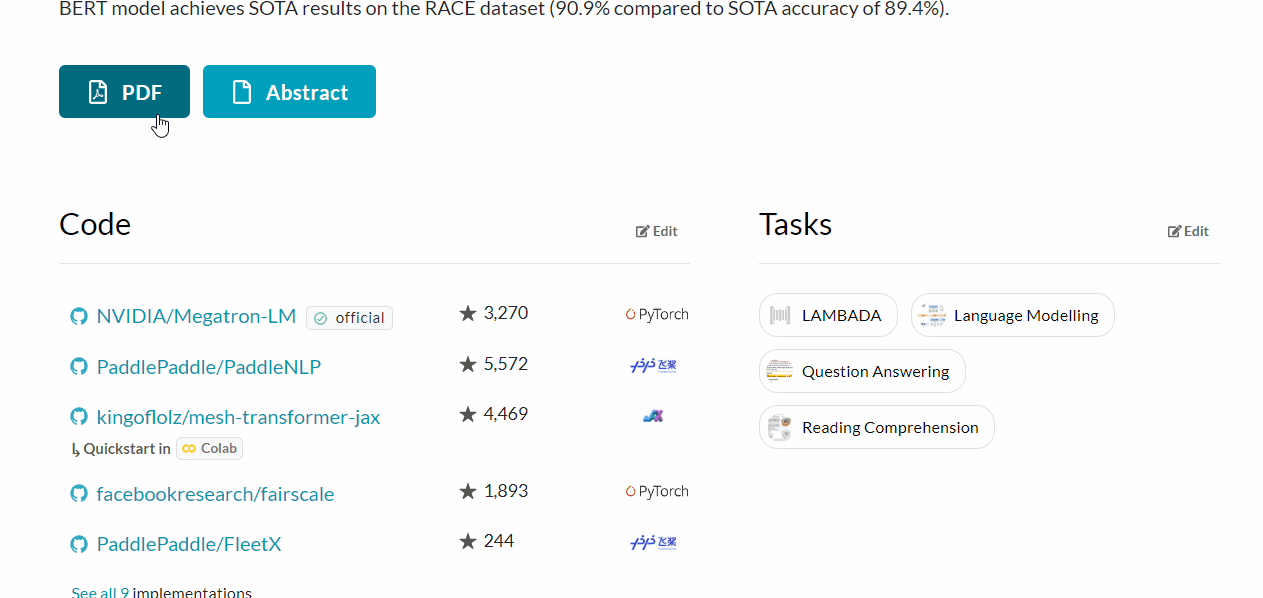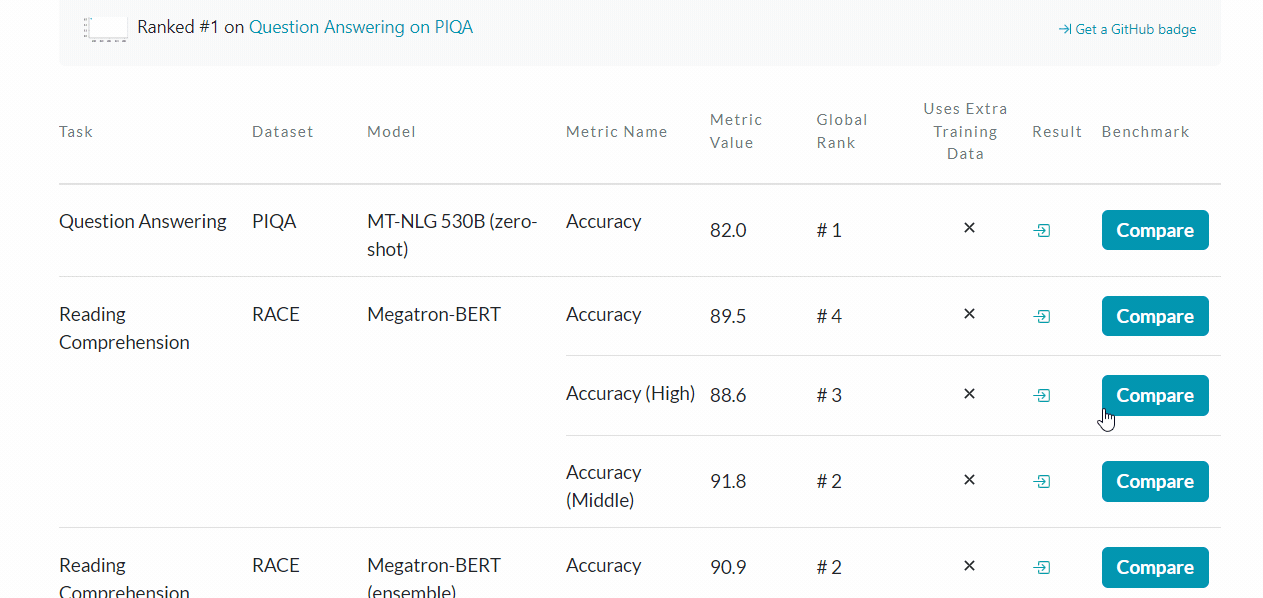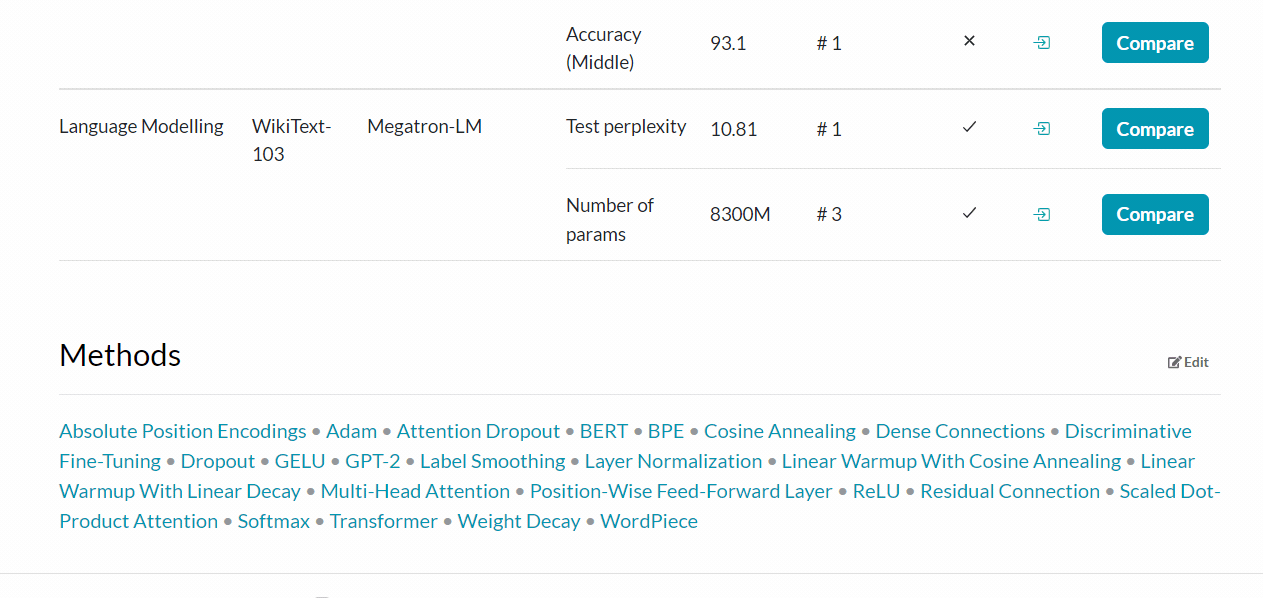
Papers With Code | Paper
Oben auf der Paper-Seite siehst du Titel, Autorennamen, Datum und Abstract. Danach folgen der Button PDF zum vollständigen Paper sowie Abstract zur arxiv.org-Abstract-Seite.
Ein Paper umfasst typischerweise fünf Bereiche:
Ein Paper auf Papers With Code zu lesen ist einfach und interaktiv. Statt das ganze Dokument herunterzuladen, lernst du fast alles über Tags, Code, Aufgaben und Ergebnisse.
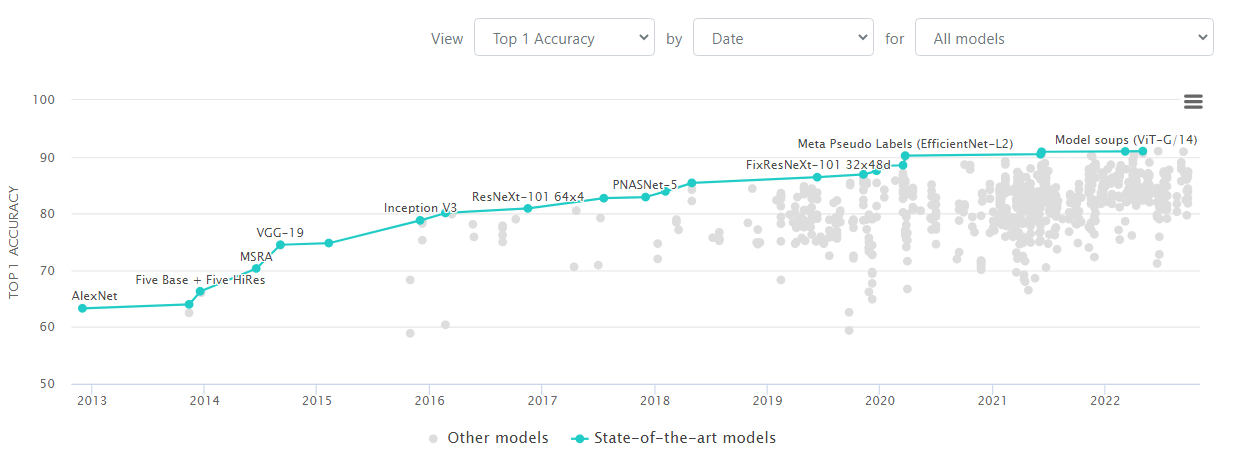
Papers With Code | Leaderboard für Image Classification auf ImageNet
Im obigen Bild stehen die türkisfarbenen Linien und Punkte für die jeweils führenden Modelle zur Bildklassifikation auf dem ImageNet-Datensatz. Die grauen Punkte markieren in einem Zeitraum schwächer abschneidende Modelle.
Das gesamte Ökosystem von Papers With Code dreht sich um Leaderboards und hebt State-of-the-Art-Forschung hervor. Auf der Startseite siehst du Trends basierend auf Stars und Popularität. Jeder Bereich fördert populäre Datensätze, Code-Implementierungen sowie die besten Methoden und Papers.
Die Vision hinter Leaderboards, Trends und Benchmarks ist es, Forschungsqualität sichtbar zu machen. So treiben wir die Grenzen des Machine Learning täglich voran, um den State-of-the-Art zu erreichen.
Hier findest du praktische Tipps, wie du Papers With Code nutzt und dein Forschungsprojekt optimierst:
Die Entwicklerinnen und Entwickler bauen laufend neue Funktionen für ein besseres Nutzungserlebnis. Wenn du etwas beitragen oder Features vorschlagen willst, erreichst du sie über Twitter oder Slack.
Papers With Code bringt Menschen mit unterschiedlichen Hintergründen zusammen. Die Website wird von Meta AI betreut, lebt aber von der Community. Die Offenheit für Beiträge schafft Inklusivität – ein zentraler Treiber für das rasante Wachstum von Machine Learning und Künstlicher Intelligenz.
In diesem Blog hast du die Bedeutung einer interaktiven, vernetzten Plattform wie Papers With Code kennengelernt. Außerdem haben wir die wichtigsten Features und Tipps für eine effiziente Recherche beleuchtet.
Papers With Code ist großartig für ML-Papers, Code, Datasets und Benchmarks. Es ist einer der besten Startpunkte für dein Abschlussprojekt. Selbst wenn du neu im Feld bist, kannst du mit dem Machine Learning Scientist mit Python- oder dem R-Karrierepfad in deine professionelle Laufbahn starten.
Wenn du nach Machine-Learning-Projekten suchst, findest du in unserem ausführlichen Blog Ideen für alle Lernniveaus.
Machine-Learning-Kurse
Kurs
Kurs
Kurs
Tutorial
Matt Crabtree
5 Min.
Tutorial
Javier Canales Luna
11 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Mark Pedigo
10 Min.






