
Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
10.7K
La nuova ondata di modelli di classe Flash continua a crescere.
Di recente abbiamo parlato di Qwen3.8-Flash-Next, GLM-5.3-Flash, Gemini 3.8 Flash e DeepSeek V4.1 Flash, tutti in corsa per la fascia di mercato sensibile ai costi e con inferenza veloce.
Il team Qwen di Alibaba aggiunge ora un nuovo punto di vista con Qwen3.8-Omni-Flash, un modello nativamente omnimodale costruito attorno ad agenti audio e video.
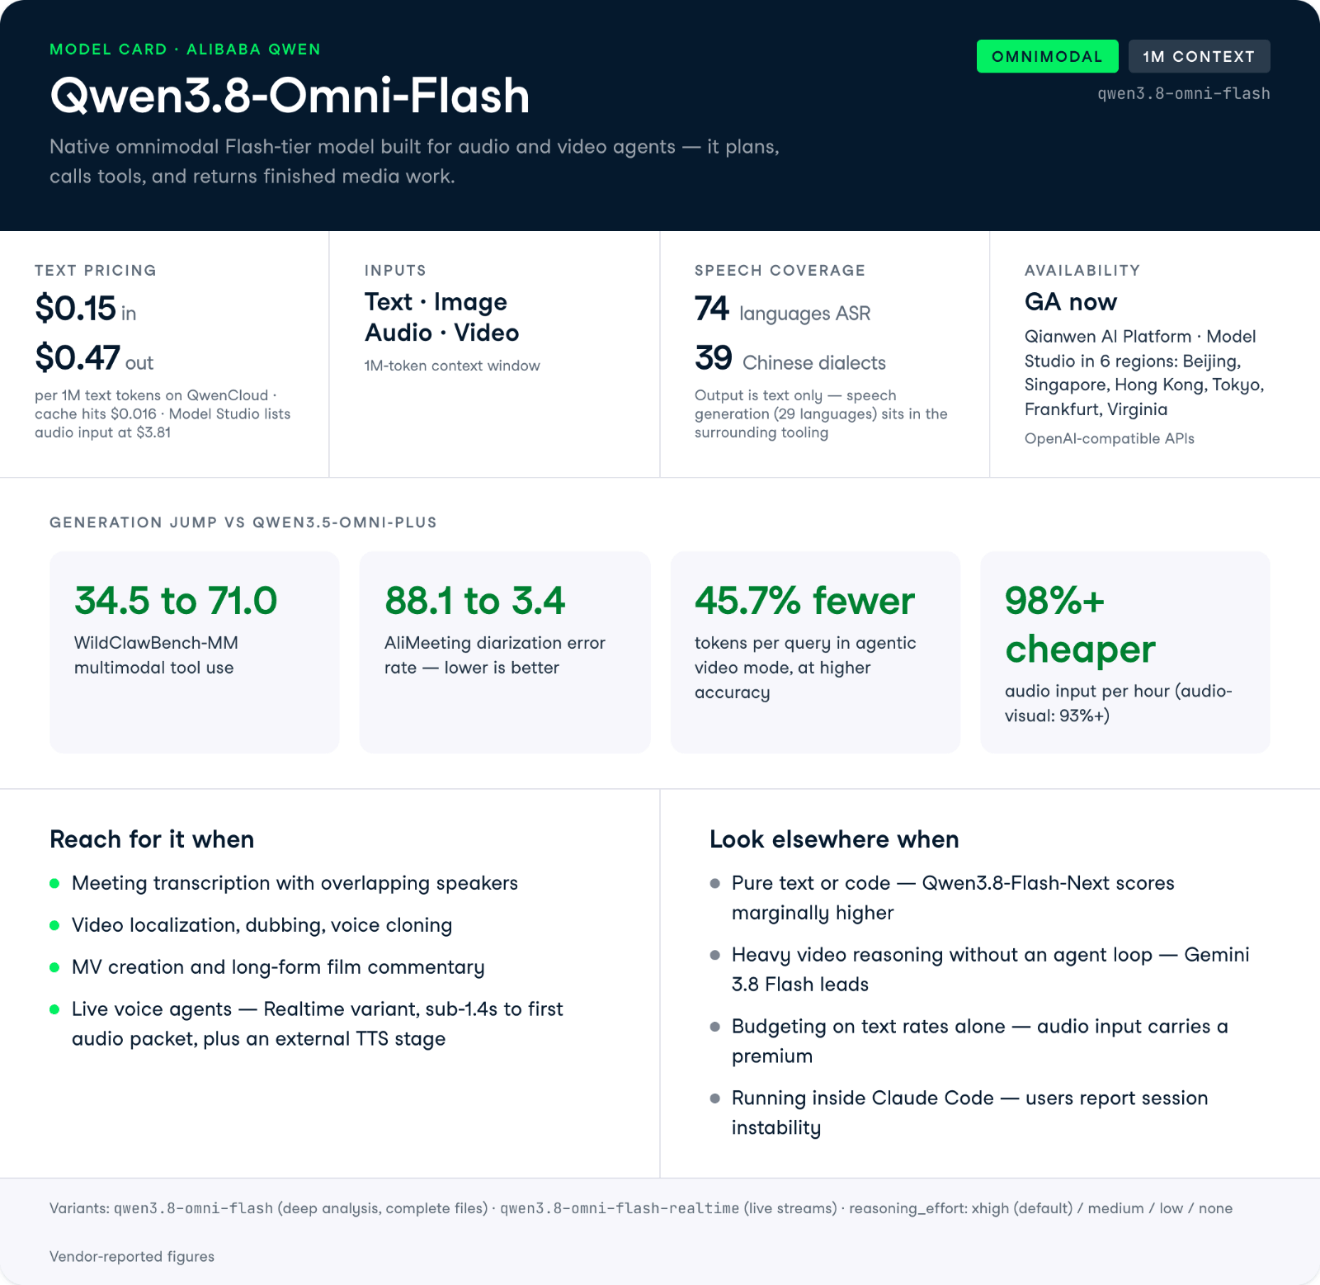
Qwen3.8-Omni-Flash accetta input di testo, immagini, audio e video con una finestra di contesto da 1 milione di token. Alibaba dichiara prestazioni audio-visive vicine a Gemini 3.8 Flash e prestazioni audio complessive superiori, insieme a un miglioramento medio del 25%+ rispetto al predecessore Qwen3.5-Omni-Plus su 29 valutazioni. I risultati principali per gli agenti sono +36,5 punti su WildClawBench-MM e un calo superiore al 98% del prezzo orario dell’input audio.
In questo articolo vedremo tutte le novità di Qwen3.8-Omni-Flash: analizzeremo le nuove funzionalità, lo confronteremo con gli altri modelli Flash che abbiamo recensito e passeremo in rassegna i benchmark.
Per approfondire come si confrontano questi modelli, dai un’occhiata alla nostra guida su DeepSeek V4.1 Flash vs Gemini 3.8 Flash e al nostro confronto tra GLM-5.3 Flash e Qwen3.8-Flash-Next.
Qwen3.8-Omni-Flash è un modello nativamente omnimodale del team Qwen di Alibaba, posizionato nel tier Flash come opzione economica e ad alto throughput all’interno della gamma.
Elabora testo, immagini, audio e video in un unico modello e supporta una finestra di contesto da 1 milione di token, mantenendo prestazioni sul testo paragonabili a un modello solo testo della stessa dimensione.
L’obiettivo di questa generazione è la capacità d’agente su audio e video, non solo la loro comprensione.
Se Qwen3.5-Omni-Plus era focalizzato sull’interpretazione di contenuti omnimodali, Qwen3.8-Omni-Flash è progettato per pianificare compiti, chiamare strumenti e completare lavori creativi come montaggio video, creazione di music video e commenti cinematografici.
Alibaba presenta questo come il passaggio di audio e video da input percettivi a media centrali attraverso cui un agente ragiona ed esegue.
La grande dichiarazione qui è un salto di 36,5 punti su WildClawBench-MM fino a 71,0 (Qwen3.5-Omni-Plus aveva 34,5), oltre a +22,3 punti su AgenticVBench.
Quando testato su audio di riunioni reali in cui spesso le persone si sovrappongono parlando, il nuovo sistema ha mostrato miglioramenti enormi rispetto al precedente:
Le funzionalità ruotano attorno a un’idea: dare a un agente mani per lavorare con audio e video, non solo occhi e orecchie.
Alibaba ha distribuito il modello insieme a due layer di strumenti, Qwen-MM-Plugins per workflow di lungo raggio e Qwen-Live Harness per l’interazione in tempo reale.
Puoi dare a Qwen3.8-Omni-Flash una canzone o un film intero e descrivere in una frase ciò che vuoi: pianificherà il compito, chiamerà strumenti creativi e restituirà un video finito.
Supporta workflow end-to-end, inclusa la creazione di music video, la traduzione di corti con clonazione vocale e commenti cinematografici di lunga durata.
Per un film di due ore, il modello esegue comprensione video long-form, estrazione delle trame chiave, pianificazione del commento, produzione di voiceover e musica, montaggio e un controllo qualità finale.
Può alternare dialoghi originali e narrazione e regolare velocità e volume della voce in modo che i livelli audio si integrino.
Questo è importante perché il ciclo frammentato trascrivi-traduci-doppia-monta è esattamente il costo di coordinamento che stronca questi progetti per i creator singoli.
Sei tu a definire cosa guarda il modello, con quanta attenzione e come presenta il risultato, invece di accettare una descrizione fissa.
Gli utenti possono specificare il soggetto, l’intervallo temporale, il livello di dettaglio e il formato di output per lo stesso video.
Metti di fornirgli una demo prodotto di 40 minuti. Puoi chiedere una panoramica di 200 parole per una pagina listing, poi rieseguire la stessa clip chiedendo un output in schema JSON con timestamp per scena, estrazione del testo on-screen e trascrizioni con speaker tag per una pipeline a valle.
Su OmniCap-IF, i punteggi di struttura dei contenuti e di aderenza alle istruzioni (CSR e ISR) migliorano rispettivamente di 8,5 e 14,1 punti rispetto al predecessore.
Invece di elaborare una registrazione di molte ore, il modello parte dalla tua domanda e decide cosa guardare e ascoltare, raccogliendo evidenze dal grosso al fine.
Questo concentra computazione e token sui segmenti rilevanti.
Su OmniVideoBench, questa modalità agentica aumenta l’accuratezza da 63,4 a 67,8 riducendo al contempo il consumo di token da 145.736 a 79.117 per query, una riduzione di circa il 45,7%.
Per chi paga a token su filmati di ore, quel guadagno di efficienza è la caratteristica principale.
Una variante separata, Qwen3.8-Omni-Flash-Realtime, percepisce e risponde mentre riceve stream audio-visivi dal vivo e usa il contesto in tempo reale per chiamare strumenti.
Gestisce pratica di conversazione con feedback sulla pronuncia, percezione audio spaziale e iniezione di conoscenza tramite Skills.
La percezione audio spaziale è l’aspetto più insolito: Alibaba afferma che sia il primo modello omnimodale in grado di localizzare un bersaglio dal suono, combinando audio direzionale con informazioni visive per determinare direzione e distanza di una sorgente.
Il tempo riportato al primo pacchetto audio è inferiore a 1,4 secondi anche per input audio-visivi di 20 secondi.
Qwen3.8-Omni-Flash supporta il riconoscimento vocale in 74 lingue e 39 dialetti cinesi, dal mandarino e cantonese al sichuanese, allo shanghainese e al min meridionale.
La generazione vocale copre 29 lingue e 7 dialetti.
Per workflow di localizzazione e doppiaggio, questa ampiezza di dialetti è un elemento pratico di differenziazione rispetto alla maggior parte dei modelli Flash concorrenti, che in genere pubblicano il numero di lingue ma non la copertura a livello di dialetto.
Una delle dimostrazioni più insolite del rilascio è Alibaba che usa Qwen3.8-Omni-Flash per migliorare un modello più piccolo invece di servire direttamente gli utenti.
Dando 12 ore per migliorare il riconoscimento del dialetto sichuanese di Qwen2.5-Omni-3B, l’agente ha selezionato il set di valutazione WenetSpeech-Chuan, costruito una baseline e diagnosticato gli errori ascoltando campioni audio.
In quattro round ha creato 3.413 esempi di training, ripristinato i tentativi falliti e ridotto il tasso di errore sui caratteri dal 25,79% al 15,30%, una riduzione relativa di circa il 40,7%.
È un piccolo esperimento, ma suggerisce un modello grande che guida l’addestramento di piccoli modelli specializzati per la produzione.
Il pattern è coerente: Qwen3.8-Omni-Flash vince nettamente la categoria audio, se la gioca con Gemini 3.8 Flash sui compiti audio-visivi e resta competitivo sul testo rispetto ai modelli fratelli.
Non è avanti ovunque, e diverse righe di video reasoning favoriscono ancora Gemini 3.8 Flash.
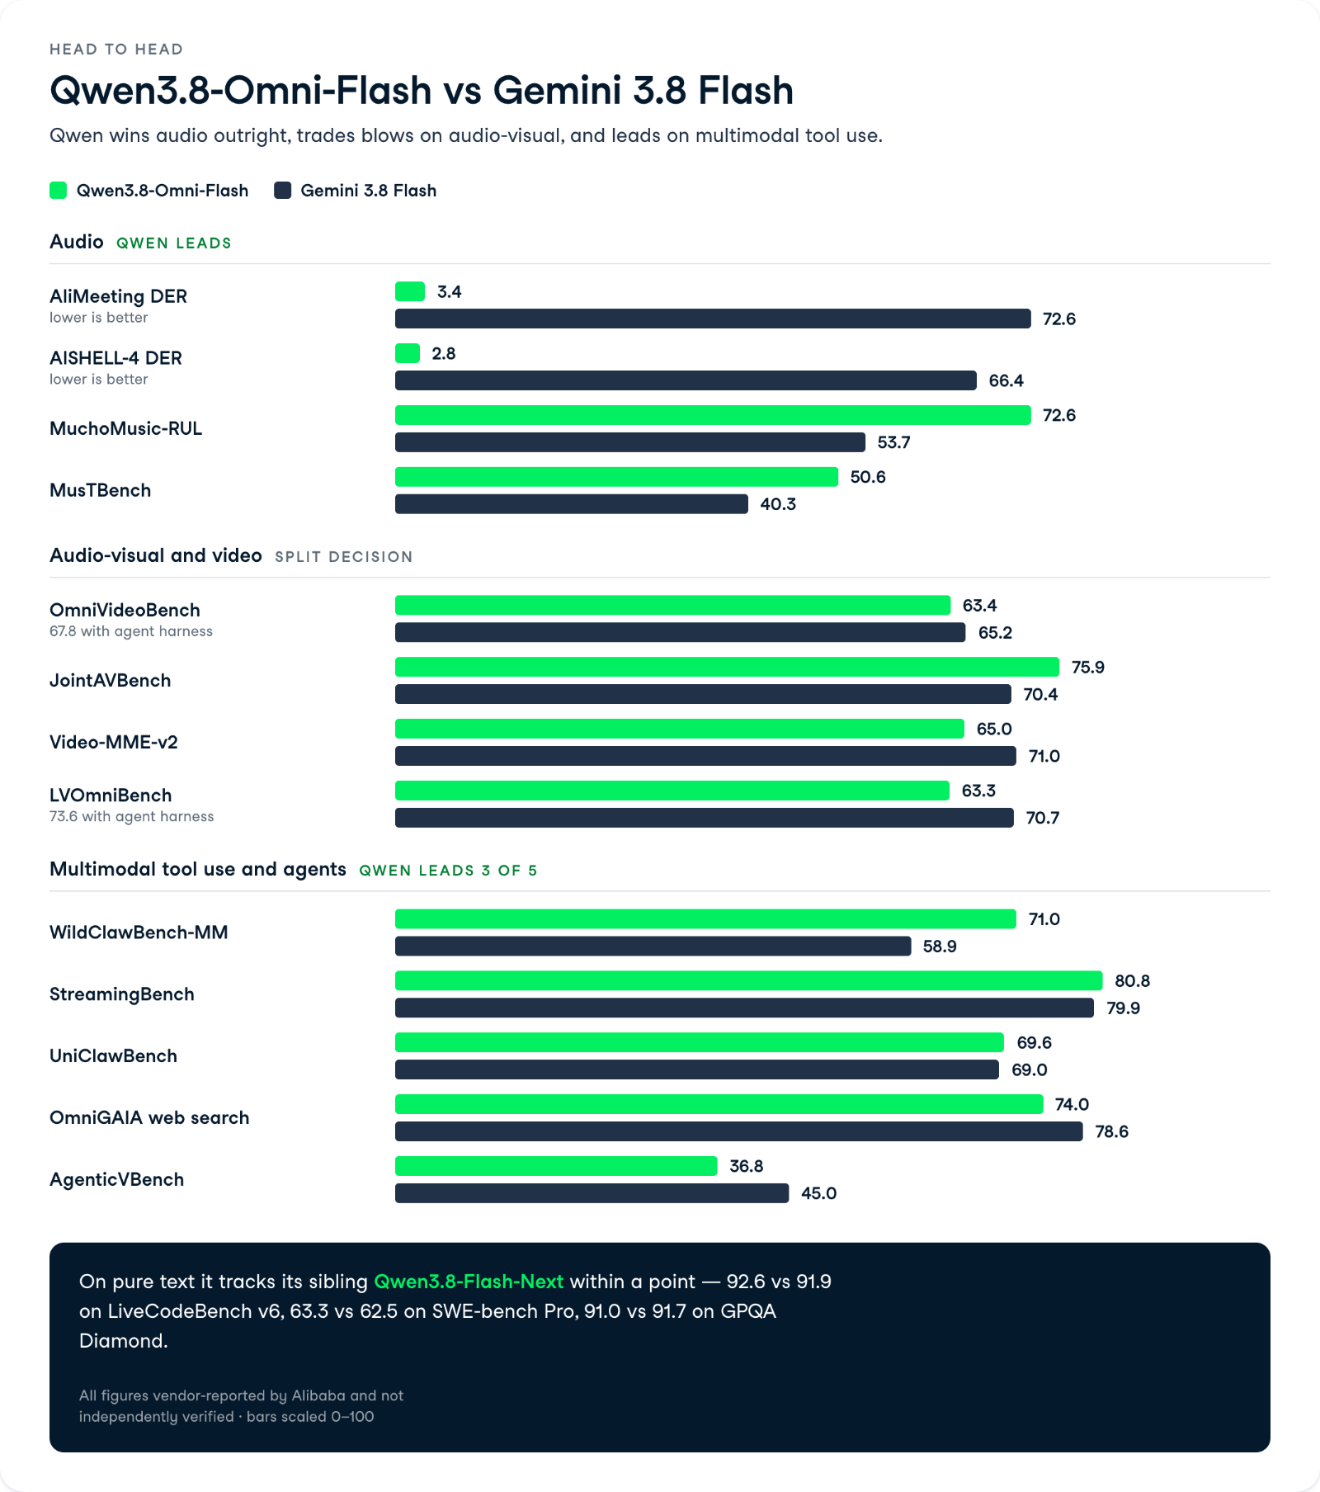
Qui il modello è più forte e supera Gemini 3.8 Flash con ampio margine.
Nel test ASR multi-speaker AliMeeting registra un tasso di errore di diarizzazione di 3,4 contro il 72,6 di Gemini 3.8 Flash, e su AISHELL-4 arriva a 2,8 contro i 66,4 di Gemini, segno che Gemini fatica molto con parlanti sovrapposti.
Il tasso di errore di diarizzazione misura quanto bene un modello attribuisce il parlato allo speaker corretto, quindi un punteggio basso conta per verbali di riunioni, trascrizioni di interviste e qualsiasi workflow in cui le persone parlano una sull’altra.
Sulla comprensione musicale, conduce nettamente, totalizzando 72,6 su MuchoMusic-RUL contro i 53,7 di Gemini e 50,6 su MusTBench contro 40,3.
Qui Gemini 3.8 Flash di solito è leggermente avanti, ma il divario è piccolo e si chiude quando Qwen gira in modalità agente.
Le righe di video reasoning sono più miste.
Su Video-MME-v2, Gemini guida 71,0 a 65,0 in statico, e su LVOmniBench Gemini tiene 70,7 contro 63,3 di Qwen, sebbene Qwen salti a 73,6 con il harness agentico.
Se il tuo lavoro richiede video reasoning intenso senza loop di agenti, Gemini mantiene il vantaggio.
La capacità d’agente è il punto di forza, e il risultato su WildClawBench-MM lo conferma: 71,0 per Qwen3.8-Omni-Flash contro 58,9 per Gemini 3.8 Flash e 41,9 per Seed 2.0 Lite.
Su UniClawBench i due sono praticamente alla pari a 69,6 e 69,0.
Gemini vince però AgenticVBench a 45,0 contro 36,8 di Qwen e OmniGAIA web search a 78,6 contro 74,0.
Quindi la storia dell’uso degli strumenti è reale, ma non un cappotto. Su StreamingBench, un benchmark d’interazione, Qwen è nettamente avanti a 80,8 contro 79,9 di Gemini e 57,1 del predecessore.
Su puro testo, Qwen3.8-Omni-Flash segue da vicino il fratello solo testo Qwen3.8-Flash-Next, di solito entro un punto.
Ottiene 92,6 su LiveCodeBench v6 (Qwen3.8-Flash-Next: 91,9), 63,3 su SWE-bench Pro (Qwen3.8-Flash-Next: 62,5) e 91,0 su GPQA Diamond (Qwen3.8-Flash-Next: 91,7).
Contro DeepSeek-V4-Flash-0731, Qwen3.8-Omni-Flash è avanti su SWE-bench Pro (63,3 vs 56,0) e IFBench (81,5 vs 79,2), ma DeepSeek vince NL2Repo-Bench a 54,2 contro 48,9.
Quando abbiamo testato DeepSeek-V4-Flash-0731, lo abbiamo trovato il miglior modello di coding locale provato fino ad allora, quindi un modello omnimodale di livello Flash che lo eguaglia sull’ingegneria del software a livello di repository è un risultato concreto.
Qwen3.8-Omni-Flash è disponibile in due varianti più un’impostazione regolabile di reasoning, quindi la scelta giusta dipende dal fatto che ti serva analisi profonda dei contenuti o interazione live.
La distinzione è semplice:
Non useresti il modello base per una conversazione live, né Realtime per renderizzare un commento su un film di due ore.
Oltre alla scelta di variante, il modello base espone un parametro reasoning_effort con impostazioni xhigh (predefinita), medium e low, che ti permette di scambiare profondità di ragionamento con velocità e costo.
Usa low per didascalie ad alto volume dove conta la velocità e xhigh per pianificazioni multi-step come la scrittura di commenti.
| Use case | Variant | Why |
|---|---|---|
| Creazione di MV e commenti cinematografici | Qwen3.8-Omni-Flash | Pianificazione di lungo orizzonte e chiamate a strumenti su file completi |
| Verbali di riunione e action item | Qwen3.8-Omni-Flash | Riconoscimento congiunto audio-visivo degli speaker, fino a 1 ora di input |
| Assistenti vocali live e customer service | Qwen3.8-Omni-Flash-Realtime | Tempo al primo pacchetto audio inferiore a 1,4 s, Skills per iniezione di conoscenza |
| Audio spaziale e navigazione | Qwen3.8-Omni-Flash-Realtime | Localizza bersagli dal suono in tempo reale |
Elenchi di terze parti indicano Qwen3.8-Omni-Flash a circa $0,15 in input / $0,47 in output per 1M di token di testo, con OmniaKey e LLM Reference che citano le tariffe ufficiali. Venice API elenca una rotta correlata Qwen 3.8 Flash a $0,14 in input / $0,49 in output. Questi sono prezzi per il testo.
Gli input audio e audio-visivi costano di più, ed è questa la nota importante. L’indicazione prezzi di Puter segnala che l’input audio ha un sovrapprezzo rispetto al testo, e il confronto di Alibaba mette il prezzo dell’input audio-visivo contro Gemini 3.8 Flash invece di citare una tariffa flat per token. Alibaba afferma che il prezzo orario dell’input audio è calato di oltre il 98% rispetto a Qwen3.5-Omni-Plus e quello audio-visivo di oltre il 93%, quindi il sovrapprezzo è minore di prima, ma esiste ancora.
Il modello è generalmente disponibile ora sulla piattaforma Qianwen AI e instradato tramite Alibaba Cloud Model Studio, con endpoint a Pechino e Singapore. Nelle note di rilascio non è descritto alcun tier consumer gratuito.
L’ID del modello API è qwen3.8-omni-flash e la variante realtime è qwen3.8-omni-flash-realtime.
Supporta le API Chat Completions e Responses compatibili con OpenAI, e gli strumenti multimodali si collegano agli harness per agenti, tra cui Codex, Claude Code, Qwen Code e Gemini CLI tramite Qwen-MM-Plugins.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{"role": "user", "content": "Summarize this meeting recording."}],
    reasoning_effort="xhigh",  # xhigh, medium, or low
)
print(completion.choices.message.content)
Una spigolosità segnalata: utenti GitHub hanno evidenziato interruzioni frequenti e instabilità di sessione usando Qwen3.8-Omni-Flash con Claude Code, quindi metti in conto tempo per il troubleshooting dell’harness.
Per ulteriori informazioni sulla configurazione, vedi il nostro tutorial sull’esecuzione di modelli di classe Flash e la nostra guida a Qwen3.8-Max.
Alibaba sta ritagliando una corsia specifica invece di inseguire ogni rivale Flash sul testo.
Rispetto a Qwen3.8-Flash-Next, GLM-5.3-Flash, Gemini 3.8 Flash e DeepSeek V4.1 Flash, qui l’offerta è agenti audio e video più il prezzo del testo più basso del gruppo.
Io sceglierei questo modello se il tuo lavoro coinvolge trascrizione di riunioni, localizzazione video o produzione di MV e commenti, dove gli strumenti per agenti audio-visivi e i progressi sulla diarizzazione AliMeeting spiccano davvero.
Per solo testo o codice, Qwen3.8-Flash-Next ottiene punteggi leggermente superiori, e Gemini 3.8 Flash resta avanti su alcuni aspetti del video reasoning, quindi non è un sostituto predefinito per tutti.
Se vuoi prendere confidenza con i workflow a agenti e i modelli multimodali, ti consiglio di iniziare con il percorso di competenze AI Fundamentals.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



