Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
10.7K
Z.ai ha rilasciato GLM-5.3-Flash, il modello ottimizzato per i costi che affianca il suo flagship GLM-5.3. È arrivato con un nome in codice anonimo in anteprima, per poi essere rivelato pubblicamente come "Ox Alpha". Qwen3.8-Flash-Next è stato lanciato lo stesso giorno, quindi il segmento LLM a budget si è affollato in fretta.
Se stai seguendo la corsa tra i laboratori cinesi open-weight e la frontiera occidentale, questo merita attenzione.
L'affermazione principale è semplice: prestazioni di coding e agentiche quasi di frontiera a una frazione del costo.
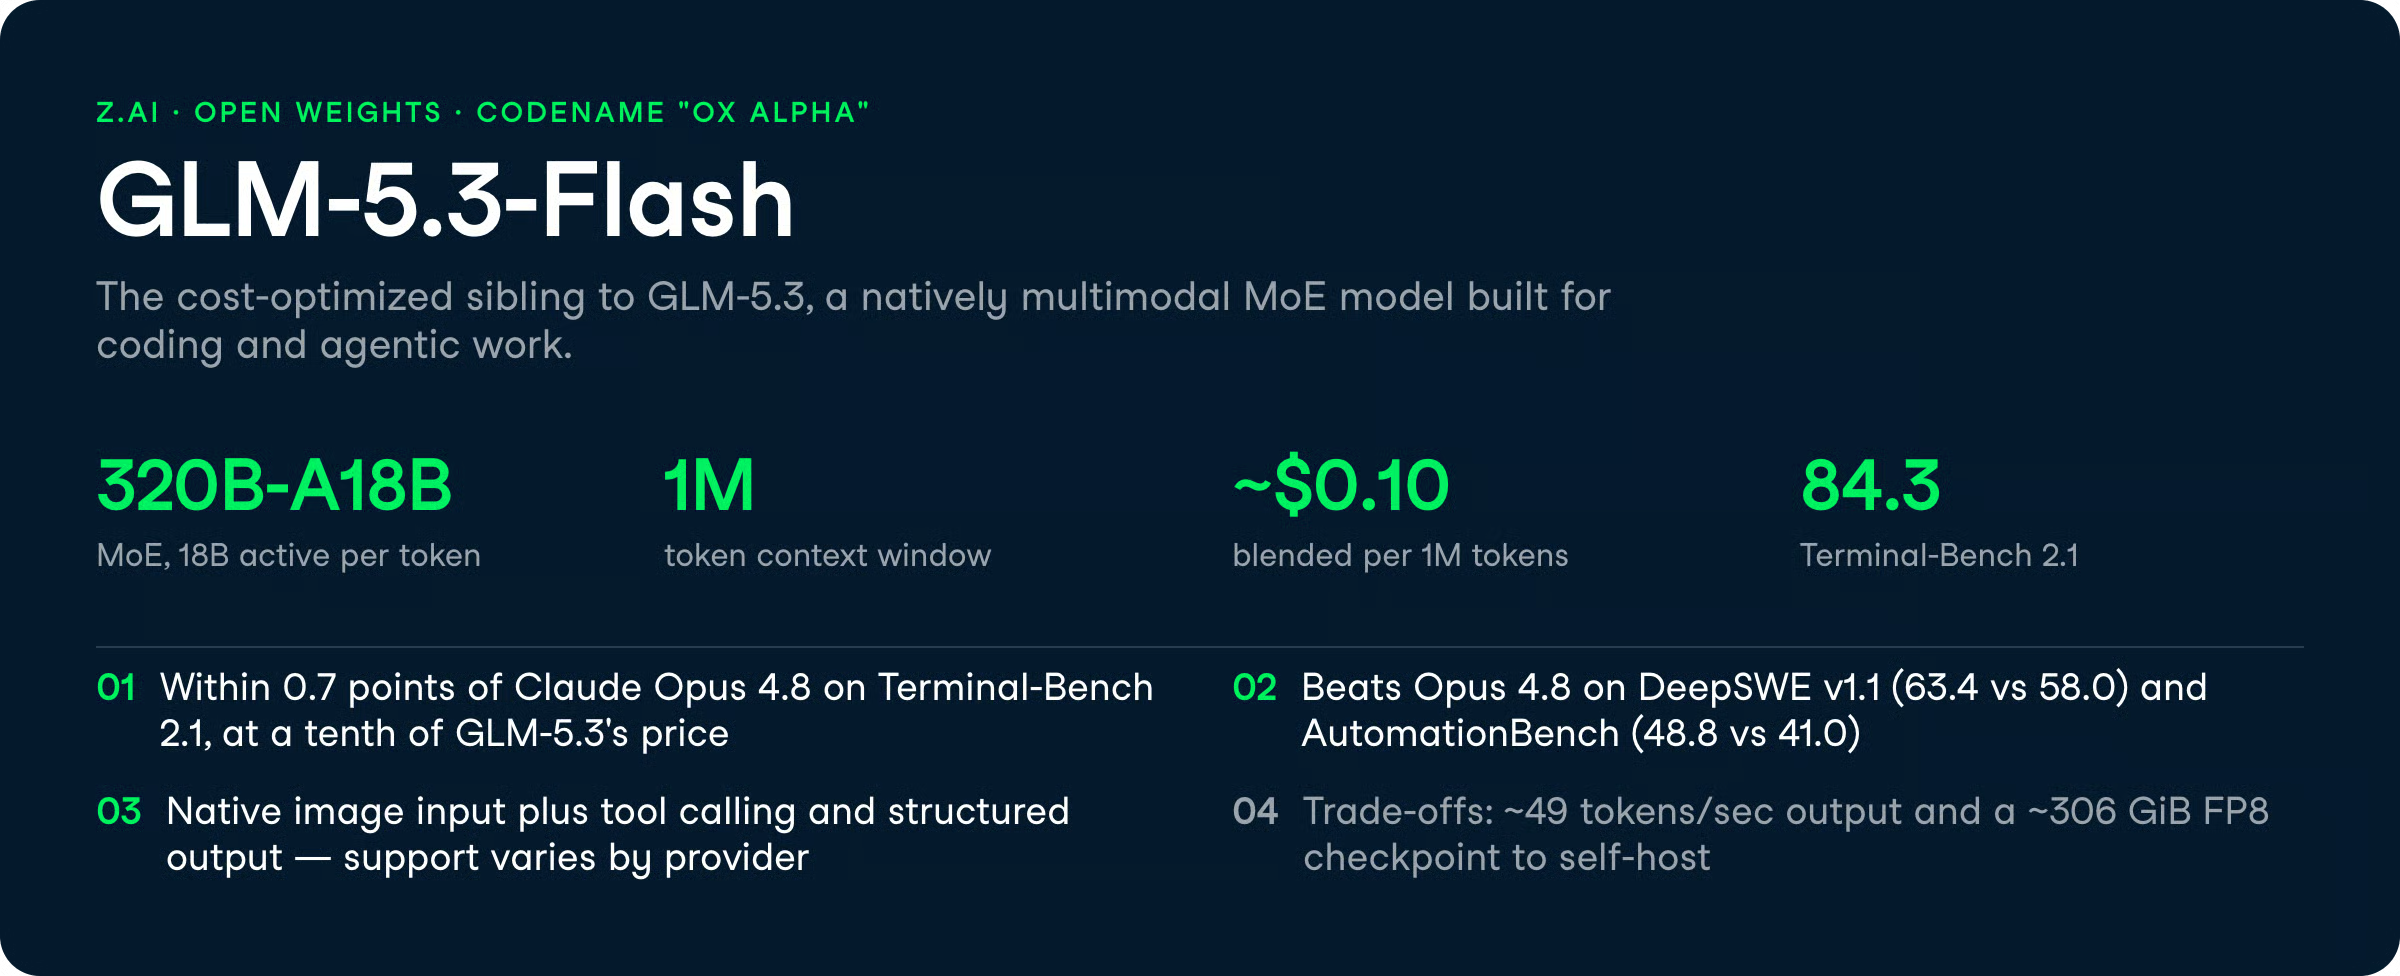
GLM-5.3-Flash ottiene 84,3 su Terminal-Bench 2.1, che lo mette a distanza ravvicinata di Claude Opus 4.8 (85,0) e GPT-5.6 Terra (87,4).
Utilizza un design mixture-of-experts in configurazione 320B-A18B (320B parametri aggregati, 18B attivi per token), supporta una finestra di contesto da 1M token ed è nativamente multimodale.
In questo articolo, vedremo tutto ciò che c'è di nuovo in GLM-5.3-Flash, analizzando le funzioni e i benchmark. Per vedere il modello in azione, dai un'occhiata al nostro tutorial su GLM-5.3-Flash, in cui lo usiamo con CrewAI per creare un team multi-agente di analisti finanziari.
Se vuoi confrontarlo con l'altro modello budget uscito lo stesso giorno, consulta la nostra guida a Qwen3.8-Flash-Next, e per un modello MoE simile che abbiamo eseguito in locale, dai un'occhiata al nostro tutorial su come eseguire DeepSeek-V4-Flash-0731.
GLM-5.3-Flash è il modello ottimizzato per i costi della famiglia GLM-5.3 di Z.ai, al di sotto del flagship GLM-5.3 per capacità ma molto più economico.
Artificial Analysis lo valuta con un indice di intelligenza pari a 57, rispetto ai 60 di GLM-5.3.
Lo scambio è tra velocità e costo: Flash serve a circa un decimo del prezzo di GLM-5.2, o circa un nono del prezzo blended di GLM-5.3, e genera token più lentamente.
Il modello è stato distribuito inizialmente come anteprima anonima prima di essere nominato, e la community gli ha rapidamente attribuito il nome in codice "Ox Alpha".
Il checkpoint pubblico è disponibile come zai-org/GLM-5.3-Flash su Hugging Face, con supporto per contesti lunghi (~1M token) e funzionalità di tool calling e multimodalità esposte dall'ecosistema circostante.
Il benchmark più rilevante qui è Terminal-Bench 2.1, dove GLM-5.3-Flash raggiunge 84,3. È sopra l'82,7 che abbiamo visto per DeepSeek-V4-Flash-0731 e solo 0,7 punti dietro Claude Opus 4.8. Per un modello con prezzo blended stimato intorno a $0,10 per 1M token, questo è il punto chiave del rilascio.
GLM-5.3-Flash è pensato per gli sviluppatori che vogliono prestazioni agentiche e di coding senza i prezzi da flagship.
Ecco le capacità che contano nel lavoro pratico.
Puoi eseguire agenti di coding e workflow di automazione a un prezzo che rende realistico l'uso ad alto volume.
GLM-5.3-Flash ottiene 84,3 su Terminal-Bench 2.1 e 63,4 su DeepSWE v1.1, in netto aumento rispetto ai 46,2 di GLM-5.2 sullo stesso eval DeepSWE.
Per i professionisti, il vantaggio è poter eseguire compiti di coding che su modelli di classe Opus sarebbero costosi.
Alcuni confronti presentano Flash come "solido" per coding e agenti di automazione a un costo sensibilmente inferiore rispetto a GLM-5.3, e il salto su DeepSWE rispetto a GLM-5.2 suggerisce miglioramenti reali nel coding e non solo specifici del benchmark.
Puoi fornire interi codebase, documenti lunghi o tracce multi-file di agenti in un'unica richiesta.
GLM-5.3-Flash supporta una finestra di contesto da 1M token, in linea con GLM-5.3 e con le finestre da 1M di GPT-5.6 Terra e Claude Sonnet 5.
Tuttavia, alcuni report della community menzionano un "drift" dell'attenzione a lunghezze estreme oltre ~700K token, una limitazione condivisa dalla maggior parte dei pari con contesti molto ampi.
Si riscontra un buon richiamo su centinaia di migliaia di token, ma non dare per scontato un recupero perfetto all'estremo della finestra.
Puoi collegare GLM-5.3-Flash a framework di agenti con function call e schemi JSON vincolati. Il modello ottiene 78,4 su Toolathlon e 48,8 su AutomationBench, quest'ultimo un forte balzo rispetto ai 26,2 di GLM-5.2.
Una cosa da considerare: il supporto varia a seconda del provider.
Alcuni gateway indicano l'output strutturato come non supportato e la gestione dei system prompt differisce tra i provider hosted, quindi potresti dover adattare lo schema degli strumenti e la modalità JSON per endpoint.
Puoi inviare immagini insieme al testo per leggere grafici, analizzare documenti e ragionare visivamente.
GLM-5.3-Flash ottiene 89,4% su CharXiv-R, 80,5 su MMVU e 78,0 su Chartography, a indicare una gestione solida di grafici e documenti visivi.
Il supporto multimodale è nativo e non aggiunto a posteriori, anche se, come per il tool calling, la superficie esatta dipende dal provider che usi. Un checkout "puro" su Hugging Face potrebbe non esporre tutto ciò che fa l'API hosted.
GLM-5.3-Flash ottiene 57 sull'Artificial Analysis Intelligence Index v4.1.1 a $0,045 per task (scontato). Z.ai afferma che quel livello di intelligenza prima costava circa dieci volte tanto.
La valutazione su sei benchmark qui sotto confronta Flash con GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra e Gemini 3.7 Flash.
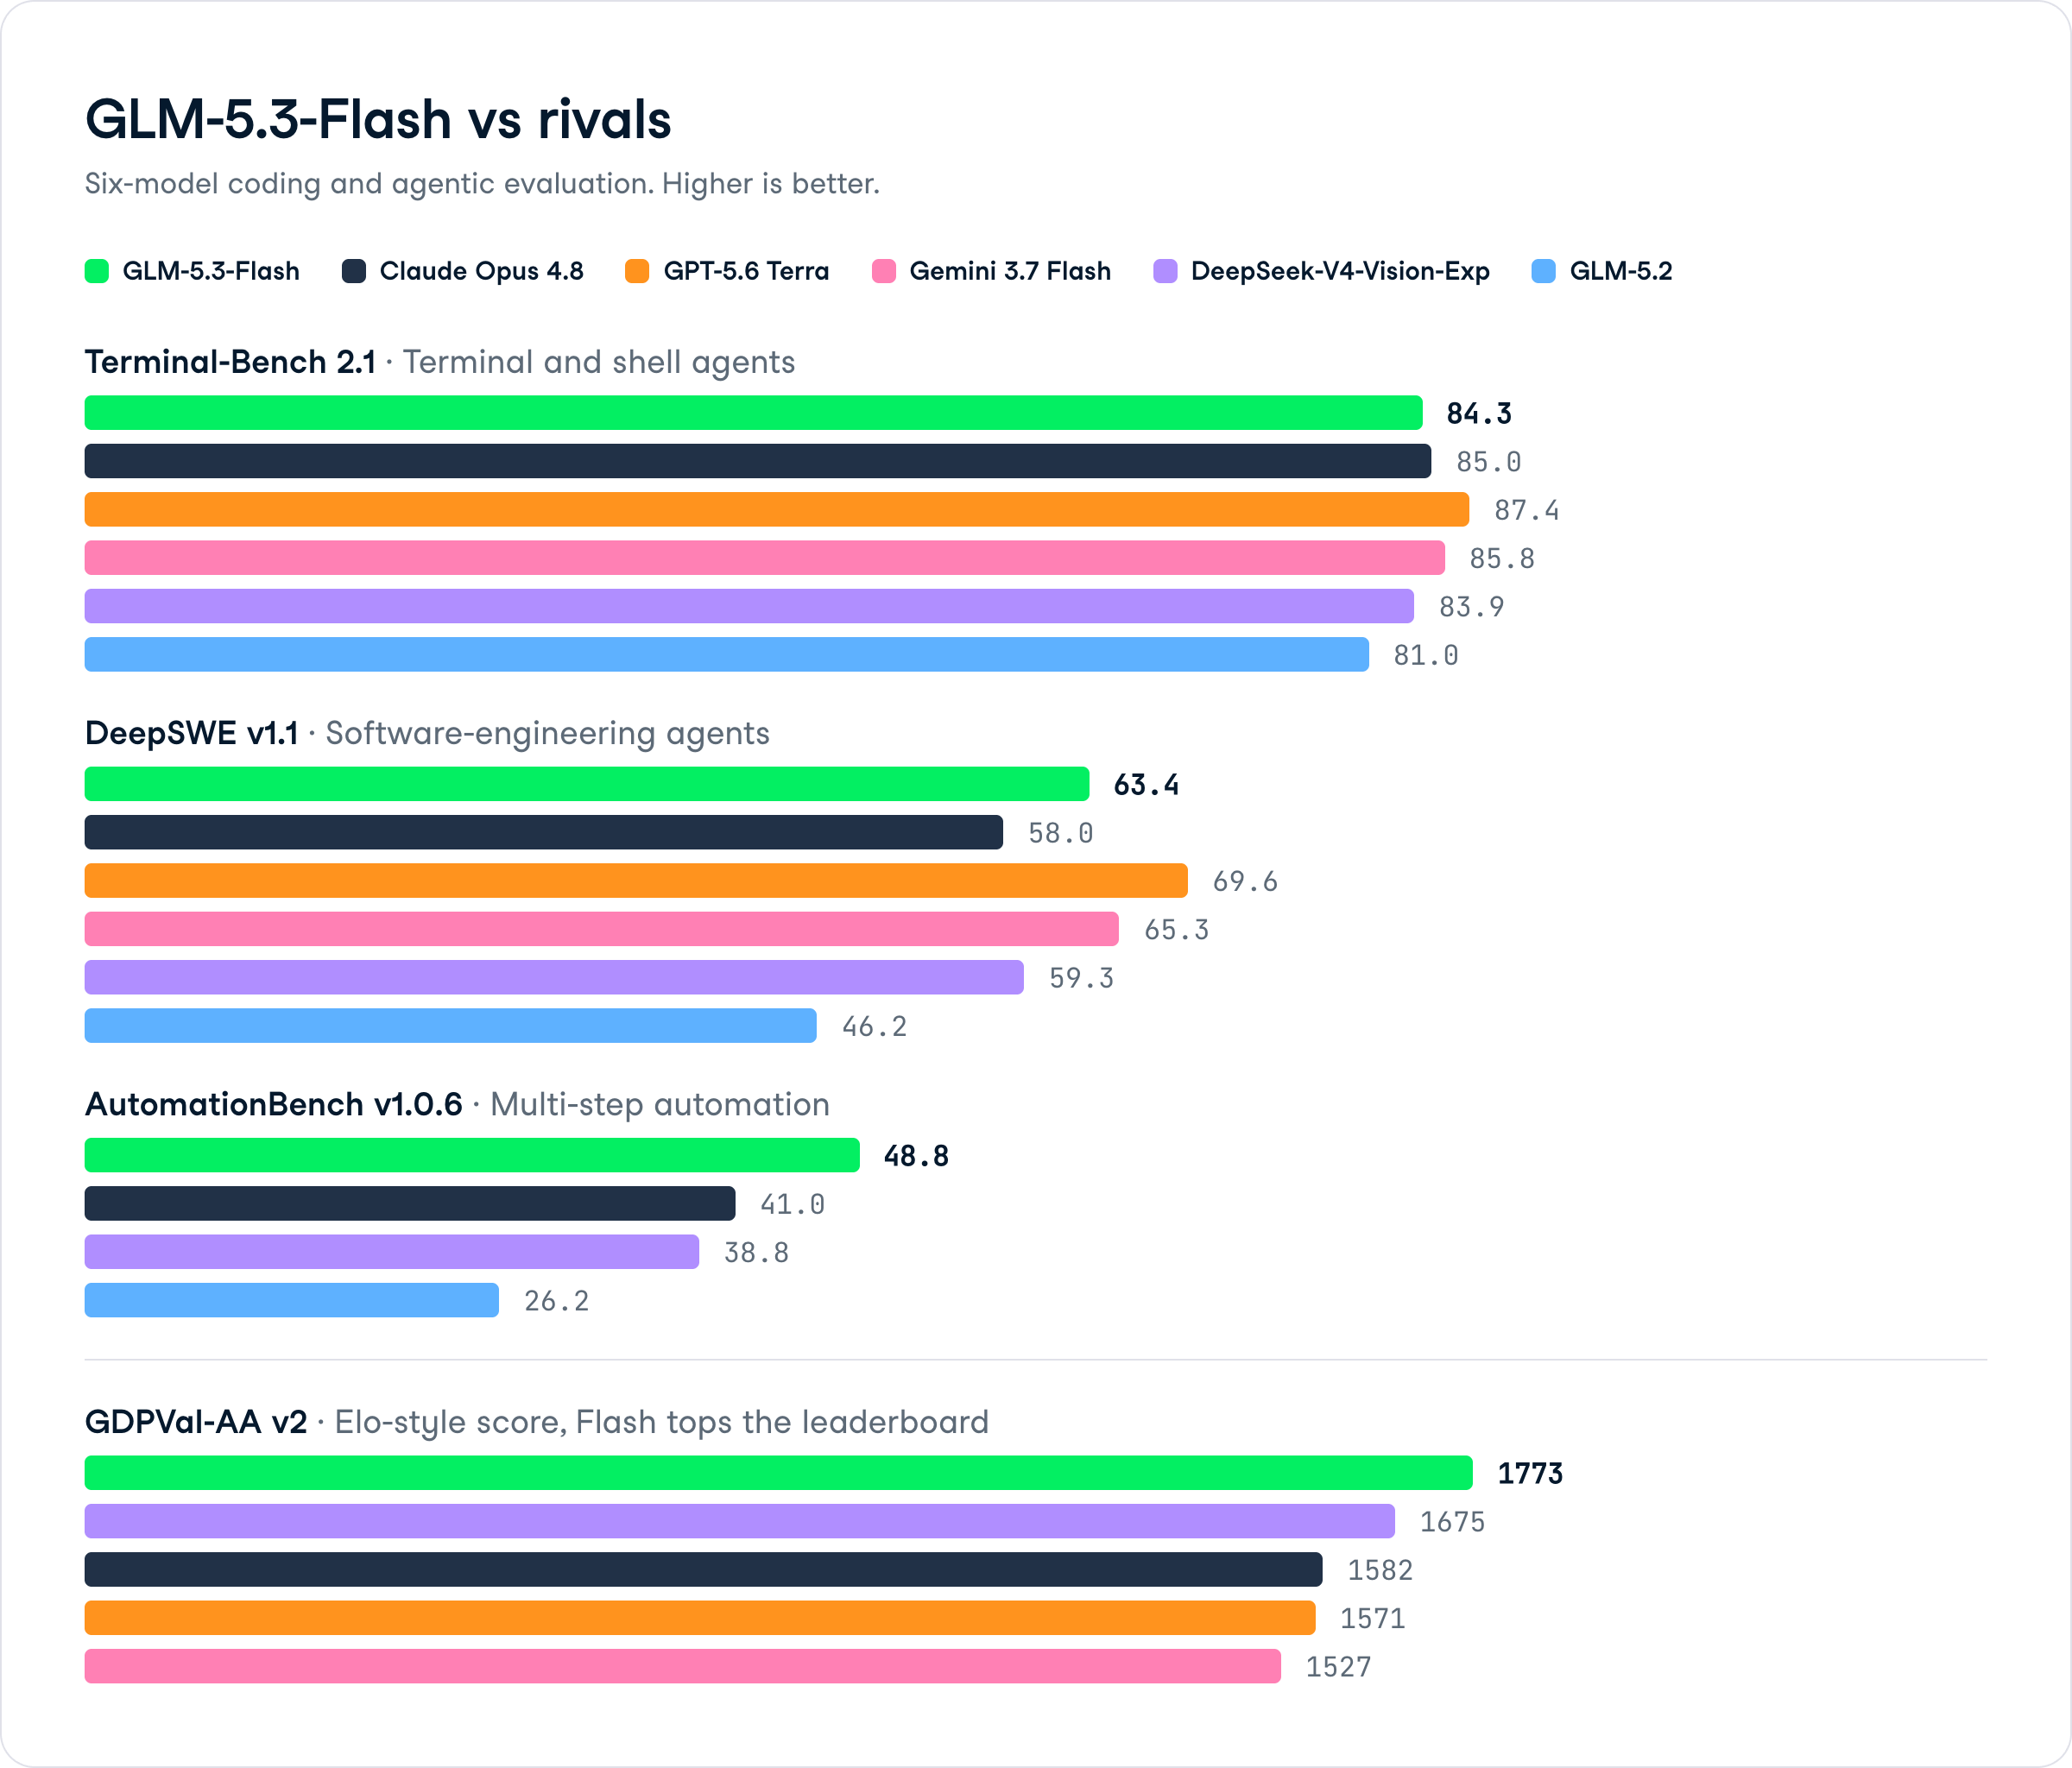
Su questo benchmark per agenti di ingegneria del software, GLM-5.3-Flash ottiene 63,4, davanti a Claude Opus 4.8 (58,0) e DeepSeek-V4-Vision-Exp (59,3), e in crescita rispetto ai 46,2 di GLM-5.2.
È dietro a GPT-5.6 Terra (69,6) e Gemini 3.7 Flash (65,3), ma battere Claude a costo da Flash è il punto pratico qui.
GLM-5.3-Flash ottiene 48,8 sui workflow di automazione multi-step, il vantaggio più ampio su Claude Opus 4.8 (41,0) e DeepSeek-V4-Vision-Exp (38,8) tra tutti i benchmark del set.
GLM-5.2 aveva ottenuto 26,2, quindi è anche il miglior miglioramento generazionale.
Su questa valutazione generale di sviluppo e programmazione, Flash è in cima alla classifica con 1773, davanti a DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571) e Gemini 3.7 Flash (1527).
Flash ottiene 84,3 su task per agenti da terminale e shell, poco sotto Claude Opus 4.8 (85,0) e Gemini 3.7 Flash (85,8), e dietro GPT-5.6 Terra (87,4). Supera di poco GLM-5.2 (81,0) e DeepSeek-V4-Vision-Exp (83,9). Competitivo, non dominante.
GLM-5.3-Flash è disponibile tramite l'API di Z.ai e attraverso vari gateway di terze parti, tra cui Baseten, Deep Infra, Venice AI e Requesty.
Il checkpoint pubblico zai-org/GLM-5.3-Flash è su Hugging Face per l'auto-hosting.
I prezzi ufficiali di listino di Z.ai e la promozione a tempo limitato sono i seguenti:
Apidog riporta un prezzo blended, ponderato per l'uso, di circa $0,10 per 1M token per Flash, contro circa $0,90 per GLM-5.3.
I gateway di terze parti lo prezzano diversamente: EmpirioLabs a $0,07 in input / $0,25 in output, Venice AI a $0,09 / $0,31 e Requesty a $0,14 / $0,45 con promozione -55% indicata fino al 9 set 2026.
La nota dolente è il throughput e l'hardware.
Flash serve a ~49 token/sec contro ~86 per GLM-5.3, e Artificial Analysis lo valuta 2/4 in velocità.
L'auto-hosting non è leggero: il checkpoint FP8 è ~306 GiB solo di pesi, prima di KV-cache e runtime, quindi servono più GPU con molta memoria (pensa a >4×80 GiB) invece di una singola scheda.
La scelta tra i due dipende da costo, indice di intelligenza e throughput. La tabella qui sotto riassume il compromesso.
| Attributo | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Indice di intelligenza (Artificial Analysis) | 57 | 60 |
| Prezzo blended / 1M token | ~$0,10 | ~$0,90 |
| Velocità di output | ~49 token/sec | ~86 token/sec |
| Tempo al primo token | ~1,52 s | ~1,57 s |
| Terminal-Bench 2.1 | 84,3 | N/D nelle note |
| Finestra di contesto | 1M | 1M |
Scegli Flash quando il vincolo è il costo per token e il tuo lavoro è coding o agentico. Scegli GLM-5.3 quando ti servono i 3 punti extra di indice di intelligenza e circa il doppio del throughput.
Entrambi i modelli sono stati lanciati il 26 agosto 2026, puntando allo stesso segmento agentico a budget. GLM-5.3-Flash supera di poco Qwen3.8-Flash-Next nell'unico benchmark condiviso direttamente (DeepSWE v1.1: 63,4 vs 58,7), ma i due modelli sono abbastanza diversi che la scelta dipende più dal tuo carico di lavoro che da un singolo punteggio.
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| Architettura | 320B totali / 18B attivi | 125B totali / 6B attivi |
| Contesto nativo | 1M token | 262K (1M con YaRN) |
| DeepSWE v1.1 | 63,4 | 58,7 |
| Prezzo input | ~$0,075/1M (promo) | $0,16/1M |
| Multimodale | Sì (nativo) | Sì (nativo) |
GLM-5.3-Flash attiva tre volte i parametri per token, il che probabilmente spiega il vantaggio su DeepSWE e il risultato su Terminal-Bench 2.1 (84,3).
Qwen3.8-Flash-Next risponde con punteggi dichiarati più forti su SWE-bench Pro (62,5) e benchmark d'ufficio e agentici come CoWorkBench (73,9) e JobBench (55,7), dove GLM non pubblica cifre comparabili.
Sul prezzo, GLM è più economico durante la finestra promozionale. In termini di efficienza dei parametri, Qwen fa di più con un'impronta attiva più piccola. Per l'auto-hosting, il checkpoint più ridotto di Qwen è significativamente più semplice da eseguire in locale.
Se la tua priorità sono agenti di coding e throughput agentico puro, GLM-5.3-Flash ha numeri più forti dove il confronto è diretto. Se i tuoi workflow sono orientati all'ufficio, multimodali o traggono vantaggio da un checkpoint auto-hosted più piccolo, vale la pena testare prima Qwen3.8-Flash-Next.
Consulta la nostra guida completa a Qwen3.8-Flash-Next per un'analisi dettagliata.
GLM-5.3-Flash segna una scommessa chiara di Z.ai sul segmento agentico a budget: avvicinarsi a uno-due punti da Opus 4.8 e GPT-5.6 Terra nelle valutazioni di coding, poi batterli di un ordine di grandezza sul prezzo.
L'84,3 su Terminal-Bench 2.1 a circa $0,10 blended per 1M token è l'argomento, ed è convincente per coding e automazione ad alto volume.
Le limitazioni riguardano velocità e infrastruttura.
A ~49 token/sec non è il modello per streaming sensibile alla latenza, e il checkpoint FP8 da ~306 GiB esclude un deployment locale casual. I primi utenti in anteprima su r/opencodeCLI hanno segnalato code e avvii lenti sotto carico, anche se la GA probabilmente ha migliorato la situazione.
La mia opinione è che, se il vincolo è il costo per token e il tuo lavoro è coding o agentico, valga la pena testare GLM-5.3-Flash rispetto a GPT-5.6 Terra e Claude Opus 4.8 prima di decidere.
Se ti servono i 3 punti extra di indice di intelligenza e un throughput più rapido, il full GLM-5.3 esiste per un motivo. È uscito anche lo stesso giorno di Qwen3.8-Flash-Next, quindi in questo momento conviene guardarsi intorno nel segmento budget.
Se vuoi prendere dimestichezza con modelli di questo tipo, ti consiglio il nostro percorso di competenze AI Fundamentals per costruire le basi, poi il nostro tutorial su come eseguire localmente un modello MoE Flash per la parte pratica.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min