
Last chance! 50% off DataCamp Premium
Sale ends in
Gelombang model kelas Flash saat ini terus bermunculan.
Baru-baru ini kami membahas Qwen3.8-Flash-Next, GLM-5.3-Flash, Gemini 3.8 Flash, dan DeepSeek V4.1 Flash, yang semuanya bersaing untuk slot inferensi cepat dan sensitif biaya di pasar.
Tim Qwen dari Alibaba kini menambahkan sudut baru dalam persaingan tersebut dengan Qwen3.8-Omni-Flash, model omnimodal native yang dibangun untuk agen audio dan video.
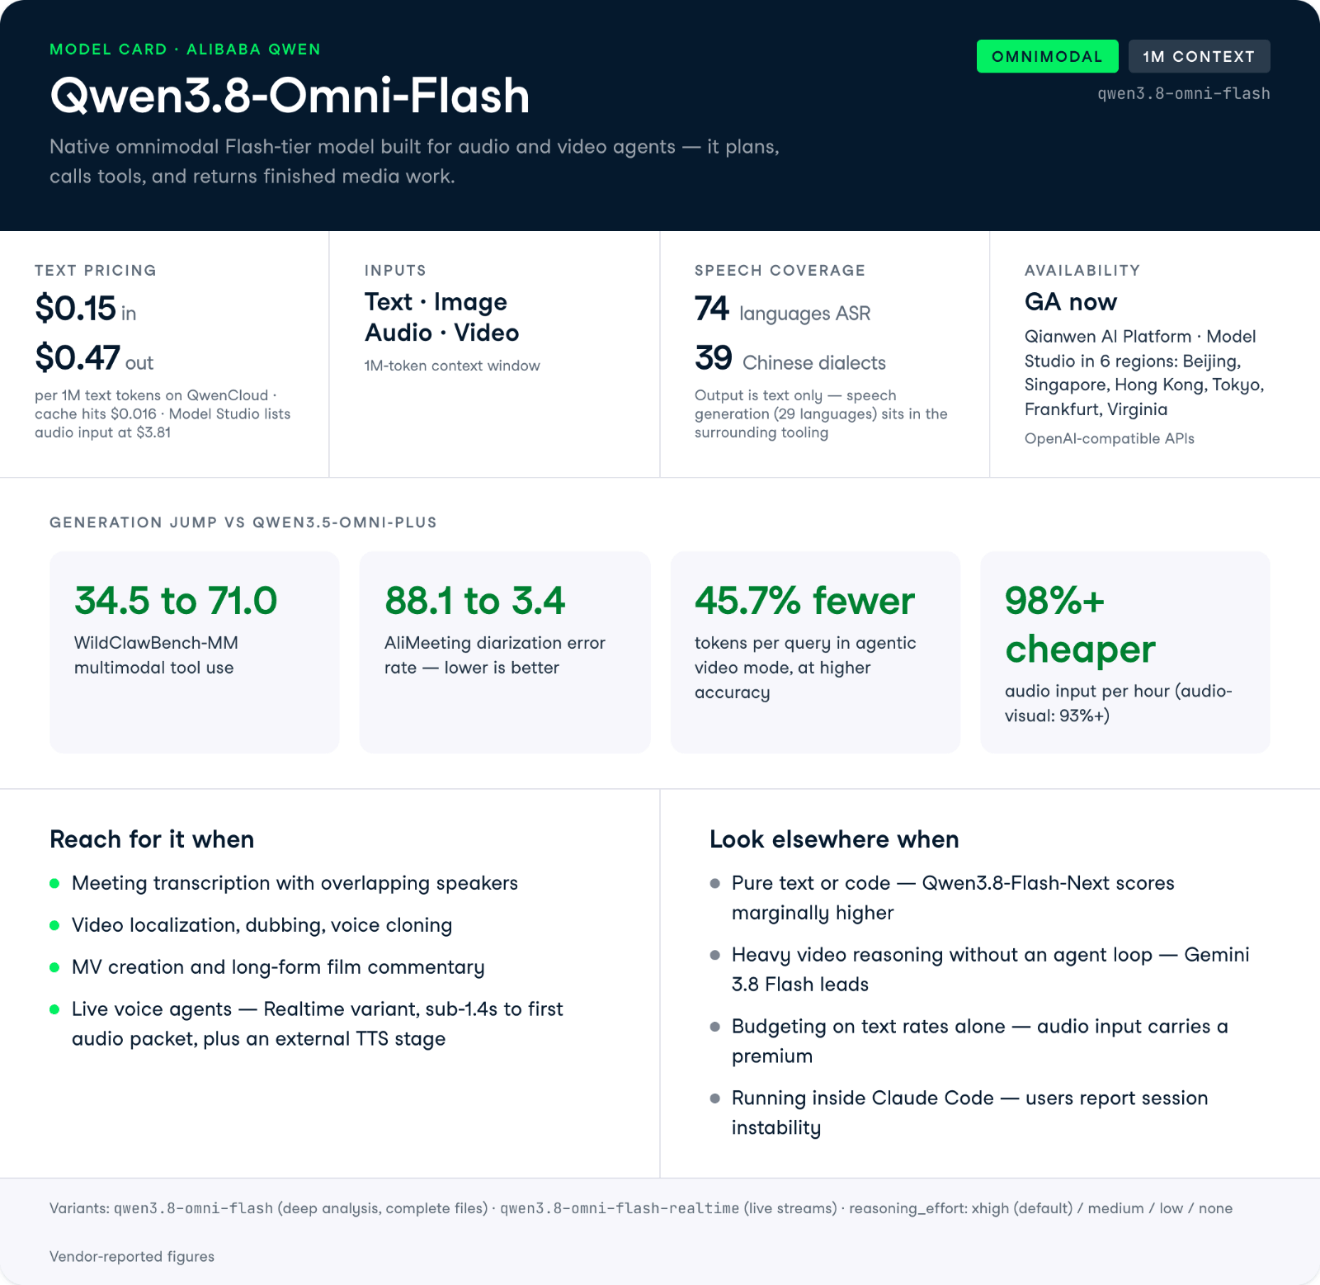
Qwen3.8-Omni-Flash menerima masukan teks, gambar, audio, dan video dengan jendela konteks 1 juta token. Alibaba mengklaim kinerja audio-visual yang mendekati Gemini 3.8 Flash dan kinerja audio keseluruhan yang melampauinya, disertai peningkatan rata-rata 25%+ dibanding pendahulunya Qwen3.5-Omni-Plus dalam 29 evaluasi. Peningkatan utama untuk agen adalah lonjakan 36,5 poin pada WildClawBench-MM dan penurunan harga per jam untuk input audio lebih dari 98%.
Dalam artikel ini, saya akan membahas semua hal baru pada Qwen3.8-Omni-Flash, melihat fitur-fitur barunya, membandingkannya dengan model Flash lain yang telah kami ulas, dan mengulas tolok ukurnya.
Untuk mempelajari lebih lanjut bagaimana model-model ini dibandingkan, lihat panduan kami tentang DeepSeek V4.1 Flash vs Gemini 3.8 Flash dan perbandingan kami GLM-5.3 Flash vs Qwen3.8-Flash-Next.
Qwen3.8-Omni-Flash adalah model omnimodal native dari tim Qwen Alibaba, berada di tier Flash sebagai opsi hemat biaya dengan throughput tinggi dalam lini produknya.
Model ini memproses teks, gambar, audio, dan video dalam satu model dan mendukung jendela konteks 1 juta token, sambil menjaga kinerja teks setara dengan model khusus teks berukuran sama.
Tujuan generasi ini adalah kapabilitas agen dalam audio dan video, bukan sekadar memahaminya.
Jika Qwen3.5-Omni-Plus berfokus pada interpretasi konten omnimodal, Qwen3.8-Omni-Flash dibangun untuk merencanakan tugas, memanggil alat, dan menyelesaikan karya kreatif seperti penyuntingan video, pembuatan music video, dan ulasan film.
Alibaba memposisikannya sebagai memindahkan audio dan video dari input perseptual menjadi media inti tempat agen bernalar dan mengeksekusi.
Klaim besarnya adalah lonjakan 36,5 poin pada WildClawBench-MM menjadi 71,0 (Qwen3.5-Omni-Plus mencetak 34,5), plus kenaikan 22,3 poin pada AgenticVBench.
Saat diuji pada audio rapat nyata di mana orang sering berbicara bersamaan, sistem baru menunjukkan peningkatan besar dibanding yang lama:
Fitur-fitur di sini berpusat pada satu ide: memberi agen “tangan” untuk pekerjaan audio dan video, bukan hanya “mata” dan “telinga”.
Alibaba merilis model ini bersama dua lapisan tooling, Qwen-MM-Plugins untuk alur kerja horizon panjang dan Qwen-Live Harness untuk interaksi waktu nyata.
Anda dapat memberikan Qwen3.8-Omni-Flash sebuah lagu atau film berdurasi penuh lalu menjelaskan kebutuhan Anda dalam satu kalimat, dan model ini akan merencanakan tugas, memanggil alat kreatif, serta mengembalikan video yang telah selesai.
Model ini mendukung alur kerja end-to-end, termasuk pembuatan music video, penerjemahan drama pendek dengan kloning suara, dan ulasan film berdurasi panjang.
Untuk film dua jam, model melakukan pemahaman video panjang, ekstraksi alur utama, perencanaan komentar, produksi sulih suara dan musik, penyuntingan, dan peninjauan kualitas akhir.
Model dapat menyisipkan dialog asli dengan narasi dan menyesuaikan kecepatan serta volume bicara agar lapisan audio menyatu.
Ini penting karena siklus terfragmentasi transkripsi—terjemahan—sulih suara—penyuntingan adalah biaya koordinasi yang sering menggagalkan proyek-proyek ini bagi kreator individu.
Anda menentukan apa yang dilihat model, seberapa teliti ia mengamati, dan bagaimana hasilnya disajikan, alih-alih menerima deskripsi tetap.
Pengguna dapat menentukan subjek, rentang waktu, tingkat detail, dan format keluaran untuk video yang sama.
Misalnya Anda memasukkan demo produk 40 menit. Anda bisa meminta ringkasan 200 kata untuk halaman listing, lalu menjalankan ulang klip yang sama dengan meminta keluaran skema JSON berisi stempel waktu per adegan, ekstraksi teks di layar, dan transkrip bertanda pembicara untuk pipeline lanjutan.
Pada OmniCap-IF, skor struktur konten dan kepatuhan instruksi (CSR dan ISR) meningkat masing-masing 8,5 dan 14,1 poin dibanding pendahulunya.
Alih-alih memproses seluruh rekaman berjam-jam, model memulai dari pertanyaan Anda dan memutuskan apa yang akan ditonton dan didengarkan melalui pengumpulan bukti dari kasar ke rinci.
Pendekatan ini memfokuskan komputasi dan token pada segmen relevan.
Pada OmniVideoBench, mode agen ini meningkatkan akurasi dari 63,4 menjadi 67,8 sambil memangkas konsumsi token dari 145.736 menjadi 79.117 per kueri, pengurangan sekitar 45,7%.
Bagi siapa pun yang membayar per token untuk rekaman berdurasi jam, efisiensi ini adalah fitur utama.
Varian terpisah, Qwen3.8-Omni-Flash-Realtime, mengindra dan merespons saat menerima stream audio-visual langsung dan memanfaatkan konteks waktu nyata untuk memanggil alat.
Model ini menangani latihan berbicara dengan umpan balik pelafalan, persepsi audio spasial, dan penyuntikan pengetahuan melalui Skills.
Klaim audio spasial adalah yang paling unik di sini: Alibaba mengatakan ini adalah model omnimodal pertama yang dapat menemukan target berdasarkan suara, menggabungkan audio terarah dengan informasi visual untuk menentukan arah dan jarak sumber.
Waktu ke paket audio pertama dilaporkan di bawah 1,4 detik bahkan untuk input audio-visual 20 detik.
Qwen3.8-Omni-Flash mendukung pengenalan ujaran dalam 74 bahasa dan 39 dialek Tionghoa, dari Mandarin dan Kanton hingga Sichuan, Shanghai, dan Minnan.
Generasi ujaran mencakup 29 bahasa dan 7 dialek.
Untuk alur kerja lokalisasi dan dubbing, keluasan dialek ini menjadi pembeda praktis terhadap sebagian besar model Flash pesaing, yang biasanya memublikasikan jumlah bahasa tetapi bukan cakupan tingkat dialek.
Salah satu demo yang lebih tidak biasa dalam rilis ini adalah Alibaba menggunakan Qwen3.8-Omni-Flash untuk meningkatkan model yang lebih kecil alih-alih langsung melayani pengguna.
Diberi waktu 12 jam untuk meningkatkan pengenalan dialek Sichuan pada Qwen2.5-Omni-3B, agen memilih set evaluasi WenetSpeech-Chuan, membangun baseline, dan mendiagnosis kesalahan dengan mendengarkan sampel audio.
Dalam empat putaran, agen membuat 3.413 contoh pelatihan, membatalkan percobaan yang gagal, dan memangkas tingkat kesalahan karakter dari 25,79% menjadi 15,30%, pengurangan relatif sekitar 40,7%.
Ini eksperimen kecil, tetapi mengarah pada skenario model besar yang mengarahkan pelatihan model kecil khusus untuk produksi.
Pola di seluruh tolok ukur konsisten: Qwen3.8-Omni-Flash menang telak di kategori audio, saling susul pada tugas audio-visual dengan Gemini 3.8 Flash, dan tetap kompetitif pada teks dibanding model saudara.
Model ini tidak selalu unggul, dan beberapa baris penalaran video masih memfavoritkan Gemini 3.8 Flash.
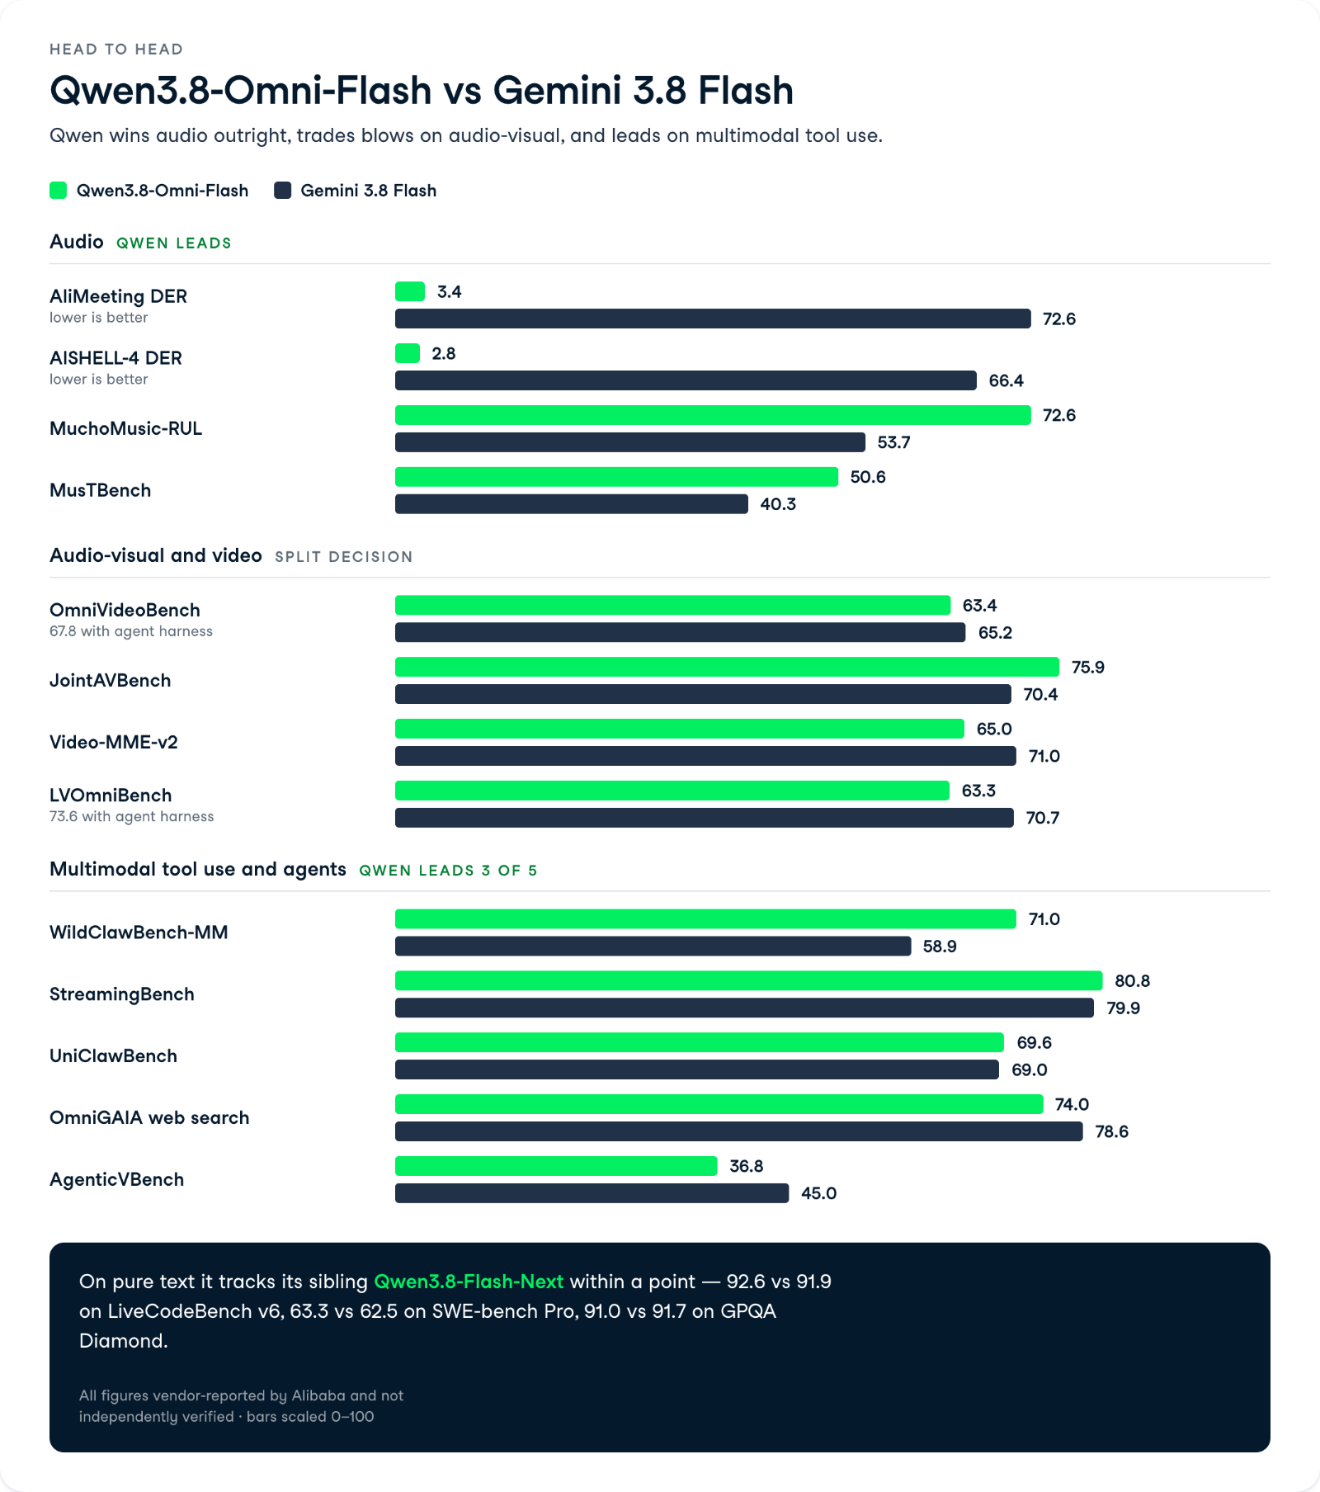
Inilah area terkuat model ini, dan di sini ia mengungguli Gemini 3.8 Flash dengan margin lebar.
Pada uji ASR multi-pembicara AliMeeting, model ini mencatat tingkat galat diarization 3,4 dibanding 72,6 milik Gemini 3.8 Flash, dan pada AISHELL-4 mencetak 2,8 versus 66,4 milik Gemini, yang mencerminkan kesulitan besar Gemini dengan pembicara yang tumpang tindih.
Tingkat galat diarization mengukur seberapa baik model mengatribusikan ujaran ke pembicara yang benar, sehingga skor rendah penting untuk notulen rapat, transkripsi wawancara, dan alur kerja apa pun dengan orang yang berbicara bersamaan.
Pada pemahaman musik, model ini juga unggul jelas, mencetak 72,6 pada MuchoMusic-RUL versus 53,7 milik Gemini dan 50,6 pada MusTBench versus 40,3.
Di sini, Gemini 3.8 Flash biasanya sedikit unggul, tetapi jaraknya kecil dan menutup ketika Qwen berjalan dalam mode agen.
Baris penalaran video lebih beragam.
Pada Video-MME-v2, Gemini unggul 71,0 versus 65,0 statis, dan pada LVOmniBench Gemini memegang 70,7 dibanding 63,3 milik Qwen, meski Qwen melonjak menjadi 73,6 dengan harness agen.
Jika pekerjaan Anda banyak penalaran video tanpa loop agen, Gemini masih lebih unggul.
Kemampuan agen adalah nilai jualnya, dan hasil WildClawBench-MM mendukungnya: 71,0 untuk Qwen3.8-Omni-Flash dibanding 58,9 untuk Gemini 3.8 Flash dan 41,9 untuk Seed 2.0 Lite.
Pada UniClawBench keduanya nyaris seri di 69,6 dan 69,0.
Gemini memang menang pada AgenticVBench di 45,0 dibanding 36,8 milik Qwen dan OmniGAIA web search di 78,6 dibanding 74,0.
Jadi cerita penggunaan alat itu nyata, tetapi bukan sapuan bersih. Pada StreamingBench, tolok ukur interaksi, Qwen memimpin tegas di 80,8 dibanding 79,9 milik Gemini dan 57,1 pendahulunya.
Untuk teks murni, Qwen3.8-Omni-Flash mengikuti saudara khusus teksnya Qwen3.8-Flash-Next dengan ketat, biasanya dalam selisih satu poin.
Model ini mencetak 92,6 pada LiveCodeBench v6 (Qwen3.8-Flash-Next: 91,9), 63,3 pada SWE-bench Pro (Qwen3.8-Flash-Next: 62,5), dan 91,0 pada GPQA Diamond (Qwen3.8-Flash-Next: 91,7).
Dibanding DeepSeek-V4-Flash-0731, Qwen3.8-Omni-Flash unggul pada SWE-bench Pro (63,3 vs 56,0) dan IFBench (81,5 vs 79,2), tetapi DeepSeek menang di NL2Repo-Bench pada 54,2 vs 48,9.
Saat kami menguji DeepSeek-V4-Flash-0731, kami mendapati itu model coding lokal terkuat yang pernah kami jalankan hingga saat itu, sehingga model omnimodal tingkat Flash yang menandinginya pada rekayasa perangkat lunak tingkat repo adalah hasil yang berarti.
Qwen3.8-Omni-Flash hadir dalam dua varian plus pengaturan penalaran yang dapat disesuaikan, jadi memilih kombinasi yang tepat bergantung pada apakah Anda memerlukan analisis konten mendalam atau interaksi langsung.
Pembagiannya sederhana:
Anda tidak akan menggunakan model dasar untuk percakapan langsung, dan Anda tidak akan menggunakan Realtime untuk merender ulasan film dua jam.
Di atas pilihan varian, model dasar menyediakan parameter reasoning_effort dengan pengaturan xhigh (bawaan), medium, dan low, memungkinkan Anda menukar kedalaman penalaran dengan kecepatan dan biaya.
Gunakan low untuk pembuatan caption volume tinggi saat kecepatan penting dan xhigh untuk perencanaan multi-langkah seperti penulisan naskah komentar.
| Use case | Variant | Why |
|---|---|---|
| Pembuatan MV dan ulasan film | Qwen3.8-Omni-Flash | Perencanaan horizon panjang dan pemanggilan alat pada berkas lengkap |
| Notulen rapat dan butir tindakan | Qwen3.8-Omni-Flash | Pengenalan pembicara audio-visual gabungan, hingga 1 jam input |
| Asisten suara langsung dan layanan pelanggan | Qwen3.8-Omni-Flash-Realtime | Waktu ke paket audio pertama < 1,4 dtk, Skills untuk penyuntikan pengetahuan |
| Audio spasial dan navigasi | Qwen3.8-Omni-Flash-Realtime | Menemukan target berdasarkan suara secara waktu nyata |
Listing pihak ketiga menempatkan Qwen3.8-Omni-Flash sekitar $0,15 input / $0,47 output per 1 juta token teks, dengan OmniaKey dan LLM Reference sama-sama mengutip tarif resmi. Venice API mencantumkan rute Qwen 3.8 Flash terkait di $0,14 input / $0,49 output. Ini adalah tarif teks.
Input audio dan audio-visual berbiaya lebih tinggi, dan ini adalah catatan penting. Catatan harga Puter menandai bahwa input audio memiliki premi atas teks, dan perbandingan Alibaba sendiri memposisikan harga input audio-visual terhadap Gemini 3.8 Flash alih-alih mengutip tarif token flat. Alibaba mengklaim harga per jam input audio turun lebih dari 98% dibanding Qwen3.5-Omni-Plus dan input audio-visual lebih dari 93%, jadi preminya lebih kecil dari sebelumnya, tetapi masih ada.
Model ini umumnya tersedia sekarang di Qianwen AI Platform dan dirutekan melalui Alibaba Cloud Model Studio, dengan endpoint Beijing dan Singapura. Tidak ada tier konsumen gratis yang dijelaskan dalam catatan rilis.
ID model API adalah qwen3.8-omni-flash, dan varian waktu nyata adalah qwen3.8-omni-flash-realtime.
Model ini mendukung Chat Completions dan Responses API yang kompatibel dengan OpenAI, dan tooling multimodal terhubung ke harness agen, termasuk Codex, Claude Code, Qwen Code, dan Gemini CLI melalui Qwen-MM-Plugins.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{"role": "user", "content": "Summarize this meeting recording."}],
    reasoning_effort="xhigh",  # xhigh, medium, or low
)
print(completion.choices.message.content)
Satu kekurangan yang dilaporkan: pengguna GitHub menandai interupsi sering dan ketidakstabilan sesi saat menjalankan Qwen3.8-Omni-Flash dengan Claude Code, jadi sediakan waktu untuk penyiapan harness.
Untuk info selengkapnya tentang penyiapan, lihat tutorial kami tentang menjalankan model kelas Flash dan panduan Qwen3.8-Max.
Alibaba mengambil jalur spesifik alih-alih mengejar semua pesaing Flash pada teks.
Dibanding Qwen3.8-Flash-Next, GLM-5.3-Flash, Gemini 3.8 Flash, dan DeepSeek V4.1 Flash, nilai jual di sini adalah agen audio dan video plus harga teks termurah di kelompoknya.
Saya akan memilih ini jika pekerjaan Anda melibatkan transkripsi rapat, lokalisasi video, atau produksi MV dan ulasan, di mana tooling agen audio-visual dan peningkatan diarization AliMeeting benar-benar menonjol.
Untuk teks atau kode murni, Qwen3.8-Flash-Next mencetak sedikit lebih tinggi, dan Gemini 3.8 Flash masih unggul pada sebagian penalaran video, jadi ini bukan pengganti default untuk semua orang.
Jika Anda ingin nyaman dengan alur kerja agen dan model multimodal, saya sarankan mulai dari skill track AI Fundamentals.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




