Curso
Programación asistida por IA para desarrolladores
1 h 30 min
10.7K
La nueva ola de modelos de la clase Flash no deja de crecer.
Hace poco hablamos de Qwen3.8-Flash-Next, GLM-5.3-Flash, Gemini 3.8 Flash y DeepSeek V4.1 Flash, todos compitiendo por el segmento del mercado que busca bajo coste y respuesta rápida.
Ahora el equipo Qwen de Alibaba aporta un enfoque distinto con Qwen3.8-Omni-Flash, un modelo omnimodal nativo diseñado alrededor de agentes de audio y vídeo.
Qwen3.8-Omni-Flash acepta entradas de texto, imagen, audio y vídeo con una ventana de contexto de 1M de tokens. Alibaba afirma un rendimiento audiovisual cercano a Gemini 3.8 Flash y un rendimiento global en audio que lo supera, junto con una mejora media del 25% o más frente a su predecesor Qwen3.5-Omni-Plus en 29 evaluaciones. Los titulares en agentes son +36,5 puntos en WildClawBench-MM y una caída reportada de más del 98% en el precio por hora de la entrada de audio.
En este artículo repasamos todo lo nuevo de Qwen3.8-Omni-Flash: sus funciones, cómo se compara con otros modelos Flash que ya analizamos y un recorrido por los benchmarks.
Si quieres ver cómo se comparan estos modelos, consulta nuestra guía de DeepSeek V4.1 Flash vs Gemini 3.8 Flash y nuestra comparativa de GLM-5.3 Flash vs Qwen3.8-Flash-Next.
Qwen3.8-Omni-Flash es un modelo omnimodal nativo del equipo Qwen de Alibaba, situado en la gama Flash como opción eficiente en costes y de alto rendimiento.
Procesa texto, imagen, audio y vídeo en un único modelo y admite una ventana de contexto de 1M de tokens, manteniendo un rendimiento en texto comparable al de un modelo solo de texto del mismo tamaño.
El objetivo de esta generación es dotar de capacidad de agente en audio y vídeo, no solo comprenderlos.
Mientras Qwen3.5-Omni-Plus se centraba en interpretar contenido omnimodal, Qwen3.8-Omni-Flash está pensado para planificar tareas, llamar a herramientas y terminar trabajos creativos como edición de vídeo, creación de videoclips y comentarios de cine.
Alibaba plantea esto como pasar de tratar audio y vídeo como entradas perceptivas a convertirlos en los medios a través de los cuales un agente razona y ejecuta.
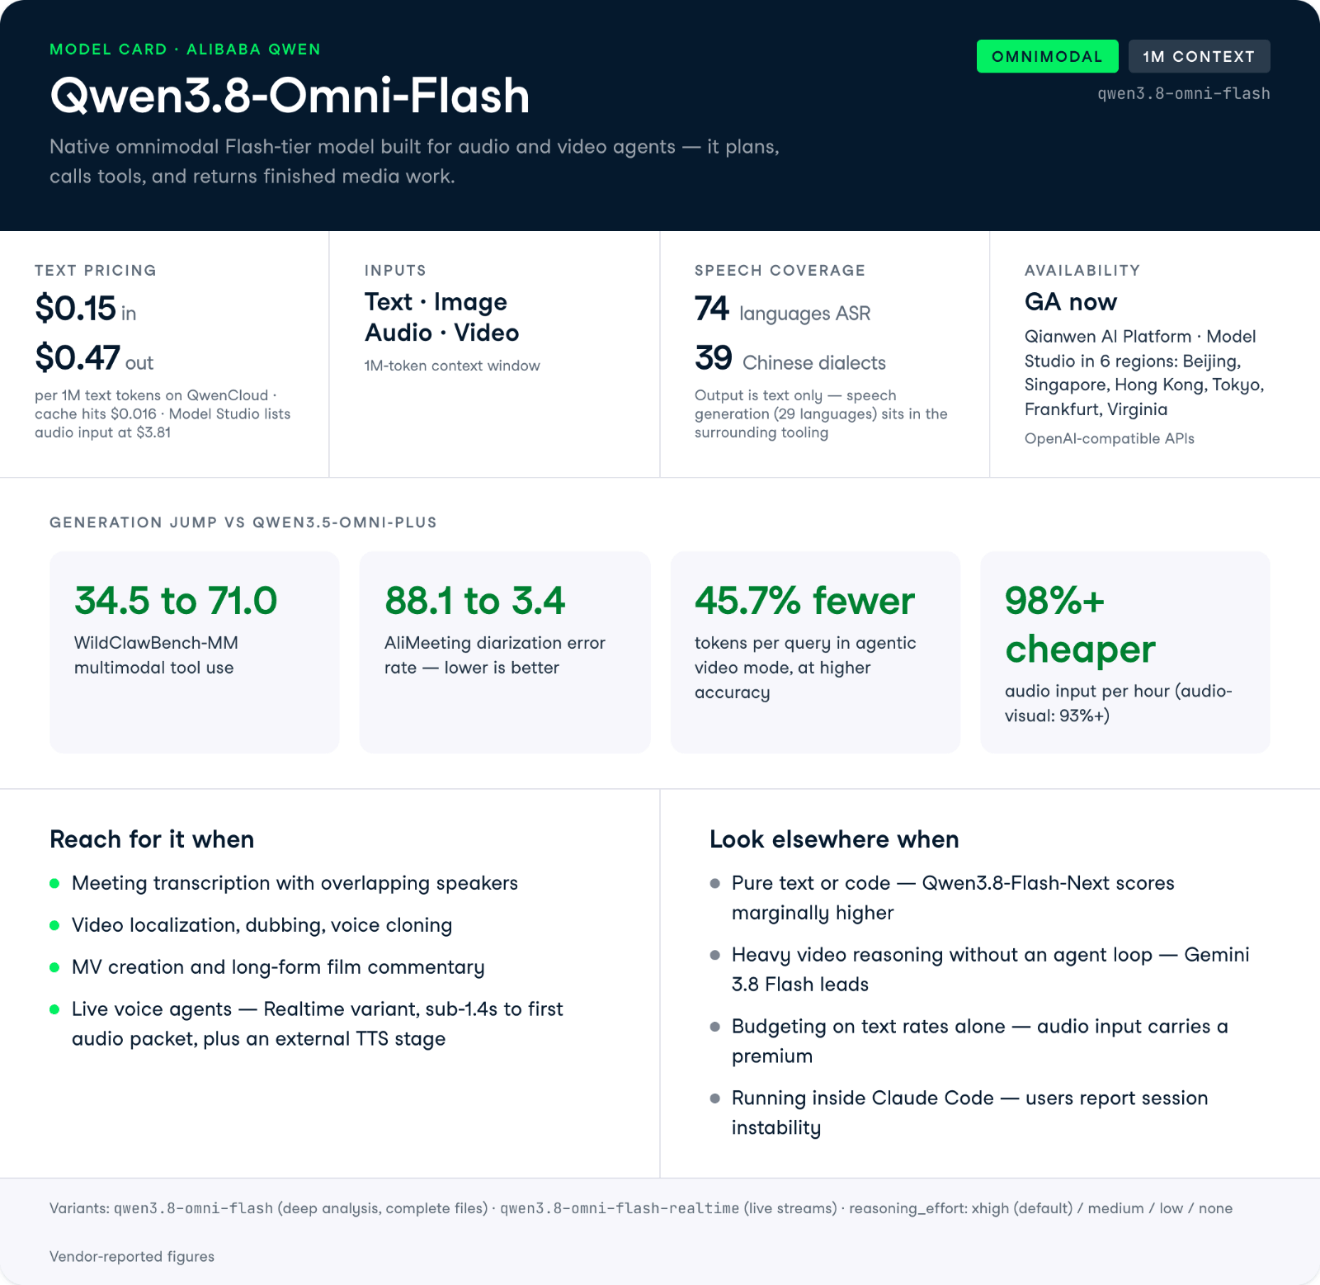
La gran cifra aquí es un salto de 36,5 puntos en WildClawBench-MM hasta 71,0 (Qwen3.5-Omni-Plus obtuvo 34,5), además de +22,3 puntos en AgenticVBench.
Al probarlo con audio real de reuniones donde la gente se solapa al hablar, el nuevo sistema mostró mejoras enormes frente al anterior:
Las funciones giran en torno a una idea: dar a un agente manos para trabajar con audio y vídeo, no solo ojos y oídos.
Alibaba lanzó el modelo junto a dos capas de herramientas: Qwen-MM-Plugins para flujos de trabajo de largo recorrido y Qwen-Live Harness para interacción en tiempo real.
Puedes darle a Qwen3.8-Omni-Flash una canción o una película larga, describir lo que quieres en una frase, y el modelo planificará la tarea, llamará a herramientas creativas y devolverá un vídeo terminado.
Admite flujos de trabajo de extremo a extremo, como creación de videoclips, traducción de cortos con clonación de voz y comentarios de películas de larga duración.
Para una película de dos horas, el modelo realiza comprensión de vídeo de larga duración, extracción de tramas clave, planificación del comentario, locución y producción musical, edición y una revisión final de calidad.
Puede intercalar el diálogo original con la narración y ajustar la velocidad y el volumen de la voz para que las capas de audio encajen.
Esto importa porque el bucle fragmentado de transcribir-traducir-doblar-editar es justo el coste de coordinación que tumba estos proyectos para creadores en solitario.
Tú decides qué mira el modelo, con qué nivel de detalle y cómo presenta el resultado, en lugar de aceptar una descripción fija.
Se puede indicar el sujeto, el rango temporal, el nivel de detalle y el formato de salida para un mismo vídeo.
Imagina que le pasas una demo de producto de 40 minutos. Puedes pedir un resumen de 200 palabras para una página de listado y luego volver a ejecutar el mismo clip pidiendo una salida en esquema JSON con marcas de tiempo por escena, extracción de texto en pantalla y transcripciones con etiquetas de hablante para un pipeline posterior.
En OmniCap-IF, sus puntuaciones de estructura de contenido y seguimiento de instrucciones (CSR e ISR) mejoran en 8,5 y 14,1 puntos respecto al modelo anterior.
En lugar de procesar toda una grabación de varias horas, el modelo parte de tu pregunta y decide qué ver y escuchar mediante una recogida de evidencias de lo general a lo específico.
Así concentra el cómputo y los tokens en los segmentos relevantes.
En OmniVideoBench, este modo basado en agentes eleva la precisión de 63,4 a 67,8 mientras reduce el consumo de tokens de 145.736 a 79.117 por consulta, una reducción de aproximadamente el 45,7%.
Para quien paga por token en material de horas, esa eficiencia es la función clave.
Una variante aparte, Qwen3.8-Omni-Flash-Realtime, percibe y responde mientras recibe flujos audiovisuales en vivo y usa el contexto en tiempo real para llamar a herramientas.
Gestiona práctica de conversación con feedback de pronunciación, percepción de audio espacial e inyección de conocimiento mediante Skills.
La capacidad de audio espacial es la más llamativa: Alibaba afirma que es el primer modelo omnimodal capaz de localizar un objetivo por el sonido, combinando audio direccional con información visual para determinar la dirección y la distancia de una fuente.
El tiempo hasta el primer paquete de audio se sitúa por debajo de 1,4 segundos incluso con entradas audiovisuales de 20 segundos.
Qwen3.8-Omni-Flash admite reconocimiento de voz en 74 idiomas y 39 dialectos chinos, de mandarín y cantonés a sichuanés, shanghainés y min del sur.
La generación de voz cubre 29 idiomas y 7 dialectos.
Para flujos de trabajo de localización y doblaje, esa amplitud de dialectos es un diferenciador práctico frente a la mayoría de modelos Flash competidores, que suelen publicar recuentos de idiomas pero no cobertura a nivel de dialecto.
Una de las demostraciones más curiosas del lanzamiento es Alibaba usando Qwen3.8-Omni-Flash para mejorar un modelo más pequeño, en lugar de servir directamente a usuarios.
Dadas 12 horas para mejorar el reconocimiento del dialecto de Sichuan en Qwen2.5-Omni-3B, el agente seleccionó el conjunto de evaluación WenetSpeech-Chuan, construyó una línea base y diagnosticó errores escuchando muestras de audio.
A lo largo de cuatro rondas, creó 3.413 ejemplos de entrenamiento, revirtió intentos fallidos y redujo la tasa de error de caracteres del 25,79% al 15,30%, una reducción relativa de alrededor del 40,7%.
Es un experimento pequeño, pero apunta a un modelo grande que orquesta el entrenamiento de modelos pequeños especializados para producción.
El patrón es consistente: Qwen3.8-Omni-Flash gana con claridad la categoría de audio, se disputa el liderazgo con Gemini 3.8 Flash en tareas audiovisuales y se mantiene competitivo en texto frente a sus modelos hermanos.
No va por delante en todo, y varias pruebas de razonamiento en vídeo siguen favoreciendo a Gemini 3.8 Flash.
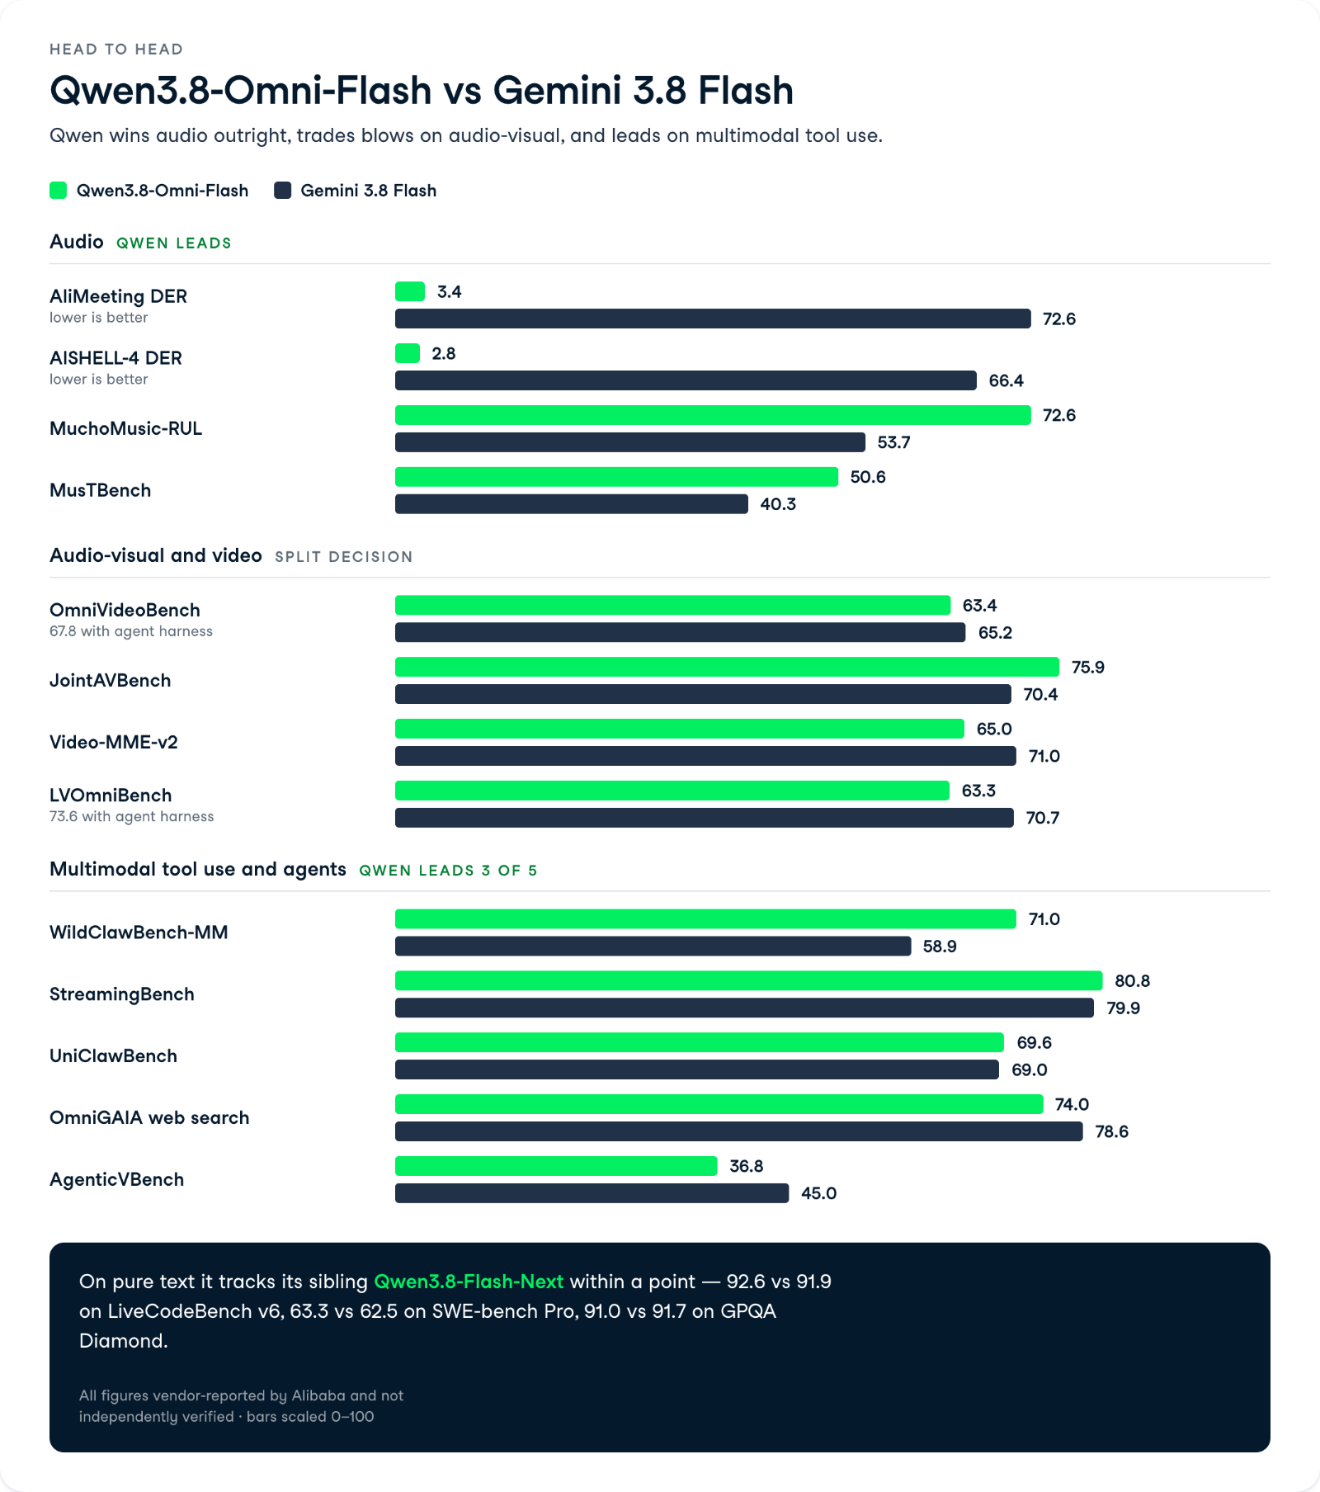
Este es su punto más fuerte, y donde supera a Gemini 3.8 Flash por un amplio margen.
En la prueba ASR multihablante AliMeeting registra un 3,4 de error de diarización frente al 72,6 de Gemini 3.8 Flash, y en AISHELL-4 marca 2,8 frente al 66,4 de Gemini, lo que refleja que Gemini sufre con hablantes superpuestos.
La tasa de error de diarización mide lo bien que un modelo atribuye el discurso al hablante correcto, así que una puntuación baja es clave para actas de reuniones, transcripción de entrevistas y cualquier flujo con gente hablándose por encima.
En comprensión musical también lidera con claridad: 72,6 en MuchoMusic-RUL frente a 53,7 de Gemini, y 50,6 en MusTBench frente a 40,3.
Aquí, Gemini 3.8 Flash suele aventajar por poco, pero la brecha es pequeña y se cierra cuando Qwen corre en modo agente.
Las filas de razonamiento en vídeo son más mixtas.
En Video-MME-v2, Gemini lidera 71,0 a 65,0 en estático, y en LVOmniBench Gemini mantiene 70,7 frente a 63,3 de Qwen, aunque Qwen salta a 73,6 con el arnés de agente.
Si tu trabajo depende mucho del razonamiento en vídeo sin bucle de agente, Gemini aún tiene ventaja.
La propuesta va de capacidad de agente, y el resultado en WildClawBench-MM lo respalda: 71,0 para Qwen3.8-Omni-Flash frente a 58,9 de Gemini 3.8 Flash y 41,9 de Seed 2.0 Lite.
En UniClawBench ambos quedan prácticamente empatados en 69,6 y 69,0.
Gemini sí gana AgenticVBench con 45,0 frente a 36,8 de Qwen y OmniGAIA web search con 78,6 frente a 74,0.
Así que la historia de uso de herramientas es real, pero no es un pleno. En StreamingBench, un benchmark de interacción, Qwen lidera con claridad con 80,8 frente a 79,9 de Gemini y 57,1 del predecesor.
En texto puro, Qwen3.8-Omni-Flash sigue de cerca a su hermano solo de texto Qwen3.8-Flash-Next, normalmente a menos de un punto.
Puntúa 92,6 en LiveCodeBench v6 (Qwen3.8-Flash-Next: 91,9), 63,3 en SWE-bench Pro (Qwen3.8-Flash-Next: 62,5) y 91,0 en GPQA Diamond (Qwen3.8-Flash-Next: 91,7).
Frente a DeepSeek-V4-Flash-0731, Qwen3.8-Omni-Flash lidera en SWE-bench Pro (63,3 vs 56,0) e IFBench (81,5 vs 79,2), pero DeepSeek gana NL2Repo-Bench con 54,2 frente a 48,9.
Cuando probamos DeepSeek-V4-Flash-0731, fue el mejor modelo local de programación que habíamos ejecutado hasta entonces, así que que un omnimodal de la gama Flash se le acerque en ingeniería de software a nivel de repositorio es un resultado notable.
Qwen3.8-Omni-Flash llega en dos variantes y un ajuste de razonamiento configurable, así que elegir la combinación adecuada depende de si necesitas análisis profundo de contenido o interacción en vivo.
La división es clara:
No usarías el modelo base para una conversación en vivo, ni usarías Realtime para renderizar un comentario de dos horas.
Además de la variante, el modelo base expone un parámetro reasoning_effort con valores xhigh (por defecto), medium y low, que te permite intercambiar profundidad de razonamiento por velocidad y coste.
Usa low para subtitulado masivo donde prime la velocidad y xhigh para planificación multietapa como guiones de comentario.
| Uso | Variante | Motivo |
|---|---|---|
| Creación de MVs y comentarios de cine | Qwen3.8-Omni-Flash | Planificación de largo recorrido y llamadas a herramientas sobre archivos completos |
| Actas de reuniones y tareas | Qwen3.8-Omni-Flash | Reconocimiento conjunto audio-visual de hablantes, hasta 1 hora de entrada |
| Asistentes de voz y atención al cliente en vivo | Qwen3.8-Omni-Flash-Realtime | Menos de 1,4 s hasta el primer paquete de audio, Skills para inyección de conocimiento |
| Audio espacial y navegación | Qwen3.8-Omni-Flash-Realtime | Localiza objetivos por sonido en tiempo real |
Listados de terceros sitúan Qwen3.8-Omni-Flash en torno a $0.15 por entrada / $0.47 por salida por 1M de tokens de texto, con OmniaKey y LLM Reference citando las tarifas oficiales. Venice API lista una ruta relacionada de Qwen 3.8 Flash a $0.14 por entrada / $0.49 por salida. Estas son tarifas para texto.
El audio y el audiovisual cuestan más, y este es el matiz importante. La nota de precios de Puter indica que la entrada de audio tiene una prima frente al texto, y la propia comparación de Alibaba posiciona la entrada audiovisual frente a Gemini 3.8 Flash en lugar de dar una tarifa plana por token. Alibaba afirma que el precio por hora de la entrada de audio cayó más del 98% frente a Qwen3.5-Omni-Plus y la entrada audiovisual más del 93%, así que la prima es menor que antes, pero sigue existiendo.
El modelo está disponible de forma general en Qianwen AI Platform y a través de Alibaba Cloud Model Studio, con endpoints en Pekín y Singapur. No se describe una capa gratuita para consumidores en las notas de lanzamiento.
El ID del modelo en la API es qwen3.8-omni-flash, y la variante en tiempo real es qwen3.8-omni-flash-realtime.
Es compatible con las APIs de Chat Completions y Responses compatibles con OpenAI, y las herramientas multimodales se conectan a arneses de agentes como Codex, Claude Code, Qwen Code y Gemini CLI mediante Qwen-MM-Plugins.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{"role": "user", "content": "Summarize this meeting recording."}],
    reasoning_effort="xhigh",  # xhigh, medium, or low
)
print(completion.choices.message.content)
Un posible punto débil: usuarios de GitHub han señalado interrupciones frecuentes e inestabilidad de sesión al ejecutar Qwen3.8-Omni-Flash con Claude Code, así que reserva tiempo para depurar el arnés si lo usas.
Para más información sobre la configuración, consulta nuestro tutorial para ejecutar modelos de la clase Flash y nuestra guía de Qwen3.8-Max.
Alibaba se está diferenciando en un carril concreto en lugar de perseguir a cada rival Flash en texto.
Frente a Qwen3.8-Flash-Next, GLM-5.3-Flash, Gemini 3.8 Flash y DeepSeek V4.1 Flash, aquí la propuesta son agentes de audio y vídeo más el precio de texto más barato del grupo.
Yo optaría por este modelo si tu trabajo implica transcripción de reuniones, localización de vídeo o producción de MVs y comentarios, donde las herramientas de agente audiovisual y las mejoras en diarización en AliMeeting destacan de verdad.
Para texto o código puros, Qwen3.8-Flash-Next puntúa ligeramente mejor, y Gemini 3.8 Flash todavía lidera en algunos razonamientos de vídeo, así que no es un sustituto por defecto para todo el mundo.
Si quieres familiarizarte con flujos de trabajo con agentes y modelos multimodales, te recomiendo empezar por el AI Fundamentals skill track.
Los mejores cursos de DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Abid Ali Awan
9 min
blog
Matt Crabtree
13 min
blog
blog
Abid Ali Awan
10 min
Tutorial
Dimitri Didmanidze
8 min