{count, plural, one {Curso} other {Cursos}}
Codificação com IA para Desenvolvedores
{hours} h {minutes} min
11K
A onda atual de modelos da classe Flash não para de crescer.
Recentemente, cobrimos o Qwen3.8-Flash-Next, o GLM-5.3-Flash, o Gemini 3.8 Flash e o DeepSeek V4.1 Flash, todos disputando o espaço do mercado que exige baixo custo e inferência rápida.
Agora, o time Qwen da Alibaba traz um novo ângulo para essa disputa com o Qwen3.8-Omni-Flash, um modelo omnimodal nativo criado em torno de agentes de áudio e vídeo.
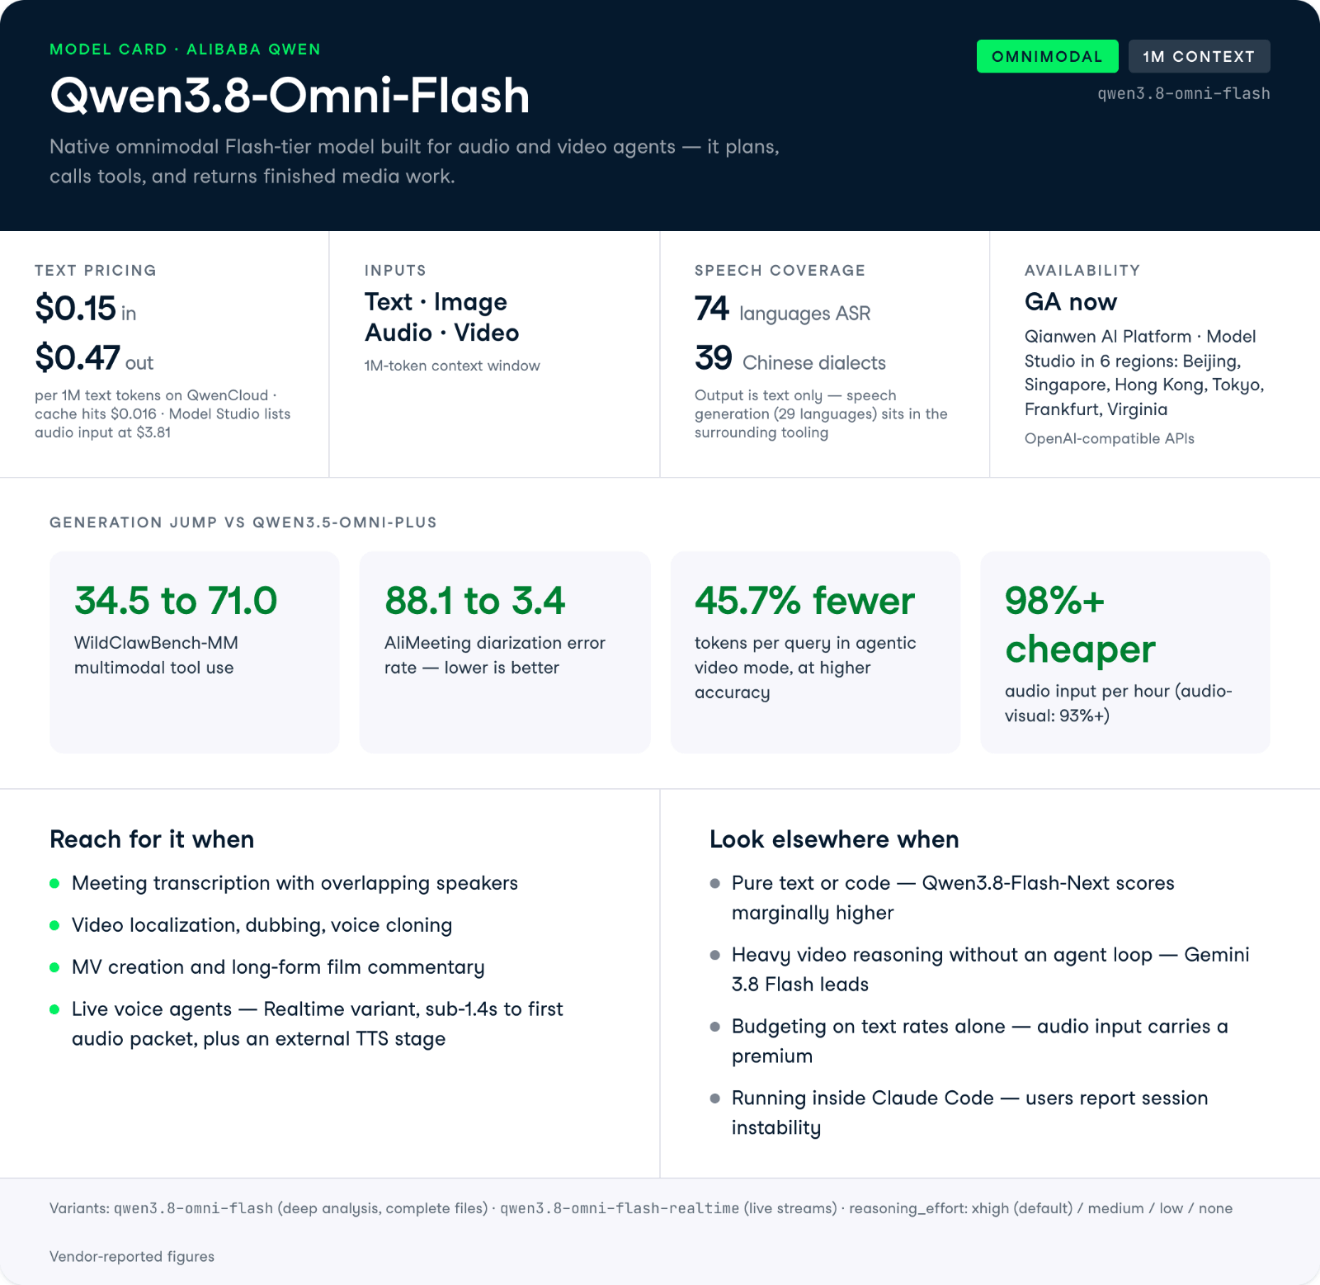
O Qwen3.8-Omni-Flash aceita entradas de texto, imagem, áudio e vídeo com uma janela de contexto de 1M de tokens. A Alibaba afirma desempenho audiovisual próximo ao do Gemini 3.8 Flash e desempenho geral em áudio superior, além de uma melhoria média de 25%+ sobre seu antecessor Qwen3.5-Omni-Plus em 29 avaliações. Os destaques para agentes são um ganho de 36,5 pontos no WildClawBench-MM e uma queda relatada de mais de 98% no preço por hora de entrada de áudio.
Neste artigo, vou cobrir as novidades do Qwen3.8-Omni-Flash, apresentar os novos recursos, compará-lo com outros modelos Flash que já analisamos e percorrer os benchmarks.
Para saber mais sobre como esses modelos se comparam, confira nosso guia DeepSeek V4.1 Flash vs Gemini 3.8 Flash e nossa comparação GLM-5.3 Flash vs Qwen3.8-Flash-Next.
O Qwen3.8-Omni-Flash é um modelo omnimodal nativo do time Qwen da Alibaba, posicionado na categoria Flash como a opção de alto rendimento e custo eficiente.
Ele processa texto, imagem, áudio e vídeo em um único modelo e suporta janela de contexto de 1M de tokens, mantendo o desempenho em texto comparável ao de um modelo apenas de texto do mesmo porte.
O objetivo desta geração é a capacidade de agir em áudio e vídeo, não apenas entendê-los.
Enquanto o Qwen3.5-Omni-Plus focava em interpretar conteúdo omnimodal, o Qwen3.8-Omni-Flash foi criado para planejar tarefas, acionar ferramentas e concluir trabalhos criativos como edição de vídeo, criação de clipes musicais e comentários de filmes.
A Alibaba descreve isso como levar áudio e vídeo de entradas perceptivas para os meios centrais pelos quais um agente raciocina e executa.
A grande alegação aqui é um salto de 36,5 pontos no WildClawBench-MM, para 71,0 (o Qwen3.5-Omni-Plus marcou 34,5), além de um ganho de 22,3 pontos no AgenticVBench.
Em teste com áudios reais de reuniões, onde as pessoas frequentemente falam ao mesmo tempo, o novo sistema mostrou melhorias enormes em relação ao anterior:
Os recursos giram em torno de uma ideia: dar "mãos" ao agente para trabalhar com áudio e vídeo, não só "olhos e ouvidos".
A Alibaba lançou o modelo junto com duas camadas de ferramentas, o Qwen-MM-Plugins para fluxos de trabalho de longo horizonte e o Qwen-Live Harness para interação em tempo real.
Você pode entregar ao Qwen3.8-Omni-Flash uma música ou um longa-metragem e descrever o que quer em uma frase; ele planeja a tarefa, aciona ferramentas criativas e devolve um vídeo finalizado.
Ele suporta fluxos ponta a ponta, incluindo criação de clipes musicais, tradução de curtas com clonagem de voz e comentários de filmes longos.
Para um filme de duas horas, o modelo faz entendimento de vídeo de longa duração, extração de enredo, planejamento do comentário, gravação de voz e produção musical, edição e uma revisão final de qualidade.
Consegue intercalar o diálogo original com a narração e ajustar velocidade e volume da fala para que as camadas de áudio combinem bem.
Isso é relevante porque o ciclo fragmentado transcrever-traduzir-dublar-editar é exatamente o custo de coordenação que inviabiliza esses projetos para criadores solo.
Você define o que o modelo observa, com que profundidade analisa e como apresenta o resultado, em vez de aceitar uma descrição fixa.
Usuários podem especificar o assunto, o intervalo de tempo, o nível de detalhe e o formato de saída para o mesmo vídeo.
Por exemplo: você envia um demo de produto de 40 minutos. Pode pedir um resumo de 200 palavras para uma página de listagem e depois executar o mesmo clipe pedindo uma saída em JSON Schema com timestamps por cena, extração de textos na tela e transcrições com marcação de palestrantes para um pipeline a jusante.
No OmniCap-IF, as pontuações de estrutura de conteúdo e de seguir instruções (CSR e ISR) melhoram 8,5 e 14,1 pontos em relação ao antecessor.
Em vez de processar uma gravação de várias horas inteira, o modelo parte da sua pergunta e decide o que assistir e ouvir por meio de uma coleta de evidências do grosso ao fino.
Isso concentra computação e tokens nos trechos relevantes.
No OmniVideoBench, esse modo com agente eleva a acurácia de 63,4 para 67,8 enquanto corta o consumo de tokens de 145.736 para 79.117 por consulta, uma redução de cerca de 45,7%.
Para quem paga por token em vídeos longos, esse ganho de eficiência é o recurso.
Uma variante separada, o Qwen3.8-Omni-Flash-Realtime, percebe e responde enquanto recebe streams audiovisuais ao vivo e usa o contexto em tempo real para acionar ferramentas.
Ele lida com prática de conversação com feedback de pronúncia, percepção de áudio espacial e injeção de conhecimento via Skills.
A afirmação sobre áudio espacial é a mais incomum aqui: a Alibaba diz que é o primeiro modelo omnimodal capaz de localizar um alvo pelo som, combinando áudio direcional com informação visual para determinar direção e distância da fonte.
O tempo até o primeiro pacote de áudio fica abaixo de 1,4 segundo mesmo para entradas audiovisuais de 20 segundos.
O Qwen3.8-Omni-Flash reconhece fala em 74 idiomas e 39 dialetos chineses, de mandarim e cantonês a sichuanês, shangainês e min meridional.
A geração de fala cobre 29 idiomas e 7 dialetos.
Para fluxos de localização e dublagem, essa amplitude de dialetos é um diferencial prático em relação à maioria dos concorrentes da classe Flash, que normalmente informam quantidade de idiomas, mas não cobertura em nível de dialeto.
Uma das demonstrações mais diferentes do lançamento é a Alibaba usando o Qwen3.8-Omni-Flash para melhorar um modelo menor, em vez de atender usuários diretamente.
Dadas 12 horas para aprimorar o reconhecimento do dialeto de Sichuan no Qwen2.5-Omni-3B, o agente selecionou o conjunto de avaliação WenetSpeech-Chuan, construiu uma linha de base e diagnosticou erros ouvindo amostras de áudio.
Ao longo de quatro rodadas, criou 3.413 exemplos de treino, desfez tentativas malsucedidas e reduziu a taxa de erro de caracteres de 25,79% para 15,30%, uma queda relativa de cerca de 40,7%.
É um experimento pequeno, mas aponta para um modelo maior conduzindo o treinamento de modelos menores e especializados para produção.
O padrão é consistente: o Qwen3.8-Omni-Flash vence com folga em áudio, troca golpes com o Gemini 3.8 Flash em tarefas audiovisuais e se mantém competitivo em texto contra os modelos irmãos.
Ele não lidera em tudo, e várias métricas de raciocínio em vídeo ainda favorecem o Gemini 3.8 Flash.
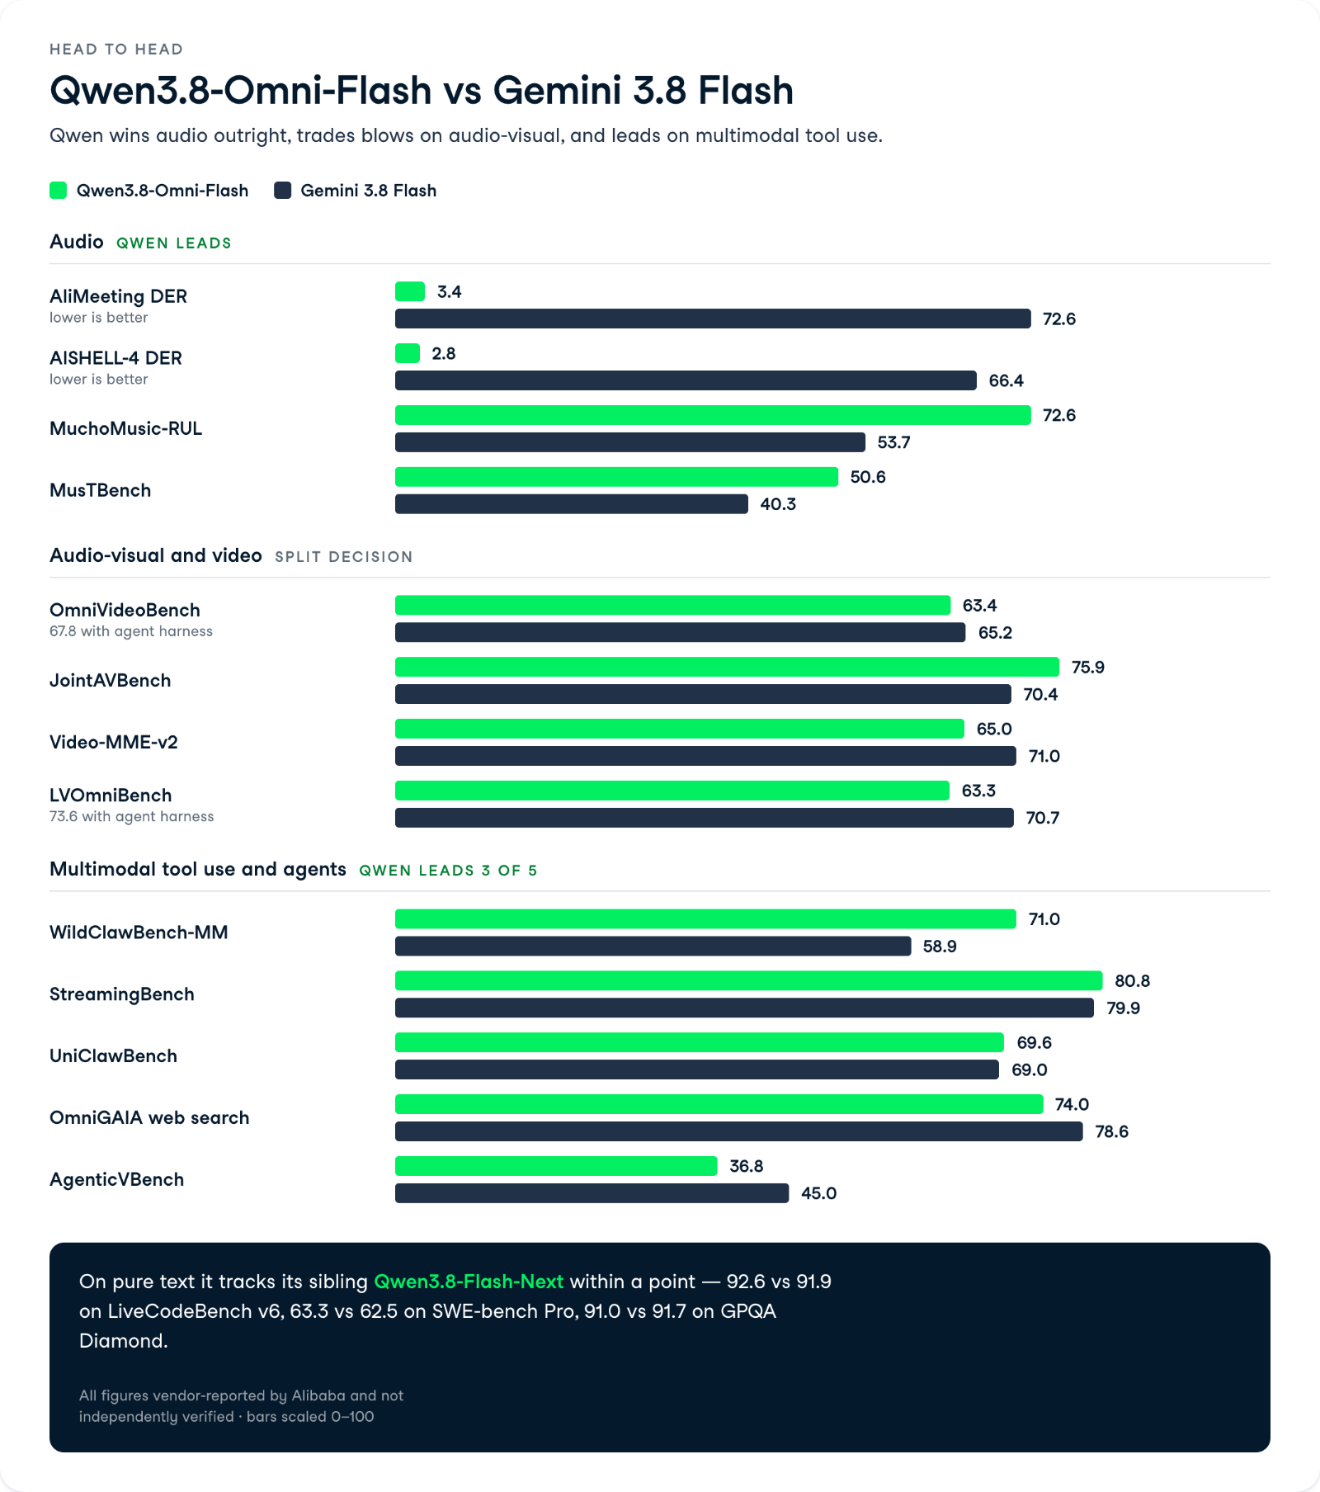
Aqui é onde o modelo é mais forte, abrindo grande vantagem sobre o Gemini 3.8 Flash.
No teste ASR multi-falantes AliMeeting, registra taxa de erro de diarização de 3,4 contra 72,6 do Gemini 3.8 Flash, e no AISHELL-4 atinge 2,8 contra 66,4 do Gemini, o que mostra o quanto o Gemini sofre com falas sobrepostas.
A taxa de erro de diarização mede quão bem o modelo atribui a fala ao locutor correto, então uma pontuação baixa é crucial para atas de reunião, transcrição de entrevistas e qualquer fluxo com pessoas falando ao mesmo tempo.
Em entendimento musical, ele também lidera com folga, marcando 72,6 no MuchoMusic-RUL contra 53,7 do Gemini e 50,6 no MusTBench contra 40,3.
Nesse quesito, o Gemini 3.8 Flash geralmente fica um pouco à frente, mas a diferença é pequena e diminui quando o Qwen roda em modo agente.
As métricas de raciocínio em vídeo são mais mistas.
No Video-MME-v2, o Gemini lidera por 71,0 a 65,0 em modo estático, e no LVOmniBench o Gemini mantém 70,7 contra 63,3 do Qwen, embora o Qwen salte para 73,6 com o harness de agente.
Se o seu trabalho exige raciocínio pesado em vídeo sem loop de agente, o Gemini ainda leva vantagem.
A capacidade de agente é a proposta, e o resultado no WildClawBench-MM sustenta isso: 71,0 para o Qwen3.8-Omni-Flash contra 58,9 do Gemini 3.8 Flash e 41,9 do Seed 2.0 Lite.
No UniClawBench, os dois praticamente empatam em 69,6 e 69,0.
O Gemini vence no AgenticVBench por 45,0 a 36,8 do Qwen e no OmniGAIA web search por 78,6 a 74,0.
Então, a história do uso de ferramentas é real, mas não é varrida total. No StreamingBench, um benchmark de interação, o Qwen lidera com 80,8 contra 79,9 do Gemini e 57,1 do antecessor.
Em texto puro, o Qwen3.8-Omni-Flash acompanha de perto o irmão somente-texto Qwen3.8-Flash-Next, geralmente dentro de um ponto.
Ele marca 92,6 no LiveCodeBench v6 (Qwen3.8-Flash-Next: 91,9), 63,3 no SWE-bench Pro (Qwen3.8-Flash-Next: 62,5) e 91,0 no GPQA Diamond (Qwen3.8-Flash-Next: 91,7).
Contra o DeepSeek-V4-Flash-0731, o Qwen3.8-Omni-Flash lidera no SWE-bench Pro (63,3 vs 56,0) e no IFBench (81,5 vs 79,2), mas o DeepSeek vence no NL2Repo-Bench com 54,2 contra 48,9.
Quando testamos o DeepSeek-V4-Flash-0731, vimos que era o modelo local de código mais forte que havíamos rodado até então, então um modelo omnimodal da classe Flash igualando-o em engenharia de software em nível de repositório é um bom resultado.
O Qwen3.8-Omni-Flash é oferecido em duas variantes e traz um ajuste de raciocínio, então a escolha certa depende se você precisa de análise profunda de conteúdo ou interação ao vivo.
A divisão é simples:
Você não usaria o modelo base para uma conversa ao vivo, e não usaria o Realtime para renderizar um comentário de filme de duas horas.
Além da variante, o modelo base expõe o parâmetro reasoning_effort com as opções xhigh (padrão), medium e low, permitindo trocar profundidade de raciocínio por velocidade e custo.
Use low para legendagem em alto volume, onde velocidade importa, e xhigh para planejamento em várias etapas, como roteirização de comentários.
| Uso | Variante | Por quê |
|---|---|---|
| Criação de MV e comentários de filmes | Qwen3.8-Omni-Flash | Planejamento de longo horizonte e chamadas de ferramentas em arquivos completos |
| Atas de reunião e itens de ação | Qwen3.8-Omni-Flash | Reconhecimento conjunto áudio-visual de palestrantes, até 1 hora de entrada |
| Assistentes de voz e atendimento ao cliente ao vivo | Qwen3.8-Omni-Flash-Realtime | Tempo até o primeiro pacote de áudio abaixo de 1,4 s, Skills para injeção de conhecimento |
| Áudio espacial e navegação | Qwen3.8-Omni-Flash-Realtime | Localiza alvos pelo som em tempo real |
Listagens de terceiros colocam o Qwen3.8-Omni-Flash em cerca de US$ 0,15 de entrada / US$ 0,47 de saída por 1M de tokens de texto, com OmniaKey e LLM Reference citando as tarifas oficiais. A Venice API lista uma rota relacionada do Qwen 3.8 Flash por US$ 0,14 de entrada / US$ 0,49 de saída. Esses são preços para texto.
Entradas de áudio e audiovisual custam mais, e esse é o ponto de atenção. A nota de preços da Puter sinaliza que entrada de áudio tem prêmio sobre texto, e a própria comparação da Alibaba precifica entrada audiovisual em relação ao Gemini 3.8 Flash em vez de citar uma taxa fixa por token. A Alibaba afirma que o preço por hora de entrada de áudio caiu mais de 98% em relação ao Qwen3.5-Omni-Plus e a entrada audiovisual mais de 93%, então o prêmio diminuiu, mas ainda existe.
O modelo está disponível de forma geral na Qianwen AI Platform e via Alibaba Cloud Model Studio, com endpoints em Pequim e Cingapura. Não há camada gratuita para consumidores descrita nas notas de lançamento.
O ID do modelo na API é qwen3.8-omni-flash, e a variante em tempo real é qwen3.8-omni-flash-realtime.
Ele é compatível com as APIs Chat Completions e Responses no padrão OpenAI, e as ferramentas multimodais se conectam a harnesses de agente, incluindo Codex, Claude Code, Qwen Code e Gemini CLI via Qwen-MM-Plugins.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{"role": "user", "content": "Summarize this meeting recording."}],
    reasoning_effort="xhigh",  # xhigh, medium, or low
)
print(completion.choices.message.content)
Um ponto de atrito relatado: usuários no GitHub apontaram interrupções frequentes e instabilidade de sessão ao rodar o Qwen3.8-Omni-Flash com o Claude Code, então reserve tempo para ajustes no harness.
Para mais detalhes de configuração, veja nosso tutorial sobre como rodar modelos da classe Flash e nosso guia do Qwen3.8-Max.
A Alibaba está abrindo uma faixa específica em vez de tentar superar todos os rivais da classe Flash em texto.
Frente ao Qwen3.8-Flash-Next, GLM-5.3-Flash, Gemini 3.8 Flash e DeepSeek V4.1 Flash, a proposta aqui são agentes de áudio e vídeo, além do preço de texto mais baixo do grupo.
Eu escolheria este se seu trabalho envolve transcrição de reuniões, localização de vídeo ou produção de MV e comentários, onde as ferramentas de agente audiovisual e os ganhos de diarização no AliMeeting realmente se destacam.
Para texto puro ou código, o Qwen3.8-Flash-Next pontua um pouco melhor, e o Gemini 3.8 Flash ainda lidera em alguns cenários de raciocínio em vídeo, então não é uma troca padrão para todo mundo.
Se você quer ganhar fluência em fluxos com agentes e modelos multimodais, recomendo começar pela trilha de habilidades AI Fundamentals.
Principais cursos da DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Richie Cotton
7 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
9 min
{count, plural, one {blog} other {blogs}}
Richie Cotton
{count, plural, one {blog} other {blogs}}
{count, plural, one {Tutorial} other {Tutoriais}}
Kurtis Pykes
12 min
{count, plural, one {Tutorial} other {Tutoriais}}
Josep Ferrer
11 min