Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
10.7K
Lo stesso giorno del lancio di GLM-5.3 Flash, il team Qwen di Alibaba ha rilasciato i pesi di Qwen3.8-Flash-Next, un modello multimodale Mixture-of-Experts (MoE) che funge anche da anteprima dell'architettura alla base della prossima famiglia Qwen4.
Ricalca quanto fatto da Qwen3-Next per Qwen3.5: pubblicare in anticipo le modifiche architetturali rispetto all'intera linea di modelli, così che la community possa analizzarle per prima.
La vera notizia qui è il costo. Grazie a una nuova architettura altamente efficiente, Qwen3.8-Flash-Next costa circa un nono rispetto al suo predecessore, Qwen3.7-Plus. Ma non sacrifica potenza per arrivarci; batte infatti pesi massimi come Claude Opus 4.6 Max in test di coding rilevanti come SWE-bench.
In questo articolo vedremo tutte le novità di Qwen3.8-Flash-Next, analizzando architettura e funzionalità ed esaminando i benchmark. Per una guida dettagliata su come scaricare ed eseguire il modello in locale, leggi il nostro tutorial su Qwen3.8-Flash-Next. Se ti serve contesto su alcuni degli altri modelli cinesi, consulta la nostra guida a Qwen3.8-Max e il nostro tutorial su eseguire DeepSeek-V4-Flash-0731 in locale. Ti consiglio anche di dare un'occhiata al nuovo rilascio di Qwen3.8-Omni-Flash.
Qwen3.8-Flash-Next è un modello MoE multimodale del team Qwen di Alibaba, rilasciato il 26 agosto 2026, pensato come mulo da lavoro efficiente nei costi più che come ammiraglia top di gamma.
Si colloca sotto i modelli di classe Max in termini di intelligenza, ma batte quasi tutti sul prezzo: è questo il senso della linea "Flash".
Il modello supporta nativamente una finestra di contesto da 262.144 token, estendibile a 1.000.000 di token con YaRN (metodo [Yet another RoPE extensioN], una tecnica di codifica posizionale che estende la finestra di contesto di un modello, permettendogli di gestire input testuali enormi mantenendo le prestazioni originali).
Gestisce testo, immagini e video tramite una singola API, uno dei motivi per cui è stato definito da molti "il beniamino della community da un giorno all'altro" nei riepiloghi dei rilasci di agosto 2026.
Ciò che più conta per i practitioner è il rapporto benchmark-per-dollaro.
Qwen3.8-Flash-Next supera il suo fratello da 27B in ogni benchmark pubblicato e batte Claude Opus 4.6 Max nella maggior parte delle valutazioni pratiche di coding e agenti, pur attivando solo 6B parametri per token. Essendo un'anteprima dell'architettura Qwen4, le scelte progettuali indicano la direzione verso cui Alibaba si sta muovendo.
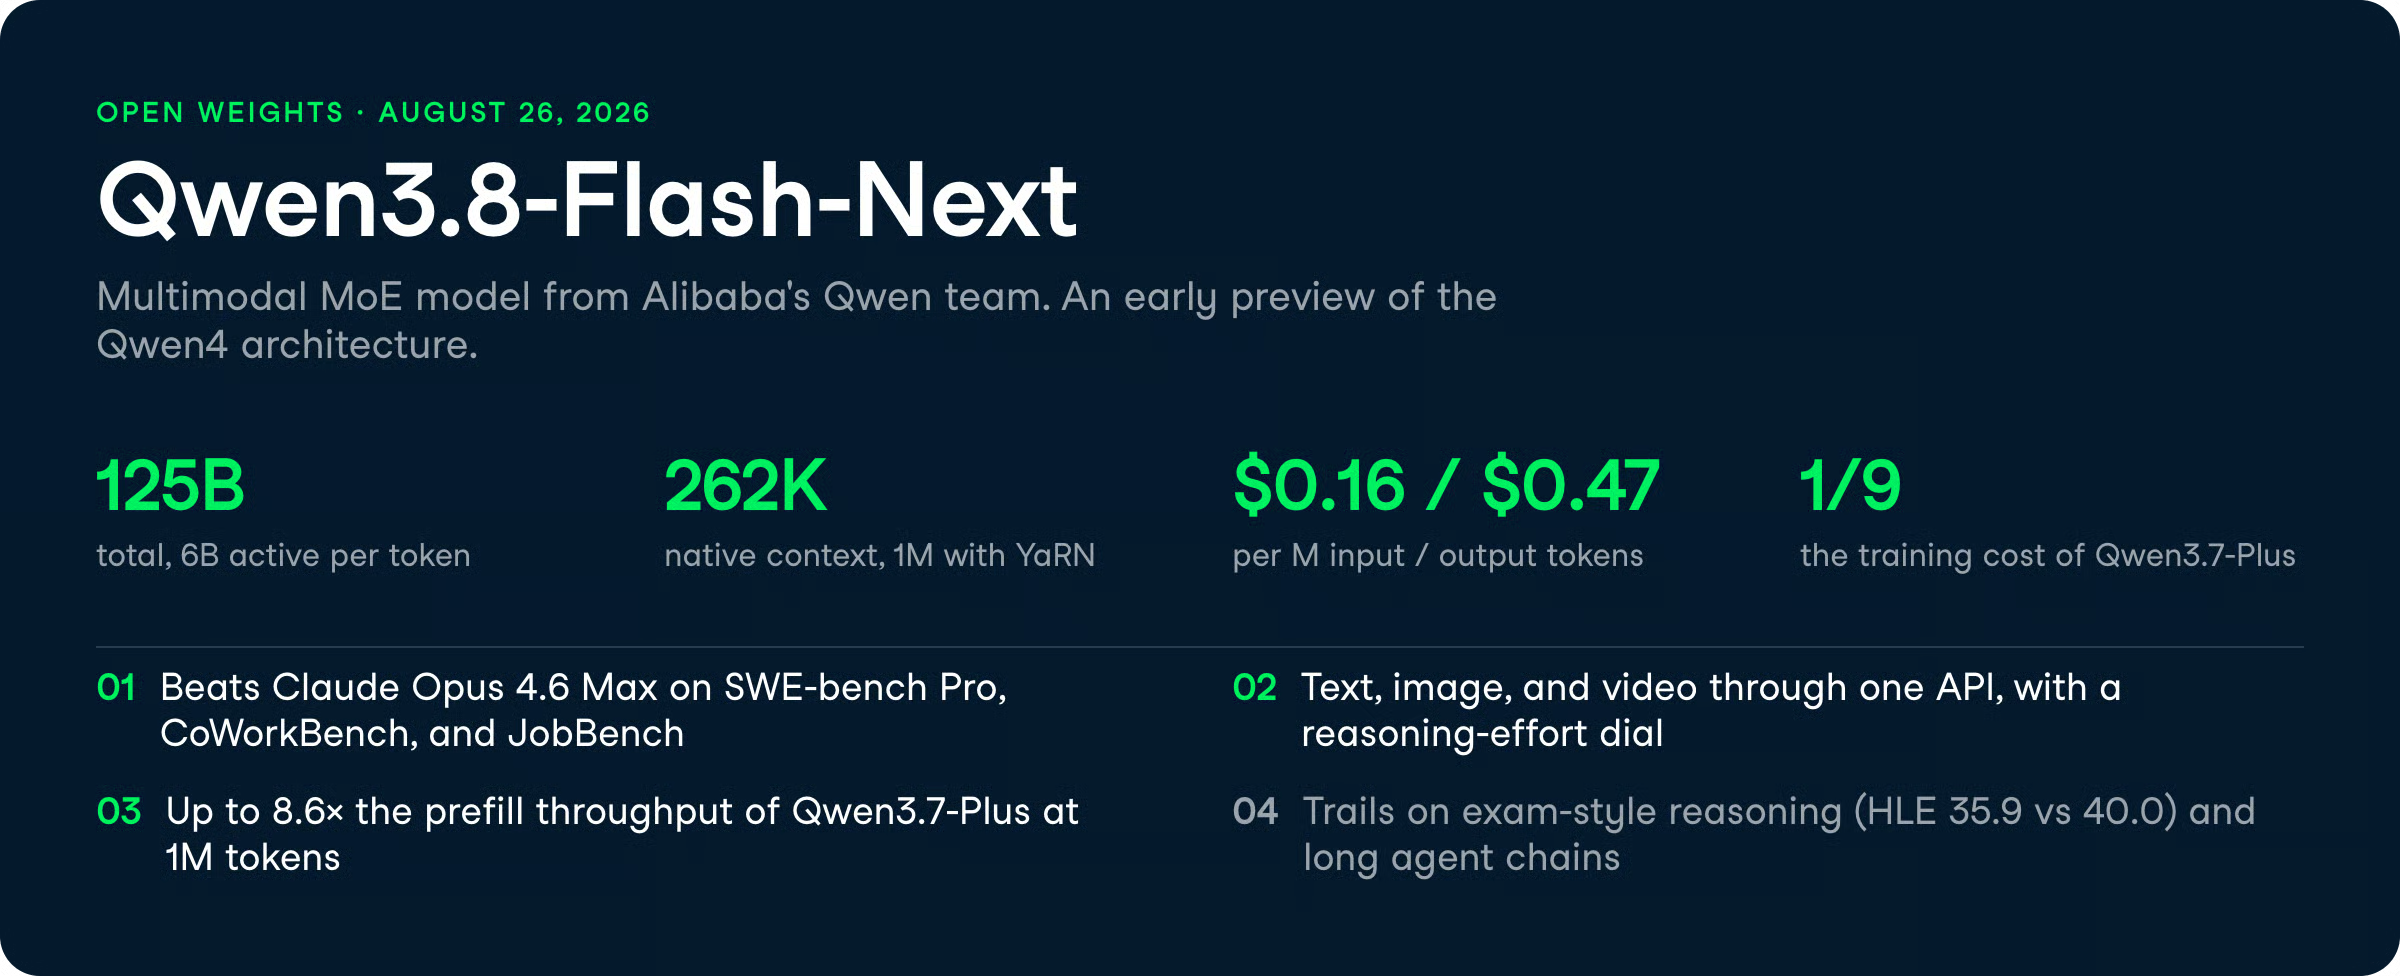
Qwen3.8-Flash-Next aggiorna il modello lungo quattro assi: attenzione, residui, embedding e ottimizzazione.
Di seguito spiego cosa ti portano concretamente questi cambiamenti, non solo cosa sono.
Il guadagno pratico più grande è la velocità sugli input lunghi.
Qwen3.8-Flash-Next usa un design di attenzione ibrido, in cui comprime gran parte della cronologia del contesto per risparmiare spazio e utilizza uno strumento mirato di "Sparse Attention" per recuperare solo i dettagli più rilevanti quando servono.
Le accelerazioni a 1 milione di token sono enormi: fino a 7,6x nel processamento del prompt (prefill) e 4,9x nella generazione (decode). In una tipica configurazione di serving con prefissi in cache, il throughput complessivo aumenta di 8,6x rispetto a Qwen3.7-Plus.
Per chi esegue retrieval ad alto volume o agenti di coding a livello di repository, quella differenza di throughput è la funzionalità.
Paghi il compute, e questo design taglia il conto proprio sulle sequenze lunghe che prima erano notoriamente costose.
Qwen usa un trucco ingegnoso chiamato N-gram Embedding per aggiungere 51 miliardi di parametri sostanzialmente gratis. Invece di guardare un solo token alla volta, considera il token corrente più i vicini recenti, offrendo al modello una grande "memoria di pattern locali".
Poiché il modello sa in anticipo cosa recuperare, questi 51B parametri extra risiedono nella normale memoria di sistema (RAM), non sulla GPU. Vengono richiamati automaticamente dietro le quinte, quindi non occupano in modo permanente la memoria GPU né rallentano il compute per token.
Ottieni il cervello di un modello molto più grande senza pagare la solita tassa di VRAM.
Qwen3.8-Flash-Next gestisce testo, immagini e video attraverso una singola interfaccia e le sue capacità di visione sono nettamente superiori alla sua fascia di costo.
Batte comodamente Claude Opus 4.6 Max nei test di utilizzo mobile (84,5 vs 62,0 su AndroidWorld) e nella comprensione visiva del mondo reale (88,5 vs 73,9 su RealWorldQA).
E domina anche la matematica visiva, raggiungendo fino a 95,7 su MathVision (ben avanti rispetto al 65,5 di Opus).
Se il tuo flusso di lavoro prevede il parsing di screenshot, grafici o interfacce app, Qwen offre un vantaggio reale su Claude a questo prezzo.
L'API ti offre una manopola reasoning effort con tre impostazioni (alta, media e bassa), che ti permette di scambiare profondità di ragionamento con latenza più bassa e richieste più economiche.
Il modello integra anche un modulo di previsione multi-token, che in pratica significa che predice diversi passi in anticipo per accelerare la generazione nei carichi reali.
Il risultato pratico è il controllo.
Puoi abbassare il ragionamento per traffico ad alto volume e sensibile ai costi, e aumentarlo per compiti agentici complessi, tutto usando lo stesso ID modello.
Nei numeri pubblicati, Qwen3.8-Flash-Next guida nella maggior parte dei benchmark di coding e agenti, rimanendo dietro in un paio di valutazioni di ragionamento in stile esame.
Supera il suo fratello da 27B ovunque, con i divari maggiori nel lavoro agentico.
Tutti i confronti sotto provengono dalla tabella di rilascio di Qwen salvo diversa indicazione.
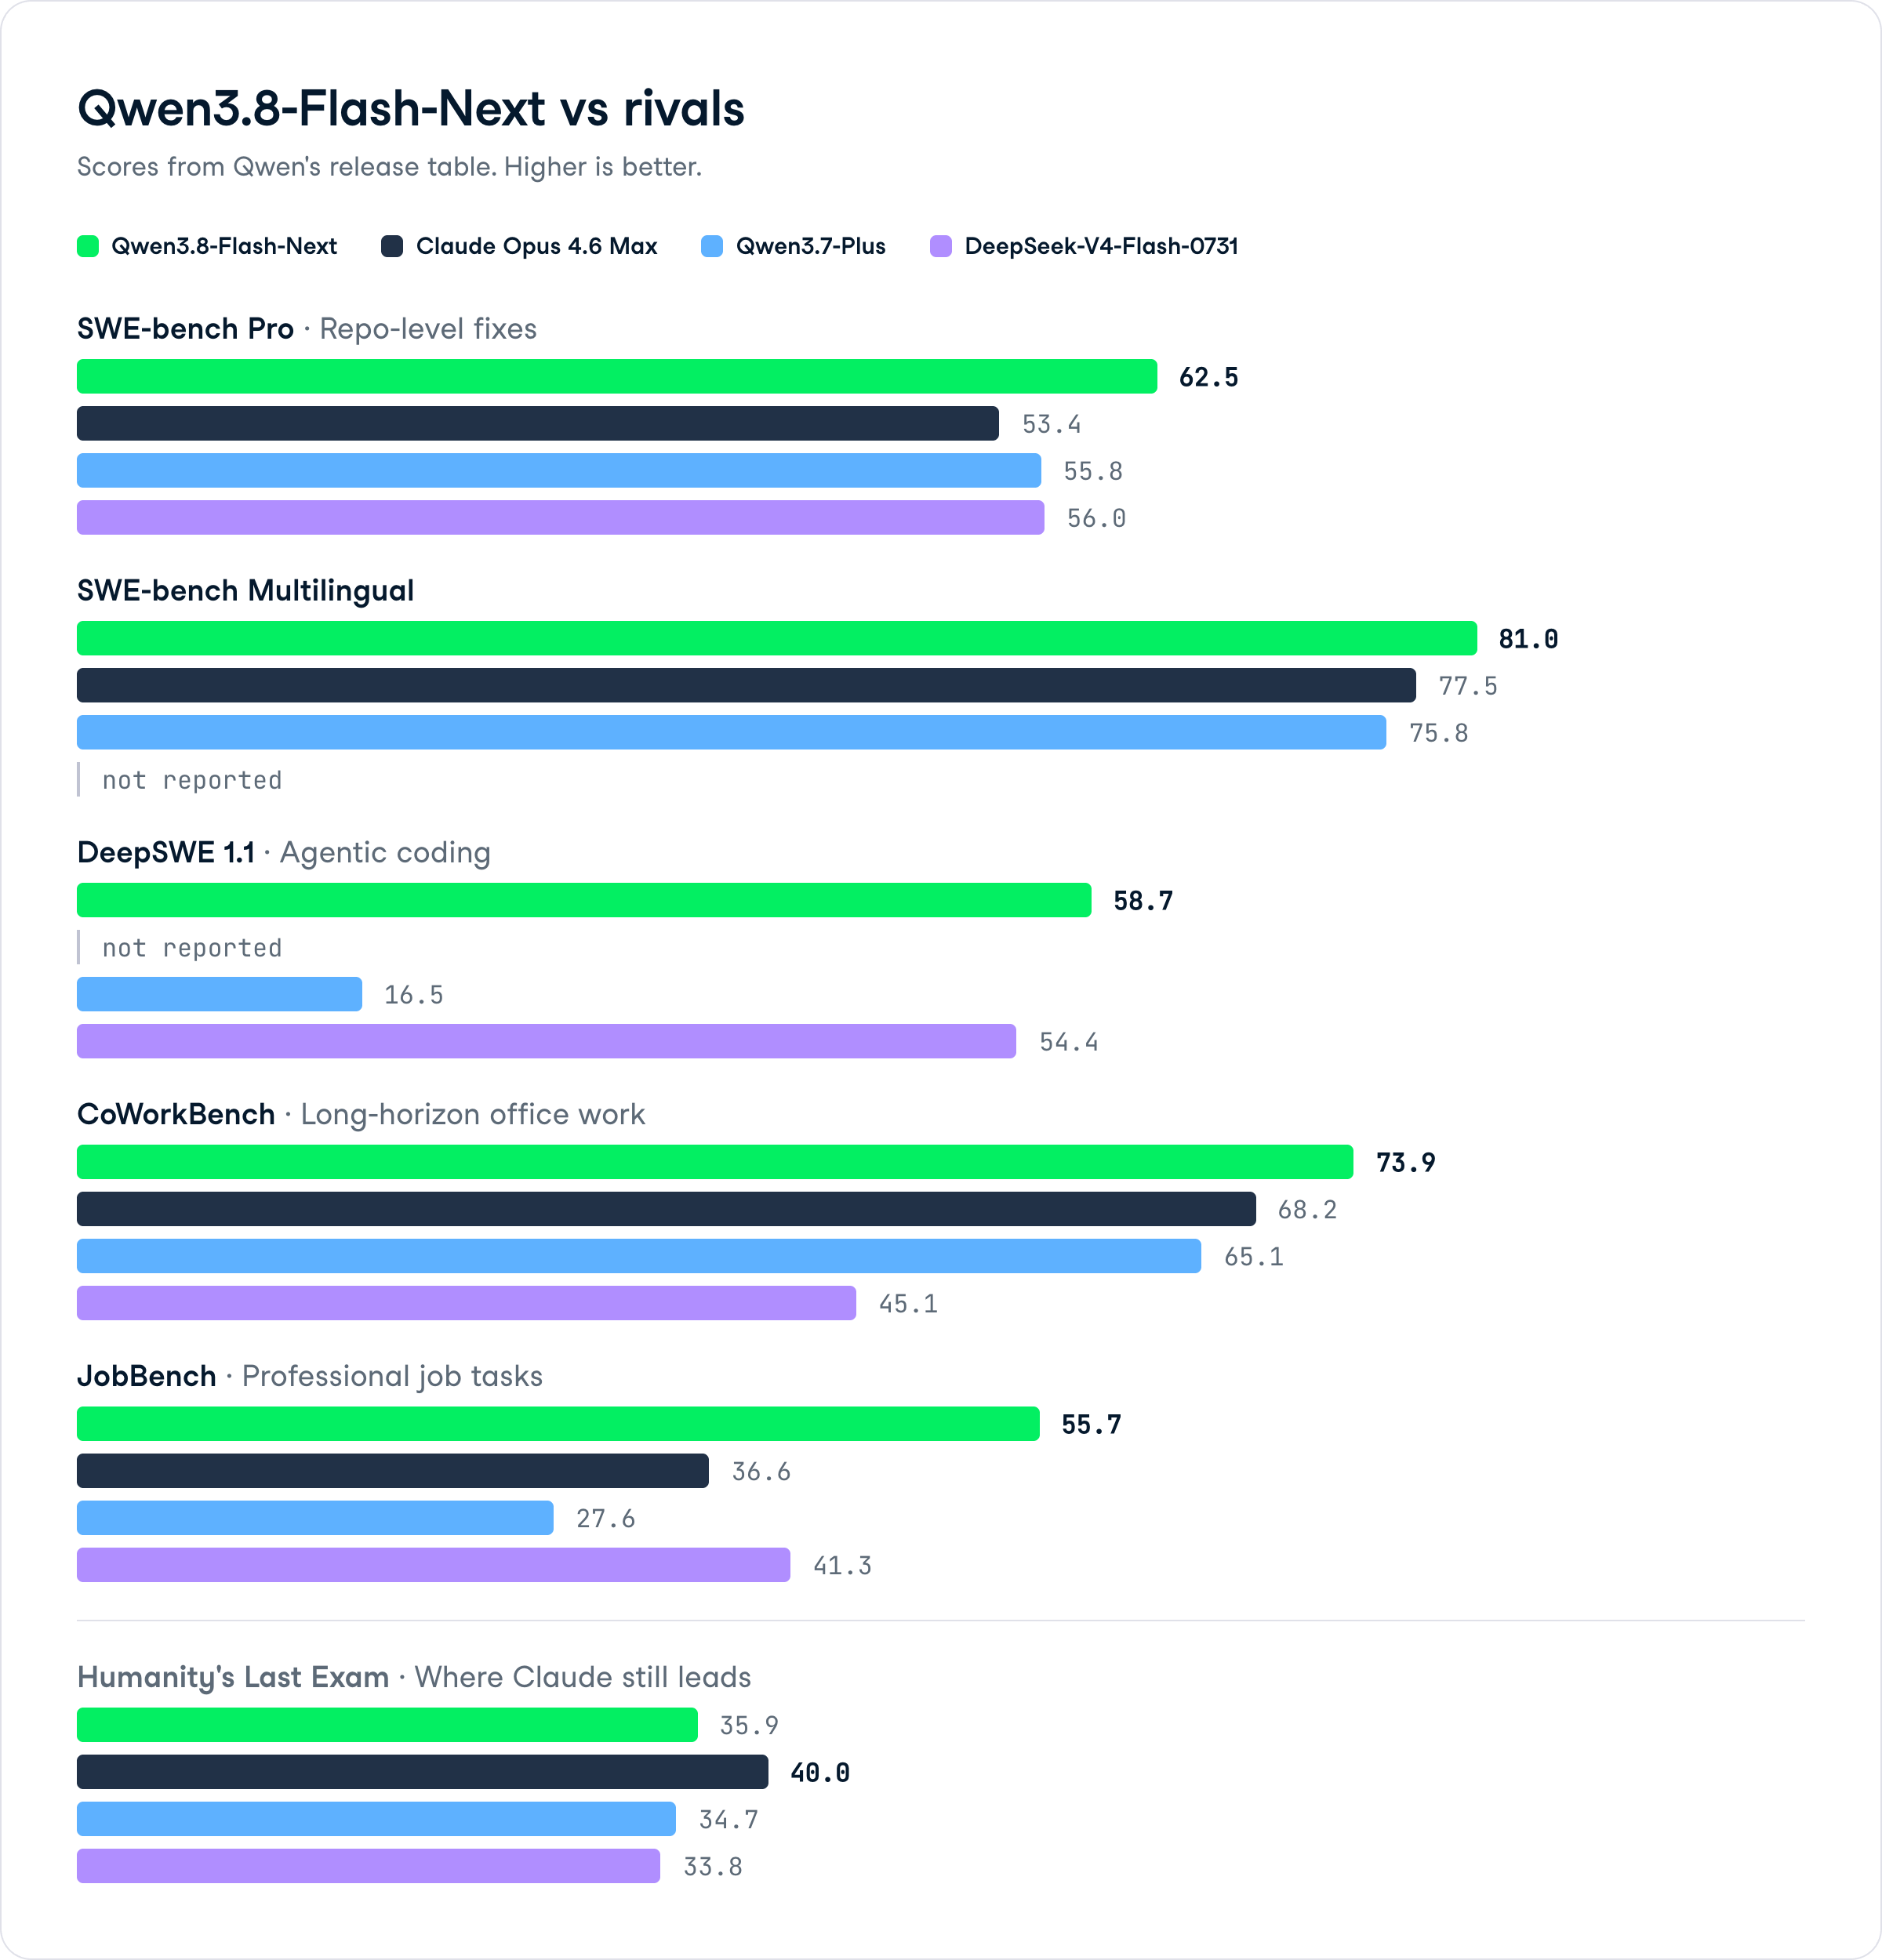
SWE-bench Pro misura correzioni software reali a livello di repository, e Qwen3.8-Flash-Next totalizza 62,5, davanti ai 53,4 di Claude Opus 4.6 Max e ai 55,8 di Qwen3.7-Plus.
Su SWE-bench Multilingual, che testa correzioni in più lingue, raggiunge 81,0 contro i 77,5 di Opus 4.6 Max.
Questi sono i numeri che trainano il rilascio.
Il fatto che un modello con 6B parametri attivi batta un Claude di fascia Max su ingegneria a livello di repository è il motivo per cui ha attirato tanta attenzione.
DeepSWE 1.1 valuta il coding agentico tramite harness come Claude Code e mini-SWE-agent, e Qwen3.8-Flash-Next segna 58,7 contro i 42,2 del suo fratello da 27B e i 16,5 di Qwen3.7-Plus.
DeepSeek-V4-Flash-0731 qui si attesta a 54,4.
Quando abbiamo eseguito DeepSeek-V4-Flash-0731 come agente di coding nel nostro tutorial, ha costruito un intero sito di analytics azionari da un singolo prompt in circa 20 minuti, generando chat a circa 33 token al secondo.
Il divario DeepSWE tra i due modelli suggerisce che Qwen3.8-Flash-Next dovrebbe cavarsela bene in loop di coding agentici simili.
Lato agenti, il modello mostra numeri solidi su diverse valutazioni:
Il divario su JobBench spicca.
Su compiti di workflow professionali, Qwen3.8-Flash-Next segna quasi 20 punti in più di un Claude di fascia Max, il tipo di risultato che vale la pena testare per l'automazione enterprise.
Nel ragionamento generale, Qwen3.8-Flash-Next raggiunge 91,7 su GPQA Diamond (ragionamento scientifico), appena davanti ai 91,3 di Claude Opus 4.6 Max, e 91,9 su LiveCodeBench v6 (coding competitivo) contro gli 88,8 di Opus 4.6 Max.
Non vince ovunque, però.
Su Humanity's Last Exam (HLE), che testa il ragionamento multidisciplinare, ottiene 35,9 contro i 40,0 di Claude Opus 4.6 Max. Su Agents' Last Exam Pass@1, DeepSeek-V4-Flash-0731 lo supera 25,2 a 24,3.
Il pattern regge anche sui tracker indipendenti: Qwen3.8-Flash-Next guida su coding pratico e lavoro agentico, mentre Claude mantiene il vantaggio su alcuni benchmark di ragionamento in stile esame.
Qwen3.8-Flash-Next-Base vince 8 benchmark su 14 di pretraining contro i modelli base di Qwen3.8-27B e il ben più grande Qwen3.7-Plus.
È in testa su MMLU-Pro (73,23), SuperGPQA (51,36), BBH (90,87), GSM8K (93,29), EvalPlus (78,76), SWEBench-Pretrain (50,99), MGSM (89,33) e MMMLU (84,86).
Colpisce che lo faccia con 6B parametri attivati contro i 17B attivi e 397B totali di Qwen3.7-Plus, restando entro un punto su MMLU, MMLU-Redux, GPQA, MATH e MultiPL-E.
I 51B parametri di N-gram embedding sono indirizzati in modo deterministico e non entrano mai nel budget di matmul per token, quindi si tratta di efficienza reale, non di un trucco sul conteggio parametri.
Ecco come il modello si confronta con Claude Opus 4.6 Max, il suo predecessore Qwen3.7-Plus e DeepSeek-V4-Flash-0731 nelle valutazioni principali.
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 53.4 | 55.8 | 56.0 |
| SWE-bench Multilingual | 81.0 | 77.5 | 75.8 | -- |
| DeepSWE 1.1 | 58.7 | -- | 16.5 | 54.4 |
| CoWorkBench | 73.9 | 68.2 | 65.1 | 45.1 |
| JobBench | 55.7 | 36.6 | 27.6 | 41.3 |
| GPQA Diamond | 91.7 | 91.3 | 90.3 | 90.8 |
| LiveCodeBench v6 | 91.9 | 88.8 | 89.6 | 90.6 |
| HLE | 35.9 | 40.0 | 34.7 | 33.8 |
I pesi di Qwen3.8-Flash-Next sono disponibili ora come modello open-weight su Hugging Face e ModelScope.
La versione di produzione, con contesto 1M di default e strumenti integrati, è servita come Qwen3.8-Flash su QwenCloud con ID modello qwen3.8-flash.
Il prezzo è dove questo modello compete più duramente:
Per confronto, la nostra copertura di Qwen3.8-Max indica quel modello a $2,00 in input e $6,00 in output per milione di token, quindi Flash-Next batte il suo stesso fratello Max di oltre 10x sull'input.
QwenCloud supporta le API Chat Completions e Responses compatibili con OpenAI oltre a un'interfaccia compatibile con Anthropic, quindi si integra in Claude Code, Codex e Qwen Code con modifiche minime di configurazione.
Nota che all'annuncio l'API era indicata come in arrivo, quindi verifica su QwenCloud la disponibilità attuale.
GLM-5.3-Flash è l'altro modello economico lanciato lo stesso giorno, ed è il rivale più diretto da mettere fianco a fianco.
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| Architettura | 125B totali / 6B attivi | 320B totali / 18B attivi |
| Contesto nativo | 262K (1M con YaRN) | 1M token |
| DeepSWE v1.1 | 58.7 | 63.4 |
| SWE-bench Pro | 62.5 | Non pubblicato |
| Prezzo input | $0.16/1M | ~$0.075/1M (promo) |
| Multimodale | Sì | Sì |
GLM-5.3-Flash guida su DeepSWE v1.1 (63,4 vs 58,7) e totalizza 84,3 su Terminal-Bench 2.1, un benchmark per cui Qwen non pubblica dati.
Ha anche un prezzo input più basso durante la finestra promozionale e una finestra di contesto da 1M token nativa, senza bisogno di YaRN.
Qwen3.8-Flash-Next guida su SWE-bench Pro (62,5), CoWorkBench (73,9) e JobBench (55,7), dove GLM non pubblica numeri equivalenti. Qwen attiva inoltre molti meno parametri per token (6B vs 18B), il che lo rende significativamente più economico da self-hostare e più veloce da servire su larga scala.
In sintesi, GLM ha numeri pubblicati più forti sui benchmark condivisi direttamente. Qwen guida sulle valutazioni di ufficio e workflow professionale, ed è la scelta migliore se gestisci la tua infrastruttura. Per una analisi completa di GLM-5.3-Flash, vedi la nostra guida.
Qwen3.8-Flash-Next è la dichiarazione chiara di Alibaba: l'efficienza dei costi è il campo di battaglia.
Battere Claude Opus 4.6 Max su SWE-bench Pro, CoWorkBench e JobBench con 6B parametri attivi, a $0,16 per milione di token in input, è una proposta seria per chi gestisce carichi di lavoro di coding o agenti ad alto volume.
Lo tratterei come una solida impostazione predefinita per pipeline basate su tool e pesanti di coding, con due caveat.
Segnalazioni dalla community indicano occasionali instabilità su catene agentiche molto lunghe e fragilità quando gli strumenti restituiscono JSON non standard, e il modello è meno conservativo sulla sicurezza rispetto alla serie Claude, quindi richiede prompt accurati per contenuti al limite.
I risultati su HLE e Agents' Last Exam mostrano inoltre che non è il modello a cui ricorrere per il ragionamento in stile esame più difficile.
Come anteprima dell'architettura Qwen4, i design ibridi GDN + QSA e N-gram Embedding meritano attenzione, perché saranno la base dell'intera famiglia Qwen4.
Se Alibaba riuscirà a mantenere questo rapporto benchmark-per-dollaro al livello flagship, cambierà la conversazione sui prezzi al frontier.
Se vuoi costruire workflow agentici e di coding attorno a modelli come questo, ti consiglio di partire dal nostro percorso di competenze AI Agent Fundamentals per allinearti ai concetti chiave.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min