
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.7K
De huidige golf van Flash-klasse modellen blijft zich opstapelen.
We bespraken onlangs Qwen3.8-Flash-Next, GLM-5.3-Flash, Gemini 3.8 Flash en DeepSeek V4.1 Flash, die allemaal strijden om de plek in de markt waar kosten en snelle inferentie cruciaal zijn.
Alibaba's Qwen-team voegt nu een nieuwe invalshoek toe met Qwen3.8-Omni-Flash, een native omnimodaal model dat is gebouwd rond audio- en videoagents.
Qwen3.8-Omni-Flash accepteert tekst-, beeld-, audio- en video-invoer met een contextvenster van 1M tokens. Alibaba claimt audio-visuele prestaties die dicht bij Gemini 3.8 Flash liggen en algehele audioprestaties die daarbovenuit stijgen, naast een gemiddelde verbetering van 25%+ ten opzichte van zijn voorganger Qwen3.5-Omni-Plus over 29 evaluaties. De kop-resultaten voor agents zijn 36,5 punten op WildClawBench-MM en een gerapporteerde daling van 98%+ in de uurprijs van audio-invoer.
In dit artikel neem ik alles wat nieuw is in Qwen3.8-Omni-Flash door: de nieuwe functies, een vergelijking met de andere Flash-modellen die we hebben beoordeeld, en een wandeling langs de benchmarks.
Wil je meer weten over hoe deze modellen zich tot elkaar verhouden, bekijk dan onze gids DeepSeek V4.1 Flash vs Gemini 3.8 Flash en onze vergelijking van GLM-5.3 Flash vs Qwen3.8-Flash-Next.
Qwen3.8-Omni-Flash is een native omnimodaal model van Alibaba's Qwen-team en valt in de Flash-tier als de kostenefficiënte, high-throughput optie in het portfolio.
Het verwerkt tekst, beeld, audio en video in één model en ondersteunt een contextvenster van 1M tokens, terwijl het tekstprestaties behoudt die vergelijkbaar zijn met een tekst-only model van dezelfde grootte.
Het doel van deze generatie is agent-capaciteit in audio en video, niet alleen begrip daarvan.
Waar Qwen3.5-Omni-Plus zich richtte op het interpreteren van omnimodale content, is Qwen3.8-Omni-Flash gebouwd om taken te plannen, tools aan te roepen en creatief werk af te ronden zoals videobewerking, het maken van music videos en filmcommentaar.
Alibaba presenteert dit als het verplaatsen van audio en video van louter perceptuele input naar de kernmedia waarmee een agent redeneert en uitvoert.
De grote claim hier is een sprong van 36,5 punten op WildClawBench-MM naar 71,0 (Qwen3.5-Omni-Plus scoorde 34,5), plus 22,3 punten winst op AgenticVBench.
Bij tests op echte vergaderaudio, waar mensen vaak door elkaar praten, liet het nieuwe systeem enorme verbeteringen zien ten opzichte van het oude:
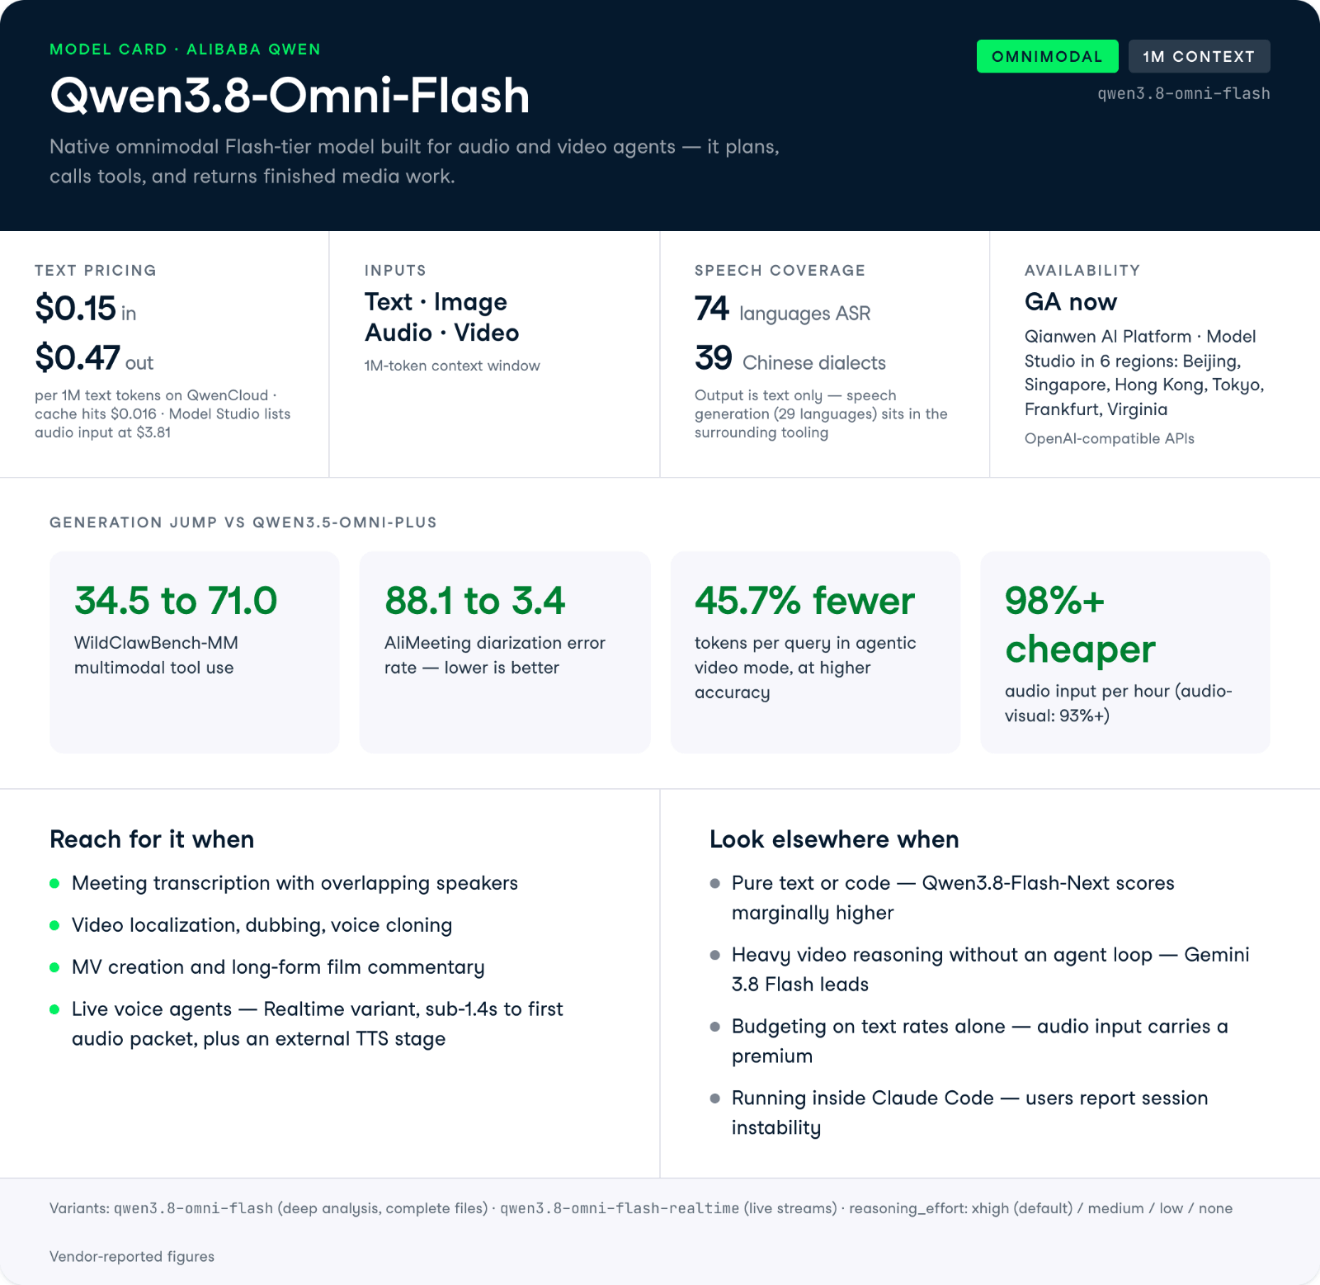
De functies draaien hier om één idee: een agent handen geven voor audio- en videowerk, niet alleen ogen en oren.
Alibaba leverde het model samen met twee toolinglagen: Qwen-MM-Plugins voor workflows op lange termijn en Qwen-Live Harness voor realtime interactie.
Je kunt Qwen3.8-Omni-Flash een nummer of een volledige speelfilm geven en in één zin beschrijven wat je wilt; het model plant de taak, roept creatieve tools aan en levert een afgewerkte video terug.
Het ondersteunt end-to-end workflows, waaronder het maken van music videos, vertaling van korte drama’s met voice cloning en filmcommentaar op lange vorm.
Voor een film van twee uur voert het model langvorm video-understanding uit, haalt kernplots eruit, plant commentaar, produceert voice-over en muziek, monteert en doet een finale kwaliteitscontrole.
Het kan originele dialogen afwisselen met narratie en het spreektempo en volume aanpassen zodat de audiolagen goed op elkaar aansluiten.
Dit is belangrijk omdat de gefragmenteerde transcribe-translate-dub-edit-cyclus precies de coördinatiekosten zijn die dit soort projecten voor solocreators de das omdoen.
Je bepaalt waar het model naar kijkt, hoe nauwkeurig het kijkt en hoe het het resultaat presenteert, in plaats van een vaste beschrijving te accepteren.
Gebruikers kunnen voor dezelfde video het onderwerp, de tijdsrange, het detailniveau en het uitvoerformaat specificeren.
Stel, je voert een productdemo van 40 minuten in. Je kunt vragen om een overzicht van 200 woorden voor een listingpagina, en vervolgens dezelfde clip opnieuw draaien met het verzoek om een JSON-schema-uitvoer met timestamps per scène, on-screen tekstuittreksels en transcripties met sprekerstags voor een downstream-pijplijn.
Op OmniCap-IF verbeteren de scores voor contentstructuur en instructie-opvolging (CSR en ISR) met 8,5 en 14,1 punten ten opzichte van de voorganger.
In plaats van een volledige opname van meerdere uren te verwerken, begint het model bij jouw vraag en beslist het wat het moet bekijken en beluisteren via grof-naar-fijn bewijsverzameling.
Dit richt rekenkracht en tokens op de relevante segmenten.
Op OmniVideoBench verhoogt deze agentische modus de nauwkeurigheid van 63,4 naar 67,8, terwijl het tokenverbruik per query daalt van 145.736 naar 79.117, een reductie van circa 45,7%.
Voor iedereen die per token betaalt op uren aan beeldmateriaal, is die efficiëntiewinst dé feature.
Een aparte variant, Qwen3.8-Omni-Flash-Realtime, neemt waar en reageert terwijl het live audio-visuele streams ontvangt en gebruikt realtime context om tools aan te roepen.
Het ondersteunt spreekvaardigheidsoefening met uitspraakfeedback, ruimtelijke audioperceptie en kennisinjectie via Skills.
De claim rond ruimtelijk geluid is hier het opvallendst: Alibaba zegt dat dit het eerste omnimodale model is dat een doelwit kan lokaliseren op gehoor, waarbij directionele audio wordt gecombineerd met visuele informatie om richting en afstand van een bron te bepalen.
De gerapporteerde time-to-first-audio-packet ligt onder de 1,4 seconden, zelfs voor audio-visuele input van 20 seconden.
Qwen3.8-Omni-Flash ondersteunt spraakherkenning in 74 talen en 39 Chinese dialecten, van Mandarijn en Kantonees tot Sichuanese, Shanghains en Southern Min.
Spraakgeneratie dekt 29 talen en 7 dialecten.
Voor localisatie- en dubbingworkflows is die dialectbreedte een praktisch onderscheid ten opzichte van de meeste concurrerende Flash-modellen, die doorgaans wel aantallen talen publiceren maar geen dekking op dialectniveau.
Een van de opvallendere demo’s in de release is dat Alibaba Qwen3.8-Omni-Flash gebruikt om een kleiner model te verbeteren in plaats van direct gebruikers te bedienen.
Met 12 uur om de herkenning van het Sichuan-dialect van Qwen2.5-Omni-3B te verbeteren, selecteerde de agent de WenetSpeech-Chuan-evaluatieset, bouwde een baseline en diagnosticeerde fouten door naar audiovoorbeelden te luisteren.
Over vier rondes creëerde het 3.413 trainingsvoorbeelden, draaide mislukte pogingen terug en verlaagde de karakterfoutgraad van 25,79% naar 15,30%, een relatieve daling van circa 40,7%.
Het is een klein experiment, maar het wijst op een groter model dat de training van gespecialiseerde kleine modellen voor productie aanstuurt.
Het patroon over de benchmarks is consistent: Qwen3.8-Omni-Flash wint de audiocategorie overtuigend, wisselt stuivertje met Gemini 3.8 Flash op audio-visuele taken en blijft competitief op tekst ten opzichte van zustermodellen.
Het staat niet universeel voorop, en verschillende videoredeneer-tests vallen nog steeds in het voordeel van Gemini 3.8 Flash uit.
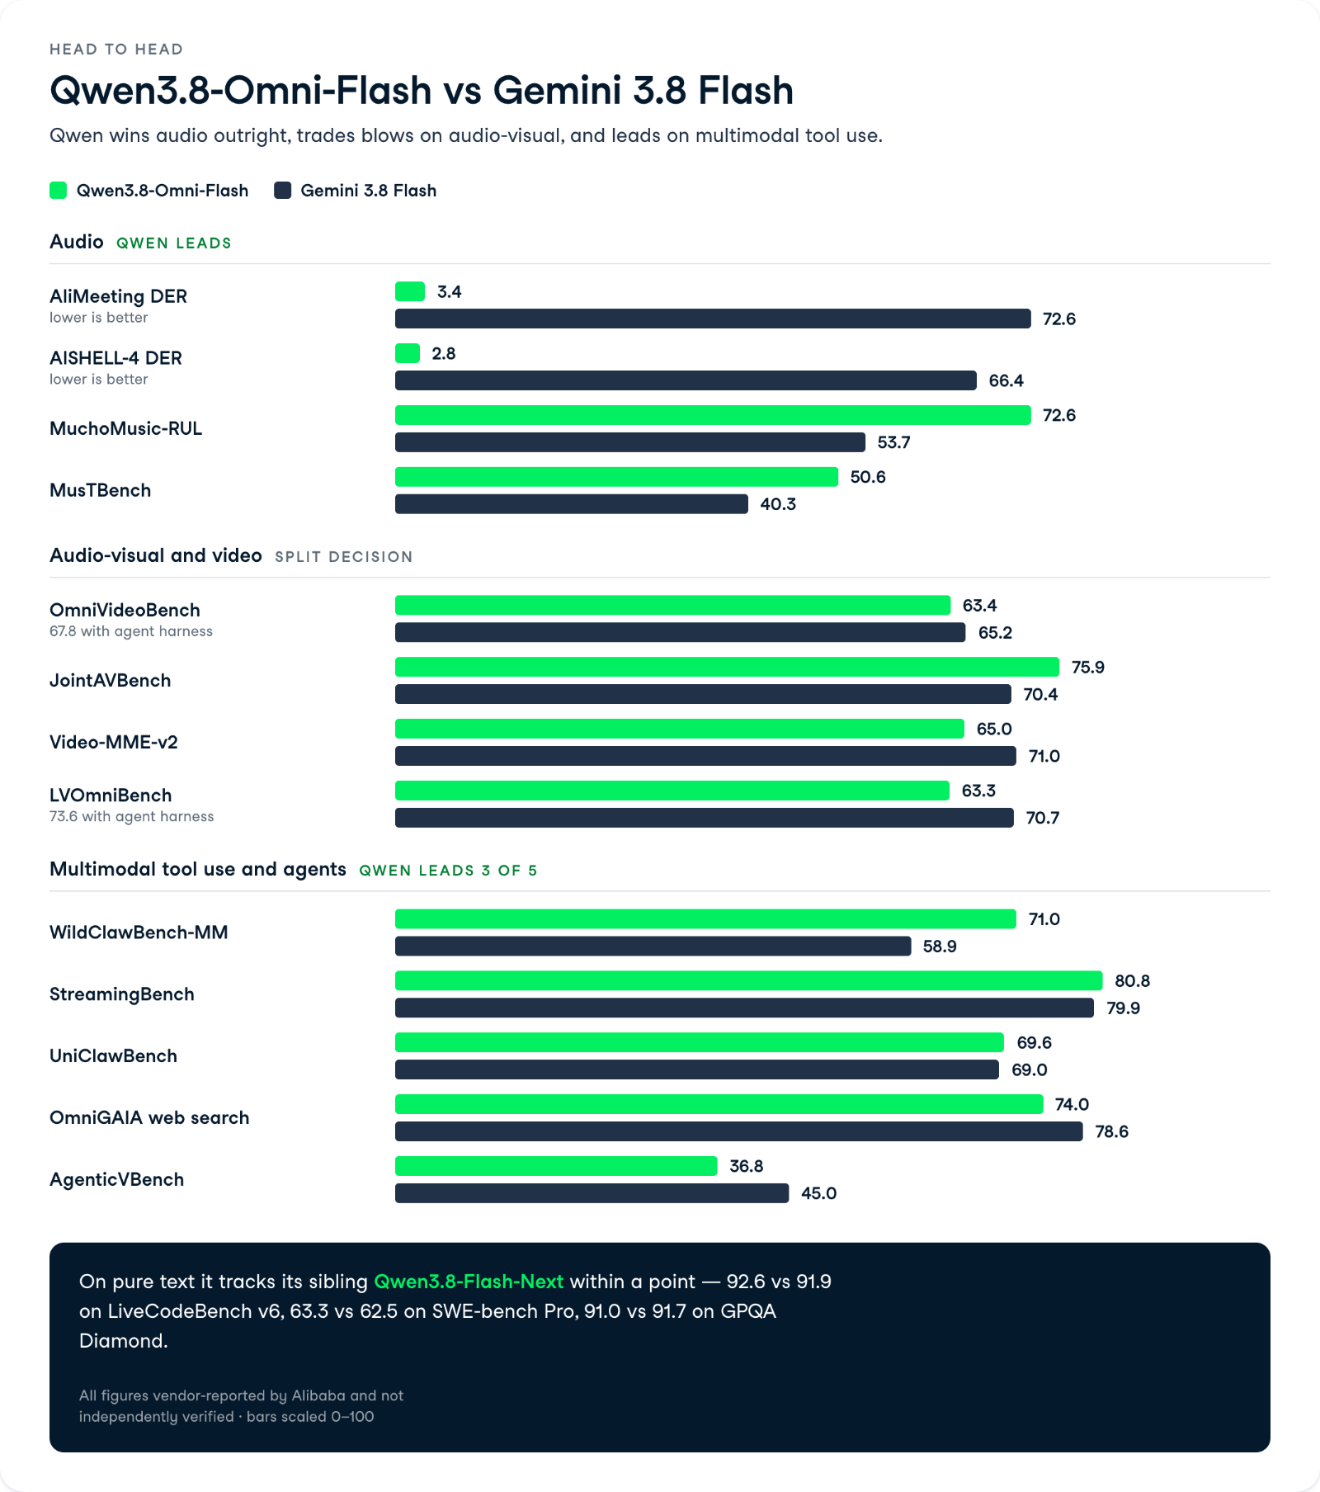
Hier is het model op zijn sterkst en verslaat het Gemini 3.8 Flash met ruime marge.
Op de AliMeeting multi-speaker ASR-test noteert het een diarisatiefoutpercentage van 3,4 tegenover 72,6 voor Gemini 3.8 Flash, en op AISHELL-4 haalt het 2,8 tegenover 66,4 voor Gemini, wat laat zien dat Gemini het zwaar heeft met overlappende sprekers.
Diarisatiefoutpercentage meet hoe goed een model spraak toekent aan de juiste spreker; een lage score is dus belangrijk voor notulen, interviewtranscripties en elke workflow waarin mensen door elkaar praten.
Ook op muziekinzicht loopt het duidelijk voor: 72,6 op MuchoMusic-RUL tegenover 53,7 voor Gemini, en 50,6 op MusTBench tegenover 40,3.
Hier gaat Gemini 3.8 Flash meestal nipt aan de leiding, maar het gat is klein en sluit wanneer Qwen in agentmodus draait.
De rijen voor videoredeneerwerk zijn gemengder.
Op Video-MME-v2 leidt Gemini met 71,0 tegen 65,0 statisch, en op LVOmniBench houdt Gemini 70,7 tegenover 63,3 voor Qwen, hoewel Qwen naar 73,6 springt met het agent-harnas.
Als je werk zwaar leunt op videoredenatie zonder agent-loop, heeft Gemini nog de overhand.
Agentcapaciteit is de pitch, en de WildClawBench-MM-score ondersteunt dat: 71,0 voor Qwen3.8-Omni-Flash tegenover 58,9 voor Gemini 3.8 Flash en 41,9 voor Seed 2.0 Lite.
Op UniClawBench staan de twee praktisch gelijk met 69,6 en 69,0.
Gemini wint wel AgenticVBench met 45,0 tegen 36,8 voor Qwen en OmniGAIA web search met 78,6 tegen 74,0.
Dus het verhaal rond tool-use is echt, maar geen clean sweep. Op StreamingBench, een interactiebenchmark, leidt Qwen overtuigend met 80,8 tegenover 79,9 voor Gemini en 57,1 voor de voorganger.
Op pure tekst volgt Qwen3.8-Omni-Flash zijn tekst-only broer Qwen3.8-Flash-Next op de voet, meestal binnen een punt.
Het scoort 92,6 op LiveCodeBench v6 (Qwen3.8-Flash-Next: 91,9), 63,3 op SWE-bench Pro (Qwen3.8-Flash-Next: 62,5) en 91,0 op GPQA Diamond (Qwen3.8-Flash-Next: 91,7).
Tegen DeepSeek-V4-Flash-0731 leidt Qwen3.8-Omni-Flash op SWE-bench Pro (63,3 vs 56,0) en IFBench (81,5 vs 79,2), maar DeepSeek wint NL2Repo-Bench met 54,2 tegen 48,9.
Toen we DeepSeek-V4-Flash-0731 testten, vonden we het het sterkste lokale codemodel dat we tot dan toe hadden gedraaid, dus een omnimodaal model in de Flash-tier dat dit evenaart op repo-niveau software-engineering is een serieus resultaat.
Qwen3.8-Omni-Flash wordt geleverd in twee varianten plus een instelbare redeneringsinstelling, dus de juiste combinatie hangt af van of je diepe contentanalyse of live interactie nodig hebt.
De verdeling is eenvoudig:
Je gebruikt het basismodel niet voor een live gesprek, en je gebruikt Realtime niet om een filmcommentaar van twee uur te renderen.
Naast de keuze voor een variant biedt het basismodel een reasoning_effort-parameter met xhigh (standaard), medium en low, zodat je diepgang in redenering kunt inruilen voor snelheid en kosten.
Gebruik low voor grootschalige bijschriftprojecten waar snelheid telt en xhigh voor meerstapsplanning zoals het schrijven van commentaar.
| Use case | Variant | Why |
|---|---|---|
| MV- en filmcommentaar-creatie | Qwen3.8-Omni-Flash | Plannen op lange horizon en tool-calls op volledige bestanden |
| Vergadernotulen en actielijsten | Qwen3.8-Omni-Flash | Gezamenlijke audio-visuele sprekerherkenning, tot 1 uur input |
| Live stemassistenten en klantenservice | Qwen3.8-Omni-Flash-Realtime | Minder dan 1,4 s tot eerste audiopakket, Skills voor kennisinjectie |
| Ruimtelijke audio en navigatie | Qwen3.8-Omni-Flash-Realtime | Localiseert doelen op geluid in realtime |
Derde partijen plaatsen Qwen3.8-Omni-Flash op ongeveer $0,15 input / $0,47 output per 1M teksttokens, waarbij OmniaKey en LLM Reference beide de officiële tarieven noemen. Venice API vermeldt een gerelateerde Qwen 3.8 Flash-route op $0,14 input / $0,49 output. Dit zijn tekstrates.
Audio- en audio-visuele input kosten meer, en dit is de belangrijke kanttekening. De prijsaantekening van Puter geeft aan dat audio-invoer een toeslag heeft ten opzichte van tekst, en Alibaba’s eigen vergelijking zet audio-visuele input af tegen Gemini 3.8 Flash in plaats van een vast tokentarief te citeren. Alibaba claimt dat de uurprijs van audio-invoer met meer dan 98% is gedaald ten opzichte van Qwen3.5-Omni-Plus en audio-visuele input met meer dan 93%, dus de toeslag is kleiner dan voorheen, maar bestaat nog steeds.
Het model is nu algemeen beschikbaar op het Qianwen AI Platform en routeert via Alibaba Cloud Model Studio, met endpoints in Peking en Singapore. Er is geen gratis consumententier beschreven in de releasenotes.
De API-model-ID is qwen3.8-omni-flash, en de realtimevariant is qwen3.8-omni-flash-realtime.
Het ondersteunt OpenAI-compatibele Chat Completions- en Responses-API’s, en de multimodale tooling haakt in op agent-harnassen, waaronder Codex, Claude Code, Qwen Code en Gemini CLI via Qwen-MM-Plugins.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{"role": "user", "content": "Summarize this meeting recording."}],
    reasoning_effort="xhigh",  # xhigh, medium, or low
)
print(completion.choices.message.content)
Eén gerapporteerd ruw randje: GitHub-gebruikers hebben frequente onderbrekingen en instabiliteit in sessies gemeld bij het draaien van Qwen3.8-Omni-Flash met Claude Code, dus plan tijd in voor harnas-troubleshooting.
Voor meer info over de setup, zie onze tutorial over het draaien van Flash-klasse modellen en onze Qwen3.8-Max-gids.
Alibaba kiest bewust een specifieke koers in plaats van elke Flash-rivaal op tekst achterna te jagen.
Vergeleken met Qwen3.8-Flash-Next, GLM-5.3-Flash, Gemini 3.8 Flash en DeepSeek V4.1 Flash is de pitch hier audio- en videoagents plus de goedkoopste tekstprijs in de groep.
Ik zou hiervoor kiezen als je werk vergadertranscripties, videolocalisatie of MV- en commentaarproductie omvat, waar de audio-visuele agenttooling en de AliMeeting-diatisatiewinsten echt opvallen.
Voor pure tekst of code scoort Qwen3.8-Flash-Next marginaal hoger, en Gemini 3.8 Flash leidt nog steeds op sommige videoredenatie, dus het is geen automatische vervanger voor iedereen.
Als je vertrouwd wilt raken met agentworkflows en multimodale modellen, raad ik aan te beginnen met de AI Fundamentals skill track.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

