
Last chance! 50% off DataCamp Premium
Sale ends in
La corsa ai modelli di frontiera alla fine del 2026 è stata soprattutto una gara al ribasso sui prezzi più che sulla pura capacità. Solo a settembre abbiamo visto GPT-6 Astra di OpenAI e Claude Fable 5.1 di Anthropic posizionarsi entrambi a $10 per 1M token in input e $50 per 1M token in output, e nessuno dei due è disponibile su piani gratuiti.
La risposta di DeepSeek è andare nella direzione opposta.
DeepSeek V4.1 Flash è un modello mixture-of-experts da 552 miliardi di parametri che ne attiva circa 8 miliardi in input e 16 miliardi in output, include pesi open con licenza MIT e costa $0,30/$1,20 per 1M token nelle fasce di picco, scendendo a $0,15/$0,60 fuori picco, battendo altri modelli Flash simili come Gemini 3.8 Flash e GLM-5.3-Flash.
In questo articolo ti racconto tutto ciò che c’è di nuovo in DeepSeek V4.1 Flash, esplorando le nuove funzionalità e i benchmark. Se vuoi vedere il modello in azione, leggi il nostro tutorial sull’API di DeepSeek V4.1.
Per saperne di più sulla famiglia DeepSeek, dai un’occhiata alla nostra guida su come eseguire DeepSeek-V4-Flash-0731 con Unsloth Studio e OpenCode e al nostro confronto tra DeepSeek v4.1 Flash e Gemini 3.8 Flash.
DeepSeek V4.1 Flash è il modello più recente della linea Flash di DeepSeek, pensato come livello efficiente e ad alto throughput, non come un heavyweight da ricerca.
È un’architettura MoE sparsa con 552 miliardi di parametri totali, di cui solo circa 8 miliardi sono attivi per token in input e 16 miliardi in output. Questa attivazione sparsa mantiene bassi i costi di serving pur raggiungendo punteggi di livello frontier su diversi benchmark.
La novità principale rispetto alla generazione precedente è l’efficienza.
DeepSeek ha ridotto la KV cache a circa un quarto della dimensione del precedente V4 Flash, diminuendo l’impronta di memoria e permettendo al modello di gestire contesti più lunghi a costi inferiori. L’azienda afferma anche che V4.1 Flash supera il vecchio V4 Pro 0813 per prestazioni, costo, velocità e tempo totale, e che V4 Pro è in fase di dismissione.
Sul fronte dei benchmark, il numero che spicca è 90,6 su Terminal-Bench 2.1. Quando abbiamo testato il precedente DeepSeek-V4-Flash-0731, aveva ottenuto 82,7 sullo stesso benchmark, quindi V4.1 Flash rappresenta un vero salto di qualità nel lavoro agentico da terminale all’interno della stessa famiglia.
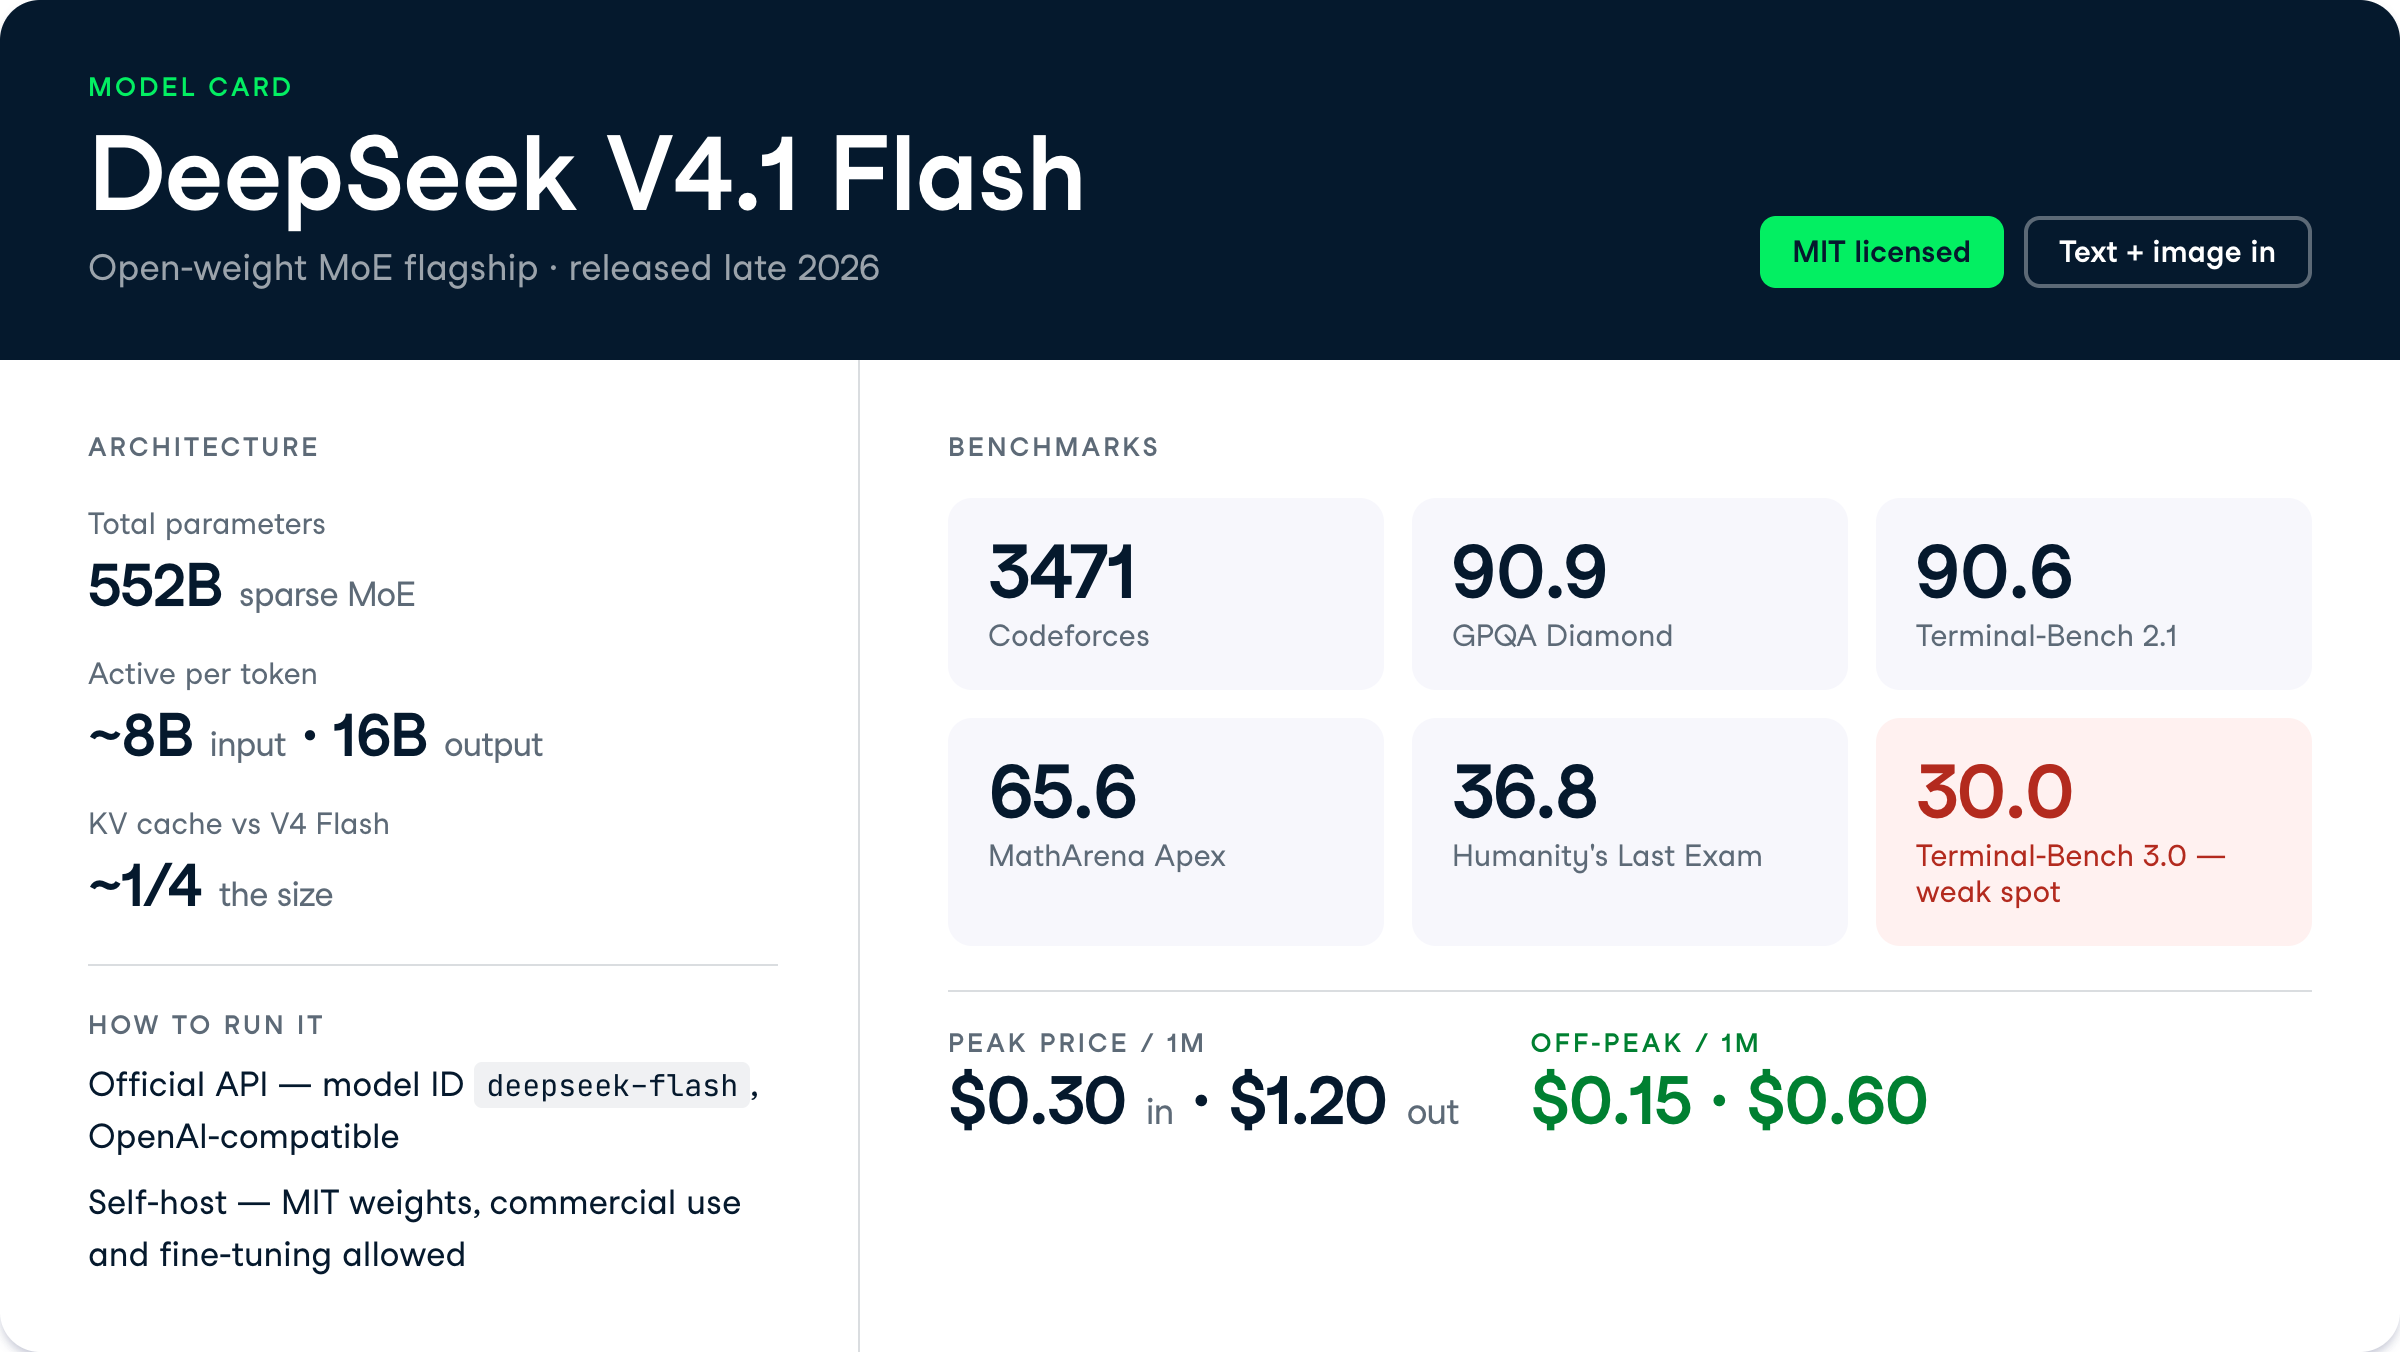
Il set di funzionalità di V4.1 Flash ruota attorno a due idee: costi bassi e apertura. Ecco le capacità che contano di più per un data scientist o ML engineer al lavoro.
V4.1 Flash include pesi con licenza MIT, la licenza comune più permissiva, che consente uso commerciale, ridistribuzione e fine-tuning senza soglie di ricavo.
Per i team con vincoli di privacy dei dati, questo significa che puoi eseguire il modello interamente sulla tua infrastruttura invece di inviare richieste all’API di DeepSeek.
Il rovescio della medaglia è che la licenza MIT trasferisce su di te la responsabilità per sicurezza, fine-tuning e ottimizzazione dell’inferenza.
Quando abbiamo eseguito localmente il precedente V4-Flash-0731, servivano tre GPU NVIDIA A100 80GB a quantizzazione Q8, quindi l’auto-hosting è praticabile solo quando hai vera memoria GPU da dedicare.
V4.1 Flash accetta immagini direttamente in input, senza un adattatore di visione separato o uno step di pre-processing. Questo ti permette di inserire screenshot, grafici o scansioni di documenti nella stessa richiesta insieme al testo, utile per pipeline documentali e workflow da UI-agent.
L’input multimodale nativo a questo prezzo è insolito. Nella valutazione ZeroBench-main con strumenti, V4.1 Flash ottiene 49,0, un segnale indicativo di come gestisce il reasoning su input visivi.
La KV cache in V4.1 Flash è circa un quarto della dimensione del precedente V4 Flash, riducendo il costo di memoria nel mantenere contesti lunghi in una sessione di serving.
Per chi esegue inferenza always-on, una KV cache più piccola significa più sessioni concorrenti per GPU oppure minore overhead di memoria per richiesta.
Combinato con l’input da cache-hit a $0,006 per 1M token in fascia di picco, il riuso del contesto diventa estremamente economico. Se invii ripetutamente lo stesso prompt di sistema o lo stesso documento, la parte in cache costa quasi nulla.
DeepSeek adotta uno schema a due livelli in cui i prezzi fuori picco sono fissati alla metà dei prezzi di picco, con l’intento dichiarato di spostare i carichi batch e schedulati nelle finestre fuori picco. Questo trasforma $0,30/$1,20 in $0,15/$0,60 per 1M token se riesci a programmare i job.
La riserva è operativa. I carichi always-on diventano più difficili da prevedere in termini di costo, e per cogliere lo sconto serve logica di schedulazione dei job che devi costruire e mantenere tu.
Il punto di forza di V4.1 Flash sono i benchmark agentici e di reasoning, dove raggiunge punteggi vicini alla frontiera a una frazione del costo per token.
I punteggi calano nettamente sulle valutazioni agentiche più dure, cosa da sapere prima di affidargli compiti a lungo orizzonte.
V4.1 Flash ottiene 90,6 su Terminal-Bench 2.1, che misura quanto bene un modello completa task multi-step in un ambiente terminale.
Per dare un riferimento, DeepSeek-V4-Flash-0731 ha ottenuto 82,7 nello stesso benchmark nei nostri test, e GPT-5.6 Terra ha raggiunto 87,4 nel nostro confronto Terra vs. Sonnet 5.
Il quadro cambia sulle valutazioni agentiche più difficili.
V4.1 Flash scende a 30,0 su Terminal-Bench 3.0, quindi il modello gestisce bene i task terminal standard ma fatica con la suite agentica più impegnativa. Il suo rating Codeforces di 3471 indica una forte capacità di competitive programming.
Su GPQA Diamond, un set di domande scientifiche a livello di laurea magistrale progettate per essere difficili da rispondere a memoria, V4.1 Flash ottiene 90,9.
È un risultato solido per un modello in questa fascia di prezzo e lo mette in dialogo con modelli di frontiera ben più costosi.
Su Humanity’s Last Exam (HLE), un benchmark volutamente severo a livello esperto, V4.1 Flash ottiene 36,8, o 39,1 con la configurazione con asterisco.
Per confronto, valutazioni di scienza agentica come Terminal-Bench-Science 0.1 mostrano Claude Fable 5.1 al 52,6% contro rivali più duri, quindi V4.1 Flash non guida le eval più estreme, ma non sfigura nemmeno.
V4.1 Flash ottiene 65,6 su MathArena Apex, un benchmark di matematica competitiva che premia il reasoning simbolico multi-step.
È uno dei suoi risultati più forti e suggerisce che sia una scelta sensata per carichi quantitativi e ad alta intensità matematica.
Un punteggio a metà anni ’60 qui conta per chi costruisce strumenti che richiedono aritmetica e algebra affidabili, dato che molti modelli economici crollano proprio su questi compiti.
La decisione riguarda meno le varianti di modello e più il modo in cui distribuisci V4.1 Flash, dato che gli stessi pesi girano in tre modalità. La scelta dipende da prevedibilità dei costi, privacy dei dati e dalla tua capacità di schedulare i job.
DeepSeek sta anche gestendo un periodo di migrazione. Dalle 12:00 ora di Pechino del 14 settembre 2026, fino al futuro rilascio di V4.1 Pro, le richieste agli endpoint legacy vengono reindirizzate, spingendo gli utenti esistenti verso la famiglia V4.1. Se stai ancora usando V4 Pro 0813, quel modello è in via di dismissione, quindi pianifica ora il passaggio a V4.1 Flash.
| Caso d’uso | Percorso consigliato | Perché |
|---|---|---|
| Agent di coding ad alto volume e always-on | API ufficiale, prezzo di picco | $0,30/$1,20 per 1M è già molto al di sotto dei rivali di frontiera; nessun overhead di schedulazione |
| Grandi job batch di reasoning o matematica | API ufficiale, fuori picco | Fuori picco dimezza la tariffa a $0,15/$0,60 per 1M se puoi schedulare l’esecuzione |
| Dati sensibili o proprietari | Auto-ospita i pesi MIT | Mantiene l’inferenza sull’hardware proprio; richiede vera memoria GPU |
| Forte riuso del contesto | API con caching del prompt | L’input da cache-hit a $0,006 per 1M rende quasi gratuito il contesto ripetuto |
V4.1 Flash è uno dei modelli capaci più economici disponibili, soprattutto fuori picco. Ecco come si articolano i prezzi per token.
| Tariffa | Picco | Fuori picco |
|---|---|---|
| Input per 1M token | $0,30 | $0,15 |
| Output per 1M token | $1,20 | $0,60 |
| Input cache-hit per 1M token | $0,006 | Non pubblicato |
I prezzi fuori picco sono fissati alla metà di quelli di picco, e lo schema è pensato per spingere carichi batch e schedulati nelle finestre fuori picco.
Per contestualizzare la tariffa di picco, GPT-6 Astra e Claude Fable 5.1 chiedono entrambi $10 per 1M in input e $50 per 1M in output, quindi V4.1 Flash costa circa 30 volte meno in input e 40 volte meno in output in picco.
Il modello in dismissione, V4 Pro 0813, è prezzato a $0,435 per 1M in input e $0,87 per 1M in output con contesto da 1M token.
Poiché DeepSeek sostiene che V4.1 Flash superi V4 Pro per prestazioni, costo e velocità, ci sono poche ragioni per restare sul modello più vecchio.
V4.1 Flash è disponibile tramite l’API ufficiale di DeepSeek e i suoi pesi con licenza MIT sono pubblicati per l’auto-hosting.
Dal 14 settembre 2026, le richieste agli endpoint legacy vengono reindirizzate verso la famiglia V4.1 fino alla disponibilità di V4.1 Pro.
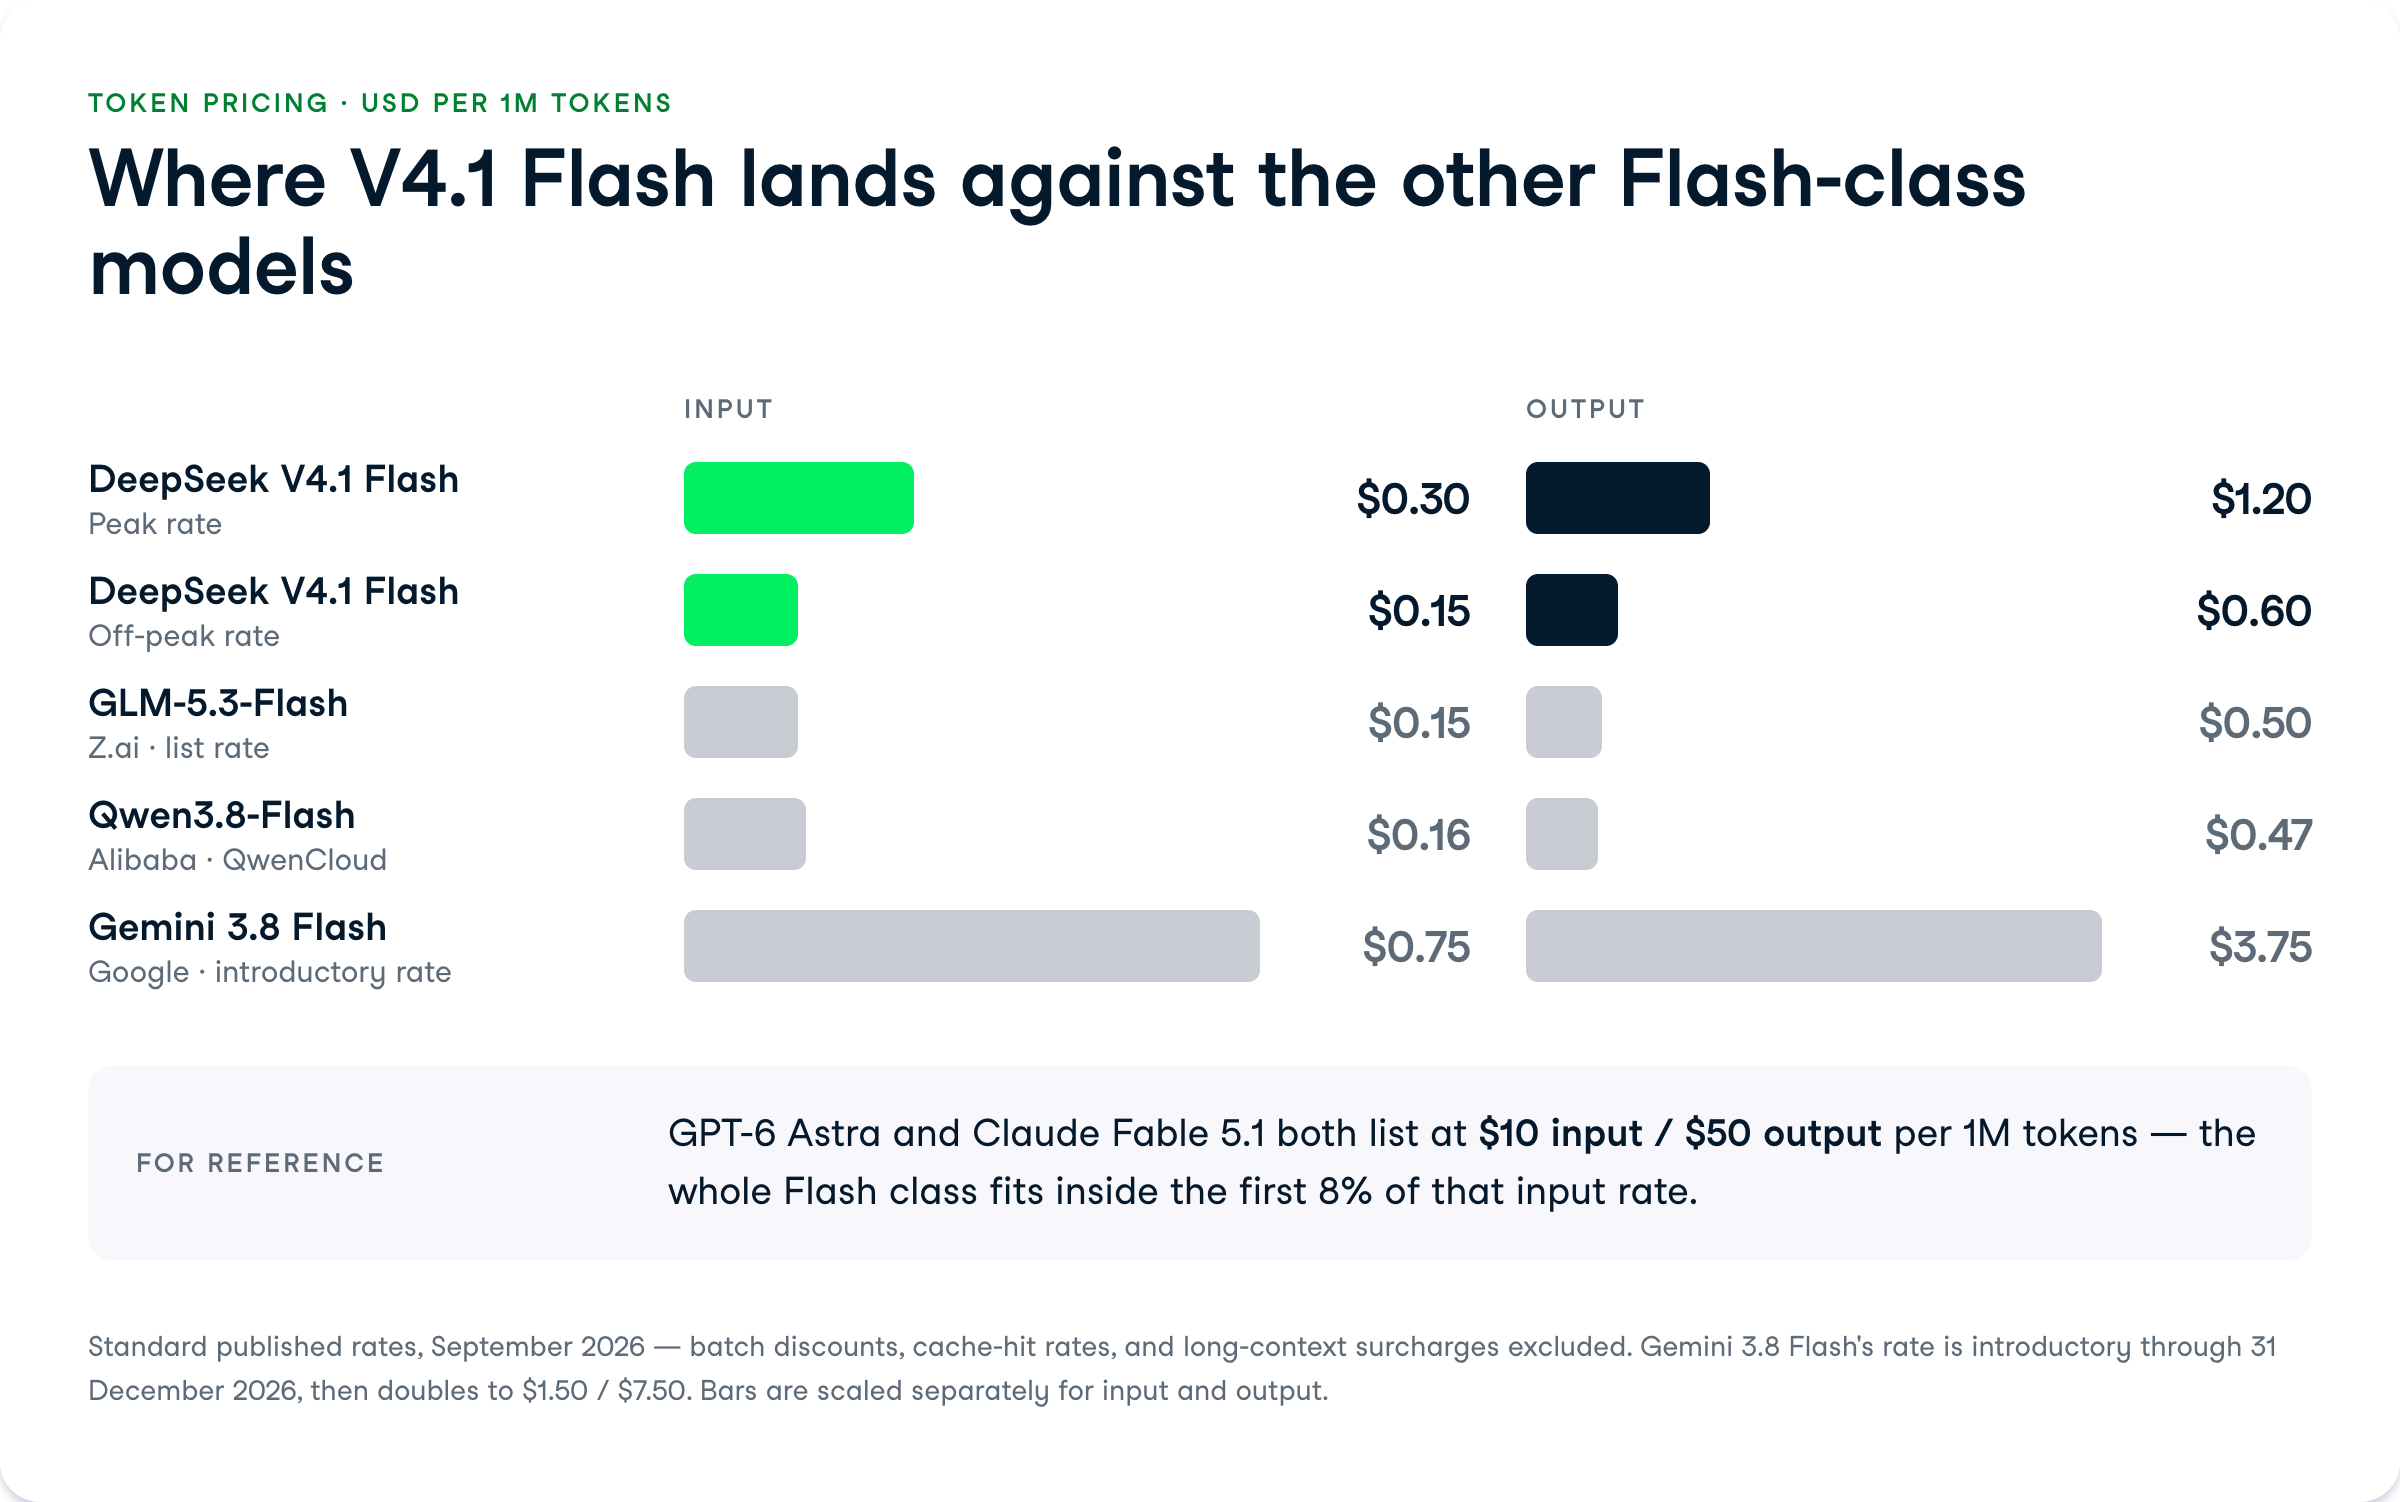
V4.1 Flash è sia un modello API sia un rilascio a pesi aperti, quindi puoi raggiungerlo in due modi.
Sull’API, l’ID del modello è comunemente indicato come deepseek-flash e l’endpoint è compatibile con OpenAI, il che significa che la maggior parte del codice client OpenAI esistente funziona con un cambio della base URL.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
Per l’auto-hosting, i pesi con licenza MIT consentono uso commerciale, ridistribuzione e fine-tuning senza soglie di ricavo.
Quando abbiamo eseguito localmente il precedente V4-Flash-0731 con Unsloth Studio, servivano tre GPU NVIDIA A100 80GB a quantizzazione Q8, quindi prevedi hardware simile per il setup in piena precisione.
Per una guida completa in locale, vedi il nostro tutorial su come eseguire DeepSeek-V4-Flash con Unsloth Studio e OpenCode, che copre in dettaglio la distribuzione su GPU e il setup di inferenza.
V4.1 Flash è la dichiarazione di DeepSeek su prezzo e apertura, mentre il resto della frontiera sale verso $10/$50 per 1M token e nasconde l’accesso dietro piani a pagamento.
Un modello MoE da 552B con pesi MIT, input immagine nativo, 90,9 su GPQA Diamond e un prezzo di picco 30 volte inferiore a GPT-6 Astra è un’offerta seria per carichi ad alto volume.
Io ci passerei per agent di coding e job batch di reasoning, soprattutto se puoi schedulare fuori picco.
I lati negativi emergono guardando il 30,0 su Terminal-Bench 3.0, che mostra incertezze sui task agentici più duri, e la fatturazione picco/fuori picco aggiunge lavoro di schedulazione a tuo carico.
Se vuoi costruire workflow agentici attorno a modelli come questo, il nostro percorso di competenze AI Agent Fundamentals è un buon punto di partenza.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




