新一波 Flash 级模型正不断涌现。
我们近期介绍了 Qwen3.8-Flash-Next、GLM-5.3-Flash、Gemini 3.8 Flash 和 DeepSeek V4.1 Flash,它们都在争夺这个对成本敏感、推理速度快的市场位置。
阿里巴巴的通义千问团队现以 Qwen3.8-Omni-Flash 加入战局,从原生全模态角度切入,重点围绕音视频智能体。
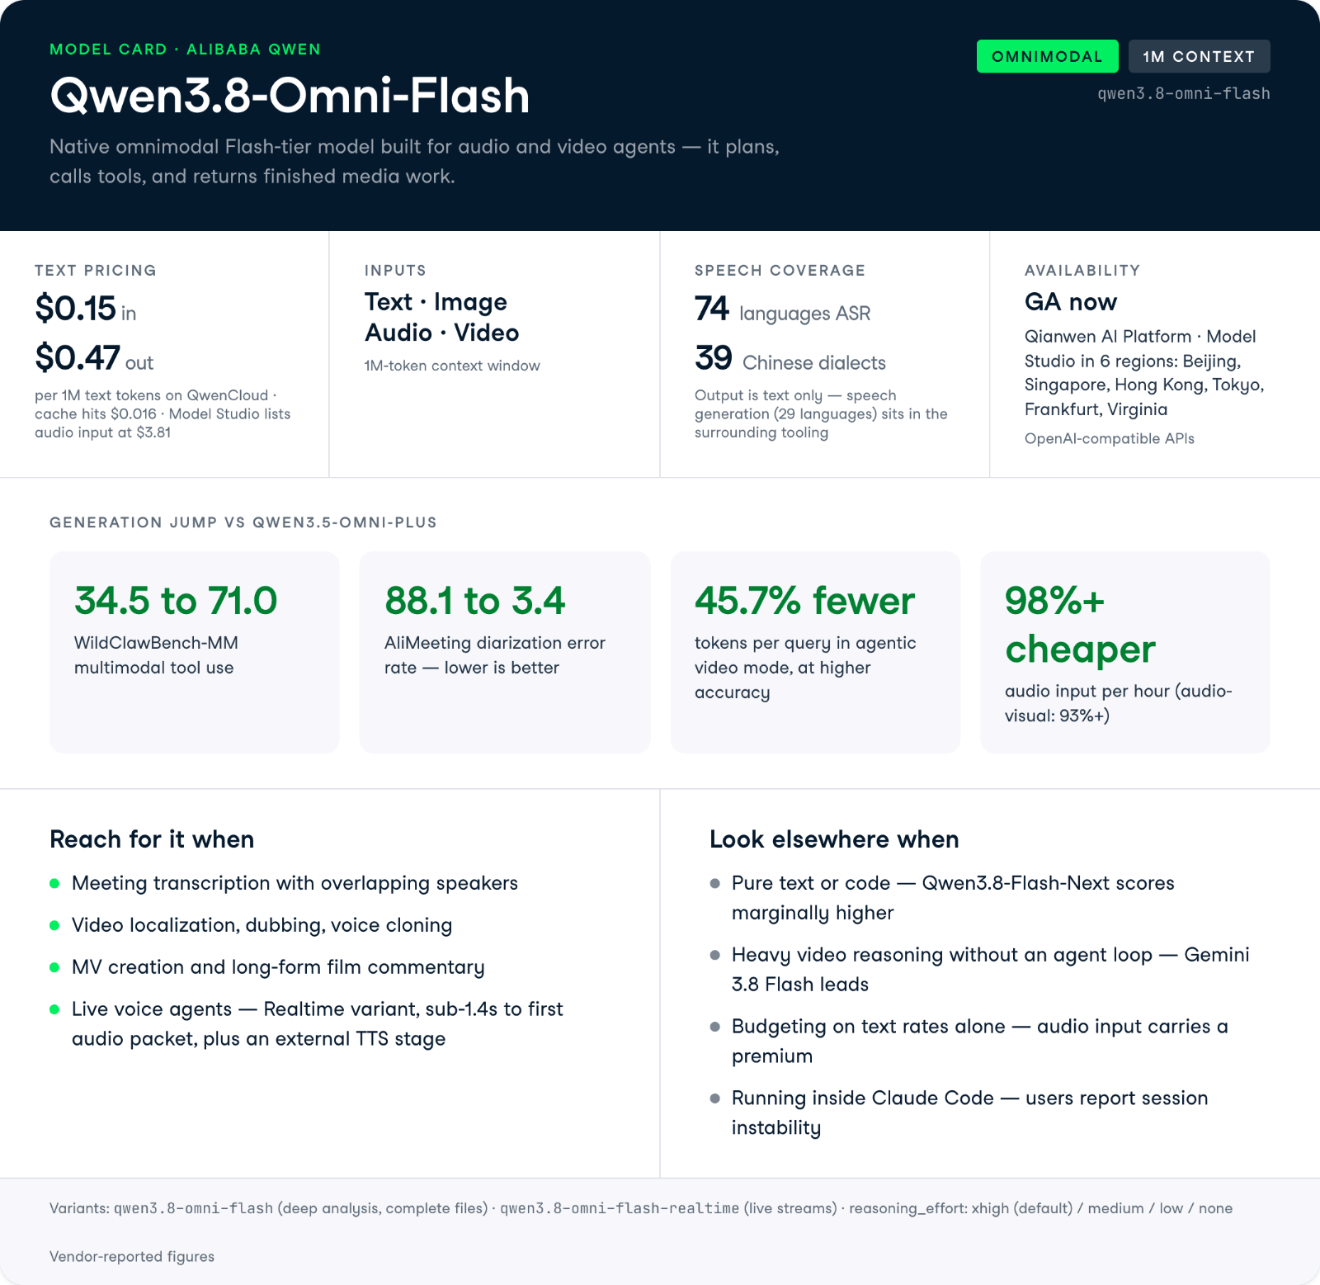
Qwen3.8-Omni-Flash 支持文本、图像、音频与视频输入,并提供 100 万 Token 上下文窗口。阿里巴巴称其音视频表现接近 Gemini 3.8 Flash,整体音频能力甚至更胜一筹;相较前代 Qwen3.5-Omni-Plus,在 29 项评测中平均提升 25% 以上。智能体方面的亮点是 WildClawBench-MM 提升 36.5 分,以及音频输入的小时价格据称下降 98%+。
本文将全面介绍 Qwen3.8-Omni-Flash 的最新变化,涵盖新功能亮点、与我们评测过的其他 Flash 模型的对比,以及各项基准测试表现。
若想了解这些模型的横向对比,请参阅我们的指南:DeepSeek V4.1 Flash 对比 Gemini 3.8 Flash,以及 GLM-5.3 Flash 对比 Qwen3.8-Flash-Next。
要点速览
- Qwen3.8-Omni-Flash 是阿里巴巴新一代全模态模型,用于替代 Qwen3.5-Omni-Plus。
- 其差异化在于音视频智能体:可观看、可聆听、能规划、会调度工具,产出成品内容,如 MV 与影视解说。
- 在大多数音频基准上优于 Gemini 3.8 Flash,音视频推理上与其相近。
- 如果您的工作负载以音频或视频为主,优先考虑它;纯文本或代码场景中,Qwen3.8-Flash-Next 略占上风。
- 按约 $0.15/百万 Token 输入、$0.47/百万 Token 输出计价,其文本价格低于多数同级 Flash 竞品。
Qwen3.8-Omni-Flash 是什么?
Qwen3.8-Omni-Flash 是阿里巴巴通义千问团队推出的原生全模态模型,定位于 Flash 等级,强调高性价比与高吞吐。
它在同一模型中处理文本、图像、音频与视频,支持 100 万 Token 上下文窗口,同时保持与同规模纯文本模型相当的文本能力。
这一代的目标是让模型具备音视频的智能体能力,而不止于“理解”。
前代 Qwen3.5-Omni-Plus 偏重全模态内容的解读,Qwen3.8-Omni-Flash 则面向任务规划、工具调用,并完成创作型工作,如视频剪辑、MV 制作、影视解说等。
阿里巴巴的表述是:将音视频从“感知输入”升级为智能体“推理与执行”的核心媒介。
核心宣称包括:WildClawBench-MM 从 34.5 跃升至 71.0(+36.5 分),以及 AgenticVBench 提升 22.3 分。
在真实会议音频(多人打断、交叠发言)测试中,新系统相较旧版本有显著改进:
- 说话人分离(Diarization): 错误率从 88% 降至 3%。
- 实际用词转写(cpWER): 错误率从近 90% 降至 17%。
Qwen3.8-Omni-Flash 关键功能
这些功能围绕一个理念:不止给智能体“眼睛”和“耳朵”,还要给它处理音视频工作的“手”。
阿里巴巴同时发布了两层工具链:用于长链路流程的 Qwen-MM-Plugins,以及面向实时交互的 Qwen-Live Harness。
能交付成品的音视频智能体
您可以把一首歌或一部完整电影交给 Qwen3.8-Omni-Flash,并用一句话描述需求;它会规划任务、调用创作工具,并返回成片视频。
它支持端到端流程,包括 MV 制作、短剧翻译(含声音克隆),以及长篇影视解说。
处理一部两小时电影时,模型可进行长视频理解、关键信息提取、解说策划、配音与配乐制作、剪辑,以及最终质检。
它可以在原片对白与解说之间穿插,并调节语速与音量,使多层音轨自然融合。
这点很重要,因为分散的“转写-翻译-配音-剪辑”循环,正是让个体创作者难以推进此类项目的协调成本。
可控的音视频描述生成
您可以定义模型“看什么、看多细、怎么表述”,而不是接受固定描述。
用户可针对同一段视频指定主体、时间范围、细节层级与输出格式。
例如输入 40 分钟的产品演示:您可以先要一段用于列表页的 200 字概览,然后对同一片段再次运行,要求输出符合 JSON 模式的结果,包含分场景时间戳、屏幕文字提取、带说话人标注的转写,方便进入下游流程。
在 OmniCap-IF 上,其内容结构与指令跟随得分(CSR 与 ISR)相较前代分别提升 8.5 与 14.1 分。
具备智能体能力的长视频理解
模型并非一次性处理数小时录制内容,而是从您的问题出发,通过由粗到细的取证过程决定看与听哪些片段。
这能将算力与 Token 聚焦在相关片段。
在 OmniVideoBench 上,此智能体模式将准确率从 63.4 提升至 67.8,同时把每次查询的 Token 消耗从 145,736 降至 79,117,约减少 45.7%。
对于需要按 Token 计费处理小时级素材的人来说,这种效率提升本身就是功能亮点。
Qwen3.8-Omni-Flash-Realtime 的实时交互
另一个变体 Qwen3.8-Omni-Flash-Realtime 能在接收音视频流的同时进行感知与响应,并利用实时上下文进行工具调用。
它支持口语练习与发音反馈、空间音频感知,以及通过 Skills 进行知识注入。
其中最特别的是空间音频能力:阿里巴巴称其为首个可“凭声音定位目标”的全模态模型,能将方向性音频与视觉信息结合,判断声源的方向与距离。
即便输入 20 秒的音视频,首个音频分组的响应时间也低于 1.4 秒。
语言与方言覆盖
Qwen3.8-Omni-Flash 支持 74 种语言与 39 种中文方言的语音识别,覆盖普通话、粤语、四川话、上海话与闽南语等。
语音合成覆盖 29 种语言与 7 种方言。
对于本地化与配音流程,这种方言广度是相较多数同级 Flash 模型的实际差异点——后者通常给出语言数量,但较少披露到方言级的覆盖。
将模型研发视为智能体任务
此次发布中一个较为特别的演示是:阿里巴巴用 Qwen3.8-Omni-Flash 来改进一个更小的模型,而非直接面向终端用户。
给定 12 小时以提升 Qwen2.5-Omni-3B 的四川话识别能力,该智能体选择了 WenetSpeech-Chuan 评测集,搭建基线,并通过聆听音频样本定位错误。
在四轮迭代中,它创建了 3,413 个训练样本,回滚失败尝试,并将字符错误率从 25.79% 降至 15.30%,相对降低约 40.7%。
这虽是个小实验,但指向一种趋势:由更大的模型驱动面向生产的专项小模型训练。
Qwen3.8-Omni-Flash 的基准测试表现如何?
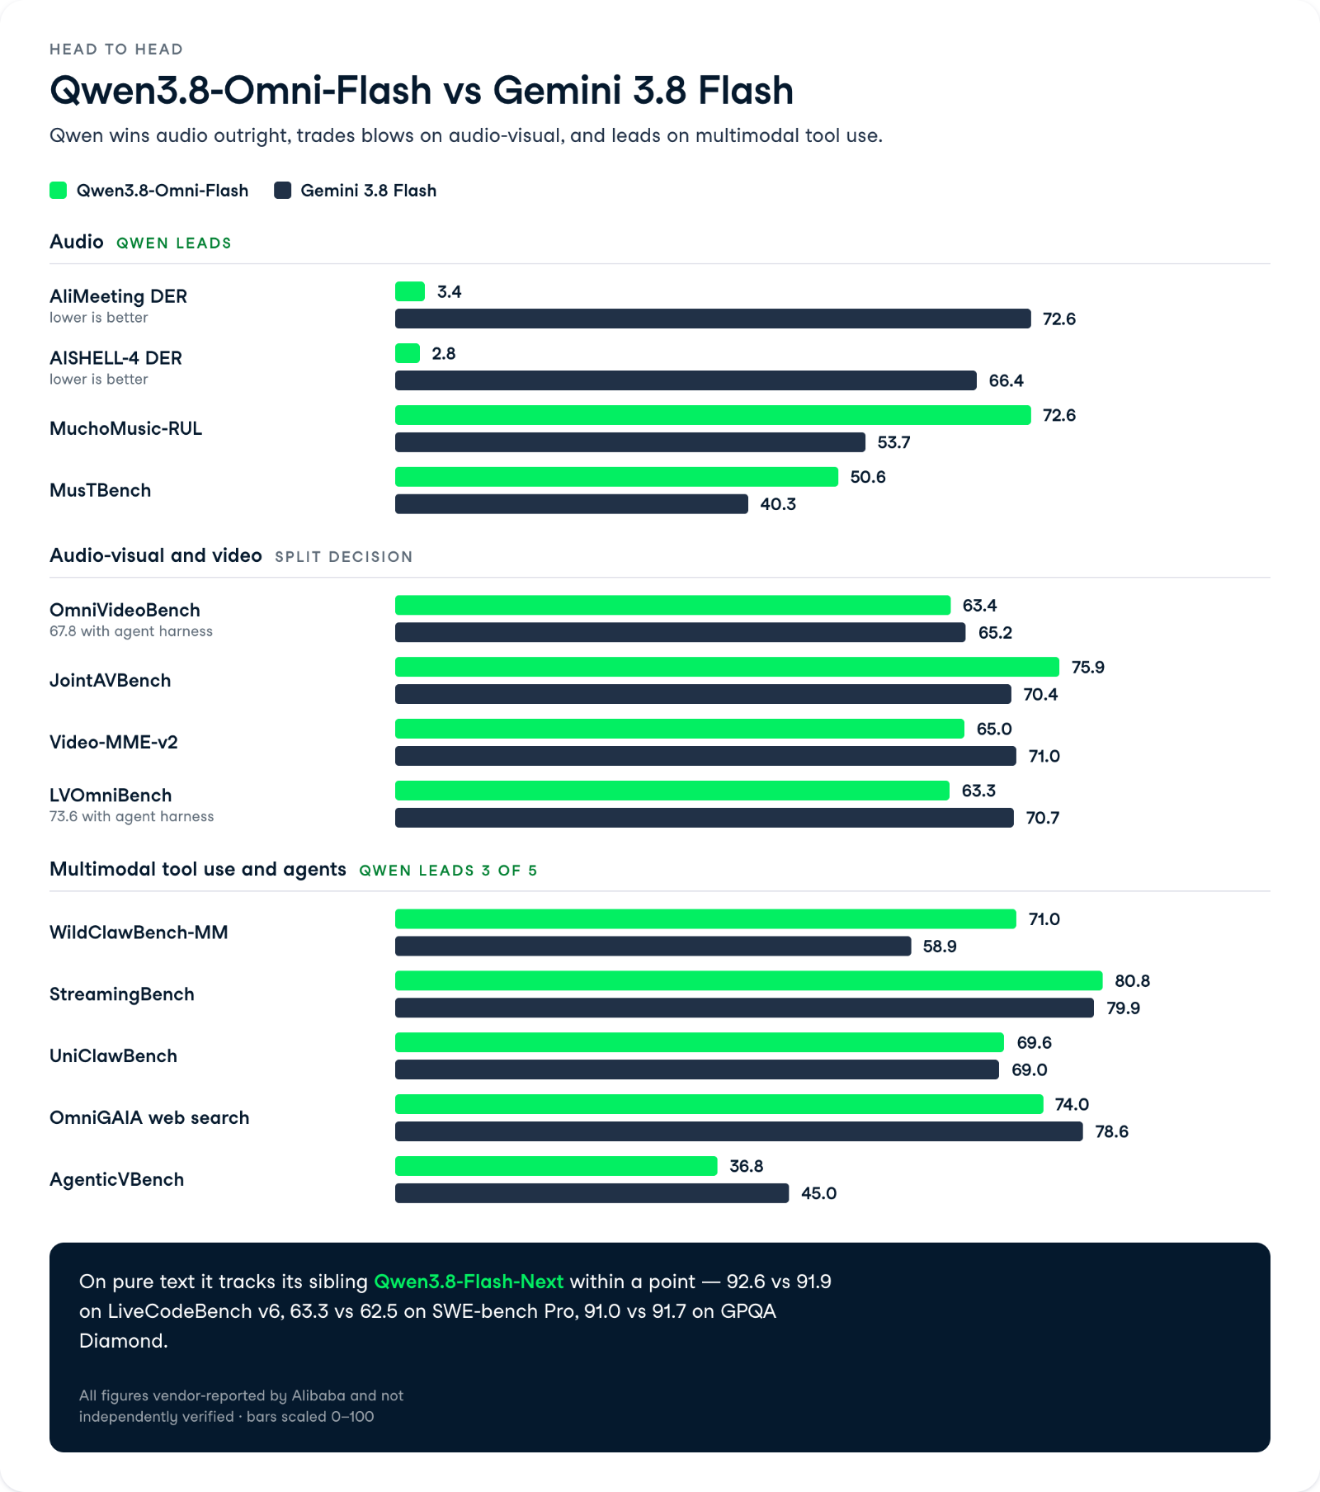
各项基准的整体规律很一致:Qwen3.8-Omni-Flash 在音频类全面领先;音视频任务与 Gemini 3.8 Flash 互有胜负、差距不大;文本方面在同门模型间保持竞争力。
它并非在所有方面都领先,部分视频推理测试仍偏向 Gemini 3.8 Flash。
音频与多人说话识别
这是该模型最强的领域,并以较大优势超过 Gemini 3.8 Flash。
在 AliMeeting 多人 ASR 测试中,它的说话人分离错误率为 3.4,而 Gemini 3.8 Flash 为 72.6;在 AISHELL-4 上,它为 2.8,Gemini 为 66.4,显示 Gemini 在重叠说话场景中明显吃力。
说话人分离错误率衡量模型能否将语音归属到正确的说话人,因此低分对会议纪要、访谈转写及任何多人同时说话的流程都至关重要。
在音乐理解方面,它同样领先:MuchoMusic-RUL 得分 72.6(Gemini 为 53.7),MusTBench 得分 50.6(Gemini 为 40.3)。
音视频推理与理解
在这里,Gemini 3.8 Flash 通常略占优势,但差距不大,且当 Qwen 以智能体模式运行时差距进一步缩小。
- 在 OmniVideoBench 上,Qwen 静态得分 63.4,Gemini 为 65.2;但配合 Qwen Code 工具链后,Qwen 可升至 67.8。
- 在 JointAVBench 上,Qwen 反而以 75.9 领先 Gemini 的 70.4。
视频推理的若干行则更为分化。
在 Video-MME-v2 上,Gemini 以 71.0 比 65.0(静态)领先;在 LVOmniBench 上,Gemini 以 70.7 对 63.3 领先,尽管 Qwen 在智能体模式下可跃升至 73.6。
如果您的工作以不带智能体循环的重度视频推理为主,Gemini 仍更占优。
多模态工具使用与智能体
智能体能力是其主打,WildClawBench-MM 的结果也支撑了这一点:Qwen3.8-Omni-Flash 得分 71.0,对比 Gemini 3.8 Flash 的 58.9 和 Seed 2.0 Lite 的 41.9。
在 UniClawBench 上,两者基本持平,分别为 69.6 与 69.0。
Gemini 在 AgenticVBench 上以 45.0 胜过 Qwen 的 36.8,并在 OmniGAIA 网页搜索上以 78.6 对 74.0 领先。
因此,工具使用的优势确实存在,但并非全面碾压。在交互类基准 StreamingBench 上,Qwen 以 80.8 显著领先 Gemini 的 79.9 以及前代的 57.1。
与同门 Flash 模型的文本与代码对比
在纯文本任务中,Qwen3.8-Omni-Flash 与其纯文本同门 Qwen3.8-Flash-Next 表现接近,通常相差不超过 1 分。
它在 LiveCodeBench v6 取得 92.6 分(Qwen3.8-Flash-Next:91.9),SWE-bench Pro 为 63.3(Qwen3.8-Flash-Next:62.5),GPQA Diamond 为 91.0(Qwen3.8-Flash-Next:91.7)。
对比 DeepSeek-V4-Flash-0731,Qwen3.8-Omni-Flash 在 SWE-bench Pro(63.3 vs 56.0)与 IFBench(81.5 vs 79.2)上领先,但 DeepSeek 在 NL2Repo-Bench 上以 54.2 对 48.9 占优。
我们在 测试 DeepSeek-V4-Flash-0731 时发现,它是当时我们本地运行过的最强代码模型之一,因此一款 Flash 级全模态模型能在仓库级软件工程上与其分庭抗礼,确属可观。
应选择哪个变体?
Qwen3.8-Omni-Flash 提供两个变体与一个可调的推理设置,选择取决于您是需要深度内容分析还是实时交互。
区分很直观:
- 基础版 Qwen3.8-Omni-Flash 面向完整音视频文件的深度理解与创作;
- Qwen3.8-Omni-Flash-Realtime 通过 WebSocket 或 WebRTC 处理持续、低延迟的流式交互。
实时对话不应使用基础版;而渲染一部两小时的影视解说也不应由 Realtime 承担。
在变体选择之外,基础版还提供 reasoning_effort 参数,包含 xhigh(默认)、medium 与 low 设置,允许在推理深度与速度、成本之间权衡。
高频字幕生成等注重速度的场景用 low;多步规划(如解说脚本)用 xhigh。
| 使用场景 | 变体 | 原因 |
|---|
| MV 与影视解说制作 | Qwen3.8-Omni-Flash | 完整文件上的长链路规划与工具调用 |
| 会议纪要与行动项 | Qwen3.8-Omni-Flash | 联合的音视频说话人识别,最长 1 小时输入 |
| 实时语音助手与客服 | Qwen3.8-Omni-Flash-Realtime | 首个音频分组响应低于 1.4 秒,支持 Skills 知识注入 |
| 空间音频与导航 | Qwen3.8-Omni-Flash-Realtime | 可实时凭声音定位目标 |
Qwen3.8-Omni-Flash 的价格与可用性
第三方信息显示,Qwen3.8-Omni-Flash 的文本计价约为每百万 Token 输入 $0.15、输出 $0.47;OmniaKey 与 LLM Reference 均引用官方费率。Venice API 列出的相关 Qwen 3.8 Flash 路由为每百万 Token 输入 $0.14、输出 $0.49。以上均为文本价格。
音频与音视频输入成本更高——这是一条重要提示。Puter 的定价说明指出音频输入相对文本有溢价,且阿里巴巴在对比中以 Gemini 3.8 Flash 的音视频输入价格为参照,而非给出统一的 Token 费率。阿里巴巴称音频输入的小时价格较 Qwen3.5-Omni-Plus 降低超过 98%,音视频输入降低超过 93%,因此溢价已显著收窄,但仍然存在。
该模型已在通义千问平台普遍可用,并可通过阿里云百炼(模型工作室)路由,提供北京与新加坡端点。发布说明未提及面向消费者的免费层。
如何获取 Qwen3.8-Omni-Flash 的使用权限?
API 模型 ID 为 qwen3.8-omni-flash,实时变体为 qwen3.8-omni-flash-realtime。
它兼容 OpenAI 的 Chat Completions 与 Responses API,多模态工具链可接入各类智能体框架,包括 Codex、Claude Code、Qwen Code 与 Gemini CLI(通过 Qwen-MM-Plugins)。
from openai import OpenAI
import os
client = OpenAI(
api_key=os.environ.get("DASHSCOPE_API_KEY"),
base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
model="qwen3.8-omni-flash",
messages=[{"role": "user", "content": "Summarize this meeting recording."}],
reasoning_effort="xhigh",
)
print(completion.choices.message.content)技术支持
一个已知的粗糙之处:有 GitHub 用户反映,在与 Claude Code 搭配运行 Qwen3.8-Omni-Flash 时,常出现中断与会话不稳定,建议预留时间排查与适配工具链。
更多设置信息,请参阅我们的 Flash 级模型运行教程 与 Qwen3.8-Max 指南。
结语
阿里巴巴选择的是一条差异化道路,而不是在文本上对标每一个 Flash 竞品。
相较 Qwen3.8-Flash-Next、GLM-5.3-Flash、Gemini 3.8 Flash 与 DeepSeek V4.1 Flash,本次主打的是“音视频智能体 + 组内最低的文本价格”。
如果您的工作涉及会议转写、视频本地化,或 MV 与解说制作,那么它的音视频智能体工具链与 AliMeeting 的说话人分离提升确实亮眼。
纯文本或代码方面,Qwen3.8-Flash-Next 略高一分;部分视频推理上,Gemini 3.8 Flash 仍领先,因此它并非对所有人都可直接替换。
若您希望熟悉智能体工作流与多模态模型,建议从我们的 AI Fundamentals 技能路径入手。


新一波 Flash 级模型正不断涌现。
我们近期介绍了 Qwen3.8-Flash-Next、GLM-5.3-Flash、Gemini 3.8 Flash 和 DeepSeek V4.1 Flash,它们都在争夺这个对成本敏感、推理速度快的市场位置。
阿里巴巴的通义千问团队现以 Qwen3.8-Omni-Flash 加入战局,从原生全模态角度切入,重点围绕音视频智能体。
Qwen3.8-Omni-Flash 支持文本、图像、音频与视频输入,并提供 100 万 Token 上下文窗口。阿里巴巴称其音视频表现接近 Gemini 3.8 Flash,整体音频能力甚至更胜一筹;相较前代 Qwen3.5-Omni-Plus,在 29 项评测中平均提升 25% 以上。智能体方面的亮点是 WildClawBench-MM 提升 36.5 分,以及音频输入的小时价格据称下降 98%+。
本文将全面介绍 Qwen3.8-Omni-Flash 的最新变化,涵盖新功能亮点、与我们评测过的其他 Flash 模型的对比,以及各项基准测试表现。
若想了解这些模型的横向对比,请参阅我们的指南:DeepSeek V4.1 Flash 对比 Gemini 3.8 Flash,以及 GLM-5.3 Flash 对比 Qwen3.8-Flash-Next。
要点速览
Qwen3.8-Omni-Flash 是什么?
Qwen3.8-Omni-Flash 是阿里巴巴通义千问团队推出的原生全模态模型,定位于 Flash 等级,强调高性价比与高吞吐。
它在同一模型中处理文本、图像、音频与视频,支持 100 万 Token 上下文窗口,同时保持与同规模纯文本模型相当的文本能力。
这一代的目标是让模型具备音视频的智能体能力,而不止于“理解”。
前代 Qwen3.5-Omni-Plus 偏重全模态内容的解读,Qwen3.8-Omni-Flash 则面向任务规划、工具调用,并完成创作型工作,如视频剪辑、MV 制作、影视解说等。
阿里巴巴的表述是:将音视频从“感知输入”升级为智能体“推理与执行”的核心媒介。
核心宣称包括:WildClawBench-MM 从 34.5 跃升至 71.0(+36.5 分),以及 AgenticVBench 提升 22.3 分。
在真实会议音频(多人打断、交叠发言)测试中,新系统相较旧版本有显著改进:
Qwen3.8-Omni-Flash 关键功能
这些功能围绕一个理念:不止给智能体“眼睛”和“耳朵”,还要给它处理音视频工作的“手”。
阿里巴巴同时发布了两层工具链:用于长链路流程的 Qwen-MM-Plugins,以及面向实时交互的 Qwen-Live Harness。
能交付成品的音视频智能体
您可以把一首歌或一部完整电影交给 Qwen3.8-Omni-Flash,并用一句话描述需求;它会规划任务、调用创作工具,并返回成片视频。
它支持端到端流程,包括 MV 制作、短剧翻译(含声音克隆),以及长篇影视解说。
处理一部两小时电影时,模型可进行长视频理解、关键信息提取、解说策划、配音与配乐制作、剪辑,以及最终质检。
它可以在原片对白与解说之间穿插,并调节语速与音量,使多层音轨自然融合。
这点很重要,因为分散的“转写-翻译-配音-剪辑”循环,正是让个体创作者难以推进此类项目的协调成本。
可控的音视频描述生成
您可以定义模型“看什么、看多细、怎么表述”,而不是接受固定描述。
用户可针对同一段视频指定主体、时间范围、细节层级与输出格式。
例如输入 40 分钟的产品演示:您可以先要一段用于列表页的 200 字概览,然后对同一片段再次运行,要求输出符合 JSON 模式的结果,包含分场景时间戳、屏幕文字提取、带说话人标注的转写,方便进入下游流程。
在 OmniCap-IF 上,其内容结构与指令跟随得分(CSR 与 ISR)相较前代分别提升 8.5 与 14.1 分。
具备智能体能力的长视频理解
模型并非一次性处理数小时录制内容,而是从您的问题出发,通过由粗到细的取证过程决定看与听哪些片段。
这能将算力与 Token 聚焦在相关片段。
在 OmniVideoBench 上,此智能体模式将准确率从 63.4 提升至 67.8,同时把每次查询的 Token 消耗从 145,736 降至 79,117,约减少 45.7%。
对于需要按 Token 计费处理小时级素材的人来说,这种效率提升本身就是功能亮点。
Qwen3.8-Omni-Flash-Realtime 的实时交互
另一个变体 Qwen3.8-Omni-Flash-Realtime 能在接收音视频流的同时进行感知与响应,并利用实时上下文进行工具调用。
它支持口语练习与发音反馈、空间音频感知,以及通过 Skills 进行知识注入。
其中最特别的是空间音频能力:阿里巴巴称其为首个可“凭声音定位目标”的全模态模型,能将方向性音频与视觉信息结合,判断声源的方向与距离。
即便输入 20 秒的音视频,首个音频分组的响应时间也低于 1.4 秒。
语言与方言覆盖
Qwen3.8-Omni-Flash 支持 74 种语言与 39 种中文方言的语音识别,覆盖普通话、粤语、四川话、上海话与闽南语等。
语音合成覆盖 29 种语言与 7 种方言。
对于本地化与配音流程,这种方言广度是相较多数同级 Flash 模型的实际差异点——后者通常给出语言数量,但较少披露到方言级的覆盖。
将模型研发视为智能体任务
此次发布中一个较为特别的演示是:阿里巴巴用 Qwen3.8-Omni-Flash 来改进一个更小的模型,而非直接面向终端用户。
给定 12 小时以提升 Qwen2.5-Omni-3B 的四川话识别能力,该智能体选择了 WenetSpeech-Chuan 评测集,搭建基线,并通过聆听音频样本定位错误。
在四轮迭代中,它创建了 3,413 个训练样本,回滚失败尝试,并将字符错误率从 25.79% 降至 15.30%,相对降低约 40.7%。
这虽是个小实验,但指向一种趋势:由更大的模型驱动面向生产的专项小模型训练。
Qwen3.8-Omni-Flash 的基准测试表现如何?
各项基准的整体规律很一致:Qwen3.8-Omni-Flash 在音频类全面领先;音视频任务与 Gemini 3.8 Flash 互有胜负、差距不大;文本方面在同门模型间保持竞争力。
它并非在所有方面都领先,部分视频推理测试仍偏向 Gemini 3.8 Flash。
音频与多人说话识别
这是该模型最强的领域,并以较大优势超过 Gemini 3.8 Flash。
在 AliMeeting 多人 ASR 测试中,它的说话人分离错误率为 3.4,而 Gemini 3.8 Flash 为 72.6;在 AISHELL-4 上,它为 2.8,Gemini 为 66.4,显示 Gemini 在重叠说话场景中明显吃力。
说话人分离错误率衡量模型能否将语音归属到正确的说话人,因此低分对会议纪要、访谈转写及任何多人同时说话的流程都至关重要。
在音乐理解方面,它同样领先:MuchoMusic-RUL 得分 72.6(Gemini 为 53.7),MusTBench 得分 50.6(Gemini 为 40.3)。
音视频推理与理解
在这里,Gemini 3.8 Flash 通常略占优势,但差距不大,且当 Qwen 以智能体模式运行时差距进一步缩小。
视频推理的若干行则更为分化。
在 Video-MME-v2 上,Gemini 以 71.0 比 65.0(静态)领先;在 LVOmniBench 上,Gemini 以 70.7 对 63.3 领先,尽管 Qwen 在智能体模式下可跃升至 73.6。
如果您的工作以不带智能体循环的重度视频推理为主,Gemini 仍更占优。
多模态工具使用与智能体
智能体能力是其主打,WildClawBench-MM 的结果也支撑了这一点:Qwen3.8-Omni-Flash 得分 71.0,对比 Gemini 3.8 Flash 的 58.9 和 Seed 2.0 Lite 的 41.9。
在 UniClawBench 上,两者基本持平,分别为 69.6 与 69.0。
Gemini 在 AgenticVBench 上以 45.0 胜过 Qwen 的 36.8,并在 OmniGAIA 网页搜索上以 78.6 对 74.0 领先。
因此,工具使用的优势确实存在,但并非全面碾压。在交互类基准 StreamingBench 上,Qwen 以 80.8 显著领先 Gemini 的 79.9 以及前代的 57.1。
与同门 Flash 模型的文本与代码对比
在纯文本任务中,Qwen3.8-Omni-Flash 与其纯文本同门 Qwen3.8-Flash-Next 表现接近,通常相差不超过 1 分。
它在 LiveCodeBench v6 取得 92.6 分(Qwen3.8-Flash-Next:91.9),SWE-bench Pro 为 63.3(Qwen3.8-Flash-Next:62.5),GPQA Diamond 为 91.0(Qwen3.8-Flash-Next:91.7)。
对比 DeepSeek-V4-Flash-0731,Qwen3.8-Omni-Flash 在 SWE-bench Pro(63.3 vs 56.0)与 IFBench(81.5 vs 79.2)上领先,但 DeepSeek 在 NL2Repo-Bench 上以 54.2 对 48.9 占优。
我们在 测试 DeepSeek-V4-Flash-0731 时发现,它是当时我们本地运行过的最强代码模型之一,因此一款 Flash 级全模态模型能在仓库级软件工程上与其分庭抗礼,确属可观。
应选择哪个变体?
Qwen3.8-Omni-Flash 提供两个变体与一个可调的推理设置,选择取决于您是需要深度内容分析还是实时交互。
区分很直观:
实时对话不应使用基础版;而渲染一部两小时的影视解说也不应由 Realtime 承担。
在变体选择之外,基础版还提供
reasoning_effort参数,包含xhigh(默认)、medium与low设置,允许在推理深度与速度、成本之间权衡。高频字幕生成等注重速度的场景用
low;多步规划(如解说脚本)用xhigh。Qwen3.8-Omni-Flash 的价格与可用性
第三方信息显示,Qwen3.8-Omni-Flash 的文本计价约为每百万 Token 输入 $0.15、输出 $0.47;OmniaKey 与 LLM Reference 均引用官方费率。Venice API 列出的相关 Qwen 3.8 Flash 路由为每百万 Token 输入 $0.14、输出 $0.49。以上均为文本价格。
音频与音视频输入成本更高——这是一条重要提示。Puter 的定价说明指出音频输入相对文本有溢价,且阿里巴巴在对比中以 Gemini 3.8 Flash 的音视频输入价格为参照,而非给出统一的 Token 费率。阿里巴巴称音频输入的小时价格较 Qwen3.5-Omni-Plus 降低超过 98%,音视频输入降低超过 93%,因此溢价已显著收窄,但仍然存在。
该模型已在通义千问平台普遍可用,并可通过阿里云百炼(模型工作室)路由,提供北京与新加坡端点。发布说明未提及面向消费者的免费层。
如何获取 Qwen3.8-Omni-Flash 的使用权限?
API 模型 ID 为
qwen3.8-omni-flash,实时变体为qwen3.8-omni-flash-realtime。它兼容 OpenAI 的 Chat Completions 与 Responses API,多模态工具链可接入各类智能体框架,包括 Codex、Claude Code、Qwen Code 与 Gemini CLI(通过 Qwen-MM-Plugins)。
一个已知的粗糙之处:有 GitHub 用户反映,在与 Claude Code 搭配运行 Qwen3.8-Omni-Flash 时,常出现中断与会话不稳定,建议预留时间排查与适配工具链。
更多设置信息,请参阅我们的 Flash 级模型运行教程 与 Qwen3.8-Max 指南。
结语
阿里巴巴选择的是一条差异化道路,而不是在文本上对标每一个 Flash 竞品。
相较 Qwen3.8-Flash-Next、GLM-5.3-Flash、Gemini 3.8 Flash 与 DeepSeek V4.1 Flash,本次主打的是“音视频智能体 + 组内最低的文本价格”。
如果您的工作涉及会议转写、视频本地化,或 MV 与解说制作,那么它的音视频智能体工具链与 AliMeeting 的说话人分离提升确实亮眼。
纯文本或代码方面,Qwen3.8-Flash-Next 略高一分;部分视频推理上,Gemini 3.8 Flash 仍领先,因此它并非对所有人都可直接替换。
若您希望熟悉智能体工作流与多模态模型,建议从我们的 AI Fundamentals 技能路径入手。