
Last chance! 50% off DataCamp Premium
Sale ends in
Se vuoi saperne di più sulla gestione dei dati, dai un'occhiata agli altri miei articoli di questa serie:
Un data warehouse è un sistema di archiviazione specializzato progettato per raccogliere e organizzare grandi quantità di dati. Presenta diverse caratteristiche chiave che ne definiscono scopo e funzionalità.
In un data warehouse i dati sono organizzati attorno a specifici soggetti o aree di business (ad es. vendite, marketing, inventario). Questo rende più semplice analizzare aspetti specifici dell'azienda.
I dati provenienti da fonti eterogenee vengono combinati e trasformati in un formato coerente all'interno di un data warehouse. Questa integrazione strutturata garantisce uniformità e affidabilità dei dati, facilitandone l'analisi e la comprensione.
I dati sono archiviati in modo storico in un data warehouse. Ciò significa che le versioni passate non vengono sovrascritte quando si aggiungono nuove versioni. Questa variabilità temporale consente analisi delle tendenze e confronti nel tempo. La prospettiva storica offerta dai data warehouse è importante per comprendere andamenti e pattern di lungo periodo.
A differenza dei sistemi di dati in tempo reale, i dati in un warehouse in genere non vengono aggiornati in tempo reale. Vengono invece caricati in batch per garantire stabilità e coerenza. Una volta inseriti, i dati non vengono modificati. Questa non volatilità contribuisce a mantenere una traccia affidabile e coerente delle transazioni aziendali.
I data warehouse si concentrano su aree specifiche del business, combinano dati da fonti diverse in un formato coerente, mantengono registri storici per tracciare i cambiamenti nel tempo e archiviano i dati in modo stabile, senza modificarli dopo l'inserimento.
Data warehouse e data lake rientrano entrambi nelle architetture dati moderne, con ruoli complementari. Entrambi i sistemi sono progettati per gestire e analizzare grandi volumi di dati, ma adottano approcci differenti.
|
Caratteristica |
Data warehouse |
Data lake |
|
Struttura dei dati |
Strutturati |
Non strutturati, semi-strutturati e strutturati |
|
Schema |
Schema predefinito |
Schema-on-read (schema definito durante l'elaborazione) |
|
Elaborazione dei dati |
ETL (Extract, Transform, Load) prima dell'archiviazione |
Dati archiviati in formato grezzo, elaborati all'occorrenza |
|
Casi d'uso principali |
Business intelligence, reportistica, analisi storica |
Analisi esplorative, machine learning, advanced analytics |
|
Prestazioni delle query |
Ottimizzato per query veloci |
Variabili, in base al framework di elaborazione e all'organizzazione dei dati |
|
Archiviazione dei dati |
Ottimizzata per dati strutturati |
Accoglie tipi e formati di dati diversi |
|
Flessibilità |
Meno flessibile, richiede trasformazione prima dell'archiviazione |
Più flessibile, consente l'evoluzione dello schema |
|
Uso comune |
Utilizzato per esigenze di report e analisi ben definite |
Utilizzato per analisi esplorative e scoperta di insight |
|
Integrazione |
Spesso utilizzato con i data lake come fonte di dati curati |
Spesso utilizzato insieme ai data warehouse per l'archiviazione ed elaborazione dei dati grezzi |
Dai un'occhiata a questo tutorial Data Lakes vs Data Warehouses per un confronto più approfondito.
Lo schema seguente è un esempio di come i dati da più fonti possono confluire in un data warehouse.
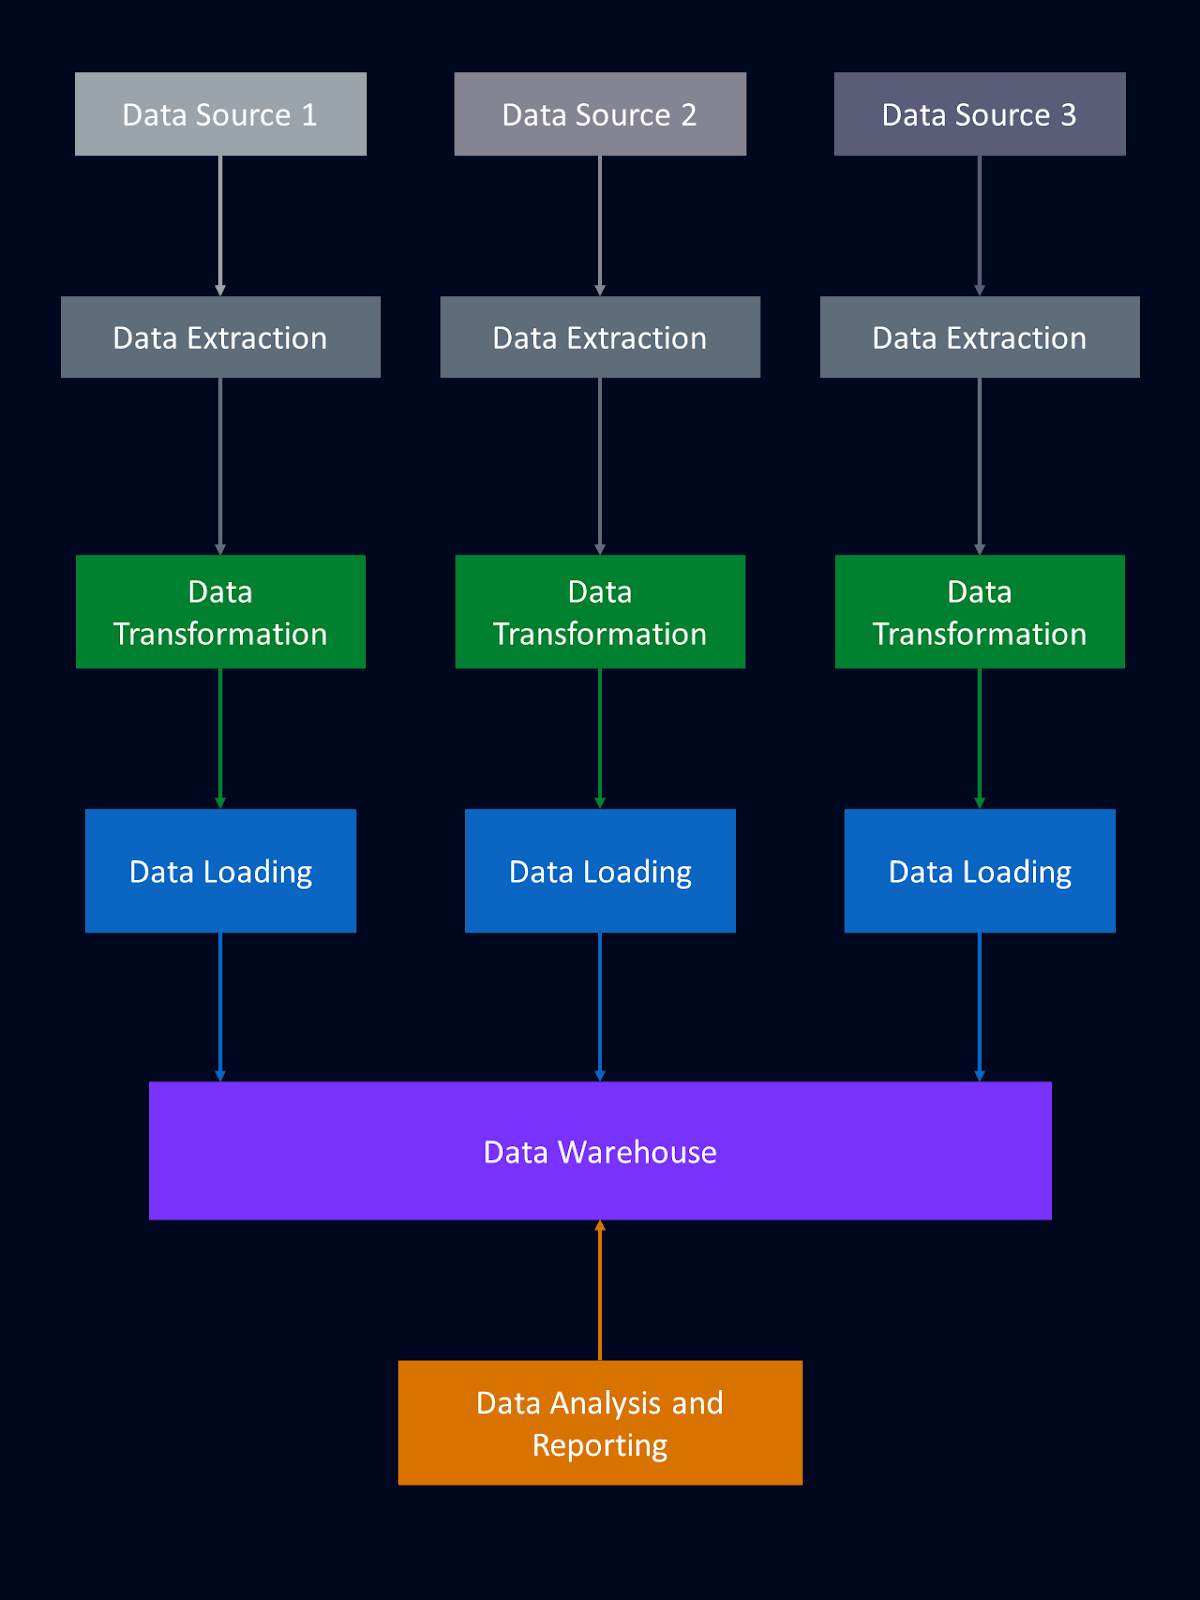
Configurare un data warehouse significa strutturare i dati da varie fonti in un repository centralizzato. Vediamo i componenti che costituiscono l'architettura di un data warehouse e come supportano funzioni critiche nella gestione dei dati e nell'analisi.
L'area di staging può essere vista come una zona di atterraggio per i dati grezzi nella pipeline. È una posizione di archiviazione intermedia dove i dati grezzi vengono inizialmente estratti da vari sistemi sorgente come database, API, data lake e file. Questi dati grezzi sono spesso eterogenei e non strutturati, e richiedono una prima elaborazione prima di poter essere integrati nel data warehouse.
Nell'area di staging i dati subiscono pulizia e validazione preliminari. Questo può includere la rimozione dei duplicati, la gestione dei valori mancanti e la verifica dell'integrità dei dati. Puoi leggere di più sul data cleaning in questo tutorial Beginner’s Guide to Data Cleaning o in questo corso Data Cleaning in Python. I dati possono anche essere trasformati in un formato standardizzato per facilitarne l'integrazione con lo schema del data warehouse.
L'area di staging funge da buffer che disaccoppia il processo di estrazione da quello di caricamento nel warehouse. Questa separazione consente flessibilità nella gestione del flusso dei dati e garantisce che nel warehouse entrino solo dati validati e correttamente formattati. Preparando i dati nell'area di staging, possiamo migliorare qualità e affidabilità dei dati archiviati nel nostro data warehouse.
Una volta nell'area di staging, i dati passano attraverso le consuete fasi di Extraction, Transformation e Loading (ETL). Il processo ETL è un componente importante della gestione dei dati. Vediamo brevemente le tre fasi:
Il processo ETL è una parte fondamentale della gestione dei dati, poiché assicura che i dati grezzi vengano convertiti in un asset utilizzabile e prezioso per un'organizzazione.
Il livello di archiviazione di un data warehouse determina come i dati vengono archiviati, gestiti e accessi. I data warehouse moderni spesso utilizzano una combinazione di soluzioni di archiviazione per sfruttare i punti di forza di tecnologie diverse. Vediamo alcune soluzioni comuni per i data warehouse: database relazionali, database colonnari e archiviazione cloud.
I database relazionali sono tradizionalmente la spina dorsale dell'archiviazione dati nei data warehouse. Questi database utilizzano tabelle con relazioni predefinite tra loro, seguendo un modello relazionale. I dati strutturati sono archiviati in righe e colonne, risultando facilmente interpretabili. SQL (Structured Query Language) è spesso utilizzato per gestire e interrogare i dati nei database relazionali.
I database relazionali eccellono in scenari con dati transazionali strutturati, come sistemi finanziari e sistemi di gestione delle relazioni con i clienti. Tuttavia, possono incontrare problemi di prestazioni quando si gestiscono volumi di dati molto elevati. Anche lo scaling orizzontale (aggiungere più server) può essere complesso e costoso. Di conseguenza, sebbene i database relazionali siano adatti a molte applicazioni, spesso vengono affiancati da altri tipi di archiviazione ottimizzati per esigenze diverse.
I database colonnari sono un tipo di archiviazione più specializzato, progettato specificamente per operazioni con molte letture e query analitiche. Invece di archiviare i dati per righe, i database colonnari li archiviano per colonne, da cui il nome. Ciò consente un recupero ed elaborazione più efficienti di grandi dataset. Sono particolarmente adatti al data warehousing e alle applicazioni di business intelligence.
Uno dei principali vantaggi dei database colonnari è la capacità di ottimizzare archiviazione e prestazioni delle query per carichi analitici. Archiviando separatamente ogni colonna, questi database possono accedere rapidamente ai punti dati necessari senza scansionare intere righe, velocizzando notevolmente i tempi di query. Inoltre, spesso offrono una migliore compressione, riducendo i costi di archiviazione.
Nonostante i vantaggi per le query analitiche, i database colonnari possono essere meno efficienti per carichi transazionali che prevedono scritture e aggiornamenti frequenti. In genere li usiamo in scenari che richiedono aggregazioni e sintesi rapide di grandi dataset. Sono meno adatti a sistemi in cui sono comuni aggiornamenti e inserimenti frequenti.
L'archiviazione nel cloud è diventata una scelta sempre più popolare per il data warehousing grazie a scalabilità, flessibilità ed economicità. Le soluzioni di archiviazione cloud sono offerte da servizi come Amazon Web Services (AWS), Google Cloud Platform (GCP) e Microsoft Azure, che offrono una gamma di strumenti e servizi a supporto dell'archiviazione e dell'elaborazione dei dati.
Uno dei principali vantaggi dell'archiviazione cloud è la scalabilità. Le organizzazioni possono aumentare o ridurre facilmente le esigenze di archiviazione in base alla domanda, senza grandi investimenti iniziali in hardware. Questa flessibilità è particolarmente utile per gestire volumi di dati ampi e variabili. L'archiviazione cloud offre inoltre alta disponibilità e funzionalità di disaster recovery, garantendo che i dati siano accessibili e sicuri anche in caso di guasti hardware.
Le piattaforme cloud spesso integrano sia database relazionali sia colonnari, il che significa che possiamo sfruttare il meglio di entrambi. Questo approccio ibrido supporta tipi di dati e carichi di lavoro diversi, ottimizzando prestazioni e costi.
Tuttavia, sicurezza dei dati e privacy possono destare preoccupazioni, poiché i dati sensibili sono archiviati off-premises. Possono anche emergere problemi di latenza a seconda della vicinanza dei dati ai server cloud. Inoltre, bisogna considerare i costi a lungo termine e il rischio di lock-in con il fornitore.
Il livello di archiviazione di un data warehouse può includere un mix di database relazionali, database colonnari e archiviazione cloud per soddisfare le diverse esigenze della gestione e dell'analisi dei dati moderne.
I data mart sono sottoinsiemi più piccoli e mirati del data warehouse, personalizzati per specifici reparti o funzioni di business. In sostanza sono un segmento di un data warehouse, progettato per soddisfare le esigenze particolari di un gruppo specifico di utenti all'interno dell'organizzazione.
A differenza del data warehouse a livello enterprise, che consolida i dati di tutta l'organizzazione, un data mart si concentra su una singola area tematica o funzione di business. Fornendo una vista più focalizzata dei dati, i data mart consentono ai reparti di eseguire analisi più mirate, pertinenti alle loro esigenze specifiche.
I data mart sono particolarmente utili quando determinati reparti hanno bisogno di accedere rapidamente a dati rilevanti per prendere decisioni. Offrono soluzioni dati su misura senza la complessità e i costi di un data warehouse su larga scala. Sono utili anche per sviluppare in modo incrementale una soluzione di data warehousing, partendo da data mart più piccoli e focalizzati.
Tuttavia, i data mart non sono adatti a ogni situazione. Possono sorgere problemi di integrazione, richiedendo processi ETL e governance dei dati solidi per garantire l'allineamento con il data warehouse centrale. Anche mantenere prestazioni e scalabilità con l'aumento dei volumi può essere difficile. I data mart richiedono una pianificazione attenta e un'adeguata allocazione di risorse, soprattutto in fase di scaling.
Se ti ritrovi a utilizzare molti data mart, potresti valutare un cambio di strategia verso un data mesh.
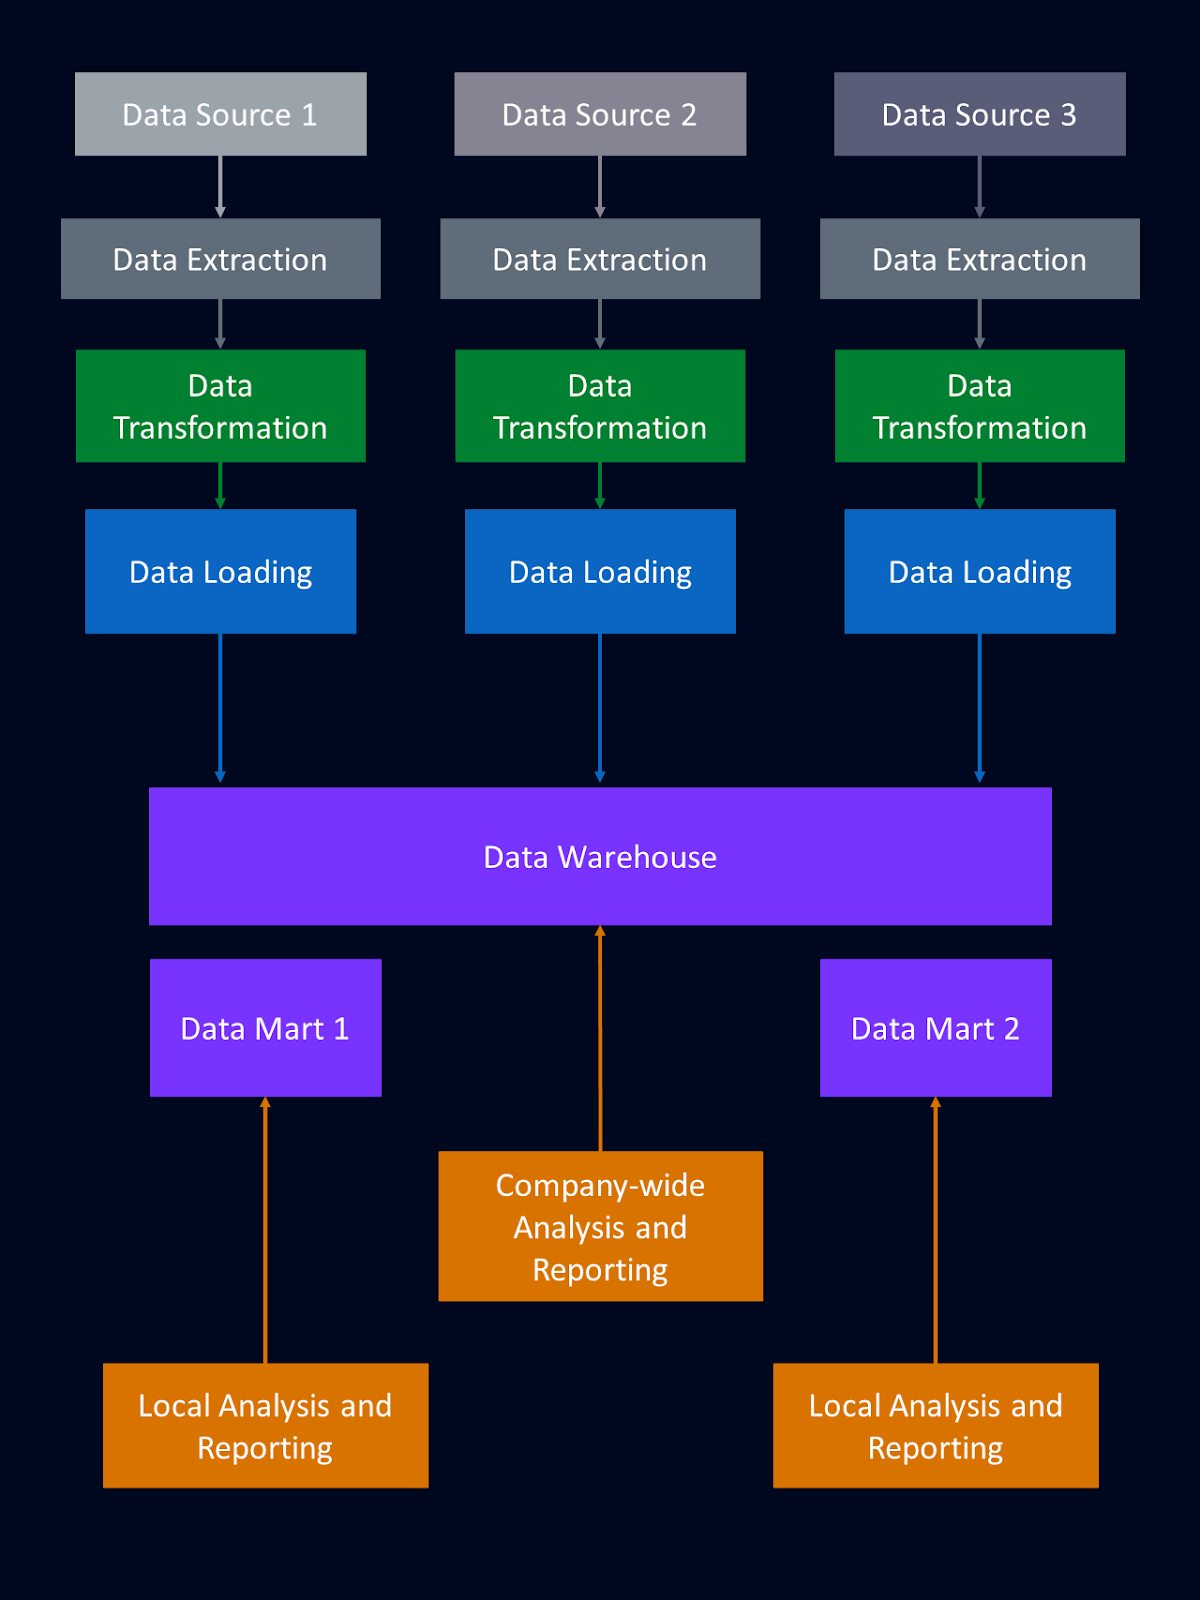
Il diagramma sopra mostra come le sottosezioni del data warehouse possano essere impostate come data mart indipendenti.
Per accedere e analizzare i dati nel warehouse, utilizziamo una varietà di strumenti progettati per il recupero, la manipolazione e la visualizzazione dei dati.
Un client SQL è un'applicazione che ci permette di connetterci a un database. Aiuta a scrivere ed eseguire query SQL per recuperare e manipolare i dati. I client SQL ci aiutano a svolgere attività come interrogare i dati, aggiornare record e creare tabelle. Potresti conoscere alcuni client SQL popolari come MySQL Workbench e pgAdmin. Se ti interessa gestire sistemi server, Introduction to SQL Servers è un ottimo punto di partenza! Oppure dai un'occhiata al percorso SQL Server Developer.
Le piattaforme di Business Intelligence forniscono una suite completa di strumenti per analisi, reportistica e visualizzazione dei dati. Ci permettono di creare report dettagliati e ottenere insight dai nostri dati. Gli strumenti di visualizzazione, come Tableau, Power BI e Looker, sono particolarmente popolari. Rendono semplice creare dashboard e visualizzazioni interattive. Scopri di più sugli strumenti BI più comuni in Tableau Fundamentals o PowerBI Fundamentals.
Strumenti di analisi come questi ci permettono di sfruttare appieno il potenziale dei dati archiviati nel nostro warehouse.
Un data warehouse offre vantaggi che possono migliorare le capacità di gestione dei dati di un'organizzazione.
Un data warehouse offre il vantaggio della gestione centralizzata dei dati. Fornisce una single source of truth per report e analisi. Questa centralizzazione garantisce coerenza e affidabilità nei dati dell'organizzazione, eliminando le discrepanze che possono verificarsi quando i dati sono sparsi su più fonti.
Un altro vantaggio significativo è la possibilità di effettuare analisi storiche. I data warehouse archiviano dati storici, consentendoci di condurre analisi delle tendenze e confronti nel tempo. Questa capacità offre insight su andamenti e pattern di lungo periodo nei nostri dati, utili per pianificare o prevedere tendenze future.
Una migliore qualità dei dati è un vantaggio chiave di qualsiasi sistema di gestione centralizzata, incluso un data warehouse. I dati vengono standardizzati e puliti per garantirne accuratezza e coerenza. Grazie a questa coerenza, le analisi o i report basati su tali dati sono più affidabili.
I data warehouse sono ottimizzati per query analitiche complesse. Questa ottimizzazione consente recuperi di dati più rapidi ed efficienti, particolarmente importanti quando facciamo affidamento su insight tempestivi per guidare le decisioni.
Gli strumenti BI sfruttano i dati centralizzati nel warehouse per fornire insight azionabili. La maggior parte degli strumenti BI comuni è ben attrezzata per utilizzare i dati di un data warehouse.
Un data warehouse è una ricca fonte di dati per analitiche avanzate, incluso data mining e machine learning. La natura strutturata dei dati in un warehouse facilita lo sviluppo di modelli predittivi sofisticati, che a loro volta ci aiutano ad anticipare tendenze, individuare opportunità e mitigare i rischi.
Sebbene un data warehouse non sia ideale in ogni situazione, ci sono circostanze in cui dovremmo valutarlo come soluzione alle nostre esigenze. Vediamo alcuni casi in cui conviene considerare l'uso di un data warehouse.
Se la nostra organizzazione affronta difficoltà nel gestire dati dispersi tra vari sistemi e applicazioni, potremmo considerare un sistema di gestione centralizzato come un data warehouse. Un data warehouse può consolidare questo panorama eterogeneo, semplificando analisi complete.
Per situazioni che richiedono analisi storiche o in cui dobbiamo comprendere andamenti e pattern nel tempo, un data warehouse può offrire il contesto storico necessario.
Se i nostri sistemi operativi faticano a eseguire in modo efficiente query complesse, creare un sistema di dati più strutturato può migliorare l'efficienza. In questo caso, possiamo considerare l'uso di un data warehouse, che ottimizza le prestazioni e supporta un accesso più rapido ai dati.
In molte situazioni, un data warehouse può far parte di un solido piano di gestione dei dati. E un buon piano di gestione è necessario per far sì che i nostri dati lavorino per noi.
Un data warehouse è uno strumento potente per sfruttare tutto il potenziale dei nostri dati. Fornisce un repository centralizzato, integrato e strutturato per i nostri dati.
Scopri di più sui data warehouse nel corso Data Warehousing Concepts di DataCamp. Ti consiglio anche What Is a Data Federation e What Is a Data Fabric come ulteriori letture utili sull'argomento.
Impara l'AI per il business!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min




